Inercja i wielopoziomowy model autoregresyjny
Inercja emocjonalna to stopień, w jakim stan emocjonalny opiera się zmianie. Kuppens i in. (2010) pokazali w dwóch badaniach naturalistycznych, że u osób z niską samooceną i z depresją wahania emocji pozytywnych i negatywnych miały wyższą inercję niż u pozostałych. Inercję najczęściej mierzy się parametrem autoregresyjnym w danych z próbkowania doświadczeń (ESM; Simsa i in., 2024). Ten parametr mówi, na ile afekt w danym sygnale da się przewidzieć z afektu w sygnale poprzednim. To ta sama idea co autokorelacja w szeregu czasowym, tyle że oszacowana dla wielu osób naraz.
Wielopoziomowy model autoregresyjny pierwszego rzędu, MLAR(1), ma dwa poziomy (Simsa i in., 2024):
Poziom 2: γ0i = β00 + ν0i, γ1i = β10 + ν1i
Na poziomie 1 każda osoba i ma własny proces: γ1i to jej inercja, a εit to innowacja, czyli część afektu, której nie przewiduje poprzedni pomiar. Na poziomie 2 inercje osób rozkładają się wokół stałego efektu β10, który zwykle jest głównym celem analizy. Model zakłada stacjonarność, czyli stałą średnią, wariancję innowacji i inercję w czasie (zob. stacjonarność), inercje osób w przedziale od −1 do 1 oraz równe odstępy między kolejnymi pomiarami. Jongerling i in. (2015) pokazują, że gdy wariancja innowacji różni się między osobami, a model traktuje ją jako stałą, oszacowania są obciążone. Dlatego w niektórych programach można ją też uczynić losową.
Ogólne przygotowanie danych ESM, z compliance, centrowaniem predyktorów i opóźnieniami w obrębie dnia, omawia wpis badania dzienniczkowe i EMA – analiza danych. Tu zajmujemy się samą inercją i tym, co robią z nią braki danych.
Przykład: 60 osób, 70 sygnałów
Symulujemy negatywny afekt (0–100) u 60 osób przez 70 kolejnych sygnałów. Każda osoba ma własny średni poziom i własną inercję. Średnia inercja w populacji wynosi 0.40, a odchylenie standardowe między osobami 0.12. Dla przejrzystości pomijamy przerwy nocne, tak jak w symulacjach Simsy i in. (2024). W prawdziwych danych opóźnienia nie mogą przechodzić przez noc. Dane są symulowane (set.seed(2031)), a cały kod jest w sekcji z przykładem w R.
Krok 1. Opóźniony predyktor i centrowanie
W lmer model MLAR(1) to regresja wielopoziomowa, w której predyktorem jest afekt z poprzedniego sygnału: y ~ y_lag_cw + (1 + y_lag_cw | id). Predyktor zwykle centruje się do średniej osoby. Wtedy stały efekt opisuje przeciętną inercję, a wyraz wolny osoby jej typowy poziom (Simsa i in., 2024). Hamaker i Grasman (2015) pokazali jednak, że przy opóźnionej zmiennej zależnej centrowanie do średniej osoby zwykle zaniża średni efekt autoregresyjny. Centrowanie jest natomiast lepszym wyborem, gdy pytasz o interakcję międzypoziomową, np. czy inercja zależy od nasilenia depresji. Decyzję o centrowaniu uzależnij więc od celu badania.
| Model | Inercja (SE) | Komentarz |
|---|---|---|
| Prawda w symulacji (średnia z 60 osób) | 0.405 | punkt odniesienia |
| Opóźnienie centrowane do średniej osoby | 0.389 (0.022) | nieco zaniżone; 95% CI [0.346, 0.433] |
| Opóźnienie bez centrowania w osobie | 0.411 (0.021) | bliżej prawdy przy 70 pomiarach |
| Zwykła regresja bez poziomów | 0.677 (0.011) | miesza inercję z różnicami średnich między osobami |
Odchylenie standardowe losowej inercji wyniosło 0.13. Inercje poszczególnych osób z modelu wahały się od 0.16 do 0.68 i korelowały z prawdziwymi na poziomie r = .75. Ostatni wiersz przypomina, dlaczego potrzebny jest model wielopoziomowy. Bez niego trwałe różnice w poziomie afektu udają silną inercję.
Krok 2. Braki w ESM: compliance, mechanizm i wzorzec w czasie
Pominięte sygnały są w ESM regułą. W metaanalizie badań EMA średnie compliance wyniosło 79% (Wrzus i Neubauer, 2023). W modelu AR braki szkodzą podwójnie, bo ta sama zmienna jest wynikiem i predyktorem. Jeden pusty sygnał usuwa więc dwie pary: tę, w której jest wynikiem, i tę, w której byłby opóźnionym predyktorem. Simsa i in. (2024) opisują braki trzema cechami:
- compliance, czyli odsetek odebranych sygnałów;
- mechanizm według klasyfikacji Rubina (1976; zob. MCAR, MAR i MNAR). Braki są MCAR, gdy każdy sygnał ma takie samo prawdopodobieństwo pominięcia. Są „ogonowe” i należą do MNAR, gdy zależą od samego afektu. Przy brakach asymetrycznych ktoś nie odpowiada, gdy czuje się źle. Przy symetrycznych pomija też chwile skrajnie dobre, np. w trakcie uroczystości;
- wzorzec w czasie: pojedyncze braki albo serie, np. pięć kolejnych sygnałów z powodu wyjazdu.
Autorzy zauważają, że czysty mechanizm MCAR jest w ESM rzadki. Zdarza się przy awariach technicznych albo w planowanych schematach braków.
Krok 3. Co braki robią z oszacowaniem inercji
Simsa i in. (2024) przeprowadzili symulację Monte Carlo. Zmieniali compliance (.4, .8, 1), mechanizm, wzorzec braków, wielkość inercji, jej zmienność między osobami i liczbę sygnałów. Model szacowali na dwa sposoby. Pierwszy to klasyczny model mieszany z usuwaniem wierszy z brakami i centrowaniem do obserwowanej średniej osoby. Drugi to bayesowski dynamiczny model równań strukturalnych (DSEM) w programie Mplus. DSEM traktuje braki jako nieznane parametry i stosuje centrowanie latentne (Asparouhov i in., 2018). Najważniejsze wyniki tego preprintu (wersja z 2024 r., jeszcze przed recenzją):
- Braki zaniżały stały efekt autoregresyjny i zwiększały jego wariancję. Przy MCAR zaniżenie było niewielkie.
- Przy brakach ogonowych obciążenie było znacznie większe, a najsilniejsze przy brakach w obu ogonach. Przy compliance .4 i brakach symetrycznych wielkość obciążenia była bliska samej inercji.
- Precyzję obniżało przede wszystkim niskie compliance, zwłaszcza przy małej liczbie sygnałów. Mechanizm braków miał mniejsze znaczenie.
- Wnioski były podobne bez względu na to, czy szacowano losowe inercje. DSEM dawał nieco mniejsze obciążenie, ale różnice były zwykle pomijalne wobec skutków samych braków.
- Gdy autorzy wprowadzili te same braki do prawdziwych danych ESM, wnioski się powtórzyły.
Autorzy wyjaśniają ten mechanizm geometrią par. Punkty (afekt w t − 1, afekt w t) tworzą elipsę, której nachylenie to inercja. Braki ogonowe wycinają jej końce w obu wymiarach naraz, więc to, co zostaje, coraz bardziej przypomina koło. Rysunek 1 pokazuje to na naszych danych.
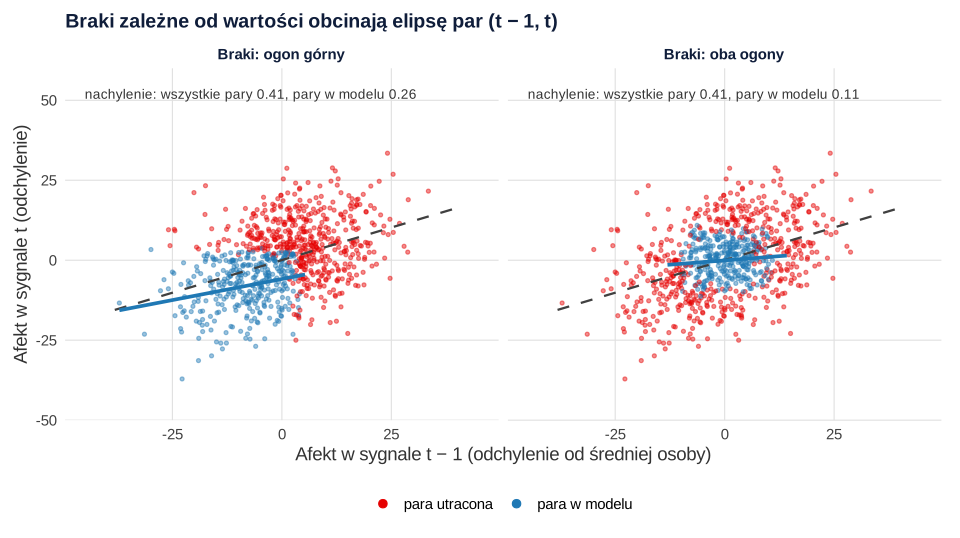
W tym samym zbiorze, przy compliance 60%, model w lmer dał następujące oszacowania inercji:
| Braki | Inercja (SE) | Pary w modelu |
|---|---|---|
| bez braków | 0.389 (0.022) | 4140 |
| MCAR, pojedyncze | 0.377 (0.030) | 1498 |
| MCAR, bloki po 5 | 0.373 (0.024) | 2204 |
| ogon górny (MNAR) | 0.243 (0.029) | 1734 |
| oba ogony (MNAR) | 0.086 (0.029) | 1569 |
Zauważ liczbę par. Przy 40% brakujących sygnałów rozsianych losowo zostaje tylko 36% par (1498 z 4140). Te same braki w blokach zostawiają ich więcej, bo w środku bloku jeden brak nie niszczy dwóch par. Dlatego blokowy wzorzec dał tu mniejszy błąd standardowy.
Krok 4. Mała symulacja w lme4
Pojedynczy zbiór może być dziełem przypadku, więc powtórzyliśmy analizę na 200 zbiorach dla każdego warunku. W każdym zbiorze było 60 osób, 70 sygnałów i prawdziwa inercja 0.40. Zmienialiśmy compliance (80% i 60%) oraz mechanizm braków. Liczymy średnie oszacowanie, obciążenie względne i empiryczne SD oszacowań. Dwa z 1 800 dopasowań zgłosiły ostrzeżenie o zbieżności.
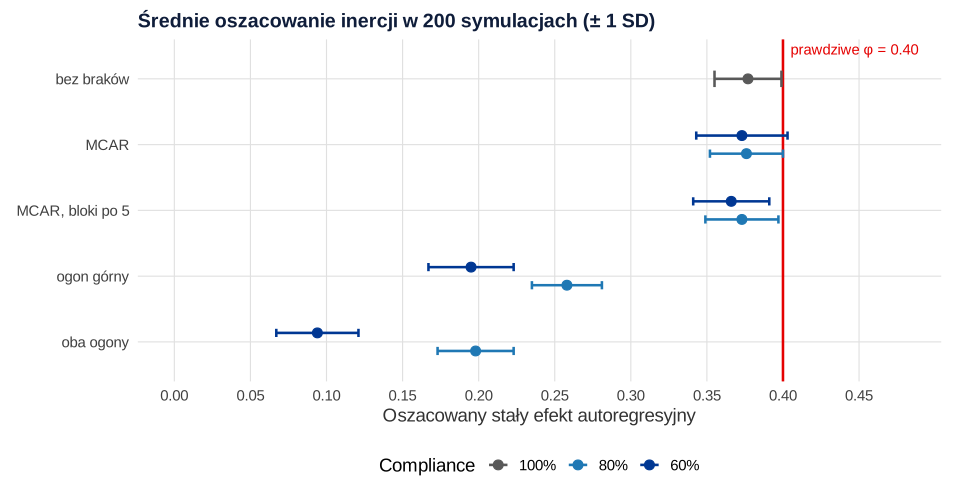
Wyniki układają się tak, jak opisują Simsa i in. (2024). Bez braków oszacowanie jest zaniżone o 5.8% przez samo centrowanie do średniej osoby. Braki MCAR dokładają niewiele (−6.7% przy compliance 60%), ale zwiększają rozrzut oszacowań z 0.022 do 0.030. Braki w górnym ogonie zaniżają inercję o 35.5% przy compliance 80% i o 51.1% przy 60%. Braki w obu ogonach zaniżają ją o 50.6% i 76.5%. Takiego obciążenia nie ujawni ani błąd standardowy, ani przedział ufności. Średnie SE z modelu były podobne we wszystkich warunkach (0.021–0.029).
Uważaj też na częsty błąd w przygotowaniu danych. Jeśli usuniesz puste wiersze i „opóźnienie” weźmiesz z poprzedniej dostępnej odpowiedzi, złamiesz założenie równych odstępów. W naszym zbiorze przy brakach MCAR tylko 60.9% tak utworzonych par to rzeczywiście sąsiednie sygnały. Inercja spadła wtedy do 0.255, choć mechanizm braków był niewinny.
Co możesz zrobić: projekt ważniejszy niż model
Simsa i in. (2024) wnioskują, że decyzje modelowe łagodzą obciążenie tylko w ograniczonym stopniu, zwłaszcza gdy braki nie są losowe. Dlatego zalecają przede wszystkim taki projekt badania, który zwiększa compliance i szansę na braki MCAR:
- Mniejsze obciążenie i gratyfikacje. Krótszy kwestionariusz w każdym sygnale i wynagrodzenie dla uczestników. W metaanalizie compliance było wyższe w badaniach z gratyfikacją finansową (Wrzus i Neubauer, 2023).
- Planowane braki. Gdy każdy sygnał zawiera tylko część pozycji, braki są z założenia losowe. Silvia i in. (2014) pokazali w symulacjach, że takie schematy dają nieobciążone oszacowania przy nieco większych błędach standardowych. Przy badaniu inercji tracisz jednak pary, więc autorzy proponują planowo pomijać całe dni, np. 7 dni pomiaru rozłożonych losowo na 14 dni.
- Próbkowanie epizodów. Pomiar uruchamiany, gdy afekt odbiega od typowego poziomu, może wyraźnie poprawić precyzję oszacowania inercji (Revol i in., 2025). Simsa i in. (2024) zauważają jednak, że pomiar w chwilach silnych emocji może bardziej przeszkadzać uczestnikom i obniżać compliance.
- Liczebność z uwzględnieniem braków. W symulacyjnej analizie mocy sprawdź kilka scenariuszy braków jako analizę wrażliwości. Logikę takiej symulacji pokazuje wpis o liczebności próby metodą Monte Carlo.
Po stronie analizy rozważ estymację, która nie usuwa wierszy. Przykładem jest DSEM z centrowaniem latentnym, w którym braki są szacowane razem z modelem (Asparouhov i in., 2018). Według wyników Simsy i in. (2024) przewaga nad klasycznym modelem była jednak niewielka. Imputacja wielokrotna czy największa wiarygodność zakładają co najmniej MAR, więc nie usuną obciążenia, gdy braki zależą od samego afektu. Autorzy przypominają też, że błąd pomiaru dodatkowo osłabia oszacowania inercji. Przy porównaniu grup pamiętaj, że dwie grupy o tej samej prawdziwej inercji, ale o różnym compliance i wzorcu braków, mogą dać wyraźnie różne oszacowania.
Jak opisać model autoregresyjny i braki
W metodzie podaj liczbę sygnałów i odstępy między nimi, sposób budowy opóźnienia (bez przechodzenia przez noc i braki), sposób centrowania, strukturę efektów losowych i metodę estymacji. W wynikach podaj compliance z rozrzutem, liczbę par użytych w modelu i omów prawdopodobny mechanizm braków. Gdy wnioski dotyczą inercji, dodaj zdanie o kierunku możliwego obciążenia.
Jeśli planujesz badanie ESM o dynamice afektu albo recenzent pyta o skutki braków w Twoich danych, możemy razem zaplanować symulację, model i jego opis w ramach wsparcia statystycznego dla badaczy.
Przykład w R
Cztery przepisy uruchamiane po kolei. Pierwszy definiuje funkcje: symulację procesu AR(1) dla wielu osób, wprowadzanie braków, budowę opóźnienia i dopasowanie modelu. Pozostałe liczą wyniki z tekstu. Potrzebujesz pakietów lme4 i lmerTest. Symulacja w przepisie 4 trwa kilka minut.
1. Funkcje: symulacja, braki, opóźnienie, model
R
# Funkcje wspólne: symulacja wielopoziomowego procesu AR(1), wprowadzanie braków, opóźnienie i dopasowanie modelu w lme4
suppressPackageStartupMessages({library(lme4); library(lmerTest)})

# n osób, T kolejnych sygnałów (bez przerw nocnych), średnia inercja phi, SD inercji między osobami
symuluj_ar <- function(n = 60, T = 70, phi = 0.40, sd_phi = 0.12, sd_innow = 10, rozgrzewka = 50) {
  do.call(rbind, lapply(1:n, function(i) {
    repeat { phi_i <- rnorm(1, phi, sd_phi); if (abs(phi_i) < 1) break }   # stacjonarność: |phi_i| < 1
    mu_i <- rnorm(1, 40, 10)                                                # średni poziom afektu osoby (0–100)
    e <- rnorm(T + rozgrzewka, 0, sd_innow)
    y <- numeric(T + rozgrzewka); y[1] <- e[1]
    for (t in 2:length(y)) y[t] <- phi_i * y[t - 1] + e[t]
    data.frame(id = sprintf("o%02d", i), t = 1:T, phi_i = phi_i, y = mu_i + tail(y, T))
  }))
}

# Braki przy zadanym compliance: MCAR pojedynczo, MCAR blokami po 5, ogon górny (asymetryczny) albo oba ogony (symetryczny)
wprowadz_braki <- function(y, compliance, mechanizm) {
  T <- length(y); k <- round((1 - compliance) * T)                          # liczba brakujących sygnałów u osoby
  brak <- rep(FALSE, T)
  if (mechanizm == "MCAR") brak[sample(T, k)] <- TRUE
  if (mechanizm == "MCAR, bloki po 5") {
    while (sum(brak) < k) {                                                  # początek bloku losowy, blok ucięty do k braków
      s <- sample(T, 1); idx <- s:min(T, s + 4); idx <- idx[!brak[idx]]
      brak[head(idx, k - sum(brak))] <- TRUE
    }
  }
  if (mechanizm == "ogon górny") brak[order(y, decreasing = TRUE)[seq_len(k)]] <- TRUE
  if (mechanizm == "oba ogony") brak[c(order(y)[seq_len(floor(k / 2))], order(y, decreasing = TRUE)[seq_len(ceiling(k / 2))])] <- TRUE
  ifelse(brak, NA, y)
}

# Opóźnienie o jeden sygnał (t − 1), także gdy poprzedni sygnał jest brakiem, i centrowanie do średniej osoby
przygotuj <- function(d) {
  d <- d[order(d$id, d$t), ]
  d$y_lag <- ave(d$y, d$id, FUN = function(x) c(NA, head(x, -1)))
  d$y_lag_cw <- d$y_lag - ave(d$y, d$id, FUN = function(x) mean(x, na.rm = TRUE))
  d
}

# Stały efekt autoregresyjny z modelu z losowym wyrazem wolnym i losową inercją (wiersze z brakiem usuwane przez lmer)
dopasuj_ar <- function(d) {
  m <- suppressMessages(lmer(y ~ y_lag_cw + (1 + y_lag_cw | id), data = d, control = lmerControl(optimizer = "bobyqa")))
  c(phi = fixef(m)[["y_lag_cw"]], se = sqrt(vcov(m)[2, 2]), pary = nobs(m))
}
2. Model MLAR(1) w pełnych danych
R
# Dane symulowane: negatywny afekt (0–100) u 60 osób, 70 kolejnych sygnałów ESM; prawdziwa średnia inercja phi = 0.40
source("b203-0-funkcje.R")
set.seed(2031)
d <- przygotuj(symuluj_ar())
head(d[, c("id", "t", "y", "y_lag", "y_lag_cw")], 4)
round(c(srednia_phi_osob = mean(tapply(d$phi_i, d$id, mean)), sd_phi_osob = sd(tapply(d$phi_i, d$id, mean))), 3)

# Model 1: opóźniony NA centrowany do średniej osoby – stały efekt = średnia inercja
m1 <- lmer(y ~ y_lag_cw + (1 + y_lag_cw | id), data = d, control = lmerControl(optimizer = "bobyqa"))
round(summary(m1)$coefficients, 3)
round(confint(m1, parm = "beta_", method = "Wald"), 3)
print(VarCorr(m1), comp = c("Variance", "Std.Dev."))
# Model 2: opóźniony NA bez centrowania do średniej osoby (tylko odjęta średnia ogólna, by ułatwić estymację)
d$y_lag_gc <- d$y_lag - mean(d$y)
m2 <- lmer(y ~ y_lag_gc + (1 + y_lag_gc | id), data = d, control = lmerControl(optimizer = "bobyqa"))
round(summary(m2)$coefficients, 3)
# Model 3: zwykła regresja na wszystkich parach (ignoruje zagnieżdżenie w osobach)
round(coef(summary(lm(y ~ y_lag, data = d)))["y_lag", 1:2], 3)
# Inercja poszczególnych osób z modelu 1 a prawdziwe wartości z symulacji
phi_os <- fixef(m1)[["y_lag_cw"]] + ranef(m1)$id$y_lag_cw
round(c(r_z_prawdziwa = cor(phi_os, tapply(d$phi_i, d$id, mean)), min = min(phi_os), max = max(phi_os)), 3)
Wynik w R
   id t         y     y_lag  y_lag_cw
1 o01 1 17.370858        NA        NA
2 o01 2  3.033637 17.370858 -22.78241
3 o01 3 26.776012  3.033637 -37.11963
4 o01 4 36.949971 26.776012 -13.37726
srednia_phi_osob      sd_phi_osob
           0.405            0.138
            Estimate Std. Error     df t value Pr(>|t|)
(Intercept)   37.940      1.306 59.001  29.045        0
y_lag_cw       0.389      0.022 63.942  17.403        0
             2.5 % 97.5 %
(Intercept) 35.380 40.500
y_lag_cw     0.346  0.433
 Groups   Name        Variance   Std.Dev. Corr
 id       (Intercept) 100.926565 10.0462
          y_lag_cw      0.017637  0.1328  -0.024
 Residual              99.982793  9.9991
            Estimate Std. Error     df t value Pr(>|t|)
(Intercept)   37.908      0.790 53.038  47.977        0
y_lag_gc       0.411      0.021 64.675  19.435        0
  Estimate Std. Error
     0.677      0.011
r_z_prawdziwa           min           max
        0.750         0.163         0.676
3. Mechanizmy braków w jednym zbiorze
R
# Te same dane (set.seed(2031)), compliance 60%: cztery mechanizmy braków i ten sam model AR(1)
source("b203-0-funkcje.R")
set.seed(2031)
pelne <- symuluj_ar()
set.seed(77)
mech <- c("MCAR", "MCAR, bloki po 5", "ogon górny", "oba ogony")
wyniki <- t(sapply(mech, function(m) {
  d <- pelne
  d$y <- ave(d$y, d$id, FUN = function(y) wprowadz_braki(y, .60, m))
  c(compliance = mean(!is.na(d$y)), dopasuj_ar(przygotuj(d)))
}))
wyniki <- rbind("bez braków" = c(compliance = 1, dopasuj_ar(przygotuj(pelne))), wyniki)
round(wyniki, 3)

# Błąd w przygotowaniu danych: „opóźnienie” liczone z poprzedniej DOSTĘPNEJ odpowiedzi (przeskakuje braki)
set.seed(77)
d <- pelne
d$y <- ave(d$y, d$id, FUN = function(y) wprowadz_braki(y, .60, "MCAR"))
d_zle <- d[!is.na(d$y), ]
d_zle$y_lag <- ave(d_zle$y, d_zle$id, FUN = function(x) c(NA, head(x, -1)))
d_zle$y_lag_cw <- d_zle$y_lag - ave(d_zle$y, d_zle$id, FUN = mean)
d_zle$odstep <- ave(d_zle$t, d_zle$id, FUN = function(x) c(NA, diff(x)))
round(prop.table(table(odstep = pmin(d_zle$odstep, 4))), 3)              # odstęp w sygnałach (4 = 4 lub więcej)
round(dopasuj_ar(d_zle), 3)
Wynik w R
                 compliance   phi    se pary
bez braków              1.0 0.389 0.022 4140
MCAR                    0.6 0.377 0.030 1498
MCAR, bloki po 5        0.6 0.373 0.024 2204
ogon górny              0.6 0.243 0.029 1734
oba ogony               0.6 0.086 0.029 1569
odstep
    1     2     3     4
0.609 0.234 0.091 0.066
     phi       se     pary
   0.255    0.026 2460.000
4. Symulacja Monte Carlo: 200 powtórzeń na warunek
R
# Mała symulacja Monte Carlo: 200 zbiorów danych na warunek (60 osób × 70 sygnałów, prawdziwe phi = 0.40)
# Warunki: compliance 80% i 60% × cztery mechanizmy braków oraz dane bez braków
source("b203-0-funkcje.R")
set.seed(4202)
R <- 200
mech <- c("MCAR", "MCAR, bloki po 5", "ogon górny", "oba ogony")
warunki <- rbind(data.frame(compliance = 1, mechanizm = "bez braków"), expand.grid(compliance = c(.8, .6), mechanizm = mech))
wyn <- do.call(rbind, lapply(1:R, function(r) {
  pelne <- symuluj_ar()
  do.call(rbind, lapply(seq_len(nrow(warunki)), function(w) {
    d <- pelne
    if (warunki$compliance[w] < 1) d$y <- ave(d$y, d$id, FUN = function(y) wprowadz_braki(y, warunki$compliance[w], warunki$mechanizm[w]))
    data.frame(warunki[w, ], t(dopasuj_ar(przygotuj(d))))
  }))
}))
podsum <- do.call(rbind, lapply(split(wyn, list(wyn$compliance, wyn$mechanizm), drop = TRUE), function(x)
  data.frame(compliance = x$compliance[1], mechanizm = x$mechanizm[1], srednie_phi = mean(x$phi),
             obciazenie_wzgl_proc = 100 * (mean(x$phi) - 0.40) / 0.40, sd_empiryczne = sd(x$phi), sredni_se = mean(x$se),
             pary = mean(x$pary))))
podsum <- podsum[order(-podsum$compliance, podsum$mechanizm), ]
print(cbind(podsum[1:2], round(podsum[3:7], 3)), row.names = FALSE)
Wynik w R
Warning in checkConv(attr(opt, "derivs"), opt$par, ctrl = control$checkConv,  :
  Model failed to converge with max|grad| = 0.00368652 (tol = 0.002, component 1)
  See ?lme4::convergence and ?lme4::troubleshooting.
Warning: Model failed to converge with 1 negative eigenvalue: -2.0e+04
 compliance        mechanizm srednie_phi obciazenie_wzgl_proc sd_empiryczne
        1.0       bez braków       0.377               -5.754         0.022
        0.8             MCAR       0.376               -5.940         0.024
        0.8 MCAR, bloki po 5       0.373               -6.689         0.024
        0.8        oba ogony       0.198              -50.609         0.025
        0.8       ogon górny       0.258              -35.548         0.023
        0.6             MCAR       0.373               -6.729         0.030
        0.6 MCAR, bloki po 5       0.366               -8.498         0.025
        0.6        oba ogony       0.094              -76.521         0.027
        0.6       ogon górny       0.195              -51.146         0.028
 sredni_se     pary
     0.021 4140.000
     0.024 2639.605
     0.023 3139.705
     0.023 2696.590
     0.023 2782.330
     0.029 1474.830
     0.025 2203.710
     0.028 1550.970
     0.028 1725.290
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietami lme4 (wersja 2.0.1) i lmerTest (wersja 3.2.1); rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- lmerTest (wersja 3.2.1): Kuznetsova, A., Brockhoff, P. B., & Christensen, R. H. B. (2017). lmerTest package: Tests in linear mixed effects models. Journal of Statistical Software, 82(13), 1–26. https://doi.org/10.18637/jss.v082.i13
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Opóźnienie z poprzedniej dostępnej odpowiedzi. Łamie założenie równych odstępów i zaniża inercję także przy losowych brakach.
- Opóźnienie przez noc. Ostatni sygnał dnia i pierwszy następnego dzieli kilkanaście godzin, a nie 2–3.
- Zwykła regresja zamiast modelu wielopoziomowego. Różnice średnich między osobami udają inercję (w przykładzie 0.68 zamiast 0.40).
- Milczenie o brakach. Compliance i prawdopodobny mechanizm braków należą do wyników, bo od nich zależy kierunek obciążenia.
- Porównanie inercji grup o różnym compliance bez komentarza. Różnica może wynikać z braków, a nie z dynamiki afektu.
- Przekonanie, że wyrafinowana estymacja rozwiąże problem. Przy brakach zależnych od afektu ważniejszy jest projekt badania.
Inne wskaźniki dynamiki, np. zmienność strategii regulacji emocji, opisuje wpis zmienność regulacji emocji w ESM. Gdy pytasz o wzajemne wpływy dwóch zmiennych w panelu z kilkoma falami, zajrzyj do wpisu o modelach cross-lagged, a gdy interesuje Cię trend, do wpisu o modelach wzrostu w lme4. Podstawy modeli mieszanych omawia model wielopoziomowy krok po kroku.
Najczęstsze pytania
Jak oszacować inercję emocjonalną w R?
Utwórz afekt z poprzedniego sygnału tego samego dnia, wycentruj go do średniej osoby i dopasuj w lme4 model y ~ y_lag_cw + (1 + y_lag_cw | id). Stały efekt opóźnienia to przeciętna inercja, a losowy efekt opisuje jej zróżnicowanie między osobami. Centrowanie w osobie może nieznacznie zaniżać średni efekt (Hamaker i Grasman, 2015).
Jak braki danych wpływają na model autoregresyjny w ESM?
Zaniżają stały efekt autoregresyjny i zwiększają jego wariancję. Przy brakach całkowicie losowych zaniżenie jest niewielkie, a przy brakach zależnych od wartości afektu – duże, najsilniej, gdy pomijane są oba krańce rozkładu (Simsa i in., 2024). W naszej symulacji przy compliance 60% inercja 0.40 spadła średnio do 0.09.
Czy przy brakach w ESM można liczyć opóźnienie z poprzedniej dostępnej odpowiedzi?
Nie. Model AR zakłada równe odstępy, więc opóźnienie musi pochodzić z sygnału t − 1, a gdy ten jest brakiem, para wypada z analizy. W przykładzie z tego wpisu przeskakiwanie braków obniżyło inercję z ok. 0.38 do 0.26, choć braki były całkowicie losowe.
Jak zwiększyć compliance w badaniu ESM?
Skróć kwestionariusz w każdym sygnale i zaplanuj gratyfikację – w metaanalizie badań EMA compliance było wyższe w badaniach z wynagrodzeniem finansowym (Wrzus i Neubauer, 2023). Przy badaniu inercji rozważ planowane pominięcie całych dni zamiast losowych pozycji, a w analizie mocy uwzględnij kilka scenariuszy braków.
Czy inna metoda estymacji usuwa obciążenie inercji przy brakach w ESM?
Tylko w niewielkim stopniu. Simsa i in. (2024) porównali klasyczny model mieszany z usuwaniem wierszy i model DSEM, który szacuje braki razem z modelem i stosuje centrowanie latentne (Asparouhov i in., 2018); drugi dawał tylko nieco mniejsze obciążenie. Gdy braki zależą od samego afektu, ważniejszy jest projekt badania niż wybór estymacji.
Powiązane hasła
Przeczytaj też
Badania dzienniczkowe i EMA – analiza danych
Compliance, ICC, centrowanie w osobie, opóźnienia w obrębie dnia, reaktywność afektywna w lme4 i rzetelność zmiany – z kodem R i wzorem opisu.
Czytaj →PoradnikZmienność regulacji emocji w ESM
SD i względne SD, Bray–Curtis z podziałem na przełączanie i zmianę nasilenia, RMSSD, AR, %DET i entropia – wzory, R i interpretacja.
Czytaj →PoradnikModele wzrostu w lme4
Losowy wyraz wolny i nachylenie czasu, kodowanie czasu, nieregularne terminy, predyktor × czas, braki MAR, porównanie z LGM i wzór opisu APA.
Czytaj →Szacujesz inercję z danych ESM, a recenzent pyta o braki?
Pomożemy zaplanować model autoregresyjny, sprawdzić wpływ braków w symulacji i opisać ograniczenia tak, żebyś mógł(a) samodzielnie bronić wyników.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Asparouhov, T., Hamaker, E. L., & Muthén, B. (2018). Dynamic structural equation models. Structural Equation Modeling: A Multidisciplinary Journal, 25(3), 359–388. https://doi.org/10.1080/10705511.2017.1406803 ● Otwarty dostęp: pełny tekst
- Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01 ● Otwarty dostęp
- Hamaker, E. L., & Grasman, R. P. P. P. (2015). To center or not to center? Investigating inertia with a multilevel autoregressive model. Frontiers in Psychology, 5. https://doi.org/10.3389/fpsyg.2014.01492 ● Otwarty dostęp
- Jongerling, J., Laurenceau, J.-P., & Hamaker, E. L. (2015). A multilevel AR(1) model: Allowing for inter-individual differences in trait-scores, inertia, and innovation variance. Multivariate Behavioral Research, 50(3), 334–349. https://doi.org/10.1080/00273171.2014.1003772 ● Otwarty dostęp: pełny tekst
- Kuppens, P., Allen, N. B., & Sheeber, L. B. (2010). Emotional inertia and psychological maladjustment. Psychological Science, 21(7), 984–991. https://doi.org/10.1177/0956797610372634 ● Otwarty dostęp: pełny tekst
- Revol, J., Ariens, S., Lafit, G., Adolf, J., & Ceulemans, E. (2025). Episode-contingent experience-sampling designs for accurate estimates of autoregressive dynamics. Psychological Methods. https://doi.org/10.1037/met0000758 ● Otwarty dostęp: pełny tekst
- Rubin, D. B. (1976). Inference and missing data. Biometrika, 63(3), 581–592. https://doi.org/10.1093/biomet/63.3.581
- Silvia, P. J., Kwapil, T. R., Walsh, M. A., & Myin-Germeys, I. (2014). Planned missing-data designs in experience-sampling research: Monte Carlo simulations of efficient designs for assessing within-person constructs. Behavior Research Methods, 46(1), 41–54. https://doi.org/10.3758/s13428-013-0353-y ● Otwarty dostęp: pełny tekst
- Simsa, B., Revol, J., Lafit, G., Cloos, L., Adolf, J., & Ceulemans, E. (2024). Navigating missing data in multilevel autoregressive modeling: Consequences of missingness mechanisms and temporal patterns of missings on estimation performance [Preprint]. PsyArXiv. https://doi.org/10.31234/osf.io/57vua ● Otwarty dostęp
- Wrzus, C., & Neubauer, A. B. (2023). Ecological momentary assessment: A meta-analysis on designs, samples, and compliance across research fields. Assessment, 30(3), 825–846. https://doi.org/10.1177/10731911211067538 ● Otwarty dostęp
Cytowania BibTeX
@article{asparouhov2018dynamic, author={Asparouhov, Tihomir and Hamaker, Ellen L. and Muthén, Bengt}, title={{Dynamic structural equation models}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2018}, volume={25}, number={3}, pages={359--388}, doi={10.1080/10705511.2017.1406803}}@article{bates2015fitting, author={Bates, Douglas and Mächler, Martin and Bolker, Ben and Walker, Steve}, title={{Fitting linear mixed-effects models using lme4}}, journal={Journal of Statistical Software}, year={2015}, volume={67}, number={1}, pages={1--48}, doi={10.18637/jss.v067.i01}}@article{hamaker2015center, author={Hamaker, Ellen L. and Grasman, Raoul P. P. P.}, title={{To center or not to center? Investigating inertia with a multilevel autoregressive model}}, journal={Frontiers in Psychology}, year={2015}, volume={5}, doi={10.3389/fpsyg.2014.01492}}@article{jongerling2015multilevel, author={Jongerling, Joran and Laurenceau, Jean-Philippe and Hamaker, Ellen L.}, title={{A multilevel AR(1) model: Allowing for inter-individual differences in trait-scores, inertia, and innovation variance}}, journal={Multivariate Behavioral Research}, year={2015}, volume={50}, number={3}, pages={334--349}, doi={10.1080/00273171.2014.1003772}}@article{kuppens2010emotional, author={Kuppens, Peter and Allen, Nicholas B. and Sheeber, Lisa B.}, title={{Emotional inertia and psychological maladjustment}}, journal={Psychological Science}, year={2010}, volume={21}, number={7}, pages={984--991}, doi={10.1177/0956797610372634}}@article{revol2025episode, author={Revol, Jordan and Ariens, Sigert and Lafit, Ginette and Adolf, Janne and Ceulemans, Eva}, title={{Episode-contingent experience-sampling designs for accurate estimates of autoregressive dynamics}}, journal={Psychological Methods}, year={2025}, doi={10.1037/met0000758}}@article{rubin1976inference, author={Rubin, Donald B.}, title={{Inference and missing data}}, journal={Biometrika}, year={1976}, volume={63}, number={3}, pages={581--592}, doi={10.1093/biomet/63.3.581}}@article{silvia2014planned, author={Silvia, Paul J. and Kwapil, Thomas R. and Walsh, Molly A. and Myin-Germeys, Inez}, title={{Planned missing-data designs in experience-sampling research: Monte Carlo simulations of efficient designs for assessing within-person constructs}}, journal={Behavior Research Methods}, year={2014}, volume={46}, number={1}, pages={41--54}, doi={10.3758/s13428-013-0353-y}}@misc{simsa2024navigating, author={Simsa, Benjamin and Revol, Jordan and Lafit, Ginette and Cloos, Leonie and Adolf, Janne and Ceulemans, Eva}, title={{Navigating missing data in multilevel autoregressive modeling: Consequences of missingness mechanisms and temporal patterns of missings on estimation performance}}, howpublished={PsyArXiv}, year={2024}, doi={10.31234/osf.io/57vua}}@article{wrzus2023ecological, author={Wrzus, Cornelia and Neubauer, Andreas B.}, title={{Ecological momentary assessment: A meta-analysis on designs, samples, and compliance across research fields}}, journal={Assessment}, year={2023}, volume={30}, number={3}, pages={825--846}, doi={10.1177/10731911211067538}}