Co to jest szereg czasowy?
Szereg czasowy (ang. time series) to ciąg pomiarów jednej zmiennej, wykonanych w kolejnych, zwykle równych odstępach czasu, w którym kolejność obserwacji ma znaczenie. Przykłady z psychologii to codzienny nastrój osoby w dzienniczku, tygodniowa liczba wizyt w poradni czy wyniki samoopisu zbierane kilka razy dziennie w metodzie próbkowania doświadczeń (ESM). Jebb i in. (2015) opisują szeregi czasowe jako narzędzie do badania zmiany: jej wzorca, efektów sezonowych, wpływu zdarzeń i prognozowania.
Szereg czasowy różni się od zwykłego zbioru danych tym, że obserwacje nie są niezależne. Dzisiejszy nastrój zależy od wczorajszego, a tydzień z sesją egzaminacyjną różni się od tygodnia wakacji. Większość testów z kursu statystyki zakłada niezależność obserwacji, więc w szeregu czasowym dają one mylące wyniki, jeśli zależności czasowej nie uwzględnisz w modelu.
Z czego składa się szereg czasowy
| Składnik | Co opisuje | Przykład |
|---|---|---|
| Trend | Długookresowy kierunek zmian | Stopniowa poprawa nastroju w trakcie terapii |
| Sezonowość (cykl) | Wzorzec powtarzający się w stałym okresie | Lepszy nastrój w weekendy; spadki w okresie sesji |
| Interwencja / zdarzenie | Skokowa lub stopniowa zmiana po określonym momencie | Zmiana poziomu objawów po rozpoczęciu leczenia |
| Składnik losowy z autokorelacją | Wahania, które „przenoszą się” na kolejne dni | Zły dzień zwiększa szansę na kolejny zły dzień |
Kluczowe pojęcie to autokorelacja: korelacja szeregu z nim samym przesuniętym o k okresów (opóźnienie, ang. lag). Autokorelacja przy opóźnieniu 1 mówi, jak bardzo wynik z dnia t przypomina wynik z dnia t − 1. Najprostszy model zależności to proces autoregresyjny pierwszego rzędu, AR(1):
W tym zapisie φ (od −1 do 1) to siła przenoszenia odchyleń z dnia na dzień, a ut – nowy, niezależny „wstrząs”. Gdy φ jest dodatnie, a model je ignoruje, błędy standardowe współczynników są zaniżone, a wartości p – zbyt małe.
Przykład: 140 dni nastroju w dzienniczku
Osoba w trakcie terapii przez 140 kolejnych dni oceniała wieczorem nastrój (średnia z trzech pytań, skala 1–7; dane symulowane). Średni nastrój wynosił M = 4.06 (SD = 0.57). Już surowy szereg miał silną autokorelację: .57 przy opóźnieniu 1 dnia i .34 przy opóźnieniu 7 dni. To typowy obraz szeregu z trendem.
Krok 1: zwykła regresja. Model z trendem (numer dnia) i zmienną weekend, oszacowany metodą najmniejszych kwadratów tak, jakby dni były niezależne, dał nachylenie trendu b = 0.0074 na dzień (SE = 0.0010). Weekendy miały nastrój wyższy o 0.27 punktu (SE = 0.09). Reszty tego modelu były jednak skorelowane: .46 przy opóźnieniu 1 dnia (rysunek 1B). Test Durbina-Watsona – pierwszy opis tej statystyki podali Durbin i Watson (1950) – dał DW = 1.07, p < .001. Wartości bliskie 2 oznaczają brak autokorelacji, a wyraźnie niższe – autokorelację dodatnią.
Krok 2: model z autokorelacją. Ten sam model oszacowany z błędem AR(1) (uogólnione najmniejsze kwadraty, GLS) dał φ = .495. Trend prawie się nie zmienił (b = 0.0071 na dzień, 95% CI [0.0038, 0.0105]), ale jego błąd standardowy wzrósł z 0.0010 do 0.0017, a statystyka t spadła z 7.49 do 4.24. Efekt weekendu wyniósł 0.36 (SE = 0.08). Model z AR(1) był wyraźnie lepiej dopasowany: test ilorazu wiarygodności χ²(1) = 35.99, p < .001, AIC 176.7 wobec 210.7. Trend oznacza poprawę o około 0.50 punktu na 10 tygodni.
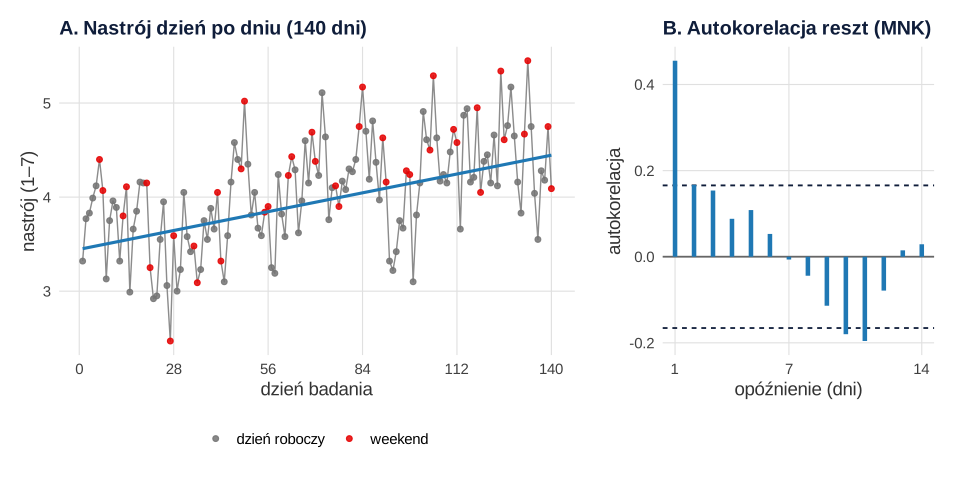
Wniosek o kierunku zmian pozostał ten sam, ale precyzja była w zwykłej regresji przeszacowana prawie dwukrotnie. Przy słabszym trendzie albo krótszym szeregu ta różnica decyduje o tym, czy wynik jest „istotny”. Huitema i McKean (1991) pokazali w badaniu Monte Carlo jeszcze jeden problem. W krótkich szeregach typowe estymatory autokorelacji są obciążone, a odsetek błędów I rodzaju odbiega od nominalnego. Przy kilkudziesięciu pomiarach traktuj więc oszacowanie φ ostrożnie.
Najważniejsze metody analizy
- Opis: wykres szeregu w czasie, średnie ruchome, autokorelacja i autokorelacja cząstkowa dla kolejnych opóźnień.
- Regresja z błędem autokorelowanym (GLS z AR(1), jak w przykładzie) – gdy interesuje cię trend, efekt dnia tygodnia albo interwencji.
- Modele ARIMA – gdy celem jest opis dynamiki i prognoza; wymagają zwykle dłuższych szeregów.
- Analiza przerwanych szeregów czasowych – porównanie poziomu i nachylenia przed interwencją i po niej (plan quasi-eksperymentalny).
- Wiele osób, wiele pomiarów: gdy masz krótkie szeregi od wielu osób (np. ESM), użyj modelu wielopoziomowego z autokorelacją reszt, a dla dwóch zmiennych mierzonych wielokrotnie – modeli opóźnień krzyżowych (zob. CLPM i RI-CLPM).
Wiele metod, zwłaszcza ARIMA, zakłada stacjonarność: średnia, wariancja i autokorelacje szeregu nie zmieniają się w czasie. Szereg z trendem, taki jak w przykładzie, nie jest stacjonarny. Trend można wtedy wprowadzić do modelu jako predyktor albo analizować różnice między kolejnymi pomiarami (dzień t minus dzień t − 1). Wybór zależy od pytania: jeśli interesuje cię sama poprawa w trakcie terapii, trend jest wynikiem, a nie zakłóceniem, więc go nie usuwaj, tylko oszacuj.
Szereg czasowy to szczególny przypadek schematu podłużnego: wiele pomiarów, zwykle jednej jednostki. W naukach ekonomicznych analiza szeregów jest podstawowym narzędziem ekonometrii.
Jak opisać analizę szeregu czasowego w pracy
Podaj długość szeregu i odstęp pomiarów, sposób uwzględnienia autokorelacji, oszacowanie φ i wynik testu autokorelacji reszt. Wzór dla przykładu:
Szereg czasowy w R
Kod tworzy 140-dniowy szereg nastroju, liczy autokorelację, szacuje zwykłą regresję z testem Durbina-Watsona i ten sam model z błędem AR(1) w nlme::gls().
Trend, weekend i autokorelacja reszt
R
suppressPackageStartupMessages({ library(lmtest); library(nlme) })
# Dane symulowane: dzienniczek jednej osoby w trakcie terapii – nastrój (średnia z 3 pytań, skala 1–7)
# przez 140 kolejnych dni: łagodny trend wzrostowy, lepszy nastrój w weekendy, autokorelacja AR(1).
set.seed(207)
n_dni <- 140
dzien <- 1:n_dni
weekend <- as.numeric(((dzien - 1) %% 7) %in% c(5, 6))   # dzień 1 = poniedziałek
e <- as.numeric(arima.sim(list(ar = 0.6), n = n_dni, sd = 0.45))
nastroj <- round(pmin(pmax(3.4 + 0.008 * dzien + 0.35 * weekend + e, 1), 7), 2)
dane <- data.frame(dzien, tydzien = (dzien - 1) %/% 7 + 1, weekend, nastroj)
round(c(M = mean(nastroj), SD = sd(nastroj)), 2)
round(acf(nastroj, lag.max = 7, plot = FALSE)$acf[2:8], 2)       # autokorelacja surowego szeregu

# 1. Zwykła regresja (MNK): trend + weekend, jakby dni były niezależne
m_mnk <- lm(nastroj ~ dzien + weekend, data = dane)
round(coef(summary(m_mnk)), 4)
round(acf(resid(m_mnk), lag.max = 3, plot = FALSE)$acf[2:4], 2)  # autokorelacja reszt
dwtest(m_mnk)                                                      # test Durbina-Watsona

# 2. Ten sam model z błędem AR(1) (uogólnione najmniejsze kwadraty, nlme::gls)
m_ar <- gls(nastroj ~ dzien + weekend, data = dane, correlation = corAR1(form = ~ dzien))
round(summary(m_ar)$tTable, 4)
round(coef(m_ar$modelStruct$corStruct, unconstrained = FALSE), 3)  # oszacowane phi
round(intervals(m_ar, which = "coef")$coef["dzien", ], 4)
anova(m_ar, update(m_ar, correlation = NULL))                      # czy AR(1) poprawia model?

# 3. Ile wynosi zmiana na 10 tygodni (70 dni) według trendu
round(70 * coef(m_ar)["dzien"], 2)
Wynik w R
   M   SD
4.06 0.57
[1] 0.57 0.35 0.40 0.36 0.32 0.32 0.34
            Estimate Std. Error t value Pr(>|t|)
(Intercept)   3.4616     0.0830 41.6968   0.0000
dzien         0.0074     0.0010  7.4860   0.0000
weekend       0.2710     0.0881  3.0777   0.0025
[1] 0.46 0.17 0.15

	Durbin-Watson test

data:  m_mnk
DW = 1.0737, p-value = 9.741e-09
alternative hypothesis: true autocorrelation is greater than 0

             Value Std.Error t-value p-value
(Intercept) 3.4448    0.1389 24.8046       0
dzien       0.0071    0.0017  4.2357       0
weekend     0.3630    0.0805  4.5078       0
  Phi
0.495
 lower   est.  upper
0.0038 0.0071 0.0105
                                 Model df      AIC      BIC     logLik   Test
m_ar                                 1  5 176.7401 191.3400  -83.37003
update(m_ar, correlation = NULL)     2  4 210.7326 222.4125 -101.36628 1 vs 2
                                 L.Ratio p-value
m_ar
update(m_ar, correlation = NULL) 35.9925  <.0001
dzien
  0.5
Bibliografia oprogramowania
Wyniki pochodzą z R 4.5.3 z pakietami lmtest i nlme; rysunek przygotowano w pakietach ggplot2 i patchwork.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lmtest (wersja 0.9.40): Zeileis, A., & Hothorn, T. (2002). Diagnostic checking in regression relationships. R News, 2(3), 7–10. https://CRAN.R-project.org/doc/Rnews/
- nlme (wersja 3.1.168): Pinheiro, J., Bates, D., & R Core Team. (2025). nlme: Linear and nonlinear mixed effects models [R package]. https://doi.org/10.32614/CRAN.package.nlme
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Analiza szeregu zwykłym testem t, korelacją albo regresją bez sprawdzenia autokorelacji. Przy dodatniej autokorelacji wartości p są zbyt małe – w przykładzie t trendu spadło z 7.49 do 4.24 po jej uwzględnieniu.
- Korelowanie dwóch szeregów z trendem. Dwie zmienne, które obie rosną w czasie, korelują silnie nawet bez żadnego związku (korelacja pozorna). Najpierw usuń trend albo modeluj zmiany.
- Pominięcie cyklu. Nieuwzględniony efekt dnia tygodnia trafia do reszt i wygląda jak autokorelacja przy opóźnieniu 7.
- Uogólnianie z jednej osoby na populację. Szereg jednej osoby opisuje tę osobę; wnioski o ludziach w ogóle wymagają wielu szeregów.
- Nierówne odstępy traktowane jak równe. Jeśli pomiary są nieregularne (np. ESM o losowych porach), uwzględnij rzeczywisty czas w strukturze korelacji.
- Zbyt krótki szereg do złożonego modelu. ARIMA z wieloma parametrami na 30 pomiarach to zgadywanie; przy krótkich szeregach oszacowania autokorelacji są obciążone (Huitema i McKean, 1991).
Najczęstsze pytania
Co to jest szereg czasowy w psychologii?
To wiele pomiarów tej samej zmiennej u tej samej osoby lub jednostki w kolejnych odstępach czasu – np. codzienny nastrój w dzienniczku, cotygodniowe nasilenie objawów w terapii albo kilka pomiarów dziennie w metodzie ESM. Pozwala badać trend, cykle i wpływ zdarzeń w czasie.
Co to jest autokorelacja w szeregu czasowym?
Autokorelacja to korelacja szeregu z nim samym przesuniętym o k okresów. Autokorelacja przy opóźnieniu 1 równa .46 (jak w resztach przykładu na tej stronie) oznacza, że odchylenie w danym dniu w dużej mierze przenosi się na dzień następny. Dodatnia autokorelacja reszt zaniża błędy standardowe w zwykłej regresji.
Jak sprawdzić autokorelację reszt w R?
Wykreśl funkcję autokorelacji reszt (acf(resid(model))) i wykonaj test Durbina-Watsona (lmtest::dwtest(model)). Wartość DW bliska 2 oznacza brak autokorelacji pierwszego rzędu, a wyraźnie niższa – autokorelację dodatnią; w przykładzie DW = 1.07.
Czym jest model AR(1)?
To model, w którym odchylenie w chwili t zależy od odchylenia w chwili t − 1 przez współczynnik φ i od nowego, losowego wstrząsu. W regresji uwzględnia się go np. funkcją nlme::gls() z corAR1(); w przykładzie φ = .495, a błąd standardowy trendu wzrósł z 0.0010 do 0.0017.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Szeregi czasowe i ARIMA w praktyce
Trend, sezonowość, ACF i test Ljunga–Boxa, wybór modelu ARIMA w stats::arima, prognoza kontrfaktyczna i regresja segmentowa z kodem R.
Czytaj →PoradnikQuasi-eksperyment i różnica w różnicach (DiD)
Ocena programu bez losowania: równoległe trendy, regresja z interakcją, błędy klastrowane, model zdarzeń, test placebo, zagrożenia trafności i kod R.
Czytaj →PoradnikModele cross-lagged: logika, założenia i interpretacja CLPM oraz RI-CLPM
Jak odróżnić stabilne różnice między osobami od zmiany wewnątrzosobowej, dobrać model panelowy i nie pomylić predykcji czasowej z przyczynowością.
Czytaj →PoradnikANOVA z powtarzanymi pomiarami czy model mieszany?
Ten sam przykład 2 × 4 w afex i lmerTest, symulacja odpadania MAR, struktura efektów losowych, stopnie swobody, R² i gotowy opis do artykułu.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Durbin, J., & Watson, G. S. (1950). Testing for serial correlation in least squares regression. I. Biometrika, 37(3–4), 409–428. https://doi.org/10.1093/biomet/37.3-4.409
- Huitema, B. E., & McKean, J. W. (1991). Autocorrelation estimation and inference with small samples. Psychological Bulletin, 110(2), 291–304. https://doi.org/10.1037/0033-2909.110.2.291
- Jebb, A. T., Tay, L., Wang, W., & Huang, Q. (2015). Time series analysis for psychological research: Examining and forecasting change. Frontiers in Psychology, 6, Article 727. https://doi.org/10.3389/fpsyg.2015.00727 ● Otwarty dostęp
Cytowania BibTeX
@article{durbin1950testing, author={Durbin, J. and Watson, G. S.}, title={{Testing for serial correlation in least squares regression. I}}, journal={Biometrika}, year={1950}, volume={37}, number={3–4}, pages={409--428}, doi={10.1093/biomet/37.3-4.409}}@article{huitema1991autocorrelation, author={Huitema, Bradley E. and McKean, Joseph W.}, title={{Autocorrelation estimation and inference with small samples}}, journal={Psychological Bulletin}, year={1991}, volume={110}, number={2}, pages={291--304}, doi={10.1037/0033-2909.110.2.291}}@article{jebb2015time, author={Jebb, Andrew T. and Tay, Louis and Wang, Wei and Huang, Qiming}, title={{Time series analysis for psychological research: Examining and forecasting change}}, journal={Frontiers in Psychology}, year={2015}, volume={6}, eid={727}, doi={10.3389/fpsyg.2015.00727}}