Dlaczego nie reguła kciuka
„Do SEM potrzeba co najmniej 200 osób”, „10 osób na parametr” – recenzenci i promotorzy wciąż przytaczają takie reguły, choć nie mają one oparcia w badaniach. Muthén i Muthén (2002) piszą wprost, że żadna reguła nie pasuje do wszystkich sytuacji. Potrzebna liczebność zależy od wielkości modelu, rozkładu zmiennych, braków danych, rzetelności wskaźników i siły związków. Wolf i in. (2013) w symulacjach typowych modeli uzyskali wymagania od 30 do 460 osób. Ogólne zasady uzasadniania liczebności omawia wpis dobór liczebności próby.
Warto też odróżnić dwa pytania o moc. Pierwsze dotyczy dopasowania całego modelu. Odpowiada na nie analiza mocy oparta na RMSEA (MacCallum i in., 1996), którą z tabelą liczebności pokazujemy we wpisie CB-SEM – założenia i interpretacja. Drugie pytanie dotyczy konkretnego parametru, np. ścieżki między dwiema zmiennymi latentnymi. Wang i Rhemtulla (2021) zauważają, że tej drugiej analizy w praktyce zwykle brakuje, a to właśnie ścieżki są hipotezami artykułu. Jobst i in. (2023) pokazują analizy mocy dla obu rodzajów hipotez. Ten wpis dotyczy drugiego pytania i rozwiązuje je symulacją Monte Carlo w pakiecie lavaan (Rosseel, 2012). Jeśli dopiero zaczynasz pracę z lavaan, zacznij od wpisu CB-SEM w R (lavaan), a mapę wszystkich tematów SEM znajdziesz w przewodniku po modelowaniu SEM.
Symulacja Monte Carlo w pięciu krokach
- Model populacyjny. Zapisujesz model z konkretnymi liczbami: ładunkami, ścieżkami, wariancjami. To Twoje założenia o świecie.
- Losowanie danych. Funkcja
simulateData()losuje próbę o zadanej liczebności z tego modelu. - Dopasowanie modelu analitycznego. Na wylosowanych danych szacujesz model, który zamierzasz dopasować w badaniu, z parametrami swobodnymi.
- Powtórzenia. Kroki 2–3 powtarzasz setki razy dla kilku liczebności i zapisujesz, czy model się zbiegł, czy rozwiązanie jest właściwe i jakie jest p dla testowanej ścieżki.
- Podsumowanie. Moc to odsetek replikacji z p < .05, czyli dopełnienie prawdopodobieństwa błędu II rodzaju. Szukasz najmniejszej liczebności, przy której przekracza ona zaplanowany poziom, np. .80.
Ten sam schemat działa dla każdego modelu: z interakcją, wielogrupowego czy z danymi porządkowymi (zob. kategorialna CFA z WLSMV). Zmienia się tylko model populacyjny i sposób estymacji.
Przykład: model populacyjny
Planujesz badanie pacjentów z chorobą przewlekłą. Hipoteza dotyczy modelu z trzema czynnikami: kompetencje zdrowotne (KZ, 4 wskaźniki) zwiększają poczucie skuteczności w leczeniu (SK, 4 wskaźniki), a ono wiąże się z przestrzeganiem zaleceń (PZ, 3 wskaźniki). Kluczowa hipoteza H2 dotyczy ścieżki SK → PZ. Na podstawie literatury przyjmujesz standaryzowane wartości:
| Parametr | Wartość | Uzasadnienie w planie |
|---|---|---|
| Ładunki wszystkich wskaźników | .70 (scenariusz ostrożny: .50) | publikacje o skalach; ładunki w nowej próbie bywają niższe |
| a: KZ → SK | .40 | wcześniejsze badania |
| b: SK → PZ (hipoteza H2) | .25 | najmniejszy efekt istotny praktycznie |
| c: KZ → PZ (efekt bezpośredni) | .10 | mały efekt, nie jest hipotezą główną |
| Braki danych | 0% (scenariusz: 20% MCAR) | doświadczenie z podobnych badań |
Wielkość ścieżki b to najważniejsza decyzja. Najlepiej przyjąć najmniejszy interesujący efekt, a nie efekt z jednego opublikowanego badania, który bywa zawyżony. W kodzie model populacyjny zapisujemy w metryce standaryzowanej. Wariancje czynników i wskaźników wynoszą 1, a wariancje reszt wyliczamy z ładunków i ścieżek. Dzięki temu ładunki i ścieżki można czytać jak wartości standaryzowane.
Jedna próba to za mało
Zanim uruchomisz pętlę, wylosuj jedną próbę i sprawdź, czy model się dopasowuje i daje sensowne oszacowania. W przykładzie (N = 300, ładunki .70) model pasował dobrze, χ²(41) = 40.07, p = .512, CFI = 1.000, RMSEA = .000, SRMR = .037. Ścieżka b wyniosła β = .30 (p < .001), ale ścieżka c, której prawdziwa wartość to .10, została oszacowana na 0.00 (p = 1.000). Jedna próba może więc nie trafić w efekt, który istnieje. Dlatego moc szacuje się z setek replikacji, a nie z jednego losowania.
Pętla Monte Carlo
Funkcja jedna_replikacja() w drugim przepisie losuje dane, w razie potrzeby wprowadza braki i dopasowuje model. Zapisuje, czy model się zbiegł, czy rozwiązanie jest właściwe (np. bez ujemnych wariancji, czyli przypadku Heywooda), oraz oszacowanie, błąd standardowy i p dla ścieżek b i c oraz efektu pośredniego a × b. Model szacujemy metodą największej wiarygodności, a przy brakach (MCAR) jej wersją FIML (missing = "ml"). W symulacjach Endersa i Bandalos (2001) ta metoda dawała nieobciążone oszacowania przy brakach MCAR i MAR i najmniej problemów ze zbieżnością.
Siatka obejmuje sześć liczebności (100–500) i trzy scenariusze, po 250 replikacji na warunek, łącznie 4500 dopasowanych modeli. Cała symulacja trwała u nas 6.9 min. Warunki liczą się równolegle na czterech rdzeniach (parallel::mclapply()), a każdy ma własne ziarno, więc wynik nie zależy od liczby rdzeni. Żeby przyspieszyć obliczenia, wyłączyliśmy test dopasowania i model bazowy (test = "none", baseline = FALSE, h1 = FALSE). Do mocy dla ścieżki nie są potrzebne.
Wyniki: krzywa mocy
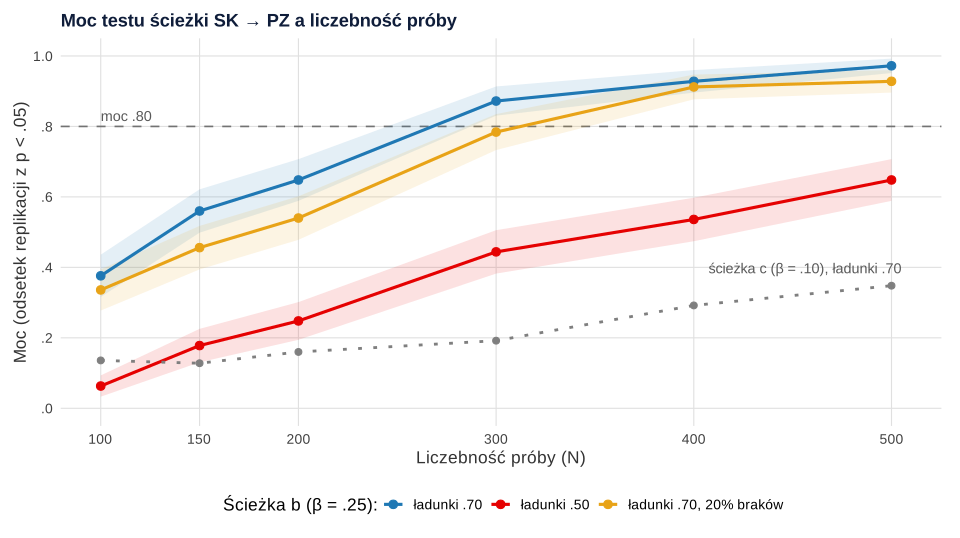
Tabela zbiera moc dla ścieżki b, czyli odsetek replikacji z p < .05, w trzech scenariuszach. Pogrubiona jest pierwsza liczebność, przy której moc przekracza .80.
| N | Ładunki .70 | Ładunki .50 | Ładunki .70, 20% braków | Efekt pośredni a × b, ładunki .70 |
|---|---|---|---|---|
| 100 | .38 | .06 | .34 | .19 |
| 150 | .56 | .18 | .46 | .37 |
| 200 | .65 | .25 | .54 | .58 |
| 300 | .87 | .44 | .78 | .84 |
| 400 | .93 | .54 | .91 | .91 |
| 500 | .97 | .65 | .93 | .96 |
Wnioski z symulacji:
- Scenariusz podstawowy. Przy ładunkach .70 moc .80 dla ścieżki b osiągamy między 200 a 300 osobami. W siatce pierwszą liczebnością z mocą powyżej .80 jest N = 300 (moc .87).
- Jakość pomiaru waży więcej niż reguła kciuka. Ta sama ścieżka przy ładunkach .50 ma przy 300 osobach moc .44, a przy 500 tylko .65. Słabszy pomiar osłabia związek obserwowanych wskaźników i zwiększa niepewność oszacowania. Gdy spodziewasz się słabszych ładunków, liczebność może wzrosnąć wielokrotnie, a nie o kilka procent.
- Braki danych kosztują. Przy 20% braków w każdym wskaźniku i estymacji FIML moc przy 300 osobach spadła do .78, a próg .80 przekroczyła dopiero liczebność 400.
- Małe ścieżki są poza zasięgiem. Ścieżka c (β = .10) przy 500 osobach ma moc tylko .35. Jeśli to ona jest hipotezą, potrzebujesz znacznie większej próby albo innego planu badania.
Błąd Monte Carlo oszacowania mocy przy 250 replikacjach i mocy .80 wynosi .025 (pasma na rysunku 1). Między 200 a 300 osobami krzywa rośnie szybko, więc do ostatecznej decyzji warto powtórzyć symulację z 1000 replikacji dla liczebności 220, 240, 260 i 280.
Zbieżność, rozwiązania niewłaściwe i obciążenie
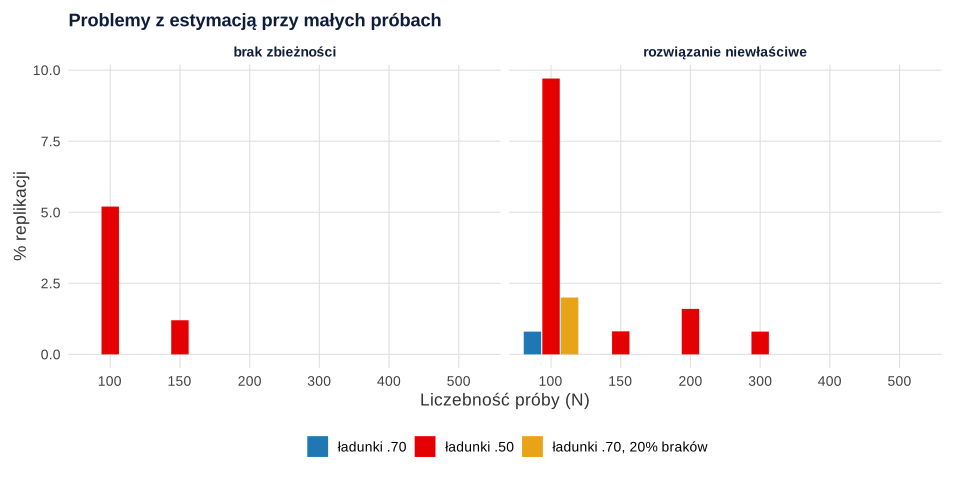
Moc to nie jedyny powód, by zwiększyć próbę. Przy małych liczebnościach model może się nie zbiec albo dać rozwiązanie niewłaściwe, np. ujemną wariancję reszty. Wolf i in. (2013) liczyli wymaganą liczebność także ze względu na obciążenie oszacowań i dopuszczalność rozwiązań, a nie tylko moc. W przykładzie przy ładunkach .70 problemy praktycznie nie występowały. Przy ładunkach .50 i 100 osobach nie zbiegło się 5.2% modeli, a 9.7% zbieżnych dało rozwiązanie niewłaściwe. Marsh i in. (1998) pokazali w symulacjach, że więcej wskaźników na czynnik zmniejsza odsetek rozwiązań niewłaściwych i częściowo kompensuje mniejszą próbę.
Warto też sprawdzić, czy estymator działa dobrze przy planowanej liczebności. Średnia standaryzowana ścieżka b we wszystkich warunkach wynosiła od .244 do .262, czyli blisko prawdziwej wartości .25. Stosunek średniego błędu standardowego do odchylenia standardowego oszacowań mieścił się między 0.85 a 1.05. Wartości wyraźnie poniżej 1 oznaczają, że błędy standardowe są zaniżone, a test zbyt liberalny. Najniższe wartości (0.85–0.90) pojawiały się głównie przy ładunkach .50. Przy 250 replikacjach ten stosunek też ma błąd losowy, więc traktuj go orientacyjnie.
Jak opisać symulację we wniosku lub artykule
Recenzent musi móc odtworzyć symulację, więc opis podaje wszystkie założenia: model, wartości parametrów i ich źródło, scenariusze, liczbę replikacji, kryterium mocy, estymator i postępowanie z brakami. Kod dołącz do materiałów uzupełniających albo do prerejestracji (zob. plan analizy statystycznej i prerejestracja).
Jeśli Twój model jest bardziej złożony, np. z interakcją zmiennych latentnych albo z wieloma grupami, możemy pomóc przygotować model populacyjny i symulację w ramach wsparcia statystycznego dla badaczy.
Przykład w R
Dwa przepisy uruchamiane po kolei w jednej sesji. Pierwszy definiuje model populacyjny i analityczny oraz dopasowuje model do jednej wylosowanej próby. Drugi to pętla Monte Carlo. Zapisuje wyniki do pliku b198-wyniki-symulacji.csv, z którego powstały rysunki. Wystarczy pakiet lavaan. Drugi przepis trwał 6.9 min; żeby najpierw sprawdzić kod, ustaw R <- 20.
1. Model populacyjny i jedna próba
R
# Krok 1: model populacyjny i jedno „badanie” z niego (dane symulowane)
# Kompetencje zdrowotne (KZ) → poczucie skuteczności (SK) → przestrzeganie zaleceń (PZ); KZ → PZ to ścieżka bezpośrednia
suppressPackageStartupMessages(library(lavaan))

# Model populacyjny w metryce standaryzowanej: wariancje czynników i wskaźników = 1,
# więc ładunki i ścieżki można czytać jak wartości standaryzowane
model_populacyjny <- function(ladunek = 0.70, a = 0.40, b = 0.25, c = 0.10) {
  e   <- 1 - ladunek^2                         # wariancja reszty wskaźnika
  rSK <- 1 - a^2                               # wariancja reszty SK
  rPZ <- 1 - (b^2 + c^2 + 2 * b * c * a)       # wariancja reszty PZ
  wsk <- list(KZ = paste0("kz", 1:4), SK = paste0("sk", 1:4), PZ = paste0("pz", 1:3))
  pomiar <- sapply(names(wsk), function(f) paste0(f, " =~ ", paste0(ladunek, "*", wsk[[f]], collapse = " + ")))
  reszty <- paste0(unlist(wsk), " ~~ ", e, "*", unlist(wsk))
  paste(c(pomiar,
          paste0("SK ~ ", a, "*KZ"),
          paste0("PZ ~ ", b, "*SK + ", c, "*KZ"),
          "KZ ~~ 1*KZ", paste0("SK ~~ ", rSK, "*SK"), paste0("PZ ~~ ", rPZ, "*PZ"),
          reszty), collapse = "\n")
}

# Model analityczny: ten sam układ, ale wszystkie parametry swobodne
model_analizy <- '
  KZ =~ kz1 + kz2 + kz3 + kz4
  SK =~ sk1 + sk2 + sk3 + sk4
  PZ =~ pz1 + pz2 + pz3
  SK ~ a*KZ
  PZ ~ b*SK + c*KZ
  posredni := a*b
'

set.seed(1980)
dane <- simulateData(model_populacyjny(ladunek = 0.70), sample.nobs = 300)
fit <- sem(model_analizy, data = dane)
lavInspect(fit, "converged")
round(fitMeasures(fit, c("chisq", "df", "pvalue", "cfi", "rmsea", "srmr")), 3)
wynik <- subset(parameterEstimates(fit, standardized = TRUE), label %in% c("a", "b", "c", "posredni"))
print(cbind(wynik[, c("lhs", "op", "rhs", "label")], round(wynik[, c("est", "se", "pvalue", "std.all")], 3)), row.names = FALSE)
Wynik w R
[1] TRUE
 chisq     df pvalue    cfi  rmsea   srmr
40.065 41.000  0.512  1.000  0.000  0.037
      lhs op rhs    label   est    se pvalue std.all
       SK  ~  KZ        a 0.434 0.078  0.000   0.422
       PZ  ~  SK        b 0.308 0.087  0.000   0.302
       PZ  ~  KZ        c 0.000 0.084  1.000   0.000
 posredni := a*b posredni 0.134 0.043  0.002   0.128
2. Symulacja Monte Carlo
R
# Krok 2: symulacja Monte Carlo – moc, zbieżność i rozwiązania niewłaściwe dla kilku liczebności
# Wymaga obiektów z kroku 1 (model_populacyjny, model_analizy)
suppressPackageStartupMessages(library(lavaan))
library(parallel)

jedna_replikacja <- function(n, ladunek, braki = 0) {
  d <- simulateData(model_populacyjny(ladunek = ladunek), sample.nobs = n)
  if (braki > 0) d[matrix(runif(n * ncol(d)) < braki, n)] <- NA          # braki MCAR w każdym wskaźniku
  fit <- tryCatch(suppressWarnings(sem(model_analizy, data = d, missing = if (braki > 0) "ml" else "listwise",
                                       test = "none", baseline = FALSE, h1 = FALSE)),
                  error = function(e) NULL)
  if (is.null(fit) || !lavInspect(fit, "converged")) return(c(zbiezny = 0, wlasciwy = NA, est_b = NA, se_b = NA,
                                                              p_b = NA, std_b = NA, p_c = NA, p_ind = NA))
  pe <- parameterEstimates(fit, standardized = TRUE)
  w <- function(lab, kol) pe[pe$label == lab, kol]
  c(zbiezny = 1, wlasciwy = as.numeric(suppressWarnings(lavInspect(fit, "post.check"))),
    est_b = w("b", "est"), se_b = w("b", "se"), p_b = w("b", "pvalue"), std_b = w("b", "std.all"),
    p_c = w("c", "pvalue"), p_ind = w("posredni", "pvalue"))
}

warunki <- expand.grid(n = c(100, 150, 200, 300, 400, 500),
                       scenariusz = c("ładunki .70", "ładunki .50", "ładunki .70, 20% braków"),
                       stringsAsFactors = FALSE)
warunki$ladunek <- ifelse(grepl("\\.50", warunki$scenariusz), 0.50, 0.70)
warunki$braki <- ifelse(grepl("braków", warunki$scenariusz), 0.20, 0)
R <- 250                                       # liczba replikacji na warunek

rdzenie <- if (.Platform$OS.type == "windows") 1 else 4   # mclapply działa równolegle tylko na macOS i Linuksie
start <- Sys.time()
wyniki <- do.call(rbind, mclapply(seq_len(nrow(warunki)), function(i) {
  set.seed(19800 + i)                          # własne ziarno dla warunku: wynik nie zależy od liczby rdzeni
  sym <- t(replicate(R, jedna_replikacja(warunki$n[i], warunki$ladunek[i], warunki$braki[i])))
  ok <- sym[, "zbiezny"] == 1
  data.frame(scenariusz = warunki$scenariusz[i], n = warunki$n[i],
             zbieznosc = mean(ok), niewlasciwe = mean(sym[ok, "wlasciwy"] == 0),
             moc_b = mean(sym[ok, "p_b"] < .05), moc_c = mean(sym[ok, "p_c"] < .05),
             moc_posredni = mean(sym[ok, "p_ind"] < .05),
             sr_std_b = mean(sym[ok, "std_b"], na.rm = TRUE),
             se_do_sd = mean(sym[ok, "se_b"]) / sd(sym[ok, "est_b"]))
}, mc.cores = rdzenie))
czas <- difftime(Sys.time(), start, units = "mins")

print(cbind(wyniki[1:2], round(wyniki[-(1:2)], 3)), row.names = FALSE)
# Błąd Monte Carlo oszacowania mocy przy R = 250 replikacjach i mocy około .80
round(sqrt(.80 * .20 / R), 3)
# Najmniejsza liczebność z siatki, przy której moc dla ścieżki b osiąga .80
sapply(split(wyniki, wyniki$scenariusz), function(w) if (any(w$moc_b >= .80)) min(w$n[w$moc_b >= .80]) else NA)
cat("Liczba dopasowanych modeli:", R * nrow(warunki), "\n")
cat("Czas symulacji (min):", round(as.numeric(czas), 1), "\n")
write.csv(wyniki, "b198-wyniki-symulacji.csv", row.names = FALSE)
Wynik w R
              scenariusz   n zbieznosc niewlasciwe moc_b moc_c moc_posredni sr_std_b se_do_sd
             ładunki .70 100     1.000       0.008 0.376 0.136        0.188    0.244    0.898
             ładunki .70 150     1.000       0.000 0.560 0.128        0.368    0.246    1.034
             ładunki .70 200     1.000       0.000 0.648 0.160        0.584    0.252    1.014
             ładunki .70 300     1.000       0.000 0.872 0.192        0.844    0.262    1.029
             ładunki .70 400     1.000       0.000 0.928 0.292        0.912    0.250    1.002
             ładunki .70 500     1.000       0.000 0.972 0.348        0.964    0.244    1.051
             ładunki .50 100     0.948       0.097 0.063 0.025        0.000    0.251    0.897
             ładunki .50 150     0.988       0.008 0.178 0.061        0.008    0.260    0.881
             ładunki .50 200     1.000       0.016 0.248 0.052        0.048    0.246    0.921
             ładunki .50 300     1.000       0.008 0.444 0.116        0.276    0.252    0.906
             ładunki .50 400     1.000       0.000 0.536 0.172        0.428    0.245    0.852
             ładunki .50 500     1.000       0.000 0.648 0.176        0.588    0.248    0.969
 ładunki .70, 20% braków 100     1.000       0.020 0.336 0.060        0.088    0.260    0.963
 ładunki .70, 20% braków 150     1.000       0.000 0.456 0.104        0.264    0.246    0.968
 ładunki .70, 20% braków 200     1.000       0.000 0.540 0.128        0.444    0.257    0.861
 ładunki .70, 20% braków 300     1.000       0.000 0.784 0.144        0.708    0.251    0.996
 ładunki .70, 20% braków 400     1.000       0.000 0.912 0.216        0.888    0.258    1.019
 ładunki .70, 20% braków 500     1.000       0.000 0.928 0.264        0.924    0.250    0.921
[1] 0.025
            ładunki .50             ładunki .70 ładunki .70, 20% braków
                     NA                     300                     400
Liczba dopasowanych modeli: 4500
Czas symulacji (min): 6.9
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietem lavaan 0.7.2 (funkcje simulateData(), sem(), lavInspect()); rysunki przygotowano w pakiecie ggplot2 4.0.2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7.2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Efekt z jednego badania jako wartość populacyjna. Opublikowane efekty bywają zawyżone. Wybierz najmniejszy interesujący efekt albo policz scenariusz ostrożny.
- Ładunki „idealne”. Założenie ładunków .80, gdy skala w nowej próbie ma .55, daje zbyt małą próbę. Słabszy pomiar podnosi wymaganą liczebność, a więcej dobrych wskaźników na czynnik ją obniża (Marsh i in., 1998).
- Moc dla dopasowania zamiast dla hipotezy. Analiza mocy RMSEA nie mówi, czy wykryjesz ścieżkę z hipotezy.
- Pominięte braki danych. Przy 20% braków moc spada. Uwzględnij braki w symulacji i dolicz osoby, które mogą zrezygnować.
- Moc dla efektu pośredniego z testu Sobela. Do planowania mocy w mediacji zaleca się test oparty na przedziale bootstrapowym albo Monte Carlo (Schoemann i in., 2017). Nasz test oparty na metodzie delta to tylko szybkie przybliżenie, a w samej analizie użyj bootstrapu w SEM (zob. mediacja równoległa i szeregowa).
- Brak opisu założeń. Sama liczba „N = 300 na podstawie symulacji” nic nie mówi. Podaj model, wartości, scenariusze i liczbę replikacji.
Najczęstsze pytania
Ile osób potrzeba do modelu SEM?
Nie ma jednej liczby. Wolf i in. (2013) w symulacjach typowych modeli uzyskali wymagania od 30 do 460 osób. W przykładzie z tego wpisu ta sama ścieżka (β = .25) wymagała innej liczebności przy ładunkach .70 i .50. Policz liczebność dla swojego modelu i parametru, który testujesz.
Jak zrobić analizę mocy dla SEM w R?
Zapisz model populacyjny z liczbami w lavaan, losuj z niego dane funkcją simulateData() dla kilku liczebności, dopasuj model analityczny funkcją sem() i policz odsetek replikacji z p < .05 dla wybranej ścieżki. Pętlę i gotowy kod znajdziesz w sekcji z przykładem w R.
Skąd wziąć wartości parametrów do symulacji Monte Carlo?
Z wcześniejszych badań, metaanaliz albo pilotażu, a ładunki z publikacji o skalach, których użyjesz. Wielkość ścieżki ustal raczej jako najmniejszy efekt, który ma dla Ciebie znaczenie, niż jako efekt z jednego badania. Gdy wartości są niepewne, policz kilka scenariuszy i wybierz liczebność dla bardziej ostrożnego.
Ile replikacji potrzeba w symulacji mocy?
Błąd Monte Carlo oszacowania mocy to √(moc × (1 − moc) / R). Przy 250 replikacjach i mocy .80 wynosi około .025, co wystarcza do krzywej mocy. Dla ostatecznej liczebności powtórz symulację z 1000 lub więcej replikacji tylko dla kilku liczebności wokół progu.
Czym różni się moc dla ścieżki od mocy testu dopasowania RMSEA?
Analiza mocy oparta na RMSEA dotyczy dopasowania całego modelu. Moc dla ścieżki dotyczy hipotezy o jednym parametrze, np. związku dwóch zmiennych latentnych. Wang i Rhemtulla (2021) podkreślają, że to dwa różne pytania, a w artykule zwykle testujesz właśnie ścieżki.
Powiązane hasła
Przeczytaj też
CB-SEM – założenia i interpretacja
Identyfikacja, ML, MLR i WLSMV, test χ² i indeksy dopasowania bez magicznych progów, moc, modele równoważne i raport – z symulacjami w R.
Czytaj →PoradnikDobór liczebności próby
Analiza mocy a priori, SESOI i test równoważności, precyzja przedziału ufności, analiza wrażliwości i pułapka pilotażu – z obliczeniami w R.
Czytaj →PoradnikCB-SEM w R (lavaan)
Kompletny przykład w lavaan 0.7 na danych do pobrania: CFA z MLR i FIML, dopasowanie, omega i AVE, efekt pośredni z bootstrapem i tabela APA.
Czytaj →Potrzebujesz uzasadnić liczebność próby do modelu SEM we wniosku lub artykule?
Pomożemy przełożyć hipotezy na model populacyjny, przygotować i uruchomić symulację oraz opisać założenia tak, żebyś mógł(a) samodzielnie obronić liczebność przed recenzentem.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Enders, C. K., & Bandalos, D. L. (2001). The relative performance of full information maximum likelihood estimation for missing data in structural equation models. Structural Equation Modeling: A Multidisciplinary Journal, 8(3), 430–457. https://doi.org/10.1207/s15328007sem0803_5
- Jobst, L. J., Bader, M., & Moshagen, M. (2023). A tutorial on assessing statistical power and determining sample size for structural equation models. Psychological Methods, 28(1), 207–221. https://doi.org/10.1037/met0000423
- MacCallum, R. C., Browne, M. W., & Sugawara, H. M. (1996). Power analysis and determination of sample size for covariance structure modeling. Psychological Methods, 1(2), 130–149. https://doi.org/10.1037/1082-989X.1.2.130
- Marsh, H. W., Hau, K.-T., Balla, J. R., & Grayson, D. (1998). Is more ever too much? The number of indicators per factor in confirmatory factor analysis. Multivariate Behavioral Research, 33(2), 181–220. https://doi.org/10.1207/s15327906mbr3302_1
- Muthén, L. K., & Muthén, B. O. (2002). How to use a Monte Carlo study to decide on sample size and determine power. Structural Equation Modeling: A Multidisciplinary Journal, 9(4), 599–620. https://doi.org/10.1207/s15328007sem0904_8
- Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2). https://doi.org/10.18637/jss.v048.i02 ● Otwarty dostęp
- Schoemann, A. M., Boulton, A. J., & Short, S. D. (2017). Determining power and sample size for simple and complex mediation models. Social Psychological and Personality Science, 8(4), 379–386. https://doi.org/10.1177/1948550617715068
- Wang, Y. A., & Rhemtulla, M. (2021). Power analysis for parameter estimation in structural equation modeling: A discussion and tutorial. Advances in Methods and Practices in Psychological Science, 4(1), Article 2515245920918253. https://doi.org/10.1177/2515245920918253 ● Otwarty dostęp
- Wolf, E. J., Harrington, K. M., Clark, S. L., & Miller, M. W. (2013). Sample size requirements for structural equation models: An evaluation of power, bias, and solution propriety. Educational and Psychological Measurement, 73(6), 913–934. https://doi.org/10.1177/0013164413495237 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{enders2001relative, author={Enders, Craig K. and Bandalos, Deborah L.}, title={{The relative performance of full information maximum likelihood estimation for missing data in structural equation models}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2001}, volume={8}, number={3}, pages={430--457}, doi={10.1207/s15328007sem0803_5}}@article{jobst2023tutorial, author={Jobst, Lisa J. and Bader, Martina and Moshagen, Morten}, title={{A tutorial on assessing statistical power and determining sample size for structural equation models}}, journal={Psychological Methods}, year={2023}, volume={28}, number={1}, pages={207--221}, doi={10.1037/met0000423}}@article{maccallum1996power, author={MacCallum, Robert C. and Browne, Michael W. and Sugawara, Hazuki M.}, title={{Power analysis and determination of sample size for covariance structure modeling}}, journal={Psychological Methods}, year={1996}, volume={1}, number={2}, pages={130--149}, doi={10.1037/1082-989x.1.2.130}}@article{marsh1998more, author={Marsh, Herbert W. and Hau, Kit-Tai and Balla, John R. and Grayson, David}, title={{Is more ever too much? The number of indicators per factor in confirmatory factor analysis}}, journal={Multivariate Behavioral Research}, year={1998}, volume={33}, number={2}, pages={181--220}, doi={10.1207/s15327906mbr3302_1}}@article{muthen2002how, author={Muthén, Linda K. and Muthén, Bengt O.}, title={{How to use a Monte Carlo study to decide on sample size and determine power}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2002}, volume={9}, number={4}, pages={599--620}, doi={10.1207/s15328007sem0904_8}}@article{rosseel2012lavaan, author={Rosseel, Yves}, title={{lavaan: An R package for structural equation modeling}}, journal={Journal of Statistical Software}, year={2012}, volume={48}, number={2}, doi={10.18637/jss.v048.i02}}@article{schoemann2017determining, author={Schoemann, Alexander M. and Boulton, Aaron J. and Short, Stephen D.}, title={{Determining power and sample size for simple and complex mediation models}}, journal={Social Psychological and Personality Science}, year={2017}, volume={8}, number={4}, pages={379--386}, doi={10.1177/1948550617715068}}@article{wang2021power, author={Wang, Y. Andre and Rhemtulla, Mijke}, title={{Power analysis for parameter estimation in structural equation modeling: A discussion and tutorial}}, journal={Advances in Methods and Practices in Psychological Science}, year={2021}, volume={4}, number={1}, eid={2515245920918253}, doi={10.1177/2515245920918253}}@article{wolf2013sample, author={Wolf, Erika J. and Harrington, Kelly M. and Clark, Shaunna L. and Miller, Mark W.}, title={{Sample size requirements for structural equation models: An evaluation of power, bias, and solution propriety}}, journal={Educational and Psychological Measurement}, year={2013}, volume={73}, number={6}, pages={913--934}, doi={10.1177/0013164413495237}}