ordered, który włącza WLSMV. Przy skośnych pozycjach ML i MLR zaniżają ładunki, a przeskalowane (scaled) CFI i RMSEA z WLSMV są zbyt optymistyczne, dlatego raportuj wersje robust, rozkład odpowiedzi i decyzje o łączeniu rzadkich kategorii.Kiedy pozycje Likerta potraktować jako porządkowe
Odpowiedź „3” na skali Likerta nie jest liczbą zmierzoną na skali przedziałowej. To kategoria, którą osoba wybrała, bo jej natężenie cechy przekroczyło jakiś próg. Klasyczna konfirmacyjna analiza czynnikowa z estymatorem ML traktuje jednak odpowiedzi 1–5 jak dane ciągłe. Kategorialna CFA modeluje je wprost jako dane porządkowe: za każdą pozycją stoi ciągła skłonność y*, a model opisuje korelacje polichoryczne tych skłonności.
Decyzja nie musi być ideologiczna. Rhemtulla, Brosseau-Liard i Savalei (2012) porównali w symulacji odporny ML z kategorialną metodą najmniejszych kwadratów. Metoda kategorialna dokładniej szacowała ładunki, zwłaszcza przy mniej niż 5 kategoriach. Przy 5 i więcej kategoriach, małej próbie i w przybliżeniu symetrycznych progach ML wypadał równie dobrze. Li (2016) w modelu dwuczynnikowym stwierdził, że WLSMV szacował ładunki z mniejszym obciążeniem niż MLR niemal we wszystkich warunkach. W małych próbach i przy nienormalnych rozkładach ukrytych zawyżał jednak umiarkowanie korelacje czynników. Przy dwóch i trzech kategoriach przewaga WLSMV jest wyraźna także w teście χ² (Beauducel i Herzberg, 2006).
Przed wyborem estymatora sprawdź więc cztery rzeczy:
- liczbę kategorii – im mniej, tym silniejszy argument za podejściem porządkowym;
- rozkład odpowiedzi – skośność i efekt podłogi lub sufitu oznaczają asymetryczne progi, przy których ML zaniża ładunki;
- liczebność kategorii – odpowiedzi wybierane przez kilka osób dają niestabilne progi;
- braki danych – WLSMV korzysta z par dostępnych obserwacji, a MLR z FIML lepiej znosi braki typu MAR.
Sam estymator opisujemy w haśle WLSMV. Tu pokazujemy pełną analizę jednej skali: od rozkładów, przez progi i trzy estymatory, po łączenie kategorii i opis do artykułu. Spór o to, czy odpowiedzi Likerta wolno uśredniać, omawia wpis czy skala Likerta jest ilościowa.
Przykład: dwuczynnikowa skala lęku społecznego
Czterysta osób dorosłych (dane symulowane) odpowiedziało na 10 pozycji ocenianych od 1 („zupełnie nieprawdziwe”) do 5 („całkowicie prawdziwe”). Pięć pozycji mierzy zamartwianie się oceną innych (ZO, z1–z5), pięć – unikanie sytuacji społecznych (US, u1–u5). Dane wygenerowano z modelu o znanych ładunkach od .55 do .80 i korelacji czynników .50. Dodaliśmy jedną niemodelowaną kowariancję reszt (z4 i z5 mają podobne sformułowania), więc model dwuczynnikowy jest lekko błędny, jak zwykle w praktyce.
Rozkłady są prawoskośne, jak w większości skal objawowych w próbach nieklinicznych. Najniższą odpowiedź wybrało od 134 osób (z4, 33.5%) do 249 osób (u5, 62.2%). Skośność wynosi od 0.69 do 1.54. Odpowiedź „5” jest rzadka: przy z3 wybrały ją 2 osoby, przy u2 i u5 – po 3, przy u4 – 4. Pięć kategorii to dokładnie granica, przy której według Rhemtulli i in. (2012) ML bywa wystarczający, ale tylko przy symetrycznych progach. Tu progi są wyraźnie asymetryczne.
WLSMV w lavaan: co zmienia argument ordered
W pakiecie lavaan (Rosseel, 2012) wystarczy wskazać pozycje porządkowe: cfa(model, data = dane, ordered = names(dane)). Program wybiera wtedy domyślnie WLSMV. Najpierw szacuje progi i macierz korelacji polichorycznych, potem dopasowuje do niej model metodą DWLS i koryguje statystykę χ² oraz błędy standardowe. Flora i Curran (2004) pokazali, że takie odporne podejście sprawdzało się we wszystkich badanych warunkach, a pełny WLS – tylko w największej próbie. Sama opcja estimator = "WLSMV" bez ordered nie wystarcza: model zostanie policzony na zwykłych korelacjach.
W wydruku pojawiają się trzy nowe elementy: progi zamiast wyrazów wolnych, dwie kolumny statystyk (Standard i Scaled) oraz wiersz Robust przy CFI, TLI i RMSEA. Każdy z nich trzeba umieć przeczytać.
Jak czytać progi
Pozycja z 5 kategoriami ma 4 progi (τ1–τ4, w lavaan t1–t4). Próg τk to punkt na standaryzowanej skali y*, powyżej którego osoba wybiera kategorię wyższą niż k. W modelu jednogrupowym próg jest po prostu kwantylem rozkładu normalnego dla skumulowanego odsetka odpowiedzi. Odpowiedź „1” przy z1 wybrało 160 osób, czyli 40.0% próby, więc τ1 = −0.253, bo tyle wynosi qnorm(.40). Kolumna qnorm w wyniku R potwierdza tę zgodność dla wszystkich 40 progów.
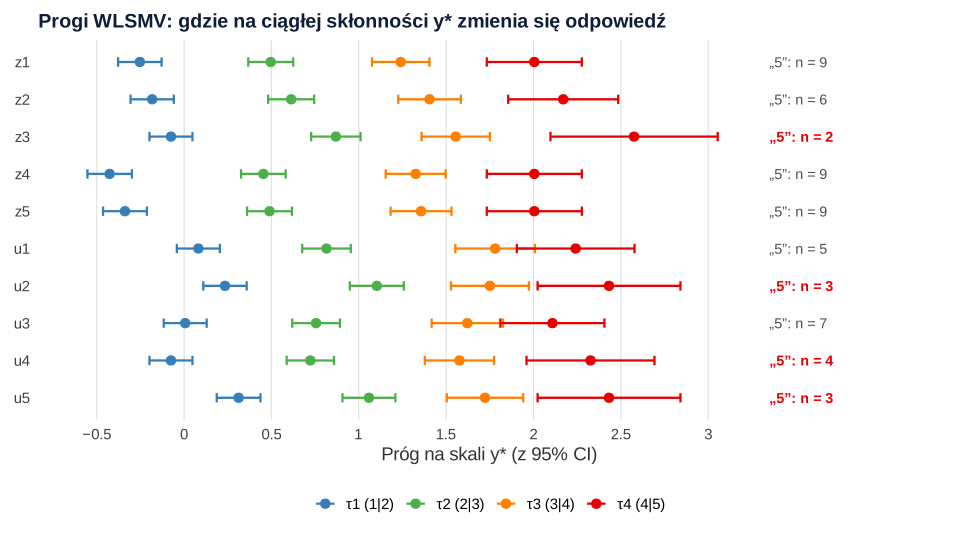
Z rysunku odczytasz dwie rzeczy. Po pierwsze, progi pozycji unikania leżą wyżej niż progi zamartwiania się. Wysoką odpowiedź na pozycje US wybierają tylko osoby z wysokim natężeniem cechy, podobnie jak przy „trudności” pozycji w teorii odpowiedzi na pozycje. Po drugie, rzadka kategoria daje próg wysunięty i niepewny. Czwarty próg z3 wynosi 2.576 (SE = 0.244), a z1 – 2.005 (SE = 0.139). W modelu jednogrupowym progów zwykle nie interpretuje się szczegółowo. Podaj rozkład odpowiedzi i sprawdź, czy któryś próg nie jest oparty na kilku osobach. Progi stają się kluczowe przy porównaniu grup. W kategorialnej analizie inwariancji pomiaru zastępują wyrazy wolne na etapie inwariancji skalarnej.
ML, MLR i WLSMV na tych samych danych
Ten sam model dwuczynnikowy dopasowaliśmy trzema estymatorami. ML i MLR traktują odpowiedzi 1–5 jak liczby. WLSMV traktuje je jako porządkowe. Ponieważ dane są symulowane, znamy prawdziwe ładunki i możemy sprawdzić, który estymator jest bliżej prawdy.
| Wynik | ML | MLR | WLSMV |
|---|---|---|---|
| χ²(34) | 63.40, p = .002 | 54.32, p = .015 | 58.16, p = .006 |
| CFI / TLI | .973 / .965 | .978 / .971 (robust) | .967 / .957 (robust); .986 / .981 (scaled) |
| RMSEA [90% CI] | .046 [.028, .064] | .042 [.019, .062] | .061 [.034, .086] (robust); .042 [.023, .060] (scaled) |
| SRMR | .037 | .037 | .044 |
| Ładunki standaryzowane | .572–.756 | .572–.756 | .618–.839 |
| Średni błąd ładunku (oszacowanie − prawda) | −0.043 | −0.043 | 0.013 |
| Korelacja ZO–US [95% CI] | .47 [.37, .57] | .47 [.36, .59] | .48 [.37, .58] |
Wnioski z tabeli są typowe dla skośnych pozycji pięciostopniowych:
- ML i MLR dają te same ładunki. MLR poprawia tylko błędy standardowe i statystykę testu. Nie jest „estymatorem dla danych porządkowych” i nie usuwa zaniżenia ładunków, które w ML wyniosło średnio 0.043.
- WLSMV jest bliżej prawdziwych ładunków (średni błąd 0.013). To zgodne z wynikami Li (2016) i Rhemtulli i in. (2012). Od ładunków zależą dalej rzetelność i AVE.
- Korelacja czynników prawie się nie zmienia (.47 a .48). Rhemtulla i in. (2012) także zauważyli, że ML ocenia korelacje czynników równie dobrze.
- Błędy standardowe MLR są większe niż ML, np. dla u5: 0.049 wobec 0.039. Zwykły ML przy skośnych danych jest więc zbyt optymistyczny co do precyzji.
Indeksy dopasowania: scaled czy robust
Najważniejsza różnica kryje się w kolumnie WLSMV. Przeskalowane (scaled) wersje CFI i RMSEA wskazują dopasowanie niemal wzorcowe: CFI = .986, RMSEA = .042. Odporne (robust) wersje z tego samego modelu dają CFI = .967 i RMSEA = .061, 90% CI [.034, .086]. Wiemy, że model pomija kowariancję reszt z4–z5, więc to druga para lepiej sygnalizuje rzeczywiste niedopasowanie.
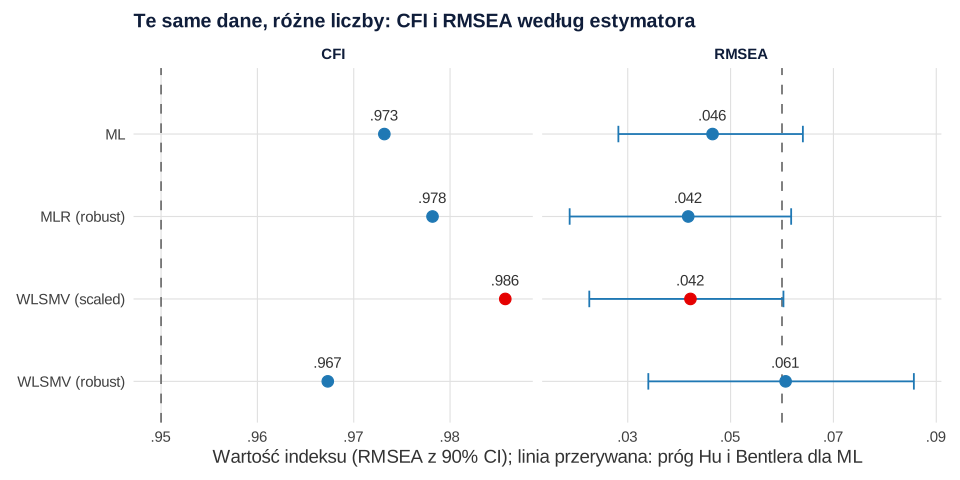
To nie przypadek tej próby. Xia i Yang (2019) wykazali, że DWLS daje mniejsze RMSEA oraz większe CFI i TLI niż ML dla tego samego modelu, niezależnie od tego, czy indeksy są skalowane. Stosowanie progów Hu i Bentlera (1999), wyznaczonych dla ML, sprzyja więc przeoczeniu niedopasowania. Savalei (2021) wyjaśniła źródło problemu i zaproponowała poprawione wzory dla DWLS. Według dokumentacji funkcji fitMeasures() lavaan podaje te nowsze wersje z przyrostkiem .robust i zaleca je, gdy są dostępne. Uwaga: przy niedodatnio określonej macierzy polichorycznej lavaan zwraca je jako NA.
W praktyce:
- raportuj CFI, TLI i RMSEA w wersji robust i napisz to wprost;
- progów opracowanych dla ML używaj ostrożnie, jako orientacji, a nie kryterium zero-jedynkowego;
- dodaj SRMR i obejrzyj lokalne niedopasowanie: reszty korelacji i kowariancje reszt sugerowane przez treść pozycji;
- modele zagnieżdżone porównuj testem różnicy χ² dla statystyk przeskalowanych (
lavTestLRT()), a nie odejmowaniem.
Przy MLR także masz dwie wersje: indeksy oparte na przeskalowanym χ² i nowsze wersje odporne w wierszu Robust. Raportuj te drugie. Logikę skalowania statystyki opisuje hasło skalowany χ² Satorry–Bentlera.
Rzadkie kategorie: łączyć czy nie
Kategoria wybrana przez 2–4 osoby to słaba podstawa do oszacowania progu i korelacji polichorycznych. DiStefano, Shi i Morgan (2021) zbadali w symulacji pięciostopniową skalę z nielicznymi odpowiedziami skrajnymi. Połączenie kategorii było korzystne dla WLSMV: dawało lepszą zbieżność, dokładniejsze parametry i błędy standardowe oraz odsetek odrzuceń testu χ² bliski nominalnemu. Przy co najmniej 5 kategoriach alternatywą może być potraktowanie danych jako ciągłych, zwłaszcza gdy rzadkie kategorie ma niewiele pozycji.
W przykładzie przyjęliśmy przed analizą prostą regułę: w pozycjach, w których „5” wybrało mniej niż 5 osób, łączymy „5” z „4”. Dotyczy to z3, u2, u4 i u5. Te pozycje mają po połączeniu 3 progi zamiast 4.
| Model WLSMV | χ²(34) | CFI (robust) | TLI (robust) | RMSEA (robust) [90% CI] | SRMR |
|---|---|---|---|---|---|
| 5 kategorii we wszystkich pozycjach | 58.16 | .967 | .957 | .061 [.034, .086] | .044 |
| „4” i „5” połączone w z3, u2, u4, u5 | 56.75 | .969 | .959 | .059 [.031, .084] | .043 |
Przy N = 400 zmiana jest niewielka: ładunki przesunęły się najwyżej o 0.005. Nie oznacza to, że łączenie nic nie daje. W mniejszej próbie albo w analizie wielogrupowej kategoria z dwiema odpowiedziami może w którejś grupie zniknąć, a wtedy model staje się niestabilny albo niemożliwy do oszacowania. Kilka zasad:
- ustal regułę łączenia przed analizą i nie zmieniaj jej po obejrzeniu dopasowania;
- łącz kategorie sąsiednie, zgodnie z treścią etykiet odpowiedzi;
- w porównaniach grup stosuj to samo kodowanie we wszystkich grupach;
- w raporcie podaj, które pozycje i kategorie połączono oraz dlaczego.
Problem rzadkich kategorii zaczyna się zwykle przy projektowaniu narzędzia. Liczbę odpowiedzi warto dobrać do populacji, o czym piszemy we wpisie ile stopni skali Likerta wybrać.
Jak opisać kategorialną CFA (APA)
W sekcji metod podaj estymator, program i uzasadnienie traktowania pozycji jako porządkowych (liczba kategorii, rozkład). Napisz, czy łączono kategorie, i podaj, którą wersję indeksów raportujesz. Jeśli porównujesz modele w tabeli, skorzystaj ze wzoru tabeli dopasowania modelu CFA.
Jeśli recenzent pyta, dlaczego indeksy WLSMV różnią się od tych z ML, odeślij do Xia i Yang (2019) i Savalei (2021). Taką odpowiedź możemy wspólnie przygotować w ramach wsparcia statystycznego dla badaczy. Kolejny krok walidacji, czyli AVE, rzetelność złożoną i HTMT, opisujemy we wpisie o trafności zbieżnej i różnicowej.
Przykład w R
Dwa przepisy uruchamiane po kolei w jednej sesji. Pierwszy tworzy dane i porównuje estymatory, drugi łączy rzadkie kategorie i liczy model końcowy. Potrzebne są pakiety lavaan i MASS.
1. Rozkłady, trzy estymatory i progi
R
# Dane symulowane: skala lęku społecznego (10 pozycji, 1–5: od „zupełnie nieprawdziwe” do „całkowicie prawdziwe”),
# dwa czynniki: zamartwianie się oceną (ZO, z1–z5) i unikanie sytuacji społecznych (US, u1–u5); N = 400
library(lavaan)
set.seed(1712)
N <- 400
lambda <- c(z1 = .75, z2 = .70, z3 = .80, z4 = .65, z5 = .60, u1 = .80, u2 = .70, u3 = .75, u4 = .65, u5 = .55)
fi <- .50                                       # prawdziwa korelacja czynników
eta <- MASS::mvrnorm(N, c(0, 0), matrix(c(1, fi, fi, 1), 2))
F <- cbind(eta[, rep(1, 5)], eta[, rep(2, 5)])
E <- matrix(rnorm(N * 10), N) %*% diag(sqrt(1 - lambda^2))
# niemodelowana kowariancja reszt z4–z5 (podobne sformułowania), żeby model nie był idealny
wsp <- rnorm(N); E[, 4] <- E[, 4] + .45 * wsp; E[, 5] <- E[, 5] + .45 * wsp
ystar <- F %*% diag(lambda) + E
# progi: efekt podłogi; u pozycji z3, u2 i u5 najwyższą odpowiedź wybiera tylko kilka osób
progi <- list(c(-0.2, 0.6, 1.4, 2.1), c(-0.1, 0.7, 1.5, 2.2), c(0.0, 0.9, 1.7, 2.6), c(-0.3, 0.5, 1.3, 2.0), c(-0.2, 0.6, 1.5, 2.2),
              c(0.1, 0.9, 1.7, 2.3), c(0.2, 1.0, 1.8, 2.7), c(0.0, 0.8, 1.6, 2.3), c(-0.1, 0.7, 1.5, 2.2), c(0.3, 1.1, 1.9, 2.7))
dane <- as.data.frame(sapply(1:10, function(j) findInterval(ystar[, j] / sd(ystar[, j]), progi[[j]]) + 1))
names(dane) <- names(lambda)

# 1. Rozkład odpowiedzi: liczebności kategorii 1–5 i skośność
czest <- t(sapply(dane, function(x) table(factor(x, levels = 1:5))))
skos <- sapply(dane, function(x) mean((x - mean(x))^3) / sd(x)^3)
print(cbind(czest, skosnosc = round(skos, 2)))
round(100 * czest[, 1] / N, 1)                 # odsetek odpowiedzi „1”

model <- '
  ZO =~ z1 + z2 + z3 + z4 + z5
  US =~ u1 + u2 + u3 + u4 + u5
'
# 2. Ten sam model trzema estymatorami
fit_ml  <- cfa(model, data = dane, estimator = "ML")
fit_mlr <- cfa(model, data = dane, estimator = "MLR")
fit_wls <- cfa(model, data = dane, ordered = names(dane))   # WLSMV jest domyślny przy ordered =

ind <- function(fit, typ) {
  f <- fitMeasures(fit)
  s <- switch(typ, zwykle = "", skalowane = ".scaled", odporne = ".robust")
  chi <- if (typ == "zwykle") "chisq" else "chisq.scaled"
  c(chisq = f[[chi]], df = f[[if (typ == "zwykle") "df" else "df.scaled"]],
    p = f[[if (typ == "zwykle") "pvalue" else "pvalue.scaled"]],
    CFI = f[[paste0("cfi", s)]], TLI = f[[paste0("tli", s)]], RMSEA = f[[paste0("rmsea", s)]],
    RMSEA_lo = f[[paste0("rmsea.ci.lower", s)]], RMSEA_hi = f[[paste0("rmsea.ci.upper", s)]], SRMR = f[["srmr"]])
}
dopasowanie <- rbind(ML = ind(fit_ml, "zwykle"), MLR = ind(fit_mlr, "odporne"),
                     WLSMV_scaled = ind(fit_wls, "skalowane"), WLSMV_robust = ind(fit_wls, "odporne"))
print(round(dopasowanie, 3))

# 3. Ładunki standaryzowane i korelacja czynników a wartości prawdziwe
std <- function(fit) { s <- standardizedSolution(fit); s }
lad <- function(fit) { s <- std(fit); s[s$op == "=~", "est.std"] }
se_lad <- function(fit) { s <- std(fit); s[s$op == "=~", "se"] }
kor <- function(fit) { s <- std(fit); s[s$op == "~~" & s$lhs == "ZO" & s$rhs == "US", c("est.std", "ci.lower", "ci.upper")] }
ladunki <- data.frame(prawda = lambda, ML = lad(fit_ml), WLSMV = lad(fit_wls),
                      SE_ML = se_lad(fit_ml), SE_MLR = se_lad(fit_mlr), SE_WLSMV = se_lad(fit_wls))
print(round(ladunki, 3))
round(c(sredni_blad_ML = mean(ladunki$ML - lambda), sredni_blad_WLSMV = mean(ladunki$WLSMV - lambda)), 3)
print(round(rbind(ML = unlist(kor(fit_ml)), MLR = unlist(kor(fit_mlr)), WLSMV = unlist(kor(fit_wls))), 3))

# 4. Progi WLSMV (skala y*): oszacowanie, SE i zgodność z qnorm(skumulowanych odsetków)
pr <- parameterEstimates(fit_wls)
pr <- pr[pr$op == "|", c("lhs", "rhs", "est", "se")]
pr$qnorm <- unlist(lapply(dane, function(x) qnorm(cumsum(table(factor(x, levels = 1:5)))[1:4] / N)))
print(cbind(pr[1:2], round(pr[3:5], 3)), row.names = FALSE)
Wynik w R
     1   2  3  4 5 skosnosc
z1 160 116 81 34 9     0.78
z2 171 121 76 26 6     0.86
z3 188 135 53 22 2     1.03
z4 134 136 93 28 9     0.69
z5 147 128 90 26 9     0.75
u1 213 104 68 10 5     1.15
u2 237 109 38 13 3     1.50
u3 201 109 69 14 7     1.12
u4 188 118 71 19 4     0.95
u5 249  93 41 14 3     1.54
  z1   z2   z3   z4   z5   u1   u2   u3   u4   u5
40.0 42.8 47.0 33.5 36.8 53.2 59.2 50.2 47.0 62.2
              chisq df     p   CFI   TLI RMSEA RMSEA_lo RMSEA_hi  SRMR
ML           63.399 34 0.002 0.973 0.965 0.046    0.028    0.064 0.037
MLR          54.324 34 0.015 0.978 0.971 0.042    0.019    0.062 0.037
WLSMV_scaled 58.157 34 0.006 0.986 0.981 0.042    0.023    0.060 0.044
WLSMV_robust 58.157 34 0.006 0.967 0.957 0.061    0.034    0.086 0.044
   prawda    ML WLSMV SE_ML SE_MLR SE_WLSMV
z1   0.75 0.698 0.759 0.035  0.041    0.036
z2   0.70 0.582 0.629 0.041  0.043    0.045
z3   0.80 0.706 0.745 0.035  0.037    0.036
z4   0.65 0.572 0.618 0.041  0.046    0.040
z5   0.60 0.588 0.648 0.041  0.051    0.044
u1   0.80 0.756 0.839 0.029  0.032    0.032
u2   0.70 0.664 0.727 0.034  0.045    0.041
u3   0.75 0.744 0.788 0.030  0.037    0.033
u4   0.65 0.625 0.670 0.037  0.040    0.041
u5   0.55 0.590 0.656 0.039  0.049    0.046
   sredni_blad_ML sredni_blad_WLSMV
           -0.043             0.013
      est.std ci.lower ci.upper
ML      0.472    0.371    0.574
MLR     0.472    0.356    0.589
WLSMV   0.476    0.374    0.579
 lhs rhs    est    se  qnorm
  z1  t1 -0.253 0.063 -0.253
  z1  t2  0.496 0.066  0.496
  z1  t3  1.240 0.084  1.240
  z1  t4  2.005 0.139  2.005
  z2  t1 -0.183 0.063 -0.183
  z2  t2  0.613 0.067  0.613
  z2  t3  1.405 0.091  1.405
  z2  t4  2.170 0.161  2.170
  z3  t1 -0.075 0.063 -0.075
  z3  t2  0.869 0.072  0.869
  z3  t3  1.555 0.100  1.555
  z3  t4  2.576 0.244  2.576
  z4  t1 -0.426 0.065 -0.426
  z4  t2  0.454 0.065  0.454
  z4  t3  1.326 0.088  1.326
  z4  t4  2.005 0.139  2.005
  z5  t1 -0.338 0.064 -0.338
  z5  t2  0.489 0.066  0.489
  z5  t3  1.356 0.089  1.356
  z5  t4  2.005 0.139  2.005
  u1  t1  0.082 0.063  0.082
  u1  t2  0.815 0.071  0.815
  u1  t3  1.780 0.116  1.780
  u1  t4  2.241 0.172  2.241
  u2  t1  0.234 0.063  0.234
  u2  t2  1.103 0.079  1.103
  u2  t3  1.751 0.114  1.751
  u2  t4  2.432 0.209  2.432
  u3  t1  0.006 0.063  0.006
  u3  t2  0.755 0.070  0.755
  u3  t3  1.621 0.104  1.621
  u3  t4  2.108 0.152  2.108
  u4  t1 -0.075 0.063 -0.075
  u4  t2  0.722 0.069  0.722
  u4  t3  1.576 0.101  1.576
  u4  t4  2.326 0.187  2.326
  u5  t1  0.312 0.064  0.312
  u5  t2  1.058 0.077  1.058
  u5  t3  1.722 0.112  1.722
  u5  t4  2.432 0.209  2.432
2. Łączenie rzadkich kategorii i model końcowy
R
# Kontynuacja przepisu 1 (te same dane). Rzadkie kategorie: łączymy odpowiedź 5 z 4 w pozycjach,
# w których „5” wybrało mniej niż 5 osób (reguła ustalona przed analizą)
rzadkie <- names(dane)[sapply(dane, function(x) sum(x == 5) < 5)]
rzadkie
dane_p <- dane
dane_p[rzadkie] <- lapply(dane_p[rzadkie], function(x) pmin(x, 4))
fit_wls_p <- cfa(model, data = dane_p, ordered = names(dane_p))

porownanie <- rbind(przed = ind(fit_wls, "odporne"), po_polaczeniu = ind(fit_wls_p, "odporne"))
print(round(porownanie, 3))
round(data.frame(przed = lad(fit_wls), po = lad(fit_wls_p), row.names = names(lambda)), 3)
pp <- parameterEstimates(fit_wls_p)
pp <- pp[pp$op == "|" & pp$lhs %in% rzadkie, c("lhs", "rhs", "est", "se")]
print(cbind(pp[1:2], round(pp[3:4], 3)), row.names = FALSE)

# Do opisu: zakres ładunków standaryzowanych i korelacja czynników z 95% CI
s <- standardizedSolution(fit_wls_p)
round(range(s[s$op == "=~", "est.std"]), 3)
round(unlist(s[s$op == "~~" & s$lhs == "ZO" & s$rhs == "US", c("est.std", "ci.lower", "ci.upper")]), 3)
Wynik w R
[1] "z3" "u2" "u4" "u5"
               chisq df     p   CFI   TLI RMSEA RMSEA_lo RMSEA_hi  SRMR
przed         58.157 34 0.006 0.967 0.957 0.061    0.034    0.086 0.044
po_polaczeniu 56.747 34 0.009 0.969 0.959 0.059    0.031    0.084 0.043
   przed    po
z1 0.759 0.757
z2 0.629 0.628
z3 0.745 0.747
z4 0.618 0.622
z5 0.648 0.653
u1 0.839 0.839
u2 0.727 0.723
u3 0.788 0.790
u4 0.670 0.672
u5 0.656 0.654
 lhs rhs    est    se
  z3  t1 -0.075 0.063
  z3  t2  0.869 0.072
  z3  t3  1.555 0.100
  u2  t1  0.234 0.063
  u2  t2  1.103 0.079
  u2  t3  1.751 0.114
  u4  t1 -0.075 0.063
  u4  t2  0.722 0.069
  u4  t3  1.576 0.101
  u5  t1  0.312 0.064
  u5  t2  1.058 0.077
  u5  t3  1.722 0.112
[1] 0.622 0.839
 est.std ci.lower ci.upper
   0.473    0.369    0.577
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7.2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://www.stats.ox.ac.uk/pub/MASS4/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Raportowanie indeksów scaled z WLSMV i ocenianie ich progami dla ML. Takie indeksy są zbyt optymistyczne. Podaj wersje robust i napisz, których używasz.
- MLR jako „poprawka na skalę Likerta”. MLR koryguje błędy standardowe i test, ale ładunki pozostają takie jak w ML.
- Automatyczny wybór ML przy pięciu kategoriach. Argument „5 kategorii wystarczy” dotyczy symetrycznych progów. Przy skośnych pozycjach porównaj ML lub MLR z WLSMV.
- Łączenie kategorii po obejrzeniu wyników albo różnie w różnych grupach.
- Brak rozkładu odpowiedzi w raporcie. Bez niego czytelnik nie oceni, czy progi i korelacje polichoryczne mają solidną podstawę.
Więcej o kolejnych krokach modelowania znajdziesz w przewodnikach modelowanie równań strukturalnych i psychometria i budowa skal. Pełną procedurę EFA i CFA z wyborem liczby czynników pokazuje poradnik analiza czynnikowa EFA i CFA, a model strukturalny w lavaan – wpis CB-SEM w R.
Najczęstsze pytania
Czy pięciostopniową skalę Likerta analizować w CFA jako porządkową?
To zależy od rozkładu odpowiedzi. Rhemtulla i in. (2012) stwierdzili, że przy 5 i więcej kategoriach oraz w przybliżeniu symetrycznych progach odporny ML wypada podobnie jak metoda kategorialna. Przy wyraźnej skośności, efekcie podłogi albo rzadkich kategoriach WLSMV dokładniej szacuje ładunki. Najbezpieczniej policzyć oba modele i opisać różnice.
Dlaczego CFI z WLSMV jest wyższe niż z ML dla tego samego modelu?
Bo przy danych porządkowych DWLS daje zwykle większe CFI i TLI oraz mniejsze RMSEA niż ML, także w wersjach skalowanych (Xia i Yang, 2019). Progi wyznaczone dla ML łatwo wtedy przepuszczają źle dopasowany model. W przykładzie przeskalowane CFI wyniosło .986, a odporne – .967.
Które indeksy dopasowania podać przy WLSMV w lavaan: scaled czy robust?
Podaj wersje robust, np. fitMeasures(fit, c("cfi.robust", "tli.robust", "rmsea.robust")), i napisz o tym w tekście. Według dokumentacji lavaan to nowsze obliczenia, oparte m.in. na propozycji Savalei (2021), zalecane zamiast starszych wersji scaled. Gdy macierz polichoryczna nie jest dodatnio określona, lavaan zwraca je jako NA.
Kiedy łączyć kategorie odpowiedzi przed CFA?
Gdy którąś kategorię wybrało bardzo niewiele osób, zwłaszcza w małej próbie lub w porównaniu grup. DiStefano i in. (2021) pokazali, że przy WLSMV połączenie rzadkich kategorii poprawia zbieżność i dokładność oszacowań. Regułę ustal przed analizą, łącz kategorie sąsiednie i stosuj to samo kodowanie we wszystkich grupach.
Czy MLR wystarczy, żeby poprawnie analizować pozycje Likerta w CFA?
MLR poprawia błędy standardowe i statystykę testu przy nienormalnych danych, ale ładunki ma takie same jak ML. Przy skośnych pozycjach pięciostopniowych oba zaniżały w przykładzie ładunki średnio o 0.043, a WLSMV mylił się średnio o 0.013. MLR warto pokazać w analizie wrażliwości albo wtedy, gdy masz dużo braków danych.
Powiązane hasła
Przeczytaj też
Analiza czynnikowa EFA i CFA
EFA czy CFA, analiza równoległa, rotacja oblimin a varimax, przejście od EFA do CFA na nowej próbie, WLSMV i opis APA – z danymi i kodem R.
Czytaj →PoradnikInwariancja pomiaru krok po kroku
Wielogrupowa CFA w lavaan: model konfiguracyjny, metryczny, skalarny i ścisły, kryteria ΔCFI i ΔRMSEA, testy punktowe, częściowa inwariancja i opis APA.
Czytaj →PoradnikTrafność zbieżna i różnicowa: AVE i HTMT
AVE i rzetelność złożona z ładunków lavaan, HTMT z bootstrapem, krytyka Fornella–Larckera i co zrobić, gdy dwa konstrukty są trudne do odróżnienia.
Czytaj →Recenzent kwestionuje estymator albo indeksy dopasowania w Twojej CFA?
Pomożemy dobrać estymator do pozycji porządkowych, policzyć model w lavaan, porównać wyniki ML, MLR i WLSMV oraz wyjaśnić je tak, żebyś mógł(a) samodzielnie opisać i obronić analizę.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Beauducel, A., & Herzberg, P. Y. (2006). On the performance of maximum likelihood versus means and variance adjusted weighted least squares estimation in CFA. Structural Equation Modeling: A Multidisciplinary Journal, 13(2), 186–203. https://doi.org/10.1207/s15328007sem1302_2
- DiStefano, C., Shi, D., & Morgan, G. B. (2021). Collapsing categories is often more advantageous than modeling sparse data: Investigations in the CFA framework. Structural Equation Modeling: A Multidisciplinary Journal, 28(2), 237–249. https://doi.org/10.1080/10705511.2020.1803073
- Flora, D. B., & Curran, P. J. (2004). An empirical evaluation of alternative methods of estimation for confirmatory factor analysis with ordinal data. Psychological Methods, 9(4), 466–491. https://doi.org/10.1037/1082-989X.9.4.466 ● Otwarty dostęp: pełny tekst
- Hu, L., & Bentler, P. M. (1999). Cutoff criteria for fit indexes in covariance structure analysis: Conventional criteria versus new alternatives. Structural Equation Modeling: A Multidisciplinary Journal, 6(1), 1–55. https://doi.org/10.1080/10705519909540118
- Li, C.-H. (2016). Confirmatory factor analysis with ordinal data: Comparing robust maximum likelihood and diagonally weighted least squares. Behavior Research Methods, 48(3), 936–949. https://doi.org/10.3758/s13428-015-0619-7 ● Otwarty dostęp
- Rhemtulla, M., Brosseau-Liard, P. É., & Savalei, V. (2012). When can categorical variables be treated as continuous? A comparison of robust continuous and categorical SEM estimation methods under suboptimal conditions. Psychological Methods, 17(3), 354–373. https://doi.org/10.1037/a0029315
- Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2). https://doi.org/10.18637/jss.v048.i02 ● Otwarty dostęp
- Savalei, V. (2021). Improving fit indices in structural equation modeling with categorical data. Multivariate Behavioral Research, 56(3), 390–407. https://doi.org/10.1080/00273171.2020.1717922 ● Otwarty dostęp
- Xia, Y., & Yang, Y. (2019). RMSEA, CFI, and TLI in structural equation modeling with ordered categorical data: The story they tell depends on the estimation methods. Behavior Research Methods, 51(1), 409–428. https://doi.org/10.3758/s13428-018-1055-2 ● Otwarty dostęp
Cytowania BibTeX
@article{beauducel2006performance, author={Beauducel, Andre and Herzberg, Philipp Yorck}, title={{On the performance of maximum likelihood versus means and variance adjusted weighted least squares estimation in CFA}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2006}, volume={13}, number={2}, pages={186--203}, doi={10.1207/s15328007sem1302_2}}@article{distefano2021collapsing, author={DiStefano, Christine and Shi, Dexin and Morgan, Grant B.}, title={{Collapsing categories is often more advantageous than modeling sparse data: Investigations in the CFA framework}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2021}, volume={28}, number={2}, pages={237--249}, doi={10.1080/10705511.2020.1803073}}@article{flora2004empirical, author={Flora, David B. and Curran, Patrick J.}, title={{An empirical evaluation of alternative methods of estimation for confirmatory factor analysis with ordinal data}}, journal={Psychological Methods}, year={2004}, volume={9}, number={4}, pages={466--491}, doi={10.1037/1082-989x.9.4.466}}@article{hu1999cutoff, author={Hu, Li-tze and Bentler, Peter M.}, title={{Cutoff criteria for fit indexes in covariance structure analysis: Conventional criteria versus new alternatives}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={1999}, volume={6}, number={1}, pages={1--55}, doi={10.1080/10705519909540118}}@article{li2016confirmatory, author={Li, Cheng-Hsien}, title={{Confirmatory factor analysis with ordinal data: Comparing robust maximum likelihood and diagonally weighted least squares}}, journal={Behavior Research Methods}, year={2016}, volume={48}, number={3}, pages={936--949}, doi={10.3758/s13428-015-0619-7}}@article{rhemtulla2012when, author={Rhemtulla, Mijke and Brosseau-Liard, Patricia É. and Savalei, Victoria}, title={{When can categorical variables be treated as continuous? A comparison of robust continuous and categorical SEM estimation methods under suboptimal conditions}}, journal={Psychological Methods}, year={2012}, volume={17}, number={3}, pages={354--373}, doi={10.1037/a0029315}}@article{rosseel2012lavaan, author={Rosseel, Yves}, title={{lavaan: An R package for structural equation modeling}}, journal={Journal of Statistical Software}, year={2012}, volume={48}, number={2}, doi={10.18637/jss.v048.i02}}@article{savalei2021improving, author={Savalei, Victoria}, title={{Improving fit indices in structural equation modeling with categorical data}}, journal={Multivariate Behavioral Research}, year={2021}, volume={56}, number={3}, pages={390--407}, doi={10.1080/00273171.2020.1717922}}@article{xia2019rmsea, author={Xia, Yan and Yang, Yanyun}, title={{RMSEA, CFI, and TLI in structural equation modeling with ordered categorical data: The story they tell depends on the estimation methods}}, journal={Behavior Research Methods}, year={2019}, volume={51}, number={1}, pages={409--428}, doi={10.3758/s13428-018-1055-2}}