Co to jest WLSMV?
WLSMV (ang. weighted least squares, mean- and variance-adjusted) to estymator stosowany w CFA i SEM, gdy zmienne obserwowane są porządkowe albo dychotomiczne. Dotyczy to np. pozycji z odpowiedziami „wcale – trochę – wyraźnie – bardzo”, krótkich skal Likerta i odpowiedzi tak/nie. Nazwa opisuje dwie rzeczy. Parametry szacuje się ważoną metodą najmniejszych kwadratów z diagonalną macierzą wag (DWLS). Statystykę χ² i błędy standardowe koryguje się ze względu na średnią i wariancję.
WLSMV nie traktuje odpowiedzi 0, 1, 2, 3 jak liczb na skali przedziałowej. Zakłada, że za każdą pozycją stoi ciągła, normalnie rozłożona skłonność y*, którą odpowiedzi tną na kategorie w miejscach zwanych progami (τ). Model czynnikowy opisuje korelacje między tymi ciągłymi skłonnościami, czyli korelacje polichoryczne, a nie korelacje surowych odpowiedzi.
Jak działa estymacja WLSMV – trzy kroki
- Progi. Dla każdej pozycji program wyznacza progi z odsetków odpowiedzi: τk = Φ−1(odsetek odpowiedzi ≤ k), gdzie Φ−1 to funkcja odwrotna do dystrybuanty rozkładu normalnego (rysunek 1).
- Korelacje polichoryczne. Dla każdej pary pozycji program szacuje korelację ciągłych y* przy ustalonych progach. Olsson (1979) opisał tę dwuetapową procedurę i jej wersję z pełną metodą największej wiarygodności.
- Dopasowanie modelu. Model dopasowuje się do macierzy polichorycznej metodą DWLS. Wagi pochodzą tylko z przekątnej macierzy kowariancji asymptotycznych korelacji. Pełna macierz służy do odpornych błędów standardowych i do przeskalowania χ². Pełny WLS, czyli metoda ADF, odwraca całą macierz wag. Flora i Curran (2004) pokazali, że działa on poprawnie tylko w bardzo dużych próbach, a odporny WLS sprawdzał się we wszystkich badanych warunkach.
Badania symulacyjne dają jasną wskazówkę dla pozycji z niewielką liczbą kategorii. Beauducel i Herzberg (2006) stwierdzili, że przy 2–3 kategoriach test χ² WLSMV odrzucał poprawny model z częstością bliską nominalnym 5%, a ML znacznie częściej. WLSMV dokładniej szacował też ładunki. Rhemtulla i in. (2012) zalecają metody kategorialne przy mniej niż 5 kategoriach. Przy 5 i więcej kategoriach, w przybliżeniu symetrycznych rozkładach i małej próbie odporna metoda ML (MLR) bywa równie dobra.
Przykład: ML a WLSMV dla skali o czterech kategoriach
Pięciuset uczniów (dane symulowane) odpowiedziało na 6 pozycji skali lęku egzaminacyjnego (0 = wcale, 1 = trochę, 2 = wyraźnie, 3 = bardzo). Rozkłady są prawoskośne. Przy pierwszej pozycji 55.0% osób wybrało „wcale”, a tylko 5.6% – „bardzo”. Dane wygenerowano z modelu jednoczynnikowego o znanych ładunkach (od .60 do .80), więc wiemy, jaki wynik jest prawdziwy.
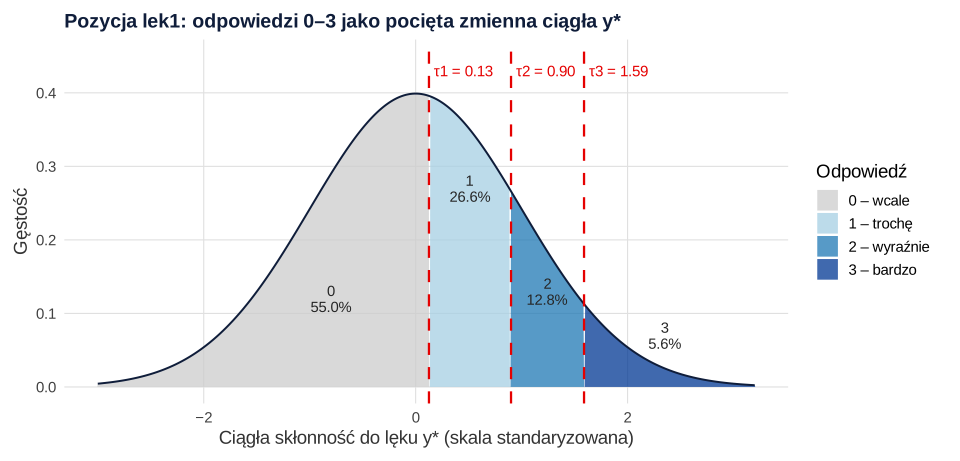
Progi pozycji lek1 oszacowane przez WLSMV (0.126, 0.900 i 1.589) są dokładnie równe wartościom Φ−1 skumulowanych odsetków 0.550, 0.816 i 0.944. Korelacja Pearsona dla pary lek1–lek2 wynosi .503, a polichoryczna – .593. Pocięcie zmiennej ciągłej na cztery nierówne kategorie zaniża zwykłą korelację, a to przenosi się na ładunki.
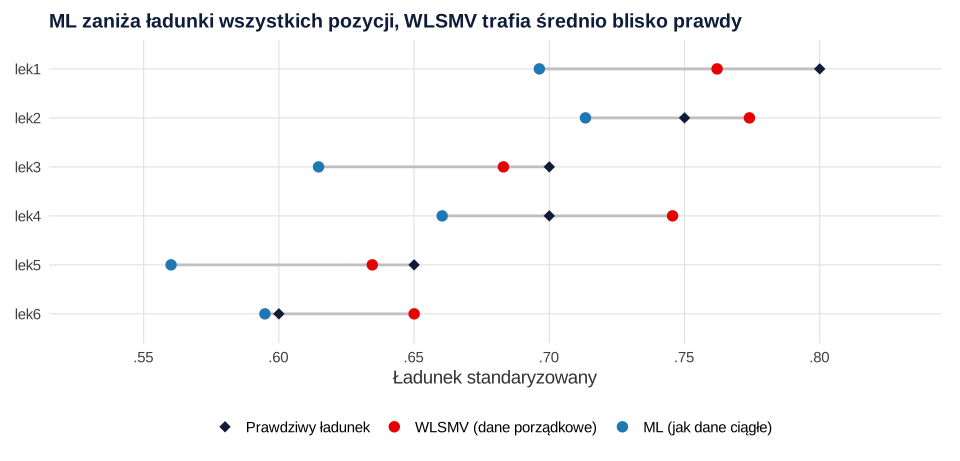
ML zaniżył ładunek każdej pozycji, średnio o 0.060. Przy pozycji lek5 ładunek wyniósł .560 zamiast .65. Błędy WLSMV szły w obie strony i niemal się znosiły (średnio +0.008). To praktyczna różnica: od wielkości ładunków zależą m.in. omega McDonalda i AVE. Model WLSMV pasował do danych bardzo dobrze: przeskalowane χ²(9) = 6.51, p = .689, CFI = 1.000, TLI = 1.003, RMSEA = .000, SRMR = .018.
Kiedy wybrać WLSMV, a kiedy MLR
| Sytuacja | Rozsądny wybór |
|---|---|
| Pozycje dychotomiczne albo 3–4 kategorie | WLSMV (zmienne zadeklarowane jako porządkowe) |
| 5 i więcej kategorii, rozkłady zbliżone do symetrycznych | MLR albo WLSMV – wyniki zwykle podobne |
| 5–7 kategorii, silna skośność, efekt podłogi lub sufitu | raczej WLSMV; porównaj z MLR w analizie wrażliwości |
| Dużo braków danych, mechanizm MAR | MLR z FIML; WLSMV używa par dostępnych obserwacji, co zakłada braki typu MCAR (zob. braki danych) |
| Kategoria wybrana przez bardzo niewiele osób w małej próbie | rozważ połączenie kategorii przed analizą |
Wybór liczby odpowiedzi warto przemyśleć już przy budowie narzędzia – zobacz poradnik ile stopni skali Likerta wybrać.
Co pojawia się w wyniku WLSMV
Wydruk z WLSMV różni się od wydruku ML w kilku miejscach, które warto znać przed pisaniem rozdziału wyników:
- Progi zamiast wyrazów wolnych. Każda pozycja o k kategoriach ma k − 1 progów (oznaczenia
t1,t2…). W jednej grupie progi zwykle tylko odtwarzają rozkład odpowiedzi i nie wymagają interpretacji. - Dwie kolumny statystyk. Program podaje χ² „standardowe” i przeskalowane (scaled). W pracy podaj przeskalowane, podobnie jak wersje CFI, TLI i RMSEA z dopiskiem scaled lub robust.
- Parametryzacja delta albo theta. Domyślna parametryzacja delta ustala całkowitą wariancję y* na 1. Parametryzacja theta ustala na 1 wariancje reszt. Rozwiązania standaryzowane są w obu identyczne, ale surowe oszacowania i ograniczenia w modelach wielogrupowych zależą od wyboru.
- Reszty i wariancje reszt odnoszą się do y*, nie do surowych odpowiedzi. Wariancja reszty pozycji z ładunkiem .70 wynosi więc 1 − .70² = .51 w metryce standaryzowanej.
Jak opisać WLSMV w pracy (APA)
Napisz, że pozycje potraktowano jako porządkowe i że model dopasowano do macierzy korelacji polichorycznych estymatorem WLSMV. Podaj program, parametryzację (delta lub theta, gdy ma znaczenie) i rozkład odpowiedzi. Przy wskaźnikach dopasowania zaznacz, że to wersje przeskalowane. Porównania modeli wykonuj testem różnicy przeznaczonym dla WLSMV, a nie zwykłym odejmowaniem χ² (zob. test różnicy chi-kwadrat w SEM).
WLSMV w R (lavaan)
Kod tworzy dane z przykładu i dopasowuje ten sam model metodą ML oraz WLSMV. Porównuje ładunki z prawdziwymi, sprawdza progi i korelację polichoryczną oraz wypisuje wskaźniki dopasowania. Liczby w tekście i na obu rysunkach pochodzą z tego kodu.
CFA pozycji porządkowych: ML a WLSMV
R
suppressPackageStartupMessages(library(lavaan))   # CFA: ML i WLSMV

# Dane symulowane: 500 uczniów, 6 pozycji skali lęku egzaminacyjnego z 4 odpowiedziami
# (0 = wcale, 1 = trochę, 2 = wyraźnie, 3 = bardzo). Rozkłady są prawoskośne – większość osób
# wybiera 0 lub 1. Prawdziwe ładunki standaryzowane: .80, .75, .70, .70, .65, .60.
set.seed(141)
lambda <- c(0.80, 0.75, 0.70, 0.70, 0.65, 0.60)
eta <- rnorm(500)
ukryte <- sapply(lambda, function(l) l * eta + rnorm(500, sd = sqrt(1 - l^2)))   # ciągłe y*
progi <- c(0.1, 0.9, 1.6)                                                        # progi kategorii
dane <- as.data.frame(apply(ukryte, 2, function(y) findInterval(y, progi)))
names(dane) <- paste0("lek", 1:6)
round(prop.table(table(dane$lek1)), 3)        # rozkład odpowiedzi na pierwszą pozycję

model <- 'lek =~ lek1 + lek2 + lek3 + lek4 + lek5 + lek6'
fit_ml    <- cfa(model, data = dane, estimator = "ML")
fit_wlsmv <- cfa(model, data = dane, ordered = names(dane), estimator = "WLSMV")

# 1. Ładunki standaryzowane: prawda, ML (pozycje traktowane jak ciągłe), WLSMV (porządkowe)
lad <- function(fit) standardizedSolution(fit)[1:6, "est.std"]
data.frame(pozycja = names(dane), prawda = lambda, ML = round(lad(fit_ml), 3), WLSMV = round(lad(fit_wlsmv), 3))
round(c(sredni_blad_ML = mean(lad(fit_ml) - lambda), sredni_blad_WLSMV = mean(lad(fit_wlsmv) - lambda)), 3)

# 2. Progi pozycji lek1 w WLSMV = kwantyle rozkładu normalnego dla skumulowanych odsetków
pe <- parameterEstimates(fit_wlsmv)
pe[pe$lhs == "lek1" & pe$op == "|", c("lhs", "op", "rhs", "est")]
skum <- cumsum(prop.table(table(dane$lek1)))[1:3]
round(rbind(odsetek_skumulowany = skum, qnorm = qnorm(skum)), 3)

# 3. Korelacja Pearsona a polichoryczna (dane wejściowe WLSMV) dla pary lek1–lek2
round(c(pearson = cor(dane$lek1, dane$lek2),
        polichoryczna = lavCor(dane[, 1:2], ordered = c("lek1", "lek2"))[1, 2]), 3)

# 4. Dopasowanie: statystyka przeskalowana (średnia i wariancja) i wskaźniki w wersji skalowanej
round(fitMeasures(fit_wlsmv, c("chisq", "chisq.scaled", "df", "pvalue.scaled",
                               "cfi.scaled", "tli.scaled", "rmsea.scaled", "srmr")), 3)
Wynik w R
    0     1     2     3
0.550 0.266 0.128 0.056
  pozycja prawda    ML WLSMV
1    lek1   0.80 0.696 0.762
2    lek2   0.75 0.713 0.774
3    lek3   0.70 0.615 0.683
4    lek4   0.70 0.660 0.746
5    lek5   0.65 0.560 0.635
6    lek6   0.60 0.595 0.650
   sredni_blad_ML sredni_blad_WLSMV
           -0.060             0.008
   lhs op rhs   est
7 lek1  |  t1 0.126
8 lek1  |  t2 0.900
9 lek1  |  t3 1.589
                        0     1     2
odsetek_skumulowany 0.550 0.816 0.944
qnorm               0.126 0.900 1.589
      pearson polichoryczna
        0.503         0.593
        chisq  chisq.scaled            df pvalue.scaled    cfi.scaled
        3.419         6.505         9.000         0.689         1.000
   tli.scaled  rmsea.scaled          srmr
        1.003         0.000         0.018
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7.2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Niezadeklarowanie zmiennych jako porządkowych. W lavaan sam wybór
estimator = "WLSMV"bez argumentuorderedliczy model na korelacjach Pearsona. Wtedy tracisz główną zaletę metody. - Odejmowanie χ² modeli WLSMV. Statystyki przeskalowane nie dają się odejmować. Użyj
lavTestLRT()albo DIFFTEST w Mplus. - Porównywanie CFI i RMSEA z WLSMV z progami ustalonymi dla ML. Wskaźniki z estymacji kategorialnej zachowują się inaczej. Traktuj progi ostrożnie i opisz, której wersji używasz.
- Puste lub prawie puste kategorie. Gdy którejś odpowiedzi nikt nie wybrał (albo wybrało ją kilka osób), progi i korelacje polichoryczne są niestabilne. Połącz kategorie i opisz to w pracy.
- Ignorowanie braków danych. WLSMV korzysta z par dostępnych obserwacji. Przy wielu brakach typu MAR rozważ imputację albo MLR z FIML.
- Raportowanie alfy Cronbacha z korelacji Pearsona obok ładunków WLSMV bez komentarza. Oba wyniki opierają się na innych macierzach korelacji.
Pełną procedurę CFA z wyborem estymatora pokazuje poradnik analiza czynnikowa EFA i CFA, a porównanie grup przy pozycjach porządkowych (progi zamiast wyrazów wolnych) – inwariancja pomiaru krok po kroku.
Najczęstsze pytania
Kiedy stosować estymator WLSMV?
Gdy pozycje są porządkowe i mają mało kategorii – zwłaszcza odpowiedzi dychotomiczne i skale 3–4-stopniowe – oraz gdy rozkłady odpowiedzi są wyraźnie skośne. Przy 5 i więcej kategoriach i symetrycznych rozkładach podobne wyniki daje zwykle MLR, więc warto porównać obie metody.
Czym WLSMV różni się od MLR?
MLR traktuje odpowiedzi jak zmienne ciągłe i koryguje błędy standardowe oraz χ² ze względu na nienormalność; WLSMV modeluje je jako porządkowe – przez progi i korelacje polichoryczne. MLR lepiej radzi sobie z brakami danych typu MAR (FIML), a WLSMV dokładniej szacuje ładunki pozycji o niewielu kategoriach.
Jak ustawić WLSMV w lavaan?
Podaj nazwy pozycji w argumencie ordered, np. cfa(model, data = dane, ordered = c("lek1", "lek2")) – lavaan wybierze wtedy WLSMV domyślnie. Sam argument estimator = "WLSMV" bez ordered nie potraktuje zmiennych jako porządkowych.
Dlaczego w WLSMV nie można odejmować wartości chi-kwadrat?
Bo WLSMV raportuje statystykę przeskalowaną ze względu na średnią i wariancję, a różnica dwóch takich statystyk nie ma rozkładu χ². Modele zagnieżdżone porównuj specjalnym testem różnicy – w lavaan funkcją lavTestLRT(), w Mplus opcją DIFFTEST.
Co to są progi w CFA z WLSMV?
Progi (τ) to punkty na ciągłej skali ukrytej skłonności, w których odpowiedź zmienia się na wyższą kategorię. Pozycja z 4 kategoriami ma 3 progi, wyznaczane z odsetków odpowiedzi. W porównaniach grup progi zastępują wyrazy wolne przy testowaniu inwariancji skalarnej.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Analiza czynnikowa EFA i CFA
EFA czy CFA, analiza równoległa, rotacja oblimin a varimax, przejście od EFA do CFA na nowej próbie, WLSMV i opis APA – z danymi i kodem R.
Czytaj →PoradnikInwariancja pomiaru krok po kroku
Wielogrupowa CFA w lavaan: model konfiguracyjny, metryczny, skalarny i ścisły, kryteria ΔCFI i ΔRMSEA, testy punktowe, częściowa inwariancja i opis APA.
Czytaj →PoradnikIle stopni skali Likerta wybrać?
4, 5, 7 czy więcej punktów: co mówią badania, środek skali, etykiety, tabela decyzyjna, symulacja w R i wzór opisu do pracy.
Czytaj →PoradnikKategorialna CFA: WLSMV w lavaan
Kiedy pozycje Likerta są porządkowe, jak czytać progi, ML, MLR i WLSMV na tych samych danych, indeksy robust, rzadkie kategorie i opis APA.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Beauducel, A., & Herzberg, P. Y. (2006). On the performance of maximum likelihood versus means and variance adjusted weighted least squares estimation in CFA. Structural Equation Modeling: A Multidisciplinary Journal, 13(2), 186–203. https://doi.org/10.1207/s15328007sem1302_2
- Flora, D. B., & Curran, P. J. (2004). An empirical evaluation of alternative methods of estimation for confirmatory factor analysis with ordinal data. Psychological Methods, 9(4), 466–491. https://doi.org/10.1037/1082-989X.9.4.466 ● Otwarty dostęp: pełny tekst
- Olsson, U. (1979). Maximum likelihood estimation of the polychoric correlation coefficient. Psychometrika, 44(4), 443–460. https://doi.org/10.1007/BF02296207
- Rhemtulla, M., Brosseau-Liard, P. É., & Savalei, V. (2012). When can categorical variables be treated as continuous? A comparison of robust continuous and categorical SEM estimation methods under suboptimal conditions. Psychological Methods, 17(3), 354–373. https://doi.org/10.1037/a0029315
Cytowania BibTeX
@article{beauducel2006performance, author={Beauducel, Andre and Herzberg, Philipp Yorck}, title={{On the performance of maximum likelihood versus means and variance adjusted weighted least squares estimation in CFA}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2006}, volume={13}, number={2}, pages={186--203}, doi={10.1207/s15328007sem1302_2}}@article{flora2004empirical, author={Flora, David B. and Curran, Patrick J.}, title={{An empirical evaluation of alternative methods of estimation for confirmatory factor analysis with ordinal data}}, journal={Psychological Methods}, year={2004}, volume={9}, number={4}, pages={466--491}, doi={10.1037/1082-989x.9.4.466}}@article{olsson1979maximum, author={Olsson, Ulf}, title={{Maximum likelihood estimation of the polychoric correlation coefficient}}, journal={Psychometrika}, year={1979}, volume={44}, number={4}, pages={443--460}, doi={10.1007/bf02296207}}@article{rhemtulla2012when, author={Rhemtulla, Mijke and Brosseau-Liard, Patricia É. and Savalei, Victoria}, title={{When can categorical variables be treated as continuous? A comparison of robust continuous and categorical SEM estimation methods under suboptimal conditions}}, journal={Psychological Methods}, year={2012}, volume={17}, number={3}, pages={354--373}, doi={10.1037/a0029315}}