Trzy pytania do modelu pomiarowego
Dobre dopasowanie modelu CFA nie kończy oceny pomiaru. Zanim przejdziesz do ścieżek w CB-SEM, odpowiedz na trzy pytania:
- Czy wskaźniki mierzą wspólny konstrukt? To trafność zbieżna w sensie przyjętym w SEM. Oceniasz ją po ładunkach i średniej wyodrębnionej wariancji (AVE).
- Czy suma wskaźników jest rzetelna? Odpowiada na to rzetelność złożona (CR), czyli w CB-SEM omega.
- Czy konstrukty da się od siebie odróżnić? To trafność różnicowa, sprawdzana kryterium Fornella–Larckera, wskaźnikiem HTMT i przedziałem ufności korelacji czynników.
Definicje i pojedyncze wskaźniki opisują hasła słownika. Tu pokazujemy całą procedurę na jednym modelu w lavaan. W przykładzie jedna para konstruktów nie przechodzi kontroli, a dalsza część wpisu pokazuje, co wtedy zrobić.
Przykład: satysfakcja z pracy i przywiązanie do organizacji
W ankiecie 350 pracowników (dane symulowane) użyto czterech skal z odpowiedziami 1–7: wsparcie przełożonego (WP, 4 pozycje), satysfakcja z pracy (SAT, 4), przywiązanie afektywne do organizacji (PRZ, 4) i intencja odejścia (INT, 3). Przy siedmiu kategoriach i rozkładach zbliżonych do symetrycznych potraktowaliśmy odpowiedzi jako ciągłe i użyliśmy estymatora MLR w pakiecie lavaan (Rosseel, 2012). Przy krótszych lub skośnych skalach zacznij od kategorialnej CFA z WLSMV.
Czteroczynnikowy model pasował do danych bardzo dobrze: χ²(84) = 107.09, p = .045, CFI = .993, TLI = .991, RMSEA = .028, SRMR = .029 (wersje odporne). Dane wygenerowaliśmy jednak tak, że satysfakcja i przywiązanie są silnie skorelowane, a pozycja prz4 („Lubię to, czym zajmuję się w tej firmie”) mierzy częściowo satysfakcję. Indeksy dopasowania tego nie pokazały.
AVE i rzetelność złożona z ładunków lavaan
Obie miary liczysz ze standaryzowanych ładunków λ, które zwraca standardizedSolution(). Dla czynnika z k wskaźnikami:
AVE to średni odsetek wariancji wskaźnika wyjaśniony przez czynnik. CR to rzetelność sumy wskaźników przy modelu kongenerycznym. Raykov (1997) pokazał, że taki estymator nie ma ogólnej skłonności do zaniżania rzetelności, którą ma alfa Cronbacha. Różnicę między modelami opisuje hasło model tau-ekwiwalentny a kongeneryczny.
| Skala | Ładunki | AVE (ręcznie) | CR (ręcznie) | AVE (semTools) | omega (semTools) |
|---|---|---|---|---|---|
| Wsparcie przełożonego (WP) | .60–.78 | .515 | .808 | .516 | .809 |
| Satysfakcja z pracy (SAT) | .85–.90 | .761 | .927 | .762 | .928 |
| Przywiązanie afektywne (PRZ) | .77–.87 | .696 | .901 | .697 | .905 |
| Intencja odejścia (INT) | .72–.83 | .611 | .824 | .612 | .825 |
Funkcje AVE() i compRelSEM() z pakietu semTools dają prawie to samo. Różnice w trzecim miejscu po przecinku wynikają z tego, że semTools używa w mianowniku wariancji obserwowanych albo macierzy modelu, a nie samych ładunków standaryzowanych. W raporcie podaj jedną wersję i napisz, którą.
Fornell i Larcker (1981) zaproponowali, by AVE nie spadała poniżej .50, co przypominają Cheung i in. (2024). Wszystkie skale spełniają ten warunek, WP tylko nieznacznie (.515). Cheung i in. (2024) krytykują jednak mechaniczne stosowanie progu, bo pomija błąd próbkowania. Zalecają ocenę kilkoma kryteriami, z przedziałami ufności. AVE równa .515 przy najniższym ładunku .60 nie jest więc ani sukcesem, ani porażką. To sygnał, by obejrzeć treść słabszej pozycji.
Kryterium Fornella–Larckera i jego krytyka
Kryterium Fornella–Larckera wymaga, by AVE każdego czynnika była większa niż kwadrat jego korelacji z każdym innym czynnikiem. Równoważnie: √AVE na przekątnej macierzy ma przewyższać korelacje w tym samym wierszu i kolumnie.
| Czynnik | WP | SAT | PRZ | INT |
|---|---|---|---|---|
| WP | .718 | |||
| SAT | .448 | .872 | ||
| PRZ | .438 | .847 | .834 | |
| INT | −.285 | −.487 | −.524 | .781 |
Para SAT–PRZ nie spełnia kryterium: korelacja .847 przewyższa √AVE przywiązania (.834). W kwadratach: r² = .718, a AVE PRZ = .696. Względem satysfakcji (AVE = .761) kryterium jest spełnione, więc wynik zależy od tego, z którą AVE porównasz korelację. Porównuj zawsze z obiema.
Kryterium ma poważne ograniczenia. Henseler, Ringle i Sarstedt (2015) wykazali w symulacji, że kryterium Fornella–Larckera i analiza ładunków krzyżowych w typowych sytuacjach nie wykrywały wiarygodnie braku trafności różnicowej. Ich badanie dotyczyło PLS-SEM, w którym ładunki, a więc i AVE, są zawyżone. Cheung i in. (2024) zwracają uwagę na problem, który dotyczy też CB-SEM: wysoka AVE toleruje wysokie korelacje. Kryterium porównuje dwie liczby z próby bez uwzględnienia ich niepewności. Pokażemy niżej, że wystarczy usunąć jedną słabszą pozycję, by AVE wzrosła i para „przeszła” test, choć korelacja wciąż przekracza .80.
HTMT i przedział ufności korelacji
HTMT (heterotrait-monotrait ratio) to stosunek średniej korelacji między wskaźnikami dwóch różnych konstruktów do średniej korelacji między wskaźnikami tego samego konstruktu. Henseler i in. (2015) wyprowadzili go z logiki macierzy MTMM i zaproponowali progi .85 lub .90. Franke i Sarstedt (2019) potwierdzili, że HTMT dobrze szacuje korelację konstruktów skorygowaną o błąd pomiaru i działa podobnie jak podejście oparte na korelacji czynników z CFA.
Klasyczny HTMT zakłada model tau-ekwiwalentny. Roemer, Schuberth i Henseler (2021) zaproponowali HTMT2, który zamiast średnich arytmetycznych używa geometrycznych i daje mniej obciążone wyniki przy niejednorodnych ładunkach. Funkcja semTools::htmt() liczy domyślnie HTMT2 (htmt2 = TRUE). W przykładzie ładunki SAT i PRZ są podobne, więc obie wersje niemal się pokrywają (.861 i .862).
Rönkkö i Cho (2022) definiują trafność różnicową przez korelację dwóch miar po uwzględnieniu błędu pomiaru. Zalecają ocenę przedziału ufności tej korelacji, czyli procedurę CICFA(sys). Dla SAT–PRZ 95% CI korelacji czynników wynosi [.807, .888]. Bootstrapowy 95% CI dla HTMT (2000 prób, bootstrap percentylowy) to [.822, .895]. Oba przedziały sięgają wyraźnie powyżej .85, więc tej pary nie można uznać za dobrze odróżnioną.
Tabela 1
Wskaźniki trafności różnicowej dla sześciu par konstruktów w modelu czteroczynnikowym
| Para | r [95% CI] | r2 | Mniejsza AVE | HTMT | HTMT2 |
|---|---|---|---|---|---|
| WP – SAT | .45 [.34, .55] | .20 | .51 | .45 | .45 |
| WP – PRZ | .44 [.33, .54] | .19 | .51 | .45 | .45 |
| WP – INT | −.28 [−.40, −.17] | .08 | .51 | .29 | .28 |
| SAT – PRZ | .85 [.81, .89] | .72 | .70 | .86 | .86 |
| SAT – INT | −.49 [−.58, −.39] | .24 | .61 | .48 | .48 |
| PRZ – INT | −.52 [−.62, −.43] | .27 | .61 | .54 | .54 |
Uwaga. N = 350 (dane symulowane). r – standaryzowana korelacja czynników z CFA (estymator MLR) z 95% CI; mniejsza AVE – niższa z dwóch średnich wyodrębnionych wariancji w parze; HTMT – średnie arytmetyczne korelacji (Henseler i in., 2015), HTMT2 – średnie geometryczne (Roemer i in., 2021); dla korelacji ujemnych HTMT podano w wartościach bezwzględnych. Bootstrapowy 95% CI dla HTMT pary SAT–PRZ: [.82, .90]. WP – wsparcie przełożonego; SAT – satysfakcja z pracy; PRZ – przywiązanie afektywne; INT – intencja odejścia.
Co zrobić, gdy para nie przechodzi kontroli
Brak trafności różnicowej to wynik, a nie błąd do ukrycia. Postępuj w czterech krokach.
1. Wróć do teorii
Zapytaj, czy konstrukty mają być różne i jak silnego związku się spodziewasz. Satysfakcja z pracy to ocena samej pracy, a przywiązanie afektywne – więź z organizacją. Teoria uzasadnia ich rozdzielenie, ale nie wyklucza bardzo wysokiej korelacji. Ustal przed analizą, jaki próg przyjmujesz, i stosuj go do wszystkich par.
2. Przejrzyj pozycje
Szukaj pozycji, która mierzy oba konstrukty. Największy indeks modyfikacji dotyczy ładunku prz4 na czynniku SAT (MI = 26.51, oczekiwany ładunek standaryzowany .46). Treść pozycji („Lubię to, czym zajmuję się w tej firmie”) opisuje raczej satysfakcję z pracy niż więź z organizacją. Dopiero zgodność obu przesłanek, statystycznej i treściowej, uzasadnia zmianę.
Po usunięciu prz4 model pasował bardzo dobrze: χ²(71) = 61.72, p = .776, CFI = 1.000, RMSEA = .000, SRMR = .023. Korelacja SAT–PRZ spadła do .819, 95% CI [.773, .865], a HTMT – do .821, 95% CI [.772, .865]. AVE przywiązania wzrosła z .696 do .744, więc kryterium Fornella–Larckera jest teraz spełnione: r² = .671. Rysunek 1 pokazuje, dlaczego to słaba pociecha.
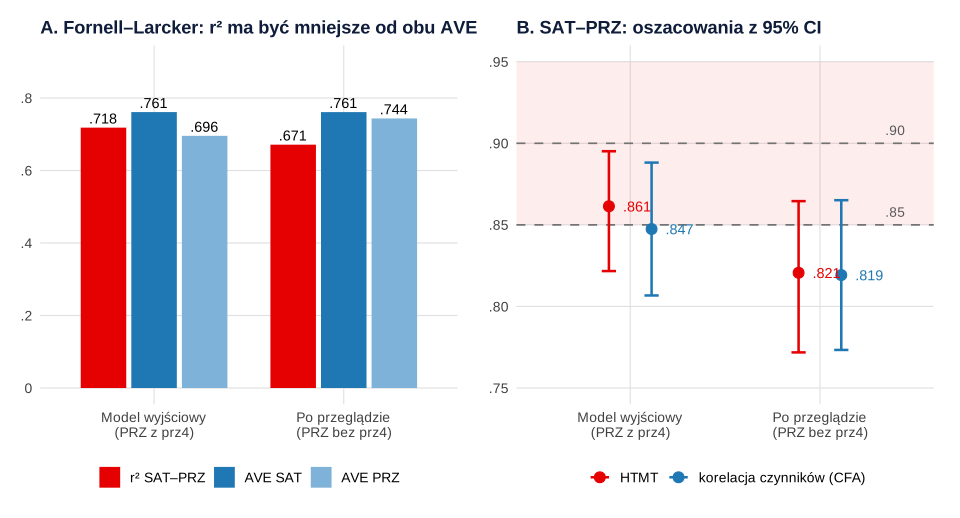
Kryterium Fornella–Larckera zmieniło werdykt, bo zmieniła się AVE, a nie dlatego, że konstrukty stały się wyraźnie odrębne. HTMT i przedział ufności pokazują to samo co wcześniej: korelacja jest wysoka, a górna granica przekracza .85. Zmiana wynikła z danych, więc w artykule pokaż oba modele, uzasadnij usunięcie pozycji jej treścią i sprawdź decyzję na nowej próbie.
3. Rozważ połączenie konstruktów
Model, w którym SAT i PRZ tworzą jeden czynnik, pasował wyraźnie gorzej: χ²(74) = 250.27, CFI = .941, RMSEA = .082, SRMR = .039. Skalowany test różnicy χ² dał Δχ²(3) = 211.25, p < .001. To jednak tylko dowód, że korelacja jest mniejsza niż 1, a nie że jest wystarczająco niska. Gdy teoria na to pozwala, alternatywą jest wspólny czynnik wyższego rzędu (zob. konstrukty wyższego rzędu). Jeśli zostawiasz oba czynniki jako predyktory w modelu strukturalnym, licz się ze skutkami współliniowości: niestabilnymi i trudnymi do interpretacji ścieżkami.
4. Opisz wynik uczciwie
Podaj wszystkie kryteria, przyjęte progi, decyzje o pozycjach i ich uzasadnienie. Wysoką korelację SAT–PRZ omów w dyskusji i w ograniczeniach badania. Nie wybieraj kryterium, które akurat daje korzystny wynik. Recenzenci coraz częściej o to pytają, co pokazuje zestawienie typowych zarzutów recenzentów do statystyki.
Jak opisać trafność zbieżną i różnicową (APA)
W tekście podaj estymator, zakres ładunków, AVE i CR każdej skali oraz kryteria trafności różnicowej z progami. Pełne wartości umieść w tabeli jak Tabela 1. Wzór tabeli rzetelności znajdziesz w haśle tabela rzetelności skal w APA.
Jeśli recenzent zakwestionował trafność różnicową Twoich skal, możemy wspólnie przejrzeć model pomiarowy i przygotować odpowiedź w ramach wsparcia statystycznego dla badaczy.
Przykład w R
Dwa przepisy uruchamiane po kolei w jednej sesji. Pierwszy tworzy dane, dopasowuje model i liczy AVE, CR, kryterium Fornella–Larckera i HTMT. Drugi pokazuje przegląd pozycji, model bez prz4 i model z połączonymi czynnikami. Potrzebne są pakiety lavaan, semTools i MASS. Bootstrap trwa około minuty.
1. AVE, CR, Fornell–Larcker i HTMT
R
# Dane symulowane: ankieta pracowników (N = 350), cztery skale 1–7:
# wsparcie przełożonego (WP, wp1–wp4), satysfakcja z pracy (SAT, sat1–sat4),
# przywiązanie afektywne do organizacji (PRZ, prz1–prz4), intencja odejścia (INT, int1–int3)
library(lavaan)
library(semTools)
set.seed(1722)
N <- 350
Phi <- matrix(c(1, .45, .40, -.30,
                .45, 1, .80, -.50,
                .40, .80, 1, -.55,
                -.30, -.50, -.55, 1), 4, dimnames = list(c("WP", "SAT", "PRZ", "INT"), c("WP", "SAT", "PRZ", "INT")))
eta <- MASS::mvrnorm(N, rep(0, 4), Phi)
L <- matrix(0, 15, 4, dimnames = list(c(paste0("wp", 1:4), paste0("sat", 1:4), paste0("prz", 1:4), paste0("int", 1:3)), colnames(Phi)))
L[1:4, "WP"] <- c(.80, .75, .70, .65)
L[5:8, "SAT"] <- c(.90, .88, .88, .85)
L[9:12, "PRZ"] <- c(.90, .88, .86, .45)
L[12, "SAT"] <- .40             # prz4 („Lubię to, czym zajmuję się w tej firmie”) mierzy też satysfakcję
L[13:15, "INT"] <- c(.85, .80, .75)
wspolna <- rowSums((L %*% Phi) * L)
ystar <- eta %*% t(L) + matrix(rnorm(N * 15), N) %*% diag(sqrt(1 - wspolna))
dane <- as.data.frame(pmin(pmax(round(4 + 1.3 * ystar), 1), 7))

model <- '
  WP  =~ wp1 + wp2 + wp3 + wp4
  SAT =~ sat1 + sat2 + sat3 + sat4
  PRZ =~ prz1 + prz2 + prz3 + prz4
  INT =~ int1 + int2 + int3
'
fit <- cfa(model, data = dane, estimator = "MLR")
round(fitMeasures(fit, c("chisq.scaled", "df", "pvalue.scaled", "cfi.robust", "tli.robust", "rmsea.robust", "srmr")), 3)

# 1. AVE i rzetelność złożona (CR) ręcznie z ładunków standaryzowanych
s <- standardizedSolution(fit)
lad <- s[s$op == "=~", c("lhs", "rhs", "est.std")]
rcz <- t(sapply(split(lad$est.std, lad$lhs), function(l)
  c(min = min(l), max = max(l), AVE = mean(l^2), CR = sum(l)^2 / (sum(l)^2 + sum(1 - l^2)))))
print(round(rcz[colnames(Phi), ], 3))
# to samo w semTools (AVE oraz omega z macierzy modelu)
round(rbind(AVE = AVE(fit), omega = unlist(compRelSEM(fit))), 3)

# 2. Korelacje czynników z 95% CI i kryterium Fornella–Larckera (√AVE na przekątnej)
kor <- s[s$op == "~~" & s$lhs != s$rhs, c("lhs", "rhs", "est.std", "ci.lower", "ci.upper")]
print(cbind(kor[1:2], round(kor[3:5], 3)), row.names = FALSE)
FL <- lavInspect(fit, "cor.lv")
diag(FL) <- sqrt(rcz[rownames(FL), "AVE"])
print(round(FL, 3))
# para przechodzi FL, gdy kwadrat korelacji < mniejszej z dwóch AVE
kor$r2 <- kor$est.std^2
kor$min_AVE <- pmin(rcz[kor$lhs, "AVE"], rcz[kor$rhs, "AVE"])
kor$FL_ok <- kor$r2 < kor$min_AVE
print(cbind(kor[1:2], round(kor[c(3, 6, 7)], 3), FL_ok = kor$FL_ok), row.names = FALSE)

# 3. HTMT (średnia arytmetyczna, Henseler i in., 2015) i HTMT2 (średnia geometryczna, Roemer i in., 2021)
H1 <- htmt(model, data = dane, htmt2 = FALSE)
H2 <- htmt(model, data = dane, htmt2 = TRUE)
round(H1, 3); round(H2, 3)

# 4. Bootstrapowy 95% CI dla HTMT pary SAT–PRZ (2000 prób)
B <- 2000
htmt_b <- replicate(B, { d <- dane[sample(N, replace = TRUE), ]; htmt(model, data = d, htmt2 = FALSE)["PRZ", "SAT"] })
round(c(HTMT = H1["PRZ", "SAT"], quantile(htmt_b, c(.025, .975))), 3)
Wynik w R
 chisq.scaled            df pvalue.scaled    cfi.robust    tli.robust
      107.087        84.000         0.045         0.993         0.991
 rmsea.robust          srmr
        0.028         0.029
      min   max   AVE    CR
WP  0.597 0.781 0.515 0.808
SAT 0.853 0.897 0.761 0.927
PRZ 0.772 0.870 0.696 0.901
INT 0.718 0.834 0.611 0.824
         WP   SAT   PRZ   INT
AVE   0.516 0.762 0.697 0.612
omega 0.809 0.928 0.905 0.825
 lhs rhs est.std ci.lower ci.upper
  WP SAT   0.448    0.341    0.554
  WP PRZ   0.438    0.331    0.544
  WP INT  -0.285   -0.401   -0.169
 SAT PRZ   0.847    0.807    0.888
 SAT INT  -0.487   -0.585   -0.389
 PRZ INT  -0.524   -0.619   -0.428
        WP    SAT    PRZ    INT
WP   0.718
SAT  0.448  0.872
PRZ  0.438  0.847  0.834
INT -0.285 -0.487 -0.524  0.781
 lhs rhs est.std    r2 min_AVE FL_ok
  WP SAT   0.448 0.200   0.515  TRUE
  WP PRZ   0.438 0.192   0.515  TRUE
  WP INT  -0.285 0.081   0.515  TRUE
 SAT PRZ   0.847 0.718   0.696 FALSE
 SAT INT  -0.487 0.237   0.611  TRUE
 PRZ INT  -0.524 0.274   0.611  TRUE
       WP   SAT   PRZ   INT
WP  1.000
SAT 0.452 1.000
PRZ 0.448 0.861 1.000
INT 0.290 0.485 0.541 1.000
       WP   SAT   PRZ   INT
WP  1.000
SAT 0.451 1.000
PRZ 0.446 0.862 1.000
INT 0.284 0.483 0.541 1.000
 HTMT  2.5% 97.5%
0.861 0.822 0.895
2. Przegląd pozycji, model bez prz4 i połączenie czynników
R
# Kontynuacja przepisu 1 (te same dane): co zrobić, gdy para SAT–PRZ nie przechodzi kontroli trafności różnicowej
# a) przegląd pozycji: indeksy modyfikacji wskazujące ładunki krzyżowe
mi <- modindices(fit, sort. = TRUE)
print(head(mi[mi$op == "=~", c("lhs", "op", "rhs", "mi", "sepc.all")], 4), row.names = FALSE)

# b) model bez prz4 (decyzja po przeglądzie treści pozycji, nie tylko po indeksie modyfikacji)
model_b <- '
  WP  =~ wp1 + wp2 + wp3 + wp4
  SAT =~ sat1 + sat2 + sat3 + sat4
  PRZ =~ prz1 + prz2 + prz3
  INT =~ int1 + int2 + int3
'
fit_b <- cfa(model_b, data = dane, estimator = "MLR")
round(fitMeasures(fit_b, c("chisq.scaled", "df", "pvalue.scaled", "cfi.robust", "tli.robust", "rmsea.robust", "srmr")), 3)
sb <- standardizedSolution(fit_b)
round(unlist(sb[sb$op == "~~" & sb$lhs == "SAT" & sb$rhs == "PRZ", c("est.std", "ci.lower", "ci.upper")]), 3)
lb <- sb[sb$op == "=~", ]
ave_b <- tapply(lb$est.std^2, lb$lhs, mean)      # AVE z ładunków, jak w przepisie 1
round(ave_b[c("WP", "SAT", "PRZ", "INT")], 3)
round(c(r2_SAT_PRZ = sb[sb$op == "~~" & sb$lhs == "SAT" & sb$rhs == "PRZ", "est.std"]^2), 3)
round(htmt(model_b, data = dane, htmt2 = FALSE)["PRZ", "SAT"], 3)
htmt_bb <- replicate(B, { d <- dane[sample(N, replace = TRUE), ]; htmt(model_b, data = d, htmt2 = FALSE)["PRZ", "SAT"] })
round(quantile(htmt_bb, c(.025, .975)), 3)

# c) czy SAT i PRZ to jeden konstrukt? Model z połączonym czynnikiem a model czterech czynników (bez prz4)
model_c <- '
  WP  =~ wp1 + wp2 + wp3 + wp4
  SATPRZ =~ sat1 + sat2 + sat3 + sat4 + prz1 + prz2 + prz3
  INT =~ int1 + int2 + int3
'
fit_c <- cfa(model_c, data = dane, estimator = "MLR")
round(fitMeasures(fit_c, c("chisq.scaled", "df", "cfi.robust", "rmsea.robust", "srmr")), 3)
lavTestLRT(fit_b, fit_c)
Wynik w R
 lhs op  rhs     mi sepc.all
 SAT =~ prz4 26.514    0.464
 SAT =~ prz3 12.710   -0.301
 INT =~ prz4  9.242   -0.152
  WP =~ prz2  2.946   -0.073
 chisq.scaled            df pvalue.scaled    cfi.robust    tli.robust
       61.723        71.000         0.776         1.000         1.004
 rmsea.robust          srmr
        0.000         0.023
 est.std ci.lower ci.upper
   0.819    0.773    0.865
   WP   SAT   PRZ   INT
0.515 0.761 0.744 0.611
r2_SAT_PRZ
     0.671
[1] 0.821
 2.5% 97.5%
0.772 0.865
chisq.scaled           df   cfi.robust rmsea.robust         srmr
     250.265       74.000        0.941        0.082        0.039

Scaled Chi-Squared Difference Test (method = “satorra.bentler.2001”)

lavaan->lavTestLRT():
   lavaan NOTE: The “Chisq” column contains standard test statistics, not the
   robust test that should be reported per model. A robust difference test is
   a function of two standard (not robust) statistics.

      Df   AIC   BIC  Chisq Chisq diff   RMSEA Df diff Pr(>Chisq)
fit_b 71 13800 13931  61.19
fit_c 74 13980 14099 246.97     211.25 0.41763       3  < 2.2e-16 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7.2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- semTools (wersja 0.5-8): Jorgensen, T. D., Pornprasertmanit, S., Schoemann, A. M., & Rosseel, Y. (2026). semTools: Useful tools for structural equation modeling (R package version 0.5-8) [Computer software]. https://CRAN.R-project.org/package=semTools
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://www.stats.ox.ac.uk/pub/MASS4/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Dobre dopasowanie jako dowód trafności. W przykładzie CFI = .993, a jedna para konstruktów była trudna do odróżnienia.
- Tylko kryterium Fornella–Larckera. Zależy od AVE, pomija niepewność i łatwo zmienia werdykt. Podawaj je najwyżej obok HTMT i przedziału ufności korelacji.
- Porównanie korelacji tylko z wyższą AVE. Kryterium wymaga, by kwadrat korelacji był mniejszy od obu AVE.
- Próg wybrany po analizie, np. .90 zamiast .85, bo przy .85 wynik jest niekorzystny.
- Usuwanie pozycji wyłącznie według indeksów modyfikacji, bez oceny treści i bez informacji w raporcie.
- Test χ² dla korelacji równej 1 jako dowód trafności. Odrzucenie r = 1 mówi tylko, że konstrukty nie są identyczne.
Kolejne kroki budowy modelu znajdziesz w przewodnikach modelowanie równań strukturalnych i psychometria i budowa skal. Cały model CB-SEM z efektem pośrednim pokazuje wpis CB-SEM w R (lavaan), a te same kryteria w PLS-SEM – PLS-SEM krok po kroku.
Najczęstsze pytania
Jak policzyć AVE i rzetelność złożoną w lavaan?
Weź standaryzowane ładunki z standardizedSolution(). AVE to średnia ich kwadratów, a CR = (Σλ)² / [(Σλ)² + Σ(1 − λ²)]. To samo dają funkcje AVE() i compRelSEM() z pakietu semTools; różnice w trzecim miejscu po przecinku wynikają ze sposobu liczenia mianownika.
Dlaczego kryterium Fornella–Larckera jest krytykowane?
W symulacji Henselera i in. (2015) kryterium Fornella–Larckera i ładunki krzyżowe często nie wykrywały braku trafności różnicowej. Cheung i in. (2024) zwracają uwagę, że wysoka AVE toleruje wysokie korelacje, a kryterium pomija błąd próbkowania. W przykładzie usunięcie jednej pozycji zmieniło werdykt, choć korelacja konstruktów wciąż przekraczała .80.
Jak policzyć przedział ufności dla HTMT?
Wylosuj ze zwracaniem wiele prób bootstrapowych (np. 2000), w każdej policz semTools::htmt() i weź percentyle 2.5 i 97.5. W przykładzie HTMT pary satysfakcja–przywiązanie wyniósł .861, 95% CI [.822, .895]. Porównaj górną granicę z progiem ustalonym przed analizą.
Czym różni się HTMT2 od klasycznego HTMT?
HTMT2 używa średnich geometrycznych zamiast arytmetycznych, więc nie zakłada równych ładunków. Roemer i in. (2021) wykazali, że jest mniej obciążony przy niejednorodnych ładunkach. Można go policzyć tylko przy dodatnich korelacjach wskaźników; w semTools jest domyślny (htmt2 = TRUE).
Czy usunąć pozycję, żeby poprawić trafność różnicową?
Tylko wtedy, gdy statystyka (np. indeks modyfikacji ładunku krzyżowego) i treść pozycji wskazują, że mierzy ona także inny konstrukt. Pokaż w artykule model przed zmianą i po niej oraz uzasadnij decyzję. Najlepiej sprawdź ją na nowej próbie, bo zmiana wynika z tych samych danych.
Powiązane hasła
Przeczytaj też
CB-SEM w R (lavaan)
Kompletny przykład w lavaan 0.7 na danych do pobrania: CFA z MLR i FIML, dopasowanie, omega i AVE, efekt pośredni z bootstrapem i tabela APA.
Czytaj →PoradnikKategorialna CFA: WLSMV w lavaan
Kiedy pozycje Likerta są porządkowe, jak czytać progi, ML, MLR i WLSMV na tych samych danych, indeksy robust, rzadkie kategorie i opis APA.
Czytaj →PoradnikModelowanie zmiennych i konstruktów wyższego rzędu
Jak odróżnić wspólny czynnik od kompozytu, wybrać typ modelu drugiego rzędu, zwalidować obie warstwy i poprawnie opisać wynik.
Czytaj →Recenzent pyta o trafność różnicową, a dwie skale korelują zbyt silnie?
Pomożemy policzyć AVE, rzetelność złożoną i HTMT z przedziałami ufności, przejrzeć model pomiarowy i przygotować uczciwy opis wyników, który samodzielnie przedstawisz i obronisz.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Cheung, G. W., Cooper-Thomas, H. D., Lau, R. S., & Wang, L. C. (2024). Reporting reliability, convergent and discriminant validity with structural equation modeling: A review and best-practice recommendations. Asia Pacific Journal of Management, 41(2), 745–783. https://doi.org/10.1007/s10490-023-09871-y ● Otwarty dostęp
- Fornell, C., & Larcker, D. F. (1981). Evaluating structural equation models with unobservable variables and measurement error. Journal of Marketing Research, 18(1), 39–50. https://doi.org/10.1177/002224378101800104
- Franke, G., & Sarstedt, M. (2019). Heuristics versus statistics in discriminant validity testing: A comparison of four procedures. Internet Research, 29(3), 430–447. https://doi.org/10.1108/intr-12-2017-0515
- Henseler, J., Ringle, C. M., & Sarstedt, M. (2015). A new criterion for assessing discriminant validity in variance-based structural equation modeling. Journal of the Academy of Marketing Science, 43(1), 115–135. https://doi.org/10.1007/s11747-014-0403-8 ● Otwarty dostęp
- Raykov, T. (1997). Estimation of composite reliability for congeneric measures. Applied Psychological Measurement, 21(2), 173–184. https://doi.org/10.1177/01466216970212006
- Roemer, E., Schuberth, F., & Henseler, J. (2021). HTMT2–an improved criterion for assessing discriminant validity in structural equation modeling. Industrial Management & Data Systems, 121(12), 2637–2650. https://doi.org/10.1108/imds-02-2021-0082 ● Otwarty dostęp
- Rönkkö, M., & Cho, E. (2022). An updated guideline for assessing discriminant validity. Organizational Research Methods, 25(1), 6–14. https://doi.org/10.1177/1094428120968614 ● Otwarty dostęp
- Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2). https://doi.org/10.18637/jss.v048.i02 ● Otwarty dostęp
Cytowania BibTeX
@article{cheung2024reporting, author={Cheung, Gordon W. and Cooper-Thomas, Helena D. and Lau, Rebecca S. and Wang, Linda C.}, title={{Reporting reliability, convergent and discriminant validity with structural equation modeling: A review and best-practice recommendations}}, journal={Asia Pacific Journal of Management}, year={2024}, volume={41}, number={2}, pages={745--783}, doi={10.1007/s10490-023-09871-y}}@article{fornell1981evaluating, author={Fornell, Claes and Larcker, David F.}, title={{Evaluating structural equation models with unobservable variables and measurement error}}, journal={Journal of Marketing Research}, year={1981}, volume={18}, number={1}, pages={39--50}, doi={10.1177/002224378101800104}}@article{franke2019heuristics, author={Franke, George and Sarstedt, Marko}, title={{Heuristics versus statistics in discriminant validity testing: A comparison of four procedures}}, journal={Internet Research}, year={2019}, volume={29}, number={3}, pages={430--447}, doi={10.1108/intr-12-2017-0515}}@article{henseler2015new, author={Henseler, Jörg and Ringle, Christian M. and Sarstedt, Marko}, title={{A new criterion for assessing discriminant validity in variance-based structural equation modeling}}, journal={Journal of the Academy of Marketing Science}, year={2015}, volume={43}, number={1}, pages={115--135}, doi={10.1007/s11747-014-0403-8}}@article{raykov1997estimation, author={Raykov, Tenko}, title={{Estimation of composite reliability for congeneric measures}}, journal={Applied Psychological Measurement}, year={1997}, volume={21}, number={2}, pages={173--184}, doi={10.1177/01466216970212006}}@article{roemer2021htmt2, author={Roemer, Ellen and Schuberth, Florian and Henseler, J{\"o}rg}, title={{HTMT2–an improved criterion for assessing discriminant validity in structural equation modeling}}, journal={Industrial Management \& Data Systems}, year={2021}, volume={121}, number={12}, pages={2637--2650}, doi={10.1108/imds-02-2021-0082}}@article{ronkko2022updated, author={Rönkkö, Mikko and Cho, Eunseong}, title={{An updated guideline for assessing discriminant validity}}, journal={Organizational Research Methods}, year={2022}, volume={25}, number={1}, pages={6--14}, doi={10.1177/1094428120968614}}@article{rosseel2012lavaan, author={Rosseel, Yves}, title={{lavaan: An R package for structural equation modeling}}, journal={Journal of Statistical Software}, year={2012}, volume={48}, number={2}, doi={10.18637/jss.v048.i02}}