Co to są indeksy modyfikacji?
Indeks modyfikacji (ang. modification index, MI) to przewidywany spadek statystyki χ² modelu SEM, jeśli uwolnimy jeden parametr ustalony dotąd na zero (np. ładunek krzyżowy albo kowariancję reszt) albo zniesiemy jedno ograniczenie równości. Sörbom (1989) opisał MI jako wskazówkę w poszukiwaniu „lepszego” modelu. Mierzy on, o ile zmniejszy się rozbieżność między modelem a danymi, z uwzględnieniem zmian wszystkich pozostałych parametrów. Technicznie MI to test mnożników Lagrange'a (test punktowy). Ma w przybliżeniu rozkład χ² z jednym stopniem swobody, więc MI > 3.84 odpowiada istotności na poziomie α = .05.
Programy podają MI razem z oczekiwaną zmianą parametru (EPC, ang. expected parameter change). EPC to przybliżona wartość, jaką przyjmie uwolniony parametr. Jego standaryzowana wersja (SEPC) pokazuje wielkość zmiany w jednostkach korelacji albo ładunku standaryzowanego. MI mówi, czy zmiana byłaby istotna, a SEPC – czy byłaby duża. W lavaan obie wartości daje funkcja modindices(), a w AMOS – okno Modification Indices.
MI to przybliżenie testu różnicy χ² między modelem obecnym a modelem z jednym dodatkowym parametrem. Jego zaleta polega na tym, że nie trzeba szacować drugiego modelu: program liczy MI dla wszystkich ustalonych parametrów naraz, na podstawie jednego dopasowania. Lista obejmuje ładunki krzyżowe (np. czy ładunek pozycji na drugim czynniku powinien być różny od zera), kowariancje reszt, ścieżki w części strukturalnej i ograniczenia równości. Te ostatnie są ważne w analizie wielogrupowej: test punktowy wskazuje, które równości ładunków albo wyrazów wolnych najbardziej pogarszają dopasowanie (zob. inwariancja pomiaru w CB-SEM).
Dlaczego z MI trzeba korzystać ostrożnie?
Model niedopasowany kusi, by uwalniać parametry z najwyższym MI, aż wskaźniki przekroczą progi. To jednak modyfikacja oparta na danych. MacCallum i in. (1992) pokazali, że takie modyfikacje są podatne na przypadkowe cechy próby. W powtarzanych próbach z tych samych danych sekwencje zmian okazywały się bardzo niespójne. Autorzy zalecają więc porównywanie kilku modeli określonych przed analizą.
Dwa dodatkowe problemy:
- Wielkość MI zależy od liczebności próby. Przy dużym N nawet mały pominięty parametr daje wysoki MI. Saris i in. (2009) proponują oceniać błędy specyfikacji łącznie przez MI, EPC i moc testu MI, zamiast patrzeć tylko na MI.
- MI wskazuje także parametry bez sensu merytorycznego. Kaplan (1989) zauważył, że MI częściej sugeruje uwolnienie parametrów nieuzasadnionych teorią, a EPC i SEPC – parametrów interesujących. W symulacji Whittaker (2012) poleganie na SEPC częściej niż na samym MI prowadziło do poprawnego modelu CFA.
Problem powiększa liczba testów. W modelu dwóch czynników z dziesięcioma pozycjami lavaan sprawdza 55 możliwych modyfikacji. W symulacji z kodu niżej model był dokładnie poprawny, a mimo to w 89.3% prób (N = 300) największy MI przekraczał 3.84. W 8.3% prób przekraczał nawet 10. Średni największy MI wynosił 6.45. To ten sam mechanizm co problem wielokrotnych porównań.
Przykład: lęk przed oceną i unikanie sytuacji społecznych
400 osób (dane symulowane) wypełniło po pięć pozycji lęku przed oceną (o1–o5) i unikania sytuacji społecznych (u1–u5). Model dwuczynnikowy CFA jest dopasowany przeciętnie: χ²(34) = 86.35, p < .001, CFI = .962, TLI = .949, RMSEA = .062, SRMR = .056. W populacji model ma dwa błędy specyfikacji. Pozycje u2 i u4 są podobnie sformułowane, więc ich reszty korelują. Pozycja o5 („unikam rozmów, w których mogę zostać oceniony”) ładuje też na unikaniu. Rysunek 1 pokazuje dziesięć największych MI.
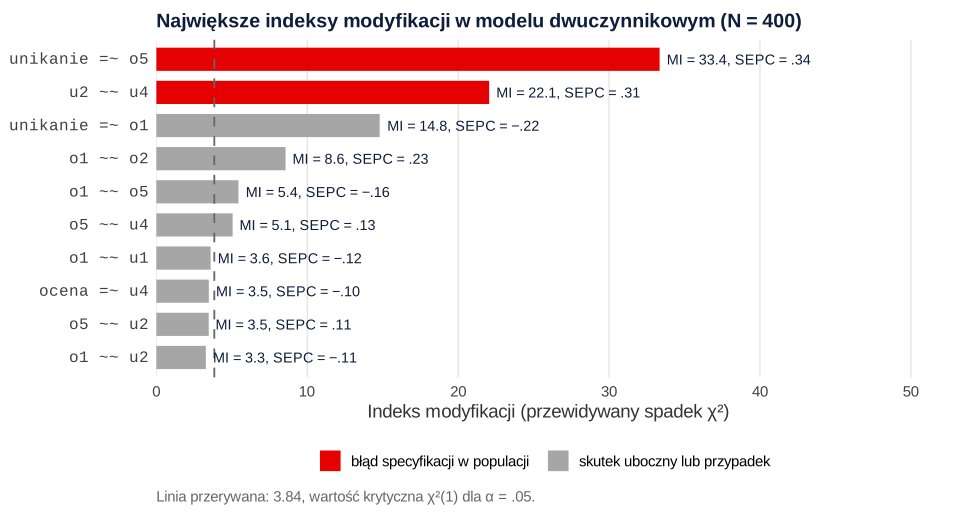
=~ ładunek, ~~ kowariancja reszt. Obliczenia: R (dane symulowane).Oba prawdziwe błędy mają najwyższe MI (33.35 i 22.05) i duże SEPC (.34 i .31). Trzeci na liście jest jednak ładunek o1 na unikaniu (MI = 14.80, SEPC = −.22), którego w populacji nie ma. To skutek uboczny: pominięty ładunek o5 zniekształca pozostałe oszacowania, a MI „rozlewa” się na sąsiednie parametry.
Jak postąpić rozsądnie? Uwalniaj parametry pojedynczo i tylko z uzasadnieniem treściowym.
- Kowariancja reszt u2 i u4 ma uzasadnienie: pozycje mają niemal identyczne sformułowanie. Po jej uwolnieniu χ²(33) = 65.65, a test różnicy dał Δχ²(1) = 20.70, p < .001. Spadek był podobny, choć nie identyczny z przewidywanym (MI = 22.05). Korelacja reszt wyniosła .27.
- Ładunek krzyżowy o5 też ma uzasadnienie, bo treść pozycji dotyczy unikania. Po jego uwolnieniu model jest dobrze dopasowany: χ²(32) = 34.59, p = .345, CFI = .998, RMSEA = .014, SRMR = .030. Pozycja o5 ładuje oba czynniki (.43 i .31).
- Ładunek o1 na unikaniu nadal ma MI = 7.29, ale małe SEPC (−.15) i brak uzasadnienia. Tu należy się zatrzymać. Kolejna zmiana poprawiłaby dopasowanie w tej próbie, ale przypuszczalnie nie powtórzyłaby się w innej.
Jak opisać modyfikacje modelu w pracy (APA)
Opisz każdą modyfikację: na podstawie czego ją rozważano (MI, SEPC), jakie miała uzasadnienie merytoryczne i jak zmieniło się dopasowanie. Zaznacz też, że model końcowy jest częściowo eksploracyjny. Wzór:
Tabelę modeli wyjściowego i końcowego przygotujesz według wzoru tabeli dopasowania modelu CFA w APA. Jak wpisać modyfikacje w szerszą procedurę oceny modelu, pokazuje poradnik CB-SEM krok po kroku. Testy punktowe dla ograniczeń równości wykorzystuje się też przy częściowej inwariancji (inwariancja pomiaru krok po kroku).
Przykład w R
Kod tworzy dane z przykładu i szacuje model wyjściowy. Wypisuje MI z EPC i SEPC, uwalnia kolejno dwa uzasadnione parametry i porównuje modele. Na końcu symuluje, jak często poprawny model daje MI powyżej 3.84 (300 prób; trwa kilkanaście sekund).
modindices() w lavaan krok po kroku
R
# Indeksy modyfikacji (MI) i oczekiwana zmiana parametru (EPC, SEPC) w lavaan
library(lavaan)

# Model populacyjny: lęk przed oceną (o1–o5) i unikanie sytuacji społecznych (u1–u5).
# Dwa błędy specyfikacji, których badacz nie uwzględnił: u2 i u4 mają podobne sformułowanie
# (kowariancja reszt), a o5 ładuje także na unikaniu.
pop <- '
  ocena    =~ 0.75*o1 + 0.70*o2 + 0.70*o3 + 0.65*o4 + 0.45*o5
  unikanie =~ 0.70*u1 + 0.65*u2 + 0.75*u3 + 0.65*u4 + 0.70*u5 + 0.30*o5
  ocena ~~ 0.50*unikanie
  u2 ~~ 0.20*u4
'
model <- '
  ocena    =~ o1 + o2 + o3 + o4 + o5
  unikanie =~ u1 + u2 + u3 + u4 + u5
'
set.seed(113)
dane <- simulateData(pop, sample.nobs = 400, standardized = TRUE)   # dane symulowane

f0 <- cfa(model, data = dane)
miary <- c("chisq", "df", "pvalue", "cfi", "tli", "rmsea", "srmr")
round(fitMeasures(f0, miary), 3)

# 1. Lista MI posortowana malejąco, z EPC i standaryzowanym EPC (sepc.all)
mi <- modindices(f0, sort. = TRUE)
print(head(mi[, c("lhs", "op", "rhs", "mi", "epc", "sepc.all")], 10), digits = 3, row.names = FALSE)
saveRDS(head(mi[, c("lhs", "op", "rhs", "mi", "sepc.all")], 10), "mi-top10.rds")

# 2. Uwolnienie jednego parametru uzasadnionego treścią pozycji (u2 i u4 – podobne sformułowanie)
f1 <- cfa(paste(model, "\nu2 ~~ u4"), data = dane)
round(fitMeasures(f1, miary), 3)
lavTestLRT(f1, f0)
mi1 <- modindices(f1, sort. = TRUE)
print(head(mi1[, c("lhs", "op", "rhs", "mi", "epc", "sepc.all")], 5), digits = 3, row.names = FALSE)
# standaryzowana kowariancja reszt u2 ~~ u4 w modelu f1
st1 <- standardizedSolution(f1); print(st1[st1$lhs == "u2" & st1$rhs == "u4", c("lhs", "op", "rhs", "est.std", "pvalue")], digits = 3)

# 3. Ładunek krzyżowy o5 na unikaniu
f2 <- cfa(paste(model, "\nu2 ~~ u4\nunikanie =~ o5"), data = dane)
round(fitMeasures(f2, miary), 3)
st2 <- standardizedSolution(f2); print(st2[st2$rhs == "o5" & st2$op == "=~", c("lhs", "op", "rhs", "est.std", "pvalue")], digits = 3)
print(head(modindices(f2, sort. = TRUE)[, c("lhs", "op", "rhs", "mi", "sepc.all")], 3), digits = 3, row.names = FALSE)

# 4. Szansa przypadkowych modyfikacji: model POPRAWNY, 300 prób po 300 osób
pop_ok <- ' F1 =~ 0.7*y1 + 0.7*y2 + 0.7*y3 + 0.7*y4 + 0.7*y5
            F2 =~ 0.7*y6 + 0.7*y7 + 0.7*y8 + 0.7*y9 + 0.7*y10
            F1 ~~ 0.5*F2 '
m_ok <- ' F1 =~ y1 + y2 + y3 + y4 + y5
          F2 =~ y6 + y7 + y8 + y9 + y10 '
set.seed(1130)
maks <- replicate(300, {
  d <- simulateData(pop_ok, sample.nobs = 300, standardized = TRUE)
  max(modindices(cfa(m_ok, data = d))$mi)
})
round(c(sredni_max_MI = mean(maks), odsetek_max_MI_ponad_3.84 = mean(maks > 3.84),
        odsetek_max_MI_ponad_10 = mean(maks > 10)), 3)
cat("Liczba MI sprawdzanych w jednym modelu:", nrow(modindices(cfa(m_ok, data = d <- simulateData(pop_ok, sample.nobs = 300, standardized = TRUE)))), "\n")
Wynik w R
 chisq     df pvalue    cfi    tli  rmsea   srmr
86.349 34.000  0.000  0.962  0.949  0.062  0.056
      lhs op rhs    mi    epc sepc.all
 unikanie =~  o5 33.35  0.471    0.340
       u2 ~~  u4 22.05  0.154    0.308
 unikanie =~  o1 14.80 -0.324   -0.216
       o1 ~~  o2  8.56  0.111    0.230
       o1 ~~  o5  5.44 -0.082   -0.158
       o5 ~~  u4  5.05  0.068    0.128
       o1 ~~  u1  3.60 -0.056   -0.116
    ocena =~  u4  3.48 -0.139   -0.105
       o5 ~~  u2  3.47  0.056    0.108
       o1 ~~  u2  3.28 -0.054   -0.111
 chisq     df pvalue    cfi    tli  rmsea   srmr
65.650 33.000  0.001  0.976  0.967  0.050  0.053

Chi-Squared Difference Test

   Df     AIC   BIC  Chisq Chisq diff   RMSEA Df diff Pr(>Chisq)
f1 33  9983.6 10071 65.650
f0 34 10002.3 10086 86.349     20.699 0.22192       1  5.374e-06 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
      lhs op rhs    mi    epc sepc.all
 unikanie =~  o5 31.19  0.461    0.336
 unikanie =~  o1 13.93 -0.318   -0.215
       o1 ~~  o2  8.41  0.110    0.228
       o1 ~~  o5  5.37 -0.082   -0.157
       o1 ~~  u1  4.77 -0.064   -0.135
   lhs op rhs est.std pvalue
11  u2 ~~  u4   0.268      0
 chisq     df pvalue    cfi    tli  rmsea   srmr
34.585 32.000  0.345  0.998  0.997  0.014  0.030
        lhs op rhs est.std pvalue
5     ocena =~  o5   0.429      0
12 unikanie =~  o5   0.312      0
      lhs op rhs   mi sepc.all
 unikanie =~  o1 7.29   -0.150
       o1 ~~  u5 3.53    0.120
       o1 ~~  o2 3.48    0.165
            sredni_max_MI odsetek_max_MI_ponad_3.84   odsetek_max_MI_ponad_10
                    6.449                     0.893                     0.083
Liczba MI sprawdzanych w jednym modelu: 55
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7-2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Uwalnianie parametrów „do skutku”, aż CFI przekroczy .95. Model staje się dopasowany do tej próby, a nie do populacji (MacCallum i in., 1992).
- Kilka modyfikacji naraz. MI dotyczy jednego parametru przy pozostałych bez zmian. Po każdej zmianie MI trzeba policzyć od nowa, bo część z nich znika, jak było z ładunkiem o1.
- Patrzenie tylko na MI bez SEPC. Przy dużej próbie wysoki MI może dotyczyć bardzo małej korelacji reszt, której nie warto uwzględniać.
- Kowariancje reszt dla pozycji z różnych czynników albo bez wspólnej treści. Takie modyfikacje zmieniają znaczenie czynników (zob. kowariancja reszt w SEM).
- Raportowanie modelu po modyfikacjach jako konfirmacyjnego. Napisz wprost, które parametry dodano na podstawie danych. Jeśli to możliwe, sprawdź model w drugiej połowie próby albo w nowym badaniu.
- Szukanie przyczyn niedopasowania tylko w MI. Uzupełnij je macierzą reszt standaryzowanych i przeglądem treści pozycji. Gdy model jest źle dopasowany globalnie, rozważ zmianę liczby czynników (analiza czynnikowa EFA i CFA).
Najczęstsze pytania
Od jakiej wartości indeks modyfikacji jest istotny?
MI ma w przybliżeniu rozkład χ² z jednym stopniem swobody, więc MI > 3.84 odpowiada p < .05. Ten próg nie uwzględnia jednak liczby sprawdzanych parametrów. W symulacji na tej stronie poprawny model w 89.3% prób miał co najmniej jeden MI powyżej 3.84, więc o modyfikacji decyduj na podstawie SEPC i treści pozycji.
Co oznacza SEPC przy indeksie modyfikacji?
SEPC (standaryzowana oczekiwana zmiana parametru) to przybliżona wartość uwolnionego parametru w jednostkach standaryzowanych, np. korelacja reszt albo ładunek. MI mówi, czy zmiana poprawiłaby dopasowanie istotnie, a SEPC – czy byłaby duża. W lavaan to kolumna sepc.all.
Jak wyświetlić indeksy modyfikacji w lavaan?
Użyj modindices(model, sort. = TRUE), aby dostać listę posortowaną od największego MI, z kolumnami epc i sepc.all. Możesz ograniczyć ją do wartości powyżej progu: modindices(model, minimum.value = 10). Zapis =~ oznacza ładunek, a ~~ kowariancję.
Czy można dodawać kowariancje reszt na podstawie indeksów modyfikacji?
Tylko gdy masz uzasadnienie niezależne od danych, np. podobne sformułowanie pozycji, wspólny format albo ten sam wskaźnik w kolejnych pomiarach. Kowariancje dodawane po to, by poprawić wskaźniki, zmieniają znaczenie czynników i zwykle nie powtarzają się w innych próbach.
Dlaczego po uwolnieniu parametru spadek χ² różni się od indeksu modyfikacji?
MI to przybliżenie liczone w punkcie obecnych oszacowań, a po uwolnieniu parametru zmieniają się też inne parametry. W przykładzie na tej stronie MI wynosił 22.05, a rzeczywisty spadek χ² – 20.70. Przy dużych zmianach różnica może być większa.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
CB-SEM krok po kroku: założenia, dopasowanie i interpretacja
Praktyczny przewodnik po covariance-based SEM: identyfikacja, estymator, brakujące dane, ocena dopasowania, reszty, parametry i raport APA 7.
Czytaj →PoradnikAnaliza czynnikowa EFA i CFA: jak dobrać metodę i uniknąć błędów
EFA i CFA w praktyce: liczba czynników, metoda ekstrakcji, rotacja, ładunki, walidacja oraz najczęstsze błędy w analizie czynnikowej.
Czytaj →PoradnikInwariancja pomiaru krok po kroku
Wielogrupowa CFA w lavaan: model konfiguracyjny, metryczny, skalarny i ścisły, kryteria ΔCFI i ΔRMSEA, testy punktowe, częściowa inwariancja i opis APA.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Kaplan, D. (1989). Model modification in covariance structure analysis: Application of the expected parameter change statistic. Multivariate Behavioral Research, 24(3), 285–305. https://doi.org/10.1207/s15327906mbr2403_2
- MacCallum, R. C., Roznowski, M., & Necowitz, L. B. (1992). Model modifications in covariance structure analysis: The problem of capitalization on chance. Psychological Bulletin, 111(3), 490–504. https://doi.org/10.1037/0033-2909.111.3.490
- Saris, W. E., Satorra, A., & van der Veld, W. M. (2009). Testing structural equation models or detection of misspecifications? Structural Equation Modeling: A Multidisciplinary Journal, 16(4), 561–582. https://doi.org/10.1080/10705510903203433 ● Otwarty dostęp: pełny tekst
- Sörbom, D. (1989). Model modification. Psychometrika, 54(3), 371–384. https://doi.org/10.1007/bf02294623
- Whittaker, T. A. (2012). Using the modification index and standardized expected parameter change for model modification. The Journal of Experimental Education, 80(1), 26–44. https://doi.org/10.1080/00220973.2010.531299
Cytowania BibTeX
@article{kaplan1989model, author={Kaplan, David}, title={{Model modification in covariance structure analysis: Application of the expected parameter change statistic}}, journal={Multivariate Behavioral Research}, year={1989}, volume={24}, number={3}, pages={285--305}, doi={10.1207/s15327906mbr2403_2}}@article{maccallum1992model, author={MacCallum, Robert C. and Roznowski, Mary and Necowitz, Lawrence B.}, title={{Model modifications in covariance structure analysis: The problem of capitalization on chance}}, journal={Psychological Bulletin}, year={1992}, volume={111}, number={3}, pages={490--504}, doi={10.1037/0033-2909.111.3.490}}@article{saris2009testing, author={Saris, Willem E. and Satorra, Albert and van der Veld, William M.}, title={{Testing structural equation models or detection of misspecifications?}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2009}, volume={16}, number={4}, pages={561--582}, doi={10.1080/10705510903203433}}@article{sorbom1989model, author={Sörbom, Dag}, title={{Model modification}}, journal={Psychometrika}, year={1989}, volume={54}, number={3}, pages={371--384}, doi={10.1007/bf02294623}}@article{whittaker2012using, author={Whittaker, Tiffany A.}, title={{Using the modification index and standardized expected parameter change for model modification}}, journal={The Journal of Experimental Education}, year={2012}, volume={80}, number={1}, pages={26--44}, doi={10.1080/00220973.2010.531299}}