Co to jest trafność różnicowa?
Trafność różnicowa (ang. discriminant validity, czasem tłumaczona jako trafność dyskryminacyjna) to dowód, że miara jednego konstruktu jest empirycznie odróżnialna od miar innych konstruktów. Jeśli nowa skala wypalenia akademickiego koreluje z miarą depresji prawie tak silnie jak z inną skalą wypalenia, to nie wiadomo, czy mierzy wypalenie, czy po prostu ogólne złe samopoczucie.
Rönkkö i Cho (2022) proponują ogólną definicję: dwie miary mają trafność różnicową, gdy ich korelacja – po uwzględnieniu błędu pomiaru – jest wyraźnie niższa od 1. To ważne doprecyzowanie, bo surowe korelacje sum punktów są zaniżane przez nierzetelność i mogą ukryć problem. Trafność różnicowa jest jednym ze źródeł dowodów trafności testu i stanowi parę z trafnością zbieżną: pierwsza pyta, czy miara się odróżnia, druga – czy się zgadza z miarami tego samego konstruktu.
Uwaga na nazewnictwo. W części polskich podręczników „trafnością różnicową” nazywa się też co innego: zdolność testu do odróżniania grup, o których wiadomo, że różnią się cechą (np. osoby z diagnozą i bez niej). Na tej stronie chodzi o znaczenie przyjęte w modelowaniu równań strukturalnych i w literaturze anglojęzycznej.
Skąd się wzięła i dlaczego jest tak ważna
Pojęcie wprowadzili Campbell i Fiske (1959) razem z macierzą wielu cech i wielu metod (MTMM). W tej logice miara powinna korelować silniej z innymi miarami tej samej cechy niż z miarami innych cech, nawet gdy te mierzy się tą samą metodą. Kiedy różnicowanie zawodzi, pojawiają się trzy problemy:
- Zbędne konstrukty – badacz opisuje „nowe” zjawisko, które jest starym pod inną nazwą.
- Błędne wnioski o związkach – w modelu ścieżkowym dwa prawie identyczne predyktory dają niestabilne, a nawet przeciwne co do znaku współczynniki (zob. współliniowość).
- Sztucznie silne efekty – „związek” wypalenia z depresją w wysokości .88 może opisywać nakładanie się treści pozycji, a nie zależność między zjawiskami.
Jak sprawdza się trafność różnicową
| Metoda | Na czym polega | Uwagi |
|---|---|---|
| Przedział ufności korelacji czynników | W CFA sprawdzasz, czy górna granica 95% CI korelacji dwóch czynników leży wyraźnie poniżej 1; próg ustalasz z góry, często .85 lub .90 | Podejście zalecane przez Rönkkö i Cho (2022); opiera się na korelacji oczyszczonej z błędu |
| Kryterium Fornella–Larckera | AVE każdego czynnika powinna być większa niż kwadrat jego korelacji z innym czynnikiem | Klasyczne kryterium z pracy Fornella i Larckera (1981); w symulacjach często nie wykrywa problemu |
| HTMT | Stosunek średniej korelacji pozycji różnych konstruktów do średniej korelacji pozycji tego samego konstruktu | Henseler i in. (2015) pokazali, że w PLS-SEM radzi sobie lepiej niż Fornell–Larcker; najczęściej stosowane progi to .85 lub .90 |
| Test różnicy χ² (korelacja = 1) | Porównujesz model swobodny z modelem, w którym korelację czynników ustalono na 1 | Odrzucenie r = 1 to bardzo słaby dowód: wystarczy, że korelacja wynosi .95 |
| Ładunki krzyżowe | Każda pozycja ładuje swój czynnik silniej niż inne | Mało czułe – według Henselera i in. (2015) zawodzi w typowych sytuacjach |
Którą metodę wybrać? W CB-SEM najprostsza i najlepiej uzasadniona jest ocena przedziału ufności korelacji czynników, bo korzysta z oszacowań oczyszczonych z błędu pomiaru i od razu pokazuje niepewność. W PLS-SEM, gdzie nie ma korelacji czynników w tym sensie, standardem stało się HTMT. Kryterium Fornella–Larckera i ładunki krzyżowe podawaj najwyżej jako uzupełnienie, gdy wymaga tego czasopismo albo promotor. Niezależnie od metody próg ustal przed analizą i stosuj go do wszystkich par konstruktów.
Przykład: wypalenie, depresja i zaangażowanie
W badaniu 320 osób studiujących (dane symulowane) zastosowano trzy skale po cztery pozycje: wypalenie akademickie (WYP), objawy depresji (DEP) i zaangażowanie w naukę (ZAA). Trzyczynnikowy model CFA był dobrze dopasowany: χ²(51) = 60.25, CFI = .993, TLI = .991, RMSEA = .024, SRMR = .030. Dobre dopasowanie nie rozstrzyga jednak, czy czynniki są odróżnialne. To trzeba sprawdzić osobno:
| Para czynników | r [95% CI] | r² | Mniejsza AVE w parze | HTMT |
|---|---|---|---|---|
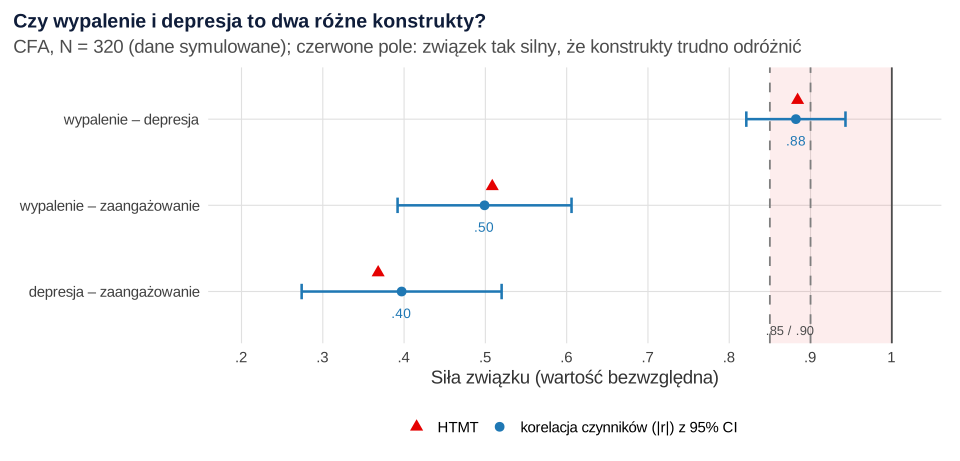
| Wypalenie – depresja | .88 [.82, .94] | .78 | .44 (DEP) | .88 |
| Wypalenie – zaangażowanie | −.50 [−.61, −.39] | .25 | .51 (ZAA) | .51 |
| Depresja – zaangażowanie | −.40 [−.52, −.27] | .16 | .44 (DEP) | .37 |
Pary z zaangażowaniem nie budzą wątpliwości. Para wypalenie–depresja zawodzi według każdego z trzech kryteriów: przedział korelacji sięga .94, kwadrat korelacji (.78) przekracza AVE obu czynników (.53 i .44), a HTMT wynosi .88. Mimo to test różnicy χ² odrzuca hipotezę, że korelacja wynosi 1: Δχ²(1) = 19.21, p < .001. Kto oparłby się tylko na tym teście, ogłosiłby trafność różnicową dwóch konstruktów, które dzielą prawie 80% wariancji. Szczegóły testu opisuje hasło test różnicy chi-kwadrat w SEM.
Co zrobić, gdy trafności różnicowej brakuje
- Wróć do treści pozycji. Sprawdź, czy w obu skalach nie ma niemal identycznych twierdzeń (np. „czuję się wyczerpany” i „nie mam energii”). Czasem wystarczy przeformułować lub usunąć kilka pozycji.
- Rozważ wspólne źródło wariancji. Gdy wszystkie skale pochodzą z jednego kwestionariusza samoopisowego, korelacje zawyża wspólna wariancja metody.
- Porównaj modele. Oszacuj model, w którym dwa czynniki połączono w jeden, albo model z czynnikiem wyższego rzędu. Decyzję uzasadnij teorią, nie samym dopasowaniem.
- Opisz problem otwarcie. W pracy dyplomowej lepiej napisać, że dwie skale mierzą w dużej mierze to samo, niż interpretować ich „związek” jako odkrycie.
Jak opisać trafność różnicową w pracy (APA)
Podaj korelacje czynników z 95% CI, a jeśli recenzenci tego oczekują (zwłaszcza przy PLS-SEM), także HTMT i porównanie AVE z kwadratami korelacji. Napisz, jakie progi przyjąłeś, i oceń każdą parę konstruktów osobno.
Gdzie umieścić te liczby w rozdziale wyników modelu pomiarowego, pokazują przewodniki CB-SEM krok po kroku i PLS-SEM krok po kroku.
Przykład w R
Kod szacuje trzyczynnikowy model CFA w pakiecie lavaan, a następnie ocenia trafność różnicową czterema sposobami: przedziałami ufności korelacji czynników, kryterium Fornella–Larckera, HTMT i testem różnicy χ². Liczby w tekście pochodzą z tego kodu.
Korelacje czynników, AVE, HTMT i test r = 1
R
# R161 – trafność różnicowa: wypalenie akademickie, objawy depresji i zaangażowanie (dane symulowane)
suppressPackageStartupMessages({library(lavaan); library(semTools); library(MASS)})
set.seed(161)
N <- 320
Phi <- matrix(c(1, .88, -.50,
                .88, 1, -.40,
                -.50, -.40, 1), 3)
F <- mvrnorm(N, rep(0, 3), Phi)
lad <- list(c(.78, .74, .70, .72), c(.76, .70, .73, .68), c(.75, .80, .71, .69))
X <- do.call(cbind, lapply(1:3, function(f) sapply(lad[[f]], function(l)
  findInterval(l * F[, f] + rnorm(N, 0, sqrt(1 - l^2)), c(-1.6, -0.6, 0.4, 1.4)) + 1)))
colnames(X) <- c(paste0("wyp", 1:4), paste0("dep", 1:4), paste0("zaa", 1:4))
dane <- as.data.frame(X)
model <- "WYP =~ wyp1 + wyp2 + wyp3 + wyp4
          DEP =~ dep1 + dep2 + dep3 + dep4
          ZAA =~ zaa1 + zaa2 + zaa3 + zaa4"
m <- cfa(model, data = dane, std.lv = TRUE)
round(fitMeasures(m, c("chisq", "df", "cfi", "tli", "rmsea", "srmr")), 3)

# 1. Korelacje czynników z 95% CI
ss <- standardizedSolution(m)
kor <- subset(ss, op == "~~" & lhs != rhs)[, c("lhs", "rhs", "est.std", "ci.lower", "ci.upper")]
kor[, 3:5] <- round(kor[, 3:5], 3); kor

# 2. Fornell–Larcker: AVE a kwadrat korelacji
lam <- subset(ss, op == "=~")
ave <- tapply(lam$est.std^2, lam$lhs, mean)
round(ave, 3)
round(kor$est.std^2, 3)

# 3. HTMT (na korelacjach pozycji)
round(htmt(model, data = dane), 3)

# 4. Test różnicy chi-kwadrat: korelacja WYP–DEP ustalona na 1
m1 <- suppressWarnings(cfa(paste(model, "\n WYP ~~ 1*DEP"), data = dane, std.lv = TRUE))   # model z r = 1 jest z definicji „na granicy”
anova(m1, m)
Wynik w R
 chisq     df    cfi    tli  rmsea   srmr
60.246 51.000  0.993  0.991  0.024  0.030
   lhs rhs est.std ci.lower ci.upper
28 WYP DEP   0.882    0.821    0.943
29 WYP ZAA  -0.499   -0.606   -0.392
30 DEP ZAA  -0.397   -0.520   -0.274
  DEP   WYP   ZAA
0.438 0.529 0.507
[1] 0.778 0.249 0.158
      WYP   DEP   ZAA
WYP 1.000
DEP 0.884 1.000
ZAA 0.508 0.368 1.000

Chi-Squared Difference Test

   Df    AIC    BIC  Chisq Chisq diff   RMSEA Df diff Pr(>Chisq)
m  51 9531.8 9633.5 60.246
m1 52 9549.0 9647.0 79.457     19.211 0.23856       1   1.17e-05 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3; model CFA oszacowano w pakiecie lavaan (estymator ML), HTMT policzono funkcją htmt() z pakietu semTools, dane wygenerowano funkcją mvrnorm() z pakietu MASS, a rysunek przygotowano w ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7-2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- semTools (wersja 0.5-8): Jorgensen, T. D., Pornprasertmanit, S., Schoemann, A. M., & Rosseel, Y. (2026). semTools: Useful tools for structural equation modeling (Version 0.5-8) [R package]. https://doi.org/10.32614/CRAN.package.semTools
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Test χ² przeciw korelacji równej 1 jako jedyny dowód. W przykładzie dał „istotny” wynik przy korelacji .88. Przy dużej próbie odrzuci r = 1 nawet przy .95.
- Surowe korelacje sum punktów zamiast korelacji czynników. Nierzetelność zaniża korelacje sum, więc problem może się ukryć. Rönkkö i Cho (2022) definiują trafność różnicową właśnie przez korelację po uwzględnieniu błędu pomiaru.
- Raportowanie samego kryterium Fornella–Larckera. Jest mało czułe, więc jego spełnienie nie wystarcza. Uzupełnij je przedziałami ufności korelacji lub HTMT.
- Sprawdzanie tylko par z „głównym” konstruktem. Oceń wszystkie pary w modelu, także dwie zmienne zależne.
- Mylenie dobrego dopasowania modelu z trafnością różnicową. Model z dwoma prawie identycznymi czynnikami może być świetnie dopasowany, tak jak w przykładzie (CFI = .993).
- Odwrócone pozycje w HTMT. HTMT liczy się na wartościach bezwzględnych korelacji, a pozycje odwrócone trzeba wcześniej przekodować.
Najczęstsze pytania
Jak sprawdzić trafność różnicową w CFA?
Oszacuj model z wszystkimi czynnikami i odczytaj korelacje czynników z 95% przedziałami ufności. Jeśli górna granica przedziału dla danej pary leży poniżej przyjętego z góry progu (często .85 lub .90), konstrukty są odróżnialne. Wynik możesz uzupełnić HTMT i porównaniem AVE z kwadratami korelacji.
Na czym polega kryterium Fornella–Larckera?
Kryterium wymaga, by średnia wyodrębniona wariancja (AVE) każdego czynnika była większa niż kwadrat jego korelacji z każdym innym czynnikiem. Na przykład przy korelacji .88 kwadrat wynosi .78, więc oba czynniki musiałyby mieć AVE powyżej .78. Kryterium bywa mało czułe, dlatego warto je uzupełnić HTMT lub przedziałami ufności korelacji.
Jaka wartość HTMT oznacza brak trafności różnicowej?
Najczęściej przyjmuje się progi .85 (ostrzejszy) lub .90 (łagodniejszy). HTMT powyżej progu sygnalizuje, że pozycje dwóch skal korelują ze sobą niemal tak samo jak pozycje jednej skali. W przykładzie wypalenia i depresji HTMT wyniosło .88, czyli przekroczyło próg .85.
Czym różni się trafność różnicowa od zbieżnej?
Trafność zbieżna pokazuje, że miara zgadza się z innymi miarami tego samego konstruktu, a trafność różnicowa – że da się ją odróżnić od miar innych konstruktów. Obie wywodzą się z macierzy wielu cech i wielu metod (MTMM) Campbella i Fiske’a i zwykle sprawdza się je razem.
Co zrobić, gdy dwie skale nie mają trafności różnicowej?
Sprawdź treść pozycji (czy nie powtarzają się niemal identyczne twierdzenia), rozważ wpływ wspólnej metody pomiaru i porównaj model z połączonymi czynnikami. Decyzję uzasadnij teorią. W pracy opisz problem otwarcie i nie interpretuj bardzo wysokiej korelacji jako związku między różnymi zjawiskami.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
CB-SEM – założenia i interpretacja
Identyfikacja, ML, MLR i WLSMV, test χ² i indeksy dopasowania bez magicznych progów, moc, modele równoważne i raport – z symulacjami w R.
Czytaj →PoradnikPLS-SEM krok po kroku
Logika kompozytów, założenia, ocena modelu refleksyjnego i formatywnego, ścieżki, f² i PLSpredict – na przykładzie z R, z tabelą progów i źródeł.
Czytaj →PoradnikJak zbudować i zwalidować skalę psychometryczną?
Od definicji konstruktu i tworzenia pozycji po pilotaż, EFA, CFA, rzetelność, trafność teoretyczną, różnicową i niezmienniczość.
Czytaj →PoradnikTrafność zbieżna i różnicowa: AVE i HTMT
AVE i rzetelność złożona z ładunków lavaan, HTMT z bootstrapem, krytyka Fornella–Larckera i co zrobić, gdy dwa konstrukty są trudne do odróżnienia.
Czytaj →PoradnikKalkulator AVE, CR i HTMT
AVE, rzetelność złożona i tabela Fornella–Larckera z ładunków oraz HTMT i HTMT2 z wklejonej macierzy korelacji. Zgodny z R i semTools.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Campbell, D. T., & Fiske, D. W. (1959). Convergent and discriminant validation by the multitrait-multimethod matrix. Psychological Bulletin, 56(2), 81–105. https://doi.org/10.1037/h0046016 ● Otwarty dostęp: pełny tekst
- Fornell, C., & Larcker, D. F. (1981). Evaluating structural equation models with unobservable variables and measurement error. Journal of Marketing Research, 18(1), 39–50. https://doi.org/10.1177/002224378101800104
- Henseler, J., Ringle, C. M., & Sarstedt, M. (2015). A new criterion for assessing discriminant validity in variance-based structural equation modeling. Journal of the Academy of Marketing Science, 43(1), 115–135. https://doi.org/10.1007/s11747-014-0403-8 ● Otwarty dostęp
- Rönkkö, M., & Cho, E. (2022). An updated guideline for assessing discriminant validity. Organizational Research Methods, 25(1), 6–14. https://doi.org/10.1177/1094428120968614 ● Otwarty dostęp
Cytowania BibTeX
@article{campbell1959convergent, author={Campbell, Donald T. and Fiske, Donald W.}, title={{Convergent and discriminant validation by the multitrait-multimethod matrix}}, journal={Psychological Bulletin}, year={1959}, volume={56}, number={2}, pages={81--105}, doi={10.1037/h0046016}}@article{fornell1981evaluating, author={Fornell, Claes and Larcker, David F.}, title={{Evaluating structural equation models with unobservable variables and measurement error}}, journal={Journal of Marketing Research}, year={1981}, volume={18}, number={1}, pages={39--50}, doi={10.1177/002224378101800104}}@article{henseler2015new, author={Henseler, Jörg and Ringle, Christian M. and Sarstedt, Marko}, title={{A new criterion for assessing discriminant validity in variance-based structural equation modeling}}, journal={Journal of the Academy of Marketing Science}, year={2015}, volume={43}, number={1}, pages={115--135}, doi={10.1007/s11747-014-0403-8}}@article{ronkko2022updated, author={Rönkkö, Mikko and Cho, Eunseong}, title={{An updated guideline for assessing discriminant validity}}, journal={Organizational Research Methods}, year={2022}, volume={25}, number={1}, pages={6--14}, doi={10.1177/1094428120968614}}