Co to jest test różnicy chi-kwadrat?
Test różnicy chi-kwadrat (Δχ², ang. chi-square difference test, także likelihood ratio test) porównuje dwa zagnieżdżone modele SEM. Odpowiada na pytanie, czy ograniczenia nałożone w modelu prostszym istotnie pogarszają dopasowanie. Model M0 jest zagnieżdżony w M1, jeśli powstaje z niego przez nałożenie ograniczeń: ustalenie parametru na 0, zrównanie dwóch parametrów albo ustalenie parametru na określonej wartości. Oba modele muszą być przy tym oszacowane na tych samych danych i dla tych samych zmiennych.
W psychologii test ten służy m.in. do sprawdzania, czy potrzebny jest efekt bezpośredni w modelu mediacji, czy dwa współczynniki ścieżek są równe i czy model pomiarowy jest taki sam w grupach (inwariancja pomiaru). Bentler i Bonett (1980) opisali sekwencyjne porównywanie modeli zagnieżdżonych jako uzupełnienie oceny pojedynczego modelu. Marsh i in. (2004) zauważają, że wskaźniki dopasowania lepiej sprawdzają się przy wykrywaniu różnic między modelami zagnieżdżonymi niż przy ocenie jednego modelu według progów.
Wzór i logika testu
Przy estymacji metodą największej wiarygodności (ML) i prawdziwej hipotezie zerowej (ograniczenia są w populacji spełnione) Δχ² ma w dużych próbach rozkład χ² z Δdf stopniami swobody. Δdf to liczba nałożonych ograniczeń. Istotny wynik oznacza, że ograniczenia pogarszają dopasowanie, więc należy wybrać model bardziej złożony. Wynik nieistotny przemawia za modelem prostszym, bo jest oszczędniejszy, a dopasowuje się tak samo dobrze.
Statystyka χ² modelu (CMIN) to iloczyn liczebności próby i minimum funkcji rozbieżności (FMIN). Dlatego Δχ² rośnie liniowo z N przy tej samej różnicy między modelami (rysunek 1). W dużych próbach test wykrywa różnice praktycznie bez znaczenia. Uzupełnij go więc zmianą wskaźników dopasowania, np. ΔCFI, i oceną wielkości parametru, którego dotyczy ograniczenie.
Modeli niezagnieżdżonych (np. z różnymi zmiennymi albo o odwróconym kierunku ścieżki przy tej samej liczbie parametrów) tym testem nie porównasz. Do tego służą kryteria informacyjne AIC i BIC.
Przeskalowany test przy danych nienormalnych
Gdy pozycje mają skośne rozkłady, zamiast ML stosuje się estymator odporny MLR (albo MLM). Program podaje wtedy przeskalowaną statystykę χ²: zwykłą statystykę podzieloną przez współczynnik skalujący c. Różnica dwóch przeskalowanych statystyk nie ma rozkładu χ². Satorra i Bentler (2001) podali poprawny sposób obliczenia:
gdzie χ² to zwykłe (nieprzeskalowane) statystyki ML obu modeli. Bryant i Satorra (2012) zwracają uwagę, że współczynnik c trzeba odczytać zgodnie z tym, jak dany program definiuje statystykę. Proponują też rozwiązanie na wypadek ujemnego licznika. W lavaan robi to za Ciebie lavTestLRT(). Przy estymatorze WLSMV różnicę liczy się jeszcze inną, specjalną procedurą (w lavaan ta sama funkcja, w Mplus opcja DIFFTEST).
Przykład: czy w modelu mediacji potrzebny jest efekt bezpośredni?
Trzystu pięćdziesięciu studentów (dane symulowane) wypełniło po trzy pozycje (1–5) mierzące perfekcjonizm, stres i wypalenie. Odpowiedzi są skośne i mają grube ogony. Model M0 zakłada mediację całkowitą (perfekcjonizm → stres → wypalenie). M1 dodaje efekt bezpośredni perfekcjonizm → wypalenie. M0 jest więc zagnieżdżony w M1: ten efekt ustalono w nim na 0, Δdf = 1.
| Statystyka | M0 (bez efektu bezpośredniego) | M1 (z efektem bezpośrednim) | Różnica |
|---|---|---|---|
| χ² ML (df) | 36.92 (25) | 29.95 (24) | Δχ²(1) = 6.96, p = .008 |
| χ² MLR, przeskalowane | 33.77 | 27.95 | zwykła różnica 5.82 – niepoprawna |
| Współczynnik skalujący c | 1.093 | 1.072 | cd = 1.605 |
| Test Satorry–Bentlera (2001) | – | – | Td(1) = 4.34, p = .037 |
Przy ML różnica wynosi 6.96 i przekracza wartość krytyczną 3.84 (df = 1, α = .05). Dane nie są jednak normalne, więc właściwy jest test przeskalowany. Współczynnik skalujący różnicy (cd = 1.605) jest dużo większy niż współczynniki obu modeli osobno. Poprawna statystyka wynosi więc 4.34, a nie 5.82, jak dałoby zwykłe odejmowanie przeskalowanych χ². Wniosek się nie zmienia (p = .037), ale przy wyniku bliższym granicy mógłby się odwrócić. Ograniczenie pogarsza dopasowanie, więc wybieramy M1. Efekt bezpośredni jest niewielki: β = 0.18, SE = 0.08, p = .037.
Rohrer i in. (2022) przypominają, że lepsze dopasowanie jednego modelu ścieżkowego nie rozstrzyga, który model jest przyczynowo prawdziwy. Test różnicy mówi tylko, czy ograniczenie jest zgodne z danymi. O tym, czy perfekcjonizm „wpływa” na wypalenie bezpośrednio, decyduje plan badania. Więcej o interpretacji takiego wyniku piszemy w haśle mediacja częściowa.
Δχ² a liczebność próby
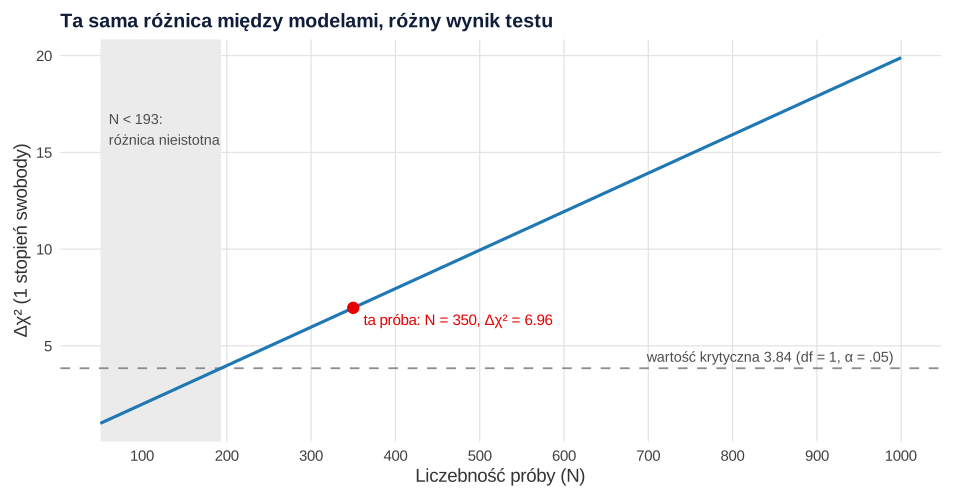
Ta sama rozbieżność między modelami daje przy N = 100 wynik Δχ²(1) = 1.99, p = .158, przy N = 200 – 3.98, p = .046, a przy N = 1000 – 19.89. Nieistotny wynik w małej próbie nie dowodzi więc, że ograniczenie jest prawdziwe. Może to być po prostu za mała moc testu. Dlatego obok p podawaj wielkość parametru, którego dotyczy ograniczenie.
Jak opisać test różnicy chi-kwadrat (APA)
Napisz, które modele porównano i jakie ograniczenie je różni. Podaj χ² i df obu modeli, Δχ², Δdf i p, a przy MLR lub WLSMV – nazwę poprawki. Dodaj wskaźniki dopasowania obu modeli, najlepiej w tabeli.
Test różnicy chi-kwadrat w R
Kod tworzy dane z przykładu, porównuje modele testem zwykłym (ML) i przeskalowanym (MLR). Pokazuje też, że ręczne obliczenie według Satorry i Bentlera daje ten sam wynik co lavTestLRT(). Rysunek 1 korzysta z różnicy minimum funkcji rozbieżności z tego kodu.
Δχ² przy ML i przeskalowana różnica przy MLR
R
suppressPackageStartupMessages(library(lavaan))   # SEM, test różnicy chi-kwadrat

# Dane symulowane: 350 studentów; perfekcjonizm (p1–p3), stres (s1–s3) i wypalenie (w1–w3), pozycje 1–5.
# Odpowiedzi są skośne i mają grube ogony, więc obok ML używamy odpornego estymatora MLR.
set.seed(11)
populacja <- '
  perfekcjonizm =~ 0.75*p1 + 0.70*p2 + 0.65*p3
  stres         =~ 0.80*s1 + 0.75*s2 + 0.70*s3
  wypalenie     =~ 0.80*w1 + 0.70*w2 + 0.75*w3
  stres     ~ 0.45*perfekcjonizm
  wypalenie ~ 0.50*stres + 0.15*perfekcjonizm
'
z <- simulateData(populacja, sample.nobs = 350, standardized = TRUE, skewness = 2, kurtosis = 7)
dane <- as.data.frame(lapply(z, function(x) pmin(pmax(round(2 + 0.9 * x), 1), 5)))

pomiar <- 'perfekcjonizm =~ p1 + p2 + p3
           stres         =~ s1 + s2 + s3
           wypalenie     =~ w1 + w2 + w3'
m0 <- paste(pomiar, '\n stres ~ perfekcjonizm \n wypalenie ~ stres')                    # mediacja całkowita
m1 <- paste(pomiar, '\n stres ~ perfekcjonizm \n wypalenie ~ stres + perfekcjonizm')    # + efekt bezpośredni

# 1. Estymacja ML: zwykły test różnicy chi-kwadrat
fit0 <- sem(m0, data = dane)
fit1 <- sem(m1, data = dane)
round(rbind(M0 = fitMeasures(fit0, c("chisq", "df", "pvalue")), M1 = fitMeasures(fit1, c("chisq", "df", "pvalue"))), 3)
lavTestLRT(fit0, fit1)
c(delta_chi2 = fitMeasures(fit0, "chisq") - fitMeasures(fit1, "chisq"),
  wartosc_krytyczna = qchisq(0.95, df = 1))

# 2. Estymacja MLR (odporna): przeskalowane chi-kwadrat obu modeli
fit0r <- sem(m0, data = dane, estimator = "MLR")
fit1r <- sem(m1, data = dane, estimator = "MLR")
f0 <- fitMeasures(fit0r, c("chisq", "chisq.scaled", "df", "pvalue.scaled", "chisq.scaling.factor", "cfi.robust", "rmsea.robust"))
f1 <- fitMeasures(fit1r, c("chisq", "chisq.scaled", "df", "pvalue.scaled", "chisq.scaling.factor", "cfi.robust", "rmsea.robust"))
round(rbind(M0 = f0, M1 = f1), 3)

# 2a. BŁĘDNIE: zwykła różnica przeskalowanych statystyk
c(roznica_przeskalowanych = unname(f0["chisq.scaled"] - f1["chisq.scaled"]))

# 2b. POPRAWNIE: przeskalowana różnica Satorry–Bentlera (2001), ręcznie i w lavaan
cd  <- (f0[["df"]] * f0[["chisq.scaling.factor"]] - f1[["df"]] * f1[["chisq.scaling.factor"]]) / (f0[["df"]] - f1[["df"]])
TRd <- (f0[["chisq"]] - f1[["chisq"]]) / cd
round(c(cd = cd, TRd = TRd, p = pchisq(TRd, df = 1, lower.tail = FALSE)), 4)
suppressMessages(lavTestLRT(fit0r, fit1r, method = "satorra.bentler.2001"))

# 3. Efekt bezpośredni w M1 (rozwiązanie standaryzowane, MLR)
pe <- standardizedSolution(fit1r)
pe[pe$op == "~", c("lhs", "op", "rhs", "est.std", "se", "pvalue")]
Wynik w R
    chisq df pvalue
M0 36.916 25  0.059
M1 29.954 24  0.186

Chi-Squared Difference Test

     Df    AIC    BIC  Chisq Chisq diff   RMSEA Df diff Pr(>Chisq)
fit1 24 7083.6 7164.7 29.953
fit0 25 7088.6 7165.8 36.916     6.9629 0.13053       1   0.008322 **
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
 delta_chi2.chisq wartosc_krytyczna
         6.962893          3.841459
    chisq chisq.scaled df pvalue.scaled chisq.scaling.factor cfi.robust
M0 36.916       33.772 25         0.113                1.093      0.993
M1 29.954       27.948 24         0.262                1.072      0.997
   rmsea.robust
M0        0.033
M1        0.022
roznica_przeskalowanych
               5.824047
    cd    TRd      p
1.6054 4.3372 0.0373

Scaled Chi-Squared Difference Test (method = “satorra.bentler.2001”)

lavaan->lavTestLRT():
   lavaan NOTE: The “Chisq” column contains standard test statistics, not the
   robust test that should be reported per model. A robust difference test is
   a function of two standard (not robust) statistics.

      Df    AIC    BIC  Chisq Chisq diff   RMSEA Df diff Pr(>Chisq)
fit1r 24 7083.6 7164.7 29.953
fit0r 25 7088.6 7165.8 36.916     4.3372 0.12372       1    0.03729 *
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
         lhs op           rhs est.std    se pvalue
10     stres  ~ perfekcjonizm   0.409 0.068  0.000
11 wypalenie  ~         stres   0.432 0.071  0.000
12 wypalenie  ~ perfekcjonizm   0.176 0.084  0.037
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7.2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Odejmowanie przeskalowanych χ² (MLR, MLM, WLSMV) tak jak zwykłych. Użyj poprawki Satorry–Bentlera albo procedury właściwej dla estymatora.
- Porównywanie modeli niezagnieżdżonych, np. modeli z inną listą zmiennych albo z odwróconą strzałką. Wtedy Δχ² nie ma rozkładu χ² – użyj AIC/BIC i argumentów teoretycznych.
- Modele oszacowane na różnych próbach, np. po innym usunięciu braków danych w każdym z nich. Sprawdź, czy N jest w obu modelach takie samo.
- „Nieistotna różnica dowodzi równości parametrów”. Przy małej próbie test ma niską moc (rysunek 1). Wynik nieistotny oznacza tylko brak podstaw do odrzucenia ograniczenia.
- Ograniczenia na granicy przestrzeni parametrów, np. wariancja czynnika ustalona na 0 albo korelacja czynników ustalona na 1. Wtedy zwykły rozkład χ² nie obowiązuje, a test jest konserwatywny.
- Wybieranie modelu wyłącznie na podstawie p w bardzo dużej próbie. Uzupełnij decyzję o zmianę CFI i RMSEA (RMSEA, CFI) oraz o wielkość efektu.
Sekwencję testów różnicy w porównaniu grup krok po kroku pokazuje poradnik inwariancja pomiaru krok po kroku. Porównanie modeli mediacji całkowitej i częściowej opisuje analiza mediacji krok po kroku.
Najczęstsze pytania
Kiedy modele SEM są zagnieżdżone?
Model prostszy jest zagnieżdżony w bardziej złożonym, jeśli powstaje z niego przez nałożenie ograniczeń – ustalenie parametrów na stałą wartość (np. 0) albo zrównanie ich – przy tych samych zmiennych i danych. Model mediacji bez efektu bezpośredniego jest zagnieżdżony w modelu z tym efektem; model z odwróconą strzałką zwykle nie jest.
Jak policzyć różnicę chi-kwadrat przy estymatorze MLR?
Nie odejmuj przeskalowanych statystyk. Oblicz współczynnik skalujący różnicy cd = (df0c0 − df1c1) / (df0 − df1) i podziel przez niego różnicę zwykłych χ² ML. W lavaan wystarczy lavTestLRT(fit0, fit1), które dla MLR stosuje tę poprawkę automatycznie.
Co oznacza nieistotny test różnicy chi-kwadrat?
Że dane nie dają podstaw do odrzucenia ograniczeń modelu prostszego – zwykle wybiera się wtedy model oszczędniejszy. Nie dowodzi to jednak, że ograniczony parametr w populacji wynosi 0: w małej próbie test ma niską moc, dlatego podaj też wielkość tego parametru.
Czy testem różnicy chi-kwadrat można porównać dowolne dwa modele?
Nie – tylko modele zagnieżdżone, oszacowane na tych samych obserwacjach. Modele niezagnieżdżone porównuje się kryteriami informacyjnymi AIC i BIC, a ostateczny wybór i tak powinien opierać się na teorii.
Jak zapisać wynik testu różnicy chi-kwadrat w APA?
Podaj porównywane modele, statystykę różnicy z liczbą stopni swobody i p, np. Δχ²(1) = 4.34, p = .037, oraz nazwę poprawki, jeśli użyto MLR lub WLSMV. Obok podaj wskaźniki dopasowania obu modeli, najlepiej w tabeli dopasowania w APA.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Inwariancja podłużna pomiaru
Trzy pomiary w lavaan: kowariancje reszt, measEq.syntax, częściowa inwariancja w jednym pomiarze, odpadanie i progi – co zmienia się we wniosku o zmianie.
Czytaj →PoradnikInwariancja pomiaru krok po kroku
Wielogrupowa CFA w lavaan: model konfiguracyjny, metryczny, skalarny i ścisły, kryteria ΔCFI i ΔRMSEA, testy punktowe, częściowa inwariancja i opis APA.
Czytaj →PoradnikAnaliza mediacji krok po kroku
Hipoteza, ścieżki a, b, c′, efekt pośredni z bootstrapem, PROCESS w SPSS, lavaan w R, dwa mediatory, moc i gotowy opis APA – na jednym przykładzie.
Czytaj →PoradnikCB-SEM – założenia i interpretacja
Identyfikacja, ML, MLR i WLSMV, test χ² i indeksy dopasowania bez magicznych progów, moc, modele równoważne i raport – z symulacjami w R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Bentler, P. M., & Bonett, D. G. (1980). Significance tests and goodness of fit in the analysis of covariance structures. Psychological Bulletin, 88(3), 588–606. https://doi.org/10.1037/0033-2909.88.3.588
- Bryant, F. B., & Satorra, A. (2012). Principles and practice of scaled difference chi-square testing. Structural Equation Modeling: A Multidisciplinary Journal, 19(3), 372–398. https://doi.org/10.1080/10705511.2012.687671 ● Otwarty dostęp: pełny tekst
- Marsh, H. W., Hau, K.-T., & Wen, Z. (2004). In search of golden rules: Comment on hypothesis-testing approaches to setting cutoff values for fit indexes and dangers in overgeneralizing Hu and Bentler's (1999) findings. Structural Equation Modeling: A Multidisciplinary Journal, 11(3), 320–341. https://doi.org/10.1207/s15328007sem1103_2
- Rohrer, J. M., Hünermund, P., Arslan, R. C., & Elson, M. (2022). That’s a lot to process! Pitfalls of popular path models. Advances in Methods and Practices in Psychological Science, 5(2), Article 25152459221095827. https://doi.org/10.1177/25152459221095827 ● Otwarty dostęp
- Satorra, A., & Bentler, P. M. (2001). A scaled difference chi-square test statistic for moment structure analysis. Psychometrika, 66(4), 507–514. https://doi.org/10.1007/bf02296192
Cytowania BibTeX
@article{bentler1980significance, author={Bentler, Peter M. and Bonett, Douglas G.}, title={{Significance tests and goodness of fit in the analysis of covariance structures}}, journal={Psychological Bulletin}, year={1980}, volume={88}, number={3}, pages={588--606}, doi={10.1037/0033-2909.88.3.588}}@article{bryant2012principles, author={Bryant, Fred B. and Satorra, Albert}, title={{Principles and practice of scaled difference chi-square testing}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2012}, volume={19}, number={3}, pages={372--398}, doi={10.1080/10705511.2012.687671}}@article{marsh2004search, author={Marsh, Herbert W. and Hau, Kit-Tai and Wen, Zhonglin}, title={{In search of golden rules: Comment on hypothesis-testing approaches to setting cutoff values for fit indexes and dangers in overgeneralizing Hu and Bentler's (1999) findings}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2004}, volume={11}, number={3}, pages={320--341}, doi={10.1207/s15328007sem1103_2}}@article{rohrer2022process, author={Rohrer, Julia M. and Hünermund, Paul and Arslan, Ruben C. and Elson, Malte}, title={{That’s a lot to process! Pitfalls of popular path models}}, journal={Advances in Methods and Practices in Psychological Science}, year={2022}, volume={5}, number={2}, eid={25152459221095827}, doi={10.1177/25152459221095827}}@article{satorra2001scaled, author={Satorra, Albert and Bentler, Peter M.}, title={{A scaled difference chi-square test statistic for moment structure analysis}}, journal={Psychometrika}, year={2001}, volume={66}, number={4}, pages={507--514}, doi={10.1007/bf02296192}}