Dla kogo jest ten przewodnik i jak z niego korzystać
Ten przewodnik jest dla osób, które budują własną skalę, adaptują kwestionariusz z innego języka albo muszą przekonać recenzenta, że narzędzie użyte w artykule mierzy to, co deklarują. Nie jest kolejnym poradnikiem od zera. Zebraliśmy w nim w jedną ścieżkę wpisy, hasła ze słownika i kalkulatory z metodolog.pl, a przy każdym etapie piszemy, co przeczytać i po co.
Kolejność etapów odpowiada logice, którą opisują przewodniki metodologiczne: najpierw konstrukt i pozycje, potem budowa skali i jej struktura, a na końcu ocena wymiarowości, rzetelności i trafności (Boateng i in., 2018). W praktyce ścieżka rzadko jest prosta. Złe dopasowanie modelu odsyła do treści pozycji, a brak inwariancji ogranicza to, co wolno napisać o różnicach między grupami. Te pętle zaznaczyliśmy na rysunku 1.
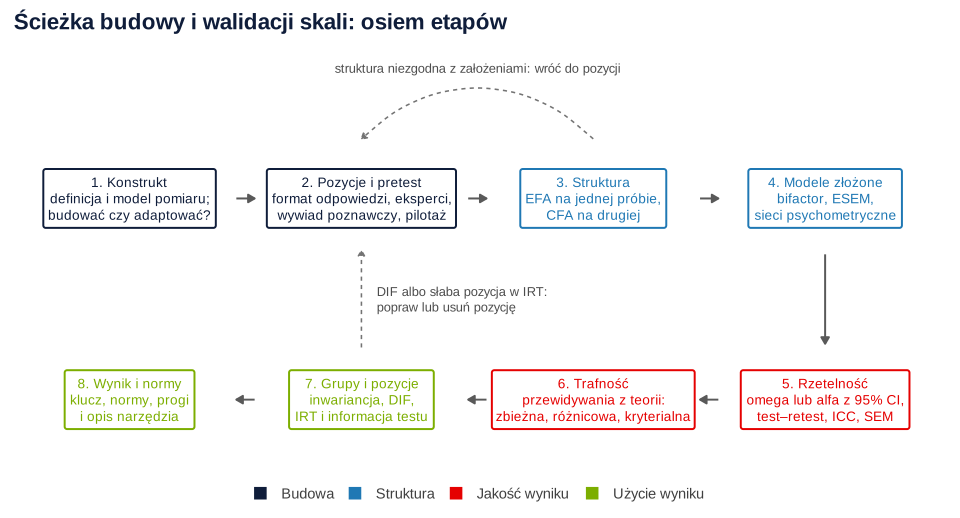
Jeśli dopiero planujesz narzędzie, przejdź etapy po kolei. Jeśli masz już dane i konkretny kłopot, na przykład niską alfę albo słabe CFI, zacznij od tabeli „mam problem → przeczytaj”. Na końcu znajdziesz hasła ze słownika pogrupowane tematycznie i kalkulatory, które przydają się przy liczeniu wyników.
Ścieżka krok po kroku: osiem etapów
Każdy etap ma krótką instrukcję i listę stron. Wpisy na blogu prowadzą przez całą procedurę z przykładem i kodem, a hasła ze słownika wyjaśniają jedno pojęcie, do którego wrócisz przy pisaniu metody.
Etap 1. Zdefiniuj konstrukt i zdecyduj: budować, adaptować czy wybrać gotowe narzędzie
Zanim napiszesz pierwszą pozycję, opisz konstrukt: z jakich elementów się składa, czym różni się od pojęć bliskich i w jakich zachowaniach lub doświadczeniach się przejawia. Clark i Watson (2019) traktują jasną konceptualizację jako punkt wyjścia, a trafny pomiar konstruktu – jako główny cel budowy skali. Rozstrzygnij też, czy wskaźniki odzwierciedlają konstrukt (model refleksyjny), czy go tworzą (model formatywny), bo od tego zależy sens alfy i CFA na dalszych etapach. Często najrozsądniej jest wziąć narzędzie istniejące albo je zaadaptować.
- Co to jest operacjonalizacja? – jak przejść od pojęcia do definicji operacyjnej, zmiennych i wskaźników.
- Model refleksyjny czy formatywny? – kryteria wyboru modelu pomiaru, skutki błędnej specyfikacji i model MIMIC.
- Gdzie znaleźć kwestionariusze psychologiczne – gdzie szukać polskich adaptacji, co sprawdzić przed wyborem i kiedy potrzebna jest zgoda właściciela praw.
- Adaptacja kulturowa kwestionariusza – proces od zgody autora i dwóch niezależnych przekładów po CFA, rzetelność, trafność i normy.
- Jak zbudować i zwalidować skalę psychometryczną? – przegląd całej drogi: definicja konstruktu, pozycje, pilotaż, CFA, rzetelność oraz trafność teoretyczna i różnicowa.
- Kwestionariusz a ankieta – jak w opisie metody osobno nazwać technikę badania i narzędzie.
Etap 2. Napisz pozycje i sprawdź je przed badaniem właściwym
Przygotuj wyraźnie szerszą pulę pozycji, niż chcesz mieć w wersji końcowej, i testuj je także względem konstruktów bliskich, a nie tylko względem siebie nawzajem (Clark i Watson, 2019). Zdecyduj o liczbie stopni i etykietach odpowiedzi, o pozycjach odwróconych i usuń pytania o dwie rzeczy naraz. Potem oddaj pozycje do oceny ekspertom i sprawdź w wywiadach poznawczych, czy respondenci rozumieją je tak jak Ty. Pilotaż sprawdza procedurę i działanie narzędzia, a nie hipotezy.
- Ile stopni skali Likerta wybrać? – 4, 5 czy 7 punktów: wyniki badań, środek skali i etykiety, z tabelą decyzyjną.
- Pozycja odwrócona – jak ją rekodować i dlaczego takie pozycje potrafią tworzyć osobny czynnik metody.
- Pytanie dwuznaczne (double-barreled) – jak rozpoznać i rozdzielić pozycję, która pyta o dwie rzeczy naraz.
- Trafność treściowa (CVI) – ocena panelu ekspertów podsumowana wskaźnikami I-CVI i S-CVI.
- Wywiad poznawczy w pilotażu krok po kroku – jak prowadzić rundy wywiadów, kodować problemy pozycja po pozycji i sprawdzać poprawki.
- Badanie pilotażowe – co sprawdza pilotaż, ile osób zbadać i dlaczego nie planować próby na podstawie d z pilotażu.
- Najczęstsze błędy w ankietach – typowe usterki w sformułowaniach i układzie pytań z gotowymi poprawkami.
Etap 3. Sprawdź strukturę: EFA na jednej próbie, CFA na drugiej
Struktura mówi, ile wymiarów mierzy skala i które pozycje do nich należą. Gdy struktura nie jest jeszcze znana, zacznij od eksploracyjnej analizy czynnikowej: liczbę czynników ustal analizą równoległą, przy skorelowanych wymiarach użyj rotacji ukośnej, a pozycje porządkowe analizuj na korelacjach polichorycznych. Model, który z tego wyjdzie, sprawdź w CFA na innych danych. Oceniaj dopasowanie globalne i lokalne, a modyfikacje wprowadzaj tylko wtedy, gdy uzasadnia je treść pozycji.
- Analiza czynnikowa EFA i CFA – od liczby czynników w EFA do modelu potwierdzonego na nowych danych.
- KMO i test sferyczności Bartletta – czy dane nadają się do analizy czynnikowej i dlaczego warto sprawdzić MSA każdej pozycji.
- Analiza równoległa – liczba czynników ustalana przez porównanie z wartościami własnymi z danych losowych.
- Korelacja polichoryczna – kiedy analizować pozycje porządkowe na korelacjach cech ukrytych.
- Rotacja nieortogonalna (ukośna) – oblimin i promax przy wymiarach, które ze sobą korelują.
- CFA (konfirmacyjna analiza czynnikowa) – specyfikacja modelu, dopasowanie globalne i lokalne oraz porównanie z modelem alternatywnym.
- CB-SEM w R (lavaan) – kompletny przykład od modelu pomiarowego z MLR i FIML po tabelę APA.
Etap 4. Gdy prosty model nie wystarcza: bifactor, ESEM, wyższy rząd i sieci
Przy skalach wielowymiarowych pada pytanie, czy wolno liczyć wynik ogólny, czy tylko podskale. ESEM pozwala pozycjom ładować kilka czynników, więc nie zawyża korelacji wymiarów przez wyzerowane ładunki krzyżowe. Model bifactor dzieli wariancję wspólną na czynnik ogólny i czynniki podskal. O wyborze modelu nie rozstrzygaj samym CFI: patrz na ładunki, korelacje czynników i wskaźniki omegi hierarchicznej. Sieci psychometryczne proponują inny sposób patrzenia na dane: objawy jako powiązane węzły, a nie wskaźniki jednej cechy ukrytej.
- Model bifactor i ESEM – kolejne porównania CFA, ESEM i bifactor-ESEM w lavaan ze wskaźnikami ωH, ωHS i ECV.
- Model bifactor – czynnik ogólny i czynniki specyficzne w jednym modelu oraz to, czego nie dowodzi lepsze dopasowanie.
- ESEM – część pomiarowa w postaci EFA z rotacją i jej wpływ na korelacje czynników.
- Podskala i wynik ogólny – kiedy klucz i struktura czynnikowa pozwalają zsumować całą skalę.
- Modelowanie konstruktów wyższego rzędu – modele drugiego rzędu i podejście dwuetapowe w SEM i PLS-SEM.
- Sieci psychometryczne krok po kroku – estymacja regularyzowanej sieci objawów, centralność i bootstrapowa ocena dokładności krawędzi.
- Sieć psychometryczna – węzły, krawędzie i to, dlaczego krawędzie nie mają kierunku przyczynowego.
Etap 5. Oszacuj rzetelność wyniku w swojej próbie
Rzetelność opisuje wyniki w konkretnej próbie, a nie narzędzie raz na zawsze, dlatego licz ją na własnych danych. McNeish (2018) pokazuje, że alfa Cronbacha jest raportowana rutynowo, choć jej założenia rzadko są spełnione i zwykle prowadzą do zaniżenia rzetelności; omawia też alternatywy, takie jak omega całkowita. Dobierz współczynnik do modelu z etapu 3 i podaj go z 95% przedziałem ufności dla każdej podskali. Stabilność w czasie oceniasz osobnym badaniem test–retest, a zgodność oceniających – miarami zgodności sędziów.
- Alfa Cronbacha – rzetelność skali – założenia alfy, analiza pozycji i omega oraz sytuacje, w których alfa zaniża albo zawyża rzetelność.
- Omega McDonalda – rzetelność z jednoczynnikowego modelu CFA bez założenia równych ładunków.
- Spójność wewnętrzna – od czego zależy alfa i dlaczego jej wysoka wartość nie dowodzi jednowymiarowości.
- Rzetelność test–retest – dlaczego do oceny stabilności korelacja nie wystarcza i co podać zamiast niej.
- Standardowy błąd pomiaru – typowy błąd wyniku jednej osoby w jednostkach skali.
- Zgodność sędziów – wybór między kappą Cohena, kappą Fleissa, ICC i alfą Krippendorffa.
- Badanie rzetelności pomiaru klinicznego – plan badania z ICC, SEM, MDC i wykresem Blanda–Altmana.
- Wzór raportowania alfy Cronbacha – gotowe zdania i tabele z opisem rzetelności dla siedmiu sytuacji.
Etap 6. Zbierz dowody trafności
Messick (1995) zastąpił dawny podział na trafność treściową, kryterialną i teoretyczną jednym pojęciem trafności teoretycznej, w którym wyróżnił sześć aspektów, od treściowego po konsekwencyjny. W praktyce oznacza to, że nie „masz” trafności, tylko gromadzisz dowody na rzecz określonej interpretacji wyników. Zapisz przed zebraniem danych, z czym skala powinna korelować, jak silnie i w którą stronę, a z czym nie. Trafność zbieżną sprawdzaj razem z różnicową, a kryterium dobieraj tak, by było rzetelne i niezależne od testu.
- Trafność w psychometrii – trafność jako uzasadnienie interpretacji wyników w danym zastosowaniu.
- Trafność teoretyczna (konstruktu) – testowanie przewidywań, które wynikają z teorii konstruktu.
- Trafność zbieżna – zgodność z innymi miarami tego samego konstruktu, najlepiej mierzonego inną metodą.
- Trafność różnicowa – jak wykazać, że dwa konstrukty da się odróżnić, i dlaczego sam test χ² tego nie przesądza.
- HTMT – stosunek korelacji heterotrait-monotrait z przykładem i zapisem w APA 7.
- AVE – średnia wyodrębniona wariancja i kryterium Fornella–Larckera jako reguły kciuka.
- Trafność kryterialna – trafność predykcyjna i równoczesna oraz czynniki, które zaniżają współczynnik trafności.
- Wspólna wariancja metody (CMV) – skąd się bierze, gdy wszystkie miary pochodzą z jednej ankiety, i dlaczego test Harmana jej nie wyklucza.
Etap 7. Sprawdź, czy skala działa tak samo w grupach i na poziomie pozycji
Zanim porównasz średnie kobiet i mężczyzn, krajów albo kolejnych pomiarów, sprawdź inwariancję pomiaru. Bez niej różnica średnich może wynikać z tego, że pozycje działają w grupach inaczej. Przy narzędziach adaptowanych wytyczne ITC wymagają sprawdzenia adaptacji w pilotażu z analizą pozycji, rzetelnością i wstępnymi badaniami trafności oraz udokumentowania wszystkich zmian (International Test Commission, 2018). Teoria reagowania na pozycje testowe (IRT) pozwala z kolei ocenić każdą pozycję osobno: jej trudność, moc różnicującą i to, w jakim zakresie cechy mierzy najdokładniej.
- Inwariancja pomiaru krok po kroku – wielogrupowa CFA w lavaan od modelu konfiguracyjnego do ścisłego, z kryteriami ΔCFI i ΔRMSEA.
- Inwariancja pomiaru w CB-SEM – poziomy inwariancji oraz inwariancja podłużna w modelu jednogrupowym.
- Model MIMIC – porównanie grup na poziomie cechy ukrytej i wykrywanie DIF pojedynczych pozycji.
- Teoria reagowania na pozycje testowe (IRT) – modele Rascha, 2PL, 3PL i GRM, informacja testu i różnice wobec klasycznej teorii testów.
- IRT w R krok po kroku – analiza testu i skali Likerta w pakiecie mirt: dopasowanie, wyniki theta, porównanie z CFA i DIF.
- Dobre pozycje testowe i liczebność próby w IRT – kryteria dobrej pozycji i planowanie próby do kalibracji symulacją w R.
- Analiza pozycji testu – wskaźnik łatwości i moc różnicująca w klasycznej analizie pytań.
- Właściwa adaptacja testu – co musi obejmować adaptacja, żeby porównania między krajami miały sens.
Etap 8. Ustal sposób liczenia wyniku, normy i opisz narzędzie
Ostatni etap decyduje o tym, czy inni użyją Twojej skali tak samo jak Ty. Zapisz klucz, regułę postępowania z brakami i to, czy wynik jest sumą, czy średnią. Jeśli wyniki mają być interpretowane indywidualnie, potrzebne są normy z dobrze opisanej próby. Flake i Fried (2020) pokazują, że brak przejrzystości w opisie pomiaru uniemożliwia czytelnikom ocenę trafności wniosków, dlatego w artykule opisz każdą decyzję pomiarową, także usunięte pozycje i zmiany względem oryginału.
- Jak policzyć wynik kwestionariusza – siedem kroków od klucza, przez pozycje odwrócone i braki, po kontrolę wartości niemożliwych.
- Wynik skali: średnia czy suma – kiedy oba sposoby dają to samo, a kiedy wybór ma znaczenie.
- Normy testowe – jak normy przypisują wynikowi surowemu pozycję w rozkładzie populacji.
- Normalizacja testu – etapy opracowania norm i wpływ liczebności oraz doboru próby normalizacyjnej.
- Skala stenowa – przeliczanie na steny i czytanie profilu z uwzględnieniem błędu pomiaru.
- Niski, przeciętny, wysoki wynik – cztery sposoby wyznaczania poziomów i to, dlaczego dają różne odsetki.
- Opis narzędzia badawczego – wzór – pięć pytań, na które odpowiada opis skali, testu wiedzy i skali klinicznej.
- Tabela rzetelności skal w APA – wzór tabeli z alfą, omegą i korelacjami pozycja–skala.
Mam problem → przeczytaj
Tabela zbiera typowe pytania autorów skal i artykułów walidacyjnych. W prawej kolumnie są strony, od których warto zacząć.
| Problem | Co przeczytać |
|---|---|
| Alfa jednej z podskal wyszła niska i nie wiem, jak to opisać. | Wzór raportowania alfy, potem analiza pozycji z etapu 5 |
| Alfa jest bardzo wysoka, a recenzent pyta o jednowymiarowość. | Spójność wewnętrzna, potem EFA i CFA z etapu 3 |
| Nie wiem, ile czynników zostawić w EFA. | Analiza równoległa |
| CFA ma słabe dopasowanie. | CFI, RMSEA, SRMR i indeksy modyfikacji |
| Pozycja ładuje dwa czynniki naraz. | Macierz ładunków krzyżowych, potem ESEM z etapu 4 |
| Recenzent pyta, czy wolno liczyć wynik ogólny skali wielowymiarowej. | Podskala i wynik ogólny |
| Chcę porównać średnie kobiet i mężczyzn albo dwóch krajów. | Inwariancja pomiaru krok po kroku |
| Tłumaczę kwestionariusz z angielskiego. | Adaptacja kulturowa i wywiad poznawczy |
| Pozycje mają kilka kategorii i skośne rozkłady. | Korelacja polichoryczna |
| Mam test wiedzy z odpowiedziami poprawnymi i błędnymi. | Analiza pozycji testu, potem IRT z etapu 7 |
| Wynik wystawia dwóch lub więcej oceniających. | Zgodność sędziów i kappa ważona |
| Muszę wykazać, że skala różni się od podobnego konstruktu. | Trafność różnicowa i HTMT |
| Są braki odpowiedzi i nie wiem, czy liczyć sumę, czy średnią. | Jak policzyć wynik kwestionariusza |
| Chcę opisać wynik osoby jako niski, przeciętny albo wysoki. | Niski, przeciętny, wysoki wynik |
| Muszę ocenić, czy zmiana u pacjenta przekracza błąd pomiaru. | RCI, MDC i MCID |
| Wiele osób ma najwyższy możliwy wynik. | Efekt sufitu i podłogi |
| Część respondentów odpowiadała bez czytania pytań. | Nieuważne odpowiedzi w ankietach online |
| Wskaźniki mojego konstruktu nie korelują ze sobą. | Model refleksyjny czy formatywny? |
| Promotor pyta, czy skalę Likerta liczyć jako dane porządkowe w CFA. | Kategorialna CFA (WLSMV) |
| Chcę policzyć rzetelność skali w danych zagnieżdżonych. | Rzetelność wielopoziomowa |
| Planuję nowe narzędzie i nie wiem, ile pozycji przygotować. | Jak zaprojektować pomiar latentny |
| PCA czy analiza czynnikowa? | PCA czy analiza czynnikowa? |
| Chcę wyznaczyć punkt odcięcia skali. | Krzywa ROC i punkt odcięcia |
| Chcę sprawdzić, czy pozycje działają tak samo w grupach. | DIF krok po kroku |
| Wynik zależy od oceniającego i zadania – jak policzyć rzetelność? | Teoria generalizowalności |
| Promotor pyta o trafność fasadową mojej skali. | Trafność fasadowa |
| Walidacja skali: od czego zacząć? | Rodzaje trafności |
| Chcę sprawdzić, czy skala odróżnia grupy kliniczne. | Metoda grup znanych |
| Recenzent pyta, czy nowa skala wnosi coś ponad istniejące. | Trafność przyrostowa |
| Mam kilka cech mierzonych kilkoma metodami. | Macierz MTMM |
Najważniejsze hasła ze słownika
Hasła, które nie pojawiły się na ścieżce, a wracają przy pisaniu metody i odpowiedzi recenzentom.
Rzetelność i zgodność
Rzetelność w psychometrii · rzetelność połówkowa i wzór Spearmana–Browna · rzetelność kompozytowa (ρC) · ICC · kappa Cohena
Analiza czynnikowa i dopasowanie modelu
Ładunek czynnikowy · metoda osi głównych · wspólności w EFA · konstrukt wyższego rzędu · centralność w sieci · tabela analizy czynnikowej w APA · tabela dopasowania modelu CFA
Wyniki, skale standardowe i normy
Wynik surowy · wynik znormalizowany · standaryzacja testu · skala staninowa · skala tenowa (wyniki T) · percentyl i ranga centylowa · POMP · klucz odpowiedzi
Zniekształcenia odpowiedzi
Aprobata społeczna · style odpowiedzi skrajnych i środkowych · straightlining
Funkcjonowanie pozycji w grupach
DIF – zróżnicowane funkcjonowanie pozycji · model Rascha
Kalkulatory przydatne przy pracy ze skalą
- Kalkulator wyniku skali – liczy sumę, średnią i POMP po odwróceniu pozycji, z regułą prorated przy pojedynczych brakach.
- Kalkulator RCI i MDC – z SD i rzetelności wyznacza wiarygodną zmianę, MDC95 i punkt c Jacobsona–Truaxa.
- Kalkulator przedziału ufności – przedział dla korelacji z transformacją Fishera przyda się przy współczynnikach trafności.
- Kalkulator liczebności próby – liczebność potrzebna do wykrycia korelacji, na przykład w badaniu trafności kryterialnej.
- Kalkulator alfy i omegi – omega, alfa i współczynnik H z ładunków, z wynikiem po usunięciu każdej pozycji.
- Konwerter wyników na normy – wyniki standardowe i centyle z norm podręcznika, także w drugą stronę.
- Kalkulator AVE, CR i HTMT – AVE, CR, Fornell–Larcker i HTMT z ładunków albo z macierzy korelacji.
- Kalkulator kappy Cohena i testu McNemara – zgodność dwóch oceniających i zmiana odsetka w parach przed–po.
- Kalkulator testu diagnostycznego – czułość, swoistość, PPV, NPV i ilorazy wiarygodności z przedziałami ufności.
Inne przewodniki
Jeśli używasz gotowych skal w pracy dyplomowej, prostszą drogę opisuje przewodnik po analizie kwestionariusza. Modele pomiarowe w szerszym kontekście modeli strukturalnych omawia przewodnik po SEM, a publikowanie artykułu walidacyjnego – przewodnik po doktoracie i publikacjach.
Kiedy warto skorzystać z pomocy
Większość etapów przejdziesz samodzielnie z pomocą powyższych stron. Konsultacja przydaje się zwykle w trzech miejscach: gdy wyniki EFA i CFA się rozjeżdżają, gdy trzeba wybrać między modelem bifactor, ESEM i wyższego rzędu, oraz gdy recenzent kwestionuje inwariancję albo trafność różnicową. W ramach analiz statystycznych dla badaczy możemy sprawdzić Twoje modele, policzyć brakujące wskaźniki i wyjaśnić wyniki tak, by można je było samodzielnie opisać i obronić. Pomoc w analizie ujawnij zgodnie z zasadami czasopisma.
Najczęstsze pytania
Od czego zacząć walidację własnej skali?
Od definicji konstruktu, a nie od analizy danych. Opisz, z jakich elementów składa się konstrukt, czym różni się od pojęć bliskich i czy wskaźniki go odzwierciedlają, czy tworzą. Dopiero potem pisz pozycje, oddaj je do oceny ekspertom i sprawdź w wywiadach poznawczych. Kolejne etapy opisuje ścieżka w tym przewodniku.
Czy w artykule walidacyjnym wystarczy rzetelność podana w podręczniku testu?
Nie. Rzetelność opisuje wyniki w konkretnej próbie, więc podaj współczynnik policzony na własnych danych, z 95% przedziałem ufności i osobno dla każdej podskali. Wartość z podręcznika możesz przytoczyć dla porównania. Wzór opisu znajdziesz w poradniku opis narzędzia badawczego.
Ile prób potrzeba do walidacji nowego kwestionariusza?
Jeśli strukturę dopiero odkrywasz w EFA, potrzebujesz drugiej, niezależnej próby do CFA – inaczej powtórzysz eksplorację na tych samych danych. Często dzieli się losowo jeden duży zbiór na dwie części. Do oceny stabilności w czasie potrzebny jest jeszcze drugi pomiar części osób (test–retest), a do norm – osobna, starannie dobrana próba normalizacyjna.
Czym IRT różni się od klasycznej analizy pozycji przy budowie skali?
Klasyczna analiza pozycji opisuje każde pytanie łatwością i mocą różnicującą w danej próbie. IRT modeluje prawdopodobieństwo odpowiedzi w zależności od poziomu cechy, więc pokazuje, w jakim zakresie cechy pozycja i cały test mierzą najdokładniej, i pozwala wykrywać DIF. Szczegóły i przykład w R znajdziesz we wpisach o IRT i pakiecie mirt.
Kiedy przy walidacji skali sięgnąć po model bifactor albo ESEM?
Gdy skala ma kilka podskal i trzeba rozstrzygnąć, czy liczyć wynik ogólny, albo gdy w CFA widać ładunki krzyżowe i bardzo wysokie korelacje czynników. ESEM dopuszcza ładunki krzyżowe, a bifactor oddziela czynnik ogólny od czynników podskal. O wyborze decyduj na podstawie ładunków, korelacji czynników i omegi hierarchicznej, a nie samego CFI.
Powiązane hasła
Przeczytaj też
Jak zbudować i zwalidować skalę psychometryczną?
Od definicji konstruktu i tworzenia pozycji po pilotaż, EFA, CFA, rzetelność, trafność teoretyczną, różnicową i niezmienniczość.
Czytaj →PoradnikAnaliza czynnikowa EFA i CFA
EFA czy CFA, analiza równoległa, rotacja oblimin a varimax, przejście od EFA do CFA na nowej próbie, WLSMV i opis APA – z danymi i kodem R.
Czytaj →PoradnikAdaptacja kulturowa kwestionariusza
Dziesięć etapów według ITC: zgoda autora, przekład, CVI, wywiady poznawcze, pilotaż, CFA i inwariancja w R, rzetelność, trafność, normy i opis APA.
Czytaj →Walidujesz skalę i modele nie układają się w spójną całość?
Sprawdzimy strukturę, rzetelność i inwariancję Twojego narzędzia, policzymy brakujące wskaźniki i wyjaśnimy wyniki tak, żeby można je było opisać i obronić przed recenzentami.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Boateng, G. O., Neilands, T. B., Frongillo, E. A., Melgar-Quiñonez, H. R., & Young, S. L. (2018). Best practices for developing and validating scales for health, social, and behavioral research: A primer. Frontiers in Public Health, 6, Article 149. https://doi.org/10.3389/fpubh.2018.00149 ● Otwarty dostęp
- Clark, L. A., & Watson, D. (2019). Constructing validity: New developments in creating objective measuring instruments. Psychological Assessment, 31(12), 1412–1427. https://doi.org/10.1037/pas0000626 ● Otwarty dostęp
- Flake, J. K., & Fried, E. I. (2020). Measurement schmeasurement: Questionable measurement practices and how to avoid them. Advances in Methods and Practices in Psychological Science, 3(4), 456–465. https://doi.org/10.1177/2515245920952393 ● Otwarty dostęp: pełny tekst
- International Test Commission. (2018). ITC guidelines for translating and adapting tests (second edition). International Journal of Testing, 18(2), 101–134. https://doi.org/10.1080/15305058.2017.1398166 ● Otwarty dostęp: pełny tekst
- McNeish, D. (2018). Thanks coefficient alpha, we’ll take it from here. Psychological Methods, 23(3), 412–433. https://doi.org/10.1037/met0000144
- Messick, S. (1995). Validity of psychological assessment: Validation of inferences from persons’ responses and performances as scientific inquiry into score meaning. American Psychologist, 50(9), 741–749. https://doi.org/10.1037/0003-066x.50.9.741
Cytowania BibTeX
@article{boateng2018best, author={Boateng, Godfred O. and Neilands, Torsten B. and Frongillo, Edward A. and Melgar-Quiñonez, Hugo R. and Young, Sera L.}, title={{Best practices for developing and validating scales for health, social, and behavioral research: A primer}}, journal={Frontiers in Public Health}, year={2018}, volume={6}, eid={149}, doi={10.3389/fpubh.2018.00149}}@article{clark2019constructing, author={Clark, Lee Anna and Watson, David}, title={{Constructing validity: New developments in creating objective measuring instruments}}, journal={Psychological Assessment}, year={2019}, volume={31}, number={12}, pages={1412--1427}, doi={10.1037/pas0000626}}@article{flake2020measurement, author={Flake, Jessica Kay and Fried, Eiko I.}, title={{Measurement schmeasurement: Questionable measurement practices and how to avoid them}}, journal={Advances in Methods and Practices in Psychological Science}, year={2020}, volume={3}, number={4}, pages={456--465}, doi={10.1177/2515245920952393}}@article{itc2018guidelines, author={{International Test Commission}}, title={{ITC guidelines for translating and adapting tests (second edition)}}, journal={International Journal of Testing}, year={2018}, volume={18}, number={2}, pages={101--134}, doi={10.1080/15305058.2017.1398166}}@article{mcneish2018thanks, author={McNeish, Daniel}, title={{Thanks coefficient alpha, we’ll take it from here}}, journal={Psychological Methods}, year={2018}, volume={23}, number={3}, pages={412--433}, doi={10.1037/met0000144}}@article{messick1995validity, author={Messick, Samuel}, title={{Validity of psychological assessment: Validation of inferences from persons’ responses and performances as scientific inquiry into score meaning}}, journal={American Psychologist}, year={1995}, volume={50}, number={9}, pages={741--749}, doi={10.1037/0003-066x.50.9.741}}