Co to jest wynik znormalizowany?
Wynik znormalizowany (ang. normalized score, normalized standard score) to wynik standardowy obliczony nie przez liniowe przeliczenie wyniku surowego, lecz przez jego pozycję w rozkładzie grupy odniesienia. Wynik surowy zamienia się najpierw na rangę centylową, a potem na taką wartość z, która w rozkładzie normalnym ma tę samą rangę. Z tak uzyskanego z liczy się wynik T, sten, stanin albo IQ. W efekcie wyniki znormalizowane mają w grupie odniesienia rozkład zbliżony do normalnego, nawet gdy wyniki surowe były wyraźnie skośne.
Uwaga na podobne nazwy. Normalizacja testu to cały proces opracowania norm na próbie normalizacyjnej, a wynik znormalizowany to jeden z formatów, w jakich te normy się podaje. Ogólne zasady tworzenia tabel norm i przegląd skal standardowych znajdziesz w haśle normy testowe.
Wynik liniowy a znormalizowany
| Cecha | Wynik standaryzowany liniowo | Wynik znormalizowany |
|---|---|---|
| Obliczenie | z = (x − M) / SD, potem T = 50 + 10z | z = Φ−1(ranga centylowa), potem T = 50 + 10z |
| Kształt rozkładu | Taki jak wyników surowych – skośny zostaje skośny | W przybliżeniu normalny |
| Związek z rangą centylową | Zgodny tylko przy rozkładzie normalnym | Zawsze taki sam: T = 60 to ranga 84.1, T = 70 – ranga 97.7 |
| Odległości między osobami | Zachowane proporcjonalnie | Zmienione – w ogonach ściśnięte lub rozciągnięte |
| Czego wymaga | M i SD grupy odniesienia | Całego rozkładu i dużej grupy normalizacyjnej |
Liniowa standaryzacja zmienia tylko jednostkę i punkt zero, więc nie zmienia kształtu rozkładu. Normalizacja jest przekształceniem nieliniowym: zachowuje kolejność osób, ale zmienia odstępy między nimi.
Po co normalizować wyniki?
Rozkłady wyników testów rzadko są normalne. Micceri (1989) przeanalizował 440 dużych rozkładów wyników testów osiągnięć i miar psychometrycznych i wszystkie istotnie odbiegały od normalności – m.in. asymetrią i ciężkością ogonów. Przy skośnym rozkładzie ten sam liniowy wynik z oznacza w różnych testach inną pozycję wśród ludzi. Wynik znormalizowany ma jedno znaczenie: T = 70 zawsze oznacza wynik wyższy niż u około 97.7% grupy odniesienia.
Normalizacja ma jednak granice. Zakłada, że mierzona cecha ma w populacji rozkład normalny, a skośność wyników surowych wynika z narzędzia – gdy skośność jest prawdziwa (np. objawy w populacji ogólnej), normalizacja ją „wymazuje”. Nie rozdziela też wyników wiązanych: osoby z wynikiem minimalnym dostają ten sam wynik znormalizowany, więc efekt podłogi pozostaje. W analizach statystycznych przekształcenie rangowe do rozkładu normalnego (rankit) przed obliczeniem korelacji Pearsona minimalizowało w symulacjach błędy I i II rodzaju przy n ≥ 20 (Bishara i Hittner, 2012), ale takie przekształcenia nie zawsze utrzymują nominalny poziom błędu I rodzaju i bywa, że obniżają moc (Beasley i in., 2009). Normalizacja to przede wszystkim sposób podawania norm, a nie uniwersalne lekarstwo na nienormalne dane. Co zrobić z nienormalnym rozkładem w analizach, omawia poradnik jak sprawdzić normalność rozkładu.
Jak obliczyć wynik znormalizowany?
- Dla każdego wyniku surowego policz rangę centylową metodą punktu środkowego: odsetek osób z niższym wynikiem plus połowa odsetka osób z tym samym wynikiem.
- Zamień rangę na wartość z z rozkładu normalnego: w R
qnorm(PR), w ExceluROZKŁ.NORMALNY.S.ODWR(ang.NORM.S.INV). - Przelicz z na wybraną skalę: T = 50 + 10z, sten = 5.5 + 2z (zaokrąglony do 1–10; zob. skala stenowa), IQ = 100 + 15z.
Wzór z rangą r (średnią dla wyników wiązanych) to tzw. rankit; daje on dokładnie rangę centylową metodą punktu środkowego. Istnieją też warianty Bloma, Tukeya i van der Waerdena. Soloman i Sawilowsky (2009) porównali je w symulacjach i najdokładniejszy był rankit, który polecają jako domyślny – zastrzegając, że małe próby i skośne rozkłady pogarszają działanie każdej metody. Różnice dotyczą głównie ogonów: dla najwyższego wyniku w przykładzie niżej z wynosi 3.14 według rankitu, 3.08 według Bloma, 3.06 według Tukeya i 2.94 według van der Waerdena.
Przykład: skośny rozkład wyników w skali objawów
Skalę objawów stresu (30 pozycji 0–3, zakres 0–90) wypełniło 600 dorosłych z grupy normalizacyjnej (dane symulowane). Wyniki były prawostronnie skośne: M = 14.04, SD = 11.17, Mdn = 12, skośność 1.10, zakres w próbie 0–57. Tabela pokazuje fragment tabeli norm z wynikami T liniowymi i znormalizowanymi:
| Wynik surowy | Ranga centylowa | T liniowy | T znormalizowany |
|---|---|---|---|
| 0 | 1.1 | 37.4 | 27.0 |
| 5 | 24.3 | 41.9 | 43.0 |
| 14 | 57.8 | 50.0 | 52.0 |
| 20 | 76.1 | 55.3 | 57.1 |
| 30 | 89.8 | 64.3 | 62.7 |
| 40 | 96.6 | 73.2 | 68.2 |
| 50 | 99.3 | 82.2 | 74.7 |
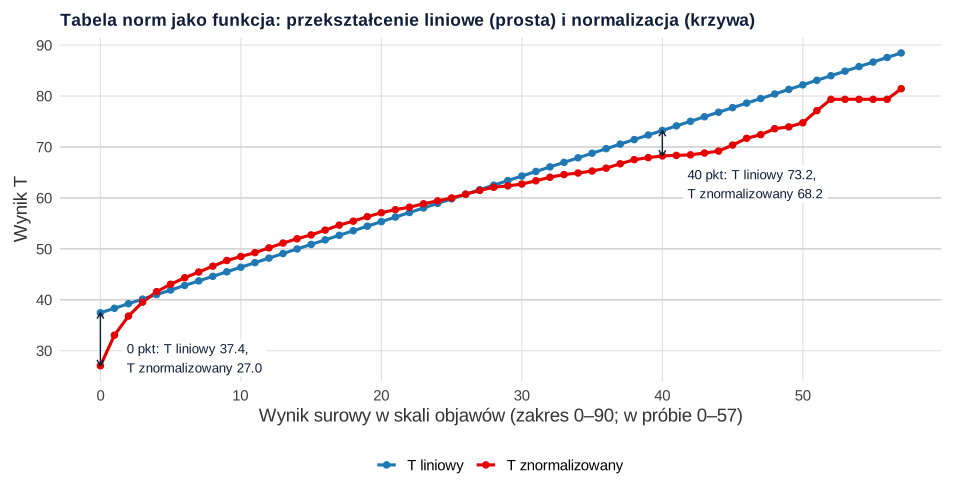
Osoba z wynikiem 40 punktów ma liniowy wynik T = 73.2, co w rozkładzie normalnym oznaczałoby wynik wyższy niż u 99% ludzi. W rzeczywistości ranga centylowa tego wyniku wynosi 96.6, więc znormalizowany T to 68.2. Na drugim końcu wynik 0 punktów daje liniowe T = 37.4, choć niżej nie ma nikogo, a połowa z 2.2% osób z zerem to ranga 1.1 – stąd znormalizowane T = 27.0. Rysunek 1 pokazuje cały rozkład: liniowe T zachowuje skośność 1.10, a znormalizowane ma skośność 0.05.
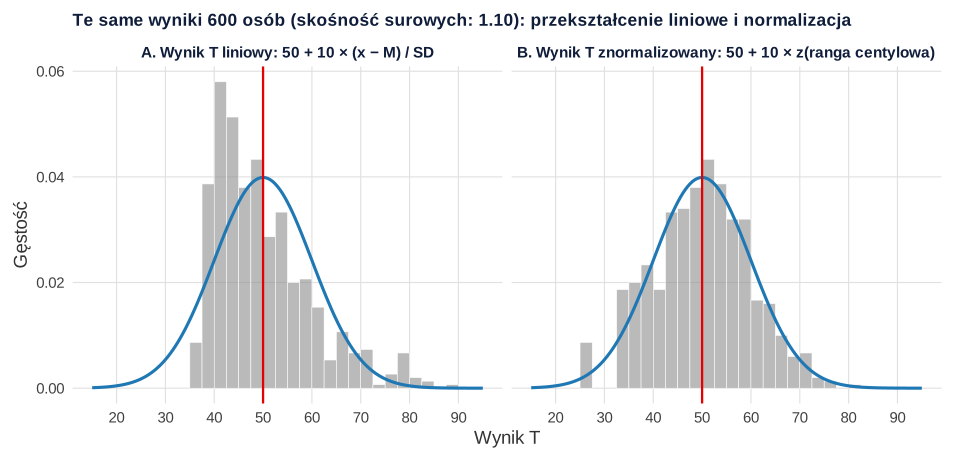
Różnica ma praktyczne skutki: wynik T ≥ 70 ma 5.3% osób według przekształcenia liniowego i 2.7% według normalizacji (w rozkładzie normalnym – 2.3%). Rysunek 2 pokazuje tę samą tabelę norm jako funkcję: prostą dla wyników liniowych i krzywą dla znormalizowanych.
Jak opisać normalizację w pracy
Przykład w R
Kod tworzy grupę normalizacyjną z przykładu, buduje fragment tabeli norm z wynikami T liniowymi i znormalizowanymi, porównuje skośność obu rozkładów i odsetki wyników T ≥ 70 oraz zestawia cztery wzory normalizacji dla najwyższego wyniku. Liczby w tekście i na rysunkach pochodzą z tego kodu.
Rangi centylowe, wynik T liniowy i znormalizowany
R
set.seed(97)
n <- 600
teta <- rnorm(n)
poz <- sapply(1:30, function(j) findInterval(0.55 * teta + sqrt(1 - 0.55^2) * rnorm(n) + runif(1, -0.25, 0.25),
                                             c(0.4, 1.2, 1.9)))       # 30 pozycji 0–3
x <- rowSums(poz)                                            # wyniki surowe grupy normalizacyjnej (0–90)
skos <- function(v) mean((v - mean(v))^3) / sd(v)^3
round(c(M = mean(x), SD = sd(x), Mdn = median(x), skosnosc = skos(x)), 2)
# 1. Tabela norm: ranga centylowa (punkt środkowy) → z znormalizowane → T; obok T liniowy
norma <- function(w) {
  PR <- 100 * (sum(x < w) + 0.5 * sum(x == w)) / n
  c(wynik = w, PR = PR, T_lin = 50 + 10 * (w - mean(x)) / sd(x), T_norm = 50 + 10 * qnorm(PR / 100))
}
round(t(sapply(c(0, 5, 10, 14, 20, 30, 40, 50), norma)), 1)
# 2. Rozkład po przekształceniu: T liniowy zachowuje skośność, T znormalizowany – nie
T_lin <- 50 + 10 * (x - mean(x)) / sd(x)
T_norm <- 50 + 10 * qnorm((rank(x) - 0.5) / n)               # rankit: (ranga − 0.5) / n
round(c(skos_T_lin = skos(T_lin), skos_T_norm = skos(T_norm)), 2)
round(100 * c(lin_70 = mean(T_lin >= 70), norm_70 = mean(T_norm >= 70), normalny_70 = 1 - pnorm(2)), 1)
# 3. Inne wzory normalizacji różnią się głównie w ogonach (najwyższy wynik w próbie)
r <- max(rank(x))
round(qnorm(c(rankit = (r - 0.5) / n, Blom = (r - 3 / 8) / (n + 1 / 4), Tukey = (r - 1 / 3) / (n + 1 / 3),
              van_der_Waerden = r / (n + 1))), 3)
Wynik w R
       M       SD      Mdn skosnosc
   14.04    11.17    12.00     1.10
     wynik   PR T_lin T_norm
[1,]     0  1.1  37.4   27.0
[2,]     5 24.3  41.9   43.0
[3,]    10 44.0  46.4   48.5
[4,]    14 57.8  50.0   52.0
[5,]    20 76.1  55.3   57.1
[6,]    30 89.8  64.3   62.7
[7,]    40 96.6  73.2   68.2
[8,]    50 99.3  82.2   74.7
 skos_T_lin skos_T_norm
       1.10        0.05
     lin_70     norm_70 normalny_70
        5.3         2.7         2.3
         rankit            Blom           Tukey van_der_Waerden
          3.144           3.078           3.059           2.936
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietów bazowych); rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Nazywanie liniowego wyniku z „znormalizowanym” – (x − M) / SD nie zmienia kształtu rozkładu.
- Normalizacja na małej próbie – rangi centylowe w ogonach są wtedy niestabilne, a wyniki skrajne mało precyzyjne.
- Oczekiwanie, że normalizacja naprawi efekt podłogi lub sufitu – osoby z tym samym wynikiem surowym zawsze dostają ten sam wynik znormalizowany.
- Normalizacja „dla testów parametrycznych” bez sprawdzenia, czy jest potrzebna – rozważ najpierw metody odporne.
- Odczytywanie różnic znormalizowanych wyników T jak różnic punktów surowych – normalizacja zmienia odstępy między osobami.
Najczęstsze pytania
Co to jest wynik znormalizowany?
To wynik standardowy, np. wynik T lub sten, obliczony przez pozycję wyniku surowego w rozkładzie grupy odniesienia: najpierw ranga centylowa, potem wartość z, która w rozkładzie normalnym ma tę samą rangę. Dzięki temu wyniki znormalizowane mają rozkład zbliżony do normalnego, nawet gdy wyniki surowe były skośne.
Czym różni się wynik znormalizowany od standaryzowanego?
Wynik standaryzowany liniowo liczy się ze wzoru z = (x − M) / SD; zmienia on jednostkę, ale nie kształt rozkładu. Wynik znormalizowany powstaje z rangi centylowej i zmienia kształt rozkładu na zbliżony do normalnego. Przy rozkładzie normalnym oba dają prawie to samo, przy skośnym – wyraźnie różne wyniki w ogonach.
Jak obliczyć wynik znormalizowany w R lub Excelu?
Policz rangę centylową (odsetek niższych wyników plus połowa odsetka takich samych), zamień ją na z funkcją qnorm() w R lub ROZKŁ.NORMALNY.S.ODWR w Excelu i przelicz na T = 50 + 10z. W R całość zapiszesz jako 50 + 10 * qnorm((rank(x) - 0.5) / length(x)).
Kiedy stosować wyniki znormalizowane?
Głównie przy opracowywaniu norm testu, gdy rozkład wyników surowych w dużej grupie normalizacyjnej jest wyraźnie skośny, a zakłada się, że sama cecha ma rozkład normalny. W małych próbach rangi w ogonach są niestabilne. Do analiz statystycznych normalizacja nie jest uniwersalnym rozwiązaniem – rozważ najpierw metody odporne.
Czy steny i staniny są wynikami znormalizowanymi?
Mogą być jednym i drugim: sten można policzyć liniowo (5.5 + 2z) albo z rangi centylowej. W podręcznikach testów steny i staniny często podaje się jako wyniki znormalizowane – sprawdź opis norm. Zob. skala stenowa i normy testowe.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Jak zbudować i zwalidować skalę psychometryczną?
Od definicji konstruktu i tworzenia pozycji po pilotaż, EFA, CFA, rzetelność, trafność teoretyczną, różnicową i niezmienniczość.
Czytaj →PoradnikJak sprawdzić normalność rozkładu
Co ma być normalne, wykres Q-Q reszt, skośność i kurtoza, granice testu Shapiro-Wilka i sześć strategii na brak normalności – z kodem R, SPSS i opisem APA.
Czytaj →PoradnikDobre pozycje testowe i liczebność próby w IRT
Kryteria dobrej pozycji, przykłady z badań, planowanie próby symulacją Monte Carlo w R i najważniejsze przeliczenia parametrów IRT.
Czytaj →PoradnikKonwerter wyników na normy
Wynik surowy na z, T, sten, stanin i centyl oraz w drugą stronę – z granicami stenów i staninów, kodem R i opisem do pracy.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Beasley, T. M., Erickson, S., & Allison, D. B. (2009). Rank-based inverse normal transformations are increasingly used, but are they merited? Behavior Genetics, 39(5), 580–595. https://doi.org/10.1007/s10519-009-9281-0 ● Otwarty dostęp
- Bishara, A. J., & Hittner, J. B. (2012). Testing the significance of a correlation with nonnormal data: Comparison of Pearson, Spearman, transformation, and resampling approaches. Psychological Methods, 17(3), 399–417. https://doi.org/10.1037/a0028087
- Micceri, T. (1989). The unicorn, the normal curve, and other improbable creatures. Psychological Bulletin, 105(1), 156–166. https://doi.org/10.1037/0033-2909.105.1.156
- Soloman, S. R., & Sawilowsky, S. S. (2009). Impact of rank-based normalizing transformations on the accuracy of test scores. Journal of Modern Applied Statistical Methods, 8(2), Article jmasm.eP1519. https://doi.org/10.22237/jmasm/1257034080 ● Otwarty dostęp
Cytowania BibTeX
@article{beasley2009rank, author={Beasley, T. Mark and Erickson, Stephen and Allison, David B.}, title={{Rank-based inverse normal transformations are increasingly used, but are they merited?}}, journal={Behavior Genetics}, year={2009}, volume={39}, number={5}, pages={580--595}, doi={10.1007/s10519-009-9281-0}}@article{bishara2012testing, author={Bishara, Anthony J. and Hittner, James B.}, title={{Testing the significance of a correlation with nonnormal data: Comparison of Pearson, Spearman, transformation, and resampling approaches}}, journal={Psychological Methods}, year={2012}, volume={17}, number={3}, pages={399--417}, doi={10.1037/a0028087}}@article{micceri1989unicorn, author={Micceri, Theodore}, title={{The unicorn, the normal curve, and other improbable creatures}}, journal={Psychological Bulletin}, year={1989}, volume={105}, number={1}, pages={156--166}, doi={10.1037/0033-2909.105.1.156}}@article{soloman2009impact, author={Soloman, Shira R. and Sawilowsky, Shlomo S.}, title={{Impact of rank-based normalizing transformations on the accuracy of test scores}}, journal={Journal of Modern Applied Statistical Methods}, year={2009}, volume={8}, number={2}, pages={448--462}, eid={jmasm.eP1519}, doi={10.22237/jmasm/1257034080}}