Co to jest wynik surowy?
Wynik surowy (ang. raw score) to wynik uzyskany bezpośrednio z odpowiedzi osoby badanej według klucza testu, zanim przeliczy się go na jakąkolwiek skalę standardową. Może to być liczba poprawnych odpowiedzi w teście zdolności, suma lub średnia punktów w kwestionariuszu, liczba błędów albo czas wykonania zadania.
Sam wynik surowy mówi niewiele. Czy 52 punkty to dużo? To zależy od zakresu testu, od tego, jak odpowiadają inni ludzie, i od tego, czy wyższy wynik oznacza nasilenie cechy, czy jej brak. Dlatego wynik surowy jest punktem wyjścia: odnosi się go do norm testowych i przelicza na wyniki standardowe – z, T, steny albo wyniki znormalizowane.
Jak liczy się wynik surowy?
- Zastosuj klucz – ustal, które pozycje wchodzą do skali lub podskali i ile punktów daje każda odpowiedź.
- Odwróć pozycje sformułowane przeciwnie (zob. pozycja odwrócona i rekodowanie).
- Zsumuj albo uśrednij odpowiedzi – sumę stosuj, gdy wymagają jej normy lub punkty odcięcia z podręcznika; średnia zachowuje metrykę odpowiedzi (szczegóły w haśle skala Likerta).
- Zastosuj regułę braków danych ustaloną przed analizą, np. „wynik liczymy, gdy osoba odpowiedziała na co najmniej 80% pozycji”. Wtedy wynik proporcjonalny to średnia odpowiedzi pomnożona przez liczbę pozycji. Zwykła suma przy jednej brakującej odpowiedzi zaniża wynik: w przykładzie z kodu R wynosi 51 punktów zamiast 53.7.
Sumowanie odpowiedzi wygląda na zwykłą arytmetykę, ale ma założenia. McNeish i Wolf (2020) pokazują, że wynik sumaryczny odpowiada szczególnemu, mocno ograniczonemu modelowi czynnikowemu, więc wymaga uzasadnienia jak każdy model. Widaman i Revelle (2023) odpowiadają, że kluczowa jest jednowymiarowość pozycji – gdy ją potwierdzono, sumy często mają solidne podstawy psychometryczne. Praktycznie: zanim zsumujesz pozycje, sprawdź strukturę i spójność wewnętrzną skali.
Dlaczego wyników surowych nie porównuje się między testami?
Wyniki surowe dwóch różnych testów nie mają wspólnej jednostki. Różnią się:
- zakresem – 20 pozycji ocenianych od 1 do 4 daje zakres 20–80, a 10 pozycji ocenianych od 0 do 3 – zakres 0–30;
- trudnością i treścią pozycji – łatwy test daje wysokie wyniki prawie wszystkim (efekt sufitu);
- rozproszeniem – różnica 5 punktów może być ogromna w jednym teście i drobna w drugim;
- grupą odniesienia – ten sam wynik ma inne znaczenie u nastolatków i u dorosłych.
Cohen, Cohen, Aiken i West (1999) zwracają uwagę, że miary w naukach behawioralnych rzadko mają zrozumiałe jednostki, przez co wyniki opisuje się tylko kierunkiem efektu albo w jednostkach standaryzowanych. Porównanie wymaga więc przekształcenia wyników do wspólnej skali.
Jak przekształcić wynik surowy?
| Przekształcenie | Wzór | Czego wymaga |
|---|---|---|
| POMP – procent maksymalnego możliwego wyniku | 100 × (X − min) / (max − min) | Tylko zakresu skali |
| Wynik z (standaryzacja) | (X − M) / SD | M i SD grupy odniesienia |
| Wynik T, steny, staniny | T = 50 + 10z; sten = 5.5 + 2z | Jak wynik z |
| Ranga centylowa (percentyl) | Odsetek niższych wyników w grupie odniesienia | Całego rozkładu w grupie odniesienia |
| Wynik znormalizowany | z odpowiadające randze centylowej w rozkładzie normalnym | Całego rozkładu; przydatny przy rozkładzie skośnym |
POMP nie wymaga norm: Cohen i in. (1999) pokazali, że przeliczenie wyniku na procent maksymalnego możliwego wyniku w wielu sytuacjach daje użyteczną dodatkową informację. Mówi jednak tylko, gdzie wynik leży w zakresie skali, a nie – jak wypada na tle innych ludzi. Do tego potrzebne są normy, a te muszą dotyczyć jasno opisanej populacji (American Educational Research Association i in., 2014).
Przykład: ta sama osoba w dwóch kwestionariuszach
Studentka uzyskała 52 punkty w kwestionariuszu A (20 pozycji 1–4, zakres 20–80) i 18 punktów w kwestionariuszu B (10 pozycji 0–3, zakres 0–30). Porównanie „52 jest więcej niż 18” nie ma sensu. Średnie na pozycję (2.6 i 1.8) też nie, bo pozycje mają inne skale odpowiedzi. POMP daje 53.3 w A i 60.0 w B.
Oba kwestionariusze mają normy z prób po 500 osób (dane symulowane): w A M = 48.25, SD = 11.52, w B M = 7.46, SD = 5.32, przy rozkładzie prawostronnie skośnym (skośność 0.74). Wynik w A odpowiada z = 0.33, T = 53.3 i randze centylowej 60.6 – jest przeciętny. Wynik w B to z = 1.98, T = 69.8 i ranga centylowa 95.5 – wyższy niż u 95% grupy odniesienia. Choć 18 to „mniej punktów” niż 52, właśnie ten wynik jest nietypowy (rysunek 1).
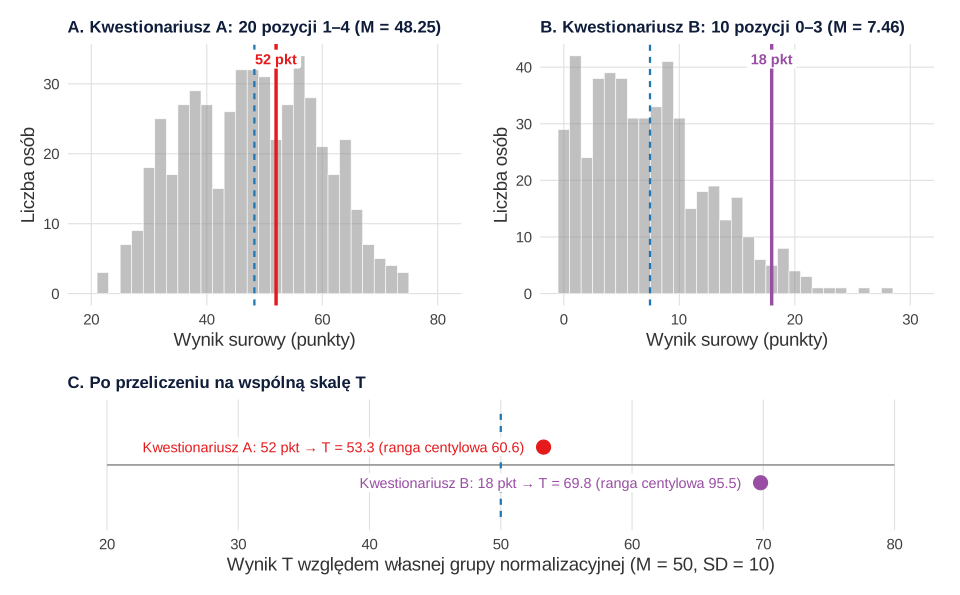
Zwróć uwagę na skośność B. Liniowy wynik z = 1.98 w rozkładzie normalnym odpowiadałby randze centylowej 97.6, a rzeczywista ranga centylowa wynosi 95.5. Przy skośnych rozkładach normy podaje się więc zwykle jako wyniki znormalizowane.
Jak opisać wynik surowy w pracy
W części o narzędziach podaj sposób liczenia wyniku: liczbę pozycji, skalę odpowiedzi, pozycje odwrócone, sumę lub średnią, zakres, kierunek i regułę braków. W wynikach podaj M i SD wyników surowych, a gdy odnosisz je do norm – nazwę i rok tabel norm. Wzór:
Cały opis narzędzi badawczych omawia poradnik rozdział metodologiczny pracy magisterskiej. Skąd wziąć klucz, normy i zgodę na użycie kwestionariusza, wyjaśniamy w poradniku Gdzie znaleźć kwestionariusze psychologiczne.
Przykład w R
Kod tworzy dwie grupy normalizacyjne z przykładu, przelicza wyniki 52 i 18 punktów na POMP, z, T i rangę centylową oraz porównuje sumę z wynikiem proporcjonalnym przy brakującej odpowiedzi. Liczby w tekście i na rysunku 1 pochodzą z tego kodu (skośność i ranga „obiecywana” przez rozkład normalny – w pełnym skrypcie strony).
Wynik surowy, POMP, wynik T i ranga centylowa
R
set.seed(96)
odpowiedzi <- function(n, k, progi, przes, l = 0.6) {      # k pozycji, kategorie 0..length(progi)
  teta <- rnorm(n)
  sapply(1:k, function(j) findInterval(l * teta + sqrt(1 - l^2) * rnorm(n) + przes[j], progi))
}
A <- odpowiedzi(500, 20, c(-0.9, 0.1, 1.1), runif(20, -0.3, 0.3)) + 1   # grupa normalizacyjna A: 20 pozycji 1–4
B <- odpowiedzi(500, 10, c(0.0, 0.9, 1.7), runif(10, -0.3, 0.3))       # grupa normalizacyjna B: 10 pozycji 0–3
surA <- rowSums(A); surB <- rowSums(B)                     # wyniki surowe = sumy punktów
round(rbind(A = c(M = mean(surA), SD = sd(surA)), B = c(M = mean(surB), SD = sd(surB))), 2)
# Ta sama osoba: 52 pkt w A (zakres 20–80) i 18 pkt w B (zakres 0–30)
przelicz <- function(x, norma, min, max) {
  z <- (x - mean(norma)) / sd(norma)
  c(POMP = 100 * (x - min) / (max - min),                  # procent maksymalnego możliwego wyniku
    z = z, T = 50 + 10 * z,                                # wyniki względem norm
    PR = 100 * (sum(norma < x) + 0.5 * sum(norma == x)) / length(norma))   # ranga centylowa
}
round(rbind(A = przelicz(52, surA, 20, 80), B = przelicz(18, surB, 0, 30)), 2)
# Brak jednej odpowiedzi w A: suma zaniża wynik, średnia pozycji × 20 – nie
odp <- c(3, 2, 3, 3, 2, 4, 3, 2, 3, 3, 2, 3, NA, 2, 3, 3, 2, 3, 2, 3)
c(suma = sum(odp, na.rm = TRUE), proporcjonalnie = round(mean(odp, na.rm = TRUE) * 20, 1))
Wynik w R
      M    SD
A 48.25 11.52
B  7.46  5.32
   POMP    z     T   PR
A 53.33 0.33 53.26 60.6
B 60.00 1.98 69.79 95.5
           suma proporcjonalnie
           51.0            53.7
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietów bazowych); rysunek przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Porównywanie wyników surowych różnych testów – „52 to więcej niż 18” nic nie mówi o nasileniu cechy.
- Czytanie wyniku surowego jak procentu – 52 punkty w skali 20–80 to nie 52% i nie „52% cechy”.
- Suma bez odwrócenia pozycji – pozycje sformułowane przeciwnie obniżają wtedy rzetelność i zniekształcają wynik.
- Suma przy brakujących odpowiedziach – zaniża wynik; ustal regułę braków przed analizą.
- Normy lub punkty odcięcia z innej wersji testu – inna liczba pozycji albo inny klucz zmieniają znaczenie wyniku surowego.
- Porównywanie sum podskal o różnej liczbie pozycji – podskala z 12 pozycjami „wygrywa” z podskalą z 6 pozycjami; porównuj średnie na pozycję albo POMP.
Najczęstsze pytania
Co to jest wynik surowy?
To wynik obliczony bezpośrednio z odpowiedzi według klucza testu – np. suma punktów w kwestionariuszu, liczba poprawnych odpowiedzi w teście zdolności albo czas wykonania zadania – zanim przeliczy się go na normy. Sam w sobie mówi niewiele, dopóki nie odniesiesz go do zakresu skali albo do wyników grupy odniesienia.
Jak obliczyć wynik surowy?
Zastosuj klucz testu: odwróć pozycje sformułowane przeciwnie, a następnie zsumuj albo uśrednij odpowiedzi na pozycje danej skali. Przed analizą ustal regułę braków, np. wynik liczony przy co najmniej 80% odpowiedzi jako średnia pomnożona przez liczbę pozycji – zwykła suma przy brakach zaniża wynik.
Czy można porównywać wyniki surowe z różnych testów?
Nie wprost. Testy różnią się zakresem, trudnością, rozproszeniem wyników i grupą odniesienia, więc 52 punkty w jednym teście i 18 w drugim nie dają się porównać. Przelicz oba wyniki na wspólną skalę – POMP, wynik z, T albo rangę centylową.
Jak przeliczyć wynik surowy na steny lub wynik T?
Najlepiej odczytać sten lub wynik T z tabel norm w podręczniku testu dla właściwej grupy (wiek, płeć, wersja testu). Gdy znasz tylko M i SD grupy normalizacyjnej, policz z = (X − M) / SD, a potem T = 50 + 10z albo sten = 5.5 + 2z (zob. normy testowe).
Co to jest wynik POMP?
POMP (ang. percent of maximum possible) to wynik wyrażony jako procent możliwego zakresu skali: 100 × (X − min) / (max − min). Nie wymaga norm i pozwala zestawić skale o różnych zakresach, ale nie mówi, jak wynik wypada na tle innych ludzi.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Jak policzyć wynik kwestionariusza
Klucz, pozycje odwrócone, podskale, reguła braków, suma czy średnia i kontrola wartości – w Excelu, SPSS, R i jamovi, z plikiem .xlsx z formułami.
Czytaj →PoradnikRozdział metodologiczny – jak go napisać
Co napisać w każdym podrozdziale metody: hipotezy, zmienne, próba, narzędzia, procedura, etyka i plan analiz – z wzorami zdań i listą JARS.
Czytaj →PoradnikJak zbudować i zwalidować skalę psychometryczną?
Od definicji konstruktu i tworzenia pozycji po pilotaż, EFA, CFA, rzetelność, trafność teoretyczną, różnicową i niezmienniczość.
Czytaj →PoradnikDane z Google Forms i LimeSurvey: kodowanie do SPSS i R
Eksport, nazwy zmiennych, rekodowanie Likerta, pozycje odwrócone, wielokrotny wybór i braki – krok po kroku, z kodem R i wzorem książki kodowej.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- American Educational Research Association, American Psychological Association, & National Council on Measurement in Education. (2014). Standards for educational and psychological testing. https://www.testingstandards.net/open-access-files.html ● Otwarty dostęp
- Cohen, P., Cohen, J., Aiken, L. S., & West, S. G. (1999). The problem of units and the circumstance for POMP. Multivariate Behavioral Research, 34(3), 315–346. https://doi.org/10.1207/S15327906MBR3403_2
- McNeish, D., & Wolf, M. G. (2020). Thinking twice about sum scores. Behavior Research Methods, 52(6), 2287–2305. https://doi.org/10.3758/s13428-020-01398-0 ● Otwarty dostęp
- Widaman, K. F., & Revelle, W. (2023). Thinking thrice about sum scores, and then some more about measurement and analysis. Behavior Research Methods, 55(2), 788–806. https://doi.org/10.3758/s13428-022-01849-w ● Otwarty dostęp
Cytowania BibTeX
@book{aera2014standards, author={{American Educational Research Association} and {American Psychological Association} and {National Council on Measurement in Education}}, title={{Standards for educational and psychological testing}}, year={2014}, publisher={American Educational Research Association}, url={https://www.testingstandards.net/open-access-files.html}}@article{cohen1999problem, author={Cohen, Patricia and Cohen, Jacob and Aiken, Leona S. and West, Stephen G.}, title={{The problem of units and the circumstance for POMP}}, journal={Multivariate Behavioral Research}, year={1999}, volume={34}, number={3}, pages={315--346}, doi={10.1207/s15327906mbr3403_2}}@article{mcneish2020thinking, author={McNeish, Daniel and Wolf, Melissa Gordon}, title={{Thinking twice about sum scores}}, journal={Behavior Research Methods}, year={2020}, volume={52}, number={6}, pages={2287--2305}, doi={10.3758/s13428-020-01398-0}}@article{widaman2023thinking, author={Widaman, Keith F. and Revelle, William}, title={{Thinking thrice about sum scores, and then some more about measurement and analysis}}, journal={Behavior Research Methods}, year={2023}, volume={55}, number={2}, pages={788--806}, doi={10.3758/s13428-022-01849-w}}