Adaptacja to więcej niż tłumaczenie
Znalazłeś(-aś) dobrze opisaną skalę w języku angielskim, a polskiej wersji nie ma. Pierwszy odruch to przetłumaczyć pozycje samodzielnie i od razu zbierać dane. Tak powstaje „polska wersja”, o której nic nie wiadomo: nie wiesz, czy pozycje znaczą to samo, czy odpowiedzi mają tę samą strukturę i czy wynik można porównywać z wynikami z oryginału. Recenzent zapyta o to w pierwszym zdaniu recenzji.
Adaptacja kulturowa (ang. cross-cultural adaptation) to cały proces: zgoda autora, przekład przez kilka osób, ocena ekspertów, wywiady z osobami z grupy docelowej, pilotaż i badanie walidacyjne z analizą struktury, rzetelności, trafności i norm. Definicję i trzy poziomy równoważności omawia hasło właściwa adaptacja. Tutaj przechodzimy przez wszystkie etapy po kolei, z jednym przykładem liczonym w R.
Zakres pracy zależy od celu. Wytyczne Międzynarodowej Komisji Testów (International Test Commission [ITC], 2018) odróżniają dwie sytuacje. Jeśli chcesz tylko mierzyć konstrukt w nowej grupie językowej, kluczowe są dowody trafności polskiej wersji. Jeśli chcesz porównywać wyniki między krajami albo łączyć dane z obu wersji, potrzebujesz też dowodów równoważności, czyli inwariancji pomiaru.
| Planowane użycie | Co musisz wykazać | Minimum analiz |
|---|---|---|
| Badanie korelacyjne w Polsce, wynik jako zmienna w modelu | Zrozumiałość pozycji, struktura, rzetelność, trafność w polskiej próbie | CFA, omega, korelacje z kryteriami |
| Porównanie Polski z innym krajem albo łączenie danych z dwóch wersji | Dodatkowo: równoważność pomiaru między wersjami | Wielogrupowa CFA (co najmniej inwariancja skalarna) |
| Diagnoza indywidualna, interpretacja wyniku osoby | Dodatkowo: polskie normy na reprezentatywnej próbie | Normy (np. steny), błąd pomiaru |
Jeśli dopiero szukasz narzędzia, zacznij od wpisu gdzie znaleźć kwestionariusze psychologiczne. Polska adaptacja może już istnieć, a wtedy oszczędzisz kilka miesięcy pracy.
Które wytyczne wybrać: ITC, ISPOR czy Beaton?
W psychologii punktem odniesienia jest drugie wydanie wytycznych ITC (International Test Commission, 2018). Zawiera 18 zaleceń w sześciu grupach, każde z objaśnieniem, sugestiami praktycznymi i listą kontrolną. W badaniach zdrowia i jakości życia częściej cytuje się wytyczne Beatona i współpracowników (Beaton i in., 2000) oraz zasady dobrej praktyki grupy zadaniowej ISPOR dla narzędzi samoopisowych wypełnianych przez pacjentów (Wild i in., 2005). Grupa ISPOR zaczynała od stwierdzenia, że stosowane metody i wcześniejsze wytyczne są niespójne. Jej raport ocenia mocne i słabe strony każdego etapu.
Różnice między wytycznymi są większe, niż sugerują podręczniki. Epstein i in. (2015) przejrzeli 31 wytycznych adaptacji kwestionariuszy i nie znaleźli konsensusu. Większość zalecała komisje, grupy fokusowe i tłumaczenie zwrotne, ale brakowało dowodów, która metoda działa najlepiej. Wniosek praktyczny: wybierz jeden zestaw wytycznych, nazwij go w artykule i trzymaj się go, a odstępstwa opisz. Epstein i in. przypominają też, że adaptacja i walidacja to dwa odrębne procesy. Dobry przekład nie zastąpi badania psychometrycznego.
| Grupa zaleceń ITC | Przykładowe zalecenie | Etap w tym wpisie |
|---|---|---|
| Warunki wstępne (PC) | Uzyskaj zgodę właściciela praw przed adaptacją (PC-1) | Krok 1 |
| Opracowanie adaptacji (TD) | Dobierz ekspertów od języka, kultury, treści i konstrukcji testów (TD-1); zbierz dane pilotażowe (TD-5) | Kroki 2–5 |
| Potwierdzenie (C) | Wykaż równoważność konstruktu, metody i pozycji (C-2); zbierz dowody rzetelności, trafności i norm (C-3) | Kroki 6–10 |
| Badanie (A) | Przygotuj instrukcje i warunki badania tak, by różnice kulturowe ich nie zniekształcały | Pilotaż i badanie główne |
| Skale wyników i interpretacja (SSI) | Porównuj wyniki populacji tylko wtedy, gdy ustalono poziom inwariancji na skali, na której raportujesz wyniki (SSI-2) | Krok 7 |
| Dokumentacja (Doc) | Opisz wszystkie zmiany wprowadzone w adaptacji (Doc-1) | Raport |
Dziesięć etapów adaptacji: mapa procesu
Poniższa kolejność łączy zalecenia ITC z praktyką badań walidacyjnych. Etapy 1–5 to przygotowanie wersji językowej. Etapy 6–10 to badanie psychometryczne na pełnej próbie. Każdy etap kończy się dokumentem, który trafi do aneksu albo do materiałów dodatkowych artykułu.
- Zgoda autora i ustalenie warunków licencji – pisemna zgoda.
- Przekład: dwa niezależne tłumaczenia, synteza, tłumaczenie zwrotne albo komisja – raport z przekładu.
- Ocena ekspertów – oceny trafności pozycji i wskaźnik CVI.
- Wywiady poznawcze z osobami z grupy docelowej – tabela problemów i poprawek.
- Pilotaż – analiza pozycji, wstępna rzetelność.
- CFA w próbie walidacyjnej – dopasowanie i ładunki.
- Inwariancja pomiaru między wersjami lub krajami – tabela kolejnych modeli.
- Rzetelność – omega, alfa, ewentualnie test–retest.
- Trafność – korelacje z miarami teoretycznie bliskimi i dalekimi.
- Normy, jeśli narzędzie ma służyć do interpretacji wyników indywidualnych.
Wiele z tych kroków pokrywa się z budową nowego narzędzia. Różnica polega na tym, że w adaptacji masz punkt odniesienia: strukturę i parametry oryginału. Jak zbudować skalę od zera, opisuje wpis jak zbudować i zwalidować skalę psychometryczną.
Krok 1. Zgoda autora i prawa do narzędzia
Pierwsze zalecenie ITC brzmi: przed adaptacją uzyskaj zgodę posiadacza praw (International Test Commission, 2018, PC-1). Objaśnienie wytycznych zwraca uwagę, że ochrona zwykle nie dotyczy pojedynczego zdania typu „czuję smutek”, ale organizacji testu: struktury skal, sposobu punktowania i układu materiału. Dlatego „własna skala” z tą samą strukturą i nowymi pozycjami również może naruszać prawa autora oryginału. Wytyczne zalecają podpisane porozumienie, które określa dopuszczalne zmiany i ustala, do kogo należą prawa do wersji adaptowanej.
Stanowisko ITC o używaniu testów w badaniach (International Test Commission, 2014) dodaje kilka praktycznych zasad: na przekład testu chronionego potrzebna jest zgoda, właściciel może odmówić albo postawić warunki, a pozycji testu nie drukuje się w całości w publikacjach. W metodzie podaj nazwę i wersję narzędzia, informację o zgodzie i sposób adaptacji.
To ogólne zasady, a nie porada prawna. Status konkretnego testu sprawdź u autora albo wydawcy. Wzór wiadomości z prośbą o zgodę znajdziesz we wpisie o szukaniu kwestionariuszy. W zapytaniu od razu napisz, że planujesz adaptację, a nie tylko użycie gotowej wersji. Zapytaj też, czy autor ma już tłumaczenie w przygotowaniu albo własne wymagania co do procedury.
Krok 2. Przekład: dwa tłumaczenia, synteza i tłumaczenie zwrotne lub komisja
Według ITC tłumacz powinien znać oba języki, kulturę docelową, treść testu i zasady konstrukcji pozycji (International Test Commission, 2018, TD-1). Wytyczne odnotowują też, że praktyka jednego tłumacza podejmującego wszystkie decyzje nie jest już uznawana za dopuszczalną. W praktyce oznacza to co najmniej dwa niezależne przekłady „w przód” (np. psycholog i tłumacz bez wykształcenia psychologicznego), a potem uzgodnienie ich w jedną wersję.
Klasycznym sprawdzianem jest tłumaczenie zwrotne (ang. back-translation): osoba, która nie zna oryginału, przekłada polską wersję z powrotem na angielski, a różnice z oryginałem wskazują miejsca do dyskusji. Brislin (1970) pokazał, że jakość przekładu zależy od języka, treści i trudności tekstu, a równoważność warto oceniać także na podstawie odpowiedzi osób badanych, a nie tylko porównania tekstów. ITC (2018, TD-2) ostrzega przed słabością tej metody: wersja „dobrze się tłumaczy z powrotem”, ale po polsku brzmi sztucznie. Dlatego wytyczne polecają podwójny przekład z uzgodnieniem przez trzecią osobę lub panel ekspertów, a tłumaczenie zwrotne jako dodatkowe sprawdzenie. Przegląd Epsteina i in. (2015) również sugeruje, że tłumaczenie zwrotne nie musi być obowiązkowe, jeśli pracuje komisja.
| Problem | Przekład dosłowny | Rozwiązanie komisji |
|---|---|---|
| Idiom bez polskiego odpowiednika („I feel burned out”) | „Czuję się wypalony(-a)” – dla części osób znaczy „zmęczony(-a) pracą zawodową” | Opis stanu zamiast metafory, np. „Czuję, że studia wyczerpały moje siły”, sprawdzony w wywiadach poznawczych |
| Realia systemu edukacji („coursework”, „GPA”) | „Praca kursowa”, „średnia GPA” | „Zaliczenia i kolokwia”, „średnia ocen” |
| Forma gramatyczna płci | Tylko formy męskie | Formy obu płci albo konstrukcje bezosobowe |
| Słowa nasilenia w kategoriach odpowiedzi | „Rzadko” dla „seldom” i „rarely” | Ta sama liczba i podobne odstępy kategorii co w oryginale |
Przykłady w tabeli są ilustracją, a nie pozycjami istniejącego testu. Wszystkie decyzje komisji zapisuj w tabeli: pozycja oryginalna, dwa przekłady, wersja uzgodniona, tłumaczenie zwrotne i uzasadnienie zmian. To jest dokumentacja wymagana przez zalecenie Doc-1 (International Test Commission, 2018).
Krok 3. Ocena ekspertów i wskaźnik trafności treściowej (CVI)
Komisja decyduje o brzmieniu, a niezależni eksperci oceniają, czy każda pozycja nadal mierzy to, co miała mierzyć. Najczęściej używa się wskaźnika trafności treściowej CVI (ang. content validity index). Każdy ekspert ocenia trafność pozycji na skali 1–4. I-CVI to odsetek ekspertów, którzy dali 3 albo 4. Dla całej skali liczy się średnią I-CVI (S-CVI/Ave) albo odsetek pozycji ocenionych zgodnie przez wszystkich (S-CVI/UA). Polit i Beck (2006) pokazali, że z opublikowanych prac nie zawsze da się odczytać, którą z tych dwóch wersji policzono, a obie mogą dać różne wartości. Zawsze więc podawaj obie albo wyraźnie nazwij jedną.
CVI nie koryguje zgody przypadkowej. Polit i in. (2007) przeliczyli I-CVI na zmodyfikowaną kappę i zaproponowali, by przy co najmniej trzech ekspertach uznawać pozycje z I-CVI ≥ .78 za dowód dobrej trafności treściowej.
Tu N to liczba ekspertów, a A – liczba ekspertów, którzy uznali pozycję za trafną. W naszym przykładzie sześciu ekspertów oceniło osiem pozycji polskiej wersji hipotetycznej skali wypalenia studenckiego. Skala ma dwa czynniki: wyczerpanie (W1–W4) i dystans wobec studiów (D1–D4). Pięć pozycji uzyskało I-CVI = 1.00, a pozycje W4 i D4 – po .83 (κ* = .82). Pozycja D2 dostała tylko trzy oceny „trafna”, I-CVI = .50, pc = .312, κ* = .27. Dla całej skali S-CVI/Ave = .90, a S-CVI/UA = .62.
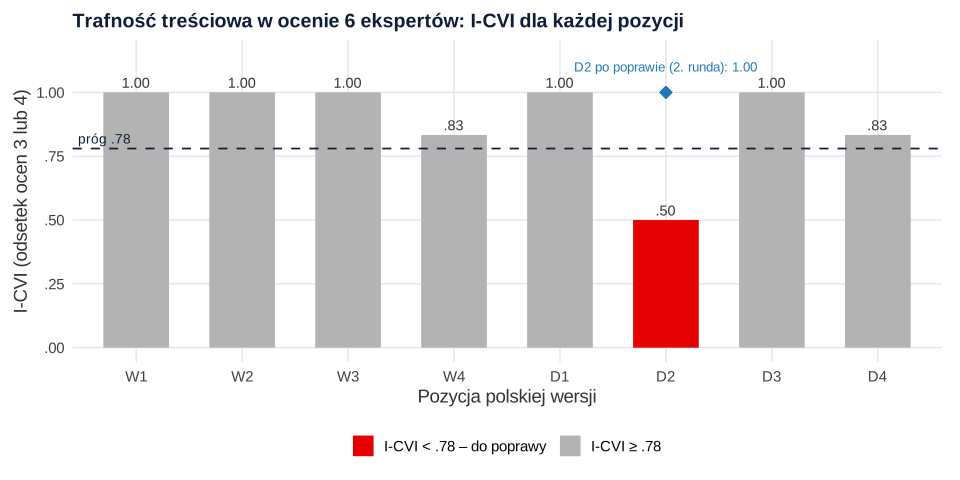
Komisja przeredagowała D2, a w drugiej rundzie wszyscy eksperci ocenili nową wersję jako trafną (I-CVI = 1.00). S-CVI/Ave wzrósł do .96, a S-CVI/UA do .75. Wynik pierwszej rundy też opisz w raporcie, bo pokazuje, że procedura rzeczywiście wychwyciła problem.
Krok 4. Wywiady poznawcze z osobami z grupy docelowej
Eksperci znają konstrukt, ale nie odpowiadają na kwestionariusz jak przeciętny student. Ten brak uzupełnia wywiad poznawczy: osoba z grupy docelowej odpowiada na pozycje, a badacz pyta, jak rozumie pytanie, skąd wzięła odpowiedź i co znaczy dla niej dana kategoria. Beatty i Willis (2007) opisują to jako zadawanie roboczych pytań ankietowych z jednoczesnym zbieraniem dodatkowych informacji werbalnych o tym, jak powstaje odpowiedź. ITC (2018, TD-3) wymienia wywiady poznawcze wśród sposobów zbierania dowodów, że instrukcja i pozycje mają podobne znaczenie w obu grupach.
Planuj kilka krótkich rund zamiast jednej długiej. W eksperymencie Lenznera i in. (2023) problemy wykryte w dziesięciu wywiadach rzeczywiście pojawiały się w badaniu właściwym. Sama poprawka nie gwarantowała jednak lepszych danych. Dlatego poprawione pozycje sprawdza się w kolejnej rundzie.
| Pozycja | Co mówili uczestnicy | Decyzja |
|---|---|---|
| D4 | Część osób rozumiała pozycję jako pytanie o zmęczenie, a nie o dystans wobec studiów | Przeredagowanie i ponowny test w 2. rundzie |
| Instrukcja | Niejasne, czy „ostatnio” to tydzień czy cały semestr | Dopisanie ram czasowych: „w ciągu ostatniego miesiąca” |
| Kategorie odpowiedzi | „Czasami” i „dość często” brzmiały prawie tak samo | Zmiana etykiety zgodnie z tabelą przekładu kategorii |
Jak przeprowadzić wywiad, ilu uczestników zaprosić i jak dokumentować problemy, opisuje hasło o wywiadzie poznawczym. Wywiady często odsłaniają też kłopoty z formą odpowiedzi, np. z liczbą punktów skali Likerta albo z pozycjami odwróconymi.
Krok 5. Pilotaż i analiza pozycji
Badanie pilotażowe to pierwszy kontakt narzędzia z danymi ilościowymi. ITC (2018, TD-5) zaleca zebrać dane pilotażowe, które pozwolą przeprowadzić analizę pozycji, ocenić rzetelność i wykonać małe badania trafności, zanim zaczniesz kosztowne badanie normalizacyjne. Pilotaż nie służy do testowania hipotez. Ma wykryć pozycje bez zróżnicowania, z odwrotnym kierunkiem korelacji, z dużą liczbą braków albo z efektem sufitu lub podłogi.
W przykładzie pilotaż objął 60 osób. Skorygowane korelacje pozycja–reszta skali (analiza pozycji testu) wynosiły od .41 do .56 w podskali wyczerpania i od .45 do .51 w podskali dystansu. Alfa w obu podskalach wyniosła .70. Przy 60 osobach przedział ufności dla alfy jest szeroki, więc wynik pilotażu traktuj jako sygnał „nic się nie sypie”, a nie jako ostateczną ocenę rzetelności. Więcej o planowaniu pilotażu: badanie pilotażowe – po co, ile osób, co sprawdzić.
Badanie walidacyjne w przykładzie
Właściwe badanie walidacyjne objęło 410 studentów (polska wersja) i 450 studentów z próby oryginalnej (wersja angielska). ITC (2018, C-1) podaje orientacyjne liczebności: badania struktury czynnikowej wymagają raczej 300 lub więcej osób, a analizy zróżnicowanego funkcjonowania pozycji (DIF) – co najmniej 200 osób na wersję. W polskiej próbie zebrano dodatkowo trzy miary do oceny trafności: stres (10–50), satysfakcję ze studiów (1–7) i ekstrawersję (1–5). Wszystkie dane są symulowane. Plik z danymi pobierzesz w sekcji z kodem.
W danych celowo ukryliśmy jeden problem, który często pojawia się w adaptacjach. Polskie sformułowanie pozycji D4 jest nieco łagodniejsze niż oryginał, więc przy tym samym poziomie dystansu osoby wybierają na niej wyższe odpowiedzi. Zobaczymy, który krok analizy to wychwyci.
Krok 6. Konfirmacyjna analiza czynnikowa polskiej wersji
W adaptacji nie szukasz struktury od nowa, tylko sprawdzasz, czy struktura oryginału pasuje do polskich danych. Służy do tego konfirmacyjna analiza czynnikowa (CFA). Przy pozycjach z pięcioma kategoriami odpowiedzi użyliśmy estymatora MLR, odpornego na odchylenia od normalności. Przy mniejszej liczbie kategorii albo silnej skośności rozważ estymator WLSMV dla danych porządkowych.
Model dwuczynnikowy był dobrze dopasowany: skalowany χ²(19) = 20.33, p = .375, CFI = .999, TLI = .998, RMSEA = .013, 90% CI [.000, .045], SRMR = .025. Hu i Bentler (1999) proponowali punkty odcięcia bliskie .95 dla CFI, .06 dla RMSEA i .08 dla SRMR oraz łączne raportowanie co najmniej dwóch wskaźników. Te wartości pochodzą z konkretnych warunków symulacji, więc traktuj je jako orientację, a nie sztywne progi.
Standaryzowane ładunki czynnikowe wynosiły od .67 do .70 dla wyczerpania i od .61 do .77 dla dystansu. Najsłabszy był ładunek D4: .61, 95% CI [.53, .68]. Korelacja czynników wyniosła .52, 95% CI [.42, .61]. W próbie oryginalnej ten sam model miał CFI = .992 i RMSEA = .032, a ładunki od .60 do .78.
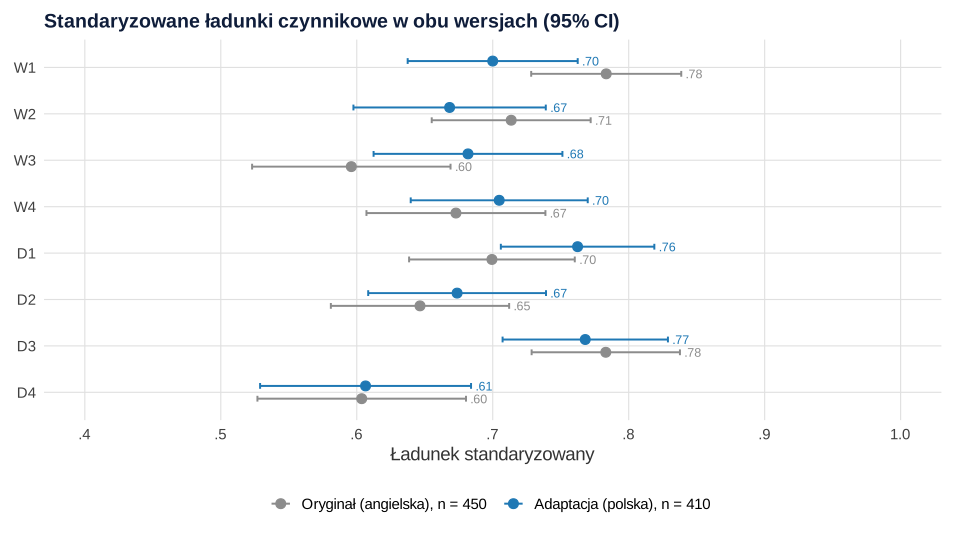
Zgodność ładunków to dobra wiadomość, ale jeszcze nie dowód równoważności. Rysunek 2 porównuje dwa osobne modele. Formalne porównanie wymaga jednego modelu wielogrupowego, w którym parametry obu wersji są kolejno zrównywane.
Krok 7. Inwariancja pomiaru między wersjami językowymi
ITC (2018, C-2) wymaga dowodów równoważności konstruktu, metody i pozycji, gdy wyniki z różnych wersji mają być porównywane. W psychometrii robi się to wielogrupową CFA. Najpierw dopasowuje się ten sam model w obu grupach (inwariancja konfiguracyjna), potem zrównuje ładunki (metryczna), a następnie wyrazy wolne (skalarna). Brak inwariancji oznacza, że konstrukt może mieć w różnych grupach inną strukturę albo znaczenie (Putnick i Bornstein, 2016). Pełną procedurę z decyzjami na każdym poziomie, testami punktowymi i wariantem dla danych porządkowych opisuje wpis inwariancja pomiaru krok po kroku. Tutaj pokazujemy tylko wynik dla naszych dwóch wersji językowych.
Jako kryterium przyjęliśmy spadek CFI nie większy niż .010 łącznie ze wzrostem RMSEA nie większym niż .015, czyli wartości, które Putnick i Bornstein (2016) przytaczają za Chen (2007). Chen zastrzega jednak, że zmiany wskaźników zależą od wzoru i odsetka nieinwariantnych pozycji oraz od liczebności grup.
Tabela 1
Inwariancja pomiaru skali wypalenia studenckiego między wersją angielską i polską
| Model | χ² | df | CFI | RMSEA | SRMR | ΔCFI | ΔRMSEA |
|---|---|---|---|---|---|---|---|
| Konfiguracyjny | 48.23 | 38 | .995 | .025 | .022 | – | – |
| Metryczny | 58.24 | 44 | .993 | .027 | .033 | −.002 | .002 |
| Skalarny | 150.56 | 50 | .952 | .067 | .052 | −.041 | .040 |
| Częściowo skalarny (D4 uwolniona) | 63.39 | 49 | .993 | .026 | .034 | .000 | −.001 |
Uwaga. N = 860 (wersja angielska n = 450, polska n = 410). Estymator MLR; χ² skalowany (korekta Yuana–Bentlera), CFI i RMSEA w wersji odpornej. Δ liczone względem modelu metrycznego. Dane symulowane.
Inwariancja metryczna została spełniona (ΔCFI = −.002, ΔRMSEA = .002; skalowany test różnicy χ²(6) = 10.06, p = .122), a pełna skalarna wyraźnie nie (ΔCFI = −.041, ΔRMSEA = .040; χ²(6) = 90.82, p < .001). Test punktowy wskazał wyraz wolny D4 jako główne źródło problemu, χ²(1) = 81.70, p < .001. Drugi w kolejności był D3 (χ²(1) = 19.65), ale po uwolnieniu D4 jego wartość spadła do 3.07 (p = .080). To częste zjawisko: jeden źle dopasowany parametr „rozlewa się” na sąsiednie, dlatego uwalniaj ograniczenia pojedynczo.
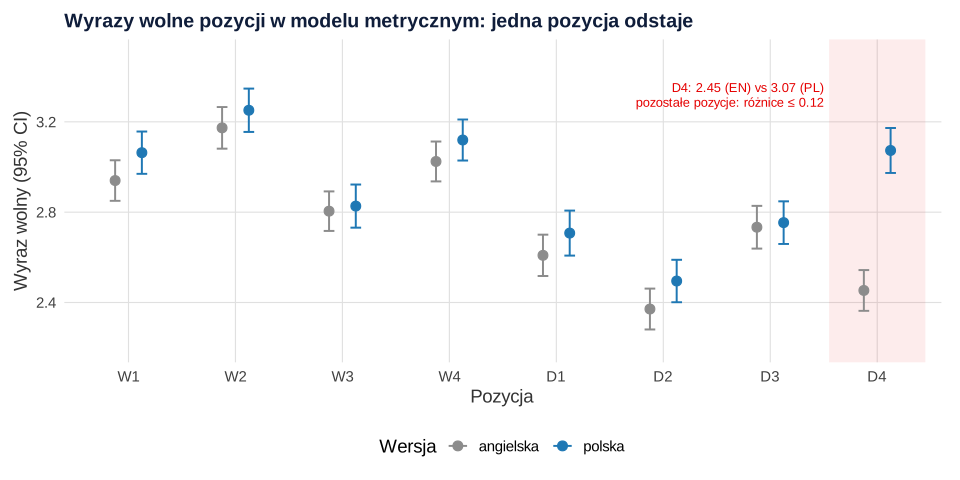
Model z uwolnionym wyrazem wolnym D4 nie różnił się od metrycznego (ΔCFI = .000; χ²(5) = 5.19, p = .393). W wersji angielskiej wyraz wolny D4 wynosił 2.45, 95% CI [2.36, 2.54], a w polskiej 3.01, 95% CI [2.91, 3.12]. Po uwzględnieniu tej różnicy średnie latentne obu wersji nie różniły się istotnie: wyczerpanie 0.09, 95% CI [−0.02, 0.20], p = .103, dystans 0.07, 95% CI [−0.04, 0.19], p = .200 (w jednostkach odchylenia standardowego czynnika w wersji angielskiej).
Co z tym zrobić w adaptacji? Wynik wraca do kroku 2. Komisja powinna porównać D4 z oryginałem i z notatkami z wywiadów poznawczych. Jeśli przyczyną jest przekład, przeredaguj pozycję i sprawdź ją na nowej próbie. Jeśli różnica wynika z kultury, a nie z przekładu, opisz ją i porównuj sumy surowe ostrożnie: przy uwolnionym wyrazie wolnym porównanie średnich latentnych jest uprawnione, ale prosta suma punktów z podskali dystansu będzie w polskiej wersji nieco zawyżona.
Krok 8. Rzetelność polskiej wersji
ITC (2018, C-3) przypomina, że rzetelność i trafność oryginału nie przechodzą automatycznie na adaptację. Polska wersja potrzebuje własnych dowodów. Z modelu CFA policzyliśmy omegę McDonalda: .78 dla wyczerpania i .80 dla dystansu. Alfa Cronbacha wyniosła odpowiednio .78 i .79, bo ładunki w podskalach są podobne. Gdy ładunki wyraźnie się różnią, alfa i omega się rozjeżdżają – więcej o tym we wpisie alfa Cronbacha: jak oceniać rzetelność skali.
Wytyczne ITC zwracają też uwagę, że rzetelność zależy zarówno od testu, jak i od populacji. Ten sam błąd pomiaru da niższą rzetelność w bardziej jednorodnej próbie. Jeśli polska rzetelność jest wyraźnie niższa niż w oryginale, porównaj odchylenia standardowe wyników w obu próbach, zanim uznasz przekład za gorszy. Jeśli narzędzie ma mierzyć zmianę albo cechę stałą, dodaj rzetelność test–retest.
Krok 9. Trafność: zbieżna i różnicowa
Struktura czynnikowa to jedno źródło dowodów trafności teoretycznej. Drugie to związki z innymi zmiennymi: wynik powinien korelować z miarami teoretycznie bliskimi (trafność zbieżna) i słabo z miarami odległymi (trafność różnicowa). Hipotezy o kierunku i przybliżonej sile korelacji zapisz przed analizą. Bez tego każda korelacja „pasuje”.
| Miara | Hipoteza | Wyczerpanie r [95% CI] | Dystans r [95% CI] |
|---|---|---|---|
| Stres (10–50) | dodatnia, umiarkowana | .39 [.30, .47] | .27 [.18, .36] |
| Satysfakcja ze studiów (1–7) | ujemna, silniejsza dla dystansu | −.14 [−.23, −.04] | −.31 [−.39, −.22] |
| Ekstrawersja (1–5) | bliska zera | .02 [−.08, .12] | .03 [−.06, .13] |
Wszystkie trzy hipotezy się potwierdziły. Wyczerpanie silniej wiązało się ze stresem, dystans – z niższą satysfakcją ze studiów, a korelacje z ekstrawersją były bliskie zera (p = .716 i .509). Pamiętaj, że brak istotności nie dowodzi zerowej korelacji. O trafności różnicowej mówi tu wąski przedział ufności wokół zera. Wspólna metoda pomiaru (wszystko z samoopisu) może zawyżać korelacje zbieżne, dlatego warto dodać choć jedną miarę z innego źródła, np. dane o zaliczeniach.
Krok 10. Normy dla polskiej wersji
Normy są potrzebne tylko wtedy, gdy wynik ma być interpretowany indywidualnie, np. w diagnozie albo w poradnictwie. W badaniach naukowych zwykle wystarczają wyniki surowe. ITC (2018, C-3) zaleca, by normy oryginału stosować tylko wtedy, gdy masz dowody, że jest to uprawnione i sprawiedliwe. W przeciwnym razie trzeba opracować własne normy testowe.
W przykładzie przeliczyliśmy wyniki surowe podskal (4–20) na steny wzorem sten = 2z + 5.5, z zaokrągleniem i ograniczeniem do zakresu 1–10. W polskiej próbie wyczerpanie miało M = 12.26, SD = 3.03, a dystans M = 11.03, SD = 3.15.
| Sten | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 |
|---|---|---|---|---|---|---|---|---|---|---|
| Wyczerpanie | 4–6 | 7 | 8–9 | 10 | 11–12 | 13 | 14–15 | 16 | 17–18 | 19–20 |
| Dystans | 4 | 5–6 | 7 | 8–9 | 10–11 | 12 | 13–14 | 15 | 16–17 | 18–20 |
Ta tabela ma charakter ćwiczebny. Norm nie buduje się na próbie wygodnej 410 studentów z jednego badania, bo nie reprezentuje ona populacji, do której narzędzie będzie stosowane. Prawdziwe normy wymagają zaplanowanego doboru próby, podziału według płci i wieku, gdy wyniki się różnią, oraz raportu błędu pomiaru.
Jak opisać adaptację w artykule
Opis adaptacji w artykule empirycznym jest zwykle krótki, ale kompletny. Szczegółowe tabele przekładu i wywiadów poznawczych dołącz jako materiały dodatkowe. Wzór dla przykładu z tego wpisu:
Tabelę dopasowania modeli sformatujesz według hasła tabela dopasowania modelu CFA w APA. Jeśli recenzent pyta o konkretny etap albo o to, czy wolno porównywać kraje przy częściowej inwariancji, pomocny będzie wpis zarzuty recenzentów do statystyki. Gdy chcesz, żeby ktoś sprawdził cały plan walidacji albo przeprowadził analizy psychometryczne do artykułu, zajrzyj do oferty analiz dla badaczy.
Adaptacja kwestionariusza w R: kod i wynik
Cztery przepisy uruchamiasz po kolei w jednej sesji R: pierwszy liczy CVI, drugi generuje dane symulowane i dopasowuje CFA, trzeci i czwarty korzystają z obiektów utworzonych w drugim. Liczby w tekście, tabelach i na rysunkach pochodzą z tych obliczeń. Dane obu wersji i zmienne trafności pobierzesz jako plik adaptacja-kwestionariusza-dane.csv (860 wierszy; kolumny W1–W4, D1–D4, wersja, stres, satysfakcja, ekstrawersja). Więcej przykładów składni lavaan znajdziesz we wpisie CB-SEM w R.
Krok 3: I-CVI, S-CVI i zmodyfikowana kappa
R
# Ocena ekspertów: trafność treściowa polskiej wersji (I-CVI, S-CVI, zmodyfikowana kappa)
# Sześciu ekspertów oceniło trafność każdej z 8 pozycji na skali 1–4
# (1 = nietrafna, 2 = wymaga dużych zmian, 3 = trafna po drobnych zmianach, 4 = w pełni trafna).
# Dane symulowane (oceny wpisane ręcznie jako przykład).
oceny <- matrix(c(
  4, 4, 3, 4, 4, 3,   # W1
  4, 3, 4, 4, 3, 4,   # W2
  3, 4, 4, 3, 4, 4,   # W3
  4, 4, 4, 3, 2, 4,   # W4
  4, 3, 3, 4, 4, 4,   # D1
  2, 3, 2, 4, 2, 3,   # D2
  4, 4, 3, 3, 4, 3,   # D3
  3, 4, 4, 4, 3, 2),  # D4
  nrow = 8, byrow = TRUE,
  dimnames = list(c(paste0("W", 1:4), paste0("D", 1:4)), paste0("E", 1:6)))

N  <- ncol(oceny)                      # liczba ekspertów
A  <- rowSums(oceny >= 3)              # ilu ekspertów uznało pozycję za trafną (3 lub 4)
I_CVI <- A / N
pc <- choose(N, A) * 0.5^N             # prawdopodobieństwo zgody przypadkowej
kappa_mod <- (I_CVI - pc) / (1 - pc)   # zmodyfikowana kappa (Polit i in., 2007)
wynik <- data.frame(trafna = A, I_CVI = round(I_CVI, 2), pc = round(pc, 3), kappa = round(kappa_mod, 2),
                    decyzja = ifelse(I_CVI >= .78, "zostaje", "do poprawy"))
wynik

# Indeksy dla całej skali: średnia I-CVI (S-CVI/Ave) i pełna zgodność (S-CVI/UA)
round(c(S_CVI_Ave = mean(I_CVI), S_CVI_UA = mean(I_CVI == 1)), 2)

# Po poprawieniu D2 (nowe sformułowanie po dyskusji komisji) – druga runda ocen tej pozycji
D2_runda2 <- c(4, 3, 4, 4, 3, 4)
c(I_CVI_D2_runda2 = mean(D2_runda2 >= 3))
I_CVI2 <- I_CVI; I_CVI2["D2"] <- mean(D2_runda2 >= 3)
round(c(S_CVI_Ave_runda2 = mean(I_CVI2), S_CVI_UA_runda2 = mean(I_CVI2 == 1)), 2)
Wynik w R
   trafna I_CVI    pc kappa    decyzja
W1      6  1.00 0.016  1.00    zostaje
W2      6  1.00 0.016  1.00    zostaje
W3      6  1.00 0.016  1.00    zostaje
W4      5  0.83 0.094  0.82    zostaje
D1      6  1.00 0.016  1.00    zostaje
D2      3  0.50 0.312  0.27 do poprawy
D3      6  1.00 0.016  1.00    zostaje
D4      5  0.83 0.094  0.82    zostaje
S_CVI_Ave  S_CVI_UA
     0.90      0.62
I_CVI_D2_runda2
              1
S_CVI_Ave_runda2  S_CVI_UA_runda2
            0.96             0.75
Kroki 5–6: pilotaż i CFA polskiej wersji
R
suppressPackageStartupMessages(library(lavaan))
options(width = 110)

# Dane symulowane: hipotetyczna 8-pozycyjna skala wypalenia studenckiego (odpowiedzi 1–5),
# dwa czynniki: wyczerpanie (W1–W4) i dystans wobec studiów (D1–D4).
# Próba oryginalna (angielska) n = 450, próba polska n = 410, pilotaż polski n = 60.
# W polskiej wersji pozycja D4 ma wyraz wolny wyższy o 0.45: sformułowanie po adaptacji jest „łagodniejsze”,
# więc przy tym samym poziomie dystansu osoby wybierają wyższe odpowiedzi.
set.seed(5207)
pozycje <- c(paste0("W", 1:4), paste0("D", 1:4))
lambda  <- c(0.80, 0.75, 0.70, 0.75,  0.75, 0.70, 0.80, 0.65)
nu      <- c(3.0, 3.2, 2.8, 3.1,  2.6, 2.4, 2.7, 2.5)
czynnik <- rep(1:2, each = 4)

generuj <- function(n, srednie = c(0, 0), r = .55, przesuniecie = rep(0, 8)) {
  eta <- MASS::mvrnorm(n, srednie, matrix(c(1, r, r, 1), 2))
  y <- sapply(1:8, function(j) nu[j] + przesuniecie[j] + lambda[j] * eta[, czynnik[j]] +
                rnorm(n, sd = sqrt(1 - lambda[j]^2)))
  y <- apply(y, 2, function(x) findInterval(x, c(1.5, 2.5, 3.5, 4.5)) + 1)
  list(pozycje = setNames(as.data.frame(y), pozycje), eta = eta)
}
en <- generuj(450)
pl <- generuj(410, srednie = c(0.10, 0.05), przesuniecie = c(rep(0, 7), 0.45))
pilot <- generuj(60, przesuniecie = c(rep(0, 7), 0.45))$pozycje

# Zmienne do trafności w próbie polskiej: stres (10–50), satysfakcja ze studiów (1–7), ekstrawersja (1–5)
pl_d <- pl$pozycje
pl_d$stres       <- round(pmin(pmax(30 + 4.5 * (0.55 * pl$eta[, 1] + 0.20 * pl$eta[, 2]) + rnorm(410, sd = 5.5), 10), 50))
pl_d$satysfakcja <- round(pmin(pmax(4.4 - 0.55 * (0.20 * pl$eta[, 1] + 0.55 * pl$eta[, 2]) + rnorm(410, sd = 1.0), 1), 7), 1)
pl_d$ekstrawersja <- round(pmin(pmax(3.2 + 0.05 * pl$eta[, 1] + rnorm(410, sd = 0.7), 1), 5), 1)
dane <- rbind(cbind(en$pozycje, wersja = "angielska"), cbind(pl$pozycje, wersja = "polska"))
table(dane$wersja)

# 1. Pilotaż (n = 60): analiza pozycji – skorygowana korelacja pozycja–reszta skali
pil <- sapply(list(W = paste0("W", 1:4), D = paste0("D", 1:4)), function(s) {
  a <- suppressWarnings(psych::alpha(pilot[, s], warnings = FALSE))
  c(alfa = a$total$raw_alpha, setNames(a$item.stats$r.drop, paste0("r_drop_", 1:4)))
})
round(pil, 2)

# 2. CFA polskiej wersji: model dwuczynnikowy, estymator MLR (odporny na nienormalność)
model <- '
  wyczerpanie =~ W1 + W2 + W3 + W4
  dystans     =~ D1 + D2 + D3 + D4
'
cfa_pl <- cfa(model, data = pl_d, estimator = "MLR")
round(fitMeasures(cfa_pl, c("chisq.scaled", "df.scaled", "pvalue.scaled", "cfi.robust", "tli.robust",
                            "rmsea.robust", "rmsea.ci.lower.robust", "rmsea.ci.upper.robust", "srmr")), 3)
std <- standardizedSolution(cfa_pl)
ladunki <- std[std$op == "=~", c("lhs", "rhs", "est.std", "ci.lower", "ci.upper")]
ladunki[, 3:5] <- round(ladunki[, 3:5], 2)
ladunki
std[std$op == "~~" & std$lhs == "wyczerpanie" & std$rhs == "dystans", c("est.std", "ci.lower", "ci.upper")]

# Ta sama CFA w próbie oryginalnej (do porównania ładunków)
cfa_en <- cfa(model, data = en$pozycje, estimator = "MLR")
round(fitMeasures(cfa_en, c("cfi.robust", "tli.robust", "rmsea.robust", "srmr")), 3)
std_en <- standardizedSolution(cfa_en)
round(setNames(std_en$est.std[std_en$op == "=~"], pozycje), 2)
Wynik w R
angielska    polska
      450       410
            W    D
alfa     0.70 0.70
r_drop_1 0.53 0.51
r_drop_2 0.45 0.49
r_drop_3 0.56 0.49
r_drop_4 0.41 0.45
         chisq.scaled             df.scaled         pvalue.scaled            cfi.robust            tli.robust
               20.328                19.000                 0.375                 0.999                 0.998
         rmsea.robust rmsea.ci.lower.robust rmsea.ci.upper.robust                  srmr
                0.013                 0.000                 0.045                 0.025
          lhs rhs est.std ci.lower ci.upper
1 wyczerpanie  W1    0.70     0.64     0.76
2 wyczerpanie  W2    0.67     0.60     0.74
3 wyczerpanie  W3    0.68     0.61     0.75
4 wyczerpanie  W4    0.70     0.64     0.77
5     dystans  D1    0.76     0.71     0.82
6     dystans  D2    0.67     0.61     0.74
7     dystans  D3    0.77     0.71     0.83
8     dystans  D4    0.61     0.53     0.68
   est.std ci.lower ci.upper
19   0.519    0.423    0.614
  cfi.robust   tli.robust rmsea.robust         srmr
       0.992        0.988        0.032        0.024
  W1   W2   W3   W4   D1   D2   D3   D4
0.78 0.71 0.60 0.67 0.70 0.65 0.78 0.60
Krok 7: inwariancja między wersjami (skrót)
R
# Inwariancja pomiaru między wersją angielską a polską (wielogrupowa CFA, MLR)
# Wymaga obiektów z b52-2-dane-cfa.R (dane, model)
mi_fit <- function(...) cfa(model, data = dane, group = "wersja", estimator = "MLR", ...)
konf    <- mi_fit()
metr    <- mi_fit(group.equal = "loadings")
skal    <- mi_fit(group.equal = c("loadings", "intercepts"))
skal_cz <- mi_fit(group.equal = c("loadings", "intercepts"), group.partial = "D4 ~ 1")

miary <- c("chisq.scaled", "df.scaled", "cfi.robust", "rmsea.robust", "srmr")
tab <- t(sapply(list(konfiguracyjna = konf, metryczna = metr, skalarna = skal, skalarna_czesciowa = skal_cz),
                fitMeasures, fit.measures = miary))
tab <- cbind(tab, dCFI = c(NA, diff(tab[1:3, "cfi.robust"]), tab[4, "cfi.robust"] - tab[2, "cfi.robust"]),
             dRMSEA = c(NA, diff(tab[1:3, "rmsea.robust"]), tab[4, "rmsea.robust"] - tab[2, "rmsea.robust"]))
round(tab, 3)

# Skalowany test różnicy chi-kwadrat dla kolejnych kroków
lavTestLRT(konf, metr, skal)
lavTestLRT(metr, skal_cz)

# Który wyraz wolny blokuje inwariancję skalarną? Test punktowy (score test) dla ograniczeń równości
st <- lavTestScore(skal)$uni
par <- parTable(skal)
st$parametr <- par$lhs[match(st$lhs, par$plabel)]
st$op <- par$op[match(st$lhs, par$plabel)]
st <- st[st$op == "~1", c("parametr", "X2", "p.value")]
st$X2 <- round(st$X2, 2); st$p.value <- signif(st$p.value, 3)
st[order(-st$X2), ][1:3, ]

# Po uwolnieniu wyrazu wolnego D4: czy któreś ograniczenie nadal wyraźnie pogarsza dopasowanie?
st2 <- lavTestScore(skal_cz)$uni
par2 <- parTable(skal_cz)
st2$parametr <- par2$lhs[match(st2$lhs, par2$plabel)]
st2 <- st2[par2$op[match(st2$lhs, par2$plabel)] == "~1", c("parametr", "X2", "p.value")]
st2$X2 <- round(st2$X2, 2); st2$p.value <- round(st2$p.value, 3)
st2[order(-st2$X2), ][1:2, ]

# Wyrazy wolne D4 w obu wersjach (model częściowej inwariancji skalarnej)
pe <- parameterEstimates(skal_cz)
pe[pe$lhs == "D4" & pe$op == "~1", c("group", "est", "ci.lower", "ci.upper")]

# Różnica średnich czynników (wersja polska względem angielskiej, średnie w grupie 1 = 0)
pe[pe$op == "~1" & pe$lhs %in% c("wyczerpanie", "dystans") & pe$group == 2,
   c("lhs", "est", "se", "pvalue", "ci.lower", "ci.upper")]
lavInspect(skal_cz, "group.label")
Wynik w R
                   chisq.scaled df.scaled cfi.robust rmsea.robust  srmr   dCFI dRMSEA
konfiguracyjna           48.232        38      0.995        0.025 0.022     NA     NA
metryczna                58.236        44      0.993        0.027 0.033 -0.002  0.002
skalarna                150.559        50      0.952        0.067 0.052 -0.041  0.040
skalarna_czesciowa       63.386        49      0.993        0.026 0.034  0.000 -0.001

Scaled Chi-Squared Difference Test (method = “satorra.bentler.2001”)

lavaan->lavTestLRT():
   lavaan NOTE: The “Chisq” column contains standard test statistics, not the robust test that should be
   reported per model. A robust difference test is a function of two standard (not robust) statistics.

     Df   AIC   BIC   Chisq Chisq diff    RMSEA Df diff Pr(>Chisq)
konf 38 17327 17565  47.024
metr 44 17324 17534  56.568     10.061 0.038641       6     0.1221
skal 50 17402 17583 146.608     90.818 0.180537       6     <2e-16 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

Scaled Chi-Squared Difference Test (method = “satorra.bentler.2001”)

lavaan->lavTestLRT():
   lavaan NOTE: The “Chisq” column contains standard test statistics, not the robust test that should be
   reported per model. A robust difference test is a function of two standard (not robust) statistics.

        Df   AIC   BIC  Chisq Chisq diff    RMSEA Df diff Pr(>Chisq)
metr    44 17324 17534 56.568
skal_cz 49 17320 17505 61.781     5.1927 0.009486       5     0.3928
   parametr    X2 p.value
14       D4 81.70   0.000
13       D3 19.65   0.000
11       D1  3.40   0.065
   parametr   X2 p.value
13       D3 3.07   0.080
12       D2 1.83   0.177
   group   est ci.lower ci.upper
27     1 2.453    2.363    2.544
56     2 3.012    2.905    3.119
           lhs   est    se pvalue ci.lower ci.upper
57 wyczerpanie 0.092 0.056  0.103   -0.018    0.201
58     dystans 0.074 0.058  0.200   -0.039    0.188
[1] "angielska" "polska"
Kroki 8–10: rzetelność, trafność i steny
R
# Rzetelność, trafność zbieżna i różnicowa oraz normy stenowe dla polskiej wersji
# Wymaga obiektów z b52-2-dane-cfa.R (pl_d, cfa_pl)

# 1. Rzetelność: omega (z CFA) i alfa Cronbacha
omega <- unlist(semTools::compRelSEM(cfa_pl))
alfa  <- sapply(list(wyczerpanie = paste0("W", 1:4), dystans = paste0("D", 1:4)),
                function(s) psych::alpha(pl_d[, s], warnings = FALSE)$total$raw_alpha)
round(rbind(omega = omega, alfa = alfa), 2)

# 2. Trafność: korelacje wyników skal (suma 4–20) z miarami zewnętrznymi i 95% CI
pl_d$wyczerpanie <- rowSums(pl_d[, paste0("W", 1:4)])
pl_d$dystans     <- rowSums(pl_d[, paste0("D", 1:4)])
kor <- expand.grid(skala = c("wyczerpanie", "dystans"), kryterium = c("stres", "satysfakcja", "ekstrawersja"),
                   stringsAsFactors = FALSE)
kor <- cbind(kor, t(mapply(function(s, k) {
  ct <- cor.test(pl_d[[s]], pl_d[[k]])
  round(c(r = unname(ct$estimate), dolna = ct$conf.int[1], gorna = ct$conf.int[2], p = ct$p.value), 3)
}, kor$skala, kor$kryterium)))
kor

# 3. Normy stenowe (próba polska, n = 410): przeliczenie wyniku surowego na sten
#    sten = 2z + 5.5, zaokrąglony i ograniczony do 1–10
opis <- sapply(pl_d[, c("wyczerpanie", "dystans")], function(x) c(M = mean(x), SD = sd(x)))
round(opis, 2)
na_sten <- function(x, M, SD) pmin(pmax(round(2 * (x - M) / SD + 5.5), 1), 10)
normy <- sapply(c("wyczerpanie", "dystans"), function(s) {
  surowe <- 4:20
  steny  <- na_sten(surowe, opis["M", s], opis["SD", s])
  tapply(surowe, steny, function(v) if (length(v) == 1) as.character(v) else paste0(min(v), "–", max(v)))[as.character(1:10)]
})
rownames(normy) <- paste("sten", 1:10)
normy
Wynik w R
      wyczerpanie dystans
omega        0.78    0.80
alfa         0.78    0.79
                    skala    kryterium      r  dolna  gorna     p
wyczerpanie   wyczerpanie        stres  0.389  0.303  0.468 0.000
dystans           dystans        stres  0.274  0.182  0.362 0.000
wyczerpanie.1 wyczerpanie  satysfakcja -0.135 -0.229 -0.039 0.006
dystans.1         dystans  satysfakcja -0.308 -0.393 -0.218 0.000
wyczerpanie.2 wyczerpanie ekstrawersja  0.018 -0.079  0.115 0.716
dystans.2         dystans ekstrawersja  0.033 -0.064  0.129 0.509
   wyczerpanie dystans
M        12.26   11.03
SD        3.03    3.15
        wyczerpanie dystans
sten 1  "4–6"       "4"
sten 2  "7"         "5–6"
sten 3  "8–9"       "7"
sten 4  "10"        "8–9"
sten 5  "11–12"     "10–11"
sten 6  "13"        "12"
sten 7  "14–15"     "13–14"
sten 8  "16"        "15"
sten 9  "17–18"     "16–17"
sten 10 "19–20"     "18–20"
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2 (zapis SVG: svglite). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7-2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- semTools (wersja 0.5-8): Jorgensen, T. D., Pornprasertmanit, S., Schoemann, A. M., & Rosseel, Y. (2026). semTools: Useful tools for structural equation modeling (Version 0.5-8) [R package]. https://doi.org/10.32614/CRAN.package.semTools
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research [R package]. Northwestern University. https://CRAN.R-project.org/package=psych
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy w adaptacji kwestionariusza
- Jeden tłumacz i brak dokumentacji. Nie da się wtedy pokazać, skąd wzięło się brzmienie pozycji. ITC (2018) uznaje pracę jednego tłumacza za praktykę, której już się nie akceptuje.
- Tłumaczenie zwrotne jako jedyna kontrola. Zgodność z oryginałem po przekładzie zwrotnym nie mówi, czy polska wersja jest naturalna i zrozumiała. Potrzebna jest komisja i wywiady poznawcze.
- Pominięcie zgody autora. Nawet jeśli pozycje są dostępne w artykule, prawa do narzędzia mogą być zastrzeżone.
- EFA zamiast CFA bez uzasadnienia. W adaptacji testujesz strukturę oryginału. Eksploracyjna analiza ma sens, gdy CFA zawodzi i chcesz zrozumieć dlaczego – zob. analiza czynnikowa EFA i CFA.
- Porównywanie średnich z oryginałem bez inwariancji. Różnica sum surowych między krajami może wynikać z jednej źle przetłumaczonej pozycji, tak jak D4 w przykładzie.
- Przenoszenie norm oryginału. Normy amerykańskie czy brytyjskie nie mówią nic o tym, co jest „wysokim wynikiem” w Polsce.
- Usuwanie pozycji, aż model „wyjdzie”. Każda zmiana struktury oddala adaptację od oryginału i musi być uzgodniona z autorem oraz opisana.
- Za mała próba walidacyjna. Przy kilkudziesięciu osobach CFA i inwariancja dają niestabilne wyniki. Zaplanuj liczebność przed badaniem, zob. dobór liczebności próby.
Najczęstsze pytania
Jak przeprowadzić adaptację kulturową kwestionariusza?
Uzyskaj zgodę autora, przygotuj co najmniej dwa niezależne przekłady i uzgodnij je w komisji (z tłumaczeniem zwrotnym albo bez niego), zbierz oceny ekspertów, sprawdź zrozumiałość w wywiadach poznawczych i w pilotażu. Potem w badaniu walidacyjnym wykonaj CFA, oceń rzetelność i trafność, a przy porównaniach z oryginałem – inwariancję pomiaru. Kolejność etapów wynika z wytycznych ITC (International Test Commission, 2018); pojęcie równoważności wersji wyjaśnia hasło właściwa adaptacja.
Ilu tłumaczy potrzeba do adaptacji kwestionariusza?
Co najmniej dwóch, którzy przygotują niezależne przekłady, oraz trzeciej osoby lub panelu, który je uzgodni. Wytyczne ITC (2018) zalecają tłumaczy znających język i kulturę docelową, treść testu i zasady konstrukcji pozycji, a pracę jednego tłumacza uznają za niewystarczającą. Do tłumaczenia zwrotnego potrzebna jest osoba, która nie zna oryginału.
Jak policzyć wskaźnik CVI z ocen ekspertów?
Każdy ekspert ocenia trafność pozycji na skali 1–4. I-CVI to odsetek ekspertów, którzy dali 3 lub 4, np. 5 z 6 to .83. Dla całej skali podaj średnią I-CVI (S-CVI/Ave) i odsetek pozycji ocenionych zgodnie przez wszystkich (S-CVI/UA). Polit i in. (2007) proponują, by przy trzech lub więcej ekspertach uznawać pozycje z I-CVI ≥ .78 za trafne.
Ile osób potrzeba do walidacji polskiej wersji kwestionariusza?
Na pilotaż wystarczy kilkadziesiąt osób, ale badanie struktury czynnikowej wymaga zwykle co najmniej 300 osób, a analizy zróżnicowanego funkcjonowania pozycji – co najmniej 200 osób na każdą wersję językową (International Test Commission, 2018). Dokładną liczebność zaplanuj z uwzględnieniem złożoności modelu i liczby grup.
Czy można porównywać wyniki polskiej i oryginalnej wersji testu?
Tylko po wykazaniu inwariancji pomiaru. Do porównania średnich potrzebna jest co najmniej częściowa inwariancja skalarna, czyli równe ładunki i wyrazy wolne większości pozycji. Bez tego różnica między krajami może wynikać z jednej źle przetłumaczonej pozycji. Procedurę opisuje wpis inwariancja pomiaru krok po kroku.
Czy na przekład skali potrzebna jest zgoda właściciela praw?
Tak, jeśli narzędzie jest chronione. Wytyczne ITC zaczynają się od zalecenia, by przed adaptacją uzyskać zgodę posiadacza praw i spisać, jakie zmiany są dopuszczalne i do kogo należą prawa do nowej wersji. Testy z domeny publicznej można tłumaczyć bez zgody, ale z podaniem źródła. W razie wątpliwości zapytaj autora lub wydawcę.
Powiązane hasła
Przeczytaj też
Inwariancja pomiaru krok po kroku
Wielogrupowa CFA w lavaan: model konfiguracyjny, metryczny, skalarny i ścisły, kryteria ΔCFI i ΔRMSEA, testy punktowe, częściowa inwariancja i opis APA.
Czytaj →PoradnikJak zbudować i zwalidować skalę psychometryczną?
Od definicji konstruktu i tworzenia pozycji po pilotaż, EFA, CFA, rzetelność, trafność teoretyczną, różnicową i niezmienniczość.
Czytaj →PoradnikGdzie znaleźć kwestionariusze psychologiczne
Polskie adaptacje, wydawca testów, bazy i IPIP; jak ocenić skalę, kiedy potrzebna jest zgoda autora, wzór e-maila i zasady tłumaczenia narzędzi.
Czytaj →Adaptujesz skalę i potrzebujesz analiz walidacyjnych?
Zaplanujemy badanie walidacyjne, policzymy CFA, inwariancję między wersjami, rzetelność i trafność oraz wyjaśnimy wyniki tak, by opis adaptacji wytrzymał recenzję.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Beaton, D. E., Bombardier, C., Guillemin, F., & Ferraz, M. B. (2000). Guidelines for the process of cross-cultural adaptation of self-report measures. Spine, 25(24), 3186–3191. https://doi.org/10.1097/00007632-200012150-00014
- Beatty, P. C., & Willis, G. B. (2007). Research synthesis: The practice of cognitive interviewing. Public Opinion Quarterly, 71(2), 287–311. https://doi.org/10.1093/poq/nfm006 ● Otwarty dostęp
- Brislin, R. W. (1970). Back-translation for cross-cultural research. Journal of Cross-Cultural Psychology, 1(3), 185–216. https://doi.org/10.1177/135910457000100301
- Chen, F. F. (2007). Sensitivity of goodness of fit indexes to lack of measurement invariance. Structural Equation Modeling: A Multidisciplinary Journal, 14(3), 464–504. https://doi.org/10.1080/10705510701301834
- Epstein, J., Santo, R. M., & Guillemin, F. (2015). A review of guidelines for cross-cultural adaptation of questionnaires could not bring out a consensus. Journal of Clinical Epidemiology, 68(4), 435–441. https://doi.org/10.1016/j.jclinepi.2014.11.021
- Hu, L., & Bentler, P. M. (1999). Cutoff criteria for fit indexes in covariance structure analysis: Conventional criteria versus new alternatives. Structural Equation Modeling: A Multidisciplinary Journal, 6(1), 1–55. https://doi.org/10.1080/10705519909540118
- International Test Commission. (2014). ITC statement on the use of tests and other assessment instruments for research purposes (Version 1.2). https://www.intestcom.org/files/statement_using_tests_for_research.pdf ● Otwarty dostęp
- International Test Commission. (2018). ITC guidelines for translating and adapting tests (second edition). International Journal of Testing, 18(2), 101–134. https://doi.org/10.1080/15305058.2017.1398166 ● Otwarty dostęp: pełny tekst
- Lenzner, T., Hadler, P., & Neuert, C. (2023). An experimental test of the effectiveness of cognitive interviewing in pretesting questionnaires. Quality & Quantity, 57(4), 3199–3217. https://doi.org/10.1007/s11135-022-01489-4 ● Otwarty dostęp
- Polit, D. F., & Beck, C. T. (2006). The content validity index: Are you sure you know what’s being reported? Critique and recommendations. Research in Nursing & Health, 29(5), 489–497. https://doi.org/10.1002/nur.20147
- Polit, D. F., Beck, C. T., & Owen, S. V. (2007). Is the CVI an acceptable indicator of content validity? Appraisal and recommendations. Research in Nursing & Health, 30(4), 459–467. https://doi.org/10.1002/nur.20199
- Putnick, D. L., & Bornstein, M. H. (2016). Measurement invariance conventions and reporting: The state of the art and future directions for psychological research. Developmental Review, 41, 71–90. https://doi.org/10.1016/j.dr.2016.06.004 ● Otwarty dostęp: pełny tekst
- Wild, D., Grove, A., Martin, M., Eremenco, S., McElroy, S., Verjee-Lorenz, A., & Erikson, P. (2005). Principles of good practice for the translation and cultural adaptation process for patient-reported outcomes (PRO) measures: Report of the ISPOR Task Force for Translation and Cultural Adaptation. Value in Health, 8(2), 94–104. https://doi.org/10.1111/j.1524-4733.2005.04054.x ● Otwarty dostęp
Cytowania BibTeX
@article{beaton2000guidelines, author={Beaton, Dorcas E. and Bombardier, Claire and Guillemin, Francis and Ferraz, Marcos Bosi}, title={{Guidelines for the process of cross-cultural adaptation of self-report measures}}, journal={Spine}, year={2000}, volume={25}, number={24}, pages={3186--3191}, doi={10.1097/00007632-200012150-00014}}@article{beatty2007research, author={Beatty, Paul C. and Willis, Gordon B.}, title={{Research synthesis: The practice of cognitive interviewing}}, journal={Public Opinion Quarterly}, year={2007}, volume={71}, number={2}, pages={287--311}, doi={10.1093/poq/nfm006}}@article{brislin1970back, author={Brislin, Richard W.}, title={{Back-translation for cross-cultural research}}, journal={Journal of Cross-Cultural Psychology}, year={1970}, volume={1}, number={3}, pages={185--216}, doi={10.1177/135910457000100301}}@article{chen2007sensitivity, author={Chen, Fang Fang}, title={{Sensitivity of goodness of fit indexes to lack of measurement invariance}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2007}, volume={14}, number={3}, pages={464--504}, doi={10.1080/10705510701301834}}@article{epstein2015review, author={Epstein, Jonathan and Santo, Ruth Miyuki and Guillemin, Francis}, title={{A review of guidelines for cross-cultural adaptation of questionnaires could not bring out a consensus}}, journal={Journal of Clinical Epidemiology}, year={2015}, volume={68}, number={4}, pages={435--441}, doi={10.1016/j.jclinepi.2014.11.021}}@article{hu1999cutoff, author={Hu, Li-tze and Bentler, Peter M.}, title={{Cutoff criteria for fit indexes in covariance structure analysis: Conventional criteria versus new alternatives}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={1999}, volume={6}, number={1}, pages={1--55}, doi={10.1080/10705519909540118}}@techreport{itc2014statement, author={{International Test Commission}}, title={{ITC statement on the use of tests and other assessment instruments for research purposes}}, year={2014}, institution={International Test Commission}, url={https://www.intestcom.org/files/statement_using_tests_for_research.pdf}}@article{itc2018guidelines, author={{International Test Commission}}, title={{ITC guidelines for translating and adapting tests (second edition)}}, journal={International Journal of Testing}, year={2018}, volume={18}, number={2}, pages={101--134}, doi={10.1080/15305058.2017.1398166}}@article{lenzner2023experimental, author={Lenzner, Timo and Hadler, Patricia and Neuert, Cornelia}, title={{An experimental test of the effectiveness of cognitive interviewing in pretesting questionnaires}}, journal={Quality \& Quantity}, year={2023}, volume={57}, number={4}, pages={3199--3217}, doi={10.1007/s11135-022-01489-4}}@article{polit2006content, author={Polit, Denise F. and Beck, Cheryl Tatano}, title={{The content validity index: Are you sure you know what’s being reported? Critique and recommendations}}, journal={Research in Nursing \& Health}, year={2006}, volume={29}, number={5}, pages={489--497}, doi={10.1002/nur.20147}}@article{polit2007cvi, author={Polit, Denise F. and Beck, Cheryl Tatano and Owen, Steven V.}, title={{Is the CVI an acceptable indicator of content validity? Appraisal and recommendations}}, journal={Research in Nursing \& Health}, year={2007}, volume={30}, number={4}, pages={459--467}, doi={10.1002/nur.20199}}@article{putnick2016measurement, author={Putnick, Diane L. and Bornstein, Marc H.}, title={{Measurement invariance conventions and reporting: The state of the art and future directions for psychological research}}, journal={Developmental Review}, year={2016}, volume={41}, pages={71--90}, doi={10.1016/j.dr.2016.06.004}}@article{wild2005principles, author={Wild, Diane and Grove, Alyson and Martin, Mona and Eremenco, Sonya and McElroy, Sandra and Verjee-Lorenz, Aneesa and Erikson, Pennifer}, title={{Principles of good practice for the translation and cultural adaptation process for patient-reported outcomes (PRO) measures: Report of the ISPOR Task Force for Translation and Cultural Adaptation}}, journal={Value in Health}, year={2005}, volume={8}, number={2}, pages={94--104}, doi={10.1111/j.1524-4733.2005.04054.x}}