Gdy celem pracy jest narzędzie, a nie zjawisko
W typowej pracy skala jest środkiem: mierzysz nią stres i pytasz, z czym się wiąże. W badaniu walidacyjnym skala jest przedmiotem badania. Pytasz, czy wynik tego narzędzia można rozumieć tak, jak chcą jego autorzy – w tej populacji, w tym języku, w tym zastosowaniu. Zmienia to prawie każde zdanie rozdziału metodologicznego, a promotorzy i recenzenci szukają w nim innych rzeczy niż zwykle.
Ten wpis dotyczy tylko opisu takiego badania w pracy. Kolejne kroki budowy skali omawia przewodnik o budowie i walidacji skali, przekład i procedurę adaptacji – wpis adaptacja kulturowa kwestionariusza, a technikę EFA i CFA – analiza czynnikowa EFA i CFA. Tu dostajesz układ prób, plan analiz, gotowy podrozdział, tabele i granice wniosków. Ogólny układ rozdziału znajdziesz we wpisie rozdział metodologiczny.
Przykład przewodni (w całości fikcyjny: skala, jej autorzy, cytowania i dane). Studentka przygotowuje polską wersję 12-pozycyjnej skali przeciążenia cyfrowego studentów. Skala ma trzy podskale po cztery pozycje: przeciążenie informacją (PI), presję dostępności (PD) i trudność odłączenia (TO). Odpowiedzi 1–5. Wszystkie liczby poniżej pochodzą z kodu na końcu wpisu.
| Element | Zwykła praca ankietowa | Praca walidacyjna |
|---|---|---|
| Cel | Odpowiedź na pytanie o zjawisko | Ocena właściwości narzędzia w określonej grupie |
| Hipotezy | O związkach między zmiennymi | O strukturze narzędzia i o jego związkach z miarami innych cech: z kierunkiem i oczekiwaną wielkością |
| Rzetelność | Jedno zdanie w opisie narzędzia | Osobna część wyników, często z retestem i błędem pomiaru |
| Korelacje | Główny wynik | Jeden z rodzajów dowodów, z wcześniej zapisanym zakresem |
| Wniosek | O badanych | O tym, do czego narzędzie wolno, a do czego jeszcze nie wolno używać |
Zacznij od statusu narzędzia
Pierwszy akapit metody ma odpowiadać na pytanie, czy wolno Ci było pracować nad tym narzędziem. Wytyczne ITC stawiają uzyskanie zgody właściciela praw przed adaptacją i wymagają udokumentowania zmian (International Test Commission, 2018). W pracy podaj, kto udzielił zgody, kiedy i na co: na przekład, na publikację pozycji, na zmiany. Gdy treść jest chroniona, nie umieszczaj pełnych pozycji w tekście ani w załącznikach bez pozwolenia – w wynikach wystarczą numery. Praktykę licencyjną opisuje wpis gdzie znaleźć kwestionariusze, a o załącznikach przeczytasz w tekście załączniki do pracy dyplomowej.
Przy adaptacji czytelnik musi wiedzieć, jaką strukturę przewiduje oryginał i kto wykonał przekład. Przy nowej skali to miejsce zajmują definicja konstruktu i pochodzenie pozycji. Co jeszcze odróżnia oba warianty, pokazuje tabela w sekcji o różnicach między dziedzinami.
Etapy i próby: kto bierze udział w czym
Najwięcej chaosu powstaje wtedy, gdy czytelnik nie wie, z której próby pochodzi która liczba. Rozrysuj to i wstaw rysunek do pracy. Boateng i in. (2018) ułożyli proces w trzy fazy: powstanie pozycji, konstrukcję skali i jej ocenę. Ten sam porządek łatwo przełożyć na podrozdziały.
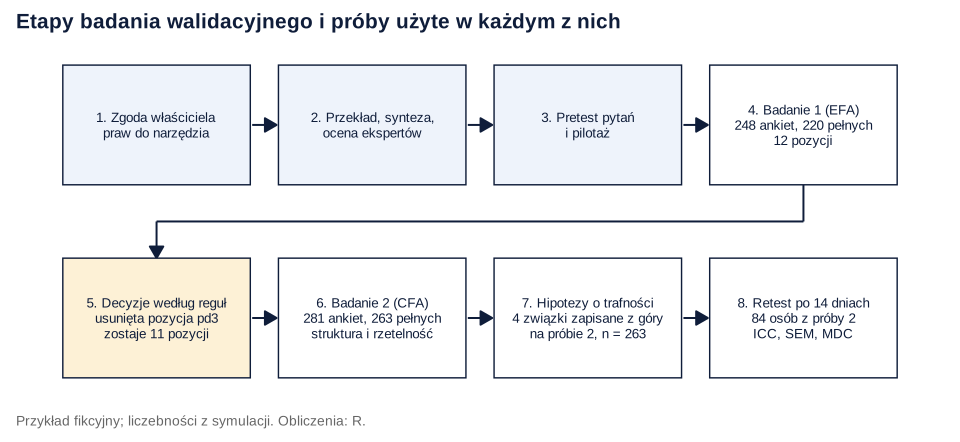
| Etap | Kto bierze udział | Co trafia do pracy |
|---|---|---|
| Zgoda, przekład, ocena ekspertów | Tłumacze, eksperci | Metoda: kto, ile osób, kryteria; wyniki: tabela ocen (np. CVI) |
| Pretest i pilotaż | Mała grupa z populacji docelowej | Metoda: liczba osób, co zmieniono w pozycjach |
| Badanie 1 – eksploracyjne | Niezależna próba, sama skala z metryczką | Wyniki: liczba czynników, ładunki, decyzje o pozycjach |
| Badanie 2 – potwierdzające | Nowa próba, wersja po decyzjach, skale do trafności | Wyniki: dopasowanie modelu, rzetelność, hipotezy |
| Retest | Podgrupa badania 2 z kodem łączącym pomiary | Wyniki: ICC, różnica średnich, błąd pomiaru |
Dwa zbiory czy jeden? Model dopasowany i poprawiony na tych samych danych ma skłonność do „potwierdzania się”, dlatego porównanie prób jest sensowne tylko wtedy, gdy próba potwierdzająca nie wzięła udziału w decyzjach. W przykładzie to dwa osobne zbierania danych. Jeśli czas na to nie pozwala, podziel losowo jedną dużą próbę i napisz to wprost: oba zbiory pochodzą wtedy z tego samego naboru i tych samych warunków. Przy adaptacji narzędzia o dobrze udokumentowanej strukturze bywa uzasadnione odwrotne podejście: CFA od razu, a EFA tylko jako plan awaryjny, gdy model nie pasuje. Wybór zapisz przed zbieraniem danych.
Liczebność. Nie cytuj zasady „10 osób na pozycję”. MacCallum i in. (1999) pokazują, że potrzebna liczebność zależy od wspólności zmiennych i liczby wskaźników na czynnik, a ich symulacja podważa popularne reguły kciuka. Podaj założenia, a wynik oprzyj o symulację dla Twojego modelu. Dla retestu policz szerokość przedziału dla ICC: przy 84 osobach przedział dla podskali PI wyniósł [.68, .85], czyli nadal mieści oceny od umiarkowanych do dobrych.
Plan: trzy grupy dowodów i kolejność analiz
Wyniki pracy układaj w trzy grupy: struktura, rzetelność, trafność. Kolejność nie jest przypadkowa. Dopóki nie wiesz, ile wymiarów ma skala, nie wiesz, co sumować. Dopóki nie wiesz, co sumować, alfa nie ma adresata, a korelacja wyniku podskali z inną miarą nie ma znaczenia. Dlatego zaczynasz od struktury.
| Krok | Pytanie | Analiza | Reguła zapisana z góry | Próba |
|---|---|---|---|---|
| 1 | Ile wymiarów? | Analiza równoległa, EFA z rotacją ukośną | Liczba czynników z analizy równoległej | Badanie 1 |
| 2 | Które pozycje zostają? | Ładunki z EFA | Ładunek główny ≥ .40, przewaga nad kolejnym ≥ .20, właściwy czynnik | Badanie 1 |
| 3 | Czy struktura się powtarza? | CFA, MLR, model jednoczynnikowy jako alternatywa | Punkty orientacyjne CFI i TLI około .95, RMSEA około .06, SRMR około .08 (Hu i Bentler, 1999) | Badanie 2 |
| 4 | Czy wynik jest spójny? | α i ω z przedziałem | Oba współczynniki dla każdej podskali, bez jednego progu | Badanie 2 |
| 5 | Czy wynik jest stabilny? | Test–retest, ICC (absolutna zgodność, jeden pomiar), SEM, MDC | Odstęp 14 dni, interpretacja przez przedział | Podgrupa badania 2 |
| 6 | Czy wynik znaczy to, co ma znaczyć? | Korelacje z miarami innych cech | Hipotezy H1–H4 z kierunkiem i zakresem | Badanie 2 |
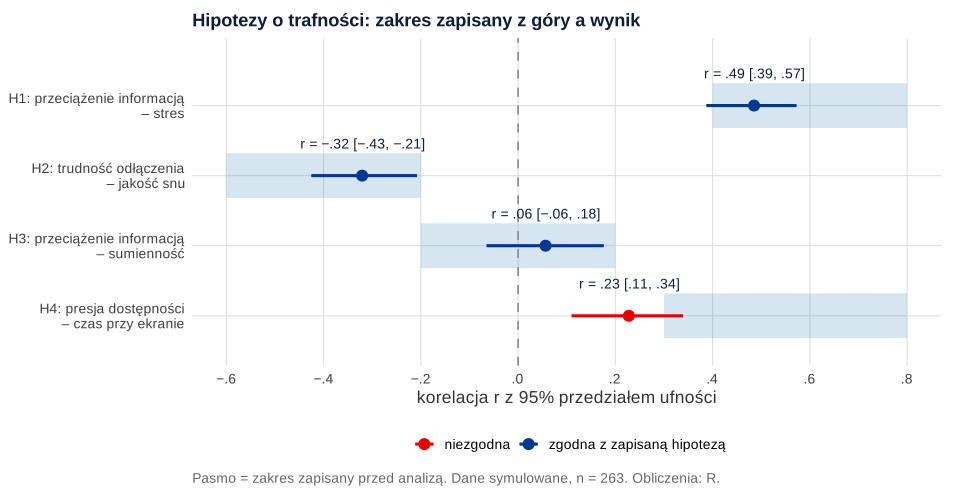
Hipotezy o trafności zapisz przed analizą. Wytyczne COSMIN zalecają przy testowaniu hipotez formułowanie ich z góry, z kierunkiem i wielkością związku (Prinsen i in., 2018). W przykładzie są cztery: H1 – przeciążenie informacją a stres, r ≥ .40; H2 – trudność odłączenia a jakość snu, r ≤ −.20; H3 – przeciążenie informacją a sumienność, |r| < .20 (dowód różnicowy); H4 – presja dostępności a dzienny czas przy ekranie, r ≥ .30. Nie ma tu złotego standardu, więc nie nazywaj tego trafnością kryterialną.
COSMIN powstał dla narzędzi samoopisowych w badaniach nad zdrowiem. Daje wspólną terminologię właściwości pomiarowych (Mokkink i in., 2010) oraz listę raportowania: 71 elementów, w tym elementy wspólne i przypisane poszczególnym właściwościom (Gagnier i in., 2021). W pracy z nauk o zdrowiu warto podać, że opis jest z nią zgodny. W psychologii i zarządzaniu potraktuj ją jako listę kontrolną, a jako ramę możesz przyjąć ujęcie z mapy dowodów trafności.
Gotowy podrozdział „Metoda” z komentarzem
To fikcyjny wzór. Nawiasy kwadratowe uzupełnij własnymi danymi. Pełny opis narzędzia w zwykłej pracy pokazuje wpis opis narzędzia badawczego – wzór; tu chodzi o sytuację, gdy narzędzie jest celem.
Cel i schemat
Komentarz. Pisz „ocena właściwości”, a nie „wykazanie trafności”. Sam cel nie powinien przesądzać o wyniku.
Narzędzie i przekład
Komentarz. Wskaż, co zmieniono po ocenie ekspertów i w pilotażu. Taki zapis jest wart więcej niż ogólne zdanie o „starannym przekładzie”.
Uczestnicy
Komentarz. Liczby muszą się zgadzać z rysunkiem i z tabelami. Sposób łączenia pomiarów opisuje wpis o kodzie identyfikacyjnym.
Procedura i pomiary dodatkowe
Komentarz. Odstęp uzasadnij rozumowaniem o cesze, a nie zwyczajem. Dla stanu zmieniającego się z dnia na dzień retest po dwóch tygodniach mierzy raczej zmianę stanu niż rzetelność. Więcej o tym w haśle rzetelność test–retest.
Plan analizy
Komentarz. Koo i Li (2016) wymagają podania modelu, typu i definicji ICC, dlatego sam skrót nie wystarczy. Pozycje na skali pięciostopniowej możesz też analizować estymatorem dla danych porządkowych (WLSMV). Jeśli planujesz porównania grup, dopisz inwariancję pomiaru. Plan najlepiej wcześniej zapisać w formie dokumentu.
Tabele wyników i gotowy akapit
W pracy walidacyjnej tabele są głównym wynikiem. Wystarczą cztery, po jednej na krok planu. Wzorce formatowania masz we wpisie tabele APA.
Struktura. Analiza równoległa wskazała trzy czynniki: wartości własne 4.66, 1.87 i 1.42 przekraczały 95. centyl z danych losowych (1.50, 1.36, 1.27), a czwarta (0.62) już nie. Pozycja pd3 złamała regułę: najsilniej ładowała nie swój czynnik.
| Pozycja | PI | PD | TO | h² | Decyzja |
|---|---|---|---|---|---|
| pi1 | .89 | .06 | −.10 | .76 | zostaje |
| pi2 | .79 | −.02 | −.02 | .60 | zostaje |
| pi3 | .69 | .06 | .02 | .52 | zostaje |
| pi4 | .60 | −.12 | .16 | .41 | zostaje |
| pd1 | .03 | .74 | .04 | .60 | zostaje |
| pd2 | .04 | .80 | −.10 | .59 | zostaje |
| pd3 | .01 | .32 | .52 | .55 | usunięta: główny ładunek na innym czynniku |
| pd4 | −.03 | .65 | .04 | .44 | zostaje |
| to1 | .06 | .04 | .72 | .59 | zostaje |
| to2 | −.07 | −.11 | .84 | .58 | zostaje |
| to3 | −.03 | .06 | .73 | .55 | zostaje |
| to4 | −.05 | −.08 | .73 | .45 | zostaje |
Korelacje czynników wyniosły .37 (PI–PD), .43 (PI–TO) i .53 (PD–TO). Usunięcie pozycji z cudzego narzędzia zmienia to narzędzie: zgłoś to autorom i napisz w tytule tabeli, że dotyczy wersji 11-pozycyjnej. Podskala PD ma teraz tylko trzy pozycje, co odnotuj w ograniczeniach.
| Model | χ²(df), p | CFI | TLI | RMSEA [90% CI] | SRMR |
|---|---|---|---|---|---|
| Trzy czynniki | 61.74 (41), .020 | .981 | .975 | .044 [.018, .066] | .040 |
| Jeden czynnik | 515.27 (44), < .001 | .634 | .542 | .189 [.174, .204] | .123 |
Zauważ, że górna granica przedziału RMSEA modelu trójczynnikowego (.066) przekracza punkt orientacyjny. Napisz to, zamiast podawać samą wartość .044. Ładunki standaryzowane wyniosły od .64 do .84, a korelacje czynników .52, .45 i .48.
| Podskala | M (SD) | α | ω [95% CI] | Różnica T2 − T1 [95% CI] | ICC [95% CI] | SEM | MDC95 |
|---|---|---|---|---|---|---|---|
| PI (4 pozycje) | 3.02 (0.84) | .83 | .83 [.79, .86] | −0.01 [−0.13, 0.12] | .78 [.68, .85] | 0.41 | 1.13 |
| PD (3 pozycje) | 3.08 (0.86) | .78 | .78 [.74, .82] | 0.09 [−0.05, 0.22] | .73 [.62, .82] | 0.45 | 1.26 |
| TO (4 pozycje) | 2.98 (0.85) | .84 | .84 [.81, .87] | 0.06 [−0.04, 0.17] | .85 [.77, .90] | 0.35 | 0.97 |
Koo i Li (2016) proponują czytać ICC przez przedział: poniżej .50 słaba, .50–.75 umiarkowana, .75–.90 dobra, powyżej .90 doskonała rzetelność. Przedziały PI i PD obejmują więc oceny od umiarkowanej do dobrej, a przedział TO mieści się w ocenie dobrej. Ostatnia kolumna jest często najbardziej pouczająca. Przy MDC95 równym 1.13 na skali 1–5 zmiana wyniku jednej osoby poniżej tej wartości nie odróżnia się od błędu pomiaru. Skala nadaje się więc do porównań grup, a znacznie słabiej do śledzenia pojedynczych osób (zob. RCI, MDC i MCID).
| Hipoteza | Zakres zapisany z góry | r [95% CI] | Werdykt |
|---|---|---|---|
| H1: PI – stres | r ≥ .40 | .49 [.39, .57] | zgodna |
| H2: TO – jakość snu | r ≤ −.20 | −.32 [−.43, −.21] | zgodna |
| H3: PI – sumienność | |r| < .20 | .06 [−.06, .18] | zgodna |
| H4: PD – czas przy ekranie | r ≥ .30 | .23 [.11, .34] | niezgodna |
Gotowy akapit:
Jak bywa napisane i jak to poprawić
| Jak bywa napisane | Co jest nie tak | Poprawione |
|---|---|---|
| „Skala została zwalidowana i jest trafna” | Trafność to własność interpretacji wyniku w danym użyciu, nie stała cecha narzędzia | „Zebrane dowody wspierają użycie podskal w badaniach grup studentów” |
| „Rzetelność potwierdzono: α = .83” | Sama alfa bywa jedynym raportowanym wskaźnikiem (Flake i in., 2017), a o stabilności nic nie mówi | „Spójność wewnętrzna: α = .83, ω = .83 [.79, .86]; stabilność po 14 dniach: ICC = .78 [.68, .85]” |
| „Struktura potwierdziła się po dodaniu trzech korelacji reszt” | Modyfikacje dobrane po danych przedstawione jako test | „Model pierwotny miał dopasowanie [wartości]; korelacje reszt dodano eksploracyjnie, wymagają replikacji” |
| „Pozycję usunięto, bo poprawiała wynik alfy” | Reguła z danych, przy wyniku oglądanym po fakcie | „Pozycję usunięto według zapisanej reguły [treść], a decyzję zgłoszono autorowi narzędzia” |
| „Hipoteza H4 nie jest istotna” | Hipoteza to zakres, a korelacja .23 jest istotna: po prostu mniejsza od założonej | „H4 nie znalazła potwierdzenia: r = .23 [.11, .34] poniżej założonego .30” |
Co wolno napisać we wnioskach
W wytycznych COSMIN dla przeglądów wynik testowania hipotez uznaje się za wystarczający, gdy co najmniej 75% wyników jest zgodnych z hipotezami (Prinsen i in., 2018). Nasze trzy z czterech osiągają tę granicę, ale nie zamieniaj tej reguły w przepustkę. Została przygotowana do oceny wielu badań naraz, a jedna praca dyplomowa to dopiero pierwszy dowód.
| Można napisać | Nie można napisać, bo… |
|---|---|
| Polska wersja miała strukturę trzyczynnikową w dwóch niezależnych próbach studentów | „Skala ma strukturę trzyczynnikową” – populacja i tryb były ograniczone |
| Wyniki podskal były umiarkowanie lub dobrze stabilne po 14 dniach | „Skala jest stabilna” – bez odstępów dłuższych i innych grup to nieznane |
| Dowody wspierają użycie podskal do porównań grup studentów | „Skala nadaje się do diagnozy” – progi i normy nie były badane; retest nie mierzył zmiany |
| Związek presji dostępności z czasem przy ekranie był słabszy od oczekiwanego | „H4 obalona, skala jest wadliwa” – jedno badanie i miara samoopisowa czasu |
| Wersja różni się od oryginału o jedną pozycję i wyników nie należy porównywać wprost | „Wyniki są porównywalne z oryginałem” – bez testu inwariancji nie wiadomo |
Pełny akapit:
Przypomnienie: skala, jej autorzy, cytowania i dane z tego przykładu są fikcyjne. Więcej wzorów masz we wpisach ograniczenia badania i hipoteza się nie potwierdziła.
Na co zwrócić uwagę w poszczególnych dziedzinach
To obserwacje ogólne o częstych konwencjach, a nie reguły. Wymagania uczelni i promotora mają pierwszeństwo.
| Dziedzina | Często oczekuje się | Co opisać dokładniej |
|---|---|---|
| Psychologia | Ram teoretycznych konstruktu i dowodów zbieżnych i różnicowych | Definicję konstruktu, hipotezy z zakresem, rozróżnienie stanu i cechy przy retescie |
| Nauki o zdrowiu | Terminologii COSMIN i narzędzi samoopisowych pacjentów | Zgodność z listą raportowania, licencję narzędzia, grupę kliniczną i jej ograniczenia |
| Fizjoterapia | Rzetelności pomiaru i błędu pomiaru przy ocenie zmian | SEM, MDC, protokół badania, związek z MCID bez jego utożsamiania |
| Zarządzanie | Adaptacji skal anglojęzycznych, CFA i inwariancji | Wspólną metodę, zagnieżdżenie w zespołach, inne kryterium niż samoopis, gdy to możliwe |
| Nowa skala (każda dziedzina) | Pochodzenia pozycji i dowodów treściowych | Definicję i źródła pozycji, ocenę ekspertów, redukcję puli |
Najczęstsze błędy
- Brak zgody właściciela praw albo publikacja wszystkich pozycji mimo chronionej treści.
- EFA i CFA na tych samych osobach i nazwanie tego potwierdzeniem.
- Usuwanie pozycji „na oko”, po obejrzeniu alfy i wskaźników dopasowania.
- Alfa jako jedyny dowód „trafności i rzetelności” (Flake i in., 2017).
- Korelacje podane bez zakresu i wniosek, że każdy istotny wynik „potwierdza trafność”.
- Korelacja Pearsona zamiast ICC przy retescie: korelacja nie widzi przesunięcia wszystkich wyników.
- Wynik ogólny skali wielowymiarowej liczony bez sprawdzenia, czy model na to pozwala (np. modelem bifactor).
- „Trafność kryterialna” bez kryterium.
Badanie walidacyjne w R: dwie próby, struktura, rzetelność, hipotezy
Trzy przepisy liczą wszystkie liczby z tekstu. Pierwszy tworzy symulowane dane i zapisuje je w pliku CSV w folderze nadrzędnym (../), dwa pozostałe go wczytują. Rysunki powstały w osobnym skrypcie na tych samych danych. Dane możesz pobrać: badanie-walidacyjne-skala-przeciazenia.csv (529 ankiet: próba, 12 pozycji, skale do trafności, pozycje retestu z przedrostkiem r_, kolumna kompletna; puste pola to braki). Skala, jej pozycje i wszystkie dane są fikcyjne.
Dwie próby i retest: dane symulowane
R
# B490 – badanie walidacyjne: symulacja dwóch prób i retestu (skala i dane są fikcyjne)
set.seed(4901)

kategorie <- function(z) as.integer(cut(z, c(-Inf, -1.45, -.55, .45, 1.35, Inf)))   # odpowiedzi 1–5
reszta <- function(l) sqrt(1 - l^2)
R_czynniki <- matrix(c(1, .42, .40,  .42, 1, .48,  .40, .48, 1), 3)
ladunki <- list(pi = c(.84, .80, .76, .72), pd = c(.82, .80, .40, .74), to = c(.85, .80, .76, .70))

# Czynniki: pi – przeciążenie informacją, pd – presja dostępności, to – trudność odłączenia
czynniki <- function(n) { m <- matrix(rnorm(3 * n), n) %*% chol(R_czynniki); colnames(m) <- names(ladunki); m }
pozycje <- function(th, przedrostek = "") {
  wyj <- list()
  for (f in names(ladunki)) for (i in seq_along(ladunki[[f]])) {
    l <- ladunki[[f]][i]
    # pozycja pd3 mierzy dwa czynniki naraz – w badaniu pierwszym wyjdzie to w EFA
    z <- if (f == "pd" && i == 3) l * th[, "pd"] + .45 * th[, "to"] + sqrt(1 - l^2 - .45^2 - 2 * l * .45 * R_czynniki[2, 3]) * rnorm(nrow(th))
         else l * th[, f] + reszta(l) * rnorm(nrow(th))
    wyj[[paste0(przedrostek, f, i)]] <- kategorie(z)
  }
  as.data.frame(wyj)
}

# Badanie 1 (eksploracyjne): tylko skala
n1 <- 248
e <- data.frame(id = sprintf("E%03d", 1:n1), proba = "eksploracyjna", pozycje(czynniki(n1)))

# Badanie 2 (potwierdzające): wersja po decyzjach z badania 1 i skale do sprawdzania trafności
n2 <- 281
th2 <- czynniki(n2)
p <- data.frame(id = sprintf("P%03d", 1:n2), proba = "potwierdzajaca", pozycje(th2))
p$pd3 <- NA                          # tej pozycji nie było już w badaniu 2
skala <- function(x, srednia, sd, min, max, krok) pmin(pmax(round((srednia + sd * x) / krok) * krok, min), max)
p$stres <- skala(.55 * th2[, "pi"] + reszta(.55) * rnorm(n2), 2.9, .7, 1, 5, .1)
p$sen <- skala(-.35 * th2[, "to"] + reszta(.35) * rnorm(n2), 3.3, .7, 1, 5, .1)
p$sumiennosc <- skala(.05 * th2[, "pi"] + reszta(.05) * rnorm(n2), 3.6, .6, 1, 5, .1)
p$ekran <- skala(.20 * th2[, "pd"] + reszta(.20) * rnorm(n2), 5.2, 1.6, .5, 14, .5)

# Retest po 14 dniach (część próby potwierdzającej podaje kod do powiązania pomiarów)
zgoda <- runif(n2) < .34
wrocili <- zgoda & runif(n2) < .72
th_ret <- .88 * th2 + sqrt(1 - .88^2) * matrix(rnorm(3 * n2), n2)
ret <- pozycje(th_ret, "r_")
ret[!wrocili, ] <- NA
ret$r_pd3 <- NA
p <- cbind(p, ret)

# Niekompletne ankiety: przerwane w połowie
dane <- merge(e, p, all = TRUE, sort = FALSE)
pyt <- c(paste0("pd", c(1, 2, 4)), paste0("to", 1:4))
dane$kompletna <- !(dane$proba == "eksploracyjna" & runif(nrow(dane)) < .08 |
                    dane$proba == "potwierdzajaca" & runif(nrow(dane)) < .09)
dane[!dane$kompletna, pyt] <- NA
dane[!dane$kompletna, grep("^r_", names(dane), value = TRUE)] <- NA
write.csv(dane, "../badanie-walidacyjne-skala-przeciazenia.csv", row.names = FALSE, na = "", fileEncoding = "UTF-8")

# ---- Przepływ uczestników ----
cat("Ankiety rozpoczęte i kompletne:\n")
tb <- with(dane, table(proba, kompletna))
print(tb)
cat("\nOdsetek kompletnych (%):", round(100 * prop.table(tb, 1)[, "TRUE"], 1), "\n")
d2 <- dane[dane$proba == "potwierdzajaca" & dane$kompletna, ]
cat(sprintf("\nRetest (próba potwierdzająca, kompletne T1): %d osób z powiązanym drugim pomiarem\n",
            sum(!is.na(d2$r_pi1))))
Wynik w R
Ankiety rozpoczęte i kompletne:
                kompletna
proba            FALSE TRUE
  eksploracyjna     28  220
  potwierdzajaca    18  263

Odsetek kompletnych (%): 88.7 93.6

Retest (próba potwierdzająca, kompletne T1): 84 osób z powiązanym drugim pomiarem
Struktura: analiza równoległa, EFA, CFA
R
# B490 – struktura: analiza równoległa i EFA (próba 1), potem CFA (próba 2)
library(lavaan)
set.seed(4902)

dane <- read.csv("../badanie-walidacyjne-skala-przeciazenia.csv", fileEncoding = "UTF-8")
dane <- dane[dane$kompletna, ]
it12 <- c(paste0("pi", 1:4), paste0("pd", 1:4), paste0("to", 1:4))
e <- dane[dane$proba == "eksploracyjna", it12]
p <- dane[dane$proba == "potwierdzajaca", ]
bz <- function(x, d = 2) sub("^(-?)0\\.", "\\1.", formatC(x, format = "f", digits = d))
cat(sprintf("Próba eksploracyjna: n = %d; próba potwierdzająca: n = %d\n\n", nrow(e), nrow(p)))

# Analiza równoległa: wartości własne z danych a 95. centyl z 1000 zbiorów losowych
wlasne <- eigen(cor(e))$values
losowe <- apply(replicate(1000, eigen(cor(matrix(rnorm(prod(dim(e))), nrow(e))))$values), 1, quantile, .95)
print(round(rbind(dane = wlasne, centyl95_losowych = losowe)[, 1:5], 2))
k <- sum(cumprod(wlasne > losowe))
cat("Liczba czynników z analizy równoległej:", k, "\n\n")

# EFA: metoda największej wiarygodności, rotacja promax
efa <- factanal(e, factors = k, rotation = "promax")
L <- unclass(efa$loadings)
# Czynnik nazywamy według podskali, której pozycje mają na nim najwyższe ładunki
gdzie <- apply(abs(L), 1, which.max)
colnames(L) <- sapply(seq_len(k), function(j) names(which.max(table(substr(names(gdzie)[gdzie == j], 1, 2)))))
Phi <- solve(efa$rotmat) %*% t(solve(efa$rotmat))
dimnames(Phi) <- list(colnames(L), colnames(L))
L <- L[, c("pi", "pd", "to")]
glowny <- apply(abs(L), 1, max)
drugi <- apply(abs(L), 1, function(x) sort(x, decreasing = TRUE)[2])
czynnik <- colnames(L)[apply(abs(L), 1, which.max)]
tab <- data.frame(round(L, 2), h2 = round(1 - efa$uniquenesses, 2), czynnik)
# Reguła zapisana przed analizą: ładunek główny >= .40, przewaga nad kolejnym >= .20, właściwy czynnik
tab$decyzja <- ifelse(glowny >= .40 & glowny - drugi >= .20 & czynnik == substr(rownames(L), 1, 2), "zostaje", "usunac")
print(tab)
cat("\nKorelacje czynników: pi-pd", bz(Phi["pi", "pd"]), " pi-to", bz(Phi["pi", "to"]), " pd-to", bz(Phi["pd", "to"]), "\n")
cat("Pozycje do usunięcia według reguły:", rownames(tab)[tab$decyzja != "zostaje"], "\n\n")

# CFA na niezależnej próbie, 11 pozycji
m3 <- "PI =~ pi1 + pi2 + pi3 + pi4
       PD =~ pd1 + pd2 + pd4
       TO =~ to1 + to2 + to3 + to4"
m1 <- "G =~ pi1 + pi2 + pi3 + pi4 + pd1 + pd2 + pd4 + to1 + to2 + to3 + to4"
f3 <- cfa(m3, data = p, estimator = "MLR")
f1 <- cfa(m1, data = p, estimator = "MLR")
miary <- c("chisq.scaled", "df.scaled", "pvalue.scaled", "cfi.robust", "tli.robust",
           "rmsea.robust", "rmsea.ci.lower.robust", "rmsea.ci.upper.robust", "srmr")
print(round(rbind(trzy_czynniki = fitMeasures(f3, miary), jeden_czynnik = fitMeasures(f1, miary)), 3))
st <- standardizedSolution(f3)
lad <- st[st$op == "=~", c("lhs", "rhs", "est.std", "ci.lower", "ci.upper")]
print(data.frame(lad[1:2], round(lad[3:5], 2)), row.names = FALSE)
kor <- st[st$op == "~~" & st$lhs != st$rhs, c("lhs", "rhs", "est.std", "ci.lower", "ci.upper")]
print(data.frame(kor[1:2], round(kor[3:5], 2)), row.names = FALSE)
Wynik w R
Próba eksploracyjna: n = 220; próba potwierdzająca: n = 263

                  [,1] [,2] [,3] [,4] [,5]
dane              4.66 1.87 1.42 0.62 0.59
centyl95_losowych 1.50 1.36 1.27 1.19 1.12
Liczba czynników z analizy równoległej: 3

       pi    pd    to   h2 czynnik decyzja
pi1  0.89  0.06 -0.10 0.76      pi zostaje
pi2  0.79 -0.02 -0.02 0.60      pi zostaje
pi3  0.69  0.06  0.02 0.52      pi zostaje
pi4  0.60 -0.12  0.16 0.41      pi zostaje
pd1  0.03  0.74  0.04 0.60      pd zostaje
pd2  0.04  0.80 -0.10 0.59      pd zostaje
pd3  0.01  0.32  0.52 0.55      to  usunac
pd4 -0.03  0.65  0.04 0.44      pd zostaje
to1  0.06  0.04  0.72 0.59      to zostaje
to2 -0.07 -0.11  0.84 0.58      to zostaje
to3 -0.03  0.06  0.73 0.55      to zostaje
to4 -0.05 -0.08  0.73 0.45      to zostaje

Korelacje czynników: pi-pd .37  pi-to .43  pd-to .53
Pozycje do usunięcia według reguły: pd3

              chisq.scaled df.scaled pvalue.scaled cfi.robust tli.robust
trzy_czynniki       61.744        41          0.02      0.981      0.975
jeden_czynnik      515.269        44          0.00      0.634      0.542
              rmsea.robust rmsea.ci.lower.robust rmsea.ci.upper.robust  srmr
trzy_czynniki        0.044                 0.018                 0.066 0.040
jeden_czynnik        0.189                 0.174                 0.204 0.123
 lhs rhs est.std ci.lower ci.upper
  PI pi1    0.78     0.71     0.85
  PI pi2    0.70     0.62     0.78
  PI pi3    0.75     0.68     0.82
  PI pi4    0.72     0.65     0.79
  PD pd1    0.82     0.75     0.89
  PD pd2    0.73     0.65     0.82
  PD pd4    0.65     0.57     0.73
  TO to1    0.84     0.79     0.89
  TO to2    0.79     0.73     0.85
  TO to3    0.74     0.67     0.80
  TO to4    0.64     0.56     0.72
 lhs rhs est.std ci.lower ci.upper
  PI  PD    0.52     0.39     0.66
  PI  TO    0.45     0.34     0.56
  PD  TO    0.48     0.36     0.60
Rzetelność, retest i hipotezy o trafności
R
# B490 – rzetelność (alfa, omega, test–retest) i hipotezy o trafności, próba potwierdzająca
library(irr)
set.seed(4903)

dane <- read.csv("../badanie-walidacyjne-skala-przeciazenia.csv", fileEncoding = "UTF-8")
p <- dane[dane$proba == "potwierdzajaca" & dane$kompletna, ]
skale <- list(PI = paste0("pi", 1:4), PD = paste0("pd", c(1, 2, 4)), TO = paste0("to", 1:4))
bz <- function(x, d = 2) sub("^(-?)0\\.", "\\1.", formatC(x, format = "f", digits = d))

alfa <- function(x) { k <- ncol(x); k / (k - 1) * (1 - sum(apply(x, 2, var)) / var(rowSums(x))) }
# Omega z modelu jednoczynnikowego dla jednej podskali (ładunki w skali surowej pozycji)
omega <- function(x) {
  u <- factanal(x, 1)$uniquenesses
  l <- apply(x, 2, sd) * sqrt(1 - u)
  psi <- apply(x, 2, var) * u
  sum(l)^2 / (sum(l)^2 + sum(psi))
}
bo <- 2000
wyn <- t(sapply(names(skale), function(s) {
  x <- p[skale[[s]]]
  b <- replicate(bo, omega(x[sample(nrow(x), replace = TRUE), ]))
  c(pozycje = ncol(x), M = mean(rowMeans(x)), SD = sd(rowMeans(x)), alfa = alfa(x), omega = omega(x),
    omega_dolna = quantile(b, .025, names = FALSE), omega_gorna = quantile(b, .975, names = FALSE))
}))
print(round(wyn, 2))

# Test–retest: te osoby, które mają oba pomiary
r <- p[!is.na(p$r_pi1), ]
cat(sprintf("\nRetest po 14 dniach: n = %d\n", nrow(r)))
ret <- t(sapply(names(skale), function(s) {
  t1 <- rowMeans(r[skale[[s]]]); t2 <- rowMeans(r[paste0("r_", skale[[s]])])
  ic <- icc(cbind(t1, t2), model = "twoway", type = "agreement", unit = "single")
  tt <- t.test(t2, t1, paired = TRUE)
  sem <- sd(t1) * sqrt(1 - ic$value)
  c(M_T1 = mean(t1), M_T2 = mean(t2), roznica = mean(t2 - t1), roznica_d = tt$conf.int[1], roznica_g = tt$conf.int[2],
    ICC = ic$value, ICC_d = ic$lbound, ICC_g = ic$ubound, SEM = sem, MDC95 = 1.96 * sqrt(2) * sem)
}))
print(round(ret, 2))

# Hipotezy o trafności, zapisane przed analizą (kierunek i oczekiwana wielkość)
for (s in names(skale)) p[[s]] <- rowMeans(p[skale[[s]]])
hip <- data.frame(hipoteza = c("H1 PI - stres", "H2 TO - jakosc snu", "H3 PI - sumiennosc", "H4 PD - czas przy ekranie"),
                  x = c("PI", "TO", "PI", "PD"), y = c("stres", "sen", "sumiennosc", "ekran"),
                  oczekiwane = c("r >= .40", "r <= -.20", "|r| < .20", "r >= .30"))
wyn_h <- t(mapply(function(x, y) { w <- cor.test(p[[x]], p[[y]]); c(w$estimate, w$conf.int) }, hip$x, hip$y))
hip$r <- wyn_h[, 1]; hip$dolna <- wyn_h[, 2]; hip$gorna <- wyn_h[, 3]
hip$zgodna <- c(hip$r[1] >= .40, hip$r[2] <= -.20, abs(hip$r[3]) < .20, hip$r[4] >= .30)
print(data.frame(hip[c("hipoteza", "oczekiwane")], r = bz(hip$r), CI = sprintf("[%s, %s]", bz(hip$dolna), bz(hip$gorna)), zgodna = hip$zgodna), row.names = FALSE)
cat(sprintf("\nHipotezy zgodne z wynikiem: %d z %d (n = %d)\n", sum(hip$zgodna), nrow(hip), nrow(p)))
Wynik w R
   pozycje    M   SD alfa omega omega_dolna omega_gorna
PI       4 3.02 0.84 0.83  0.83        0.79        0.86
PD       3 3.08 0.86 0.78  0.78        0.74        0.82
TO       4 2.98 0.85 0.84  0.84        0.81        0.87

Retest po 14 dniach: n = 84
   M_T1 M_T2 roznica roznica_d roznica_g  ICC ICC_d ICC_g  SEM MDC95
PI 3.15 3.15   -0.01     -0.13      0.12 0.78  0.68  0.85 0.41  1.13
PD 3.21 3.30    0.09     -0.05      0.22 0.73  0.62  0.82 0.45  1.26
TO 3.02 3.08    0.06     -0.04      0.17 0.85  0.77  0.90 0.35  0.97
                  hipoteza oczekiwane    r           CI zgodna
             H1 PI - stres   r >= .40  .49   [.39, .57]   TRUE
        H2 TO - jakosc snu  r <= -.20 -.32 [-.43, -.21]   TRUE
        H3 PI - sumiennosc  |r| < .20  .06  [-.06, .18]   TRUE
 H4 PD - czas przy ekranie   r >= .30  .23   [.11, .34]  FALSE

Hipotezy zgodne z wynikiem: 3 z 4 (n = 263)
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietami lavaan i irr; rysunki przygotowano w pakietach ggplot2 i svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7-2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- irr (wersja 0.85): Gamer, M., Lemon, J., Fellows, I., & Singh, P. (2026). irr: Various coefficients of interrater reliability and agreement (R package version 0.85) [Computer software]. https://doi.org/10.32614/CRAN.package.irr
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Zanim oddasz rozdział, sprawdź…
- Czy opisano zgodę właściciela praw i wersję narzędzia?
- Czy czytelnik wie, z której próby pochodzi każda liczba?
- Czy decyzje o pozycjach wynikają z reguł zapisanych wcześniej?
- Czy CFA liczono na osobach, które nie brały udziału w EFA?
- Czy podano α i ω dla podskal, a nie tylko dla całości?
- Czy retest ma uzasadniony odstęp, ICC z pełnym opisem, przedział i błąd pomiaru?
- Czy każda hipoteza o trafności ma kierunek i zakres, a niezgodne są wymienione?
- Czy we wnioskach określono populację i zastosowanie, zamiast pisać, że skala „jest trafna”?
Najczęstsze pytania
Czy praca magisterska może polegać wyłącznie na walidacji skali?
Często tak, ale decyduje uczelnia i promotor. Ustal to na początku. W takiej pracy wynikiem są właściwości narzędzia, więc potrzebne są hipotezy o strukturze i trafności, co najmniej dwa rodzaje dowodów oraz jasne ograniczenia dotyczące populacji.
Czy mogę użyć jednej próby i losowo podzielić ją na dwie części?
Tak, jeśli liczebność na to pozwala i napiszesz o tym wprost. Oba zbiory pochodzą wtedy z tego samego naboru, więc jest to słabszy dowód powtarzalności niż dwa odrębne badania. Podział wykonaj losowo przed obejrzeniem wyników.
Co napisać, gdy jedna z hipotez o trafności się nie potwierdzi?
Pokaż ją w tabeli z zakresem i wynikiem, a w tekście podaj korelację z przedziałem. W przykładzie związek wyniósł .23 przy założonym .30. Rozważ wyjaśnienia, w tym słabość miary kryterialnej, ale nie zmieniaj zakresu po fakcie.
Czy po usunięciu pozycji mogę dalej używać nazwy oryginalnej skali?
Zapytaj właściciela praw i wskaż, że to wersja zmieniona, na przykład 11-pozycyjna. Wyników zmienionej wersji nie porównuj wprost z oryginałem bez dodatkowych analiz. Zmiany opisz w metodzie.
Ile osób powinno wziąć udział w retescie?
Nie ma jednej liczby. Oblicz, jak szeroki przedział dla ICC otrzymasz przy planowanej liczebności. W przykładzie 84 pary dały dla jednej z podskal przedział [.68, .85]. Pamiętaj, że część osób nie wróci, więc zaproś ich więcej.
Powiązane hasła
Przeczytaj też
Jak zbudować i zwalidować skalę psychometryczną?
Od definicji konstruktu i tworzenia pozycji po pilotaż, EFA, CFA, rzetelność, trafność teoretyczną, różnicową i niezmienniczość.
Czytaj →PoradnikAdaptacja kulturowa kwestionariusza
Dziesięć etapów według ITC: zgoda autora, przekład, CVI, wywiady poznawcze, pilotaż, CFA i inwariancja w R, rzetelność, trafność, normy i opis APA.
Czytaj →PoradnikAnaliza czynnikowa EFA i CFA
EFA czy CFA, analiza równoległa, rotacja oblimin a varimax, przejście od EFA do CFA na nowej próbie, WLSMV i opis APA – z danymi i kodem R.
Czytaj →PoradnikRodzaje trafności – mapa dowodów
Tradycyjne nazwy trafności na mapie pięciu źródeł dowodów (Standards, 2014): jak zebrać dowód, jaka analiza, jak opisać w pracy i które 2–3 rodzaje dowodów zaplanować.
Czytaj →PoradnikOpis narzędzia badawczego – wzór
Dziesięć elementów opisu i cztery wzory: kwestionariusz z adaptacją, ankieta własna, test wiedzy i skala kliniczna – z rzetelnością z własnej próby.
Czytaj →PoradnikRozdział metodologiczny – jak go napisać
Co napisać w każdym podrozdziale metody: hipotezy, zmienne, próba, narzędzia, procedura, etyka i plan analiz – z wzorami zdań i listą JARS.
Czytaj →PoradnikEwaluacja programu w jednej placówce – opis metody
Gotowy podrozdział „Metoda”: autor jako prowadzący, wierność realizacji, grupa porównawcza i dozwolone wnioski, z kodem R.
Czytaj →PoradnikAnaliza gotowych danych w pracy
Jak opisać źródło, falę, próbę analityczną, zmienne i wagi, co wolno napisać we wnioskach – z gotowym podrozdziałem „Metoda” i kodem R.
Czytaj →Walidujesz skalę w pracy dyplomowej?
Pomożemy ułożyć plan prób i analiz, policzyć EFA, CFA i retest oraz opisać wyniki tak, by wnioski odpowiadały zebranym dowodom – z wyjaśnieniem, które pozwoli Ci samodzielnie obronić pracę.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Boateng, G. O., Neilands, T. B., Frongillo, E. A., Melgar-Quiñonez, H. R., & Young, S. L. (2018). Best practices for developing and validating scales for health, social, and behavioral research: A primer. Frontiers in Public Health, 6, Article 149. https://doi.org/10.3389/fpubh.2018.00149 ● Otwarty dostęp
- Flake, J. K., Pek, J., & Hehman, E. (2017). Construct validation in social and personality research: Current practice and recommendations. Social Psychological and Personality Science, 8(4), 370–378. https://doi.org/10.1177/1948550617693063
- Gagnier, J. J., Lai, J., Mokkink, L. B., & Terwee, C. B. (2021). COSMIN reporting guideline for studies on measurement properties of patient-reported outcome measures. Quality of Life Research, 30(8), 2197–2218. https://doi.org/10.1007/s11136-021-02822-4 ● Otwarty dostęp: pełny tekst
- Hu, L., & Bentler, P. M. (1999). Cutoff criteria for fit indexes in covariance structure analysis: Conventional criteria versus new alternatives. Structural Equation Modeling: A Multidisciplinary Journal, 6(1), 1–55. https://doi.org/10.1080/10705519909540118
- International Test Commission. (2018). ITC guidelines for translating and adapting tests (second edition). International Journal of Testing, 18(2), 101–134. https://doi.org/10.1080/15305058.2017.1398166 ● Otwarty dostęp: pełny tekst
- Koo, T. K., & Li, M. Y. (2016). A guideline of selecting and reporting intraclass correlation coefficients for reliability research. Journal of Chiropractic Medicine, 15(2), 155–163. https://doi.org/10.1016/j.jcm.2016.02.012 ● Otwarty dostęp
- MacCallum, R. C., Widaman, K. F., Zhang, S., & Hong, S. (1999). Sample size in factor analysis. Psychological Methods, 4(1), 84–99. https://doi.org/10.1037/1082-989x.4.1.84
- Mokkink, L. B., Terwee, C. B., Patrick, D. L., Alonso, J., Stratford, P. W., Knol, D. L., Bouter, L. M., & de Vet, H. C. W. (2010). The COSMIN study reached international consensus on taxonomy, terminology, and definitions of measurement properties for health-related patient-reported outcomes. Journal of Clinical Epidemiology, 63(7), 737–745. https://doi.org/10.1016/j.jclinepi.2010.02.006 ● Otwarty dostęp
- Prinsen, C. A. C., Mokkink, L. B., Bouter, L. M., Alonso, J., Patrick, D. L., de Vet, H. C. W., & Terwee, C. B. (2018). COSMIN guideline for systematic reviews of patient-reported outcome measures. Quality of Life Research, 27(5), 1147–1157. https://doi.org/10.1007/s11136-018-1798-3 ● Otwarty dostęp
Cytowania BibTeX
@article{boateng2018best, author={Boateng, Godfred O. and Neilands, Torsten B. and Frongillo, Edward A. and Melgar-Quiñonez, Hugo R. and Young, Sera L.}, title={{Best practices for developing and validating scales for health, social, and behavioral research: A primer}}, journal={Frontiers in Public Health}, year={2018}, volume={6}, eid={149}, doi={10.3389/fpubh.2018.00149}}@article{flake2017construct, author={Flake, Jessica K. and Pek, Jolynn and Hehman, Eric}, title={{Construct validation in social and personality research: Current practice and recommendations}}, journal={Social Psychological and Personality Science}, year={2017}, volume={8}, number={4}, pages={370--378}, doi={10.1177/1948550617693063}}@article{gagnier2021cosmin, author={Gagnier, Joel J. and Lai, Jianyu and Mokkink, Lidwine B. and Terwee, Caroline B.}, title={{COSMIN reporting guideline for studies on measurement properties of patient-reported outcome measures}}, journal={Quality of Life Research}, year={2021}, volume={30}, number={8}, pages={2197--2218}, doi={10.1007/s11136-021-02822-4}}@article{hu1999cutoff, author={Hu, Li-tze and Bentler, Peter M.}, title={{Cutoff criteria for fit indexes in covariance structure analysis: Conventional criteria versus new alternatives}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={1999}, volume={6}, number={1}, pages={1--55}, doi={10.1080/10705519909540118}}@article{itc2018guidelines, author={{International Test Commission}}, title={{ITC guidelines for translating and adapting tests (second edition)}}, journal={International Journal of Testing}, year={2018}, volume={18}, number={2}, pages={101--134}, doi={10.1080/15305058.2017.1398166}}@article{koo2016guideline, author={Koo, Terry K. and Li, Mae Y.}, title={{A guideline of selecting and reporting intraclass correlation coefficients for reliability research}}, journal={Journal of Chiropractic Medicine}, year={2016}, volume={15}, number={2}, pages={155--163}, doi={10.1016/j.jcm.2016.02.012}}@article{maccallum1999sample, author={MacCallum, Robert C. and Widaman, Keith F. and Zhang, Shaobo and Hong, Sehee}, title={{Sample size in factor analysis}}, journal={Psychological Methods}, year={1999}, volume={4}, number={1}, pages={84--99}, doi={10.1037/1082-989x.4.1.84}}@article{mokkink2010cosmin, author={Mokkink, Lidwine B. and Terwee, Caroline B. and Patrick, Donald L. and Alonso, Jordi and Stratford, Paul W. and Knol, Dirk L. and Bouter, Lex M. and de Vet, Henrica C. W.}, title={{The COSMIN study reached international consensus on taxonomy, terminology, and definitions of measurement properties for health-related patient-reported outcomes}}, journal={Journal of Clinical Epidemiology}, year={2010}, volume={63}, number={7}, pages={737--745}, doi={10.1016/j.jclinepi.2010.02.006}}@article{prinsen2018cosmin, author={Prinsen, C. A. C. and Mokkink, L. B. and Bouter, L. M. and Alonso, J. and Patrick, D. L. and de Vet, H. C. W. and Terwee, C. B.}, title={{COSMIN guideline for systematic reviews of patient-reported outcome measures}}, journal={Quality of Life Research}, year={2018}, volume={27}, number={5}, pages={1147--1157}, doi={10.1007/s11136-018-1798-3}}