Gotowe dane to też metoda, tylko część decyzji podjął ktoś inny
Analiza gotowych danych polega na tym, że odpowiadasz na własne pytanie na pliku, którego sam(a) nie zbierałeś(-aś): z dużego sondażu, statystyki publicznej albo bazy instytucji. Smith i in. (2011) podkreślają, że obowiązują tu te same zasady co w badaniu pierwotnym: jasne pytanie, właściwa próba, adekwatne miary i przemyślana analiza. Inny jest podział odpowiedzialności. W rozdziale metody musisz oddzielić to, co zrobił dostawca danych, od tego, co zdecydowałeś(-aś) Ty.
Ten wpis dotyczy tekstu pracy. Rodzaje ponownej analizy, licencje i prerejestrację opisuje reanaliza i wtórna analiza danych, a dostęp do ESS, PGSS i Diagnozy Społecznej oraz wybór konkretnej wagi – analiza danych z dużych badań sondażowych. Kartę ekstrakcji z dokumentacji medycznej znajdziesz we wpisie o badaniu retrospektywnym, a miejsce danych wtórnych w całej pracy pokazuje praca z socjologii.
Przykład przewodni (fikcyjny, dane symulowane). Studentka zarządzania pyta, czy dłuższy tydzień pracy wiąże się z niższym zadowoleniem z życia osób pracujących w wieku 25–64 lat. Korzysta z pliku „Sondaż Warunków Życia 2024”. Nazwa badania, instytucje i wszystkie liczby są zmyślone i nie odpowiadają żadnemu rzeczywistemu sondażowi ani danym GUS. Schemat jest typowy dla dużych badań: 6 warstw, po 20 pierwotnych jednostek losowania (PSU), po 22 adresy w każdej, jedna osoba w gospodarstwie.
Opis źródła: pięć pytań, na które odpowiada dokumentacja
Sørensen i in. (1996) oceniają wtórne źródła danych pod kątem kompletności rejestracji osób, dokładności i kompletności zapisów, wielkości źródła, okresu rejestracji, dostępności i kosztu, formatu oraz możliwości łączenia z innymi danymi. Autorzy piszą o epidemiologii, ale ta lista dobrze działa także w innych dziedzinach. Tabela przekłada ją na trzy najczęstsze rodzaje źródeł. Odpowiedzi szukaj w dokumentacji technicznej, kwestionariuszu i książce kodowej, a nie w artykułach, które z tych danych korzystały.
| Pytanie | Duży sondaż | GUS i inna statystyka publiczna | Dokumentacja lub baza instytucji |
|---|---|---|---|
| Kto i po co | Zespół lub konsorcjum, cel pomiaru | Urząd, cel statystyczny, podstawa publikacji wskaźnika | Placówka lub firma; dane powstały przy bieżącej pracy |
| Kiedy | Rok, fala, daty realizacji | Rok, stan na dzień, okres objęty | Okres, zmiany systemu i formularzy |
| Jak | Tryb, dosłowne brzmienie pytań, ankieterzy | Definicja wskaźnika i jej zmiany w czasie | Kto wpisuje, które pola są obowiązkowe, jakie kody |
| Kogo obejmuje | Populacja, operat, schemat doboru, realizacja | Jednostka (np. powiat lub gmina) i zasięg | Kogo system widzi, a kogo w nim nie ma |
| Na jakich warunkach | Rejestracja, warunki użycia, wzór cytowania, edycja pliku, data pobrania | Nazwa tabeli, data pobrania; mikrodane to zwykle osobna ścieżka dostępu | Pisemna zgoda, kto wyciągnął dane, zakres i forma pseudonimizacji |
Dane administracyjne wymagają tej samej krytycznej oceny co każde inne. Hand (2018) przypomina, że powstają zwykle jako skutek uboczny działań operacyjnych. Praktyczny skutek jest prosty: pola niepotrzebne do bieżącej pracy mogą być niekompletne. Dlatego przy bazie instytucji opisz proces powstawania wpisu, a nie tylko nazwę systemu.
Wybór fali i edycji: uzasadnij je przed obejrzeniem wyników
Falę wybierasz według pytania: czy zawiera potrzebny moduł, czy brzmienie pytań było takie samo, czy okres ma dla tematu znaczenie. Argument „najnowsza dostępna” jest poprawny, o ile to rzeczywiście powód wyboru. Argument „w tej fali wyszło istotnie” dyskwalifikuje analizę. Przy gotowych danych łatwiej o to, niż się wydaje, bo znasz opublikowane wyniki. Weston i in. (2019) opisują praktyki zwiększające przejrzystość takich analiz, a szablon Van den Akkera i in. (2021) służy do prerejestracji planu z uwzględnieniem wcześniejszej znajomości zbioru. W pracy dyplomowej wystarczy dziennik decyzji z datami i jedno zdanie o tym, co znałeś(-aś) przed analizą.
Zapisz numer edycji pliku i datę pobrania. Kolejna edycja tej samej fali może mieć poprawione dane, a liczby wtedy się zmienią. Jeżeli łączysz kilka fal przekrojowych, to wciąż są różne osoby, więc nie pisz o „zmianie u respondentów”.
Próba analityczna: od pliku do osób, które naprawdę analizujesz
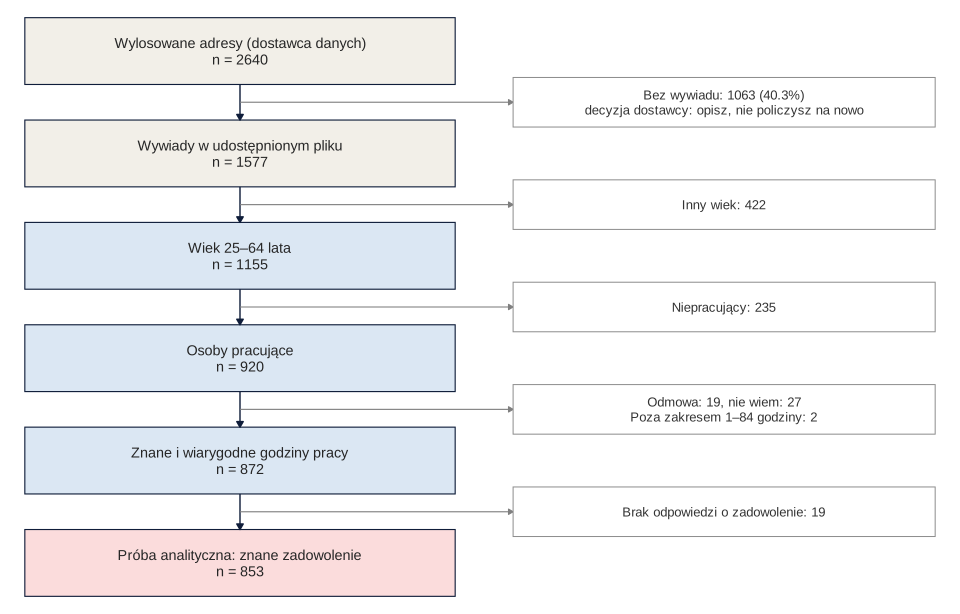
W gotowych danych próba badania i próba analityczna to dwie różne rzeczy. Rysunek 1 oddziela etapy dostawcy od Twoich. Górne liczby tylko raportujesz. Dolne wynikają z kryteriów, które ustalasz w swojej pracy, więc każde musi mieć uzasadnienie w pytaniu badawczym. Logikę takiego diagramu omawia wpis o przepływie respondentów, a rysunek przygotujesz w generatorze diagramu.
Najpierw kody specjalne. W wielu dużych zbiorach brak odpowiedzi to liczba: tu 666 (nie dotyczy), 777 (odmowa), 888 (nie wiem) dla godzin oraz 77 i 88 dla zadowolenia. Jeśli zostawisz je w danych, średnia tygodniowa liczba godzin w pliku wyniesie 307.13, a średnie zadowolenie 8.13 zamiast 6.59. Taki błąd łatwo zauważyć przy godzinach, a dużo trudniej przy skali 0–10. Przed analizą sprawdź zakresy według reguł kontroli danych.
Różne braki znaczą co innego. „Nie dotyczy” to osoba spoza pytania, a „odmowa” i „nie wiem” to braki danych w ścisłym sensie. Wśród 920 pracujących brakowało godzin u 46 osób, a 2 osoby podały wartość spoza zakresu ustalonego z góry. Przy ubytku z powodu braków porównaj osoby włączone i utracone. Tu utracono 65 z 918 osób (7.1%): były starsze (ważona średnia wieku 47.6 wobec 43.8 lat) i częściej były to kobiety (61.2% wobec 51.5%), a odsetek osób z wyższym wykształceniem był podobny (48.7% i 49.3%).
Dopasowanie zmiennych do pojęć: napisz, czego nie zmierzono
W badaniu własnym dobierasz narzędzie do pojęcia. Tu robisz odwrotnie: masz pytania z kwestionariusza i musisz uczciwie powiedzieć, które pojęcie przybliżają. To jest sedno operacjonalizacji w danych wtórnych, a recenzenci często pytają właśnie o to. Tabelę taką jak poniższa warto umieścić w metodzie.
| Pojęcie w pracy | Zmienna w pliku | Co obejmuje | Czego nie mierzy |
|---|---|---|---|
| Obciążenie czasem pracy | Zwykle przepracowane godziny tygodniowo (samoopis) | Deklarowany czas pracy zarobkowej | Intensywności pracy, nadgodzin niezapisanych, pracy nieodpłatnej, pracy w domu |
| Zadowolenie z życia | Jedno pytanie 0–10 | Ogólną ocenę z chwili badania | Wymiarów zadowolenia; rzetelności nie policzysz, bo jest jedna pozycja |
| Wykształcenie | Trzy kategorie (po recodingu) | Poziom formalny | Kierunku i dopasowania do pracy; wzór łączenia kategorii podaj w metodzie |
| Status zatrudnienia | Główna aktywność w chwili badania | Deklarację w jednym momencie | Historii pracy i niepewności zatrudnienia |
Najczęstszy błąd polega na tym, że nazwa zmiennej rośnie w tekście. Studentka nie zbadała „przeciążenia pracą”, bo nikt o nie nie pytał. Zbadała zadeklarowany czas pracy. Jeśli w temacie pracy jest pojęcie szersze niż wskaźnik, zapisz to w ograniczeniach i nie zastępuj wskaźnika nazwą pojęcia w wynikach.
Wagi, schemat i podpopulacja: cztery sposoby liczenia
West i in. (2016) oceniają, że pomijanie złożonego schematu doboru w analizach wtórnych wydaje się bardzo częste i prowadzi do obciążonych oszacowań oraz błędów standardowych niezgodnych ze schematem. Jak powstają wagi, wyjaśnia wpis o ważeniu danych sondażowych. Tu liczy się inna sprawa: gdy analizujesz tylko część próby, schemat trzeba opisać dla całego pliku, a grupę wskazać później. West i in. (2008) omawiają dwa podejścia do analizy podpopulacji i konsekwencje każdego z nich dla wnioskowania. W R służy do tego funkcja subset() z pakietu survey (Lumley, 2004) wywołana na obiekcie schematu.
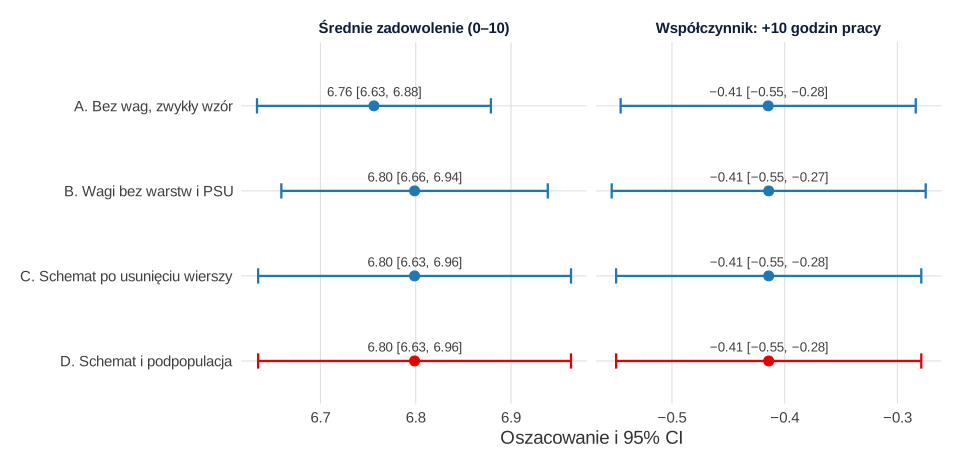
W przykładzie wagi przesuwają średnią niewiele (6.76 bez wag i 6.80 z wagami). Inaczej zachowuje się precyzja. Błąd standardowy średniej zadowolenia wynosi 0.063 bez wag, 0.071 z wagami bez warstw i PSU, a 0.083 ze schematem. Wariancja jest 1.76 razy większa niż przy wzorze dla prostej próby, więc 853 osoby niosą tu tyle informacji co około 486 osób z prostej próby losowej (efekt schematu). Współczynnik dla czasu pracy prawie się nie zmienia (−0.415 bez wag i −0.414 ze schematem, SE odpowiednio 0.067 i 0.068), bo godziny różnią się głównie między osobami w tej samej PSU. Nie uogólniaj tego na swoje dane: to, czy schemat zmienia wnioski z modelu, zależy od zmiennych. W szerokiej grupie usunięcie wierszy dało ten sam wynik co subset(), ale w wąskiej (60–64 lata, 46 osób w 39 z 120 PSU) błąd standardowy wyniósł 0.377 zamiast 0.363. Skrót działa więc, dopóki grupa jest duża, a poprawne polecenie nic nie kosztuje.
GUS i dane instytucji: co zmienia się w opisie
Dane zagregowane. Tabele GUS, np. z Banku Danych Lokalnych, mówią zwykle o jednostkach terytorialnych, a nie o osobach. Jednostką analizy jest wtedy powiat lub gmina, a zależności między obszarami nie przenoszą się na ludzi (błąd ekologiczny). Opisz definicję wskaźnika, rok, zmiany granic lub metodologii i to, czy wskaźnik przeliczono na liczbę mieszkańców. Obszarów w kraju jest skończona liczba, więc napisz też, co w takim badaniu znaczy wnioskowanie o populacji. Analizę paneli spółek opisuje wpis o pracy z finansów i rachunkowości.
Dane instytucji. Benchimol i in. (2015) w wytycznych RECORD, rozszerzających STROBE na dane zbierane rutynowo, wymagają m.in. podania kodów i algorytmów użytych do identyfikacji badanych i klasyfikacji zmiennych, opisu dostępu badaczy do bazy i metod czyszczenia danych. To dobra lista także poza medycyną, np. przy danych z ośrodka pomocy społecznej czy szkoły. Porównanie wytycznych raportowania pomoże wybrać właściwą listę. Instytucja bywa też zarówno źródłem danych, jak i miejscem ocenianego działania; wtedy zobacz wpis o ewaluacji programu, a w badaniach w małych zespołach zadbaj o to, by nikt nie dał się rozpoznać.
Gotowy podrozdział „Metoda” z komentarzem
Układ jest zgodny z poradnikiem o rozdziale metodologicznym. Akapity pasują do danych przykładu, a nawiasy kwadratowe uzupełnij własnymi informacjami.
Źródło danych
Jak bywa napisane: „W pracy wykorzystano dane z dużego ogólnopolskiego badania, które jest reprezentatywne dla Polski”.
Co jest nie tak: nie wiadomo, kto, kiedy i jak je zebrał, ani której edycji użyto. Słowo „reprezentatywne” nic nie mówi o schemacie doboru.
Odsetek realizacji podaj tak, jak definiuje go dostawca, i zaznacz tę definicję. Liczbę adresów bez wywiadu w tym przykładzie policzono prosto, a rzeczywista dokumentacja rozróżnia kategorie nierealizacji i podaje je osobno.
Próba analityczna
Jak bywa napisane: „W badaniu wzięły udział 853 osoby”.
Co jest nie tak: sugeruje, że tylu było badanych, a to wynik selekcji w pliku.
Zmienne
Jak bywa napisane: „Przeciążenie pracą mierzono liczbą godzin”.
Co jest nie tak: liczba godzin nie jest miarą przeciążenia, a czytelnik nie zna brzmienia pytania.
Braki danych
Jak bywa napisane: „Usunięto braki danych”.
Co jest nie tak: nie wiadomo, jakie, ile i u kogo.
Przy większym ubytku rozważ imputację, zgodną ze schematem, albo analizę wrażliwości i uzasadnij wybór.
Wagi i plan analizy
Jak bywa napisane: „Zastosowano regresję liniową w programie R”.
Co jest nie tak: brak informacji o wadze, warstwach i PSU, a więc o tym, skąd biorą się przedziały ufności.
Etyka i warunki użycia
Zapytaj komisję albo promotora, czy analiza gotowych danych wymaga zgody komisji bioetycznej, i zapisz odpowiedź. Zależy to od uczelni, rodzaju danych i zakresu zgód uczestników. Nie dołączaj surowego pliku do pracy, jeśli warunki użycia na to nie pozwalają, i nie próbuj identyfikować osób.
Co wolno napisać we wnioskach
Gotowy plik z jednego pomiaru to nadal schemat przekrojowy, a duża próba tego nie zmienia. Ogólne zasady znajdziesz w poradniku o wnioskach i rekomendacjach.
| Zamiast | Napisz | Dlaczego |
|---|---|---|
| „Długi czas pracy obniża zadowolenie” | „Osoby pracujące dłużej deklarowały niższe zadowolenie” | Dane przekrojowe, Brak kierunku |
| „Przeciążenie pracą wiąże się…” | „Dłuższy zadeklarowany czas pracy wiązał się…” | Nazwij to, co zmierzono |
| „Polacy są zadowoleni z życia” | „W populacji pracujących w wieku 25–64 lat objętej badaniem średni wynik wyniósł…” | Uogólnienie tylko na populację z operatu |
| „Próba jest reprezentatywna, bo ma 853 osoby” | „Próba pochodzi z doboru losowego, a wagi korygują znane różnice w strukturze wieku i płci” | Wagi nie usuwają nieobserwowanych różnic |
| „W powiatach o wyższym bezrobociu mieszkańcy są mniej zadowoleni” | „Powiaty o wyższym bezrobociu miały niższy średni wynik” | Wniosek o obszarach, a nie o osobach |
Akapity z przykładu:
Pełny schemat tej części opisuje wpis o ograniczeniach badania. Dane, nazwa badania i wyniki w powyższych akapitach są fikcyjne, a nawiasy kwadratowe uzupełnij informacjami o rzeczywistym zbiorze.
Na co zwrócić uwagę w różnych dziedzinach
To obserwacje ogólne; wymagania uczelni i promotora mają pierwszeństwo.
| Dziedzina | Typowe źródło | Najczęstsze ryzyko | Co często dopisać |
|---|---|---|---|
| Psychologia | Sondaż, otwarty zbiór z badania | Skrócone skale, jedna pozycja jako konstrukt | Trafność wskaźnika, znajomość wyników przed analizą |
| Zdrowie publiczne | Badania populacyjne, statystyka publiczna | Samoopis stanu zdrowia, porównania obszarów | Definicje wskaźników, błąd ekologiczny, STROBE |
| Pielęgniarstwo i medycyna | Dokumentacja, rejestry | Kompletność wpisów, kody rozpoznań | RECORD, algorytm identyfikacji, zgoda instytucji |
| Zarządzanie i finanse | Sprawozdania, bazy firm, panel powiatów | Dobór spółek, zmiany definicji w czasie | Okres, wykluczenia, wzory wskaźników |
| Praca socjalna | Bazy ośrodków | Zależność od instytucji, małe zespoły | Jak chroniono anonimowość, kto przygotował wyciąg |
Najczęstsze błędy
- „Reprezentatywne” bez schematu. Słowo nie zastępuje opisu operatu, doboru i realizacji.
- Kody braków w średnich. W przykładzie 777 i 888 podniosły średnią godzin do 307.13.
- Filtrowanie wierszy przed zdefiniowaniem schematu. Przy małej grupie zmienia błędy standardowe.
- Waga bez warstw i PSU. Przedział dla średniej był węższy niż ze schematem (SE 0.071 wobec 0.083).
- Nazwa pojęcia zamiast nazwy zmiennej w tytule tabeli i wnioskach.
- Brak edycji pliku i daty pobrania. Nikt nie odtworzy wyniku.
- Dopasowanie fali do wyniku i kryteriów próby do istotności.
- Wnioski o ludziach z danych o powiatach.
- Traktowanie wielu fal jak panelu, gdy w każdej są inni respondenci.
Gotowe dane w R: plik, próba analityczna i schemat
Trzy przepisy liczą wszystkie liczby z tekstu. Pierwszy tworzy fikcyjny plik w stylu dużego sondażu i zapisuje go w folderze nadrzędnym (../). Drugi przechodzi od pliku do próby analitycznej. Trzeci liczy tę samą analizę czterema sposobami. Ziarna nie wybierano pod wynik. Rysunki powstały w osobnym skrypcie. Dane do pobrania: sondaz-warunkow-zycia-2024-dane.csv (1577 osób; kody: 666 nie dotyczy, 777 odmowa, 888 nie wiem w godziny; 77 odmowa, 88 nie wiem w zadowolenie; plec: 1 kobieta; status: 1 pracuje). Dane nie odpowiadają żadnemu rzeczywistemu badaniu.
Fikcyjny plik sondażowy
R
# B492 – fikcyjny plik w stylu dużego sondażu: "Sondaż Warunków Życia 2024" (dane symulowane, nazwa zmyślona)
# Schemat: 6 warstw, po 20 PSU, po 22 adresy w PSU, jedna osoba 18+ w gospodarstwie, odmowy zależne od cech.
set.seed(4921)
osoby <- function(n) {                                   # populacja osób 18+ w gospodarstwach
  plec <- rbinom(n, 1, .52)                              # 1 = kobieta
  wiek <- sample(18:85, n, TRUE, prob = dnorm(18:85, 47, 20))
  data.frame(plec, wiek, n_doroslych = sample(1:4, n, TRUE, c(.28, .47, .17, .08)))
}
frakcja <- c(1, 1, 1.5, 1.5, 2.5, 2.5)                   # warstwy 5–6 losowano gęściej
n_psu <- 20; n_adr <- 22; K <- length(frakcja)
d <- osoby(K * n_psu * n_adr)
d$warstwa <- rep(seq_len(K), each = n_psu * n_adr)
d$psu <- (d$warstwa - 1) * n_psu + rep(rep(seq_len(n_psu), each = n_adr), K)
u_psu <- rnorm(K * n_psu, 0, .50)[d$psu]                 # zadowolenie: podobieństwo w obrębie PSU
h_psu <- rnorm(K * n_psu, 0, 3.0)[d$psu]                 # godziny pracy: podobieństwo w obrębie PSU
p3 <- plogis(-.6 + .9 * (d$warstwa <= 2) - .018 * (d$wiek - 45))
p2 <- .45
d$wyksztalcenie <- ifelse(runif(nrow(d)) < p3, 3L, ifelse(runif(nrow(d)) < p2, 2L, 1L))
# Status zatrudnienia: 1 pracuje, 2 bezrobotny, 3 emeryt/rencista, 4 uczy się, 5 inne
pr_prac <- with(d, ifelse(wiek < 25, .35, ifelse(wiek < 60, .86, ifelse(wiek < 65, .42, .05))))
ucz <- with(d, ifelse(wiek < 25, .55, 0)); eme <- with(d, ifelse(wiek >= 60, .90 - pr_prac + .05, .03))
los <- runif(nrow(d))
d$status <- with(d, ifelse(los < pr_prac, 1L, ifelse(los < pr_prac + ucz, 4L, ifelse(los < pr_prac + ucz + pmax(eme, 0), 3L,
                 ifelse(runif(nrow(d)) < .55, 2L, 5L)))))
pracuje <- d$status == 1
godz <- round(37 + 4.5 * (d$plec == 0) + .9 * (d$wyksztalcenie == 3) + h_psu + rnorm(nrow(d), 0, 8.5))
godz <- pmin(pmax(godz, 4), 80)
extrem <- which(pracuje)[sample(sum(pracuje), 5)]; godz[extrem] <- c(98, 112, 126, 140, 168)   # zapis niewiarygodny
zad_lat <- with(d, 6.1 + .40 * (wyksztalcenie == 2) + .85 * (wyksztalcenie == 3) + .25 * (n_doroslych >= 2) -
                 .018 * (wiek - 45) + u_psu + rnorm(nrow(d), 0, 1.75))
zad_lat <- zad_lat - .030 * ifelse(pracuje, pmin(godz, 84) - 40, 0)
d$zadowolenie <- pmin(pmax(round(zad_lat), 0), 10)
# Kody braków jak w książce kodowej: 666 nie dotyczy, 777 odmowa, 888 nie wiem; 77 odmowa, 88 nie wiem
d$godziny <- ifelse(pracuje, godz, 666L)
ita <- runif(nrow(d)); pr_b <- plogis(-3.2 + .025 * (d$wiek - 45) + .5 * (d$wyksztalcenie == 1))
d$godziny[pracuje & ita < pr_b] <- ifelse(runif(sum(pracuje & ita < pr_b)) < .55, 777L, 888L)
itb <- runif(nrow(d)); idx <- itb < .022
d$zadowolenie[idx] <- ifelse(runif(sum(idx)) < .6, 77L, 88L)
# Realizacja: odmowy częstsze u młodszych, mężczyzn i osób z niższym wykształceniem
pr_odp <- with(d, plogis(.15 + .022 * (pmin(wiek, 70) - 45) + .25 * plec + .35 * (wyksztalcenie == 3) + rnorm(nrow(d), 0, .15)))
d$zrealizowany <- rbinom(nrow(d), 1, pr_odp)
# Waga schematu i poststratyfikacja (rozkłady populacyjne fikcyjne: duża symulowana populacja)
d$waga_schematu <- d$n_doroslych / frakcja[d$warstwa]
pop <- osoby(5e5)
kat <- function(w) cut(w, c(17, 24, 34, 44, 54, 64, 90), labels = FALSE)
udz_pop <- prop.table(table(pop$plec, kat(pop$wiek)))
r <- d[d$zrealizowany == 1, ]
r$waga_schematu <- r$waga_schematu / mean(r$waga_schematu)
udz_pr <- prop.table(xtabs(r$waga_schematu ~ r$plec + kat(r$wiek)))
popr <- (udz_pop / udz_pr)[cbind(as.character(r$plec), as.character(kat(r$wiek)))]
r$waga_post <- as.numeric(r$waga_schematu * popr); r$waga_post <- r$waga_post / mean(r$waga_post)
r$id <- seq_len(nrow(r))
plik <- r[, c("id", "warstwa", "psu", "n_doroslych", "plec", "wiek", "wyksztalcenie", "status", "godziny", "zadowolenie", "waga_schematu", "waga_post")]
plik$waga_schematu <- round(plik$waga_schematu, 4); plik$waga_post <- round(plik$waga_post, 4)
write.csv(plik, "../sondaz-warunkow-zycia-2024-dane.csv", row.names = FALSE)

cat("Wylosowane adresy:", nrow(d), "\n")
cat("Wywiady zrealizowane:", nrow(plik), sprintf("(%.1f%%)\n", 100 * nrow(plik) / nrow(d)))
cat("Liczba PSU:", length(unique(plik$psu)), " Liczba warstw:", length(unique(plik$warstwa)), "\n")
cat("Waga po poststratyfikacji: min =", round(min(plik$waga_post), 2), " max =", round(max(plik$waga_post), 2),
    " Kish n_ef =", round(sum(plik$waga_post)^2 / sum(plik$waga_post^2)), "\n")
cat("Rekordy z kodem 666/777/888 w godzinach:", sum(plik$godziny >= 666), " Rekordy z kodem 77/88 w zadowoleniu:", sum(plik$zadowolenie >= 77), "\n")
Wynik w R
Wylosowane adresy: 2640
Wywiady zrealizowane: 1577 (59.7%)
Liczba PSU: 120  Liczba warstw: 6
Waga po poststratyfikacji: min = 0.22  max = 3.75  Kish n_ef = 1148
Rekordy z kodem 666/777/888 w godzinach: 660  Rekordy z kodem 77/88 w zadowoleniu: 33
Od pliku do próby analitycznej
R
# B492 – od pliku do próby analitycznej: kody braków, kolejne kryteria, porównanie osób z brakami
d <- read.csv("../sondaz-warunkow-zycia-2024-dane.csv")
# 1. Co się stanie, gdy kody braków zostaną w danych
cat(sprintf("Średnia godzin, wszyscy, kody potraktowane jak liczby: %.2f\n", mean(d$godziny)))
cat(sprintf("Średnia zadowolenia, kody potraktowane jak liczby: %.2f\n", mean(d$zadowolenie)))
# 2. Recoding według książki kodowej – trzy powody braku zachowane osobno
d$powod_godz <- ifelse(d$godziny == 666, "nie dotyczy", ifelse(d$godziny == 777, "odmowa", ifelse(d$godziny == 888, "nie wiem", "odpowiedź")))
d$godziny_c <- ifelse(d$godziny >= 666, NA, d$godziny)
d$zadow_c <- ifelse(d$zadowolenie >= 77, NA, d$zadowolenie)
cat(sprintf("Średnia zadowolenia po recodingu: %.2f (n = %d)\n", mean(d$zadow_c, na.rm = TRUE), sum(!is.na(d$zadow_c))))
# 3. Przepływ: warunki w kolejności zapisanej przed analizą
k1 <- d$wiek >= 25 & d$wiek <= 64
k2 <- k1 & d$status == 1
k3 <- k2 & !is.na(d$godziny_c)
k4 <- k3 & d$godziny_c >= 1 & d$godziny_c <= 84
k5 <- k4 & !is.na(d$zadow_c)
etapy <- c(plik = nrow(d), wiek_25_64 = sum(k1), pracujacy = sum(k2), znane_godziny = sum(k3), godziny_1_84 = sum(k4), znane_zadowolenie = sum(k5))
print(data.frame(n = etapy, ubylo = c(NA, -diff(etapy))))
cat("Brak godzin wśród pracujących 25-64:\n"); print(table(d$powod_godz[k2]))
d$analiza <- as.integer(k5)
# 4. Kto wypadł z powodu braków: pracujący 25-64, włączeni a utraceni z powodu braków (osoby z godzinami poza zakresem pominięte)
g <- k2 & !(k3 & !k4)
sred <- function(x, w) sum(x * w) / sum(w)
por <- function(j) with(d[g & (d$analiza == j), ], c(n = length(wiek), wiek_M = sred(wiek, waga_post), kobiety_pr = 100 * sred(plec, waga_post), wyzsze_pr = 100 * sred(wyksztalcenie == 3, waga_post)))
print(round(rbind(wlaczeni = por(1), utraceni = por(0)), 1))
cat(sprintf("Utraceni z powodu braków: %d z %d (%.1f%%)\n", sum(g & !d$analiza), sum(g), 100 * mean(!d$analiza[g])))
# 5. PSU i wagi w próbie analitycznej
cat("PSU z osobami w próbie analitycznej:", length(unique(d$psu[k5])), "z", length(unique(d$psu)), "\n")
w <- d$waga_post[k5]
cat(sprintf("Waga w próbie analitycznej: min = %.2f, max = %.2f, Kish n_ef = %.0f\n", min(w), max(w), sum(w)^2 / sum(w^2)))
Wynik w R
Średnia godzin, wszyscy, kody potraktowane jak liczby: 307.13
Średnia zadowolenia, kody potraktowane jak liczby: 8.13
Średnia zadowolenia po recodingu: 6.59 (n = 1544)
                     n ubylo
plik              1577    NA
wiek_25_64        1155   422
pracujacy          920   235
znane_godziny      874    46
godziny_1_84       872     2
znane_zadowolenie  853    19
Brak godzin wśród pracujących 25-64:

 nie wiem    odmowa odpowiedź
       27        19       874
           n wiek_M kobiety_pr wyzsze_pr
wlaczeni 853   43.8       51.5      49.3
utraceni  65   47.6       61.2      48.7
Utraceni z powodu braków: 65 z 918 (7.1%)
PSU z osobami w próbie analitycznej: 120 z 120
Waga w próbie analitycznej: min = 0.26, max = 3.75, Kish n_ef = 636
Analiza zgodna ze schematem
R
# B492 – cztery sposoby policzenia tej samej analizy; wersja D jest zgodna ze schematem
suppressPackageStartupMessages(library(survey))
d <- read.csv("../sondaz-warunkow-zycia-2024-dane.csv")
d$godziny_c <- ifelse(d$godziny >= 666, NA, d$godziny)
d$zadow_c <- ifelse(d$zadowolenie >= 77, NA, d$zadowolenie)
d$analiza <- with(d, wiek >= 25 & wiek <= 64 & status == 1 & !is.na(godziny_c) & godziny_c >= 1 & godziny_c <= 84 & !is.na(zadow_c))
d$godz10 <- (d$godziny_c - 40) / 10                 # o każde 10 godzin powyżej 40
d$wiek10 <- (d$wiek - 45) / 10
d$wyks <- factor(d$wyksztalcenie, labels = c("podst_zaw", "srednie", "wyzsze"))
a <- d[d$analiza, ]
wzor <- zadow_c ~ godz10 + wiek10 + plec + wyks
desB <- svydesign(ids = ~1, weights = ~waga_post, data = a)                                  # B: wagi bez warstw i PSU
desC <- svydesign(ids = ~psu, strata = ~warstwa, weights = ~waga_post, data = a, nest = TRUE) # C: schemat na usuniętych wierszach
des <- svydesign(ids = ~psu, strata = ~warstwa, weights = ~waga_post, data = d, nest = TRUE)  # D: schemat z całego pliku
desD <- subset(des, analiza)                                                                  # D: podpopulacja przez subset()
pas <- function(b, s, df) c(ocena = b, SE = s, dolna = b - qt(.975, df) * s, gorna = b + qt(.975, df) * s, df = df)
# Średnie zadowolenie
mA <- mean(a$zadow_c); sA <- sd(a$zadow_c) / sqrt(nrow(a))
sred <- function(ds) { e <- svymean(~zadow_c, ds); pas(coef(e), SE(e), degf(ds)) }
tab_srednia <- rbind(A_bez_wag = pas(mA, sA, nrow(a) - 1), B_wagi = sred(desB), C_usuniete_wiersze = sred(desC), D_subset = sred(desD))
cat("Średnie zadowolenie z życia (0-10):\n"); print(round(tab_srednia, 3))
cat(sprintf("Wariancja D względem A: %.2f; odpowiednik prostej próby: n = %.0f\n",
            (tab_srednia[4, 2] / sA)^2, nrow(a) / (tab_srednia[4, 2] / sA)^2))
# Regresja: zadowolenie a godziny pracy (na 10 godzin)
fit <- function(m, df) { b <- coef(m)["godz10"]; pas(b, sqrt(vcov(m)["godz10", "godz10"]), df) }
mlA <- lm(wzor, a); mB <- svyglm(wzor, desB); mC <- svyglm(wzor, desC); mD <- svyglm(wzor, desD)
tab_model <- rbind(A_bez_wag = fit(mlA, df.residual(mlA)), B_wagi = fit(mB, degf(desB)), C_usuniete_wiersze = fit(mC, degf(desC)), D_subset = fit(mD, degf(desD)))
cat("\nWspółczynnik przy godzinach pracy (na 10 godzin):\n"); print(round(tab_model, 3))
cat("\nModel D:\n"); print(round(summary(mD)$coefficients, 3))
cat(sprintf("n = %d; PSU = %d; warstwy = %d; df schematu = %d\n", nrow(a), length(unique(a$psu)), length(unique(a$warstwa)), degf(desD)))
e <- svymean(~godziny_c, desD); ci <- confint(e, df = degf(desD))
cat(sprintf("Godziny pracy (D): M = %.2f, SE = %.3f, 95%% CI [%.2f, %.2f]; bez wag M = %.2f\n", coef(e), SE(e), ci[1], ci[2], mean(a$godziny_c)))
# Wąska podpopulacja: czy skrót „usuń wiersze” działa tak samo?
a2 <- a[a$wiek >= 60, ]
desC2 <- svydesign(ids = ~psu, strata = ~warstwa, weights = ~waga_post, data = a2, nest = TRUE)
desD2 <- subset(des, analiza & wiek >= 60)
eC <- svymean(~zadow_c, desC2); eD <- svymean(~zadow_c, desD2)
cat(sprintf("\nWąska grupa 60-64 lata: n = %d, PSU z osobami = %d z %d\n", nrow(a2), length(unique(a2$psu)), length(unique(d$psu))))
cat(sprintf("Usunięte wiersze: M = %.2f, SE = %.3f\nsubset():         M = %.2f, SE = %.3f\n", coef(eC), SE(eC), coef(eD), SE(eD)))
Wynik w R
Średnie zadowolenie z życia (0-10):
                   ocena    SE dolna gorna  df
A_bez_wag          6.756 0.063 6.633 6.879 852
B_wagi             6.799 0.071 6.659 6.939 852
C_usuniete_wiersze 6.799 0.083 6.635 6.963 114
D_subset           6.799 0.083 6.635 6.963 114
Wariancja D względem A: 1.76; odpowiednik prostej próby: n = 486

Współczynnik przy godzinach pracy (na 10 godzin):
                   ocena.godz10    SE dolna.godz10 gorna.godz10  df
A_bez_wag                -0.415 0.067       -0.546       -0.284 847
B_wagi                   -0.414 0.071       -0.553       -0.275 852
C_usuniete_wiersze       -0.414 0.068       -0.550       -0.279 114
D_subset                 -0.414 0.068       -0.550       -0.279 114

Model D:
            Estimate Std. Error t value Pr(>|t|)
(Intercept)    6.452      0.157  40.967    0.000
godz10        -0.414      0.068  -6.062    0.000
wiek10        -0.076      0.066  -1.149    0.253
plec          -0.318      0.153  -2.078    0.040
wykssrednie    0.297      0.211   1.408    0.162
wykswyzsze     0.843      0.156   5.414    0.000
n = 853; PSU = 120; warstwy = 6; df schematu = 114
Godziny pracy (D): M = 39.78, SE = 0.481, 95% CI [38.83, 40.73]; bez wag M = 39.42

Wąska grupa 60-64 lata: n = 46, PSU z osobami = 39 z 120
Usunięte wiersze: M = 6.73, SE = 0.377
subset():         M = 6.73, SE = 0.363
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 i pakiecie survey; rysunki przygotowano w pakietach ggplot2 i svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- survey (wersja 4.5): Lumley, T. (2026). survey: Analysis of complex survey samples [R package]. https://CRAN.R-project.org/package=survey
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Przed oddaniem rozdziału sprawdź…
- Czy podano, kto, kiedy, jak i kogo badał, oraz numer edycji pliku i datę pobrania?
- Czy uzasadniono wybór fali i zapisano, co było wiadomo przed analizą?
- Czy książka kodowa posłużyła do zamiany kodów specjalnych i czy „nie dotyczy” oddzielono od braków?
- Czy jest diagram od pliku do próby analitycznej z powodami wyłączeń?
- Czy tabela zmiennych mówi, czego nie zmierzono?
- Czy użyto wag, warstw i PSU oraz wskazano podpopulację w obiekcie schematu?
- Czy porównano osoby włączone i utracone z powodu braków?
- Czy we wnioskach nazwy pojęć odpowiadają zmiennym, a populacja jest nazwana?
- Czy opisano warunki użycia i ustalenia dotyczące opinii komisji?
Jeśli chcesz, żeby ktoś sprawdził opis źródła, próbę analityczną i schemat w analizie, zobacz pomoc w analizie dla studentów.
Najczęstsze pytania
Czy praca magisterska może opierać się wyłącznie na gotowych danych?
Często tak, ale decydują wymagania uczelni i promotora, więc ustal to przed wyborem tematu. Smith i in. (2011) zaznaczają, że w analizie wtórnej obowiązują te same zasady co w badaniu pierwotnym: jasne pytanie, próba, miary i przemyślana analiza. Wartością pracy jest wtedy pytanie i rzetelny opis decyzji analitycznych.
Czy analiza gotowych danych wymaga zgody komisji bioetycznej?
To zależy od zasad uczelni, rodzaju danych i zakresu zgód uczestników. Nie zakładaj odpowiedzi z góry: zapytaj komisję albo promotora i zachowaj odpowiedź. W metodzie podaj numer opinii albo informację o jej niewymaganiu.
Czy muszę używać wag z sondażu w pracy dyplomowej?
Jeśli chcesz opisywać populację, zwykle tak, razem z warstwami i PSU, zgodnie z dokumentacją zbioru. W przykładzie wagi przesunęły średnią niewiele, ale uwzględnienie schematu zwiększyło błąd standardowy z 0.063 do 0.083. Wybór konkretnej wagi zależy od badania, a w modelach regresji warto uzasadnić go osobno.
Co napisać, gdy w gotowych danych nie ma zmiennej, którą chcę zbadać?
Nazwij zmienną, którą masz, i napisz, jakie pojęcie przybliża oraz czego nie obejmuje. Nie zamieniaj jej w tekście na szersze pojęcie, np. godzin pracy na przeciążenie. Jeśli rozbieżność jest duża, zmień pytanie albo źródło danych.
Czym różni się próba analityczna od próby badania?
Próba badania to osoby, od których dostawca uzyskał dane. Próba analityczna to część pliku, którą analizujesz po zastosowaniu kryteriów wieku, statusu i kompletności. W przykładzie z 1577 wywiadów zostały 853 osoby i każdy krok wyłączenia trzeba podać w metodzie.
Powiązane hasła
Przeczytaj też
Reanaliza i wtórna analiza cudzych danych
Licencje i warunki użycia, prerejestracja danych wtórnych, test GRIM, zgodność p i analiza wieloświatowa w R – z wzorami opisu i listu do autorów.
Czytaj →PoradnikAnaliza danych z ESS, PGSS i Diagnozy Społecznej
Dostęp i rejestracja, wagi dweight, pspwght i anweight, warstwy i klastry, błędy standardowe ze schematu i regresja w R z wzorem opisu.
Czytaj →PoradnikWażenie danych sondażowych krok po kroku
Wagi schematu, korekta braku odpowiedzi, raking w R, przycinanie wag, efektywna liczebność Kisha, błąd standardowy i wzór opisu.
Czytaj →PoradnikAnaliza dokumentacji medycznej – badanie retrospektywne
Pytanie, kryteria, karta zbierania danych, „brak wpisu” ≠ „nie”, kappa na podpróbie kart, braki, zgody, STROBE i RECORD – z przykładem w R.
Czytaj →PoradnikDiagram przepływu respondentów
Od 612 wejść w link do 413 analizowanych: etapy, kryteria wykluczeń i ich kolejność, odsetek odpowiedzi i diagram w R.
Czytaj →PoradnikSondaż przekrojowy – jak opisać metodę
Gotowy podrozdział „Metoda” dla ankiety w zdrowiu: STROBE, rekrutacja, odsetek odpowiedzi, braki danych, PR a OR i to, co wolno napisać we wnioskach – z przykładem w R.
Czytaj →PoradnikJak napisać pracę z socjologii
Pytanie o zjawisko, koncept–wymiar–wskaźnik, populacja i operat, próba z internetu, wagi, dane wtórne i gotowe fragmenty pracy – na przykładzie zaufania i aktywności sąsiedzkiej.
Czytaj →PoradnikEwaluacja programu w jednej placówce – opis metody
Gotowy podrozdział „Metoda”: autor jako prowadzący, wierność realizacji, grupa porównawcza i dozwolone wnioski, z kodem R.
Czytaj →Piszesz pracę na gotowych danych?
Sprawdzimy opis źródła, próbę analityczną i uwzględnienie schematu oraz policzymy analizę w R lub SPSS, tak żebyś umiał(a) samodzielnie obronić wyniki.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Benchimol, E. I., Smeeth, L., Guttmann, A., Harron, K., Moher, D., Petersen, I., Sørensen, H. T., von Elm, E., Langan, S. M., & RECORD Working Committee. (2015). The REporting of studies Conducted using Observational Routinely-collected health Data (RECORD) statement. PLOS Medicine, 12(10), Article e1001885. https://doi.org/10.1371/journal.pmed.1001885 ● Otwarty dostęp
- Hand, D. J. (2018). Statistical challenges of administrative and transaction data. Journal of the Royal Statistical Society Series A: Statistics in Society, 181(3), 555–605. https://doi.org/10.1111/rssa.12315 ● Otwarty dostęp: pełny tekst
- Lumley, T. (2004). Analysis of complex survey samples. Journal of Statistical Software, 9(8). https://doi.org/10.18637/jss.v009.i08 ● Otwarty dostęp
- Smith, A. K., Ayanian, J. Z., Covinsky, K. E., Landon, B. E., McCarthy, E. P., Wee, C. C., & Steinman, M. A. (2011). Conducting high-value secondary dataset analysis: An introductory guide and resources. Journal of General Internal Medicine, 26(8), 920–929. https://doi.org/10.1007/s11606-010-1621-5 ● Otwarty dostęp
- Sørensen, H. T., Sabroe, S., & Olsen, J. (1996). A framework for evaluation of secondary data sources for epidemiological research. International Journal of Epidemiology, 25(2), 435–442. https://doi.org/10.1093/ije/25.2.435
- Van den Akker, O. R., Weston, S., Campbell, L., Chopik, B., Damian, R., Davis-Kean, P., Hall, A., Kosie, J., Kruse, E., Olsen, J., Ritchie, S., Valentine, K. D., Van 't Veer, A., & Bakker, M. (2021). Preregistration of secondary data analysis: A template and tutorial. Meta-Psychology, 5. https://doi.org/10.15626/mp.2020.2625 ● Otwarty dostęp
- West, B. T., Berglund, P., & Heeringa, S. G. (2008). A closer examination of subpopulation analysis of complex-sample survey data. The Stata Journal, 8(4), 520–531. https://doi.org/10.1177/1536867x0800800404 ● Otwarty dostęp
- West, B. T., Sakshaug, J. W., & Aurelien, G. A. S. (2016). How big of a problem is analytic error in secondary analyses of survey data? PLOS ONE, 11(6), Article e0158120. https://doi.org/10.1371/journal.pone.0158120 ● Otwarty dostęp
- Weston, S. J., Ritchie, S. J., Rohrer, J. M., & Przybylski, A. K. (2019). Recommendations for increasing the transparency of analysis of preexisting data sets. Advances in Methods and Practices in Psychological Science, 2(3), 214–227. https://doi.org/10.1177/2515245919848684 ● Otwarty dostęp
Cytowania BibTeX
@article{benchimol2015reporting, author={Benchimol, Eric I. and Smeeth, Liam and Guttmann, Astrid and Harron, Katie and Moher, David and Petersen, Irene and Sørensen, Henrik T. and von Elm, Erik and Langan, Sinéad M. and {RECORD Working Committee}}, title={{The REporting of studies Conducted using Observational Routinely-collected health Data (RECORD) statement}}, journal={PLOS Medicine}, year={2015}, volume={12}, number={10}, eid={e1001885}, doi={10.1371/journal.pmed.1001885}}@article{hand2018statistical, author={Hand, David J.}, title={{Statistical challenges of administrative and transaction data}}, journal={Journal of the Royal Statistical Society Series A: Statistics in Society}, year={2018}, volume={181}, number={3}, pages={555--605}, doi={10.1111/rssa.12315}}@article{lumley2004analysis, author={Lumley, Thomas}, title={{Analysis of complex survey samples}}, journal={Journal of Statistical Software}, year={2004}, volume={9}, number={8}, doi={10.18637/jss.v009.i08}}@article{smith2011conducting, author={Smith, Alexander K. and Ayanian, John Z. and Covinsky, Kenneth E. and Landon, Bruce E. and McCarthy, Ellen P. and Wee, Christina C. and Steinman, Michael A.}, title={{Conducting high-value secondary dataset analysis: An introductory guide and resources}}, journal={Journal of General Internal Medicine}, year={2011}, volume={26}, number={8}, pages={920--929}, doi={10.1007/s11606-010-1621-5}}@article{sorensen1996framework, author={Sørensen, Henrik Toft and Sabroe, Svend and Olsen, Jørn}, title={{A framework for evaluation of secondary data sources for epidemiological research}}, journal={International Journal of Epidemiology}, year={1996}, volume={25}, number={2}, pages={435--442}, doi={10.1093/ije/25.2.435}}@article{vandenakker2021preregistration, author={Van den Akker, Olmo R. and Weston, Sara and Campbell, Lorne and Chopik, Bill and Damian, Rodica and Davis-Kean, Pamela and Hall, Andrew and Kosie, Jessica and Kruse, Elliott and Olsen, Jerome and Ritchie, Stuart and Valentine, KD and Van 't Veer, Anna and Bakker, Marjan}, title={{Preregistration of secondary data analysis: A template and tutorial}}, journal={Meta-Psychology}, year={2021}, volume={5}, doi={10.15626/mp.2020.2625}}@article{west2008closer, author={West, Brady T. and Berglund, Patricia and Heeringa, Steven G.}, title={{A closer examination of subpopulation analysis of complex-sample survey data}}, journal={The Stata Journal}, year={2008}, volume={8}, number={4}, pages={520--531}, doi={10.1177/1536867x0800800404}}@article{west2016how, author={West, Brady T. and Sakshaug, Joseph W. and Aurelien, Guy Alain S.}, title={{How big of a problem is analytic error in secondary analyses of survey data?}}, journal={PLOS ONE}, year={2016}, volume={11}, number={6}, eid={e0158120}, doi={10.1371/journal.pone.0158120}}@article{weston2019recommendations, author={Weston, Sara J. and Ritchie, Stuart J. and Rohrer, Julia M. and Przybylski, Andrew K.}, title={{Recommendations for increasing the transparency of analysis of preexisting data sets}}, journal={Advances in Methods and Practices in Psychological Science}, year={2019}, volume={2}, number={3}, pages={214--227}, doi={10.1177/2515245919848684}}