Co to jest operat losowania?
Operat losowania (ang. sampling frame) to lista lub inny mechanizm, który pozwala wskazać każdą jednostkę populacji i z niej losować: rejestr mieszkańców, wykaz adresów, lista studentów z dziekanatu, kartoteka pacjentów poradni, spis szkół. Bez operatu nie da się przeprowadzić losowania próby, bo nie wiadomo, z czego losować i jakie prawdopodobieństwo wyboru ma każda osoba.
Typowe problemy z operatem
- Niedopokrycie. Części populacji nie ma na liście, np. studentów urlopowanych albo osób bez stałego adresu.
- Nadpokrycie. Na liście są jednostki spoza populacji, np. absolwenci albo osoby zmarłe.
- Duplikaty. Osoba zapisana dwa razy ma dwa razy większą szansę wyboru, więc prawdopodobieństwa przestają być równe.
- Jednostka listy inna niż jednostka badania. Wykaz adresów pozwala wylosować mieszkanie, a nie osobę; trzeba dodać drugi krok wyboru w gospodarstwie.
Groves i Lyberg (2010) zaliczają błąd pokrycia do składników całkowitego błędu badania sondażowego, obok błędu losowania i braku odpowiedzi. Amaya i in. (2021) pokazali, że niedopokrycie obciąża wyniki tylko wtedy, gdy pominięte osoby różnią się od ujętych. Dla jednych zmiennych ryzyko było małe, dla innych duże niemal przy każdym poziomie pokrycia i nie dało się go przewidzieć z góry.
Przykład
Badasz wypalenie nauczycieli w powiecie. Lista z kuratorium obejmuje szkoły publiczne, ale nie niepubliczne. Losowanie z niej daje próbę reprezentatywną dla nauczycieli szkół publicznych, a nie dla wszystkich nauczycieli. Kölln i in. (2019) dodają, że jakość operatu wpływa też na realizację: operaty z nazwiskami poprawiały odsetek odpowiedzi i współpracy o 2.5–6 punktów procentowych.
Operat wyznacza górną granicę reprezentatywności próby. Gdy go brak, pozostaje dobór nielosowy, np. dobór wygodny lub kula śnieżna, opisany uczciwie jako taki.
Na rysunku
Rysunek łączy liczby z przykładu (lista 1240 wpisów, 18 duplikatów, 23 osoby spoza populacji) z jedną liczbą przyjętą ręcznie tylko na potrzeby rysunku: 180 nauczycieli szkół niepublicznych, których lista nie obejmuje. Panel B powstał ze wzoru, bez losowania.
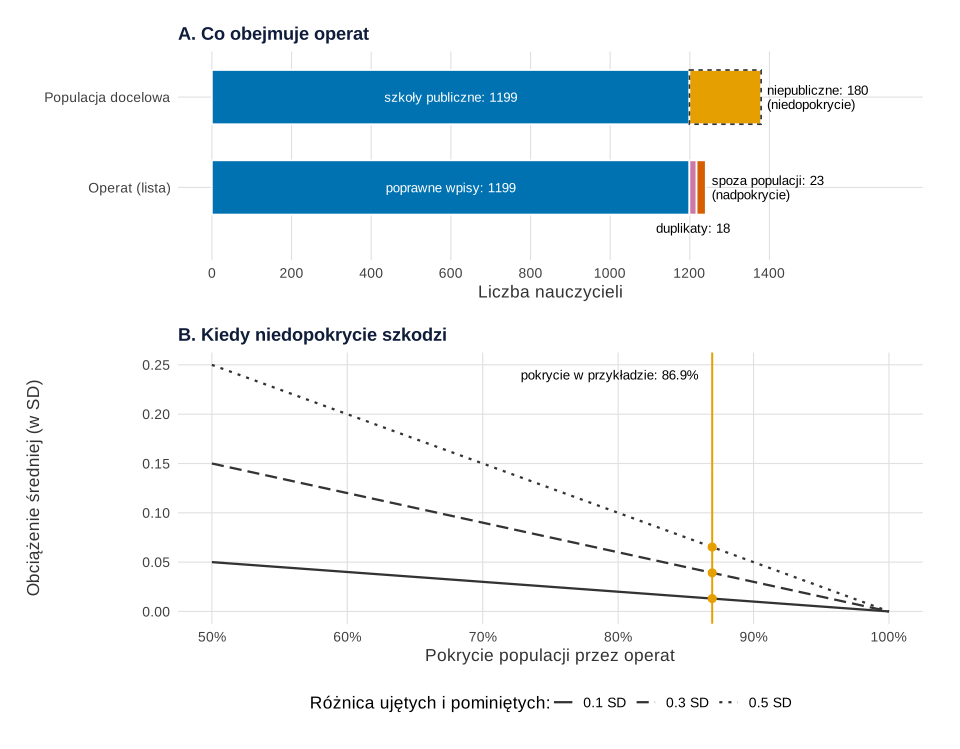
Co widać. W panelu A górny pasek to populacja docelowa, dolny – operat. Wspólna część to 1199 nauczycieli szkół publicznych. Na prawym końcu widać trzy problemy listy: niedopokrycie (180 osób poza listą), duplikaty (18) i nadpokrycie (23 osoby spoza populacji). Pokrycie populacji wynosi 86.9%. Panel B pokazuje, ile kosztuje niedopokrycie. Obciążenie średniej z operatu to (1 − pokrycie) × (średnia ujętych − średnia pominiętych). Przy pokryciu 86.9% wynosi 0.013 SD, gdy pominięci różnią się od ujętych o 0.1 SD, i 0.065 SD przy różnicy 0.5 SD. To ten sam wniosek co u Amayi i in. (2021): z samego odsetka pokrycia nie da się odczytać, czy wynik jest obciążony.
Na co uważać. Różnicy między ujętymi a pominiętymi zwykle nie znasz, bo pominiętych nie badasz. Wzór opisuje obciążenie średniej z całego operatu; w próbie dochodzą błąd losowania i brak odpowiedzi. Duplikaty i nadpokrycie nie zmieniają tego wzoru, ale zmieniają prawdopodobieństwa wyboru – usuń je przed losowaniem albo uwzględnij w wagach. Jak niedopokrycie i odmowy wyglądają na mapie całej populacji, pokazuje wpis próba reprezentatywna w obrazkach, a jak różne schematy losują z jednej listy – schematy losowania w obrazkach.
Podpis do pracy:
Kod rysunku jest samowystarczalny. Rysunek na stronie powstał z tego samego kodu, w którym podmieniono tylko motyw (krój czcionki, siatka).
Kod R rysunku 1
# Rysunek 1. Populacja docelowa a operat (A) i błąd pokrycia w funkcji odsetka pokrycia (B)
library(ggplot2)
library(patchwork)

kol <- c(ok = "#0072B2", nie = "#E69F00", nad = "#D55E00", dup = "#CC79A7")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        plot.title = element_text(face = "bold", size = rel(0.95)))

# Liczby z przykładu w haśle: lista z kuratorium 1240 wpisów, 18 duplikatów, 23 osoby spoza populacji.
# Liczbę nauczycieli szkół niepublicznych (180) przyjęto ręcznie, tylko na potrzeby rysunku.
lista <- 1240; duplikaty <- 18; spoza <- 23; niepubliczne <- 180
w_obu <- lista - duplikaty - spoza                 # nauczyciele i w populacji, i w operacie
docelowa <- w_obu + niepubliczne
pokrycie <- w_obu / docelowa
round(c(w_obu = w_obu, docelowa = docelowa, pokrycie = pokrycie), 3)

# A: dwa paski o długości proporcjonalnej do liczby osób; wspólna część jest wyrównana
seg <- data.frame(
  wiersz = c("Populacja docelowa", "Populacja docelowa", "Operat (lista)", "Operat (lista)", "Operat (lista)"),
  od  = c(0, w_obu, 0, w_obu, w_obu + duplikaty),
  do  = c(w_obu, docelowa, w_obu, w_obu + duplikaty, lista),
  typ = c("ok", "nie", "ok", "dup", "nad"))
seg$y <- ifelse(seg$wiersz == "Populacja docelowa", 2, 1)
etyk <- data.frame(
  x = c(w_obu / 2, w_obu / 2, docelowa + 15, w_obu + 9, lista + 15),
  y = c(2, 1, 2, 0.55, 1),
  hjust = c(0.5, 0.5, 0, 0.5, 0),
  kolor = c("white", "white", "black", "black", "black"),
  tekst = c(paste("szkoły publiczne:", w_obu), paste("poprawne wpisy:", w_obu),
            paste0("niepubliczne: ", niepubliczne, "\n(niedopokrycie)"),
            paste0("duplikaty: ", duplikaty),
            paste0("spoza populacji: ", spoza, "\n(nadpokrycie)")))
pA <- ggplot(seg) +
  geom_rect(aes(xmin = od, xmax = do, ymin = y - 0.3, ymax = y + 0.3, fill = typ),
            colour = "white", linewidth = 0.6) +
  geom_rect(data = seg[seg$typ == "nie", ], aes(xmin = od, xmax = do, ymin = y - 0.3, ymax = y + 0.3),
            fill = NA, colour = "grey20", linetype = "22") +
  geom_text(data = etyk, aes(x, y, label = tekst, hjust = hjust, colour = kolor), size = 3.5, lineheight = 0.9) +
  scale_colour_identity() +
  scale_fill_manual(values = kol, guide = "none") +
  scale_y_continuous(NULL, breaks = 1:2, labels = c("Operat (lista)", "Populacja docelowa"), limits = c(0.3, 2.4)) +
  scale_x_continuous("Liczba nauczycieli", limits = c(0, 1700), breaks = seq(0, 1400, 200)) +
  labs(title = "A. Co obejmuje operat") + motyw

# B: obciążenie średniej z operatu = (1 − pokrycie) × (średnia ujętych − średnia pominiętych)
siatka <- expand.grid(c = seq(0.5, 1, by = 0.01), roznica = c(0.1, 0.3, 0.5))
siatka$obciazenie <- (1 - siatka$c) * siatka$roznica
siatka$roznica <- factor(siatka$roznica, labels = c("0.1 SD", "0.3 SD", "0.5 SD"))
przyklad <- data.frame(c = pokrycie, roznica = levels(siatka$roznica), obciazenie = (1 - pokrycie) * c(0.1, 0.3, 0.5))
round(setNames(przyklad$obciazenie, przyklad$roznica), 3)
pB <- ggplot(siatka, aes(c, obciazenie, linetype = roznica)) +
  geom_line(linewidth = 0.8, colour = "grey20") +
  geom_vline(xintercept = pokrycie, colour = kol[["nie"]], linewidth = 0.7) +
  geom_point(data = przyklad, size = 2.4, colour = kol[["nie"]]) +
  annotate("text", x = pokrycie - 0.01, y = 0.24, hjust = 1, size = 3.5,
           label = paste0("pokrycie w przykładzie: ", round(100 * pokrycie, 1), "%")) +
  scale_linetype_manual("Różnica ujętych i pominiętych:", values = c("solid", "42", "12")) +
  scale_x_continuous("Pokrycie populacji przez operat", labels = function(x) paste0(100 * x, "%")) +
  scale_y_continuous("Obciążenie średniej (w SD)") +
  labs(title = "B. Kiedy niedopokrycie szkodzi") + motyw
p1 <- pA / pB + plot_layout(heights = c(1, 1.3))
p1
Wynik w R
   w_obu docelowa pokrycie
1199.000 1379.000    0.869
0.1 SD 0.3 SD 0.5 SD
 0.013  0.039  0.065
Jak opisać w pracy
Na co uważać
- Nie nazywaj populacją tego, czego nie obejmuje operat. Populację docelową i populację operatu opisz osobno.
- Usuń duplikaty przed losowaniem, a jeśli zostaną, uwzględnij je w wagach.
- Gdy operat jest już gotowy, przejdź do schematu: doboru losowego prostego, systematycznego albo wielostopniowego. Praktyczne wskazówki zawiera wpis dobór próby w pracy dyplomowej.
Bibliografia oprogramowania
Rysunek pochodzi z uruchomienia pokazanego kodu w R 4.5.3 (pakiety ggplot2 4.0.2 i patchwork 1.3.2). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Czym różni się populacja docelowa od populacji operatu?
Populacja docelowa to ci, o których chcesz wnioskować, np. wszyscy nauczyciele w powiecie. Populacja operatu to ci, którzy są na liście, np. tylko nauczyciele szkół publicznych. Losowanie daje próbę reprezentatywną dla operatu, a różnica między nimi to błąd pokrycia.
Czy lista uczestników grupy na Facebooku może być operatem losowania?
Formalnie tak, ale tylko dla tej grupy. Losując z niej, wnioskujesz o jej członkach, a nie o wszystkich studentach czy rodzicach. Członkowie grup internetowych zwykle różnią się od reszty populacji, więc szerszego uogólnienia nie uzasadnia samo losowanie.
Co zrobić z duplikatami w operacie losowania?
Najlepiej usunąć je przed losowaniem, np. po numerze albumu lub adresie e-mail. Jeśli zostaną, osoba zapisana dwa razy ma dwukrotnie większą szansę wyboru, co trzeba wyrównać wagą równą odwrotności liczby jej wpisów.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Dobór próby w pracy dyplomowej
Metody losowe i nielosowe, co wolno wnioskować z próby wygodnej, symulacja w R, kryteria włączenia i gotowy opis doboru do rozdziału metodologicznego.
Czytaj →PoradnikCałkowity błąd badania sondażowego (TSE)
Pokrycie, brak odpowiedzi, pomiar i ważenie w jednym rachunku MSE: symulacja czterech planów za ten sam budżet i opis ograniczeń.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Amaya, A., Zimmer, S., Morton, K., & Harter, R. (2021). Does undercoverage on the U.S. address-based sampling frame translate to coverage bias? Sociological Methods & Research, 50(2), 812–836. https://doi.org/10.1177/0049124118782539
- Groves, R. M., & Lyberg, L. (2010). Total survey error: Past, present, and future. Public Opinion Quarterly, 74(5), 849–879. https://doi.org/10.1093/poq/nfq065
- Kölln, A.-K., Ongena, Y. P., & Aarts, K. (2019). The effects of sampling frame designs on nonresponse and coverage error: Evidence from the Netherlands. Journal of Survey Statistics and Methodology, 7(3), 422–439. https://doi.org/10.1093/jssam/smy016 ● Otwarty dostęp
Cytowania BibTeX
@article{amaya2021does, author={Amaya, Ashley and Zimmer, Stephanie and Morton, Katherine and Harter, Rachel}, title={{Does undercoverage on the U.S. address-based sampling frame translate to coverage bias?}}, journal={Sociological Methods \& Research}, year={2021}, volume={50}, number={2}, pages={812--836}, doi={10.1177/0049124118782539}}@article{groves2010total, author={Groves, Robert M. and Lyberg, Lars}, title={{Total survey error: Past, present, and future}}, journal={Public Opinion Quarterly}, year={2010}, volume={74}, number={5}, pages={849--879}, doi={10.1093/poq/nfq065}}@article{kolln2019effects, author={Kölln, Ann-Kristin and Ongena, Yfke P. and Aarts, Kees}, title={{The effects of sampling frame designs on nonresponse and coverage error: Evidence from the Netherlands}}, journal={Journal of Survey Statistics and Methodology}, year={2019}, volume={7}, number={3}, pages={422--439}, doi={10.1093/jssam/smy016}}