Co to jest dobór losowy prosty?
Dobór losowy prosty (prosta próba losowa, ang. simple random sampling, SRS) to losowanie n jednostek z operatu liczącego N jednostek tak, że każdy możliwy zestaw n osób ma tę samą szansę zostać próbą. Każda osoba ma wtedy prawdopodobieństwo wyboru n/N. Zwykle losuje się bez zwracania: ta sama osoba nie trafia do próby dwa razy. Berndt (2020) zalicza ten schemat do podstawowych technik probabilistycznych, obok doboru systematycznego, warstwowego i zespołowego.
Prosty dobór losowy jest punktem odniesienia dla innych schematów. Efekt schematu to właśnie stosunek wariancji w danym schemacie do wariancji w prostej próbie losowej tej samej liczebności. Elliott i Valliant (2017) przypominają, że przy losowaniu wnioskowanie wynika z samego mechanizmu wyboru, a nie z założeń o populacji.
Błąd standardowy i poprawka na skończoną populację
Dla odsetka p z próby błąd standardowy wynosi SE = √[p(1 − p)/(n − 1) × (1 − n/N)]. Czynnik 1 − n/N to poprawka na skończoną populację: gdy próba obejmuje dużą część populacji, niepewność maleje. Gdy próba to niewielki ułamek populacji, np. 400 osób z całego kraju, poprawka jest bliska 1 i można ją pominąć.
Przykład w R
Operat to lista 800 uczniów szkoły, a badana cecha to doświadczenie cyberprzemocy (w populacji 21.9%). Funkcja sample() wylosowała 200 uczniów, wśród których odsetek wyniósł 22.5%. Poprawka wynosi 1 − 200/800 = 0.75, więc SE = 0.026 zamiast 0.030 bez poprawki, a 95% przedział ufności to [17.5%; 27.5%]. W 5000 powtórzeniach średnia oszacowań wyniosła 21.9%, a empiryczny błąd standardowy 0.026, zgodnie ze wzorem.
Na rysunku
Rysunek korzysta z tego samego operatu co przykład (800 uczniów, set.seed(5141), odsetek w populacji 21.9%) i losuje z niego po 5000 prób o liczebności 50, 200 i 400.
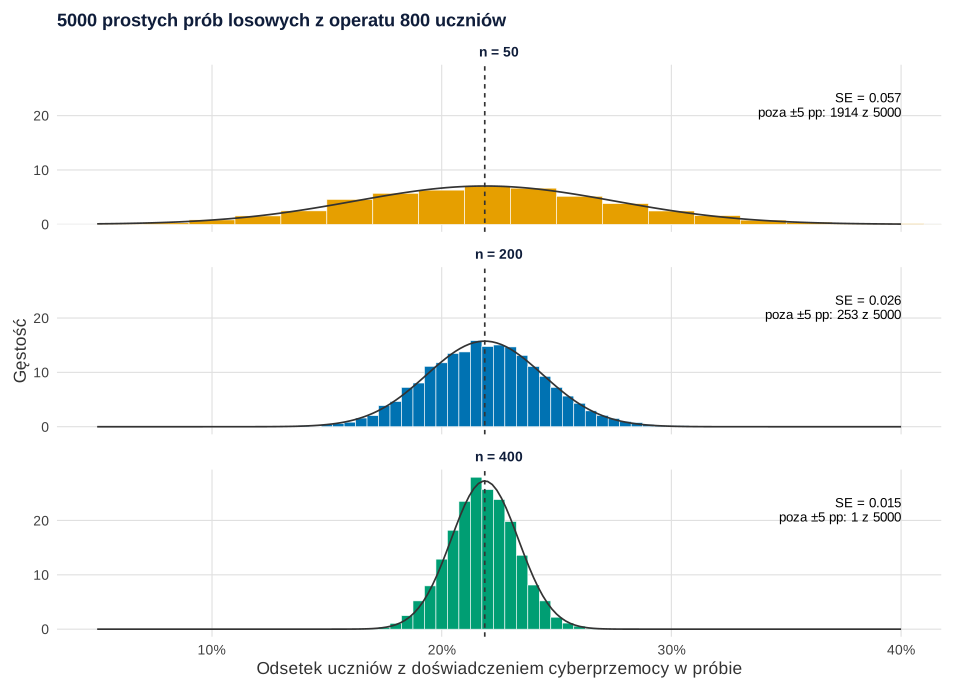
set.seed(5141)).Co widać. Każdy histogram to rozkład odsetka z 5000 prób jednej liczebności. Czarna krzywa to rozkład normalny z błędem standardowym liczonym z poprawką na skończoną populację. Wszystkie trzy rozkłady są wyśrodkowane na prawdziwym odsetku (średnie 22.0%, 21.9% i 21.9%), bo dobór losowy prosty nie jest obciążony. Zmienia się tylko rozrzut: SE wynosi 0.057, 0.026 i 0.015. Przy n = 50 aż 1914 z 5000 prób minęło się z prawdą o więcej niż 5 punktów procentowych, przy n = 200 – 253, a przy n = 400 – jedna. Przejście z 200 do 400 osób zmniejszyło SE bardziej niż √2 razy, bo 400 osób to połowa operatu: wzór bez poprawki dałby 0.021, z poprawką 0.015, tyle samo co symulacja.
Na co uważać. Rysunek pokazuje wyłącznie błąd losowania. Nie widać na nim braków odpowiedzi ani błędów operatu, które w prawdziwym badaniu przesuwają cały rozkład, a nie tylko go poszerzają. W jednym badaniu masz jeden punkt z takiego histogramu, a nie cały rozkład; jego szerokość szacujesz z próby. O marginesie błędu w sondażach piszemy we wpisie sondaż w obrazkach, a o tym, kiedy wielkość populacji ma znaczenie – we wpisie wielkość próby a wielkość populacji w obrazkach.
Podpis do pracy:
Kod rysunku jest samowystarczalny. Rysunek na stronie powstał z tego samego kodu, w którym podmieniono tylko motyw (krój czcionki, siatka).
Kod R rysunku 1
# Rysunek 1. Rozkład odsetka z 5000 prostych prób losowych o różnej liczebności z operatu 800 uczniów
library(ggplot2)

kol <- c("n = 50" = "#E69F00", "n = 200" = "#0072B2", "n = 400" = "#009E73")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        plot.title = element_text(face = "bold", size = rel(0.95)))

set.seed(5141)                                   # ten sam operat co w przykładzie w haśle
N <- 800
operat <- data.frame(id = 1:N, cyber = rbinom(N, 1, 0.22))
P <- mean(operat$cyber)
ns <- c(50, 200, 400)
# 5000 prób bez zwracania dla każdej liczebności
wyniki <- do.call(rbind, lapply(ns, function(n)
  data.frame(n = n, p = replicate(5000, mean(operat$cyber[sample(N, n)])))))
# błąd standardowy: empiryczny, ze wzoru z poprawką na skończoną populację i bez niej
tab <- t(sapply(ns, function(n) {
  p_n <- wyniki$p[wyniki$n == n]
  c(n = n, srednia_p = mean(p_n), SE_empiryczny = sd(p_n),
    SE_z_fpc = sqrt(P * (1 - P) / n * (N - n) / (N - 1)), SE_bez_fpc = sqrt(P * (1 - P) / n),
    poza_5pp = sum(abs(p_n - P) > 0.05))
}))
round(tab, 3)

wyniki$n <- factor(paste("n =", wyniki$n), levels = names(kol))
krzywe <- do.call(rbind, lapply(ns, function(n) {
  x <- seq(0.05, 0.40, by = 0.002)
  data.frame(n = paste("n =", n), x = x, gestosc = dnorm(x, P, sqrt(P * (1 - P) / n * (N - n) / (N - 1))))
}))
krzywe$n <- factor(krzywe$n, levels = names(kol))
opis <- data.frame(n = factor(names(kol), levels = names(kol)),
                   tekst = sprintf("SE = %.3f\npoza ±5 pp: %d z 5000", tab[, "SE_empiryczny"], tab[, "poza_5pp"]))
# szerokość słupka = krok, o jaki może zmienić się odsetek (1/50; przy n = 200 i 400 – 0.005)
p1 <- ggplot(wyniki, aes(p)) +
  geom_histogram(data = subset(wyniki, n == "n = 50"), aes(y = after_stat(density), fill = n),
                 binwidth = 0.02, boundary = 0.01, colour = "white", linewidth = 0.2) +
  geom_histogram(data = subset(wyniki, n != "n = 50"), aes(y = after_stat(density), fill = n),
                 binwidth = 0.005, boundary = 0.0025, colour = "white", linewidth = 0.2) +
  geom_line(data = krzywe, aes(x, gestosc), colour = "grey20", linewidth = 0.6) +
  geom_vline(xintercept = P, linetype = "22", colour = "grey20") +
  geom_text(data = opis, aes(x = 0.40, y = 22, label = tekst), hjust = 1, size = 3.5, lineheight = 0.9) +
  facet_wrap(~ n, ncol = 1) +
  scale_fill_manual(values = kol, guide = "none") +
  scale_x_continuous("Odsetek uczniów z doświadczeniem cyberprzemocy w próbie",
                     labels = function(x) paste0(100 * x, "%")) +
  coord_cartesian(xlim = c(0.05, 0.40)) +
  scale_y_continuous("Gęstość") +
  labs(title = "5000 prostych prób losowych z operatu 800 uczniów") + motyw
p1
Wynik w R
       n srednia_p SE_empiryczny SE_z_fpc SE_bez_fpc poza_5pp
[1,]  50     0.220         0.057    0.057      0.058     1914
[2,] 200     0.219         0.026    0.025      0.029      253
[3,] 400     0.219         0.015    0.015      0.021        1
Jak opisać w pracy
Na co uważać
- Losowy dobór to nie losowy przydział. Dobór decyduje, kogo badasz; randomizacja – do której grupy trafia już zbadana osoba.
- „Losowo” to nie „przypadkowo”. Zaczepianie przechodniów czy ankieta w mediach społecznościowych nie jest doborem losowym prostym, bo prawdopodobieństwa wyboru są nieznane.
- Brak odpowiedzi. Próba zrealizowana jest losowa tylko wtedy, gdy odmowy nie zależą od badanej cechy. Podaj odsetek realizacji.
Dobór losowy prosty w R
Kod tworzy operat 800 uczniów, losuje prostą próbę 200 osób, liczy odsetek, błąd standardowy z poprawką na skończoną populację i bez niej, przedział ufności oraz porównuje wzór z empirycznym błędem standardowym z 5000 powtórzeń.
Losowanie, błąd standardowy i poprawka
R
# Operat: lista 800 uczniów jednej szkoły; cecha: doświadczenie cyberprzemocy (0/1)
set.seed(5141)
N <- 800
operat <- data.frame(id = 1:N, cyber = rbinom(N, 1, 0.22))
P <- mean(operat$cyber)                          # prawdziwy odsetek w populacji
n <- 200
proba <- operat[sample(N, n), ]                  # losowanie bez zwracania
p <- mean(proba$cyber)
fpc <- 1 - n / N                                 # poprawka na skończoną populację
se <- sqrt(p * (1 - p) / (n - 1) * fpc)
round(c(P = P, p = p, fpc = fpc, SE = se, SE_bez_fpc = sqrt(p * (1 - p) / (n - 1))), 3)
round(p + c(-1, 1) * qnorm(.975) * se, 3)        # 95% przedział ufności
# 5000 powtórzeń: empiryczny błąd standardowy a wzór
p_rep <- replicate(5000, mean(operat$cyber[sample(N, n)]))
round(c(srednia_p = mean(p_rep), SE_empiryczny = sd(p_rep),
        SE_wzor = sqrt(P * (1 - P) / n * (N - n) / (N - 1))), 3)
Wynik w R
         P          p        fpc         SE SE_bez_fpc
     0.219      0.225      0.750      0.026      0.030
[1] 0.175 0.275
    srednia_p SE_empiryczny       SE_wzor
        0.219         0.026         0.025
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (przykład bez dodatkowych pakietów; rysunek: ggplot2 4.0.2). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze pytania
Losowanie ze zwracaniem czy bez zwracania?
W badaniach ankietowych losuje się bez zwracania, żeby ta sama osoba nie trafiła do próby dwa razy; w R to domyślne działanie sample(N, n). Losowanie ze zwracaniem (replace = TRUE) daje nieco większy błąd standardowy i stosuje się je głównie w symulacjach, np. w bootstrapie.
Kiedy stosować poprawkę na skończoną populację?
Gdy próba obejmuje wyraźną część populacji, np. 200 z 800 uczniów szkoły. Wtedy mnożysz wariancję przez 1 − n/N, tutaj 0.75, i błąd standardowy maleje z 0.030 do 0.026. Gdy próba to niewielki ułamek populacji, poprawka jest bliska 1.
Czy dobór losowy prosty zawsze jest najlepszy?
Nie. Jest najprostszy i stanowi punkt odniesienia, ale losowanie warstwowe bywa precyzyjniejsze przy tej samej liczebności, a dobór systematyczny lub wielostopniowy – tańszy w realizacji. Wybór zależy od dostępnego operatu i kosztu dotarcia do osób.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Schematy losowania w obrazkach
Sześć schematów losowania na mapach jednej populacji, 1000 symulowanych badań, efekt schematu i efektywna liczebność – pięć rysunków z kodem R.
Czytaj →PoradnikKalkulator przedziału ufności z poprawką na skończoną populację
Odsetek i średnia z populacji o znanej wielkości: przedział bez poprawki i z poprawką FPC, przedział dokładny, odsetek odpowiedzi i potrzebna liczebność.
Czytaj →PoradnikAnkieta wśród personelu jednego szpitala
Populacja czy próba, odsetek odpowiedzi w oddziałach, poprawka na skończoną populację w przedziale ufności, liczebność przy małej kadrze i anonimowość małych oddziałów – z przykładem w R.
Czytaj →PoradnikDobór próby w pracy dyplomowej
Metody losowe i nielosowe, co wolno wnioskować z próby wygodnej, symulacja w R, kryteria włączenia i gotowy opis doboru do rozdziału metodologicznego.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Berndt, A. E. (2020). Sampling methods. Journal of Human Lactation, 36(2), 224–226. https://doi.org/10.1177/0890334420906850
- Elliott, M. R., & Valliant, R. (2017). Inference for nonprobability samples. Statistical Science, 32(2), 249–264. https://doi.org/10.1214/16-sts598 ● Otwarty dostęp
Cytowania BibTeX
@article{berndt2020sampling, author={Berndt, Andrea E.}, title={{Sampling methods}}, journal={Journal of Human Lactation}, year={2020}, volume={36}, number={2}, pages={224--226}, doi={10.1177/0890334420906850}}@article{elliott2017inference, author={Elliott, Michael R. and Valliant, Richard}, title={{Inference for nonprobability samples}}, journal={Statistical Science}, year={2017}, volume={32}, number={2}, pages={249--264}, doi={10.1214/16-sts598}}