Dobór próby: kogo zbadasz i co z tego wynika
Dobór próby to sposób, w jaki konkretne osoby trafiają do Twojego badania. Ta decyzja zapada przed zebraniem danych, ale ustala granice wszystkich wniosków. Od niej zależy, czy wynik możesz odnieść do całej populacji, do jej części, czy tylko do osób, które akurat odpowiedziały.
Zanim wybierzesz metodę, nazwij trzy rzeczy:
- populację docelową – o kim chcesz wnioskować, np. studenci studiów stacjonarnych w Polsce;
- populację dostępną – do kogo realnie dotrzesz, np. studenci dwóch wydziałów Twojej uczelni;
- mechanizm doboru – kto decyduje o udziale: losowanie z listy, Ty według kryteriów czy sami respondenci, którzy klikają w link.
Im większa odległość między populacją docelową a próbą, tym ostrożniej trzeba pisać o trafności zewnętrznej. Ten wpis zbiera metody doboru w jednym miejscu, pokazuje symulacją, co dobór wygodny psuje, a czego nie, i daje wzór opisu do rozdziału metodologicznego. Szczegóły poszczególnych metod znajdziesz w hasłach słownika, do których linkujemy.
Metody doboru: losowe i nielosowe
Metody dzielą się na dwie rodziny. W doborze losowym (probabilistycznym) każda osoba z operatu, czyli listy populacji, ma znane i niezerowe prawdopodobieństwo wyboru. W doborze nielosowym tego prawdopodobieństwa nie znamy, bo o udziale decyduje dostępność, ocena badacza albo chęć respondenta. Berndt (2020) zestawia oba typy technik wraz z ich zaletami i wadami. Proponuje też pytania, które pomagają wybrać metodę do konkretnego badania.
| Metoda | Na czym polega | Kiedy w pracy dyplomowej |
|---|---|---|
| Losowy prosty | losujesz n osób z pełnej listy; każda ma tę samą szansę | gdy masz listę, np. pracowników firmy albo uczniów szkoły, i zgodę na jej użycie |
| Losowy warstwowy | dzielisz listę na warstwy (np. wydziały) i losujesz w każdej | gdy warstwy różnią się badaną cechą albo chcesz mieć pewną liczebność w każdej |
| Losowy zespołowy | losujesz całe grupy (klasy, oddziały, grupy dziekańskie) i badasz wszystkich w nich | gdy łatwiej dotrzeć do grup niż do osób; wymaga uwzględnienia efektu schematu |
| Wygodny | badasz osoby łatwo dostępne, np. z grup w mediach społecznościowych | najczęstszy w pracach dyplomowych; wymaga ostrożnych wniosków |
| Celowy | wybierasz osoby według kryteriów ważnych dla pytania badawczego | badania jakościowe i grupy specyficzne, np. nauczyciele ze stażem powyżej 10 lat |
| Kwotowy | ustalasz liczby osób w kategoriach (np. płeć × wiek) i zapełniasz je dowolnie | gdy znasz strukturę populacji i chcesz ją odtworzyć w próbie |
| Kula śnieżna | uczestnicy polecają kolejne osoby z tej samej grupy | grupy trudno dostępne, bez listy i bez ogłoszeń, np. opiekunowie osób z rzadką chorobą |
Schematy losowe, różnice w precyzji między losowaniem prostym, warstwowym i zespołowym oraz opis losowania omawia hasło próba losowa. Trzy najczęstsze odmiany doboru nielosowego opisuje hasło dobór celowy, wygodny i kula śnieżna, a kwoty – hasło próba kwotowa. W badaniu jakościowym dobór zwykle jest celowy, a jego odmianą jest dobór teoretyczny. Palinkas i in. (2015) wskazują, że w badaniach jakościowych najczęściej stosuje się dobór celowy według kryterium. Ile osób zaprosić do wywiadów, wyjaśnia wpis o nasyceniu próby jakościowej.
W praktyce prac dyplomowych dominuje dobór wygodny, często łączony z kryteriami (wygodny z kryteriami włączenia) albo z kulą śnieżną. To nie jest błąd, o ile nazwiesz go uczciwie. Kanały rekrutacji i ich ograniczenia opisuje poradnik gdzie znaleźć respondentów do ankiety.
Co wolno, a czego nie wolno wnioskować przy doborze nielosowym
Andrade (2021) przypomina, że wyniki z prób wygodnych i celowych można uogólniać tylko na (sub)populację, z której pobrano próbę. Grupa zadaniowa AAPOR dodaje, że wnioskowanie z próby nielosowej zawsze opiera się na założeniach modelu, które trzeba jawnie opisać (Baker i in., 2013). Klasyczne wnioskowanie, w którym rozkład oszacowań wynika z mechanizmu losowania, wprost tu nie działa (Elliott i Valliant, 2017). Trafność takich oszacowań zależy w całości od modelu, a nie od schematu doboru (Cornesse i in., 2020).
Nie znaczy to, że próba wygodna jest bezwartościowa. Rothman i in. (2013) przekonują, że reprezentatywność jest niezbędna w sondażach opinii, ale nie musi być celem badania naukowego. Takie badanie uogólnia przez zrozumienie, które czynniki mają znaczenie. Granica przebiega więc między rodzajami wniosków:
| Rodzaj wniosku | Przy doborze nielosowym |
|---|---|
| Odsetek, średnia, „ilu studentów…” w całej populacji | nie wolno bez mocnych założeń; podaj wynik jako opis zbadanej próby |
| Kierunek i siła związku w zbadanej grupie | wolno opisać; uogólnienie wymaga argumentu, że udział nie zależał od zmiennej wynikowej |
| Związek przyczynowy w eksperymencie z losowym przydziałem | wolno w obrębie próby, bo chroni go randomizacja, a nie dobór |
| „Próba była reprezentatywna, bo duża” | nie wolno; liczebność zmniejsza błąd losowy, nie błąd doboru |
| Porównanie z danymi o populacji (płeć, wiek, kierunek) | wolno i warto; zgodność tych cech nie dowodzi jednak zgodności badanej cechy |
Kluczowe jest to, od czego zależała decyzja o udziale. Mercer i in. (2017) opisują obciążenie selekcyjne w próbach nieprobabilistycznych przez analogię do wnioskowania przyczynowego. Winship i Mare (1992) pokazują, że gdy dobór nie jest niezależny od zmiennej wynikowej, wnioski o związkach są obciążone. Ilustruje to symulacja poniżej.
Symulacja: dobór wygodny a losowy
Symulowana uczelnia ma 15 000 studentów. Każdy ma wynik stresu w PSS-10 (0–40) i wynik problemów ze snem w PSQI (0–21). Wysoki stres zdefiniowaliśmy umownie jako co najmniej 27 punktów; to próg tylko na potrzeby przykładu. W populacji ma go 15.88% osób, a nachylenie regresji snu na stres wynosi b = 0.248 (r = .458). Porównaliśmy trzy sposoby zebrania 300 osób, każdy powtórzony 1000 razy (dane symulowane):
- A – losowanie z listy studentów;
- B – ankieta „o stresie” w grupach studenckich: chętniej odpowiadają osoby zestresowane, więc udział zależy od predyktora;
- C – ankieta „o śnie” w grupie dla osób z bezsennością: chętniej odpowiadają osoby ze złym snem, więc udział zależy od zmiennej wynikowej.
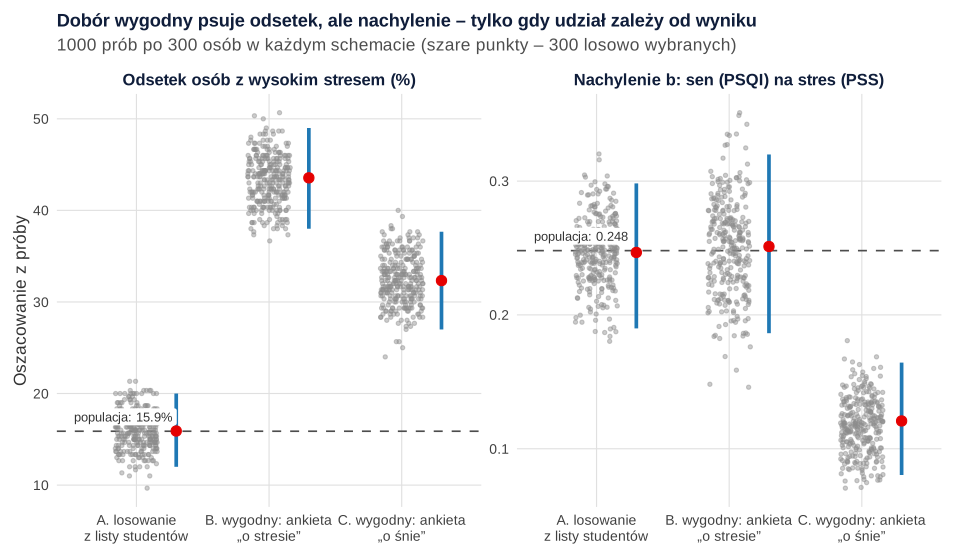
Odsetek. Losowanie trafiało średnio w 15.91%, a 95% przedział ufności obejmował prawdziwą wartość w 95.5% prób. Ankieta „o stresie” dawała średnio 43.56%, czyli zawyżała odsetek o 27.68 punktu procentowego. Ankieta „o śnie” dawała 32.33%. W obu doborach wygodnych przedział ufności nie objął prawdziwej wartości w żadnej z 1000 prób. Przedział mierzy tylko błąd losowy, a tu problemem jest błąd doboru.
Związek. Gdy udział zależał od stresu, czyli predyktora (B), średnie nachylenie wyniosło 0.251 przy prawdziwym 0.248, a pokrycie przedziału – 96.3%. Korelacja spadła jednak z .458 do .372, bo próba miała węższy zakres stresu. Gdy udział zależał od snu, czyli zmiennej wynikowej (C), nachylenie spadło do 0.121, mniej więcej o połowę, a pokrycie przedziału wyniosło 0%.
Wniosek dla pracy jest prosty. Z próby wygodnej nie podawaj odsetków ani średnich jako wyników dla populacji. O związkach pisz ostrożniej i zastanów się, czy temat ankiety mógł przyciągać osoby o określonych wartościach zmiennej wynikowej. Jeśli tak, zapisz to w ograniczeniach. W naszym przykładzie sam tytuł ogłoszenia „ankieta o śnie” wystarczył, żeby zaniżyć związek o połowę. Ważenie nie rozwiąże tego problemu, bo wyrównuje strukturę próby tylko w zmiennych użytych do ważenia (zob. ważenie danych i ważenie danych sondażowych). Podobny mechanizm działa przy błędzie braku odpowiedzi w próbie losowej.
Kryteria włączenia i wyłączenia
Kryteria włączenia to cechy, które musi mieć uczestnik, żeby odpowiedzieć na pytanie badawcze. Kryteria wyłączenia to cechy osób spełniających kryteria włączenia, które mogłyby zakłócić badanie albo zwiększyć ryzyko dla uczestnika (Patino i Ferreira, 2018). Razem wyznaczają populację, której dotyczą wnioski. Autorzy przypominają też, by ocenić, jak kryteria wpływają na trafność zewnętrzną.
- Pisz kryteria sprawdzalnie: z wartością graniczną i źródłem informacji, np. „wiek 18–30 lat (deklaracja w metryczce)”.
- Nie powtarzaj tej samej zmiennej w obu listach. Gdy badasz tylko kobiety, „mężczyzna” nie jest kryterium wyłączenia (Patino i Ferreira, 2018).
- Zamień kryteria na pytania kwalifikujące na początku ankiety i przekieruj osoby spoza nich do podziękowania.
- Ustal kryteria przed zbieraniem danych. Odrzucanie ankiet niskiej jakości to osobny etap czyszczenia danych, który opisujesz oddzielnie.
Przykłady dobrze i źle sformułowanych kryteriów znajdziesz w haśle kryteria włączenia i wyłączenia.
Jak opisać dobór próby w pracy
Opis doboru należy do podrozdziału „Osoby badane” albo „Procedura” w rozdziale metodologicznym. Powinien zawierać:
- populację docelową i dostępną;
- nazwę metody doboru, bez eufemizmów: „dobór wygodny”, a nie „dobór losowy”, gdy nikt niczego nie losował;
- kanały i okres rekrutacji;
- kryteria włączenia i wyłączenia;
- liczby osób na kolejnych etapach: zaproszone (jeśli wiadomo), rozpoczęte ankiety, wykluczone z podaniem powodów, analizowane;
- uzasadnienie liczebności – według poradnika dobór liczebności próby albo kalkulatora liczebności próby;
- zdanie o granicach uogólniania, które wróci w dyskusji.
Charakterystykę zrealizowanej próby, czyli płeć, wiek i inne cechy, podajesz osobno, według wpisu jak opisać charakterystykę próby. Wzór łączący wszystkie elementy dla doboru wygodnego z kryteriami:
Przy doborze losowym zamień drugie i trzecie zdanie na opis operatu, schematu losowania i odsetka realizacji, jak we wzorze w haśle próba losowa. Przy doborze kwotowym podaj źródło kwot.
Symulacja w R: dobór losowy a wygodny
Kod tworzy populację 15 000 studentów, definiuje trzy sposoby doboru 300 osób przez różne szanse udziału (sample(..., prob = ...)), liczy oszacowania z jednej próby i powtarza każdy schemat 1000 razy. Liczby w tekście i na rysunku 1 pochodzą z tego kodu. Wystarczy bazowy R.
Obciążenie odsetka i nachylenia w trzech sposobach doboru
R
# B234 – dobór losowy a dobór wygodny: co się psuje, a co nie (symulacja, set.seed(2341))
# Populacja: 15 000 studentów; stres (PSS-10, 0–40) i problemy ze snem (PSQI, 0–21).
# Trzy sposoby zebrania 300 osób, każdy powtórzony 1000 razy.
set.seed(2341)
N <- 15000
pss <- round(pmin(40, pmax(0, rnorm(N, 20, 6.5))))
psqi <- round(pmin(21, pmax(0, 7 + 0.25 * (pss - 20) + rnorm(N, 0, 3.2))))
pop <- data.frame(pss, psqi)

# Krok 1. Prawdziwe wartości w populacji
prawda <- c(sredni_stres = mean(pop$pss),
            proc_wysoki = 100 * mean(pop$pss >= 27),
            b = unname(coef(lm(psqi ~ pss, data = pop))[2]),
            r = cor(pop$pss, pop$psqi))
round(prawda, 3)

# Krok 2. Trzy sposoby doboru 300 osób
#  A – losowanie z listy studentów (każdy ma tę samą szansę)
#  B – ankieta „o stresie” w grupach studenckich: chętniej odpowiadają osoby zestresowane
#  C – ankieta „o śnie” w grupie o bezsenności: chętniej odpowiadają osoby ze złym snem
szansa <- list(A = rep(1, N),
               B = plogis(0.3 * (pop$pss - 25)),
               C = plogis(0.8 * (pop$psqi - 11)))
dobierz <- function(schemat, n = 300) pop[sample(N, n, prob = szansa[[schemat]]), ]

# Krok 3. Oszacowania z jednej próby (z 95% CI)
oszacuj <- function(d) {
  n <- nrow(d); p <- mean(d$pss >= 27)
  m <- lm(psqi ~ pss, data = d); ci <- confint(m)["pss", ]
  c(sredni_stres = mean(d$pss), proc_wysoki = 100 * p,
    p_dol = 100 * (p - 1.96 * sqrt(p * (1 - p) / n)), p_gor = 100 * (p + 1.96 * sqrt(p * (1 - p) / n)),
    b = unname(coef(m)[2]), b_dol = ci[[1]], b_gor = ci[[2]], r = cor(d$pss, d$psqi))
}
round(sapply(c("A", "B", "C"), function(s) oszacuj(dobierz(s))), 2)

# Krok 4. 1000 powtórzeń każdego schematu
R <- 1000
wyniki <- do.call(rbind, lapply(c("A", "B", "C"), function(s)
  data.frame(schemat = s, t(replicate(R, oszacuj(dobierz(s)))))))
podsum <- function(d) c(
  stres_srednio = mean(d$sredni_stres),
  proc_srednio = mean(d$proc_wysoki), proc_obciazenie = mean(d$proc_wysoki) - prawda[["proc_wysoki"]],
  proc_pokrycie = 100 * mean(d$p_dol <= prawda[["proc_wysoki"]] & d$p_gor >= prawda[["proc_wysoki"]]),
  b_srednio = mean(d$b), b_obciazenie = mean(d$b) - prawda[["b"]],
  b_pokrycie = 100 * mean(d$b_dol <= prawda[["b"]] & d$b_gor >= prawda[["b"]]),
  r_srednio = mean(d$r))
tab <- t(sapply(split(wyniki, wyniki$schemat), podsum))
round(tab, 3)
Wynik w R
sredni_stres  proc_wysoki            b            r
      19.975       15.880        0.248        0.458
                 A     B     C
sredni_stres 20.10 25.70 24.22
proc_wysoki  19.00 41.67 39.00
p_dol        14.56 36.09 33.48
p_gor        23.44 47.25 44.52
b             0.30  0.22  0.08
b_dol         0.25  0.15  0.04
b_gor         0.35  0.29  0.12
r             0.57  0.32  0.22
  stres_srednio proc_srednio proc_obciazenie proc_pokrycie b_srednio b_obciazenie b_pokrycie
A        19.974       15.906           0.026          95.5     0.247       -0.001       95.1
B        25.747       43.555          27.675           0.0     0.251        0.003       96.3
C        23.691       32.333          16.453           0.0     0.121       -0.127        0.0
  r_srednio
A     0.457
B     0.372
C     0.312
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek wykonano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy przy doborze próby
- „Dobór losowy”, bo ankieta trafiła do przypadkowych osób. Losowość wymaga listy i mechanizmu losowania. Link w grupie to dobór wygodny.
- Odsetki z próby wygodnej podane jako wynik dla populacji, np. „43% studentów ma wysoki stres”. W symulacji taki wynik był ponad dwa razy za wysoki.
- Wiara, że duża próba jest reprezentatywna. Więcej osób daje tylko węższy przedział wokół tej samej obciążonej wartości.
- Temat ankiety w tytule ogłoszenia, który przyciąga osoby o skrajnych wynikach zmiennej zależnej. Pisz neutralnie, np. „badanie o codziennym funkcjonowaniu studentów”.
- Kryteria wyłączenia ustalone po zebraniu danych, żeby „poprawić” wyniki. To decyzja analityczna, którą trzeba ujawnić.
- Brak liczb na etapach rekrutacji. Bez nich czytelnik nie oceni, ile osób odpadło i dlaczego.
- Dobór zespołowy analizowany jak prosty. Osoby z tej samej klasy czy oddziału są do siebie podobne, więc zwykłe błędy standardowe są za małe.
Dobór próby to jeden z elementów planu badania. Zmienne, które zmierzysz u wybranych osób, porządkuje wpis o rodzajach zmiennych w badaniu, a ich relacje – model badawczy. Całość planu analiz znajdziesz w przewodniku po statystyce w pracy dyplomowej. Jeśli chcesz, żeby ktoś sprawdził opis doboru i plan analiz w Twojej pracy, skorzystaj z oferty analizy statystyczne dla studentów.
Najczęstsze pytania
Jaki dobór próby wpisać w pracy magisterskiej, gdy ankietę rozesłałem w internecie?
Dobór wygodny, bo o udziale decydowały dostępność i chęć respondentów, a nie losowanie. Jeśli do ankiety mogły wejść tylko osoby spełniające warunki, napisz „dobór wygodny z kryteriami włączenia”, a gdy uczestnicy przekazywali link dalej – dodaj metodę kuli śnieżnej. Nie nazywaj takiej próby losową.
Czy z próby wygodnej można wyciągać wnioski?
Tak, ale tylko o zbadanej grupie i o związkach, z zastrzeżeniami. Odsetków i średnich nie przenoś na populację. Związek uogólniaj ostrożnie, bo wynik jest obciążony, gdy decyzja o udziale zależała od zmiennej wynikowej – w symulacji nachylenie spadło wtedy o połowę (Winship i Mare, 1992).
Czym różni się dobór losowy od losowego przydziału do grup?
Dobór losowy decyduje, kogo badasz, i służy uogólnianiu na populację. Losowy przydział, czyli randomizacja, decyduje, do której grupy trafia już zrekrutowana osoba, i służy wnioskowaniu przyczynowemu. Eksperyment na próbie wygodnej z losowym przydziałem ma trafność wewnętrzną, ale nie daje reprezentatywności.
Czy 300 ankiet z internetu to już próba reprezentatywna?
Nie. Większa liczebność zmniejsza błąd losowy, ale nie usuwa błędu doboru. W symulacji przedział ufności z próby wygodnej nie objął prawdziwego odsetka w żadnej z 1000 prób, choć każda liczyła 300 osób. O reprezentatywności decyduje sposób doboru, a nie liczba osób.
Gdzie w pracy opisać dobór próby?
W rozdziale metodologicznym, w podrozdziale „Osoby badane” albo „Procedura”. Podaj populację, metodę doboru, kanały i okres rekrutacji, kryteria włączenia i wyłączenia, liczby osób na etapach i uzasadnienie liczebności. Ograniczenia wynikające z doboru powtórz w dyskusji.
Powiązane hasła
Przeczytaj też
Gdzie znaleźć respondentów do ankiety?
Uczelnia, grupy tematyczne, kula śnieżna, panele i wymiana ankiet – porównanie kanałów, wzór zaproszenia, liczba zaproszeń i opis próby w pracy.
Czytaj →PoradnikIle osób do ankiety w pracy licencjackiej?
Liczebność w trzech krokach, zapas na odrzucone ankiety, pułapka nierównych grup i analiza wrażliwości, gdy ankiet jest za mało.
Czytaj →PoradnikRozdział metodologiczny – jak go napisać
Co napisać w każdym podrozdziale metody: hipotezy, zmienne, próba, narzędzia, procedura, etyka i plan analiz – z wzorami zdań i listą JARS.
Czytaj →Nie wiesz, jak nazwać i opisać dobór próby w swojej pracy?
Sprawdzimy opis doboru, kryteria i plan analiz oraz wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Andrade, C. (2021). The inconvenient truth about convenience and purposive samples. Indian Journal of Psychological Medicine, 43(1), 86–88. https://doi.org/10.1177/0253717620977000 ● Otwarty dostęp
- Baker, R., Brick, J. M., Bates, N. A., Battaglia, M., Couper, M. P., Dever, J. A., Gile, K. J., & Tourangeau, R. (2013). Summary report of the AAPOR Task Force on Non-probability Sampling. Journal of Survey Statistics and Methodology, 1(2), 90–143. https://doi.org/10.1093/jssam/smt008
- Berndt, A. E. (2020). Sampling methods. Journal of Human Lactation, 36(2), 224–226. https://doi.org/10.1177/0890334420906850
- Cornesse, C., Blom, A. G., Dutwin, D., Krosnick, J. A., De Leeuw, E. D., Legleye, S., Pasek, J., Pennay, D., Phillips, B., Sakshaug, J. W., Struminskaya, B., & Wenz, A. (2020). A review of conceptual approaches and empirical evidence on probability and nonprobability sample survey research. Journal of Survey Statistics and Methodology, 8(1), 4–36. https://doi.org/10.1093/jssam/smz041 ● Otwarty dostęp
- Elliott, M. R., & Valliant, R. (2017). Inference for nonprobability samples. Statistical Science, 32(2), 249–264. https://doi.org/10.1214/16-sts598 ● Otwarty dostęp
- Mercer, A. W., Kreuter, F., Keeter, S., & Stuart, E. A. (2017). Theory and practice in nonprobability surveys: Parallels between causal inference and survey inference. Public Opinion Quarterly, 81(S1), 250–271. https://doi.org/10.1093/poq/nfw060 ● Otwarty dostęp
- Palinkas, L. A., Horwitz, S. M., Green, C. A., Wisdom, J. P., Duan, N., & Hoagwood, K. (2015). Purposeful sampling for qualitative data collection and analysis in mixed method implementation research. Administration and Policy in Mental Health and Mental Health Services Research, 42(5), 533–544. https://doi.org/10.1007/s10488-013-0528-y ● Otwarty dostęp: pełny tekst
- Patino, C. M., & Ferreira, J. C. (2018). Inclusion and exclusion criteria in research studies: Definitions and why they matter. Jornal Brasileiro de Pneumologia, 44(2), 84. https://doi.org/10.1590/s1806-37562018000000088 ● Otwarty dostęp
- Rothman, K. J., Gallacher, J. E., & Hatch, E. E. (2013). Why representativeness should be avoided. International Journal of Epidemiology, 42(4), 1012–1014. https://doi.org/10.1093/ije/dys223 ● Otwarty dostęp
- Winship, C., & Mare, R. D. (1992). Models for sample selection bias. Annual Review of Sociology, 18(1), 327–350. https://doi.org/10.1146/annurev.so.18.080192.001551
Cytowania BibTeX
@article{andrade2021inconvenient, author={Andrade, Chittaranjan}, title={{The inconvenient truth about convenience and purposive samples}}, journal={Indian Journal of Psychological Medicine}, year={2021}, volume={43}, number={1}, pages={86--88}, doi={10.1177/0253717620977000}}@article{baker2013summary, author={Baker, R. and Brick, J. M. and Bates, N. A. and Battaglia, M. and Couper, M. P. and Dever, J. A. and Gile, K. J. and Tourangeau, R.}, title={{Summary report of the AAPOR Task Force on Non-probability Sampling}}, journal={Journal of Survey Statistics and Methodology}, year={2013}, volume={1}, number={2}, pages={90--143}, doi={10.1093/jssam/smt008}}@article{berndt2020sampling, author={Berndt, Andrea E.}, title={{Sampling methods}}, journal={Journal of Human Lactation}, year={2020}, volume={36}, number={2}, pages={224--226}, doi={10.1177/0890334420906850}}@article{cornesse2020review, author={Cornesse, Carina and Blom, Annelies G. and Dutwin, David and Krosnick, Jon A. and De Leeuw, Edith D. and Legleye, Stéphane and Pasek, Josh and Pennay, Darren and Phillips, Benjamin and Sakshaug, Joseph W. and Struminskaya, Bella and Wenz, Alexander}, title={{A review of conceptual approaches and empirical evidence on probability and nonprobability sample survey research}}, journal={Journal of Survey Statistics and Methodology}, year={2020}, volume={8}, number={1}, pages={4--36}, doi={10.1093/jssam/smz041}}@article{elliott2017inference, author={Elliott, Michael R. and Valliant, Richard}, title={{Inference for nonprobability samples}}, journal={Statistical Science}, year={2017}, volume={32}, number={2}, pages={249--264}, doi={10.1214/16-sts598}}@article{mercer2017theory, author={Mercer, Andrew W. and Kreuter, Frauke and Keeter, Scott and Stuart, Elizabeth A.}, title={{Theory and practice in nonprobability surveys: Parallels between causal inference and survey inference}}, journal={Public Opinion Quarterly}, year={2017}, volume={81}, number={S1}, pages={250--271}, doi={10.1093/poq/nfw060}}@article{palinkas2015purposeful, author={Palinkas, Lawrence A. and Horwitz, Sarah M. and Green, Carla A. and Wisdom, Jennifer P. and Duan, Naihua and Hoagwood, Kimberly}, title={{Purposeful sampling for qualitative data collection and analysis in mixed method implementation research}}, journal={Administration and Policy in Mental Health and Mental Health Services Research}, year={2015}, volume={42}, number={5}, pages={533--544}, doi={10.1007/s10488-013-0528-y}}@article{patino2018inclusion, author={Patino, Cecilia Maria and Ferreira, Juliana Carvalho}, title={{Inclusion and exclusion criteria in research studies: Definitions and why they matter}}, journal={Jornal Brasileiro de Pneumologia}, year={2018}, volume={44}, number={2}, pages={84}, doi={10.1590/s1806-37562018000000088}}@article{rothman2013why, author={Rothman, Kenneth J. and Gallacher, John E. and Hatch, Elizabeth E.}, title={{Why representativeness should be avoided}}, journal={International Journal of Epidemiology}, year={2013}, volume={42}, number={4}, pages={1012--1014}, doi={10.1093/ije/dys223}}@article{winship1992models, author={Winship, Christopher and Mare, Robert D.}, title={{Models for sample selection bias}}, journal={Annual Review of Sociology}, year={1992}, volume={18}, number={1}, pages={327--350}, doi={10.1146/annurev.so.18.080192.001551}}