Co ważenie naprawia, a czego nie
Hasło ważenie danych i wagi poststratyfikacyjne pokazuje najprostszy przypadek: jedna zmienna, jedna waga na grupę. W prawdziwym sondażu wagi powstają w kilku krokach, a każdy krok koryguje inny problem. Ten wpis prowadzi przez cały proces na jednym symulowanym badaniu, z kodem w podstawowym R: od wag schematu, przez korektę braku odpowiedzi i raking, po przycinanie wag i błąd standardowy, który uwzględnia ważenie.
Zacznij od trzeźwej oceny, czego się po wagach spodziewasz. Ważenie wyrównuje strukturę próby w zmiennych, których użyłeś do ważenia. Usuwa błąd braku odpowiedzi tylko wtedy, gdy w obrębie kategorii ważenia osoby, które odpowiedziały, nie różnią się od tych, które odmówiły. W próbach internetowych z autoselekcją ważenie często nie wystarcza (Bethlehem, 2010), a wnioskowanie z próby nielosowej zawsze opiera się na założeniach modelu (Elliott i Valliant, 2017). Prostszą wersję rakingu na próbie internetowej, w pracy dyplomowej, znajdziesz we wpisie statystyka w pracy z socjologii.
Trzy etapy budowy wag
Haziza i Beaumont (2017) opisują typowy proces ważenia w urzędach statystycznych jako trzy etapy, po których czasem następuje czwarty: przycięcie lub wygładzenie wag. Ten sam schemat sprawdza się w badaniu naukowym.
| Etap | Co koryguje | Jak liczysz | Czego potrzebujesz |
|---|---|---|---|
| 1. Waga schematu (bazowa) | Nierówne szanse wylosowania | di = 1/πi | Prawdopodobieństwa wyboru z planu losowania |
| 2. Korekta braku odpowiedzi | Różny odsetek odpowiedzi w grupach | mnożnik = suma wag wylosowanych / suma wag respondentów w klasie | Cechy znane dla wszystkich wylosowanych (z operatu) |
| 3. Kalibracja (raking) | Pozostałe różnice struktury, niepełne pokrycie | iteracyjne dopasowanie rozkładów brzegowych | Rozkłady w populacji (np. dane GUS) |
| 4. Przycinanie | Kilka skrajnych wag, które zwiększają wariancję | obcięcie do progu i ponowny raking | Próg ustalony przed analizą |
W próbie bez planu losowania (np. ankieta w mediach społecznościowych) etapu 1 nie ma, bo nie znasz prawdopodobieństw wyboru. Zostaje sama kalibracja, a jej skuteczność zależy od tego, czy zmienne ważące tłumaczą zarówno udział w badaniu, jak i badaną cechę.
Przykład: sondaż o korzystaniu z pomocy psychologicznej
Symulujemy populację 400 000 dorosłych i badamy odsetek osób, które w ostatnich 12 miesiącach korzystały z pomocy psychologicznej. Ponieważ populację tworzymy sami, znamy prawdziwy odsetek: 22.55%. Z operatu losujemy próbę warstwową: 1000 osób z miast i 1500 ze wsi, więc wieś jest celowo nadreprezentowana. Na zaproszenie odpowiada 1033 z 2500 osób (41.3%). Młodsi i gorzej wykształceni odpowiadają rzadziej, a udział w badaniu zależy też od cechy, której nie mierzymy (otwartości na rozmowę o zdrowiu psychicznym). Dane są symulowane (set.seed(2111)); zbiór respondentów z wagami z każdego kroku możesz pobrać jako plik CSV.
| Zmienna | Kategoria | Respondenci bez wag (%) | Populacja (%) |
|---|---|---|---|
| Płeć | kobieta | 52.9 | 51.9 |
| Wiek | 18–34 | 13.9 | 26.8 |
| Wiek | 55+ | 52.8 | 39.1 |
| Wykształcenie | podstawowe lub zawodowe | 31.1 | 39.1 |
| Wykształcenie | wyższe | 28.5 | 22.8 |
| Miejsce zamieszkania | wieś | 56.9 | 40.1 |
Najmłodszych jest w próbie o połowę za mało, a to oni najczęściej korzystają z pomocy. Odsetek bez wag (19.55%) jest więc zaniżony o 3.00 punktu procentowego.
Krok 1. Wagi schematu
Waga schematu to odwrotność prawdopodobieństwa wylosowania. W losowaniu warstwowym jest stała w warstwie: d = Nh / nh, czyli liczba osób w populacji, które „reprezentuje” jedna wylosowana osoba. Mieszkaniec miasta dostaje tu wagę 239.7, a mieszkaniec wsi 106.8. Po normalizacji do średniej 1 wagi wahają się od 0.65 do 1.46. Sam ten krok przywraca proporcję miasta i wsi z planu losowania, ale nie naprawia skutków odmów: odsetek rośnie tylko do 20.57%. Pojęcie próby losowej i jej odmian omawiamy w słowniku.
Krok 2. Korekta braku odpowiedzi
Korekta wymaga cechy znanej dla wszystkich wylosowanych, także tych, którzy odmówili. W rejestrze, z którego losujesz, zwykle jest wiek i miejsce zamieszkania. Dzielisz wylosowanych na klasy (tu: warstwa × wiek) i w każdej klasie mnożysz wagi respondentów przez odwrotność ważonego wskaźnika odpowiedzi:
W przykładzie mnożnik wynosi od 1.64 (miasto, 55+) do 5.07 (wieś, 18–34): na jedną młodą osobę ze wsi, która odpowiedziała, przypada pięć wylosowanych. Oszacowanie rośnie do 23.05%, czyli nieco powyżej prawdy. Klasy dobierz tak, by grupowały osoby o podobnej skłonności do odpowiedzi i podobnej wartości badanej cechy. Zbyt drobne klasy z kilkoma respondentami dają skrajne mnożniki. Mechanizmy braków opisuje hasło braki danych MCAR, MAR i MNAR; tu zakładamy MAR względem zmiennych ważących.
Krok 3. Raking, czyli iteracyjne dopasowanie rozkładów brzegowych
Po korekcie braku odpowiedzi struktura respondentów nadal odbiega od populacji: największa różnica w rozkładach brzegowych wynosi 13.52 punktu procentowego. Gdybyś znał liczebności populacji w każdej komórce płeć × wiek × wykształcenie × miejsce zamieszkania, mógłbyś zrobić poststratyfikację w tych 36 komórkach. Zwykle jednak znasz tylko rozkłady brzegowe, a pełne krzyżowanie rozprasza próbę na wiele małych komórek. Wtedy stosuje się raking (Battaglia i in., 2009): algorytm koryguje wagi po kolei dla każdej zmiennej, tak by ważony rozkład tej zmiennej zgadzał się z populacją, i powtarza cały cykl, aż wagi przestaną się zmieniać.
Raking jest szczególnym przypadkiem kalibracji: daje wagi możliwie bliskie wagom wejściowym, które dokładnie odtwarzają znane sumy populacyjne (Deville i Särndal, 1992). W przykładzie algorytm zbiegł się po 10 cyklach, a wszystkie cztery rozkłady brzegowe zgadzają się z populacją co do 0.01 punktu procentowego. Oszacowanie wynosi 22.41%, tylko 0.15 punktu poniżej prawdy. Tak dobry wynik zawdzięczamy temu, że w symulacji udział w badaniu zależy od nieobserwowanej otwartości tylko słabo. Gdyby zależał od niej silnie, raking nie usunąłby całego obciążenia.
Zmienne do rakingu wybieraj według dwóch kryteriów: wiążą się z udziałem w badaniu i z badaną cechą, a ich rozkład w populacji jest wiarygodnie znany. Kategorie w próbie i w danych o populacji muszą być zdefiniowane identycznie. Kolenikov (2014) opisuje praktyczne kwestie implementacji, w tym diagnostykę wag po rakingu.
Krok 4. Przycinanie wag
Raking poprawił strukturę, ale wagi się rozjechały: od 0.24 do 5.07 (po normalizacji do średniej 1). Pięć osób ma wagę powyżej 3.5, więc każda z nich „liczy się” za ponad trzy i pół przeciętnego respondenta. Jedna nietypowa odpowiedź takiej osoby może przesunąć wynik. Przycinanie zamienia trochę obciążenia na mniejszą wariancję. Chen i in. (2017) porównują je z innymi sposobami poprawiania oszacowań ważonych, np. modelowaniem wag.
W przykładzie wagi obcięliśmy do 3.5-krotności średniej i ponownie wykonaliśmy raking, bo przycięcie psuje dopasowanie rozkładów. Pętla „przytnij → raking” zakończyła się po 4 rundach: największa waga wynosi 3.50, a rozkłady brzegowe nadal zgadzają się z populacją.
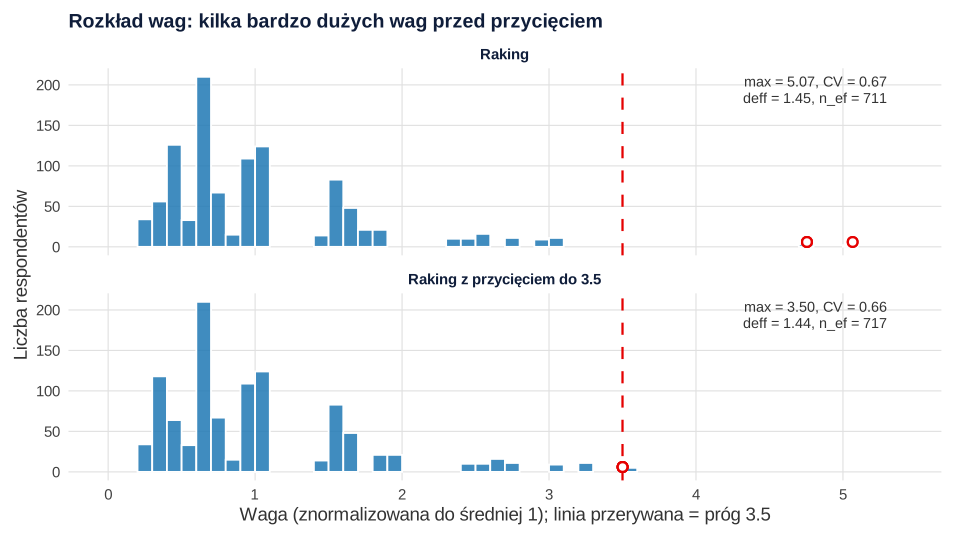
Zysk jest tu skromny, a oszacowanie się nie zmienia (22.40%). Tak bywa, gdy skrajnych wag jest kilka. Próg zapisz w planie analizy przed obejrzeniem wyników, a w raporcie podaj go razem z liczbą przyciętych wag. Typowe progi to wielokrotność średniej albo mediany wag; ich wybór to decyzja, którą warto pokazać w analizie wrażliwości.
Koszt ważenia: efektywna liczebność i błąd standardowy
Każdy krok zwiększa zróżnicowanie wag, a to obniża precyzję. Pojęcie efektu schematu wywodzi się z klasycznego podręcznika Kisha (1965). Dla samego zróżnicowania wag stosuje się przybliżenie:
| Wagi | Zakres wag | CV | deff | nef | Odsetek (%) [95% CI] | Różnica z prawdą (pp) |
|---|---|---|---|---|---|---|
| Bez wag | 1.00 | 0.00 | 1.00 | 1033 | 19.55 [17.14, 21.97] | −3.00 |
| Schemat | 0.65–1.46 | 0.40 | 1.16 | 890 | 20.57 [17.88, 23.27] | −1.98 |
| + brak odpowiedzi | 0.52–2.38 | 0.51 | 1.26 | 819 | 23.05 [20.02, 26.07] | 0.50 |
| + raking | 0.24–5.07 | 0.67 | 1.45 | 711 | 22.41 [19.18, 25.63] | −0.15 |
| + przycięcie | 0.24–3.50 | 0.66 | 1.44 | 717 | 22.40 [19.20, 25.60] | −0.15 |
Po pełnym ważeniu 1033 odpowiedzi niosą tyle informacji co około 717 odpowiedzi z prostej próby losowej. Dlatego błędu standardowego z wagami nie licz wzorem dla prostej próby. Wzór √(p(1 − p)/n) daje 1.30 punktu procentowego, a linearyzacja uwzględniająca wagi i warstwy – 1.63. Przedział z naiwnego wzoru byłby wyraźnie za wąski, a margines błędu – zaniżony.
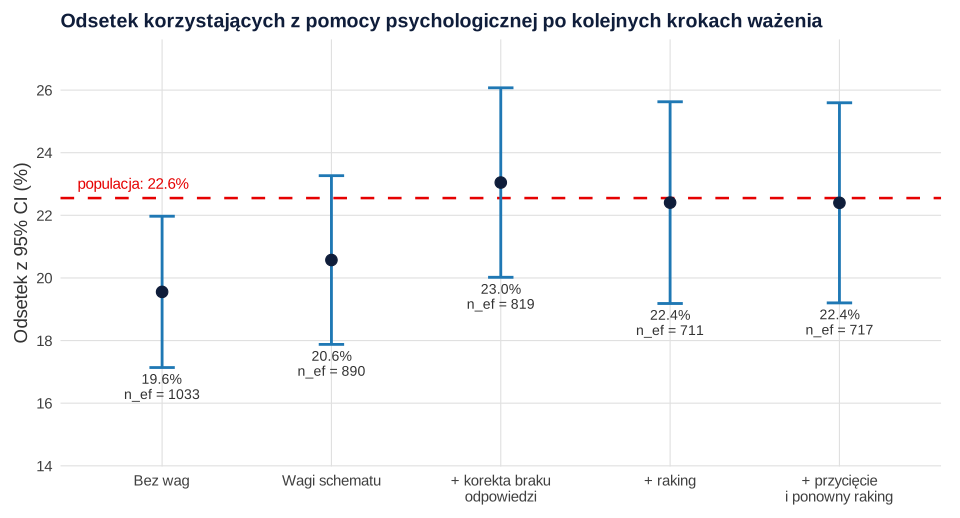
Nasz błąd standardowy z linearyzacji traktuje wagi jak stałe. To przybliżenie zwykle ostrożne, bo pomija zmniejszenie wariancji dzięki kalibracji. Standardem w R jest pakiet survey. Opisujesz w nim schemat doboru (warstwy, klastry, wagi), a wariancję szacuje on przez linearyzację albo replikację (Lumley, 2004). Funkcje rake() i trimWeights() wykonują kroki 3 i 4 na obiekcie schematu, więc błędy standardowe od razu uwzględniają kalibrację. Kod w tym pakiecie pokazujemy niżej jako przepis niewykonany. Analizę danych z gotowymi wagami, warstwami i klastrami omawia wpis analiza danych z dużych badań sondażowych.
Jak opisać ważenie w artykule
Czytelnik powinien móc odtworzyć wagi. Opisz źródło danych o populacji, zmienne i kategorie, metodę, kryterium zbieżności, próg przycięcia i diagnostykę wag. Pokaż też wynik bez wag. Duża różnica między nimi jest informacją o obciążeniu próby, a nie powodem, by ukryć jedną z wersji. Ograniczenia ważenia opisz w części o ograniczeniach badania.
Jeśli recenzent pyta o wagi albo potrzebujesz zbudować je do własnego sondażu, możemy przygotować i sprawdzić cały proces w ramach wsparcia statystycznego dla badaczy.
Ważenie krok po kroku w R
Przepis 1 tworzy populację i próbę, liczy wagi we wszystkich czterech krokach, diagnostykę i oszacowania oraz zapisuje plik wazenie-sondazu-dane.csv. Wystarcza podstawowy R. Przepis 2 pokazuje te same kroki w pakiecie survey; nie został wykonany, więc nie podajemy jego wyników.
1. Wagi schematu, brak odpowiedzi, raking i przycinanie w podstawowym R
R
# Dane symulowane: populacja 400 000 dorosłych i sondaż losowy warstwowy (miasto/wieś) z brakiem odpowiedzi.
# Zmienna badana: korzystanie z pomocy psychologicznej w ostatnich 12 miesiącach (0/1).
set.seed(2111)
N <- 400000
pop <- data.frame(
  plec = sample(c("kobieta", "mezczyzna"), N, TRUE, prob = c(.52, .48)),
  wiek = sample(c("18-34", "35-54", "55+"), N, TRUE, prob = c(.27, .34, .39)),
  miejsce = sample(c("miasto", "wies"), N, TRUE, prob = c(.60, .40)))
p_wyz <- ifelse(pop$miejsce == "miasto", .30, .14) + ifelse(pop$wiek == "55+", -.08, .04)
p_sr <- .38
u <- runif(N)
pop$wyksz <- ifelse(u < p_wyz, "wyzsze", ifelse(u < p_wyz + p_sr, "srednie", "podst/zaw"))
otwartosc <- rnorm(N)                      # cecha nieobserwowana: wpływa i na wynik, i na udział w badaniu
lp <- -2.4 + 0.45 * (pop$plec == "kobieta") + 1.3 * (pop$wiek == "18-34") + 0.5 * (pop$wiek == "35-54") +
  0.3 * (pop$wyksz == "wyzsze") + 0.3 * (pop$miejsce == "miasto") + 0.5 * otwartosc
pop$pomoc <- rbinom(N, 1, plogis(lp))
prawda <- mean(pop$pomoc)

# Losowanie warstwowe: 1000 osób z miast i 1500 ze wsi (wieś nadreprezentowana)
pop$id <- seq_len(N)
n_h <- c(miasto = 1000, wies = 1500)
proba <- do.call(rbind, lapply(names(n_h), function(h) { d <- pop[pop$miejsce == h, ]; d[sample(nrow(d), n_h[[h]]), ] }))
proba$d <- as.numeric(table(pop$miejsce)[proba$miejsce] / n_h[proba$miejsce])   # waga schematu = 1 / prawdopodobieństwo wyboru
round(tapply(proba$d, proba$miejsce, mean), 1)
# Udział w badaniu zależy od wieku, wykształcenia i nieobserwowanej otwartości
p_odp <- plogis(-0.4 + 0.8 * (proba$wiek == "55+") - 0.9 * (proba$wiek == "18-34") +
                  1.0 * (proba$wyksz == "wyzsze") - 0.7 * (proba$wyksz == "podst/zaw") + 0.25 * otwartosc[proba$id])
proba$odp <- rbinom(nrow(proba), 1, p_odp)
data.frame(N_populacja = N, n_brutto = nrow(proba), n_netto = sum(proba$odp), RR = round(mean(proba$odp), 3))

# Krok 2: korekta braku odpowiedzi w klasach warstwa × wiek (wiek znany z operatu dla wszystkich wylosowanych)
proba$klasa <- interaction(proba$miejsce, proba$wiek)
wsp <- tapply(proba$d, proba$klasa, sum) / tapply(proba$d * proba$odp, proba$klasa, sum)
round(wsp, 3)
r <- proba[proba$odp == 1, ]
r$w_nr <- r$d * wsp[as.character(r$klasa)]

# Krok 3: raking (IPF) do rozkładów brzegowych populacji
cele <- lapply(c(plec = "plec", wiek = "wiek", wyksz = "wyksz", miejsce = "miejsce"), function(v) table(pop[[v]]))
# Struktura respondentów bez wag a populacja (%)
struktura <- do.call(rbind, lapply(names(cele), function(v) data.frame(zmienna = v, kategoria = names(cele[[v]]),
  proba_proc = round(100 * as.numeric(prop.table(table(r[[v]]))[names(cele[[v]])]), 1),
  populacja_proc = round(100 * as.numeric(cele[[v]]) / N, 1))))
print(struktura, row.names = FALSE)
raking <- function(w, dane, cele, tol = 1e-8, max_iter = 100) {
  for (it in seq_len(max_iter)) {
    w_przed <- w
    for (v in names(cele)) {
      suma <- tapply(w, dane[[v]], sum)
      w <- w * (cele[[v]][as.character(dane[[v]])] / suma[as.character(dane[[v]])])
    }
    if (max(abs(w / w_przed - 1)) < tol) break
  }
  list(w = as.numeric(w), iteracje = it)
}
rk <- raking(r$w_nr, r, cele)
r$w_rake <- rk$w
rk$iteracje

# Krok 4: przycinanie do 3.5 × średnia waga i ponowny raking, aż oba warunki są spełnione
przytnij_rake <- function(w, dane, cele, k = 3.5, max_rund = 50) {
  for (i in seq_len(max_rund)) {
    w <- pmin(w, k * mean(w))
    w <- raking(w, dane, cele)$w
    if (max(w) <= k * mean(w) * 1.001) break
  }
  list(w = w, rundy = i)
}
sum(r$w_rake / mean(r$w_rake) > 3.5)   # liczba osób z wagą powyżej progu przed przycięciem
pt <- przytnij_rake(r$w_rake, r, cele)
r$w_trim <- pt$w
pt$rundy

# Diagnostyka wag (wagi znormalizowane do średniej 1) i efekt schematu Kisha
diag_wag <- function(w) {
  w1 <- w / mean(w)
  c(min = min(w1), max = max(w1), CV = sd(w1) / mean(w1), deff_Kish = 1 + (sd(w1) / mean(w1))^2,
    n_eff = sum(w)^2 / sum(w^2))
}
wagi <- list(bez_wag = rep(1, nrow(r)), schemat = r$d, nonresponse = r$w_nr, raking = r$w_rake, raking_przyciete = r$w_trim)
round(t(sapply(wagi, diag_wag)), 2)

# Zgodność rozkładów brzegowych z populacją (punkty procentowe, największe odchylenie)
odchylenie <- function(w) max(sapply(names(cele), function(v)
  max(abs(100 * tapply(w, r[[v]], sum) / sum(w) - 100 * cele[[v]] / N))))
round(sapply(wagi, odchylenie), 2)

# Odsetek z wagami i błąd standardowy z linearyzacji (warstwy, wagi traktowane jako stałe)
szacuj <- function(w, y = r$pomoc, warstwa = r$miejsce) {
  est <- sum(w * y) / sum(w)
  z <- w * (y - est) / sum(w)
  v <- sum(sapply(split(z, warstwa), function(zh) length(zh) / (length(zh) - 1) * sum((zh - mean(zh))^2)))
  se <- sqrt(v)
  c(proc = 100 * est, SE = 100 * se, dolny = 100 * (est - 1.96 * se), gorny = 100 * (est + 1.96 * se))
}
wyniki <- t(sapply(wagi, szacuj))
round(cbind(wyniki, blad_wzgl_prawdy = wyniki[, "proc"] - 100 * prawda), 2)
round(100 * prawda, 2)
# Naiwny SE z wagami (wzór dla prostej próby losowej bez uwzględnienia wag) – dla porównania
round(100 * sqrt(wyniki["raking_przyciete", "proc"] / 100 * (1 - wyniki["raking_przyciete", "proc"] / 100) / nrow(r)), 2)

write.csv(r[, c("id", "plec", "wiek", "wyksz", "miejsce", "pomoc", "d", "w_nr", "w_rake", "w_trim")],
          "wazenie-sondazu-dane.csv", row.names = FALSE)
Wynik w R
miasto   wies
 239.7  106.8
  N_populacja n_brutto n_netto    RR
1       4e+05     2500    1033 0.413
miasto.18-34   wies.18-34 miasto.35-54   wies.35-54   miasto.55+     wies.55+
       3.851        5.065        2.497        2.637        1.638        1.871
 zmienna kategoria proba_proc populacja_proc
    plec   kobieta       52.9           51.9
    plec mezczyzna       47.1           48.1
    wiek     18-34       13.9           26.8
    wiek     35-54       33.3           34.0
    wiek       55+       52.8           39.1
   wyksz podst/zaw       31.1           39.1
   wyksz   srednie       40.5           38.1
   wyksz    wyzsze       28.5           22.8
 miejsce    miasto       43.1           59.9
 miejsce      wies       56.9           40.1
[1] 10
[1] 5
[1] 4
                  min  max   CV deff_Kish   n_eff
bez_wag          1.00 1.00 0.00      1.00 1033.00
schemat          0.65 1.46 0.40      1.16  889.87
nonresponse      0.52 2.38 0.51      1.26  818.56
raking           0.24 5.07 0.67      1.45  711.24
raking_przyciete 0.24 3.50 0.66      1.44  716.98
         bez_wag          schemat      nonresponse           raking
           16.86            13.64            13.52             0.00
raking_przyciete
            0.00
                  proc   SE dolny gorny blad_wzgl_prawdy
bez_wag          19.55 1.23 17.14 21.97            -3.00
schemat          20.57 1.37 17.88 23.27            -1.98
nonresponse      23.05 1.54 20.02 26.07             0.50
raking           22.41 1.64 19.18 25.63            -0.15
raking_przyciete 22.40 1.63 19.20 25.60            -0.15
[1] 22.55
[1] 1.3
2. To samo w pakiecie survey (wymaga pakietu survey, niewykonany)
R
# Wymaga pakietu survey – przepis NIEWYKONANY (pakiet nie jest zainstalowany w środowisku, w którym liczono przykład).
# Korzysta z obiektów r, cele i N z przepisu 1.
library(survey)
proj <- svydesign(ids = ~1, strata = ~miejsce, weights = ~w_nr, data = r)   # wagi po korekcie braku odpowiedzi
marg <- lapply(names(cele), function(v) setNames(data.frame(names(cele[[v]]), as.numeric(cele[[v]])), c(v, "Freq")))
kal <- rake(proj, sample.margins = lapply(names(cele), function(v) as.formula(paste0("~", v))),
            population.margins = marg)
kal <- trimWeights(kal, upper = 3.5 * mean(weights(kal)))   # próg jak w przepisie 1
svymean(~pomoc, kal)                                         # odsetek i SE z uwzględnieniem kalibracji
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia przepisu 1 w R 4.5.3 (wyłącznie funkcje podstawowe R); rysunki przygotowano w pakiecie ggplot2. Przepis 2 wymaga pakietu survey i nie był uruchamiany.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Ważenie bez sprawdzenia, czy jest potrzebne. Porównaj strukturę respondentów z populacją i pokaż oba wyniki: z wagami i bez.
- Zmienne ważące, które nie wiążą się z badaną cechą. Zwiększają wariancję i nie zmniejszają obciążenia.
- Brak kontroli zbieżności rakingu. Po zakończeniu sprawdź, czy ważone rozkłady brzegowe rzeczywiście zgadzają się z populacją.
- Przycinanie bez ponownego rakingu albo z progiem dobranym po obejrzeniu wyników.
- Błąd standardowy z wzoru dla prostej próby. Wagi trzeba uwzględnić w wariancji, a nie tylko w średniej (zob. błąd standardowy i przedział ufności dla proporcji).
- „Reprezentatywna po zważeniu”. Próba nielosowa po ważeniu nadal jest nielosowa (zob. reprezentatywność próby i panel internetowy). Wagi sondażowe nie są też wagami odwrotnego prawdopodobieństwa leczenia z analizy przyczynowej, które omawia wpis propensity score: dopasowanie i ważenie.
Najczęstsze pytania
Czym różni się raking od poststratyfikacji?
Poststratyfikacja dopasowuje wagi w komórkach pełnego krzyżowania zmiennych (np. płeć × wiek × wykształcenie) i wymaga liczebności populacji w każdej komórce. Raking dopasowuje po kolei tylko rozkłady brzegowe każdej zmiennej i powtarza cykle aż do zbieżności (Battaglia i in., 2009). Wybierz raking, gdy znasz tylko rozkłady brzegowe albo gdy komórki byłyby bardzo małe.
Jak przyciąć wagi sondażowe?
Ustal próg przed analizą, np. wielokrotność średniej wagi, obetnij wagi powyżej progu i ponownie wykonaj raking, bo przycięcie psuje zgodność z populacją. Powtarzaj, aż oba warunki będą spełnione. W przykładzie próg 3.5 objął 5 osób, a pętla zakończyła się po 4 rundach. W raporcie podaj próg i liczbę przyciętych wag.
Ile informacji tracę przez ważenie danych sondażowych?
Tyle, ile wynika z efektywnej liczebności próby (Σw)²/Σw². Im bardziej zróżnicowane wagi, tym mniejsza. W przykładzie 1033 odpowiedzi po pełnym ważeniu odpowiadały około 717 odpowiedziom z prostej próby losowej, a efekt schematu wynikający z wag wyniósł 1.44.
Czy błąd standardowy odsetka z wagami można policzyć zwykłym wzorem?
Nie. Wzór √(p(1 − p)/n) zakłada prostą próbę losową bez wag i zaniża błąd. W przykładzie dał 1.30 punktu procentowego zamiast 1.63 z linearyzacji. Użyj linearyzacji albo metod replikacyjnych, np. w pakiecie survey (Lumley, 2004).
Czy raking usuwa błąd braku odpowiedzi?
Tylko w zakresie zmiennych, według których ważysz. Jeśli osoby, które odpowiedziały, różnią się od odmawiających także w cechach spoza wag, obciążenie zostaje. Dlatego dobieraj zmienne ważące, które wiążą się i z udziałem w badaniu, i z badaną cechą, a ograniczenie opisz w artykule.
Powiązane hasła
Przeczytaj też
Analiza danych z ESS, PGSS i Diagnozy Społecznej
Dostęp i rejestracja, wagi dweight, pspwght i anweight, warstwy i klastry, błędy standardowe ze schematu i regresja w R z wzorem opisu.
Czytaj →PoradnikStatystyka w pracy z socjologii
Sondaż, tabele krzyżowe z resztami, ważenie próby, regresja logistyczna z AME i skale postaw: plan analiz, APA, dane XLSX i kod R.
Czytaj →PoradnikBraki danych w ankiecie – co zrobić?
Jak policzyć braki, kiedy wystarczy reguła proporcjonalna, jak sprawdzić osoby, które przerwały ankietę, i jak opisać braki w pracy.
Czytaj →Budujesz wagi do sondażu albo recenzent pyta o ważenie?
Pomożemy zaplanować i policzyć wagi, sprawdzić ich diagnostykę i błędy standardowe oraz wyjaśnić wyniki tak, żebyś mógł(a) samodzielnie opisać i obronić procedurę.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Battaglia, M. P., Hoaglin, D. C., & Frankel, M. R. (2009). Practical considerations in raking survey data. Survey Practice, 2(5), 1–10. https://doi.org/10.29115/sp-2009-0019 ● Otwarty dostęp
- Bethlehem, J. (2010). Selection bias in web surveys. International Statistical Review, 78(2), 161–188. https://doi.org/10.1111/j.1751-5823.2010.00112.x ● Otwarty dostęp
- Chen, Q., Elliott, M. R., Haziza, D., Yang, Y., Ghosh, M., Little, R. J. A., Sedransk, J., & Thompson, M. (2017). Approaches to improving survey-weighted estimates. Statistical Science, 32(2), 227–248. https://doi.org/10.1214/17-sts609
- Deville, J.-C., & Särndal, C.-E. (1992). Calibration estimators in survey sampling. Journal of the American Statistical Association, 87(418), 376–382. https://doi.org/10.1080/01621459.1992.10475217
- Elliott, M. R., & Valliant, R. (2017). Inference for nonprobability samples. Statistical Science, 32(2), 249–264. https://doi.org/10.1214/16-sts598 ● Otwarty dostęp
- Haziza, D., & Beaumont, J.-F. (2017). Construction of weights in surveys: A review. Statistical Science, 32(2), 206–226. https://doi.org/10.1214/16-sts608
- Kish, L. (1965). Survey sampling. Wiley.
- Kolenikov, S. (2014). Calibrating survey data using iterative proportional fitting (raking). The Stata Journal, 14(1), 22–59. https://doi.org/10.1177/1536867x1401400104 ● Otwarty dostęp
- Lumley, T. (2004). Analysis of complex survey samples. Journal of Statistical Software, 9(8). https://doi.org/10.18637/jss.v009.i08 ● Otwarty dostęp
Cytowania BibTeX
@article{battaglia2009practical, author={Battaglia, Michael P. and Hoaglin, David C. and Frankel, Martin R.}, title={{Practical considerations in raking survey data}}, journal={Survey Practice}, year={2009}, volume={2}, number={5}, pages={1--10}, doi={10.29115/sp-2009-0019}}@article{bethlehem2010selection, author={Bethlehem, Jelke}, title={{Selection bias in web surveys}}, journal={International Statistical Review}, year={2010}, volume={78}, number={2}, pages={161--188}, doi={10.1111/j.1751-5823.2010.00112.x}}@article{chen2017approaches, author={Chen, Qixuan and Elliott, Michael R. and Haziza, David and Yang, Ye and Ghosh, Malay and Little, Roderick J. A. and Sedransk, Joseph and Thompson, Mary}, title={{Approaches to improving survey-weighted estimates}}, journal={Statistical Science}, year={2017}, volume={32}, number={2}, pages={227--248}, doi={10.1214/17-sts609}}@article{deville1992calibration, author={Deville, Jean-Claude and Särndal, Carl-Erik}, title={{Calibration estimators in survey sampling}}, journal={Journal of the American Statistical Association}, year={1992}, volume={87}, number={418}, pages={376--382}, doi={10.1080/01621459.1992.10475217}}@article{elliott2017inference, author={Elliott, Michael R. and Valliant, Richard}, title={{Inference for nonprobability samples}}, journal={Statistical Science}, year={2017}, volume={32}, number={2}, pages={249--264}, doi={10.1214/16-sts598}}@article{haziza2017construction, author={Haziza, David and Beaumont, Jean-François}, title={{Construction of weights in surveys: A review}}, journal={Statistical Science}, year={2017}, volume={32}, number={2}, pages={206--226}, doi={10.1214/16-sts608}}@book{kish1965survey, author={Kish, Leslie}, title={{Survey sampling}}, year={1965}, publisher={Wiley}}@article{kolenikov2014calibrating, author={Kolenikov, Stanislav}, title={{Calibrating survey data using iterative proportional fitting (raking)}}, journal={The Stata Journal}, year={2014}, volume={14}, number={1}, pages={22--59}, doi={10.1177/1536867x1401400104}}@article{lumley2004analysis, author={Lumley, Thomas}, title={{Analysis of complex survey samples}}, journal={Journal of Statistical Software}, year={2004}, volume={9}, number={8}, doi={10.18637/jss.v009.i08}}