anweight (European Social Survey, b.d.-c), a PGSS i Diagnozę Społeczną pobierz z Polskiego Archiwum Danych Społecznych razem z dokumentacją wag.Duży sondaż to nie jest duża ankieta
Europejski Sondaż Społeczny (ESS), Polski Generalny Sondaż Społeczny (PGSS) i Diagnoza Społeczna dają próby, których nie zbierzesz w ramach jednego grantu. Kuszą zwłaszcza w doktoracie: dane są gotowe, opisane i można z nich szybko zrobić artykuł. Ogólne zasady pracy na cudzych danych – licencje, odtworzenie opublikowanych wyników, prerejestrację analizy danych, które już widziałeś – omawia wpis reanaliza i wtórna analiza danych. Tutaj skupiamy się na tym, co jest specyficzne dla dużych sondaży: losowaniu warstwowym i wielostopniowym, wagach i dokumentacji.
Plik z takiego sondażu wygląda jak zwykła baza z ankiety, ale nią nie jest. Respondenci mieli różne szanse trafienia do próby, odpowiadali w skupiskach (obszarach, adresach) i część z nich odmówiła. Jeśli to zignorujesz, dostaniesz obciążone średnie i zbyt małe błędy standardowe. West i in. (2016) przejrzeli prace z wtórnymi analizami danych sondażowych i ocenili, że takie błędy analityczne są bardzo częste. Na rzeczywistych danych pokazali, że prowadzą do obciążonych oszacowań i błędów standardowych, które nie odzwierciedlają schematu próby.
ESS, PGSS i Diagnoza Społeczna: dostęp, wagi, dokumentacja
Poniższe informacje pochodzą z oficjalnych stron i z rekordów w Polskim Archiwum Danych Społecznych (PADS), odczytanych 27 października 2026 roku. Zasady dostępu i wersje plików się zmieniają, więc przed pobraniem danych sprawdź je u źródła.
| Badanie | Populacja i schemat | Dostęp | Wagi | Dokumentacja |
|---|---|---|---|---|
| ESS | osoby 15+ w gospodarstwach domowych; losowanie probabilistyczne, bez zastępowania odmów | bezpłatnie do użytku niekomercyjnego, po krótkiej rejestracji w portalu danych ESS | dweight, pspwght, pweight, anweight (zalecana) | zmienne warstw i klastrów: pliki SDDF (PSU, STRATIFY), od rundy 9 w głównym pliku |
| PGSS 1992–2010 | dorośli 18+; 1992–2002 wielostopniowa losowa próba adresowa z operatu GUS | zbiór skumulowany w PADS (Repozytorium Danych Społecznych); warunki dostępu do plików: „All rights reserved” | waga proporcjonalna do liczby dorosłych w gospodarstwie (1992–2002) i ważenie stratyfikacyjne według danych GUS | książka kodów, rozkłady zmiennych, opis próby i procedur ważenia |
| Diagnoza Społeczna | panel gospodarstw domowych i ich członków 16+ | dane 2000–2009 w PADS; warunki dostępu do plików: „All rights reserved” | poststratyfikacja | dokumentacja, kwestionariusze i instrukcja dla ankieterów w rekordzie zbioru |
ESS. Każdy kraj musi osiągnąć efektywną liczebność próby co najmniej 1500 osób (800 w krajach poniżej 2 mln mieszkańców) po uwzględnieniu efektu schematu (European Social Survey, b.d.-b). Wagi trzeba stosować zawsze. ESS zaleca wagę analityczną anweight, która nadaje się do wszystkich analiz (European Social Survey, b.d.-c). Strona o ważeniu opisuje cztery zmienne:
dweight– waga schematu: odwrotność prawdopodobieństwa wylosowania, przeskalowana do średniej 1;pspwght– waga poststratyfikacyjna: wagi schematu skorygowane tak, by odtwarzały rozkład krzyżowy wieku, płci i wykształcenia oraz rozkład regionu;pweight– waga populacyjna, stała w kraju: populacja 15+ / (liczebność próby netto × 10 000); potrzebna, gdy łączysz kraje;anweight=pspwght×pweight; od rundy 9 jest w pliku, dla wcześniejszych rund trzeba ją wyliczyć.
Pliki z jednej rundy łączysz po zmiennych CNTRY i IDNO. Dane cytujesz z numerem edycji i DOI według wzorów ze strony ESS (European Social Survey, b.d.-a), bo kolejne edycje tej samej rundy poprawiają błędy w danych.
PGSS. Celem programu prowadzonego w Instytucie Studiów Społecznych UW był systematyczny pomiar trendów i skutków zmian społecznych w Polsce. Część pytań jest porównywalna z amerykańskim GSS i niemieckim ALLBUS (Instytut Studiów Społecznych UW, b.d.). Skumulowany zbiór 1992–2010 liczy 1681 zmiennych i 17497 obserwacji (Polskie Archiwum Danych Społecznych, b.d.-b). W latach 1992–2002 w wylosowanym gospodarstwie wybierano jedną dorosłą osobę. Szansa wyboru malała więc z liczbą dorosłych, a waga ją wyrównuje. W latach 2005–2008 była to próba imienna, więc tej wagi nie stosowano.
Diagnoza Społeczna. W dniu odczytu oficjalna strona projektu nie była dostępna, dlatego opieramy się na rekordzie w PADS (Polskie Archiwum Danych Społecznych, b.d.-a). To panel: te same gospodarstwa i wszyscy ich dostępni członkowie w wieku 16+. Plik indywidualny 2000–2009 ma 2024 zmienne i 52758 obserwacji. Dane są ważone poststratyfikacyjnie. Rekord podaje też, że w drugiej fazie panelu dolosowano próbę uzupełniającą i dwie próby rezerwowe. To ważna informacja dla analiz przekrojowych i zmian w czasie, dlatego przeczytaj dokumentację wag dla każdej fali osobno.
Warstwy, klastry i wagi: co musisz wiedzieć o schemacie
Ogólnokrajowy sondaż face-to-face zwykle losuje w kilku stopniach. Najpierw dzieli kraj na warstwy (regiony, klasy wielkości miejscowości) i w każdej losuje pierwotne jednostki losowania (PSU), np. obszary spisowe albo gminy. Potem w PSU losuje adresy lub osoby, a czasem jedną osobę w gospodarstwie. Każdy z tych elementów ma inny skutek dla analizy:
- Warstwy zwykle zmniejszają błąd standardowy, bo każda część kraju jest w próbie na pewno.
- Klastry go zwiększają: osoby z jednego obszaru są do siebie podobne, więc wnoszą mniej informacji. Skalę zjawiska opisuje efekt schematu i ICC, a policzysz je w kalkulatorze ICC i efektu schematu.
- Wagi korygują nierówne szanse wyboru i strukturę próby, ale obniżają efektywną liczebność. Jak powstają, pokazujemy we wpisie ważenie danych sondażowych krok po kroku.
Do szacowania wariancji wystarczają zwykle trzy zmienne: warstwa, PSU i waga. Standardowe podejście (linearyzacja „ostatecznego klastra”) traktuje PSU tak, jakby losowano je ze zwracaniem w warstwach. Dalsze stopnie losowania pomija. Pakiet survey w R tak właśnie opisuje schemat i szacuje wariancję przez linearyzację albo replikację (Lumley, 2004). Model wielopoziomowy z efektem losowym obszaru to inne podejście: modeluje zależność zamiast ją korygować (zob. model wielopoziomowy krok po kroku).
Przykład: zaufanie do parlamentu w dwóch krajach
Symulujemy dane o strukturze podobnej do ESS. Kraj A ma 31 mln mieszkańców w wieku 15+, kraj B 4.5 mln. W każdym kraju są 4 warstwy i 100 PSU po 16 wylosowanych osób, a w gospodarstwie losuje się jedną osobę 15+. Młodsi częściej odmawiają, więc po realizacji zostaje 1464 osób w kraju A i 1447 w kraju B. Zmienne wag nazwaliśmy jak w ESS, a liczymy je według wzorów z dokumentacji. Zmienną badaną jest zaufanie do parlamentu na skali 0–10. Dane są symulowane (set.seed(2122)); pobierz je jako plik CSV, aby powtórzyć analizę w R, Stata albo SPSS.
| Kraj | n | M bez wag | M z pspwght | SE prostej próby | SE ze schematu | deff | nef |
|---|---|---|---|---|---|---|---|
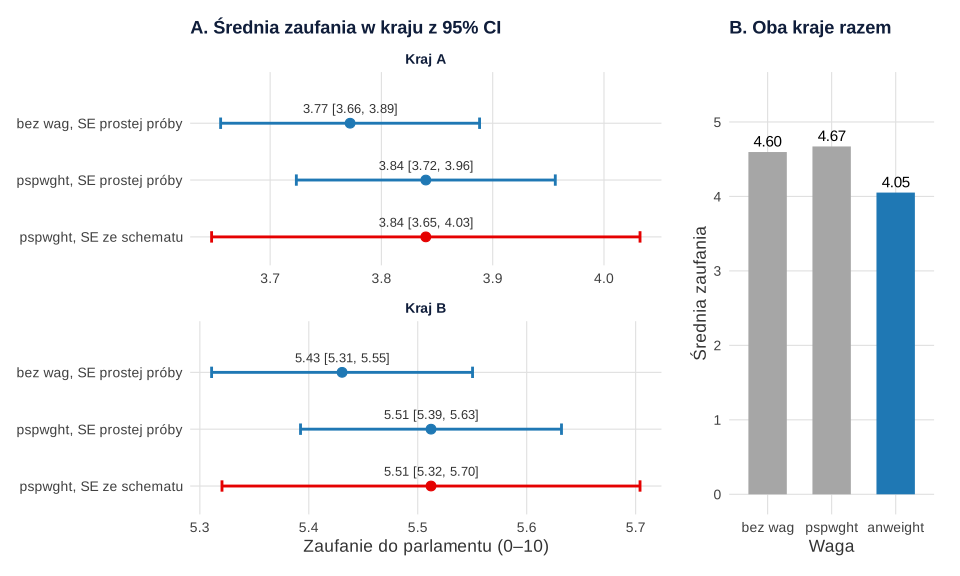
| A | 1464 | 3.77 | 3.84 | 0.059 | 0.098 | 2.74 | 535 |
| B | 1447 | 5.43 | 5.51 | 0.061 | 0.098 | 2.57 | 564 |
Wagi przesuwają średnią niewiele (z 3.77 do 3.84 w kraju A i z 5.43 do 5.51 w kraju B), bo zaufanie słabo zależy od wieku i liczby dorosłych w gospodarstwie. Prawdziwa różnica dotyczy precyzji. Błąd standardowy z uwzględnieniem warstw i klastrów wynosi w kraju A 0.098, a wzór dla prostej próby daje 0.059. Efekt schematu wynosi 2.74 w kraju A, więc 1464 wywiady niosą tyle informacji co około 535 osób z prostej próby losowej. Dlatego ESS wymaga efektywnej, a nie nominalnej liczebności 1500, a margines błędu liczony z nominalnej liczebności byłby zaniżony.
Którą wagę wybrać
W analizie jednego kraju pspwght i anweight dają te same średnie i współczynniki, bo pweight jest w kraju stała. Różnica pojawia się, gdy łączysz kraje. W przykładzie średnia dla obu krajów bez wag wynosi 4.60, z pspwght 4.67, a z anweight 4.05. Tylko ta ostatnia odpowiada populacji obu krajów razem, bo kraj B ma 4.5 mln mieszkańców, a w próbie jest go prawie tyle samo co kraju A. Waga populacyjna jest potrzebna przy oszacowaniach „dla Europy”. Gdy porównujesz kraje między sobą, analizujesz każdy kraj z jego wagami, a różnicę liczysz z błędem, który uwzględnia schemat obu prób. Kaminska i Lynn (2017) pokazują, że pominięcie warstw i klastrów w porównaniach międzynarodowych zniekształca błędy standardowe różnic, zwłaszcza gdy kraje stosują różne schematy.
Regresja na danych sondażowych
Czy w regresji ważyć, to osobne pytanie. Solon i in. (2015) przypominają, że przy opisie populacji ważenie jest potrzebne, gdy próba jej nie odzwierciedla. W modelach efektów częste motywy ważenia nie zawsze jednak mają zastosowanie. Rozsądna praktyka to model ważony z poprawnym błędem standardowym oraz model nieważony z kontrolą zmiennych użytych do ważenia. Jeśli wyniki się rozchodzą, może to oznaczać, że efekt różni się między grupami, a model tego nie uwzględnia. Jedno jest pewne: w regresji liniowej funkcja lm(weights = ) traktuje wagi jak wagi precyzji. Daje współczynniki z wagą, ale jego błędy standardowe nie uwzględniają klastrów ani warstw. W przykładzie dla kraju A:
| Predyktor | b bez wag (SE), p | b z wagą | SE z lm(weights = ) | SE ze schematu, p |
|---|---|---|---|---|
| Wykształcenie wyższe | 0.72 (0.13), p < .001 | 0.68 | 0.13 | 0.17, p < .001 |
| Wiek 60+ | 0.27 (0.12), p = .026 | 0.19 | 0.13 | 0.14, p = .178 |
| Osoba jedyna dorosła w gospodarstwie | −0.26 (0.13), p = .045 | −0.28 | 0.17 | 0.13, p = .040 |
Efekt wieku 60+ jest „istotny” tylko w analizie, która ignoruje wagi i schemat. Po ich uwzględnieniu współczynnik maleje do 0.19, a p rośnie do .178. Testy ze schematu liczymy przy 96 stopniach swobody (liczba PSU minus liczba warstw), a nie przy liczbie osób. Błąd standardowy ze schematu to sandwich z resztami zsumowanymi w PSU, czyli ta sama idea co odporne błędy standardowe, tylko na poziomie klastrów.
Podpopulacje, braki i kody specjalne
Gdy analizujesz podgrupę, np. osoby z wyższym wykształceniem, nie usuwaj pozostałych wierszy przed opisaniem schematu. Po takim usunięciu znikają PSU, w których nie było nikogo z tej grupy, i błąd standardowy jest liczony źle. W pakiecie survey służy do tego subset() na obiekcie schematu. W kodzie ręcznym zerujesz wkład osób spoza podgrupy, ale zostawiasz je w obliczeniach. Przed analizą sprawdź też w książce kodowej, jak zakodowano odmowy, „nie wiem” i pytania nieobjęte filtrem. W plikach .sav są to często osobne wartości liczbowe, które trzeba zamienić na braki danych, zanim policzysz średnią. Jak potraktować same braki, omawia hasło braki danych MCAR, MAR i MNAR.
Jak opisać analizę danych z dużego sondażu
W metodzie podaj: badanie, rundę lub falę, edycję pliku z DOI, populację i schemat doboru, liczebność próby netto, użytą wagę i sposób szacowania wariancji. Zapisz plan analizy, zanim zaczniesz modelować (zob. plan analizy i prerejestracja). Zasady udostępniania własnych danych w podobnej formie opisuje hasło otwarte dane.
Jeśli planujesz artykuł lub rozdział doktoratu na danych z dużego sondażu, możemy razem dobrać wagi, opisać schemat i sprawdzić analizy w ramach wsparcia statystycznego dla badaczy.
Analiza z warstwami, klastrami i wagami w R
Przepis 1 tworzy dane, zapisuje plik sondaz-zlozony-dane.csv i liczy wszystkie wyniki z tekstu w podstawowym R: średnie z błędem z linearyzacji, efekt schematu, średnią dla obu krajów i regresję z błędami standardowymi ze schematu. Przepis 2 pokazuje to samo w pakiecie survey; nie został wykonany, więc nie podajemy jego wyników.
1. Średnie, efekt schematu i regresja ze schematem w podstawowym R
R
# Dane symulowane o strukturze podobnej do dużego sondażu międzynarodowego: dwa kraje (A – duży, B – mały),
# losowanie warstwowe i dwustopniowe (PSU = obszary), jedna osoba losowana w gospodarstwie domowym.
# Zmienna badana: zaufanie do parlamentu (0–10). Nazwy wag jak w dokumentacji ESS: dweight, pspwght, pweight, anweight.
set.seed(2122)
kraj_dane <- function(kraj, n_psu = 100, m = 16, srednia) {
  psu <- rep(seq_len(n_psu), each = m)
  d <- data.frame(cntry = kraj, idno = seq_len(n_psu * m),
                  stratify = paste0(kraj, (psu - 1) %% 4 + 1), psu = paste0(kraj, psu),
                  dorosli = sample(1:4, n_psu * m, TRUE, prob = c(.30, .45, .17, .08)),   # osoby 15+ w gospodarstwie
                  wiek = sample(c("15-34", "35-59", "60+"), n_psu * m, TRUE, prob = c(.24, .40, .36)))
  d$wyzsze <- rbinom(nrow(d), 1, ifelse(d$wiek == "60+", .18, .32))
  d$wiek60 <- as.integer(d$wiek == "60+")
  d$sam <- as.integer(d$dorosli == 1)
  d$zaufanie <- srednia + 0.5 * d$wyzsze - 0.4 * d$sam + 0.3 * d$wiek60 + rnorm(n_psu, 0, 0.75)[psu] + rnorm(nrow(d), 0, 2.2)
  d$zaufanie <- pmin(pmax(round(d$zaufanie), 0), 10)
  d[!(d$wiek == "15-34" & runif(nrow(d)) < .35), ]        # młodsi częściej odmawiają udziału
}
dodaj_wagi <- function(d, populacja, cel = c("15-34" = .24, "35-59" = .40, "60+" = .36)) {
  d$dweight <- d$dorosli / mean(d$dorosli)                   # odwrotność szansy wyboru osoby, średnia 1
  udz <- tapply(d$dweight, d$wiek, sum) / sum(d$dweight)
  d$pspwght <- d$dweight * cel[d$wiek] / udz[d$wiek]        # poststratyfikacja do struktury wieku
  d$pspwght <- d$pspwght / mean(d$pspwght)
  d$pweight <- populacja / (nrow(d) * 10000)                # wzór wagi populacyjnej z dokumentacji ESS
  d$anweight <- d$pspwght * d$pweight
  d
}
dane <- rbind(dodaj_wagi(kraj_dane("A", srednia = 3.6), populacja = 31000000),
              dodaj_wagi(kraj_dane("B", srednia = 5.4), populacja = 4500000))
write.csv(dane, "sondaz-zlozony-dane.csv", row.names = FALSE)
table(dane$cntry)
round(tapply(dane$pweight, dane$cntry, mean), 4)

# Średnia z wagą i błąd standardowy z linearyzacji (warstwy + PSU, przybliżenie „ultimate cluster”)
srednia_schemat <- function(y, w, warstwa, psu) {
  est <- sum(w * y) / sum(w)
  z <- tapply(w * (y - est) / sum(w), psu, sum)
  h <- tapply(warstwa, psu, `[`, 1)[names(z)]
  v <- sum(sapply(split(z, h), function(zh) length(zh) / (length(zh) - 1) * sum((zh - mean(zh))^2)))
  c(srednia = est, SE = sqrt(v))
}
tab <- do.call(rbind, lapply(c("A", "B"), function(k) {
  d <- dane[dane$cntry == k, ]
  ps <- srednia_schemat(d$zaufanie, d$pspwght, d$stratify, d$psu)
  se_prosta <- sd(d$zaufanie) / sqrt(nrow(d))                  # SE jak w prostej próbie losowej
  data.frame(kraj = k, n = nrow(d), M_bez_wag = mean(d$zaufanie), M_pspwght = ps[[1]],
             SE_prosta = se_prosta, SE_schemat = ps[[2]], deff = (ps[[2]] / se_prosta)^2,
             n_ef = nrow(d) / (ps[[2]] / se_prosta)^2,
             dolny95 = ps[[1]] - 1.96 * ps[[2]], gorny95 = ps[[1]] + 1.96 * ps[[2]])
}))
print(cbind(tab[1:2], round(tab[3:10], 3)), row.names = FALSE)

# Średnia dla obu krajów razem: bez wag, z pspwght i z anweight
round(c(bez_wag = mean(dane$zaufanie),
        pspwght = sum(dane$pspwght * dane$zaufanie) / sum(dane$pspwght),
        anweight = sum(dane$anweight * dane$zaufanie) / sum(dane$anweight)), 3)

# Regresja w kraju A: współczynniki z lm(weights = pspwght) i SE z linearyzacji (sandwich z PSU w warstwach)
a <- dane[dane$cntry == "A", ]
m_bez <- lm(zaufanie ~ wyzsze + wiek60 + sam, data = a)
m_w <- lm(zaufanie ~ wyzsze + wiek60 + sam, data = a, weights = pspwght)
X <- model.matrix(m_w); w <- a$pspwght
B <- solve(crossprod(X, w * X))
U <- rowsum(w * residuals(m_w) * X, a$psu)
h <- tapply(a$stratify, a$psu, `[`, 1)[rownames(U)]
M <- Reduce(`+`, lapply(split(as.data.frame(U), h), function(Uh) {
  Uc <- scale(as.matrix(Uh), scale = FALSE)
  nrow(Uh) / (nrow(Uh) - 1) * crossprod(Uc)
}))
se_schemat <- sqrt(diag(B %*% M %*% B))
t_schemat <- coef(m_w) / se_schemat
df_schemat <- length(unique(a$psu)) - length(unique(a$stratify))   # liczba PSU − liczba warstw
round(cbind(b_bez_wag = coef(m_bez), SE_bez_wag = summary(m_bez)$coef[, 2], p_bez_wag = summary(m_bez)$coef[, 4], b_waga = coef(m_w),
            SE_lm_waga = summary(m_w)$coef[, 2], SE_schemat = se_schemat,
            p_schemat = 2 * pt(-abs(t_schemat), df_schemat)), 3)
df_schemat
Wynik w R
   A    B
1464 1447
     A      B
2.1175 0.3110
 kraj    n M_bez_wag M_pspwght SE_prosta SE_schemat  deff    n_ef dolny95
    A 1464     3.772     3.840     0.059      0.098 2.737 534.796   3.647
    B 1447     5.431     5.512     0.061      0.098 2.566 563.856   5.320
 gorny95
   4.032
   5.704
 bez_wag  pspwght anweight
   4.596    4.671    4.052
            b_bez_wag SE_bez_wag p_bez_wag b_waga SE_lm_waga SE_schemat
(Intercept)     3.551      0.095     0.000  3.626      0.090      0.138
wyzsze          0.715      0.134     0.000  0.680      0.134      0.165
wiek60          0.274      0.122     0.026  0.189      0.125      0.140
sam            -0.258      0.129     0.045 -0.276      0.169      0.133
            p_schemat
(Intercept)     0.000
wyzsze          0.000
wiek60          0.178
sam             0.040
[1] 96
2. To samo w pakiecie survey (wymaga pakietu survey, niewykonany)
R
# Wymaga pakietu survey – przepis NIEWYKONANY (pakiet nie jest zainstalowany w środowisku, w którym liczono przykład).
library(survey)
dane <- read.csv("sondaz-zlozony-dane.csv")
# Jeden kraj: PSU zagnieżdżone w warstwach, waga poststratyfikacyjna
schemat_A <- svydesign(ids = ~psu, strata = ~stratify, weights = ~pspwght, nest = TRUE,
                       data = subset(dane, cntry == "A"))
svymean(~zaufanie, schemat_A, deff = TRUE)
summary(svyglm(zaufanie ~ wyzsze + wiek60 + sam, design = schemat_A))
# Podpopulacja: subset() na obiekcie schematu, a nie na ramce danych
svymean(~zaufanie, subset(schemat_A, wyzsze == 1))
# Oba kraje razem: waga anweight
schemat_AB <- svydesign(ids = ~psu, strata = ~stratify, weights = ~anweight, nest = TRUE, data = dane)
svyby(~zaufanie, ~cntry, schemat_AB, svymean)
svymean(~zaufanie, schemat_AB)
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia przepisu 1 w R 4.5.3 (wyłącznie funkcje podstawowe R); rysunek przygotowano w pakietach ggplot2 i patchwork. Przepis 2 wymaga pakietu survey i nie był uruchamiany.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Analiza bez wag albo z inną wagą niż zalecana przez producenta danych, bez uzasadnienia.
- Łączenie krajów bez wagi populacyjnej, gdy wynik ma dotyczyć ich łącznej populacji.
- Błędy standardowe jak dla prostej próby, także z
lm(weights = ). Traktowanie osób z jednego obszaru jako niezależnych to odmiana pseudoreplikacji. - Usuwanie wierszy przed opisaniem schematu przy analizie podgrup.
- Kody odmów i „nie wiem” liczone jak wartości. Najpierw książka kodowa, potem średnie.
- Cytowanie „ESS” bez rundy, edycji i DOI. Bez tego nikt nie odtworzy Twoich liczb.
Najczęstsze pytania
Jak pobrać dane z Europejskiego Sondażu Społecznego?
Według ESS dane są bezpłatne do użytku niekomercyjnego i można je pobrać z portalu danych ESS po krótkiej rejestracji (European Social Survey, b.d.-b). Pobierz zintegrowany plik rundy razem z dokumentacją i zanotuj numer edycji, bo cytujesz go z DOI.
Której wagi użyć w ESS: pspwght czy anweight?
ESS zaleca anweight, iloczyn wagi poststratyfikacyjnej i populacyjnej, do wszystkich analiz (European Social Survey, b.d.-c). W jednym kraju obie wagi dają te same średnie i współczynniki. Różnią się przy łączeniu krajów: w przykładzie średnia dla dwóch krajów wyniosła 4.67 z pspwght i 4.05 z anweight.
Czy w regresji na danych sondażowych trzeba używać wag?
Nie zawsze. Solon i in. (2015) pokazują, że motywy ważenia w modelach efektów często nie mają zastosowania. Rozsądnie jest pokazać model ważony z błędami ze schematu i model nieważony z kontrolą zmiennych ważących. Jeśli wyniki się różnią, może to oznaczać, że efekt zależy od grupy.
Gdzie znaleźć dane PGSS i Diagnozy Społecznej?
Według Instytutu Studiów Społecznych UW zbiory PGSS 1992–2010 i Diagnozy Społecznej 2000–2009 są w Polskim Archiwum Danych Społecznych (Instytut Studiów Społecznych UW, b.d.). Rekordy zbiorów zawierają pliki danych, książkę kodów i opis próby oraz ważenia. Warunki dostępu sprawdź na stronie konkretnego zbioru.
Dlaczego błąd standardowy z danych sondażowych jest większy niż w prostej próbie?
Respondenci z jednego obszaru są do siebie podobni, a zróżnicowane wagi obniżają efektywną liczebność. W przykładzie efekt schematu wyniósł 2.74: 1464 wywiady dały precyzję około 535 osób z prostej próby losowej, a błąd standardowy średniej wzrósł z 0.059 do 0.098.
Powiązane hasła
Przeczytaj też
Ważenie danych sondażowych krok po kroku
Wagi schematu, korekta braku odpowiedzi, raking w R, przycinanie wag, efektywna liczebność Kisha, błąd standardowy i wzór opisu.
Czytaj →PoradnikReanaliza i wtórna analiza cudzych danych
Licencje i warunki użycia, prerejestracja danych wtórnych, test GRIM, zgodność p i analiza wieloświatowa w R – z wzorami opisu i listu do autorów.
Czytaj →PoradnikStatystyka w pracy z socjologii
Sondaż, tabele krzyżowe z resztami, ważenie próby, regresja logistyczna z AME i skale postaw: plan analiz, APA, dane XLSX i kod R.
Czytaj →Piszesz artykuł albo rozdział doktoratu na danych z ESS, PGSS lub Diagnozy Społecznej?
Pomożemy dobrać wagi, opisać schemat doboru, policzyć błędy standardowe i modele oraz wyjaśnić wyniki tak, żebyś mógł(a) je samodzielnie opisać i obronić przed recenzentami.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- European Social Survey. (b.d.-a). Data citation requirements. https://www.europeansocialsurvey.org/data/data-citation-requirements ● Otwarty dostęp
- European Social Survey. (b.d.-b). FAQ. https://www.europeansocialsurvey.org/about/faq ● Otwarty dostęp
- European Social Survey. (b.d.-c). Weighting. https://www.europeansocialsurvey.org/methodology/weighting ● Otwarty dostęp
- Instytut Studiów Społecznych UW. (b.d.). Ośrodek Metodologii Badań Społecznych. Pobrano 27 października 2026 z http://iss.uw.edu.pl/osrodek-metodologii/ ● Otwarty dostęp
- Kaminska, O., & Lynn, P. (2017). Survey-based cross-country comparisons where countries vary in sample design: Issues and solutions. Journal of Official Statistics, 33(1), 123–136. https://doi.org/10.1515/jos-2017-0007 ● Otwarty dostęp
- Lumley, T. (2004). Analysis of complex survey samples. Journal of Statistical Software, 9(8). https://doi.org/10.18637/jss.v009.i08 ● Otwarty dostęp
- Polskie Archiwum Danych Społecznych. (b.d.-a). Diagnoza Społeczna 2009, Warunki i Jakość Życia Polaków [opis zbioru danych]. https://rds.icm.edu.pl/dataset.xhtml?persistentId=doi:10.18150/FK4DAH ● Otwarty dostęp
- Polskie Archiwum Danych Społecznych. (b.d.-b). Polskie Generalne Sondaże Społeczne 1992–2010 [opis zbioru danych]. https://rds.icm.edu.pl/dataset.xhtml?persistentId=doi:10.18150/G5XB6R ● Otwarty dostęp
- Solon, G., Haider, S. J., & Wooldridge, J. M. (2015). What are we weighting for? Journal of Human Resources, 50(2), 301–316. https://doi.org/10.3368/jhr.50.2.301
- West, B. T., Sakshaug, J. W., & Aurelien, G. A. S. (2016). How big of a problem is analytic error in secondary analyses of survey data? PLOS ONE, 11(6), Article e0158120. https://doi.org/10.1371/journal.pone.0158120 ● Otwarty dostęp
Cytowania BibTeX
@misc{esscitation, author={{European Social Survey}}, title={{Data citation requirements}}, year={b.d.-a}, url={https://www.europeansocialsurvey.org/data/data-citation-requirements}}@misc{essfaq, author={{European Social Survey}}, title={{FAQ}}, year={b.d.-b}, url={https://www.europeansocialsurvey.org/about/faq}}@misc{essweighting, author={{European Social Survey}}, title={{Weighting}}, year={b.d.-c}, url={https://www.europeansocialsurvey.org/methodology/weighting}}@misc{issuwosrodekmetodologii, author={{Instytut Studiów Społecznych UW}}, title={{Ośrodek Metodologii Badań Społecznych}}, url={http://iss.uw.edu.pl/osrodek-metodologii/}}@article{kaminska2017survey, author={Kaminska, Olena and Lynn, Peter}, title={{Survey-based cross-country comparisons where countries vary in sample design: Issues and solutions}}, journal={Journal of Official Statistics}, year={2017}, volume={33}, number={1}, pages={123--136}, doi={10.1515/jos-2017-0007}}@article{lumley2004analysis, author={Lumley, Thomas}, title={{Analysis of complex survey samples}}, journal={Journal of Statistical Software}, year={2004}, volume={9}, number={8}, doi={10.18637/jss.v009.i08}}@misc{padsdiagnoza2009, author={{Polskie Archiwum Danych Społecznych}}, title={{Diagnoza Społeczna 2009, Warunki i Jakość Życia Polaków [opis zbioru danych]}}, year={b.d.-a}, url={https://rds.icm.edu.pl/dataset.xhtml?persistentId=doi:10.18150/FK4DAH}}@misc{padspgss19922010, author={{Polskie Archiwum Danych Społecznych}}, title={{Polskie Generalne Sondaże Społeczne 1992–2010 [opis zbioru danych]}}, year={b.d.-b}, url={https://rds.icm.edu.pl/dataset.xhtml?persistentId=doi:10.18150/G5XB6R}}@article{solon2015what, author={Solon, Gary and Haider, Steven J. and Wooldridge, Jeffrey M.}, title={{What are we weighting for?}}, journal={Journal of Human Resources}, year={2015}, volume={50}, number={2}, pages={301--316}, doi={10.3368/jhr.50.2.301}}@article{west2016how, author={West, Brady T. and Sakshaug, Joseph W. and Aurelien, Guy Alain S.}, title={{How big of a problem is analytic error in secondary analyses of survey data?}}, journal={PLOS ONE}, year={2016}, volume={11}, number={6}, eid={e0158120}, doi={10.1371/journal.pone.0158120}}