Pięć typowych projektów w pracy z socjologii
Ilościowa praca z socjologii to najczęściej sondaż: kwestionariusz wypełniony raz przez kilkaset osób, a potem analiza tego, kto co deklaruje i od czego to zależy. Socjologa interesują przede wszystkim różnice między kategoriami społecznymi (wiek, wykształcenie, miejsce zamieszkania, płeć), a nie różnice między warunkami eksperymentu. Stąd w pracach dominują odsetki, tabele krzyżowe, zmienne zero-jedynkowe i skale postaw. Tabela porządkuje pięć projektów, które omawiamy w tym poradniku.
| Projekt | Typowe pytanie | Dane | Analiza główna | Co raportować |
|---|---|---|---|---|
| 1. Sondaż opinii | Jaki odsetek mieszkańców deklaruje udział w wyborach? | pytania zamknięte, pojedyncze pozycje Likerta | odsetki z 95% CI, mediana i rozkład odpowiedzi | przedział ufności, sposób doboru próby |
| 2. Tabela krzyżowa | Czy zaufanie do władz gminy zależy od miejsca zamieszkania? | dwie zmienne kategorialne | test chi-kwadrat niezależności, reszty skorygowane | V Craméra, odsetki w wierszach |
| 3. Ważenie | Jak skorygować nadreprezentację młodych i wykształconych? | metryczka i znana struktura populacji | raking (dopasowanie rozkładów brzegowych) | zakres wag, efekt schematu, efektywna n |
| 4. Regresja logistyczna | Od czego zależy deklarowany udział w wyborach? | wynik tak/nie, kilka predyktorów | regresja logistyczna | OR z 95% CI, średnie efekty krańcowe |
| 5. Skala postaw | Czy postawy wobec partycypacji różnią się według wykształcenia? | kilka pozycji 1–5, w tym odwrócone | alfa i omega, ANOVA Welcha, korelacja Spearmana | ω², ρ, różnice parami z CI |
Wszystkie przykłady liczymy na jednym symulowanym sondażu. 800 dorosłych z panelu internetowego odpowiedziało na pytania o udział w ostatnich wyborach samorządowych, wolontariat w ostatnim roku, zaufanie do władz gminy i postawy wobec udziału mieszkańców w decyzjach lokalnych. Dane z wagami możesz pobrać jako plik XLSX (arkusz z danymi, arkusz z umowną strukturą populacji i opis zmiennych) i powtórzyć analizy w dowolnym programie. Pokrewne poradniki dla innych kierunków to statystyka w pracy z pedagogiki i statystyka w pracy z logopedii.
Zanim zaczniesz liczyć: jak powstała próba
W socjologii pierwsze pytanie recenzenta nie dotyczy testu, tylko próby. Od sposobu jej doboru zależy, czy w ogóle wolno uogólniać wyniki na populację. Próba losowa pozwala policzyć błąd losowy i zinterpretować przedział ufności dosłownie. Próba z ankiety udostępnionej w mediach społecznościowych, z panelu internetowego czy metodą kuli śnieżnej jest próbą nielosową. Cornesse i in. (2020) podsumowują, że zaufanie do prób losowych opiera się na teorii statystycznej, a trafność wniosków z prób nielosowych zależy całkowicie od przyjętych modeli. Grupa zadaniowa AAPOR doszła do podobnego wniosku: wnioskowanie z próby nielosowej zawsze wymaga założeń, które trzeba jawnie opisać, a przejrzystość doboru, zbierania danych i ważenia jest tu jeszcze ważniejsza niż przy próbie losowej (Baker i in., 2013).
W praktyce pracy dyplomowej oznacza to trzy rzeczy:
- Opisz dobór dokładnie: gdzie i kiedy zbierano odpowiedzi, kto mógł je wypełnić, ile osób zaczęło, a ile skończyło ankietę. Pomocny jest poradnik rodzaje badań ankietowych.
- Porównaj strukturę próby ze strukturą populacji pod względem płci, wieku, wykształcenia i miejsca zamieszkania. Dane o populacji weź z oficjalnej statystyki publicznej (GUS) dla tej populacji, którą badasz.
- Nie nazywaj próby „reprezentatywną”, jeśli była dobierana wygodnie. Napisz raczej, pod jakimi względami odbiega od populacji i jak próbowałeś to skorygować.
Groves i Lyberg (2010) opisują ramę całkowitego błędu badania sondażowego (total survey error), która porządkuje źródła błędów od projektu badania po realizację. Błąd losowy, który mierzy przedział ufności, jest tylko jednym z nich. Obok niego działają m.in. błędy pokrycia, braku odpowiedzi i pomiaru. Warto o tym pamiętać, pisząc ograniczenia pracy.
Projekt 1. Sondaż opinii: odsetki, przedziały ufności i margines błędu
Podstawą każdej pracy sondażowej jest opis rozkładów. W naszej próbie udział w ostatnich wyborach samorządowych zadeklarowało 515 z 800 osób, czyli 64.4%, 95% CI [61.0, 67.6]. Wolontariat w ostatnich 12 miesiącach zadeklarowało 191 osób (23.9%, 95% CI [21.1, 26.9]). Przedziały policzono metodą Wilsona, która przy odsetkach daje lepsze pokrycie niż prosty wzór z błędem standardowym (zob. przedział ufności dla proporcji).
W raportach z sondaży często pojawia się margines błędu. Dla próby losowej liczącej 800 osób i odsetka 50% wynosi on ±3.46 punktu procentowego. Ta liczba ma jednak dwa ograniczenia. Po pierwsze, formalnie dotyczy tylko próby losowej, a nasza pochodzi z panelu internetowego. Po drugie, nawet w sondażach losowych obejmuje tylko błąd losowy. Shirani-Mehr i in. (2018) przeanalizowali 4221 sondaży przedwyborczych i ustalili, że rzeczywisty przeciętny błąd był mniej więcej dwa razy większy, niż sugerowały podawane marginesy błędu. W pracy z próbą nielosową możesz podać przedział ufności, ale opisz go jako miarę precyzji przy założeniu losowości, a nie jako gwarancję trafności.
Deklaracje dotyczące zachowań cenionych społecznie, takich jak głosowanie, bywają zawyżane. Tourangeau i Yan (2007) pokazali w przeglądzie badań, że błędne raportowanie przy pytaniach drażliwych jest częste i zależy od sytuacji badania, m.in. od obecności ankietera. Dlatego w pracy pisz o „deklarowanym udziale w wyborach”, a nie o frekwencji. Mechanizm ten opisujemy w haśle aprobata społeczna.
Pojedyncze pytanie o zaufanie (od 1 – „zdecydowanie nie ufam” do 5 – „zdecydowanie ufam”, z odpowiedzią środkową „trudno powiedzieć”) opisuj rozkładem odpowiedzi i medianą, a nie samą średnią. W próbie odpowiedzi rozkładały się tak: 14.8%, 21.9%, 23.2%, 24.9% i 15.2%, mediana wyniosła 3 (Q1 = 2, Q3 = 4). Zastanów się, czy odpowiedź „trudno powiedzieć” to naprawdę środek skali, czy brak opinii. Od tej decyzji zależy, czy możesz ją traktować jako punkt skali porządkowej (zob. odpowiedź „nie wiem” i „trudno powiedzieć”). Jeśli chcesz modelować taką odpowiedź jako zmienną zależną, zamiast regresji liniowej użyj regresji porządkowej.
Projekt 2. Tabela krzyżowa: zaufanie a miejsce zamieszkania
Tabela krzyżowa to najbardziej socjologiczna z analiz: pokazuje, jak rozkład jednej cechy zmienia się w kategoriach drugiej. Odpowiedzi o zaufaniu do władz gminy zredukowaliśmy do trzech kategorii: „nie ufa” (1–2), „trudno powiedzieć” (3) i „ufa” (4–5). Następnie zestawiliśmy je z miejscem zamieszkania.
| Miejsce zamieszkania | Nie ufa | Trudno powiedzieć | Ufa |
|---|---|---|---|
| Wieś (n = 182) | 39 (21.4%) | 38 (20.9%) | 105 (57.7%) |
| Miasto do 100 tys. (n = 273) | 109 (39.9%) | 52 (19.0%) | 112 (41.0%) |
| Miasto 100 tys. i więcej (n = 345) | 145 (42.0%) | 96 (27.8%) | 104 (30.1%) |
Test chi-kwadrat niezależności wskazuje na związek obu zmiennych: χ²(4) = 43.28, p < .001, V Craméra = .16. Najmniejsza liczebność oczekiwana wyniosła 42.3, więc warunki testu były spełnione z dużym zapasem. Odsetki podajemy w wierszach, bo pytanie brzmi: „jak ufają mieszkańcy wsi, a jak mieszkańcy dużych miast?”. Kierunek procentowania wybieraj zawsze według zmiennej, którą traktujesz jako wyjaśniającą.
Sam wynik testu mówi tylko, że tabela odbiega od niezależności. Które komórki „robią” wynik, pokazują reszty standaryzowane skorygowane, przeniesione na tabele krzyżowe z analizy regresji przez Habermana (1973). Sharpe (2015) porównał cztery sposoby szukania źródła istotnego wyniku chi-kwadrat, a analiza reszt jest wśród nich najprostsza do opisania w pracy. Reszta większa niż 1.96 co do wartości bezwzględnej oznacza komórkę wyraźnie liczniejszą albo mniej liczną, niż wynikałoby z niezależności. Przy wielu komórkach warto przyjąć ostrzejszy próg.
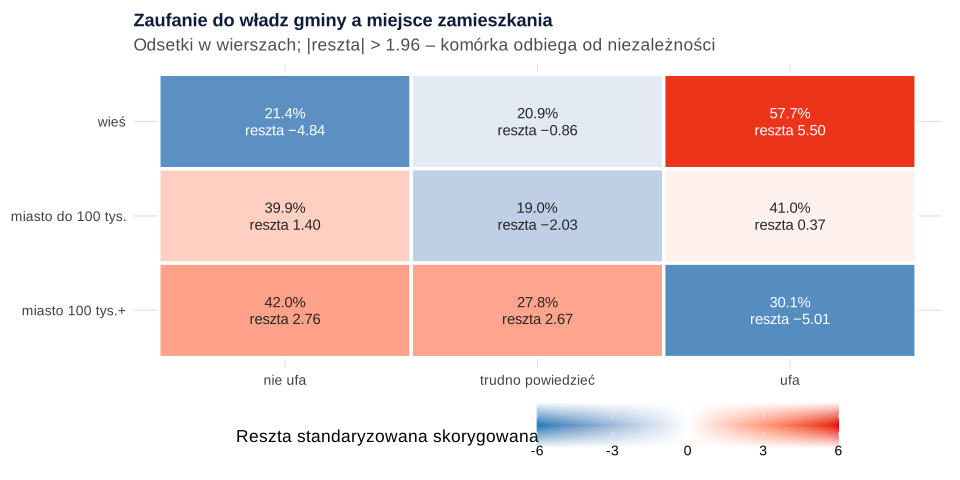
W tym przykładzie wynik tworzą przede wszystkim dwa krańce: mieszkańcy wsi częściej ufają władzom gminy (reszta 5.50), a mieszkańcy dużych miast rzadziej (−5.01) i częściej wybierają „trudno powiedzieć” (2.67). Mniejsze miasta nie odbiegają wyraźnie od rozkładu ogólnego. Krok po kroku, z liczebnościami oczekiwanymi, testem Fishera i wykresem słupkowym skumulowanym, opisujemy tę analizę w poradniku test chi-kwadrat krok po kroku.
Pamiętaj o poziomie wniosku. Tabela mówi o różnicach między kategoriami osób, a nie o tym, że „wieś sprzyja zaufaniu”. Jeszcze większa ostrożność obowiązuje, gdy analizujesz dane zagregowane, np. wskaźniki gmin, i przenosisz wnioski na jednostki. To klasyczny błąd ekologiczny.
Projekt 3. Ważenie danych: gdy próba nie przypomina populacji
Ankiety internetowe mają typowy profil: odpowiadają częściej kobiety, osoby młode, z wyższym wykształceniem i z dużych miast. Bethlehem (2010) pokazał, że niedopokrycie i samoselekcja respondentów mogą obciążać oszacowania z badań internetowych. Przeanalizował też techniki korekty, w tym ważenie, i doszedł do wniosku, że problem samoselekcji pozostaje: prowadzi ona do niewiarygodnych wyników. Nasza próba odbiega od umownej struktury populacji przyjętej w przykładzie na wszystkich czterech zmiennych. Osób z wyższym wykształceniem jest w niej 40.1% zamiast 22%, osób w wieku 55+ – 21.2% zamiast 40%, a mieszkańców wsi – 22.8% zamiast 40%.
Najczęściej stosowana w takich sytuacjach metoda to raking, czyli iteracyjne dopasowanie rozkładów brzegowych. Algorytm na przemian koryguje wagi tak, aby ważony rozkład każdej zmiennej zgadzał się z populacją: najpierw płci, potem wieku, wykształcenia i miejsca zamieszkania, i tak w kółko, aż wagi przestaną się zmieniać. Wystarczy znać rozkłady brzegowe, a nie pełną tabelę wszystkich kombinacji. W przykładzie zbieżność nastąpiła po 7 iteracjach. Więcej o rodzajach wag piszemy w haśle ważenie danych i wagi poststratyfikacyjne.
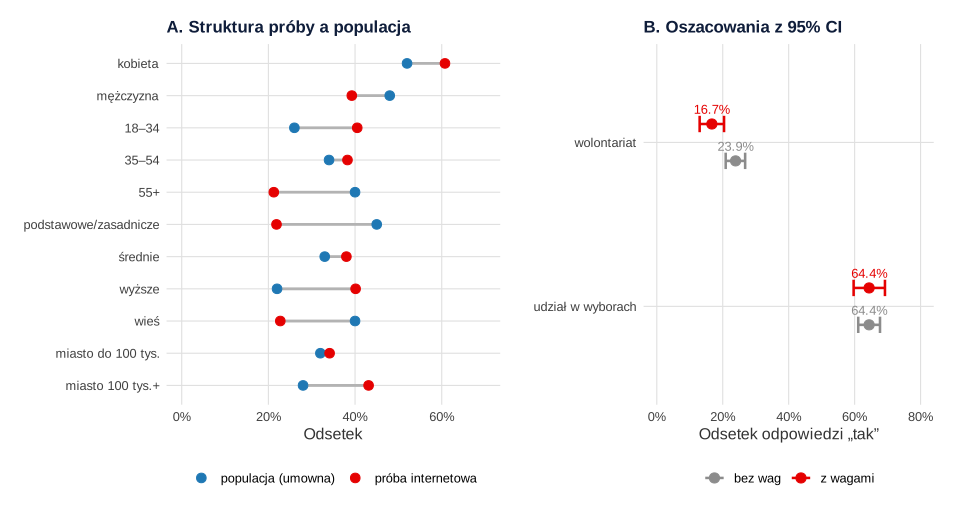
Wynik ważenia jest pouczający. Odsetek osób deklarujących wolontariat spadł z 23.9% do 16.7%. Wolontariat częściej deklarowały osoby z wyższym wykształceniem, a tych w próbie było za dużo. Deklarowany udział w wyborach się nie zmienił (64.4% w obu wersjach). Dwie korekty działały tu w przeciwnych kierunkach: zwiększenie wagi osób starszych, które częściej głosują, i zmniejszenie wagi osób z wyższym wykształceniem, które także częściej głosują. Ważenie zmienia wynik tylko wtedy, gdy zmienna wiąże się z cechami, według których ważysz. Nie zmniejsza też błędu wynikającego z cech, których nie uwzględniono w wagach, np. zainteresowania polityką.
Ważenie ma swoją cenę. Wagi wahały się od 0.18 do 10.02, a ich współczynnik zmienności wyniósł 1.03. Typowe przybliżenie Kisha, czyli 1 + CV², daje efekt schematu 2.06. Oznacza to, że pod względem precyzji 800 ważonych odpowiedzi odpowiada mniej więcej 388 odpowiedziom z próby losowej. Dlatego przedziały ufności z wagami są szersze: dla udziału w wyborach [59.7, 69.2] zamiast [61.1, 67.7]. Przedziały w tej części policzyliśmy prostszym wzorem z efektywną liczebnością próby, stąd minimalne różnice względem metody Wilsona w projekcie 1.
Bardzo duże wagi pojedynczych osób, takie jak 10.02, zwiększają wariancję oszacowań. Częstym kompromisem jest przycięcie wag. Po obcięciu ich do wartości 5 i ponownym przeskalowaniu efekt schematu spadł do 1.9 (efektywna liczebność 426.5), a odsetek wolontariatu wyniósł 17.0%. Rozkład wykształcenia przestał jednak dokładnie odpowiadać populacji (44.0% zamiast 45% dla wykształcenia podstawowego lub zasadniczego). Jeśli przycinasz wagi, podaj próg i powód.
Standardowym narzędziem do analiz ważonych w R jest pakiet survey, który opisuje schemat doboru i szacuje wariancję przez linearyzację albo replikację (Lumley, 2004). Elliott i Valliant (2017) przypominają, że klasyczne wnioskowanie oparte na schemacie losowania nie ma zastosowania do prób nielosowych, a obie omawiane przez nich alternatywy (szacowanie pseudoprawdopodobieństw włączenia i modelowanie) opierają się na założeniach modelu. W praktyce ważenie zakłada, że w obrębie kategorii ważenia respondenci nie różnią się od osób, które nie trafiły do próby. To założenie trzeba nazwać w ograniczeniach.
Projekt 4. Regresja logistyczna: kto deklaruje udział w wyborach
Gdy zmienna zależna ma dwie wartości (głosował – nie głosował, działa – nie działa w organizacji), zamiast serii tabel krzyżowych użyj regresji logistycznej. Pozwala ona ocenić związek każdej cechy przy kontroli pozostałych. Do modelu wprowadziliśmy płeć, kategorię wieku, wykształcenie, miejsce zamieszkania i wynik skali postaw wobec partycypacji (projekt 5). Zmienne kategorialne weszły jako zmienne zero-jedynkowe, z kategorią odniesienia podaną w tabeli (zob. dummy coding). Model jako całość był istotnie lepszy od modelu pustego, χ²(8) = 108.08, p < .001. Pseudo-R² wyniosło .104 (McFadden) i .174 (Nagelkerke). Te wartości nie są odsetkiem wyjaśnionej wariancji, więc nie porównuj ich z R² z regresji liniowej.
| Predyktor (kategoria odniesienia) | OR | 95% CI | p |
|---|---|---|---|
| Mężczyzna (kobieta) | 1.03 | [0.75, 1.42] | .859 |
| Wiek 35–54 (18–34) | 1.73 | [1.23, 2.45] | .002 |
| Wiek 55+ (18–34) | 3.09 | [2.00, 4.84] | < .001 |
| Wykształcenie średnie (podstawowe/zasadnicze) | 1.56 | [1.04, 2.32] | .030 |
| Wykształcenie wyższe (podstawowe/zasadnicze) | 2.35 | [1.56, 3.54] | < .001 |
| Miasto do 100 tys. (wieś) | 0.63 | [0.40, 0.96] | .034 |
| Miasto 100 tys. i więcej (wieś) | 0.62 | [0.41, 0.94] | .025 |
| Postawy wobec partycypacji (1 punkt) | 1.95 | [1.61, 2.37] | < .001 |
Iloraz szans 2.35 dla wykształcenia wyższego oznacza, że szansa (stosunek prawdopodobieństwa udziału do prawdopodobieństwa nieudziału) jest u tych osób 2.35 razy większa niż u osób z wykształceniem podstawowym lub zasadniczym przy tych samych wartościach pozostałych zmiennych. Nie znaczy to, że osoby te głosują „2.35 razy częściej”. Davies i in. (1998) pokazali, że iloraz szans czytany jak ryzyko względne zawsze zawyża efekt, a rozbieżność rośnie wraz z częstością zjawiska. Przy wyniku, który dotyczy 64% badanych, ta różnica jest duża.
W socjologii jest jeszcze drugi problem. Mood (2010) wykazała w European Sociological Review, że ilorazy szans zmieniają się po dodaniu do modelu zmiennych, nawet nieskorelowanych z predyktorami, bo odzwierciedlają też nieobserwowaną heterogeniczność. Nie można więc wprost porównywać OR między modelami z różnymi zestawami zmiennych, między grupami ani między falami badania. Dlatego obok OR coraz częściej podaje się średnie efekty krańcowe (AME), czyli przeciętną różnicę przewidywanych prawdopodobieństw. W przykładzie osoby z wykształceniem wyższym miały prawdopodobieństwo deklarowanego udziału wyższe średnio o 17.6 punktu procentowego, 95% CI [10.0, 26.0], a osoby z wykształceniem średnim – o 9.5 punktu, 95% CI [0.5, 17.9] (przedziały z 500 prób bootstrapowych). Taki wynik zrozumie każdy czytelnik.
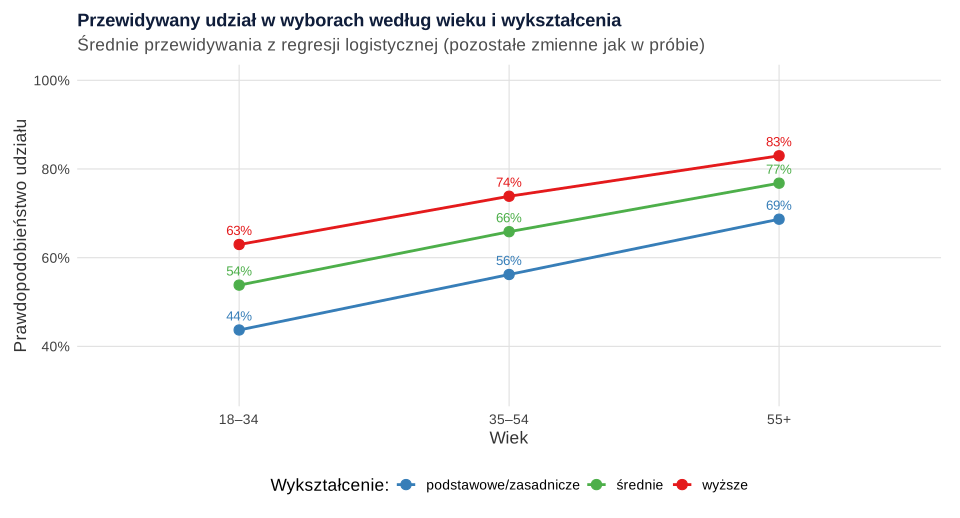
Rysunek przewidywanych prawdopodobieństw to najlepszy sposób, by pokazać wynik regresji logistycznej promotorowi. Widać na nim, że przewidywany udział rośnie od 44% (młodzi, wykształcenie podstawowe lub zasadnicze) do 83% (osoby 55+ z wyższym wykształceniem). Założenia, diagnostykę, krzywą ROC i interpretację współczynników opisujemy osobno w poradniku regresja logistyczna krok po kroku.
Czy model liczyć z wagami? To zależy od celu analizy i od tego, czy zmienne ważenia są już w modelu. Bezpiecznym rozwiązaniem w pracy dyplomowej jest pokazanie obu wersji. W wersji ważonej, liczonej z odpornymi błędami standardowymi, OR dla wieku 55+ spadł z 3.09 do 2.64, a dla postaw wzrósł z 1.95 do 2.32. Błędy standardowe były wyraźnie większe, np. dla postaw 0.136 zamiast 0.099. Jeśli wnioski z obu wersji są zgodne, napisz to w jednym zdaniu. Jeśli się różnią, opisz to jako ograniczenie.
Projekt 5. Skala postaw: rzetelność, wynik i porównanie grup
Postawy mierzy się w socjologii zestawem twierdzeń, z którymi respondent zgadza się lub nie, na skali Likerta. W przykładzie skala postaw wobec udziału mieszkańców w decyzjach lokalnych ma 6 pozycji (od 1 do 5). Dotyczą one m.in. sensu konsultacji społecznych i gotowości do udziału w zebraniach. Dwie pozycje (3 i 5) są sformułowane odwrotnie. Jeśli korzystasz z gotowej skali z literatury, zasady liczenia wyniku i numery pozycji odwróconych weź z publikacji autorów i opisz narzędzie według poradnika opis narzędzia badawczego – wzór. Jeśli budujesz skalę sam, przeprowadź pilotaż i opisz jej konstrukcję w metodzie.
Kolejność kroków jest stała:
- Odwróć pozycje sformułowane w przeciwnym kierunku (6 − odpowiedź przy skali 1–5), zanim policzysz cokolwiek innego. Pominięcie tego kroku obniża rzetelność i zniekształca wynik (zob. pozycja odwrócona).
- Sprawdź rzetelność. Alfa Cronbacha wyniosła .84, a korelacje pozycji z resztą skali – od .59 do .63. Dunn i in. (2014) proponują obok alfy podawać omegę McDonalda, która nie zakłada równych ładunków. Tu omega wyniosła .84, a ładunki w modelu jednoczynnikowym mieściły się w przedziale .66–.71.
- Policz wynik jako średnią pozycji (tu M = 3.21, SD = 0.85). Średnia jest wygodniejsza od sumy, bo zostaje w jednostkach skali odpowiedzi. Szczegóły, także postępowanie z brakami w pojedynczych pozycjach, opisujemy w poradniku jak policzyć wynik kwestionariusza.
Wynik skali z kilku pozycji można analizować testami parametrycznymi. Postawy różniły się w zależności od wykształcenia: od M = 2.99 (SD = 0.85, n = 175) przy wykształceniu podstawowym lub zasadniczym, przez 3.13 (SD = 0.81, n = 304) przy średnim, do 3.41 (SD = 0.85, n = 321) przy wyższym. ANOVA Welcha: F(2, 450.27) = 16.08, p < .001, ω² = .06. Porównania parami testem Gamesa–Howella pokazały, że osoby z wyższym wykształceniem różniły się od osób z wykształceniem podstawowym lub zasadniczym (różnica 0.42, 95% CI [0.23, 0.61], p < .001) i średnim (0.28, 95% CI [0.12, 0.43], p < .001). Dwie niższe kategorie nie różniły się istotnie (0.14, 95% CI [−0.04, 0.33], p = .168). Postawy korelowały też z zaufaniem do władz gminy: korelacja Spearmana ρ = .26, p < .001. Spearmana wybraliśmy, bo zaufanie mierzy jedno pytanie porządkowe.
Jeżeli porównujesz grupy na skali postaw, a różnice mają być sednem pracy, pomyśl o tym, czy pozycje znaczą to samo w każdej grupie. To pytanie o inwariancję pomiaru, ważne zwłaszcza przy porównaniach krajów lub fal badania. Gdy w ankiecie są pytania otwarte, np. „dlaczego nie bierze Pan(i) udziału w konsultacjach?”, zakoduj je według klucza i opisz liczebności kategorii. Procedurę pokazujemy w poradniku analiza treści pytań otwartych.
Co opisać w rozdziale metodologicznym
W pracy sondażowej opis metody jest równie ważny jak wyniki. Ogólną strukturę tego rozdziału omawiamy w poradniku rozdział metodologiczny – jak go napisać. W socjologii szczególnie ważne są:
- populacja, operat i sposób doboru próby, z jasnym rozróżnieniem doboru losowego i nielosowego;
- tryb realizacji (ankieta internetowa, telefoniczna, z ankieterem) i okres badania;
- liczba osób zaproszonych, rozpoczętych i zakończonych ankiet oraz kryteria wykluczenia odpowiedzi;
- porównanie struktury próby z populacją, źródło danych o populacji i procedura ważenia (zmienne, metoda, przycięcie wag, efekt schematu);
- przy każdej skali: liczba pozycji, skala odpowiedzi, pozycje odwrócone, sposób liczenia wyniku i rzetelność w Twojej próbie;
- analizy statystyczne, z informacją, czy wyniki są ważone.
Jeśli nie wiesz, jak dobrać wagi albo analizy do swojego sondażu, możesz je skonsultować ze statystykiem w ramach oferty analizy statystyczne dla studentów. Wyniki musisz jednak rozumieć i umieć obronić samodzielnie, a pomoc ujawnić zgodnie z zasadami uczelni.
Sondaż od opisu do regresji w R
Sześć przepisów tworzy jeden ciąg analiz na tych samych danych symulowanych. Uruchamiaj je po kolei w jednej sesji R, bo każdy kolejny korzysta z obiektów utworzonych wcześniej (ramka d, tabela, wagi, model). Pakiet survey, standardowe narzędzie do ważonych analiz sondażowych, nie był dostępny w środowisku, w którym liczyliśmy przykład, dlatego ważenie i odporne błędy standardowe pokazujemy za pomocą funkcji bazowego R i pakietu sandwich.
1. Dane sondażu, odsetki z 95% CI i margines błędu
R
# Krok 1: sondaż internetowy o aktywności obywatelskiej mieszkańców (dane symulowane).
# 800 dorosłych z panelu internetowego (dobór nielosowy); metryczka, udział w wyborach samorządowych (deklaracja),
# wolontariat w ostatnich 12 miesiącach, zaufanie do władz gminy (1–5) i 6 pozycji skali postaw wobec partycypacji (1–5).
set.seed(7301)
n <- 800
plec <- factor(sample(c("kobieta", "mężczyzna"), n, TRUE, prob = c(.62, .38)), levels = c("kobieta", "mężczyzna"))
wiek_kat <- factor(sample(c("18–34", "35–54", "55+"), n, TRUE, prob = c(.42, .36, .22)), levels = c("18–34", "35–54", "55+"))
wyksztalcenie <- factor(sample(c("podstawowe/zasadnicze", "średnie", "wyższe"), n, TRUE, prob = c(.22, .36, .42)),
                        levels = c("podstawowe/zasadnicze", "średnie", "wyższe"))
miejsce <- factor(sample(c("wieś", "miasto do 100 tys.", "miasto 100 tys.+"), n, TRUE, prob = c(.25, .33, .42)),
                  levels = c("wieś", "miasto do 100 tys.", "miasto 100 tys.+"))
# skala postaw wobec partycypacji lokalnej: 6 pozycji 1–5, pozycje 3 i 5 sformułowane odwrotnie
cecha <- rnorm(n, 0.25 * (as.integer(wyksztalcenie) - 2) + 0.15 * (miejsce == "wieś"), 1)
poz <- sapply(1:6, function(j) { x <- 3.1 + 0.85 * cecha + rnorm(n, 0, 0.85); if (j %in% c(3, 5)) x <- 6 - x
  pmin(5, pmax(1, round(x))) })
colnames(poz) <- sprintf("pp%d", 1:6)
postawy <- rowMeans(cbind(poz[, c(1, 2, 4, 6)], 6 - poz[, c(3, 5)]))
# zaufanie do władz gminy 1–5 (3 = trudno powiedzieć)
zauf_lat <- 0.35 * cecha + 0.45 * (miejsce == "wieś") - 0.2 * (miejsce == "miasto 100 tys.+") + rnorm(n, 0, 1)
zaufanie <- as.integer(cut(zauf_lat, c(-Inf, -1.1, -0.35, 0.25, 1.1, Inf)))
# udział w ostatnich wyborach samorządowych (deklaracja) i wolontariat
lp_w <- -0.55 + c(0, 0.55, 1.15)[as.integer(wiek_kat)] + c(0, 0.45, 0.95)[as.integer(wyksztalcenie)] +
  0.15 * (miejsce == "wieś") + 0.65 * (postawy - 3.1)
wybory <- rbinom(n, 1, plogis(lp_w))
lp_v <- -1.75 + c(0, 0.35, 0.9)[as.integer(wyksztalcenie)] + c(0.25, 0, -0.35)[as.integer(wiek_kat)] + 0.5 * (postawy - 3.1)
wolontariat <- rbinom(n, 1, plogis(lp_v))
d <- data.frame(id = 1:n, plec, wiek_kat, wyksztalcenie, miejsce, wybory, wolontariat, zaufanie, poz, postawy)

# Opis: odsetki z 95% CI (Wilson, bez korekty ciągłości) i margines błędu dla p = .5
odsetek <- function(x) { k <- sum(x); ci <- prop.test(k, length(x), correct = FALSE)$conf.int
  round(c(n = length(x), k = k, proc = 100 * k / length(x), CI_dol = 100 * ci[1], CI_gora = 100 * ci[2]), 1) }
rbind(wybory = odsetek(d$wybory), wolontariat = odsetek(d$wolontariat))
round(100 * 1.96 * sqrt(.25 / n), 2)                                # margines błędu (pp) przy próbie losowej n = 800
# zaufanie do władz gminy: rozkład odpowiedzi (1 = zdecydowanie nie ufam … 5 = zdecydowanie ufam)
round(100 * prop.table(table(d$zaufanie)), 1)
c(Me = median(d$zaufanie), Q1 = unname(quantile(d$zaufanie, .25)), Q3 = unname(quantile(d$zaufanie, .75)))
# struktura próby (w %)
lapply(d[, c("plec", "wiek_kat", "wyksztalcenie", "miejsce")], function(x) round(100 * prop.table(table(x)), 1))
Wynik w R
              n   k proc CI_dol CI_gora
wybory      800 515 64.4   61.0    67.6
wolontariat 800 191 23.9   21.1    26.9
[1] 3.46

   1    2    3    4    5
14.8 21.9 23.2 24.9 15.2
Me Q1 Q3
 3  2  4
$plec
x
  kobieta mężczyzna
     60.8      39.2

$wiek_kat
x
18–34 35–54   55+
 40.5  38.2  21.2

$wyksztalcenie
x
podstawowe/zasadnicze               średnie                wyższe
                 21.9                  38.0                  40.1

$miejsce
x
              wieś miasto do 100 tys.   miasto 100 tys.+
              22.8               34.1               43.1
2. Tabela krzyżowa, chi-kwadrat i reszty standaryzowane skorygowane
R
# Krok 2 (kontynuacja kroku 1): tabela krzyżowa – zaufanie do władz gminy (3 kategorie) a miejsce zamieszkania
d$zauf3 <- factor(cut(d$zaufanie, c(0, 2, 3, 5), labels = c("nie ufa", "trudno powiedzieć", "ufa")))
tab <- table(d$miejsce, d$zauf3); tab
round(100 * prop.table(tab, 1), 1)                                  # odsetki w wierszach
chi <- chisq.test(tab); chi
round(min(chi$expected), 1)                                         # najmniejsza liczebność oczekiwana
round(chi$stdres, 2)                                                # reszty standaryzowane skorygowane
round(unlist(as.data.frame(effectsize::cramers_v(tab, adjust = FALSE))[, c(1, 3, 4)]), 2)
Wynik w R
                     nie ufa trudno powiedzieć ufa
  wieś                    39                38 105
  miasto do 100 tys.     109                52 112
  miasto 100 tys.+       145                96 104

                     nie ufa trudno powiedzieć  ufa
  wieś                  21.4              20.9 57.7
  miasto do 100 tys.    39.9              19.0 41.0
  miasto 100 tys.+      42.0              27.8 30.1

	Pearson's Chi-squared test

data:  tab
X-squared = 43.277, df = 4, p-value = 9.064e-09

[1] 42.3

                     nie ufa trudno powiedzieć   ufa
  wieś                 -4.84             -0.86  5.50
  miasto do 100 tys.    1.40             -2.03  0.37
  miasto 100 tys.+      2.76              2.67 -5.01
Cramers_v    CI_low   CI_high
     0.16      0.12      1.00
3. Ważenie przez raking, efekt schematu i oszacowania ważone
R
# Krok 3 (kontynuacja): ważenie przez raking (iteracyjne dopasowanie rozkładów brzegowych).
# Rozkłady w populacji są umowne – w prawdziwym badaniu weź je z danych statystyki publicznej (GUS) dla badanej populacji.
popul <- list(plec = c(kobieta = .52, mężczyzna = .48),
              wiek_kat = c("18–34" = .26, "35–54" = .34, "55+" = .40),
              wyksztalcenie = c("podstawowe/zasadnicze" = .45, "średnie" = .33, "wyższe" = .22),
              miejsce = c("wieś" = .40, "miasto do 100 tys." = .32, "miasto 100 tys.+" = .28))
raking <- function(dane, cele, maks_iter = 100, tol = 1e-8) {
  w <- rep(1, nrow(dane))
  for (it in 1:maks_iter) {
    w_stare <- w
    for (z in names(cele)) {
      udz <- tapply(w, dane[[z]], sum) / sum(w)                       # obecny rozkład ważony
      w <- w * (cele[[z]][as.character(dane[[z]])] / udz[as.character(dane[[z]])])
    }
    if (max(abs(w - w_stare)) < tol) break
  }
  w <- unname(w / mean(w))                                          # średnia waga = 1
  attr(w, "iteracje") <- it; w
}
d$waga <- raking(d, popul)
attr(d$waga, "iteracje")
# kontrola: rozkład ważony = rozkład populacji
sapply(names(popul), function(z) round(100 * tapply(d$waga, d[[z]], sum) / sum(d$waga), 1))
# rozrzut wag, efekt schematu ważenia (Kish: 1 + CV²) i efektywna liczebność próby
cv <- sd(d$waga) / mean(d$waga)
round(c(min = min(d$waga), max = max(d$waga), CV = cv, deff = 1 + cv^2, n_efekt = n / (1 + cv^2)), 2)
# odsetki bez wag i z wagami (przybliżony 95% CI z efektywną liczebnością próby)
ocena <- function(y, w) { neff <- sum(w)^2 / sum(w^2); p <- sum(w * y) / sum(w); h <- 1.96 * sqrt(p * (1 - p) / neff)
  round(100 * c(proc = p, CI_dol = p - h, CI_gora = p + h), 1) }
rbind(wybory_bez = ocena(d$wybory, rep(1, n)), wybory_waga = ocena(d$wybory, d$waga),
      wolont_bez = ocena(d$wolontariat, rep(1, n)), wolont_waga = ocena(d$wolontariat, d$waga))
# wariant z przycięciem wag do 5 (i ponownym przeskalowaniem do średniej 1): mniejszy deff kosztem dopasowania rozkładów
w5 <- pmin(d$waga, 5); w5 <- w5 / mean(w5)
round(c(deff = 1 + (sd(w5) / mean(w5))^2, n_efekt = n / (1 + (sd(w5) / mean(w5))^2), wolont = ocena(d$wolontariat, w5)), 1)
round(100 * tapply(w5, d$wyksztalcenie, sum) / sum(w5), 1)
Wynik w R
[1] 7
$plec
  kobieta mężczyzna
       52        48

$wiek_kat
18–34 35–54   55+
   26    34    40

$wyksztalcenie
podstawowe/zasadnicze               średnie                wyższe
                   45                    33                    22

$miejsce
              wieś miasto do 100 tys.   miasto 100 tys.+
                40                 32                 28

    min     max      CV    deff n_efekt
   0.18   10.02    1.03    2.06  387.89
            proc CI_dol CI_gora
wybory_bez  64.4   61.1    67.7
wybory_waga 64.4   59.7    69.2
wolont_bez  23.9   20.9    26.8
wolont_waga 16.7   13.0    20.4
          deff        n_efekt    wolont.proc  wolont.CI_dol wolont.CI_gora
           1.9          426.5           17.0           13.5           20.6
podstawowe/zasadnicze               średnie                wyższe
                 44.0                  33.6                  22.4
4. Regresja logistyczna: OR, AME i model ważony
R
# Krok 4 (kontynuacja): regresja logistyczna – deklarowany udział w wyborach samorządowych
m <- glm(wybory ~ plec + wiek_kat + wyksztalcenie + miejsce + postawy, data = d, family = binomial)
s <- summary(m)$coefficients
ci <- suppressMessages(confint(m))                                  # przedziały profilowe
round(cbind(b = s[, 1], SE = s[, 2], OR = exp(s[, 1]), OR_dol = exp(ci[, 1]), OR_gora = exp(ci[, 2]), p = s[, 4]), 3)
m0 <- glm(wybory ~ 1, data = d, family = binomial)
lr <- anova(m0, m, test = "Chisq"); round(c(chi2 = lr$Deviance[2], df = lr$Df[2], p = lr$`Pr(>Chi)`[2]), 3)
round(c(R2_McFadden = 1 - as.numeric(logLik(m)) / as.numeric(logLik(m0)),
        R2_Nagelkerke = (1 - exp((m$deviance - m0$deviance) / n)) / (1 - exp(-m0$deviance / n))), 3)
# średnie efekty krańcowe (AME) dla wykształcenia: różnica przewidywanych prawdopodobieństw w punktach procentowych
ame <- function(model, dane, zm, poziom, odn) {
  d1 <- dane; d1[[zm]] <- factor(poziom, levels = levels(dane[[zm]]))
  d0 <- dane; d0[[zm]] <- factor(odn, levels = levels(dane[[zm]]))
  100 * mean(predict(model, d1, type = "response") - predict(model, d0, type = "response")) }
set.seed(7302)
B <- 500
boot_ame <- replicate(B, { i <- sample(n, n, TRUE); mb <- update(m, data = d[i, ])
  c(ame(mb, d[i, ], "wyksztalcenie", "średnie", "podstawowe/zasadnicze"), ame(mb, d[i, ], "wyksztalcenie", "wyższe", "podstawowe/zasadnicze")) })
round(rbind(srednie = c(AME = ame(m, d, "wyksztalcenie", "średnie", "podstawowe/zasadnicze"), quantile(boot_ame[1, ], c(.025, .975))),
            wyzsze = c(AME = ame(m, d, "wyksztalcenie", "wyższe", "podstawowe/zasadnicze"), quantile(boot_ame[2, ], c(.025, .975)))), 1)
# ten sam model z wagami: quasi-dwumianowy + odporne błędy standardowe (sandwich, HC0)
mw <- glm(wybory ~ plec + wiek_kat + wyksztalcenie + miejsce + postawy, data = d, family = quasibinomial, weights = waga)
se_w <- sqrt(diag(sandwich::vcovHC(mw, type = "HC0")))
round(cbind(OR_bez_wag = exp(coef(m)), OR_z_wagami = exp(coef(mw)), SE_bez = s[, 2], SE_wagi = se_w), 3)
Wynik w R
                               b    SE    OR OR_dol OR_gora     p
(Intercept)               -2.065 0.397 0.127  0.058   0.274 0.000
plecmężczyzna              0.029 0.163 1.029  0.748   1.419 0.859
wiek_kat35–54              0.547 0.176 1.728  1.226   2.445 0.002
wiek_kat55+                1.127 0.225 3.087  2.003   4.837 0.000
wyksztalcenieśrednie       0.442 0.204 1.556  1.044   2.321 0.030
wyksztalceniewyższe        0.852 0.210 2.345  1.557   3.543 0.000
miejscemiasto do 100 tys. -0.469 0.221 0.626  0.403   0.962 0.034
miejscemiasto 100 tys.+   -0.478 0.213 0.620  0.406   0.937 0.025
postawy                    0.667 0.099 1.947  1.608   2.372 0.000
   chi2      df       p
108.084   8.000   0.000
  R2_McFadden R2_Nagelkerke
        0.104         0.174
         AME 2.5% 97.5%
srednie  9.5  0.5  17.9
wyzsze  17.6 10.0  26.0
                          OR_bez_wag OR_z_wagami SE_bez SE_wagi
(Intercept)                    0.127       0.072  0.397   0.521
plecmężczyzna                  1.029       1.126  0.163   0.227
wiek_kat35–54                  1.728       1.437  0.176   0.229
wiek_kat55+                    3.087       2.643  0.225   0.290
wyksztalcenieśrednie           1.556       1.553  0.204   0.252
wyksztalceniewyższe            2.345       2.451  0.210   0.254
miejscemiasto do 100 tys.      0.626       0.648  0.221   0.285
miejscemiasto 100 tys.+        0.620       0.750  0.213   0.271
postawy                        1.947       2.323  0.099   0.136
5. Skala postaw: alfa, omega, ANOVA Welcha i Games–Howell
R
# Krok 5 (kontynuacja): skala postaw wobec partycypacji lokalnej – rzetelność i porównanie grup
odwr <- d[, sprintf("pp%d", 1:6)]; odwr[, c("pp3", "pp5")] <- 6 - odwr[, c("pp3", "pp5")]
a <- psych::alpha(odwr, warnings = FALSE)
round(c(alfa = a$total$raw_alpha, r_min = min(a$item.stats$r.drop), r_max = max(a$item.stats$r.drop)), 2)
f1 <- psych::fa(odwr, nfactors = 1, fm = "ml"); lam <- as.numeric(f1$loadings)
round(c(omega = sum(lam)^2 / (sum(lam)^2 + sum(1 - lam^2)), lad_min = min(lam), lad_max = max(lam)), 2)
round(c(M = mean(d$postawy), SD = sd(d$postawy)), 2)
round(t(sapply(split(d$postawy, d$wyksztalcenie), function(x) c(n = length(x), M = mean(x), SD = sd(x)))), 2)
w <- oneway.test(postawy ~ wyksztalcenie, data = d); w
round(unlist(as.data.frame(effectsize::F_to_omega2(w$statistic, w$parameter[1], w$parameter[2]))[, c(1, 3, 4)]), 3)
gh <- rstatix::games_howell_test(d, postawy ~ wyksztalcenie)
as.data.frame(gh[, c("group1", "group2", "estimate", "conf.low", "conf.high", "p.adj")])
# związek postaw z zaufaniem do władz gminy (zmienna porządkowa 1–5): korelacja Spearmana
cor.test(d$postawy, d$zaufanie, method = "spearman", exact = FALSE)
Wynik w R
 alfa r_min r_max
 0.84  0.59  0.63
  omega lad_min lad_max
   0.84    0.66    0.71
   M   SD
3.21 0.85
                        n    M   SD
podstawowe/zasadnicze 175 2.99 0.85
średnie               304 3.13 0.81
wyższe                321 3.41 0.85

	One-way analysis of means (not assuming equal variances)

data:  postawy and wyksztalcenie
F = 16.084, num df = 2.00, denom df = 450.27, p-value = 1.791e-07

Omega2_partial         CI_low        CI_high
         0.062          0.029          1.000
                 group1  group2  estimate    conf.low conf.high    p.adj
1 podstawowe/zasadnicze średnie 0.1428916 -0.04313285 0.3289161 1.68e-01
2 podstawowe/zasadnicze  wyższe 0.4197864  0.23221276 0.6073600 7.16e-07
3               średnie  wyższe 0.2768948  0.12063193 0.4331576 1.06e-04

	Spearman's rank correlation rho

data:  d$postawy and d$zaufanie
S = 63472517, p-value = 1.871e-13
alternative hypothesis: true rho is not equal to 0
sample estimates:
      rho
0.2561803
6. Zapis danych do pliku XLSX
R
# Krok 6 (kontynuacja): plik XLSX do pobrania – dane z wagami i opis zmiennych (autor w metadanych: Metodolog.pl)
library(openxlsx)
wb <- createWorkbook(creator = "Metodolog.pl", title = "Statystyka w pracy z socjologii – dane przykładowe")
setLastModifiedBy(wb, "Metodolog.pl")
addWorksheet(wb, "sondaz"); writeData(wb, "sondaz", d[, c("id", "plec", "wiek_kat", "wyksztalcenie", "miejsce", "wybory", "wolontariat",
                                                         "zaufanie", sprintf("pp%d", 1:6), "postawy", "waga")])
freezePane(wb, "sondaz", firstRow = TRUE)
addWorksheet(wb, "populacja")
writeData(wb, "populacja", do.call(rbind, lapply(names(popul), function(z) data.frame(zmienna = z, kategoria = names(popul[[z]]), udzial = unname(popul[[z]])))))
addWorksheet(wb, "opis")
writeData(wb, "opis", c("Dane symulowane (R, set.seed 7301) – metodolog.pl, wpis „Statystyka w pracy z socjologii”.",
                        "wybory: deklarowany udział w ostatnich wyborach samorządowych (1 = tak); wolontariat: w ostatnich 12 miesiącach (1 = tak).",
                        "zaufanie: zaufanie do władz gminy 1–5 (1 = zdecydowanie nie ufam, 3 = trudno powiedzieć, 5 = zdecydowanie ufam).",
                        "pp1–pp6: skala postaw wobec partycypacji lokalnej 1–5; pp3 i pp5 sformułowane odwrotnie (przed liczeniem wyniku: 6 − odpowiedź).",
                        "postawy: średnia 6 pozycji po odwróceniu pp3 i pp5; waga: waga z rakingu do rozkładów z arkusza populacja (średnia = 1).",
                        "Arkusz populacja: rozkłady umowne, przyjęte na potrzeby przykładu – w badaniu użyj danych GUS dla swojej populacji."))
saveWorkbook(wb, "../statystyka-socjologia-sondaz-dane.xlsx", overwrite = TRUE)
spr <- readxl::excel_sheets("../statystyka-socjologia-sondaz-dane.xlsx"); spr
dim(readxl::read_excel("../statystyka-socjologia-sondaz-dane.xlsx", sheet = "sondaz"))
Wynik w R
[1] "sondaz"    "populacja" "opis"
[1] 800  16
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje prop.test(), chisq.test(), glm(), oneway.test() i cor.test() z pakietu stats); rysunki przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research [R package]. Northwestern University. https://CRAN.R-project.org/package=psych
- rstatix (wersja 0.7.3): Kassambara, A. (2025). rstatix: Pipe-friendly framework for basic statistical tests [R package]. https://doi.org/10.32614/CRAN.package.rstatix
- sandwich (wersja 3.1.1): Zeileis, A., Köll, S., & Graham, N. (2020). Various versatile variances: An object-oriented implementation of clustered covariances in R. Journal of Statistical Software, 95(1), 1–36. https://doi.org/10.18637/jss.v095.i01
- openxlsx (wersja 4.2.8.1): Schauberger, P., & Walker, A. (2025). openxlsx: Read, write and edit xlsx files (R package version 4.2.8.1) [Computer software]. https://doi.org/10.32614/CRAN.package.openxlsx
- readxl (wersja 1.4.5): Wickham, H., & Bryan, J. (2025). readxl: Read Excel files [R package]. https://doi.org/10.32614/CRAN.package.readxl
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots (R package version 1.3.2) [Computer software]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy w analizach prac z socjologii
- „Próba reprezentatywna” przy doborze wygodnym. Opisz, jak próba odbiega od populacji, zamiast deklarować reprezentatywność.
- Margines błędu z próby nielosowej podany jak w sondażu losowym, bez zastrzeżeń. Nawet w sondażach losowych obejmuje on tylko błąd losowy (Shirani-Mehr i in., 2018).
- Odsetki w niewłaściwym kierunku w tabeli krzyżowej, np. procent mieszkańców wsi wśród osób ufających zamiast procentu ufających wśród mieszkańców wsi.
- Samo „χ² istotne” bez reszt i bez V Craméra. Czytelnik nie wie wtedy, na czym polega związek ani jak jest silny.
- Ważenie bez raportu kosztów: bez zakresu wag, efektu schematu i informacji o przycięciu wag. Brak też porównania wyników bez wag i z wagami.
- Iloraz szans czytany jak „razy częściej” i porównywany między modelami z różnymi zmiennymi (Mood, 2010). Lepiej podać przewidywane prawdopodobieństwa lub AME.
- Deklaracje traktowane jak zachowania. Pisz „deklarowany udział w wyborach”, a nie „frekwencja”.
- Skala postaw bez odwrócenia pozycji i bez rzetelności policzonej w Twojej próbie.
- Wnioski przyczynowe z sondażu przekrojowego, np. „wykształcenie powoduje uczestnictwo”. W badaniu przekrojowym opisujesz związki.
Najczęstsze pytania
Jakie analizy statystyczne wybrać do pracy magisterskiej z socjologii?
Zależy to od pytania i rodzaju zmiennych. Odsetki opisz z 95% przedziałem ufności, związek dwóch zmiennych kategorialnych sprawdź testem chi-kwadrat z V Craméra i resztami skorygowanymi, a zmienną tak/nie wyjaśniaj regresją logistyczną. Wynik skali postaw z kilku pozycji porównuj między grupami testem t Welcha albo ANOVA Welcha.
Czy w ankiecie internetowej do pracy z socjologii trzeba ważyć dane?
Nie zawsze, ale zawsze porównaj strukturę próby ze strukturą populacji według danych GUS. Jeśli różnice są duże, a badane zjawisko wiąże się z tymi cechami, policz wyniki także z wagami, np. metodą rakingu. Podaj wtedy zakres wag i efekt schematu oraz zaznacz, że ważenie nie usuwa skutków samoselekcji respondentów.
Czy można podać margines błędu dla ankiety rozesłanej w internecie?
Margines błędu ma sens przy doborze losowym, więc dla ankiety rozesłanej w mediach społecznościowych nie jest miarą trafności wyniku. Możesz podać 95% przedział ufności jako miarę precyzji przy założeniu losowości. W ograniczeniach napisz jednak, że wynik może być obciążony doborem próby.
Jak interpretować iloraz szans w regresji logistycznej w socjologii?
Iloraz szans mówi, ile razy większa jest szansa zdarzenia (stosunek prawdopodobieństwa wystąpienia do niewystąpienia) przy zmianie predyktora, a nie ile razy częściej zdarzenie występuje. Przy częstych zjawiskach, takich jak udział w wyborach, OR wyraźnie zawyża różnicę. Dlatego dodaj przewidywane prawdopodobieństwa albo średnie efekty krańcowe w punktach procentowych.
Jak zbudować skalę postaw do pracy z socjologii?
Przygotuj kilka twierdzeń o jednym aspekcie postawy, ocenianych na skali od 1 do 5, i część z nich sformułuj odwrotnie. Przed analizą odwróć te pozycje, sprawdź rzetelność (alfa i omega) i policz wynik jako średnią pozycji. Własną skalę sprawdź w pilotażu, a gotową opisz według publikacji autorów.
Powiązane hasła
Przeczytaj też
Test chi-kwadrat krok po kroku
Test zgodności i niezależności na jednym badaniu: odsetki, liczebności oczekiwane, reszty, V Craméra, test Fishera i gotowy opis APA.
Czytaj →PoradnikRegresja logistyczna krok po kroku
Ilorazy szans i prawdopodobieństwa przewidywane, założenia, separacja, pseudo-R², AUC i kalibracja, tabela APA – na danych do pobrania z kodem R.
Czytaj →PoradnikRodzaje badań ankietowych
Czas, dobór, kanał i cel badania ankietowego oraz ich konsekwencje dla wniosków – z symulacją autoselekcji w R i wzorem opisu schematu.
Czytaj →PoradnikSkala samotności UCLA – jak policzyć wynik
Wersje R-UCLA, 3 i trzypozycyjna, suma 3–9, odwracanie pozycji i brak progów – z przykładem w R na danych seniorów i wzorem opisu w pracy.
Czytaj →Piszesz pracę z socjologii i masz dane z sondażu?
Pomożemy dobrać analizy, sprawdzić strukturę próby i wagi, policzyć wyniki z wielkością efektu i wyjaśnić je tak, abyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Baker, R., Brick, J. M., Bates, N. A., Battaglia, M., Couper, M. P., Dever, J. A., Gile, K. J., & Tourangeau, R. (2013). Summary report of the AAPOR Task Force on Non-probability Sampling. Journal of Survey Statistics and Methodology, 1(2), 90–143. https://doi.org/10.1093/jssam/smt008
- Bethlehem, J. (2010). Selection bias in web surveys. International Statistical Review, 78(2), 161–188. https://doi.org/10.1111/j.1751-5823.2010.00112.x ● Otwarty dostęp
- Cornesse, C., Blom, A. G., Dutwin, D., Krosnick, J. A., De Leeuw, E. D., Legleye, S., Pasek, J., Pennay, D., Phillips, B., Sakshaug, J. W., Struminskaya, B., & Wenz, A. (2020). A review of conceptual approaches and empirical evidence on probability and nonprobability sample survey research. Journal of Survey Statistics and Methodology, 8(1), 4–36. https://doi.org/10.1093/jssam/smz041 ● Otwarty dostęp
- Davies, H. T. O., Crombie, I. K., & Tavakoli, M. (1998). When can odds ratios mislead? BMJ, 316(7136), 989–991. https://doi.org/10.1136/bmj.316.7136.989 ● Otwarty dostęp: pełny tekst
- Dunn, T. J., Baguley, T., & Brunsden, V. (2014). From alpha to omega: A practical solution to the pervasive problem of internal consistency estimation. British Journal of Psychology, 105(3), 399–412. https://doi.org/10.1111/bjop.12046 ● Otwarty dostęp: pełny tekst
- Elliott, M. R., & Valliant, R. (2017). Inference for nonprobability samples. Statistical Science, 32(2), 249–264. https://doi.org/10.1214/16-sts598 ● Otwarty dostęp
- Groves, R. M., & Lyberg, L. (2010). Total survey error: Past, present, and future. Public Opinion Quarterly, 74(5), 849–879. https://doi.org/10.1093/poq/nfq065
- Haberman, S. J. (1973). The analysis of residuals in cross-classified tables. Biometrics, 29(1), 205–220. https://doi.org/10.2307/2529686
- Lumley, T. (2004). Analysis of complex survey samples. Journal of Statistical Software, 9(8). https://doi.org/10.18637/jss.v009.i08 ● Otwarty dostęp
- Mood, C. (2010). Logistic regression: Why we cannot do what we think we can do, and what we can do about it. European Sociological Review, 26(1), 67–82. https://doi.org/10.1093/esr/jcp006 ● Otwarty dostęp: pełny tekst
- Sharpe, D. (2015). Chi-square test is statistically significant: Now what? Practical Assessment, Research, and Evaluation, 20, Article 8. https://doi.org/10.7275/tbfa-x148 ● Otwarty dostęp: pełny tekst
- Shirani-Mehr, H., Rothschild, D., Goel, S., & Gelman, A. (2018). Disentangling bias and variance in election polls. Journal of the American Statistical Association, 113(522), 607–614. https://doi.org/10.1080/01621459.2018.1448823
- Tourangeau, R., & Yan, T. (2007). Sensitive questions in surveys. Psychological Bulletin, 133(5), 859–883. https://doi.org/10.1037/0033-2909.133.5.859
Cytowania BibTeX
@article{baker2013summary, author={Baker, R. and Brick, J. M. and Bates, N. A. and Battaglia, M. and Couper, M. P. and Dever, J. A. and Gile, K. J. and Tourangeau, R.}, title={{Summary report of the AAPOR Task Force on Non-probability Sampling}}, journal={Journal of Survey Statistics and Methodology}, year={2013}, volume={1}, number={2}, pages={90--143}, doi={10.1093/jssam/smt008}}@article{bethlehem2010selection, author={Bethlehem, Jelke}, title={{Selection bias in web surveys}}, journal={International Statistical Review}, year={2010}, volume={78}, number={2}, pages={161--188}, doi={10.1111/j.1751-5823.2010.00112.x}}@article{cornesse2020review, author={Cornesse, Carina and Blom, Annelies G. and Dutwin, David and Krosnick, Jon A. and De Leeuw, Edith D. and Legleye, Stéphane and Pasek, Josh and Pennay, Darren and Phillips, Benjamin and Sakshaug, Joseph W. and Struminskaya, Bella and Wenz, Alexander}, title={{A review of conceptual approaches and empirical evidence on probability and nonprobability sample survey research}}, journal={Journal of Survey Statistics and Methodology}, year={2020}, volume={8}, number={1}, pages={4--36}, doi={10.1093/jssam/smz041}}@article{davies1998when, author={Davies, Huw T. O. and Crombie, Iain K. and Tavakoli, Manouchehr}, title={{When can odds ratios mislead?}}, journal={BMJ}, year={1998}, volume={316}, number={7136}, pages={989--991}, doi={10.1136/bmj.316.7136.989}}@article{dunn2014alpha, author={Dunn, Thomas J. and Baguley, Thom and Brunsden, Vivienne}, title={{From alpha to omega: A practical solution to the pervasive problem of internal consistency estimation}}, journal={British Journal of Psychology}, year={2014}, volume={105}, number={3}, pages={399--412}, doi={10.1111/bjop.12046}}@article{elliott2017inference, author={Elliott, Michael R. and Valliant, Richard}, title={{Inference for nonprobability samples}}, journal={Statistical Science}, year={2017}, volume={32}, number={2}, pages={249--264}, doi={10.1214/16-sts598}}@article{groves2010total, author={Groves, Robert M. and Lyberg, Lars}, title={{Total survey error: Past, present, and future}}, journal={Public Opinion Quarterly}, year={2010}, volume={74}, number={5}, pages={849--879}, doi={10.1093/poq/nfq065}}@article{haberman1973analysis, author={Haberman, Shelby J.}, title={{The analysis of residuals in cross-classified tables}}, journal={Biometrics}, year={1973}, volume={29}, number={1}, pages={205--220}, doi={10.2307/2529686}}@article{lumley2004analysis, author={Lumley, Thomas}, title={{Analysis of complex survey samples}}, journal={Journal of Statistical Software}, year={2004}, volume={9}, number={8}, doi={10.18637/jss.v009.i08}}@article{mood2010logistic, author={Mood, Carina}, title={{Logistic regression: Why we cannot do what we think we can do, and what we can do about it}}, journal={European Sociological Review}, year={2010}, volume={26}, number={1}, pages={67--82}, doi={10.1093/esr/jcp006}}@article{sharpe2015chisquare, author={Sharpe, Donald}, title={{Chi-square test is statistically significant: Now what?}}, journal={Practical Assessment, Research, and Evaluation}, year={2015}, volume={20}, eid={8}, doi={10.7275/tbfa-x148}}@article{shirani2018disentangling, author={Shirani-Mehr, Houshmand and Rothschild, David and Goel, Sharad and Gelman, Andrew}, title={{Disentangling bias and variance in election polls}}, journal={Journal of the American Statistical Association}, year={2018}, volume={113}, number={522}, pages={607--614}, doi={10.1080/01621459.2018.1448823}}@article{tourangeau2007sensitive, author={Tourangeau, Roger and Yan, Ting}, title={{Sensitive questions in surveys}}, journal={Psychological Bulletin}, year={2007}, volume={133}, number={5}, pages={859--883}, doi={10.1037/0033-2909.133.5.859}}