Czym jest skala samotności UCLA
Skala samotności UCLA mierzy subiektywne poczucie osamotnienia, czyli to, jak człowiek ocenia jakość swoich relacji, a nie to, ile ma kontaktów. Narzędzie często pojawia się w pracach z psychologii, socjologii i gerontologii: w badaniach studentów, osób starszych, opiekunów i pracowników. Ogólny warsztat analityczny tych kierunków opisują wpisy statystyka dla psychologa i statystyka w pracy z socjologii. W badaniach osób starszych UCLA często stoi obok skal sprawności i nastroju, np. GDS-15 czy skali Lawtona.
„UCLA” to w praktyce rodzina narzędzi, a nie jedna skala. Russell, Peplau i Cutrona (1980) opublikowali wersję zrewidowaną (R-UCLA). Miała ona ograniczyć wpływ stylu odpowiadania, który obciążał pierwszą wersję. Russell (1996) opisał wersję 3 na danych studentów, pielęgniarek, nauczycieli i osób starszych. Alfa wynosiła tam od .89 do .94, a stabilność w ciągu roku r = .73. Hughes, Waite, Hawkley i Cacioppo (2004) zbudowali z R-UCLA wersję trzypozycyjną do dużych sondaży telefonicznych. Zanim policzysz wynik, ustal więc, którą wersję masz w rękach. Klucz, zakres i porównania z literaturą zależą od wersji.
Wersje: co da się policzyć na podstawie źródeł
Treści pozycji nie przytaczamy. Poniższa tabela zbiera to, co potwierdziliśmy w publikacjach autorów, oraz to, czego potwierdzić się nie dało.
| Wersja | Źródło | Budowa | Klucz w tym wpisie |
|---|---|---|---|
| R-UCLA (zrewidowana) | Russell i in. (1980) | 20 pozycji, cztery kategorie odpowiedzi; część pozycji sformułowana w kierunku „braku samotności” (Hughes i in., 2004) | nie podajemy – numery pozycji odwróconych weź z publikacji z 1980 r. |
| Wersja 3 | Russell (1996) | pozycje sformułowane w dwóch kierunkach; jeden ogólny czynnik samotności i dwa czynniki metody związane z kierunkiem sformułowań | nie podajemy – artykuł nie jest w otwartym dostępie, a oficjalnej strony autora z kluczem nie znaleźliśmy |
| Wersja 3-pozycyjna | Hughes i in. (2004) | 3 pozycje z R-UCLA, odpowiedzi 1 = prawie nigdy, 2 = czasami, 3 = często; brak pozycji odwróconych | suma 3 pozycji, zakres 3–9 |
Wersja 3 to najczęściej cytowana forma długa. W internecie krąży wiele „kluczy” i „norm” bez źródła. Nie przepisuj ich z przypadkowej strony. Numery pozycji odwróconych i zakres wyniku weź z aneksu do artykułu Russella (1996) albo z dokumentacji polskiej wersji, której używasz. Takie źródło zacytuj w pracy.
Jak policzyć wynik krok po kroku
Wersja 3-pozycyjna (Hughes i in., 2004)
Hughes i in. (2004) wybrali trzy pozycje o najwyższych ładunkach na pierwszym czynniku R-UCLA. Na potrzeby wywiadu telefonicznego przeformułowali je w drugiej osobie i skrócili skalę odpowiedzi do trzech kategorii. Wszystkie trzy pozycje mierzą samotność w tym samym kierunku, więc niczego się nie odwraca.
- Sprawdź kodowanie. Odpowiedzi muszą mieć wartości 1, 2 i 3. Formularze online zapisują je czasem jako 0–2 i wtedy cały wynik przesuwa się o 3 punkty.
- Zsumuj trzy pozycje. Wyższy wynik oznacza większą samotność (Hughes i in., 2004). Przy kodowaniu 1–3 zakres wynosi od 3 do 9. Autorzy nie podają go wprost, ale wynika on bezpośrednio z kodowania.
- Ustal regułę dla braków. Autorzy nie podają reguły dla brakujących odpowiedzi. Przy trzech pozycjach uzupełnianie średnią zmienia wynik o całą kategorię, dlatego w przykładzie liczymy wynik tylko przy komplecie odpowiedzi. To decyzja badacza i trzeba ją opisać w pracy.
W drugim badaniu Hughes i in. (2004) zadali te same trzy pytania z czterema kategoriami odpowiedzi. Wynik takiej wersji ma inny zakres. Nie porównuj średnich z badań, które użyły różnej liczby kategorii.
Wersje 20-pozycyjne: zasada odwracania
W R-UCLA i wersji 3 część pozycji opisuje zadowolenie z relacji. Przed zsumowaniem trzeba je odwrócić, aby wyższy wynik zawsze oznaczał większą samotność. Przy odpowiedziach od min do max wartość odwrócona to min + max − x, czyli przy skali 1–4: 5 − x. Wynik możesz podać jako sumę albo jako średnią pozycji. Ważne, żeby w całej pracy używać jednej formy i ją nazwać. Plusy i minusy obu wariantów omawia hasło wynik skali: średnia czy suma. Przekodowanie w różnych programach pokazuje poradnik jak policzyć wynik kwestionariusza.
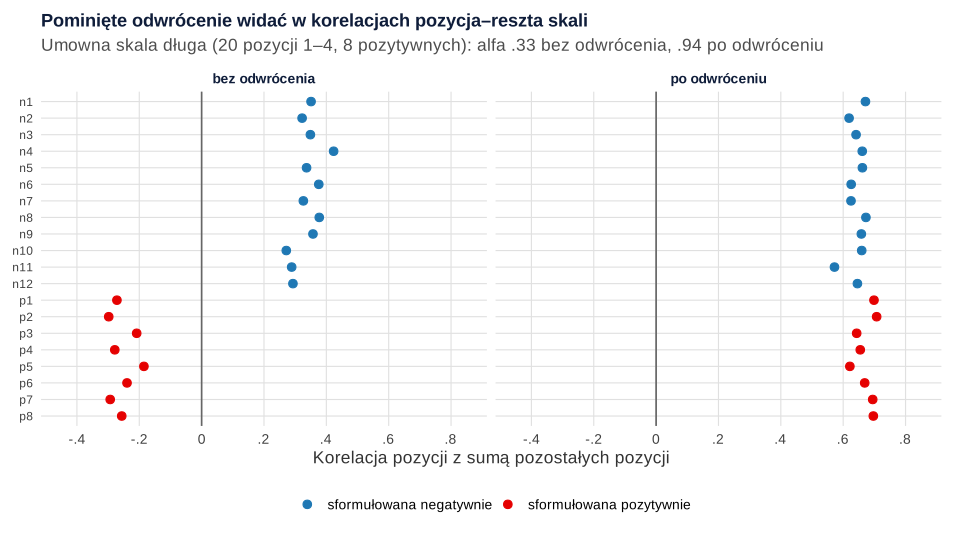
Najprostsza kontrola po odwróceniu to korelacja każdej pozycji z sumą pozostałych. Pozycja, którą zapomniano odwrócić, ma korelację ujemną. Pokazuje to rysunek 2 w przykładzie.
Interpretacja: wynik ciągły, bez progu „osoba samotna”
Wyższy wynik oznacza silniejsze poczucie samotności. Hughes i in. (2004) nie zaproponowali punktu odcięcia i podali tylko średnie oraz odchylenia standardowe. Streszczenie artykułu Russella (1996) również nie wymienia progów. Progi typu „wynik powyżej X oznacza samotność”, spotykane w raportach i na stronach internetowych, nie pochodzą z publikacji, które mogliśmy sprawdzić. Jeśli promotor wymaga podziału na grupy, wskaż źródło, z którego bierzesz punkt odcięcia, i potraktuj ten podział jako opis, a nie rozpoznanie. Dlaczego nie warto tworzyć własnych przedziałów z kwartyli, wyjaśnia wpis niski, przeciętny, wysoki wynik.
Samotność to nie to samo co izolacja. Hughes i in. (2004) pokazali, że wynik skali wiąże się z obiektywnymi wskaźnikami izolacji społecznej, ale związek jest umiarkowany. Ilość kontaktów i jakość relacji to więc różne wymiary. W pracy warto mierzyć oba, np. liczbę kontaktów obok UCLA albo wsparcie społeczne skalą MSPSS.
Porównania wieku wymagają ostrożności. Panayiotou i in. (2022) sprawdzili R-UCLA i jej skrócone wersje u dorosłych w wieku 18–99 lat. Struktura pełnej skali i wielu krótkich form okazała się słaba lub niespójna. Spośród 12 dobrze dopasowanych struktur 10 osiągnęło pełną, częściową albo przybliżoną inwariancję pomiaru względem wieku. Autorzy wnioskują, że równoważności pomiaru między grupami wieku nie wolno zakładać z góry. Procedurę opisuje wpis inwariancja pomiaru krok po kroku.
Licencja i polska wersja
Nie znaleźliśmy oficjalnej strony autora z warunkami użycia skali UCLA (stan na 1 listopada 2026 r.). Artykuł z 1996 r. jest płatny. Narzędzie jest opisane w bazie testów APA PsycTESTS, ale jej rekordy wymagają dostępu instytucjonalnego. Przed badaniem sprawdź więc warunki w rekordzie bazy, w bibliotece uczelni albo bezpośrednio u autora. Przy polskiej wersji zapytaj autorów adaptacji, z której korzystasz. Kwiatkowska, Rogoza i Kwiatkowska (2017) zbadali właściwości R-UCLA u 247 polskich licealistów w wieku 16 lat. W ich próbie najlepiej pasował model trzech skorelowanych czynników, a wynik ogólny był rzetelny. Nie przenoś jednak wyników z tej grupy na studentów czy seniorów. Jak wygląda adaptacja, opisuje wpis adaptacja kulturowa kwestionariusza, a gdzie szukać narzędzi – poradnik gdzie znaleźć kwestionariusze psychologiczne.
Przykład: 360 osób w wieku 60–85 lat
Dane są symulowane i możesz je pobrać jako plik CSV. Plik zawiera trzy pozycje krótkiej skali (u1–u3, kodowanie 1–3), informację, czy osoba mieszka sama, i liczbę kontaktów z bliskimi w ostatnim tygodniu. Pięć osób pominęło jedną pozycję, więc do analizy weszło 355 osób z kompletem odpowiedzi.
| Grupa | n | M (SD) | Me [Q1, Q3] | Wynik minimalny (3) |
|---|---|---|---|---|
| Wszyscy | 355 | 4.63 (1.73) | 4 [3, 5.5] | 34.9% |
| Mieszka z kimś | 223 | 4.37 (1.55) | 4 [3, 5] | 40.4% |
| Mieszka sam(a) | 132 | 5.07 (1.92) | 4.5 [3, 6.25] | 25.8% |
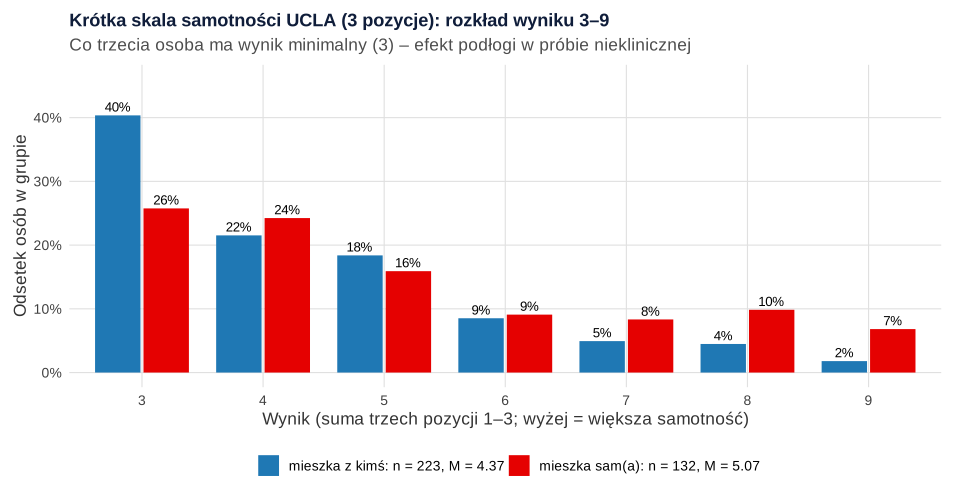
Rozkład jest prawostronnie skośny (skośność 0.97), a co trzecia osoba ma wynik minimalny. To efekt podłogi typowy dla próby nieklinicznej. Skala z siedmioma możliwymi wynikami słabo różnicuje osoby, które samotności prawie nie odczuwają.
Rzetelność
Alfa Cronbacha wyniosła .76, 95% CI [.71, .80]. To wynik zbliżony do .72, które Hughes i in. (2004) uzyskali w obu swoich badaniach. Korelacje pozycji z resztą skali wyniosły od .57 do .59. Alfa zakłada równe ładunki pozycji (McNeish, 2018), więc obok niej podaj omegę McDonalda. W jednoczynnikowym modelu CFA ładunki standaryzowane wyniosły .69–.73, a omega .76. Przy trzech pozycjach model jest dokładnie zidentyfikowany, więc nie da się ocenić jego dopasowania. Omegę z samych ładunków policzysz też w kalkulatorze alfy i omegi.
Porównanie grup i związek z izolacją
Osoby mieszkające samotnie miały wyższy wynik o 0.70 punktu, 95% CI [0.31, 1.09], test Welcha: t(231.41) = 3.55, p < .001, d = 0.41, 95% CI [0.19, 0.63]. Ze względu na skośność i małą liczbę możliwych wartości sprawdziliśmy wynik testem Manna–Whitneya, który dał ten sam wniosek (p < .001). Korelacja Spearmana wyniku z liczbą kontaktów wyniosła ρ = −.23, p < .001. Związek jest więc wyraźny, ale umiarkowany, podobnie jak w pracy Hughes i in. (2004).
Wersja długa: co się dzieje bez odwrócenia
Druga część kodu symuluje umowną skalę 20-pozycyjną z odpowiedziami 1–4. Dwanaście pozycji sformułowano w kierunku samotności, a osiem w kierunku zadowolenia z relacji. Ten układ nie odtwarza klucza UCLA, tylko ilustruje mechanizm. Bez odwrócenia alfa wyniosła .33, a wszystkie osiem pozytywnych pozycji korelowało ujemnie z resztą skali (od −.30 do −.19). Po odwróceniu alfa wzrosła do .94, a korelacje wyniosły od .62 do .71 (rysunek 2).
Russell (1996) opisał wersję 3 jednym ogólnym czynnikiem samotności i dwoma czynnikami metody związanymi z kierunkiem sformułowań. W danych przykładowych model jednoczynnikowy miał χ²(170) = 316.44, CFI = .956, RMSEA = .050, SRMR = .041. Po dodaniu czynnika metody dla pozycji pozytywnych dopasowanie się poprawiło: χ²(162) = 151.12, CFI = 1.000, RMSEA = .000, SRMR = .025. Wniosek dla pracy jest taki, że pozycje pozytywne nie tworzą osobnej podskali „towarzyskości”. To ta sama samotność mierzona z innym kierunkiem sformułowania. Podobny problem opisuje hasło tendencja do zgadzania się, a modele z czynnikami dodatkowymi wpis model bifactor i ESEM.
Jak opisać skalę UCLA w pracy
Wzór zawiera liczby z przykładu. W nawiasach kwadratowych uzupełnij dane swojej wersji.
Ogólny schemat opisu narzędzia znajdziesz w poradniku opis narzędzia badawczego – wzór, a zdania o rzetelności we wzorze raportowania alfy Cronbacha.
Skala UCLA w R: wynik, rzetelność, porównanie grup i odwracanie
Kod odtwarza liczby z tekstu i zapisuje plik CSV. Część A dotyczy wersji trzypozycyjnej, a część B pokazuje odwracanie pozycji na umownej skali długiej. Funkcja odwroc() działa dla dowolnego zakresu odpowiedzi. Alfę liczy pakiet psych, omegę i modele CFA – lavaan, a d Cohena z przedziałem – DescTools.
Wynik skali samotności UCLA krok po kroku
R
# B250 – Skala samotności UCLA: wersja 3-pozycyjna (Hughes i in., 2004) oraz kontrola odwracania pozycji
# w wersji długiej (dane symulowane, set.seed(2501)). Treści pozycji nie podajemy.
# Część A: 360 osób w wieku 60–85 lat; trzy pozycje krótkiej skali kodowane jak u Hughes i in. (2004):
# 1 = prawie nigdy, 2 = czasami, 3 = często; wynik = suma (wyżej = większa samotność).
# Część B: umowna skala długa (20 pozycji 1–4, w tym 8 sformułowanych pozytywnie: p1–p8).
# Układ pozycji w części B NIE jest kluczem UCLA – numery pozycji odwróconych weź z publikacji źródłowej.
suppressPackageStartupMessages({ library(psych); library(lavaan); library(DescTools) })
set.seed(2501)
n <- 360
samotnie <- rbinom(n, 1, 0.36)                                   # 1 = mieszka sam(a)
wiek <- round(runif(n, 60, 85))
kontakty <- rpois(n, exp(1.85 - 0.30 * samotnie))                 # kontakty z bliskimi w ostatnim tygodniu
L <- 0.45 * samotnie - 0.20 * as.numeric(scale(log1p(kontakty))) + rnorm(n)   # ukryta samotność
krotka <- sapply(1:3, function(j) 1 + findInterval(0.80 * L + rnorm(n, 0, 0.62), c(0.35, 1.35) + c(0, 0.15, -0.10)[j]))
colnames(krotka) <- paste0("u", 1:3)
dane <- data.frame(id = 1:n, wiek, mieszka_sam = ifelse(samotnie == 1, "tak", "nie"), kontakty, krotka)
dane$u2[c(41, 187, 300)] <- NA; dane$u3[c(118, 254)] <- NA            # pojedyncze braki
write.csv(dane, "../ucla-3-dane-przyklad.csv", row.names = FALSE, na = "")   # plik do pobrania
u <- paste0("u", 1:3)

# Krok 1. Kontrola kodowania: tylko 1–3 albo brak
all(as.matrix(dane[, u]) %in% c(1:3, NA))
table(braki = rowSums(is.na(dane[, u])))

# Krok 2. Wynik = suma trzech pozycji (3–9); tu tylko przy komplecie odpowiedzi (decyzja badacza)
dane$ucla3 <- ifelse(rowSums(is.na(dane[, u])) == 0, rowSums(dane[, u]), NA)
d <- dane[!is.na(dane$ucla3), ]
nrow(d)
table(d$ucla3)
opis <- function(x) round(c(n = length(x), M = mean(x), SD = sd(x), Me = median(x),
  Q1 = quantile(x, .25, names = FALSE), Q3 = quantile(x, .75, names = FALSE), proc_min = 100 * mean(x == 3), skosnosc = skew(x)), 2)
rbind(wszyscy = opis(d$ucla3), t(sapply(split(d$ucla3, d$mieszka_sam), opis)))

# Krok 3. Rzetelność: alfa z 95% CI Feldta i omega z modelu jednoczynnikowego (lavaan)
a <- psych::alpha(d[, u], warnings = FALSE)
round(c(alfa = a$total$raw_alpha, lo = a$feldt$lower.ci[[1]], hi = a$feldt$upper.ci[[1]]), 3)
round(a$item.stats$r.drop, 2)                                    # korelacja pozycja–reszta skali
f1 <- cfa("S =~ u1 + u2 + u3", data = d, std.lv = TRUE)
st <- standardizedSolution(f1)
lam <- st$est.std[st$op == "=~"]; th <- st$est.std[st$op == "~~" & st$lhs %in% u & st$lhs == st$rhs]
round(c(omega = sum(lam)^2 / (sum(lam)^2 + sum(th)), lambda = lam), 3)

# Krok 4. Osoby mieszkające same a pozostałe: test t Welcha, d Cohena z 95% CI, Mann–Whitney jako kontrola
tt <- t.test(ucla3 ~ mieszka_sam, d)                            # znak: „nie” minus „tak”
round(c(t = unname(tt$statistic), df = unname(tt$parameter), lo = tt$conf.int[1], hi = tt$conf.int[2]), 2)
format.pval(tt$p.value, digits = 3)
round(CohenD(d$ucla3[d$mieszka_sam == "tak"], d$ucla3[d$mieszka_sam == "nie"], conf.level = .95)[1:3], 2)
format.pval(wilcox.test(ucla3 ~ mieszka_sam, d, exact = FALSE)$p.value, digits = 3)

# Krok 5. Samotność a liczba kontaktów (izolacja obiektywna): korelacja Spearmana
ct <- cor.test(d$ucla3, d$kontakty, method = "spearman", exact = FALSE)
round(c(rho = unname(ct$estimate)), 2); format.pval(ct$p.value, digits = 3)

# Część B. Wersja długa: odwracanie pozycji sformułowanych pozytywnie (umowny układ 12 + 8 pozycji)
M <- rnorm(n)                                                    # czynnik metody: pozytywne sformułowanie
neg <- sapply(1:12, function(j) 1 + findInterval(0.70 * L + rnorm(n, 0, 0.70), c(-0.6, 0.4, 1.3)))
poz <- sapply(1:8, function(j) 1 + findInterval(-0.65 * L + 0.40 * M + rnorm(n, 0, 0.65), c(-1.2, -0.2, 0.8)))
colnames(neg) <- paste0("n", 1:12); colnames(poz) <- paste0("p", 1:8)
dl <- data.frame(neg, poz)
odwroc <- function(x, min, max) min + max - x                   # na skali 1–4: 5 − x
dl_odw <- dl; dl_odw[, colnames(poz)] <- lapply(dl[, colnames(poz)], odwroc, min = 1, max = 4)
r_bez <- psych::alpha(dl, check.keys = FALSE, warnings = FALSE)
r_odw <- psych::alpha(dl_odw, warnings = FALSE)
round(c(alfa_bez_odwrocenia = r_bez$total$raw_alpha, alfa_po_odwroceniu = r_odw$total$raw_alpha), 2)
round(rbind(bez = range(r_bez$item.stats$r.drop[13:20]), po = range(r_odw$item.stats$r.drop[13:20])), 2)
sum(r_bez$item.stats$r.drop < 0)                                 # ile pozycji koreluje ujemnie z resztą
round(c(M = mean(rowMeans(dl_odw)), SD = sd(rowMeans(dl_odw))), 2)   # wynik jako średnia 1–4
# Czynnik ogólny a czynnik ogólny + czynnik metody dla pozycji pozytywnych (model z dwoma kierunkami sformułowań)
m1 <- paste("S =~", paste(names(dl_odw), collapse = " + "))
m2 <- paste(m1, "\nPOZ =~", paste(colnames(poz), collapse = " + "))
g1 <- cfa(m1, data = dl_odw, estimator = "MLR", std.lv = TRUE)
g2 <- cfa(m2, data = dl_odw, estimator = "MLR", std.lv = TRUE, orthogonal = TRUE)
ind <- c("chisq.scaled", "df.scaled", "cfi.robust", "rmsea.robust", "srmr")
round(rbind(jeden_czynnik = fitMeasures(g1, ind), z_czynnikiem_metody = fitMeasures(g2, ind)), 3)
Wynik w R
[1] TRUE
braki
  0   1
355   5
[1] 355

  3   4   5   6   7   8   9
124  80  62  31  22  23  13
          n    M   SD  Me Q1   Q3 proc_min skosnosc
wszyscy 355 4.63 1.73 4.0  3 5.50    34.93     0.97
nie     223 4.37 1.55 4.0  3 5.00    40.36     1.12
tak     132 5.07 1.92 4.5  3 6.25    25.76     0.66
 alfa    lo    hi
0.756 0.708 0.797
[1] 0.59 0.57 0.59
  omega lambda1 lambda2 lambda3
  0.757   0.725   0.688   0.728
     t     df     lo     hi
 -3.55 231.41  -1.09  -0.31
[1] "0.000459"
     d lwr.ci upr.ci
  0.41   0.19   0.63
[1] "0.00073"
  rho
-0.23
[1] "1.29e-05"
alfa_bez_odwrocenia  alfa_po_odwroceniu
               0.33                0.94
     [,1]  [,2]
bez -0.30 -0.19
po   0.62  0.71
[1] 8
   M   SD
2.31 0.67
                    chisq.scaled df.scaled cfi.robust rmsea.robust  srmr
jeden_czynnik            316.438       170      0.956         0.05 0.041
z_czynnikiem_metody      151.121       162      1.000         0.00 0.025
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- lavaan (wersja 0.7.2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- DescTools (wersja 0.99.60): Signorell, A. (2025). DescTools: Tools for descriptive statistics (R package version 0.99.60) [Computer software]. https://CRAN.R-project.org/package=DescTools
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy przy skali UCLA
- Mieszanie wersji. Wynik 3–9 wersji krótkiej, sumy wersji długich i średnie pozycji to różne skale. Porównuj tylko wyniki tej samej wersji z tym samym kodowaniem.
- Klucz z przypadkowej strony. Numery pozycji odwróconych bierz z publikacji źródłowej albo z dokumentacji polskiej adaptacji, nie z niepodpisanego arkusza.
- Brak kontroli odwrócenia. Ujemna korelacja pozycji z resztą skali i niska alfa to najczęstszy objaw pominiętego odwrócenia.
- Podskale z pozycji pozytywnych. Według Russella (1996) kierunek sformułowania tworzy czynnik metody, a nie osobny wymiar samotności.
- „Odsetek samotnych” bez źródła progu. Autorzy wersji krótkiej nie podali punktu odcięcia. Analizuj wynik ciągły.
- Porównania wieku bez inwariancji. Różnice między grupami wieku mogą częściowo wynikać z innego rozumienia pozycji (Panayiotou i in., 2022).
Całą ścieżkę od kodowania po rzetelność porządkuje przewodnik po analizie kwestionariusza. Jeśli chcesz, żeby ktoś sprawdził liczenie skali UCLA w Twojej bazie, możesz skorzystać z konsultacji w ramach oferty analizy statystyczne dla studentów. Wyniki musisz jednak rozumieć i umieć obronić samodzielnie.
Najczęstsze pytania
Która wersja skali samotności UCLA wystarczy do pracy magisterskiej?
Gdy samotność jest główną zmienną, zwykle wybiera się wersję długą, bo daje szerszy zakres wyniku i wyższą rzetelność. Wersja trzypozycyjna Hughes i in. (2004) sprawdza się, gdy samotność jest jedną z wielu zmiennych w długiej ankiecie. Wybierz tę wersję, która ma opublikowaną polską adaptację, i trzymaj się jednego kodowania w całej pracy.
Jak policzyć wynik trzypozycyjnej skali samotności UCLA?
Każdą odpowiedź zakoduj jako 1 (prawie nigdy), 2 (czasami) lub 3 (często) i zsumuj trzy pozycje. Wynik mieści się w zakresie 3–9, a wyższy oznacza większą samotność. Żadnej pozycji nie odwracasz. Jeśli formularz zapisał odpowiedzi jako 0–2, dodaj 1 do każdej odpowiedzi.
Od ilu punktów w skali UCLA osoba jest samotna?
Autorzy wersji trzypozycyjnej nie podali punktu odcięcia, a streszczenie pracy Russella (1996) o wersji 3 też go nie wymienia. Wynik traktuj jako miarę ciągłą. Jeśli promotor wymaga grup, wskaż publikację, z której pochodzi próg, i nazwij grupy opisowo, bez etykiety diagnostycznej.
Skąd wziąć numery pozycji odwróconych w wersji 3 skali UCLA?
Z aneksu do artykułu Russella (1996) w Journal of Personality Assessment albo z publikacji polskiej adaptacji, której używasz. Nie kopiuj klucza z niepodpisanych stron. Po odwróceniu sprawdź korelacje pozycji z resztą skali: wartość ujemna zwykle oznacza, że pozycję pominięto.
Czy pozycje pozytywne skali UCLA można analizować jako osobną podskalę?
Lepiej nie. Russell (1996) opisał wersję 3 jednym ogólnym czynnikiem samotności i dwoma czynnikami metody związanymi z kierunkiem sformułowania pozycji. Różnica między pozycjami pozytywnymi i negatywnymi wynika więc głównie ze sposobu sformułowania, a nie z odrębnego wymiaru samotności.
Powiązane hasła
Przeczytaj też
Jak policzyć wynik kwestionariusza
Klucz, pozycje odwrócone, podskale, reguła braków, suma czy średnia i kontrola wartości – w Excelu, SPSS, R i jamovi, z plikiem .xlsx z formułami.
Czytaj →PoradnikStatystyka dla psychologa
Analizy w pracy dyplomowej z psychologii: typowe projekty, wynik kwestionariusza, alfa i omega, normy i steny, eksperyment i raport APA – z danymi i kodem R.
Czytaj →PoradnikStatystyka w pracy z socjologii
Sondaż, tabele krzyżowe z resztami, ważenie próby, regresja logistyczna z AME i skale postaw: plan analiz, APA, dane XLSX i kod R.
Czytaj →Badasz samotność i nie masz pewności, czy dobrze liczysz skalę UCLA?
Sprawdzimy wersję i kodowanie skali, odwrócenie pozycji, obsługę braków i dobór analiz oraz wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Hughes, M. E., Waite, L. J., Hawkley, L. C., & Cacioppo, J. T. (2004). A short scale for measuring loneliness in large surveys. Research on Aging, 26(6), 655–672. https://doi.org/10.1177/0164027504268574 ● Otwarty dostęp: pełny tekst
- Kwiatkowska, M. M., Rogoza, R., & Kwiatkowska, K. (2017). Analysis of the psychometric properties of the Revised UCLA Loneliness Scale in a Polish adolescent sample. Current Issues in Personality Psychology, 6(2), 164–170. https://doi.org/10.5114/cipp.2017.69681 ● Otwarty dostęp
- McNeish, D. (2018). Thanks coefficient alpha, we’ll take it from here. Psychological Methods, 23(3), 412–433. https://doi.org/10.1037/met0000144
- Panayiotou, M., Badcock, J. C., Lim, M. H., Banissy, M. J., & Qualter, P. (2022). Measuring loneliness in different age groups: The measurement invariance of the UCLA Loneliness Scale. Assessment, 30(5), 1688–1715. https://doi.org/10.1177/10731911221119533 ● Otwarty dostęp
- Russell, D. W. (1996). UCLA Loneliness Scale (Version 3): Reliability, validity, and factor structure. Journal of Personality Assessment, 66(1), 20–40. https://doi.org/10.1207/s15327752jpa6601_2
- Russell, D., Peplau, L. A., & Cutrona, C. E. (1980). The revised UCLA Loneliness Scale: Concurrent and discriminant validity evidence. Journal of Personality and Social Psychology, 39(3), 472–480. https://doi.org/10.1037/0022-3514.39.3.472
Cytowania BibTeX
@article{hughes2004short, author={Hughes, Mary Elizabeth and Waite, Linda J. and Hawkley, Louise C. and Cacioppo, John T.}, title={{A short scale for measuring loneliness in large surveys}}, journal={Research on Aging}, year={2004}, volume={26}, number={6}, pages={655--672}, doi={10.1177/0164027504268574}}@article{kwiatkowska2017analysis, author={Kwiatkowska, Maria Magdalena and Rogoza, Radosław and Kwiatkowska, Katarzyna}, title={{Analysis of the psychometric properties of the Revised UCLA Loneliness Scale in a Polish adolescent sample}}, journal={Current Issues in Personality Psychology}, year={2017}, volume={6}, number={2}, pages={164--170}, doi={10.5114/cipp.2017.69681}}@article{mcneish2018thanks, author={McNeish, Daniel}, title={{Thanks coefficient alpha, we’ll take it from here}}, journal={Psychological Methods}, year={2018}, volume={23}, number={3}, pages={412--433}, doi={10.1037/met0000144}}@article{panayiotou2022measuring, author={Panayiotou, Margarita and Badcock, Johanna C. and Lim, Michelle H. and Banissy, Michael J. and Qualter, Pamela}, title={{Measuring loneliness in different age groups: The measurement invariance of the UCLA Loneliness Scale}}, journal={Assessment}, year={2022}, volume={30}, number={5}, pages={1688--1715}, doi={10.1177/10731911221119533}}@article{russell1996ucla, author={Russell, Daniel W.}, title={{UCLA Loneliness Scale (Version 3): Reliability, validity, and factor structure}}, journal={Journal of Personality Assessment}, year={1996}, volume={66}, number={1}, pages={20--40}, doi={10.1207/s15327752jpa6601_2}}@article{russell1980revised, author={Russell, Dan and Peplau, Letitia A. and Cutrona, Carolyn E.}, title={{The revised UCLA Loneliness Scale: Concurrent and discriminant validity evidence}}, journal={Journal of Personality and Social Psychology}, year={1980}, volume={39}, number={3}, pages={472--480}, doi={10.1037/0022-3514.39.3.472}}