Wynik kwestionariusza w siedmiu krokach
Zebrałeś ankiety, przepisałeś odpowiedzi do arkusza i masz przed sobą kolumny p1, p2, p3… Do analiz potrzebujesz jednak jednej liczby na osobę: wyniku podskali albo wyniku ogólnego. Większość błędów w rozdziale wyników powstaje właśnie tutaj, zanim padnie pierwszy test. Ktoś zapomina odwrócić pozycje, sumuje kod braku −99 albo sumuje tylko te odpowiedzi, które są. Arkusz liczy wtedy bez protestu, a wynik jest po prostu zły.
Ten poradnik prowadzi przez siedem kroków na jednym przykładzie. Każdy krok pokazujemy w Excelu, w składni SPSS, w R i w jamovi. Kolejność jest taka:
| Krok | Pytanie, na które odpowiadasz | Skąd bierzesz odpowiedź |
|---|---|---|
| 1. Klucz | Które pozycje należą do której podskali i jak się je punktuje? | Podręcznik narzędzia lub artykuł autorów |
| 2. Pozycje odwrócone | Które pozycje trzeba przekodować przed liczeniem? | Klucz; wzór max + min − x |
| 3. Podskale | Jak z pozycji powstaje wynik każdej podskali? | Klucz |
| 4. Braki | Ile odpowiedzi może brakować, żeby wynik jeszcze policzyć? | Podręcznik, a gdy milczy – Twoja reguła zapisana przed analizą |
| 5. Suma czy średnia | W jakiej metryce podasz wynik? | Podręcznik i normy; w badaniu własnym – wygoda interpretacji |
| 6. Wynik ogólny | Czy wolno połączyć podskale w jedną liczbę? | Struktura narzędzia potwierdzona w badaniach |
| 7. Kontrola | Czy w pozycjach i wynikach nie ma wartości niemożliwych? | Zakres skali; minimum i maksimum każdej kolumny |
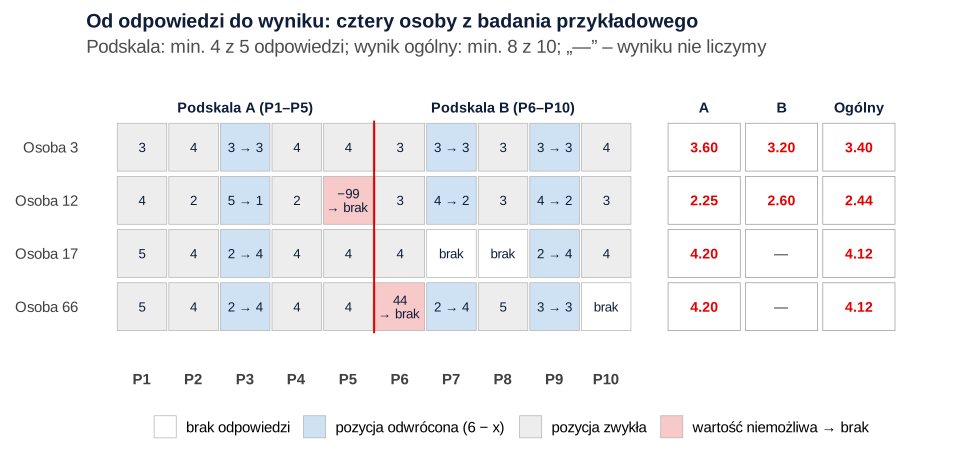
Krok 7 opisujemy na końcu, bo zamyka całą procedurę, ale jego pierwszą część – przegląd zakresu odpowiedzi – wykonaj, zanim cokolwiek policzysz. Drugą część, sprawdzenie zakresu gotowych wyników, robisz po kroku 6. Rysunek 1 pokazuje, jak cztery osoby z przykładu przechodzą przez wszystkie kroki.
Badanie przykładowe: fikcyjna skala SPS-10
Wyobraź sobie pracę licencjacką z pielęgniarstwa o samoopiece pacjentów z cukrzycą typu 2. W poradni diabetologicznej 160 pacjentów wypełniło papierową ankietę, a autorka przepisała odpowiedzi do arkusza. Głównym narzędziem jest Skala Pewności w Samoopiece (SPS-10). To narzędzie fikcyjne, wymyślone na potrzeby tego poradnika. Nie szukaj go w literaturze i nie cytuj w pracy. Dane są symulowane, ale mają wszystkie kłopoty prawdziwych danych: braki, kod odmowy odpowiedzi i literówki z przepisywania.
SPS-10 ma 10 pozycji ocenianych na pięciostopniowej skali Likerta od 1 („zdecydowanie się nie zgadzam”) do 5 („zdecydowanie się zgadzam”). Pozycje 1–5 tworzą podskalę A „Codzienna samokontrola”, np. pozycja o regularnym mierzeniu glikemii. Pozycje 6–10 tworzą podskalę B „Radzenie sobie z trudnościami”, np. pozycja o postępowaniu przy złym samopoczuciu. Trzy pozycje (3, 7 i 9) są sformułowane odwrotnie: zgoda z nimi oznacza mniejszą pewność.
Wszystkie dane i formuły z tego wpisu znajdziesz w pliku wynik-kwestionariusza-przyklad.xlsx. Plik ma arkusze z kluczem, surowymi danymi, kontrolą zakresu, danymi po czyszczeniu i wynikami liczonymi formułami. Obok formuł jest kolumna z wynikami z R do porównania.
Krok 1. Znajdź klucz i zapisz go w tabeli
Klucz odpowiedzi to instrukcja liczenia wyniku. Mówi, które pozycje wchodzą do której podskali, które trzeba odwrócić, jak punktować odpowiedzi i czy wynikiem jest suma, czy średnia. Przy narzędziach standaryzowanych klucz jest w podręczniku albo w artykule, w którym autorzy opisali narzędzie. Przy narzędziach licencjonowanych klucz bywa dostępny tylko z podręcznikiem od wydawcy. Wtedy nie publikuj go w pracy w całości, tylko opisz zasadę liczenia i zacytuj źródło. Gdzie szukać narzędzi i informacji o ich licencjach, opisujemy w poradniku gdzie znaleźć kwestionariusze psychologiczne.
Zanim zaczniesz liczyć, przepisz klucz do tabeli w arkuszu albo w książce kodowej. Jedna linijka na pozycję wystarczy. Nie licz wyniku „z pamięci” i nie przepisuj klucza z cudzej pracy dyplomowej. Polskie adaptacje często różnią się od oryginałów kolejnością pozycji, a czasem także liczbą pozycji odwróconych.
| Podskala | Pozycje | Odwrócone | Zakres średniej | Zakres sumy | Reguła braków (umowna) |
|---|---|---|---|---|---|
| A – Codzienna samokontrola | 1, 2, 3, 4, 5 | 3 | 1–5 | 5–25 | co najmniej 4 z 5 odpowiedzi |
| B – Radzenie sobie z trudnościami | 6, 7, 8, 9, 10 | 7, 9 | 1–5 | 5–25 | co najmniej 4 z 5 odpowiedzi |
| Wynik ogólny | 1–10 | 3, 7, 9 | 1–5 | 10–50 | co najmniej 8 z 10 odpowiedzi |
Wyższy wynik oznacza większą pewność w samoopiece. Kierunek wyniku zapisz w kluczu wprost, bo przy skalach objawów albo ryzyka bywa odwrotny: wyższy wynik oznacza gorszy stan.
Krok 2. Odwróć pozycje: max + min − x
Pozycja odwrócona to pozycja, przy której zgoda oznacza niższy poziom mierzonej cechy. Zanim połączysz ją z innymi pozycjami, przekoduj odpowiedzi tak, aby wszystkie pozycje miały ten sam kierunek. Wzór jest jeden dla każdej skali:
Na skali 1–5 to 6 − x: 1 zmienia się w 5, 2 w 4, a 3 zostaje trójką. Na skali 1–7 wzór to 8 − x, a na skali 0–4 to 4 − x. Ten ostatni przykład pokazuje, dlaczego wzór zawiera minimum. Odruchowe „6 − x” na skali zaczynającej się od zera zawyża każdą odwróconą odpowiedź o 2 punkty. To samo przekodowanie możesz zapisać listą wartości (1 → 5, 2 → 4 itd.). Ogólne zasady przekodowania zmiennych opisuje hasło rekodowanie.
Dwie rady praktyczne. Po pierwsze, odwrócone pozycje zapisz w nowych kolumnach (np. p3_odwr), a oryginałów nie nadpisuj. Jeśli uruchomisz skrypt dwa razy, nadpisane pozycje „odwrócą się” z powrotem i nikt tego nie zauważy. Po drugie, sprawdź przekodowanie w tabeli krzyżowej starej i nowej kolumny. W przykładzie wszystkie 23 odpowiedzi „1” w pozycji 3 stały się piątkami, a 9 odpowiedzi „5” – jedynkami.
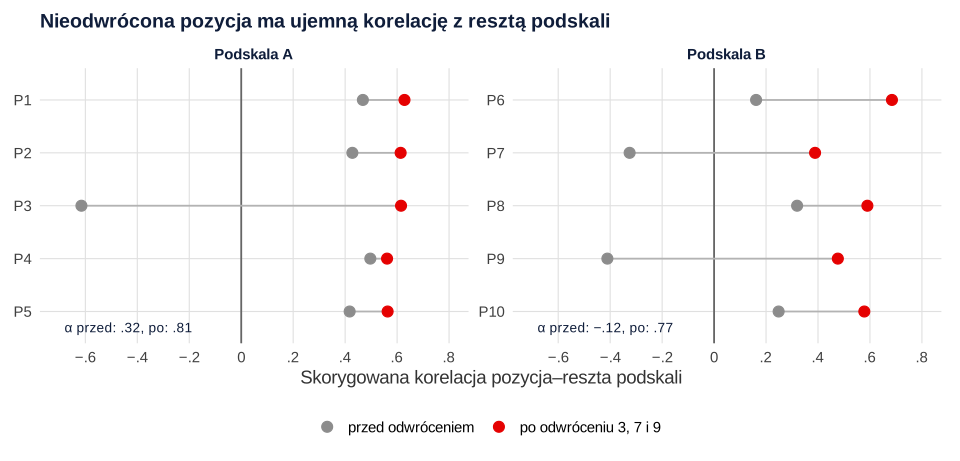
Jak sprawdzić, czy niczego nie pominąłeś? Policz skorygowaną korelację każdej pozycji z sumą pozostałych pozycji podskali (korelację pozycja–reszta). Pozycja, której zapomniano odwrócić, ma zwykle korelację ujemną. Na rysunku 2 widać to wyraźnie: przed odwróceniem pozycja 3 korelowała z resztą podskali A na poziomie r = −.62, a pozycje 7 i 9 z resztą podskali B na poziomie −.33 i −.41. Alfa Cronbacha wynosiła wtedy .32 dla podskali A i −.12 dla podskali B. Po odwróceniu wszystkie korelacje były dodatnie (od .39 do .68), a alfa wzrosła do .81 i .77.
Ujemna korelacja nie zawsze oznacza błąd w kodowaniu. Pozycje odwrócone bywają rozumiane inaczej niż proste, zwłaszcza gdy zawierają przeczenie. Van Sonderen i in. (2013) pokazali na kwestionariuszu zmęczenia, że takie pozycje nie zapobiegły stylowi odpowiadania, a do wyników wprowadziły błędy wynikające z nieuwagi i dezorientacji badanych. Jeśli więc po poprawnym odwróceniu pozycja nadal słabo koreluje z resztą, opisz to w pracy. Nie usuwaj jej jednak z wyniku na własną rękę, bo wynik przestanie być porównywalny z innymi badaniami. Więcej o tym, co robić z problematycznymi pozycjami, piszemy w poradniku alfa Cronbacha – rzetelność skali.
Krok 3. Policz podskale według klucza
Wynik podskali powstaje z pozycji wskazanych w kluczu, już po odwróceniu. W SPS-10 podskala A to pozycje 1, 2, 3 (odwrócona), 4 i 5, a podskala B to pozycje 6, 7 (odwrócona), 8, 9 (odwrócona) i 10. Najczęstszy błąd na tym etapie jest banalny: do formuły trafia oryginalna kolumna p3 zamiast p3_odwr. Dlatego w arkuszu wyników z pliku do pobrania wszystkie pozycje stoją obok siebie już w poprawnym kierunku, a formuły podskal sięgają tylko do tych kolumn.
Podskale bywają przeplatane: w wielu narzędziach pozycje jednej podskali to np. 1, 4, 7 i 10. Wtedy nie zaznaczaj zakresu „od–do”, tylko wpisz pozycje po kolei i sprawdź formułę z kluczem. W pracy podaj wynik każdej podskali osobno i dla każdej osobno rzetelność. Jak zapisać rzetelność kilku podskal w jednej tabeli, pokazuje hasło tabela rzetelności skal w APA.
Krok 4. Zdecyduj, co zrobisz z brakami odpowiedzi
W przykładzie po czyszczeniu brakuje 70 z 1600 odpowiedzi (4.4%). To niewiele, ale braki rozkładają się na wiele osób. Komplet 10 odpowiedzi ma tylko 108 ze 160 pacjentów. Gdybyś liczył wynik tylko u osób bez braków, straciłbyś co trzecią osobę z powodu pojedynczych pominiętych pytań.
Reguła proporcjonalna (prorated): średnia z dostępnych pozycji
Najczęstsze rozwiązanie wygląda tak: jeśli osoba odpowiedziała na wystarczająco wiele pozycji, wynik to średnia z dostępnych odpowiedzi. Gdy potrzebujesz sumy, mnożysz tę średnią przez liczbę pozycji podskali. To reguła proporcjonalna (ang. proration). Minimalna liczba odpowiedzi to umowa. Jeśli podręcznik narzędzia ją podaje, stosuj tę z podręcznika. Jeśli nie, przyjmij własną przed analizą i opisz ją w pracy. W SPS-10 przyjęliśmy co najmniej 4 z 5 odpowiedzi w podskali i co najmniej 8 z 10 w wyniku ogólnym.
Z tą regułą wynik podskali A ma 155 osób, wynik podskali B także 155, a wynik ogólny 157. Bez niej miałoby go 108 osób. Poza regułą zostają osoby z większą liczbą braków. Jedna pacjentka odpowiedziała tylko na trzy pierwsze pozycje, bo nie zauważyła drugiej strony arkusza.
| Ważne odpowiedzi | Podskala A (z 5) | Podskala B (z 5) | Cała skala (z 10) |
|---|---|---|---|
| Komplet | 136 | 127 | 108 |
| Jedna mniej | 19 | 28 | 41 |
| Dwie mniej | 5 (wynik niepoliczony) | 4 (wynik niepoliczony) | 8 |
| Więcej braków | 0 | 1 (wynik niepoliczony) | 3 (wynik niepoliczony) |
| Osoby z wynikiem | 155 | 155 | 157 |
Suma dostępnych odpowiedzi bez korekty – błąd, który łatwo przeoczyć
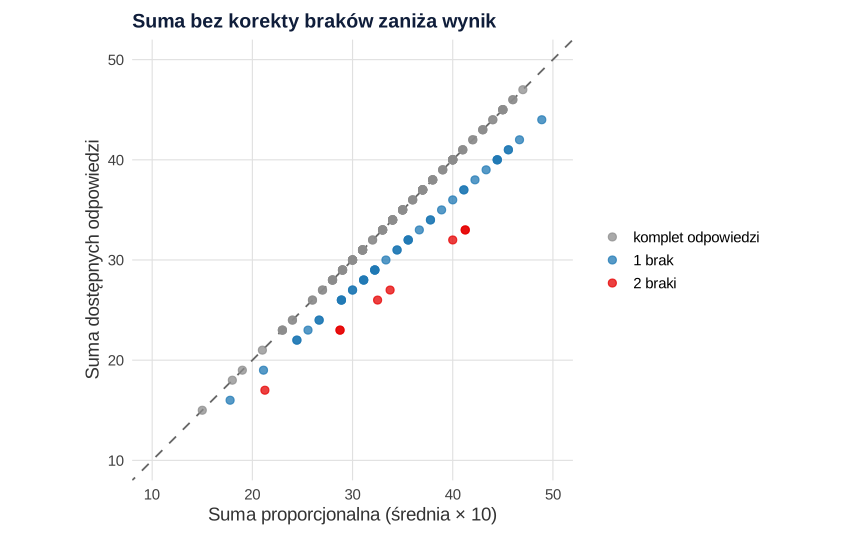
Wiele programów liczy sumę z pominięciem pustych komórek. Wygląda to niewinnie, ale osoba z brakiem dostaje wtedy niższy wynik tylko dlatego, że nie odpowiedziała. Pacjent nr 4 ma w podskali A odpowiedzi 1, 4, brak, 3 i 2. Suma dostępnych to 10 punktów. Suma proporcjonalna to 2.5 × 5 = 12.5 punktu. Na rysunku 3 widać to dla wyniku ogólnego. U osób z jednym brakiem suma dostępnych odpowiedzi jest przeciętnie o 3.47 punktu niższa niż suma proporcjonalna, a przy dwóch brakach – o 6.69 punktu. Średnia całej próby spada z 34.36 do 32.87, a 49 osób z brakami trafia niżej w rozkładzie, niż powinno.
Kiedy reguła proporcjonalna nie wystarcza
Reguła proporcjonalna jest de facto prostą imputacją: zakłada, że brakująca odpowiedź byłaby równa średniej pozostałych odpowiedzi tej osoby. Mazza i in. (2015) pokazali w symulacjach, że to silne założenie. Uśrednianie dostępnych pozycji dawało obciążenie wyników nawet wtedy, gdy braki były całkowicie losowe. Autorzy zaproponowali podejście oparte na metodzie największej wiarygodności, w którym pozycje pełnią rolę zmiennych pomocniczych. Downey i King (1998) porównali zastępowanie braku średnią osoby i średnią pozycji w skalach Likerta. Oba sposoby dobrze odtwarzały dane, gdy osoby z brakami i brakujące pozycje stanowiły najwyżej 20%. Przy większej liczbie braków średnia osoby sztucznie zawyżała korelacje między pozycjami, a więc i rzetelność.
Wniosek praktyczny: przy pojedynczych brakach w krótkiej skali reguła proporcjonalna jest rozsądnym kompromisem. Przy wielu brakach albo brakach skupionych w jednej grupie badanych potrzebujesz analizy braków i lepszej metody. Rodzaje braków opisuje hasło braki danych (MCAR, MAR, MNAR), a procedurę imputacji wielokrotnej – poradnik braki danych i imputacja wielokrotna w R.
Krok 5. Suma czy średnia?
Gdy osoba ma komplet odpowiedzi, suma i średnia niosą dokładnie tę samą informację. Średnia to suma podzielona przez stałą liczbę pozycji. W przykładzie korelacja średniej z sumą u 108 osób z kompletem odpowiedzi wynosi 1. Korelacje, testy i wartości p będą więc identyczne. Różnice dotyczą interpretacji i braków:
- Średnia zostaje w metryce odpowiedzi (1–5), więc od razu widać, że M = 3.44 to wynik nieco powyżej środka skali. Łatwo też porównać podskale o różnej liczbie pozycji. Przy brakach średnia z dostępnych pozycji to od razu wynik proporcjonalny.
- Suma jest potrzebna, gdy wymaga jej klucz narzędzia, a zwłaszcza gdy chcesz porównać wyniki z normami albo punktem odcięcia podanym w punktach. Przy brakach licz ją jako średnią × liczba pozycji, nigdy jako sumę dostępnych odpowiedzi.
Szerzej porównujemy oba sposoby w haśle wynik skali: średnia czy suma. Jeśli chcesz porównać skale o różnych zakresach, przydaje się też POMP, czyli procent maksymalnego możliwego wyniku. Pamiętaj również, że sama decyzja o sumowaniu pozycji to założenie o pomiarze. McNeish i Wolf (2020) przypominają, że wynik sumaryczny to szczególny, mocno ograniczony model czynnikowy, a nie „bezzałożeniowa” arytmetyka. Widaman i Revelle (2023) odpowiadają, że sumy mają solidne podstawy, jeśli zestaw pozycji jest jednowymiarowy. Dla pracy dyplomowej wniosek jest prosty: licz wynik tak, jak każe klucz, a jednowymiarowość podskali poprzyj wynikami z literatury albo własną analizą czynnikową.
Krok 6. Wynik ogólny – tylko wtedy, gdy narzędzie go przewiduje
Wynik ogólny łączy wszystkie pozycje albo wszystkie podskale. Wolno go liczyć wtedy, gdy przewiduje go klucz, a struktura narzędzia to uzasadnia. Podskale muszą mierzyć aspekty jednej cechy, a nie dwie różne cechy, które przypadkiem są w jednym arkuszu. Hasło podskala i wynik ogólny opisuje, jak to sprawdzić. W przykładzie podskale SPS-10 korelują na poziomie r = .35, a alfa dla 10 pozycji wynosi .81. Fikcyjny podręcznik przewiduje wynik ogólny, więc go liczymy.
Przy wyniku ogólnym wróć do reguły braków. Przyjęliśmy regułę „co najmniej 8 z 10 odpowiedzi”. Sześć osób ma według niej wynik ogólny, choć nie ma wyniku jednej z podskal. Tak jest u osoby 17 na rysunku 1: brakuje jej dwóch odpowiedzi w podskali B, więc ta podskala nie jest liczona, a wynik ogólny wynosi 4.12. U takich osób wynik ogólny opiera się głównie na podskali A. Część kluczy wymaga więc, aby wynik ogólny liczyć tylko u osób z wynikami wszystkich podskal. Nie ma tu jednej dobrej odpowiedzi. Ważne, żebyś wybrał regułę przed analizą, napisał ją w pracy i stosował tak samo we wszystkich programach.
Krok 7. Kontrola wartości niemożliwych: przed liczeniem i po
Na skali 1–5 możliwe są tylko liczby 1, 2, 3, 4 i 5. Wszystko inne to kod braku, literówka albo błąd importu. Zanim policzysz wynik, sprawdź minimum i maksimum każdej pozycji. W przykładzie przegląd pokazał 7 takich komórek:
- kod −99 (odmowa odpowiedzi) pięć razy: w pozycji 5 u osób 12, 75 i 120 oraz w pozycji 9 u osób 31 i 140;
- wartość 44 w pozycji 6 u osoby 66 – podwójne wciśnięcie klawisza;
- wartość 0 w pozycji 2 u osoby 149.
Literówki najlepiej poprawić według papierowego arkusza. Jeśli to niemożliwe, zamień je na brak i zapisz tę decyzję. Kod −99 musi zostać zadeklarowany jako brak albo zamieniony na pustą komórkę. Inaczej program potraktuje go jak zwykłą liczbę. Skutki są dramatyczne. Osoba 12 ma w podskali A odpowiedzi 4, 2, 1 (po odwróceniu), 2 i −99. Z kodem liczonym jak liczba jej średnia wynosi −18, a po zamianie kodu na brak – 2.25. W całej próbie kod −99 trafił do wyniku ogólnego pięciu osób. Najniższy wynik spadł do −7.7, a SD wzrosło z 0.68 do 1.91. Pięć „wartości odstających” w rozdziale wyników to wtedy nie pacjenci, tylko kody braków. Jak je wyłapywać, opisuje poradnik wartości odstające: jak je wykryć.
Po kroku 6 sprawdź zakres gotowych wyników. Średnie muszą leżeć w przedziale 1–5, sumy podskal w przedziale 5–25. W przykładzie wynik ogólny ma zakres od 1.50 do 4.89, a żaden wynik nie wypada poza skalę. To jednak warunek konieczny, a nie wystarczający. Zapomniane odwrócenie nie wyprowadzi wyniku poza skalę, a mimo to go zniekształci. Wynik ogólny policzony bez odwrócenia pozycji 3, 7 i 9 miał M = 3.21 i SD = 0.41 zamiast M = 3.44 i SD = 0.68. Z poprawnym wynikiem korelował tylko na poziomie r = .75. Dlatego kontrola zakresu nie zastąpi sprawdzenia korelacji pozycja–reszta z kroku 2.
| Wersja wyniku ogólnego (średnia 1–5) | n | M | SD | Min | Maks |
|---|---|---|---|---|---|
| Poprawnie | 157 | 3.44 | 0.68 | 1.50 | 4.89 |
| Bez odwrócenia pozycji 3, 7 i 9 | 157 | 3.21 | 0.41 | 2.10 | 4.10 |
| Kod −99 liczony jak liczba | 157 | 3.11 | 1.91 | −7.70 | 4.89 |
Kontrolę zakresu warto połączyć z ogólnym przeglądem danych: duplikatami, osobami, które wszędzie zaznaczyły tę samą odpowiedź, i zbyt szybkim wypełnianiem ankiet online. Procedurę opisują hasło czyszczenie danych z ankiety online i poradnik jak przygotować bazę danych do analizy.
Ten sam wynik w Excelu
W pliku do pobrania wynik liczą formuły w arkuszu Wyniki, a dane pochodzą z arkusza Dane (po czyszczeniu). Każdy wiersz to jedna osoba. Formuły podajemy w polskiej wersji Excela: z polskimi nazwami funkcji i średnikiem między argumentami. Nazwy sprawdziliśmy w polskiej pomocy Microsoft (Microsoft, b.d.-a, b.d.-b, b.d.-c). Na danych z przykładu formuły przeliczone w LibreOffice Calc dały te same wyniki co R. Największa różnica była rzędu 10−14, a braki wyniku pojawiły się u tych samych osób.
| Krok | Formuła (wiersz 2) | Co robi |
|---|---|---|
| 7a. Kontrola zakresu | =LICZ.JEŻELI(Dane_surowe!B2:K2;">5")+LICZ.JEŻELI(Dane_surowe!B2:K2;"<1") | Liczy w wierszu wartości większe niż 5 i mniejsze niż 1 |
| 7a. Kontrola kolumny | =MIN(Dane_surowe!B2:B161), =MAX(Dane_surowe!B2:B161) | Minimum i maksimum pozycji – od razu widać −99 i 44 |
| 2. Pozycja zwykła | =JEŻELI(Dane!B2="";"";Dane!B2) | Przepisuje odpowiedź, a brak zostawia pusty |
| 2. Pozycja odwrócona | =JEŻELI(Dane!D2="";"";6-Dane!D2) | 6 − x; bez warunku pusta komórka dałaby 6 |
| 4. Ważne odpowiedzi | =ILE.LICZB(B2:F2) | Liczy komórki z liczbą w podskali A |
| 3–4. Podskala A | =JEŻELI(L2>=4;ŚREDNIA(B2:F2);"") | Średnia dostępnych pozycji, gdy są co najmniej 4 z 5 |
| 6. Wynik ogólny | =JEŻELI(P2>=8;ŚREDNIA(B2:K2);"") | Średnia 10 pozycji, gdy jest co najmniej 8 odpowiedzi |
| 5. Suma proporcjonalna | =JEŻELI(Q2="";"";Q2*10) | Wynik ogólny w punktach 10–50 |
Kilka szczegółów decyduje o poprawności. Funkcja ŚREDNIA (ang. AVERAGE) pomija puste komórki i tekst, ale uwzględnia zera (Microsoft, b.d.-c). Jeśli więc w Twoim pliku brak oznaczono zerem, średnia będzie zaniżona. Zera trzeba najpierw usunąć, tak jak −99. Pusty tekst "", który zwraca JEŻELI (IF), dla ŚREDNIEJ jest tekstem, więc też zostanie pominięty. ILE.LICZB (COUNT) liczy tylko komórki z liczbami, a LICZ.JEŻELI (COUNTIF) – komórki spełniające warunek (Microsoft, b.d.-a). Składnię warunku w JEŻELI opisuje pomoc Microsoft (Microsoft, b.d.-b). Po co liczyć to w Excelu, a kiedy przejść do programu statystycznego, piszemy w poradniku analiza statystyczna w Excelu.
Ten sam wynik w składni SPSS
W SPSS najwygodniej zapisać wszystkie kroki w pliku składni. Zostaje wtedy ślad każdej decyzji. Poniższa składnia używa poleceń i funkcji opisanych w dokumentacji IBM. Liczby z tego wpisu pochodzą z R i z formuł przeliczonych w LibreOffice, a nie z uruchomienia tej składni.
DESCRIPTIVES VARIABLES=p1 TO p10 /STATISTICS=MIN MAX.
* Kod -99 i dwie literówki (0 i 44) jako braki.
MISSING VALUES p1 TO p10 (-99, 0, 44).
* Krok 2. Pozycje odwrócone: 6 - x, w nowych zmiennych.
COMPUTE p3_odwr = 6 - p3.
COMPUTE p7_odwr = 6 - p7.
COMPUTE p9_odwr = 6 - p9.
* Kroki 3-4. Podskale: średnia, gdy są co najmniej 4 z 5 odpowiedzi.
COMPUTE samokontrola = MEAN.4(p1, p2, p3_odwr, p4, p5).
COMPUTE trudnosci = MEAN.4(p6, p7_odwr, p8, p9_odwr, p10).
* Kroki 5-6. Wynik ogólny (co najmniej 8 z 10) i suma proporcjonalna.
COMPUTE ogolny = MEAN.8(p1, p2, p3_odwr, p4, p5, p6, p7_odwr, p8, p9_odwr, p10).
COMPUTE ogolny_suma = ogolny * 10.
* Krok 7b. Zakres gotowych wyników.
DESCRIPTIVES VARIABLES=samokontrola trudnosci ogolny ogolny_suma /STATISTICS=MEAN STDDEV MIN MAX.
Co warto wiedzieć o tych poleceniach:
- MISSING VALUES deklaruje podane wartości jako braki zdefiniowane przez użytkownika. Przekształcenia i procedury mogą je wtedy traktować jak braki (IBM Corp., b.d.-b). Bez tej deklaracji −99 jest zwykłą liczbą.
- COMPUTE p3_odwr = 6 - p3 nie potrzebuje osobnego warunku dla braków. Wyrażenie arytmetyczne daje brak systemowy, gdy brakuje którejkolwiek wartości (IBM Corp., b.d.-c).
- MEAN.4(…) liczy średnią tylko wtedy, gdy co najmniej 4 argumenty mają ważne wartości. Przyrostek .n działa w funkcjach SUM, MEAN, MIN, MAX, SD, VARIANCE i CFVAR (IBM Corp., b.d.-c). Bez przyrostka MEAN liczy średnią już z jednej ważnej odpowiedzi (IBM Corp., b.d.-d).
- SUM.4(…) to nie jest suma proporcjonalna. SUM dodaje tylko ważne argumenty (IBM Corp., b.d.-d), więc daje sumę dostępnych odpowiedzi – dokładnie ten błąd, który pokazuje rysunek 3. Sumę licz jako MEAN.n × liczba pozycji.
- DESCRIPTIVES z /STATISTICS=MIN MAX pokazuje minimum i maksimum każdej zmiennej (IBM Corp., b.d.-a). Pierwsze wywołanie od razu pokaże −99 jako minimum i 44 jako maksimum.
Na końcu porównaj wydruk DESCRIPTIVES z wynikami z pliku przykładowego: średnie i zakresy powinny się zgadzać co do drugiego miejsca po przecinku. Jak czytać tabele z SPSS, opisuje poradnik jak czytać wyniki z SPSS.
Ten sam wynik w jamovi (i JASP)
W jamovi wynik liczysz w nowych kolumnach. Dokumentacja programu opisuje dwa sposoby (The jamovi project, b.d.-a):
- pojedynczą pozycję odwrócisz w nowej kolumnie New Computed Variable z formułą max + 1 − pozycja, czyli dla SPS-10:
6 - p3; - kilka pozycji naraz odwrócisz przez New Transformed Variable: wybierasz pozycję jako zmienną źródłową i tworzysz przekształcenie (Create New Transform…) z formułą
6 - $source, które potem stosujesz do pozostałych pozycji odwróconych.
Wynik podskali to kolejna kolumna obliczana, np. MEAN(p1, p2, p3_odwr, p4, p5). Funkcja MEAN liczy średnią w wierszu, a SUM – sumę (The jamovi project, b.d.-b). Dokumentacja nie opisuje jednak, jak te funkcje traktują braki. Dlatego zanim przyjmiesz wynik, obejrzyj kilka wierszy z brakiem, np. osoby 4, 12 i 17 z pliku przykładowego. Sprawdź, czy wynik jest pusty, czy policzony z dostępnych odpowiedzi, i porównaj go z kolumną z wynikami z R. Kod −99 usuń z danych przed importem albo upewnij się, że program traktuje go jako brak.
W JASP logika jest ta sama: nowa kolumna liczona z formuły, osobno dla pozycji odwróconych i dla wyniku. Tu również sprawdź zachowanie funkcji przy brakach na kilku wierszach.
Wynik kwestionariusza w R
Przepis wczytuje surowe dane z pliku do pobrania i przechodzi przez wszystkie kroki: kontrolę zakresu, odwrócenie pozycji, podskale z regułą braków, wynik ogólny i sumę proporcjonalną. Na końcu sprawdza zakres wyników i rzetelność. Pozostałe liczby z tekstu (korelacje przed odwróceniem, skutki błędów, liczba braków) liczy skrypt b60-1-wynik.R, a plik Excela z kontrolą w LibreOffice – b60-2-plik.R; oba korzystają z tych samych danych symulowanych (set.seed(6010)).
Siedem kroków w jednym skrypcie
R
# Wynik fikcyjnej skali SPS-10 w siedmiu krokach (dane symulowane)
# Plik wynik-kwestionariusza-przyklad.xlsx pobierzesz ze strony wpisu
library(psych)
d <- as.data.frame(readxl::read_excel("wynik-kwestionariusza-przyklad.xlsx", sheet = "Dane_surowe"))
P <- paste0("p", 1:10); A <- P[1:5]; B <- P[6:10]; odw <- c("p3", "p7", "p9")

# Krok 7a: wartości spoza 1–5 (kod -99 i literówki) – najpierw je znajdź, potem zamień na brak
which(!is.na(d[P]) & !(as.matrix(d[P]) %in% 1:5), arr.ind = TRUE)
d[P] <- lapply(d[P], function(x) replace(x, !(x %in% 1:5), NA))

# Krok 2: pozycje odwrócone – max + min − x
d[odw] <- 6 - d[odw]

# Kroki 3–4: podskale; reguła braków: wynik tylko przy co najmniej k ważnych odpowiedziach
wynik <- function(dane, poz, k) {
  n_waz <- rowSums(!is.na(dane[poz]))
  ifelse(n_waz >= k, rowMeans(dane[poz], na.rm = TRUE), NA)
}
d$A <- wynik(d, A, 4)
d$B <- wynik(d, B, 4)
# Kroki 5–6: średnia (1–5) i suma proporcjonalna; wynik ogólny – co najmniej 8 z 10
d$ogolny <- wynik(d, P, 8)
d$ogolny_suma <- d$ogolny * 10

# Krok 7b: kontrola wyników i rzetelność podskal
round(sapply(d[c("A", "B", "ogolny", "ogolny_suma")], function(x)
  c(n = sum(!is.na(x)), M = mean(x, na.rm = TRUE), SD = sd(x, na.rm = TRUE),
    min = min(x, na.rm = TRUE), max = max(x, na.rm = TRUE))), 2)
round(c(alfa_A = alpha(d[A])$total$raw_alpha, alfa_B = alpha(d[B])$total$raw_alpha), 2)
alpha(d[B])$item.stats["r.drop"]          # po odwróceniu wszystkie korelacje dodatnie
Wynik w R
     row col
[1,] 149   2
[2,]  12   5
[3,]  75   5
[4,] 120   5
[5,]  66   6
[6,]  31   9
[7,] 140   9
         A      B ogolny ogolny_suma
n   155.00 155.00 157.00      157.00
M     3.45   3.43   3.44       34.36
SD    0.85   0.81   0.68        6.83
min   1.40   1.00   1.50       15.00
max   5.00   5.00   4.89       48.89
alfa_A alfa_B
  0.81   0.77
       r.drop
p6  0.6846244
p7  0.3887053
p8  0.5901015
p9  0.4763734
p10 0.5782938
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia kodu w R 4.5.3. Alfę i korelacje pozycja–reszta liczy funkcja alpha() z pakietu psych, dane wczytuje pakiet readxl, plik Excela z formułami zapisano pakietem openxlsx, a rysunki przygotowano w pakiecie ggplot2. Formuły sprawdzono w LibreOffice Calc 7.5.4. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- readxl (wersja 1.4.5): Wickham, H., & Bryan, J. (2025). readxl: Read Excel files [R package]. https://doi.org/10.32614/CRAN.package.readxl
- openxlsx (wersja 4.2.8.1): Schauberger, P., & Walker, A. (2025). openxlsx: Read, write and edit xlsx files [R package]. https://doi.org/10.32614/CRAN.package.openxlsx
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Jak opisać sposób liczenia wyniku w pracy
W podrozdziale o narzędziach podaj klucz w skrócie: liczbę pozycji, skalę odpowiedzi, podskale, pozycje odwrócone, sposób liczenia (suma czy średnia), zakres wyników, kierunek interpretacji i regułę braków. W wynikach dodaj, u ilu osób wynik policzono. Pełny wzór opisu narzędzia – od autorów i adaptacji po licencję – znajdziesz w poradniku opis narzędzia badawczego w pracy. Poniżej fragment dla przykładu z SPS-10:
Gdy masz już wyniki, możesz zdecydować, czy podzielić je na poziomy. Kiedy to ma sens i jak to zrobić bez utraty informacji, opisujemy we wpisie niski, przeciętny, wysoki wynik. Konkretne narzędzia, z kluczem i zasadami interpretacji ze źródeł, omawiamy w osobnych wpisach o PSS-10, GAD-7 i PHQ-9, SWLS i Skali Samooceny Rosenberga. Jeśli piszesz pracę z nauk o zdrowiu, zajrzyj też do wpisu statystyka w pracy z pielęgniarstwa.
Najczęstsze błędy przy liczeniu wyniku
- Brak odwrócenia pozycji albo odwrócenie nie tych pozycji. Wynik nie wychodzi poza skalę, ale traci zmienność i trafność. Sprawdzisz to korelacją pozycja–reszta.
- Wzór 6 − x na skali innej niż 1–5. Zawsze licz (max + min) − x.
- Nadpisanie oryginalnych pozycji wersją odwróconą. Drugie uruchomienie skryptu odwraca je z powrotem.
- Kod braku liczony jak liczba (−99, 9, 99 albo 0). Jedna taka komórka potrafi przesunąć wynik osoby daleko poza skalę.
- Suma dostępnych odpowiedzi zamiast sumy proporcjonalnej. Osoby z brakami dostają niższe wyniki tylko dlatego, że coś pominęły. W SPSS dotyczy to też SUM.n.
- Reguła braków wymyślona po obejrzeniu wyników albo różna w różnych programach. Zapisz ją przed analizą.
- Wynik ogólny z podskal, które mierzą różne cechy, bo „tak było łatwiej”. Liczy się klucz i struktura narzędzia.
- Klucz przepisany z cudzej pracy zamiast z podręcznika lub publikacji autorów.
- Brak informacji w pracy, jak liczono wynik i ile osób odpadło z powodu braków.
Jeśli masz wątpliwości, czy wynik w Twojej bazie policzono poprawnie, możesz sprawdzić go razem ze statystykiem w ramach analiz statystycznych dla studentów. Decyzje o kluczu i regule braków musisz jednak rozumieć i umieć uzasadnić samodzielnie.
Najczęstsze pytania
Jak odwrócić pozycje w kwestionariuszu na skali 1–7?
Użyj wzoru (max + min) − x, czyli na skali 1–7: 8 − x. Odpowiedź 1 zmieni się w 7, 2 w 6, a 4 zostanie czwórką. Na skali 0–4 ten sam wzór daje 4 − x. Odwrócone pozycje zapisz w nowych kolumnach i sprawdź przekodowanie tabelą krzyżową starej i nowej kolumny.
Ile odpowiedzi może brakować, żeby policzyć wynik podskali?
Jeśli podręcznik narzędzia podaje regułę, stosuj ją. Jeśli jej nie podaje, przyjmij własną przed analizą, np. „co najmniej 4 z 5 odpowiedzi” albo „co najmniej 80% pozycji”, i opisz ją w pracy. Wynik licz wtedy jako średnią z dostępnych odpowiedzi. Przy licznych brakach ta prosta reguła może zniekształcać wyniki (Mazza i in., 2015).
Dlaczego suma odpowiedzi z brakami zaniża wynik?
Bo pominięta odpowiedź liczy się jak zero punktów. W przykładzie z tego wpisu osoby z jednym brakiem dostały przeciętnie wynik niższy o 3.47 punktu, a z dwoma brakami – o 6.69 punktu. Gdy potrzebujesz sumy, policz średnią z dostępnych odpowiedzi i pomnóż ją przez liczbę pozycji (suma proporcjonalna).
Jak policzyć wynik kwestionariusza w Excelu, gdy są puste komórki?
Użyj funkcji ŚREDNIA, która pomija puste komórki, razem z ILE.LICZB i JEŻELI, np. =JEŻELI(ILE.LICZB(B2:F2)>=4;ŚREDNIA(B2:F2);""). Pamiętaj, że ŚREDNIA uwzględnia zera, więc kod braku 0 albo −99 musisz najpierw usunąć z danych. Gotowy plik z formułami pobierzesz z tego wpisu.
Czym różni się MEAN.4 od SUM.4 w SPSS?
MEAN.4 liczy średnią, jeśli co najmniej 4 argumenty mają ważne wartości. SUM.4 przy tym samym warunku dodaje tylko ważne wartości, więc daje sumę dostępnych odpowiedzi, czyli wynik zaniżony u osób z brakami. Sumę proporcjonalną policzysz jako MEAN.n pomnożone przez liczbę pozycji.
Powiązane hasła
Przeczytaj też
Niski, przeciętny, wysoki wynik
Steny, punkty odcięcia, podział skali i tercyle na jednym przykładzie: odsetki z CI, wady podziału z próby, wynik ciągły zamiast poziomów i wzór opisu.
Czytaj →PoradnikOpis narzędzia badawczego – wzór
Dziesięć elementów opisu i cztery wzory: kwestionariusz z adaptacją, ankieta własna, test wiedzy i skala kliniczna – z rzetelnością z własnej próby.
Czytaj →PoradnikJak przygotować bazę danych do analizy
Układ bazy, nazwy zmiennych, kodowanie ankiety, braki, pułapki Excela, widok zmiennych w SPSS i kontrola jakości – z szablonem .xlsx, .sav i .csv do pobrania.
Czytaj →Nie masz pewności, czy wynik skali policzono poprawnie?
Sprawdzimy klucz, odwrócone pozycje, regułę braków i formuły w Twojej bazie oraz wyjaśnimy każdy krok tak, żebyś umiał(a) go opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Downey, R. G., & King, C. V. (1998). Missing data in Likert ratings: A comparison of replacement methods. The Journal of General Psychology, 125(2), 175–191. https://doi.org/10.1080/00221309809595542
- IBM Corp. (b.d.-a). DESCRIPTIVES. IBM SPSS Statistics 24.0.0 Command Syntax Reference. https://www.ibm.com/support/knowledgecenter/SSLVMB_24.0.0/spss/base/syn_descriptives.html ● Otwarty dostęp
- IBM Corp. (b.d.-b). MISSING VALUES. IBM SPSS Statistics 24.0.0 Command Syntax Reference. https://www.ibm.com/support/knowledgecenter/SSLVMB_24.0.0/spss/base/syn_missing_values.html ● Otwarty dostęp
- IBM Corp. (b.d.-c). Missing values in numeric expressions. IBM SPSS Statistics 26.0.0 Command Syntax Reference. https://www.ibm.com/docs/en/SSLVMB_26.0.0/statistics_reference_project_ddita/spss/base/syn_transformation_expressions_missing_values_in_numeric_expressions.html ● Otwarty dostęp
- IBM Corp. (b.d.-d). Statistical functions. IBM SPSS Statistics 24.0.0 Command Syntax Reference. https://www.ibm.com/support/knowledgecenter/SSLVMB_24.0.0/spss/base/syn_transformation_expressions_statistical_functions.html ● Otwarty dostęp
- Mazza, G. L., Enders, C. K., & Ruehlman, L. S. (2015). Addressing item-level missing data: A comparison of proration and full information maximum likelihood estimation. Multivariate Behavioral Research, 50(5), 504–519. https://doi.org/10.1080/00273171.2015.1068157 ● Otwarty dostęp: pełny tekst
- McNeish, D., & Wolf, M. G. (2020). Thinking twice about sum scores. Behavior Research Methods, 52(6), 2287–2305. https://doi.org/10.3758/s13428-020-01398-0 ● Otwarty dostęp
- Microsoft. (b.d.-a). Funkcje statystyczne (informacje). Microsoft Support. https://support.microsoft.com/pl-pl/excel/statistical-functions-reference ● Otwarty dostęp
- Microsoft. (b.d.-b). JEŻELI, funkcja. Microsoft Support. https://support.microsoft.com/pl-pl/office/funkcja-je%C5%BCeli-69aed7c9-4e8a-4755-a9bc-aa8bbff73be2 ● Otwarty dostęp
- Microsoft. (b.d.-c). ŚREDNIA (funkcja). Microsoft Support. https://support.microsoft.com/pl-pl/office/%C5%9Brednia-funkcja-047bac88-d466-426c-a32b-8f33eb960cf6 ● Otwarty dostęp
- The jamovi project. (b.d.-a). Common data recipes. jamovi documentation. https://docs.jamovi.org/data/data_8_common_data_recipes.html ● Otwarty dostęp
- The jamovi project. (b.d.-b). List of functions. jamovi documentation. https://docs.jamovi.org/data/data_5_list_of_functions.html ● Otwarty dostęp
- van Sonderen, E., Sanderman, R., & Coyne, J. C. (2013). Ineffectiveness of reverse wording of questionnaire items: Let’s learn from cows in the rain. PLoS ONE, 8(7), Article e68967. https://doi.org/10.1371/journal.pone.0068967 ● Otwarty dostęp
- Widaman, K. F., & Revelle, W. (2023). Thinking thrice about sum scores, and then some more about measurement and analysis. Behavior Research Methods, 55(2), 788–806. https://doi.org/10.3758/s13428-022-01849-w ● Otwarty dostęp
Cytowania BibTeX
@article{downey1998missing, author={Downey, Ronald G. and King, Craig V.}, title={{Missing data in Likert ratings: A comparison of replacement methods}}, journal={The Journal of General Psychology}, year={1998}, volume={125}, number={2}, pages={175--191}, doi={10.1080/00221309809595542}}@misc{ibmnddescriptives, author={{IBM Corp.}}, title={{DESCRIPTIVES}}, howpublished={IBM SPSS Statistics 24.0.0 Command Syntax Reference}, year={b.d.-a}, publisher={IBM}, url={https://www.ibm.com/support/knowledgecenter/SSLVMB_24.0.0/spss/base/syn_descriptives.html}}@misc{ibmndmissingvalues, author={{IBM Corp.}}, title={{MISSING VALUES}}, howpublished={IBM SPSS Statistics 24.0.0 Command Syntax Reference}, year={b.d.-b}, publisher={IBM}, url={https://www.ibm.com/support/knowledgecenter/SSLVMB_24.0.0/spss/base/syn_missing_values.html}}@misc{ibmndmissingnumeric, author={{IBM Corp.}}, title={{Missing values in numeric expressions}}, howpublished={IBM SPSS Statistics 26.0.0 Command Syntax Reference}, year={b.d.-c}, publisher={IBM}, url={https://www.ibm.com/docs/en/SSLVMB_26.0.0/statistics_reference_project_ddita/spss/base/syn_transformation_expressions_missing_values_in_numeric_expressions.html}}@misc{ibmndstatfunctions, author={{IBM Corp.}}, title={{Statistical functions}}, howpublished={IBM SPSS Statistics 24.0.0 Command Syntax Reference}, year={b.d.-d}, publisher={IBM}, url={https://www.ibm.com/support/knowledgecenter/SSLVMB_24.0.0/spss/base/syn_transformation_expressions_statistical_functions.html}}@article{mazza2015addressing, author={Mazza, Gina L. and Enders, Craig K. and Ruehlman, Linda S.}, title={{Addressing item-level missing data: A comparison of proration and full information maximum likelihood estimation}}, journal={Multivariate Behavioral Research}, year={2015}, volume={50}, number={5}, pages={504--519}, doi={10.1080/00273171.2015.1068157}}@article{mcneish2020thinking, author={McNeish, Daniel and Wolf, Melissa Gordon}, title={{Thinking twice about sum scores}}, journal={Behavior Research Methods}, year={2020}, volume={52}, number={6}, pages={2287--2305}, doi={10.3758/s13428-020-01398-0}}@misc{microsoftndfunkcje, author={{Microsoft}}, title={{Funkcje statystyczne (informacje)}}, howpublished={Microsoft Support}, year={b.d.-a}, publisher={Microsoft}, url={https://support.microsoft.com/pl-pl/excel/statistical-functions-reference}}@misc{microsoftndjezeli, author={{Microsoft}}, title={{JEŻELI, funkcja}}, howpublished={Microsoft Support}, year={b.d.-b}, publisher={Microsoft}, url={https://support.microsoft.com/pl-pl/office/funkcja-je%C5%BCeli-69aed7c9-4e8a-4755-a9bc-aa8bbff73be2}}@misc{microsoftndsrednia, author={{Microsoft}}, title={{ŚREDNIA (funkcja)}}, howpublished={Microsoft Support}, year={b.d.-c}, publisher={Microsoft}, url={https://support.microsoft.com/pl-pl/office/%C5%9Brednia-funkcja-047bac88-d466-426c-a32b-8f33eb960cf6}}@misc{jamovindrecipes, author={{The jamovi project}}, title={{Common data recipes}}, howpublished={jamovi documentation}, year={b.d.-a}, publisher={The jamovi project}, url={https://docs.jamovi.org/data/data_8_common_data_recipes.html}}@misc{jamovindfunctions, author={{The jamovi project}}, title={{List of functions}}, howpublished={jamovi documentation}, year={b.d.-b}, publisher={The jamovi project}, url={https://docs.jamovi.org/data/data_5_list_of_functions.html}}@article{vansonderen2013ineffectiveness, author={van Sonderen, Eric and Sanderman, Robbert and Coyne, James C.}, title={{Ineffectiveness of reverse wording of questionnaire items: Let’s learn from cows in the rain}}, journal={PLoS ONE}, year={2013}, volume={8}, number={7}, eid={e68967}, doi={10.1371/journal.pone.0068967}}@article{widaman2023thinking, author={Widaman, Keith F. and Revelle, William}, title={{Thinking thrice about sum scores, and then some more about measurement and analysis}}, journal={Behavior Research Methods}, year={2023}, volume={55}, number={2}, pages={788--806}, doi={10.3758/s13428-022-01849-w}}