Czym jest PSS-10 i skąd się wzięła
Skala Odczuwanego Stresu (Perceived Stress Scale, PSS) mierzy, w jakim stopniu osoba ocenia sytuacje ze swojego życia jako stresujące. Nie pyta o konkretne wydarzenia, tylko o to, jak często w ostatnim miesiącu życie wydawało się nieprzewidywalne, niekontrolowane i przytłaczające (Klein i in., 2016). Cohen i in. (1983) opisali pierwotną wersję z 14 pozycjami. W trzech próbach, dwóch studenckich i jednej z programu rzucania palenia, miała ona zadowalającą rzetelność. Jej wynik wiązał się z objawami depresyjnymi i somatycznymi oraz z korzystaniem z opieki zdrowotnej. Lepiej niż liczba wydarzeń życiowych przewidywał też te zmienne. W tej samej pracy autorzy opisali wersję 4-pozycyjną do wywiadów telefonicznych.
Właściwości wersji 10-pozycyjnej, dziś najczęściej używanej, oraz dane normatywne z dużej próby mieszkańców USA z 1983 roku opisali Cohen i Williamson (1988). Lee (2012) przejrzała 19 prac psychometrycznych o PSS i doszła do wniosku, że właściwości wersji 10-pozycyjnej są lepsze niż 14-pozycyjnej, a najsłabsze ma wersja 4-pozycyjna. Zauważyła też, że rzetelność test–retest i trafność kryterialną badano rzadko, a większość prób stanowili studenci i pracownicy.
W pracach dyplomowych PSS-10 pojawia się jako zmienna zależna (np. stres przed sesją i po treningu), predyktor (stres a jakość snu) albo zmienna kontrolna. Niezależnie od roli wynik liczysz tak samo. W tej serii poradników opisujemy też liczenie wyników GAD-7 i PHQ-9, skali SWLS i Skali Samooceny Rosenberga. Jak opisać to narzędzie w rozdziale metodologicznym, pokazujemy na końcu, a ogólny schemat opisu każdego narzędzia jest w poradniku opis narzędzia badawczego – wzór.
Budowa skali i odpowiedzi
PSS-10 ma 10 pozycji i jeden wynik ogólny. Osoba badana zaznacza, jak często w ostatnim miesiącu doświadczała opisanego stanu. Odpowiada na pięciostopniowej skali częstości od 0 do 4, czyli na skali typu Likerta. W wersji oryginalnej odpowiedzi mają etykiety never (0), almost never (1), sometimes (2), fairly often (3) i very often (4) (Klein i in., 2016). W pracy po polsku użyj etykiet z polskiej adaptacji, z której korzystasz. Treści pozycji tu nie podajemy, bo narzędzie ma właściciela praw, a przedruk pozycji w publikacjach wymaga zgody (International Test Commission, 2014).
| Cecha | PSS-10 | Źródło |
|---|---|---|
| Liczba pozycji | 10 | Cohen i Williamson (1988); Klein i in. (2016) |
| Okres odniesienia | ostatni miesiąc | Klein i in. (2016); Carnegie Mellon University (b.d.) |
| Skala odpowiedzi | 0–4 (od never do very often) | Klein i in. (2016) |
| Pozycje odwrócone | 4, 5, 7 i 8 (sformułowane pozytywnie) | Klein i in. (2016) |
| Wynik | suma 10 pozycji po odwróceniu | Klein i in. (2016) |
| Zakres wyniku | 0–40; wyższy wynik = większy odczuwany stres | wynika z punktacji |
| Punkty odcięcia | brak – skala nie jest narzędziem diagnostycznym | Carnegie Mellon University (b.d.); Klein i in. (2016) |
Sześć pozycji opisuje stany negatywne, np. poczucie, że trudności narastają. Cztery pozycje, 4, 5, 7 i 8, opisują stany pozytywne, np. poczucie radzenia sobie. Wysoka odpowiedź na pozycji pozytywnej oznacza więc mniej stresu i trzeba ją odwrócić, zanim dodasz ją do sumy (zob. pozycja odwrócona). Okres odniesienia też ma znaczenie. Laboratorium autora skali zaznacza, że nie zbierało danych psychometrycznych dla innych okresów niż miesiąc. Przewiduje, że dłuższy okres pogorszy dokładność pomiaru, a krótszy nie powinien być problemem (Carnegie Mellon University, b.d.). Jeśli zmieniasz instrukcję, napisz o tym w pracy.
Jak policzyć wynik PSS-10 krok po kroku
Krok 1. Sprawdź, czy w danych są tylko wartości 0–4
Formularze online często zapisują odpowiedzi jako 1–5 albo jako tekst. Zanim cokolwiek policzysz, sprawdź kodowanie. Jeśli odpowiedzi są zapisane jako 1–5, odejmij 1 od każdej, bo inaczej zakres wyniku przesunie się do 10–50. Kontrolę wartości niemożliwych i przekodowanie w różnych programach opisuje poradnik jak policzyć wynik kwestionariusza.
Krok 2. Odwróć pozycje 4, 5, 7 i 8
Przy skali 0–4 nowa wartość to 4 − odpowiedź (ogólnie: maksimum + minimum − odpowiedź). Środek skali zostaje na miejscu:
| Odpowiedź zaznaczona | 0 | 1 | 2 | 3 | 4 |
|---|---|---|---|---|---|
| Wartość po odwróceniu (4 − x) | 4 | 3 | 2 | 1 | 0 |
Zapisz odwrócone pozycje w nowych kolumnach (np. p4_odw) i zostaw surowe odpowiedzi bez zmian. Unikniesz wtedy podwójnego odwrócenia, gdy uruchomisz skrypt drugi raz.
Krok 3. Zsumuj 10 pozycji
Wynik PSS-10 to suma sześciu pozycji negatywnych i czterech odwróconych pozycji pozytywnych, w zakresie 0–40 (Klein i in., 2016). Suma jest standardem tej skali i pozwala porównać Twoje wyniki z literaturą. Średnia z pozycji (0–4) daje te same wnioski z analiz, ale utrudnia porównania. Jeśli ją wybierzesz, napisz o tym wprost (zob. wynik skali: średnia czy suma).
Krok 4. Zdecyduj, co zrobisz z brakami
Źródła, które tu cytujemy, nie podają reguły dla pojedynczych braków. Klein i in. (2016) po prostu wykluczyli z analizy osoby, które nie odpowiedziały na wszystkie 10 pozycji. Możesz zrobić tak samo albo przyjąć regułę proporcjonalną, np. przy jednym braku średnia z dziewięciu pozycji pomnożona przez 10. To jednak Twoja decyzja, a nie zasada skali. Zapisz ją przed analizą, podaj w pracy i napisz, ilu osób dotyczyła. Mechanizmy braków danych opisuje hasło braki danych MCAR, MAR i MNAR.
Jak interpretować wynik: dlaczego nie ma progów
Wyższy wynik oznacza większy odczuwany stres. Na tym kończy się interpretacja, którą dają autorzy skali. Laboratorium Sheldona Cohena pisze wprost, że PSS nie jest narzędziem diagnostycznym, nie ma punktów odcięcia, a wyniki porównuje się w obrębie własnej próby (Carnegie Mellon University, b.d.). To samo podkreślają Klein i in. (2016). Dane normatywne z dużych prób amerykańskich istnieją (Cohen i Williamson, 1988), ale pochodzą z innej populacji. Nie pozwalają one ocenić wyniku polskiego studenta jako „wysokiego”.
W internecie i w części prac dyplomowych spotkasz gotowe przedziały „stres niski, umiarkowany, wysoki”. W źródłach, na które się tu powołujemy, takich progów nie ma. Jeśli chcesz ich użyć, najpierw ustal, kto je zaproponował i na jakiej podstawie. Jeśli tego nie wiesz, nie stosuj ich. Gdy promotor prosi o poziomy, rozważ podział teoretyczny albo podział z próby i opisz go jako umowny. Wady obu podejść omawia poradnik niski, przeciętny, wysoki wynik, a hasło podział względem mediany wyjaśnia, ile informacji traci się przy dzieleniu wyniku ciągłego. W analizach i tak używaj wyniku ciągłego. Nigdy nie pisz, że PSS-10 „wykazał” u kogoś zaburzenie: to miara subiektywnej oceny stresu, a nie rozpoznanie.
Przykład: PSS-10 u 240 osób studiujących
Wyobraź sobie badanie 240 osób studiujących w połowie semestru. Dane są symulowane i możesz je pobrać jako plik CSV (kolumny id i p1–p10, odpowiedzi 0–4 przed odwróceniem). Dwie osoby pominęły pozycję 6. Zgodnie z regułą Kleina i in. (2016) nie policzyliśmy dla nich wyniku, więc analizujemy 238 osób.
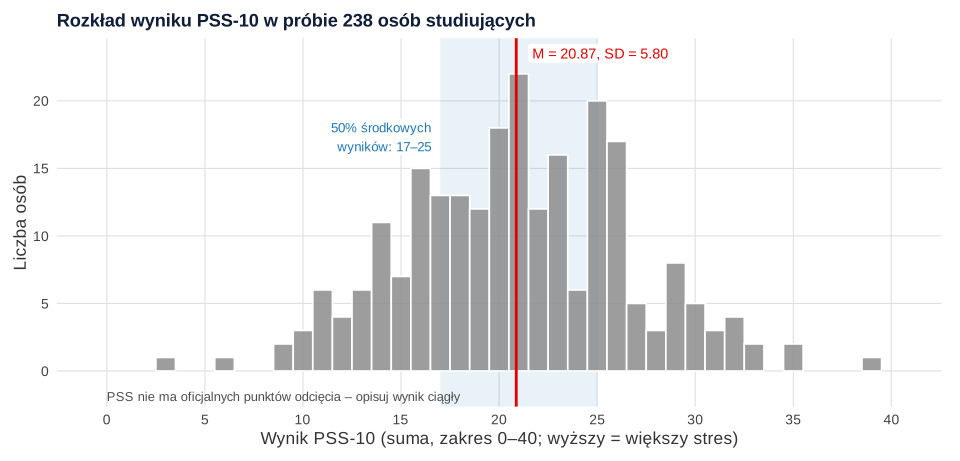
Średni wynik wyniósł M = 20.87 (SD = 5.80), mediana 21, a połowa osób miała wynik od 17 do 25. Rozkład jest prawie symetryczny (skośność 0.06), a wyniki rozciągają się od 3 do 39 punktów (rysunek 1). Nikt nie uzyskał 0 ani 40, więc efekt podłogi i sufitu nie występuje.
Rzetelność we własnej próbie
Spójność wewnętrzną sprawdzamy najpierw alfą Cronbacha. Dla 10 pozycji wyniosła ona α = .79, 95% CI [.75, .83], a skorygowane korelacje pozycja–reszta od .37 do .54. Klein i in. (2016), powołując się na przegląd Lee (2012), podają, że α wersji 10-pozycyjnej wynosiła w różnych krajach od .78 do .91. Wynik z przykładu mieści się więc w tym przedziale. Ponieważ alfa ma założenia, które rzadko są spełnione (McNeish, 2018), obok niej podaj omegę McDonalda. Z modelu dwuczynnikowego omega dla wyniku ogólnego wyniosła ω = .81. Gotowe zdania o rzetelności znajdziesz we wzorze raportowania alfy Cronbacha.
Co się stanie, gdy zapomnisz odwrócić pozycje
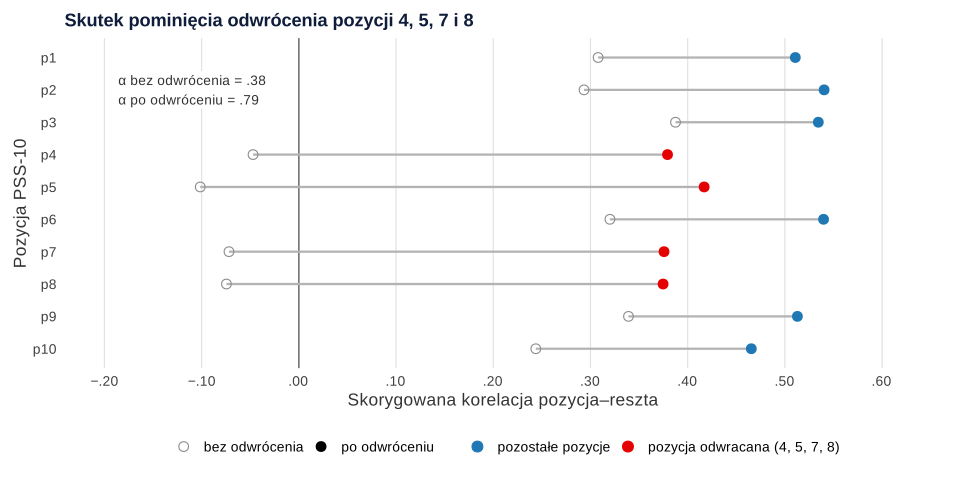
To najczęstszy błąd przy PSS-10, a łatwo go wykryć. Bez odwrócenia pozycji 4, 5, 7 i 8 alfa spada w przykładzie do .38. Korelacje pozycja–reszta dla tych czterech pozycji są wtedy bliskie zera albo ujemne, od −.10 do −.05 (rysunek 2). Jeśli zobaczysz taki wzór we własnych danych, wróć do kroku 2.
Jeden wynik czy dwa czynniki?
PSS pomyślano jako miarę jednego konstruktu, ale w analizach czynnikowych pozycje negatywne i pozytywne często tworzą dwa skorelowane czynniki. Klein i in. (2016) potwierdzili taką strukturę w reprezentatywnej próbie niemieckiej. Taylor (2015) w porządkowej konfirmacyjnej analizie czynnikowej na próbie 1236 dorosłych również uzyskał najlepsze dopasowanie modelu dwóch skorelowanych czynników, jeden z nich nazwał poczuciem bezradności. Autor kwestionuje wnioski, które tę wielowymiarowość pomijają. W przykładzie model jednoczynnikowy miał CFI = .933 i RMSEA = .085, a dwuczynnikowy CFI = 1.000 i RMSEA = .000, przy korelacji czynników .60. Tak dobre dopasowanie wynika z tego, że dane symulowaliśmy z modelu dwuczynnikowego. Prawdziwe dane zwykle dopasowują się gorzej.
Co z tego wynika dla pracy dyplomowej? Wynik ogólny PSS-10 jest standardem i możesz go używać. Jeśli jednak Twoje hipotezy dotyczą osobno poczucia bezradności i poczucia radzenia sobie, rozważ dwa wyniki i napisz, na jakiej podstawie je wyodrębniłeś. Omega dla czynnika z czterech pozycji pozytywnych wyniosła w przykładzie .62, czyli krótka podskala jest wyraźnie mniej rzetelna niż wynik ogólny. Jak sprawdzić strukturę w R, pokazuje poradnik analiza czynnikowa EFA i CFA.
Jak opisać PSS-10 w rozdziale metodologicznym
Wzór poniżej zawiera liczby z przykładu. W nawiasach kwadratowych uzupełnij dane polskiej adaptacji, z której korzystasz, i wartości z jej publikacji.
W rozdziale z wynikami opisz rozkład, a nie poziomy:
Polska wersja PSS-10 i zgoda na użycie
O zgodę na użycie oryginalnej, angielskiej wersji PSS prosi się przez platformę ePROVIDE fundacji Mapi Research Trust. Według laboratorium autora jest to bezpłatne (Carnegie Mellon University, b.d.). Inaczej jest z tłumaczeniami. Laboratorium podaje, że przekłady są własnością intelektualną tłumaczy i o zgodę trzeba prosić ich. Polskie tłumaczenie PSS-10 przygotowali Zygfryd Juczyński i Nina Ogińska-Bulik, a w sprawie informacji o niej strona odsyła do Pracowni Testów Psychologicznych. Laboratorium zaznacza też, że samo nie testowało tego przekładu i nie zna jego właściwości psychometrycznych.
W praktyce: sprawdź u autorów polskiej adaptacji albo u wydawcy, na jakich warunkach możesz użyć skali w pracy i czy możesz przenieść ją do ankiety online. Właściwości psychometryczne i ewentualne normy bierz z publikacji polskiej adaptacji, a nie z tego poradnika. Pamiętaj też, że własny przekład z angielskiego nie jest właściwą adaptacją. Nie zamieszczaj pozycji w aneksie, jeśli warunki użycia na to nie pozwalają (International Test Commission, 2014). Jak szukać narzędzi i prosić o zgodę, opisuje poradnik gdzie znaleźć kwestionariusze psychologiczne.
PSS-10 w R: wynik, rzetelność i struktura
Kod odtwarza wszystkie liczby z tekstu i rysunków, a na początku zapisuje plik CSV z danymi, który możesz pobrać powyżej. Odwracanie pozycji to jedna linia: 4 - x dla pozycji 4, 5, 7 i 8. Alfę z przedziałem Feldta liczy pakiet psych, modele CFA – pakiet lavaan, a omegę – funkcja compRelSEM() z pakietu semTools. Na własnych danych zmień tylko nazwy kolumn.
Wynik PSS-10 krok po kroku
R
# B63 – PSS-10: liczenie wyniku, rzetelność, rozkład i struktura (dane symulowane, set.seed(6310)).
# 240 osób studiujących; odpowiedzi 0–4 na 10 pozycji (p1–p10) zapisane tak, jak je zaznaczono.
# Zasady liczenia (Klein i in., 2016): odwrócić pozycje 4, 5, 7 i 8 (4 − odpowiedź), zsumować 10 pozycji (0–40).
# Treści pozycji nie podajemy – w danych są tylko numery.
suppressPackageStartupMessages({ library(MASS); library(psych); library(lavaan); library(semTools) })
set.seed(6310)
n <- 240
F <- mvrnorm(n, c(0, 0), matrix(c(1, .62, .62, 1), 2))          # czynnik pozycji negatywnych i pozytywnych
neg <- c(1, 2, 3, 6, 9, 10); poz <- c(4, 5, 7, 8)
lam <- c(.72, .66, .74, .62, .58, .70, .60, .66, .64, .68)          # ładunki w kolejności p1–p10
progi <- c(-1.6, -0.55, 0.45, 1.45)
odp <- sapply(1:10, function(j) {
  f <- if (j %in% neg) F[, 1] else -F[, 2]                          # pozycje pozytywne: wyższa odpowiedź = mniej stresu
  findInterval(lam[j] * f + rnorm(n, 0, sqrt(1 - lam[j]^2)) + 0.15, progi)
})
colnames(odp) <- paste0("p", 1:10)
dane <- data.frame(id = 1:n, odp)
dane$p6[c(17, 102)] <- NA                                            # dwie osoby pominęły jedną pozycję
write.csv(dane, "../pss-10-dane-przyklad.csv", row.names = FALSE)    # plik do pobrania

# Krok 1. Kontrola zakresu: tylko wartości 0–4 albo brak
sapply(dane[, -1], function(x) all(x %in% c(0:4, NA)))
colSums(is.na(dane[, -1]))[colSums(is.na(dane[, -1])) > 0]

# Krok 2. Odwrócenie pozycji 4, 5, 7 i 8: max + min − x = 4 + 0 − x
pss <- dane[, paste0("p", 1:10)]
odwr <- paste0("p", poz)
pss[, odwr] <- 4 - pss[, odwr]
table(surowa = dane$p4, odwrocona = pss$p4)

# Krok 3. Wynik ogólny: suma 10 pozycji (0–40); osoby z brakiem – bez wyniku (NA)
dane$PSS10 <- rowSums(pss)
c(n_z_wynikiem = sum(!is.na(dane$PSS10)), bez_wyniku = sum(is.na(dane$PSS10)))
x <- dane$PSS10[!is.na(dane$PSS10)]
round(c(M = mean(x), SD = sd(x), Me = median(x), min = min(x), max = max(x), skosnosc = psych::skew(x)), 2)
round(quantile(x, c(.25, .75)), 1)

# Krok 4. Rzetelność: alfa (95% CI Feldta) i omega całkowita z modelu dwuczynnikowego
pelne <- na.omit(pss)
a <- alpha(pelne, check.keys = FALSE, warnings = FALSE)
round(c(alfa = a$total$raw_alpha, lo = a$feldt$lower.ci[[1]], hi = a$feldt$upper.ci[[1]]), 3)
round(range(a$item.stats$r.drop), 2)                                # skorygowane korelacje pozycja–reszta
# Ten sam współczynnik bez odwrócenia pozycji – typowy błąd
surowe <- na.omit(dane[, paste0("p", 1:10)])
bez <- alpha(surowe, check.keys = FALSE, warnings = FALSE)
round(c(alfa_bez_odwrocenia = bez$total$raw_alpha), 3)
round(rbind(przed = bez$item.stats$r.drop, po = a$item.stats$r.drop), 2)

# Krok 5. Struktura: jeden czynnik czy dwa (CFA, pozycje porządkowe, WLSMV)
m1 <- cfa("PSS =~ p1 + p2 + p3 + p4 + p5 + p6 + p7 + p8 + p9 + p10",
          data = pelne, ordered = TRUE, estimator = "WLSMV", std.lv = TRUE)
m2 <- cfa("NEG =~ p1 + p2 + p3 + p6 + p9 + p10\nPOZ =~ p4 + p5 + p7 + p8",
          data = pelne, ordered = TRUE, estimator = "WLSMV", std.lv = TRUE)
wsk <- c("chisq.scaled", "df.scaled", "cfi.scaled", "tli.scaled", "rmsea.scaled", "srmr")
noquote(rbind(jeden = formatC(fitMeasures(m1, wsk), format = "f", digits = 3),
              dwa = formatC(fitMeasures(m2, wsk), format = "f", digits = 3)))
std <- standardizedSolution(m2)
round(std$est.std[std$op == "~~" & std$lhs == "NEG" & std$rhs == "POZ"], 2)    # korelacja czynników
m2_ciagly <- cfa("NEG =~ p1 + p2 + p3 + p6 + p9 + p10\nPOZ =~ p4 + p5 + p7 + p8", data = pelne, std.lv = TRUE)
round(unlist(compRelSEM(m2_ciagly, return.total = TRUE)), 3)            # omega dla czynników i wyniku ogólnego

# Wartości w zapisie do tekstu (dwa miejsca po kropce, bez zera wiodącego)
bz <- function(v) sub("^(-?)0\\.", "\\1.", formatC(v, format = "f", digits = 2))
noquote(c(alfa = bz(a$total$raw_alpha), alfa_lo = bz(a$feldt$lower.ci[[1]]), alfa_hi = bz(a$feldt$upper.ci[[1]]),
          alfa_bez_odwrocenia = bz(bez$total$raw_alpha), sapply(compRelSEM(m2_ciagly, return.total = TRUE), bz)))
Wynik w R
  p1   p2   p3   p4   p5   p6   p7   p8   p9  p10
TRUE TRUE TRUE TRUE TRUE TRUE TRUE TRUE TRUE TRUE
p6
 2
      odwrocona
surowa  0  1  2  3  4
     0  0  0  0  0 10
     1  0  0  0 56  0
     2  0  0 90  0  0
     3  0 66  0  0  0
     4 18  0  0  0  0
n_z_wynikiem   bez_wyniku
         238            2
       M       SD       Me      min      max skosnosc
   20.87     5.80    21.00     3.00    39.00     0.06
25% 75%
 17  25
 alfa    lo    hi
0.792 0.751 0.830
[1] 0.37 0.54
alfa_bez_odwrocenia
              0.385
      [,1] [,2] [,3]  [,4]  [,5] [,6]  [,7]  [,8] [,9] [,10]
przed 0.31 0.29 0.39 -0.05 -0.10 0.32 -0.07 -0.07 0.34  0.24
po    0.51 0.54 0.53  0.38  0.42 0.54  0.38  0.37 0.51  0.47
      chisq.scaled df.scaled cfi.scaled tli.scaled rmsea.scaled srmr
jeden 95.244       35.000    0.933      0.913      0.085        0.067
dwa   25.626       34.000    1.000      1.012      0.000        0.033
[1] 0.6
    NEG     POZ .TOTAL.
  0.798   0.625   0.813
               alfa             alfa_lo             alfa_hi alfa_bez_odwrocenia                 NEG
                .79                 .75                 .83                 .38                 .80
                POZ             .TOTAL.
                .62                 .81
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- lavaan (wersja 0.7.2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- semTools (wersja 0.5.8): Jorgensen, T. D., Pornprasertmanit, S., Schoemann, A. M., & Rosseel, Y. (2026). semTools: Useful tools for structural equation modeling (R package version 0.5-8) [Computer software]. https://CRAN.R-project.org/package=semTools
- MASS (wersja 7.3.65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy przy PSS-10
- Brak odwrócenia pozycji 4, 5, 7 i 8. Obniża rzetelność i zniekształca wynik (rysunek 2). Sprawdź korelacje pozycja–reszta.
- Kodowanie 1–5 zamiast 0–4. Wynik wychodzi w zakresie 10–50 i nie da się go porównać z literaturą. Przy odwracaniu na skali 1–5 wzór to 6 − odpowiedź, a nie 4 − odpowiedź.
- Progi „niski, umiarkowany, wysoki” bez źródła. Autorzy skali progów nie podają. Opisuj wynik ciągły.
- Pisanie o „diagnozie stresu”. PSS-10 mierzy subiektywną ocenę sytuacji, nie rozpoznaje zaburzeń.
- Porównywanie średniej z normami z innego kraju bez zastrzeżenia, że to inna populacja i inny czas badania.
- Mieszanie wersji. PSS-4, PSS-10 i PSS-14 mają różne zakresy wyniku. Napisz, której wersji użyłeś, i nie porównuj sum z różnych wersji.
- Zmiana okresu odniesienia (np. „w ostatnim roku”) bez informacji w pracy. Dla innych okresów niż miesiąc autorzy nie mają danych psychometrycznych.
- Podawanie tylko alfy z polskiej adaptacji. Podaj też rzetelność we własnej próbie, z przedziałem ufności.
Jeśli chcesz sprawdzić, czy dobrze policzyłeś wynik PSS-10 i jak go opisać w swojej pracy, możesz skorzystać z konsultacji w ramach oferty analizy statystyczne dla studentów. Wyniki musisz jednak rozumieć i umieć obronić samodzielnie.
Najczęstsze pytania
Jak policzyć wynik w skali PSS-10?
Sprawdź, czy odpowiedzi są zapisane jako 0–4. Odwróć pozycje 4, 5, 7 i 8 (nowa wartość = 4 − odpowiedź), a następnie zsumuj wszystkie 10 pozycji. Wynik mieści się w zakresie 0–40, a wyższy oznacza większy odczuwany stres (Klein i in., 2016).
Które pozycje PSS-10 są odwrócone?
Odwrócone są cztery pozycje sformułowane pozytywnie: 4, 5, 7 i 8. Przy skali 0–4 odwracasz je wzorem 4 − odpowiedź, czyli 0 zamienia się w 4, 1 w 3, a 2 zostaje bez zmian. Pominięcie tego kroku obniża rzetelność i daje ujemne korelacje tych pozycji z resztą skali.
Czy PSS-10 ma punkty odcięcia dla niskiego i wysokiego stresu?
Nie. Laboratorium autora skali podaje, że PSS nie jest narzędziem diagnostycznym, nie ma punktów odcięcia, a wyniki porównuje się w obrębie własnej próby (Carnegie Mellon University, b.d.). Przedziały „niski, umiarkowany, wysoki” spotykane w internecie nie pochodzą z publikacji autorów, więc w pracy opisuj wynik ciągły.
Czy wynik PSS-10 to suma czy średnia odpowiedzi?
Standardem jest suma 10 pozycji po odwróceniu, w zakresie 0–40. Średnia z pozycji (0–4) daje te same wnioski z korelacji i porównań grup, ale utrudnia porównanie z literaturą. Jeśli ją wybierzesz, napisz o tym w opisie narzędzia.
Czy na użycie PSS-10 w pracy magisterskiej potrzebna jest zgoda?
Na wersję angielską zgodę uzyskuje się bezpłatnie przez platformę ePROVIDE Mapi Research Trust. Prawa do tłumaczeń mają ich autorzy, a w sprawie polskiej wersji strona laboratorium autora odsyła do Pracowni Testów Psychologicznych (Carnegie Mellon University, b.d.). Warunki użycia sprawdź przed badaniem i opisz je w pracy.
Jaka powinna być alfa Cronbacha dla PSS-10?
Klein i in. (2016), powołując się na przegląd Lee (2012), podają, że α wersji 10-pozycyjnej wynosiła w badaniach z różnych krajów od .78 do .91. Zamiast porównywać z jednym progiem, podaj α z 95% przedziałem ufności z własnej próby i porównaj ją z wartością z polskiej adaptacji.
Powiązane hasła
Przeczytaj też
Opis narzędzia badawczego – wzór
Dziesięć elementów opisu i cztery wzory: kwestionariusz z adaptacją, ankieta własna, test wiedzy i skala kliniczna – z rzetelnością z własnej próby.
Czytaj →PoradnikJak policzyć wynik kwestionariusza
Klucz, pozycje odwrócone, podskale, reguła braków, suma czy średnia i kontrola wartości – w Excelu, SPSS, R i jamovi, z plikiem .xlsx z formułami.
Czytaj →PoradnikNiski, przeciętny, wysoki wynik
Steny, punkty odcięcia, podział skali i tercyle na jednym przykładzie: odsetki z CI, wady podziału z próby, wynik ciągły zamiast poziomów i wzór opisu.
Czytaj →Masz wyniki PSS-10 i nie wiesz, jak je opisać?
Sprawdzimy liczenie wyniku i rzetelność skali w Twojej próbie oraz wyjaśnimy analizy tak, żebyś umiał(a) samodzielnie opisać i obronić wyniki.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Carnegie Mellon University. (b.d.). Scales: Laboratory for the Study of Stress, Immunity, and Disease. Pobrano 25 października 2026 z https://www.cmu.edu/dietrich/psychology/stress-immunity-disease-lab/scales/index.html ● Otwarty dostęp
- Cohen, S., & Williamson, G. (1988). Perceived stress in a probability sample of the United States. In S. Spacapan & S. Oskamp (Eds.), The social psychology of health: Claremont Symposium on Applied Social Psychology (pp. 31–67). Sage.
- Cohen, S., Kamarck, T., & Mermelstein, R. (1983). A global measure of perceived stress. Journal of Health and Social Behavior, 24(4), 385–396. https://doi.org/10.2307/2136404 ● Otwarty dostęp: pełny tekst
- International Test Commission. (2014). ITC statement on the use of tests and other assessment instruments for research purposes (Version 1.2). https://www.intestcom.org/files/statement_using_tests_for_research.pdf ● Otwarty dostęp
- Klein, E. M., Brähler, E., Dreier, M., Reinecke, L., Müller, K. W., Schmutzer, G., Wölfling, K., & Beutel, M. E. (2016). The German version of the Perceived Stress Scale – psychometric characteristics in a representative German community sample. BMC Psychiatry, 16(1), Article 159. https://doi.org/10.1186/s12888-016-0875-9 ● Otwarty dostęp
- Lee, E.-H. (2012). Review of the psychometric evidence of the Perceived Stress Scale. Asian Nursing Research, 6(4), 121–127. https://doi.org/10.1016/j.anr.2012.08.004 ● Otwarty dostęp
- McNeish, D. (2018). Thanks coefficient alpha, we’ll take it from here. Psychological Methods, 23(3), 412–433. https://doi.org/10.1037/met0000144
- Taylor, J. M. (2015). Psychometric analysis of the Ten-Item Perceived Stress Scale. Psychological Assessment, 27(1), 90–101. https://doi.org/10.1037/a0038100
Cytowania BibTeX
@misc{cmundpss, author={{Carnegie Mellon University}}, title={{Scales: Laboratory for the Study of Stress, Immunity, and Disease}}, url={https://www.cmu.edu/dietrich/psychology/stress-immunity-disease-lab/scales/index.html}}@incollection{cohen1988perceived, author={Cohen, Sheldon and Williamson, G.}, title={{Perceived stress in a probability sample of the United States}}, booktitle={The social psychology of health: Claremont Symposium on Applied Social Psychology}, year={1988}, pages={31--67}, publisher={Sage}}@article{cohen1983global, author={Cohen, Sheldon and Kamarck, Tom and Mermelstein, Robin}, title={{A global measure of perceived stress}}, journal={Journal of Health and Social Behavior}, year={1983}, volume={24}, number={4}, pages={385--396}, doi={10.2307/2136404}}@techreport{itc2014statement, author={{International Test Commission}}, title={{ITC statement on the use of tests and other assessment instruments for research purposes}}, year={2014}, institution={International Test Commission}, url={https://www.intestcom.org/files/statement_using_tests_for_research.pdf}}@article{klein2016german, author={Klein, Eva M. and Brähler, Elmar and Dreier, Michael and Reinecke, Leonard and Müller, Kai W. and Schmutzer, Gabriele and Wölfling, Klaus and Beutel, Manfred E.}, title={{The German version of the Perceived Stress Scale – psychometric characteristics in a representative German community sample}}, journal={BMC Psychiatry}, year={2016}, volume={16}, number={1}, eid={159}, doi={10.1186/s12888-016-0875-9}}@article{lee2012review, author={Lee, Eun-Hyun}, title={{Review of the psychometric evidence of the Perceived Stress Scale}}, journal={Asian Nursing Research}, year={2012}, volume={6}, number={4}, pages={121--127}, doi={10.1016/j.anr.2012.08.004}}@article{mcneish2018thanks, author={McNeish, Daniel}, title={{Thanks coefficient alpha, we’ll take it from here}}, journal={Psychological Methods}, year={2018}, volume={23}, number={3}, pages={412--433}, doi={10.1037/met0000144}}@article{taylor2015psychometric, author={Taylor, John M.}, title={{Psychometric analysis of the Ten-Item Perceived Stress Scale}}, journal={Psychological Assessment}, year={2015}, volume={27}, number={1}, pages={90--101}, doi={10.1037/a0038100}}