Po co sprawdzać inwariancję pomiaru?
Porównujesz stres akademicki kobiet i mężczyzn, a recenzent pyta, czy sprawdzono inwariancję pomiaru skali między grupami. To jeden z typowych zarzutów recenzentów do statystyki. Różnica średnich może wynikać z tego, że grupy różnią się poziomem stresu, ale też z tego, że niektóre pozycje działają w grupach inaczej – na przykład jedna grupa łatwiej przyznaje się do płaczu w stresie przy tym samym poziomie napięcia. Bez sprawdzenia nie wiesz, którą z tych różnic mierzysz.
Inwariancja pomiaru (niezmienność pomiarowa, ang. measurement invariance) oznacza, że związek pozycji kwestionariusza z mierzonym konstruktem jest taki sam w porównywanych grupach albo w kolejnych pomiarach. Vandenberg i Lance (2000) nazywają ją logicznym warunkiem wstępnym porównań między grupami – zarówno średnich, jak i parametrów strukturalnych. Według Putnick i Bornstein (2016) jej brak sugeruje, że konstrukt ma w grupach inną strukturę albo inne znaczenie. Ta sama logika dotyczy pomiarów w czasie, na przykład przed analizą modeli cross-lagged. Krótką definicję podaje hasło inwariancja pomiaru w CB-SEM.
Standardowym narzędziem jest wielogrupowa konfirmacyjna analiza czynnikowa (MGCFA, ang. multi-group CFA). Pozycję j w grupie g opisuje w niej równanie:
ν to wyraz wolny (oczekiwana odpowiedź przy zerowym poziomie czynnika), λ – ładunek czynnikowy, η – zmienna latentna, a ε – błąd pomiaru o wariancji θ. Testy inwariancji sprawdzają po kolei, które z tych parametrów można uznać za równe w grupach. Poniżej przechodzimy przez całą procedurę w pakiecie lavaan na jednym przykładzie (dane symulowane), z wariantem dla pozycji porządkowych i gotowym opisem APA. Ogólne zasady modelowania opisują poradniki CB-SEM krok po kroku i CB-SEM w R (lavaan).
Poziomy inwariancji: co ograniczasz i co wolno porównać
Każdy kolejny model dodaje ograniczenia równości do poprzedniego. Meredith (1993) nazwał kolejne szczeble słabą inwariancją pomiaru oraz silną i ścisłą inwariancją czynnikową; częściej mówi się o inwariancji metrycznej, skalarnej i ścisłej.
| Poziom | Co jest równe w grupach | Co wolno porównać | group.equal |
|---|---|---|---|
| Konfiguracyjna (konfiguralna) | liczba czynników i układ ładunków; wartości parametrów mogą się różnić | tylko to, że konstrukt ma w grupach podobną strukturę | brak (model bazowy) |
| Progów (tylko pozycje porządkowe) | progi kategorii odpowiedzi | jeszcze nic – to krok przygotowujący test ładunków | "thresholds" |
| Metryczna (słaba) | ładunki czynnikowe | wariancje czynników, kowariancje, korelacje i ścieżki regresji z udziałem czynników | "loadings" |
| Skalarna (silna) | ładunki i wyrazy wolne (przy pozycjach porządkowych także progi) | dodatkowo średnie czynników | c("loadings", "intercepts") |
| Ścisła | dodatkowo wariancje reszt | dodatkowo precyzję pozycji; tego poziomu wymaga sprawiedliwe porównywanie wyników obserwowanych (Meredith, 1993) | c("loadings", "intercepts", "residuals") |
Do porównania średnich czynników wystarczy pełna albo częściowa inwariancja skalarna – inwariancja reszt nie jest tu warunkiem, bo reszty nie należą do czynnika (Putnick i Bornstein, 2016). Co innego surowe wyniki skali (sumy albo średnie pozycji): w symulacji Steinmetza (2013) już jeden lub dwa nierówne wyrazy wolne wyraźnie zniekształcały różnicę wyników złożonych. Porównania sum punktów uznał on za uzasadnione tylko przy pełnej inwariancji i zalecał porównywanie średnich latentnych.
Procedura krok po kroku: kryteria i decyzje
Decyzje zapisz w planie analizy, zanim zobaczysz wyniki:
- Wybierz estymator. Pozycje z pięcioma i więcej kategoriami odpowiedzi traktuj jako ciągłe i szacuj odporną metodą MLR, a pozycje z czterema i mniej kategoriami – jako porządkowe, estymatorem WLSMV. Taki podział odpowiada zaleceniom, które sformułowali Rhemtulla i in. (2012): metody kategorialne dokładniej szacowały ładunki przy mniej niż pięciu kategoriach, a odporny ML sprawdzał się przy pięciu i więcej.
- Sprawdź liczebności grup. Model trzeba oszacować w każdej grupie osobno, dlatego pomijamy grupy mniejsze niż 100 osób, a zalecamy 100–200 osób i więcej. Przy małych próbach RMSEA i TLI zbyt często odrzucają poprawne modele (Hu i Bentler, 1999).
- Testuj poziomy po kolei: konfiguracyjny → progów (tylko pozycje porządkowe) → metryczny → skalarny → ścisły (tylko pozycje ciągłe).
- Porównuj każdy model z ostatnim przyjętym. Poziom jest spełniony, gdy jednocześnie ΔCFI ≥ −.010 (Cheung i Rensvold, 2002) i ΔRMSEA ≤ .015 (Chen, 2007). Test różnicy chi-kwadrat – przy MLR i WLSMV skalowany (Satorra, 2000) – podawaj informacyjnie, bo w dużych próbach wykrywa nawet nieistotne praktycznie różnice (Meade i in., 2008).
- Gdy poziom nie spełnia kryteriów, szukaj inwariancji częściowej (Byrne i in., 1989). Testy punktowe (
lavTestScore()) pokazują, o ile spadłby chi-kwadrat po zniesieniu pojedynczego ograniczenia równości. Uwalniaj po jednym ograniczeniu – to o największym χ² i p < .05, wyłącznie spośród parametrów ograniczonych na tym poziomie – i po każdym uwolnieniu porównaj model ponownie. Przerwij, gdy kryteria są spełnione albo po trzech uwolnieniach. - Zachowaj uwolnione parametry na dalszych poziomach – parametru różnego w grupach nie zrównuj w kolejnych modelach. Jeśli uwolnisz ładunek pozycji, zostaw wolny także jej wyraz wolny, bo przy różnych ładunkach test równości wyrazów wolnych traci sens (Putnick i Bornstein, 2016). Jeśli korekta się nie uda, wnioskuj tylko do ostatniego spełnionego poziomu; dalsze kroki licz już wyłącznie informacyjnie.
- Średnie czynników porównuj przy pełnej albo częściowej inwariancji skalarnej – w modelu, który ją osiągnął.
Limit trzech uwolnień to reguła ostrożności tej procedury, a nie norma z literatury. Według przeglądu Putnick i Bornstein (2016) Byrne i in. (1989) nie ograniczali liczby uwalnianych parametrów, wymagając jedynie sensu merytorycznego, a Vandenberg i Lance (2000) uznawali czynnik za częściowo inwariantny, gdy większość jego pozycji jest inwariantna – choć tej reguły nie poparto badaniami empirycznymi. Putnick i Bornstein (2016) przypominają też, że sekwencyjne uwalnianie zawodzi, gdy pozycji nieinwariantnych jest dużo. Każde uwolnienie uzasadnij więc treścią pozycji.
Przykład: skala stresu akademickiego u kobiet i mężczyzn
300 kobiet i 300 mężczyzn (dane symulowane) wypełniło 12-pozycyjną skalę stresu akademickiego z odpowiedziami na pięciostopniowej skali typu Likerta. Skala ma trzy czynniki po cztery pozycje: przeciążenie obowiązkami (P1–P4), obawy o oceny (O1–O4) i reakcje emocjonalne (E1–E4). Dane wygenerowaliśmy tak, żeby znać prawdę:
- w populacji kobiety mają wyższą średnią obaw o oceny (o 0.25 SD) i reakcji emocjonalnych (o 0.30 SD), a w przeciążeniu grupy się nie różnią;
- pozycja E3 („Kiedy jestem zestresowany(-a), chce mi się płakać”) ma u kobiet wyraz wolny wyższy o 0.45 punktu – przy tym samym poziomie reakcji emocjonalnych kobiety wybierają na niej wyższe odpowiedzi;
- żeby dopasowanie nie było idealne, dodaliśmy w obu grupach dwie drobne niezgodności z modelem: wspólną wariancję reszt P1 i P2 oraz słaby ładunek pozycji O3 na reakcjach emocjonalnych.
Na pozycji E3 kobiety uzyskały M = 3.24 (SD = 1.05), a mężczyźni M = 2.56 (SD = 0.99); na pozostałych pozycjach reakcji emocjonalnych różnice wynosiły 0.15–0.24 punktu. Sama różnica średnich nie rozstrzyga jednak, czy to efekt wyższego poziomu czynnika, czy innego działania pozycji.
W lavaan grupy wskazuje argument group = "plec", a ograniczenia równości – group.equal. Model identyfikujemy przez standaryzację czynników (std.lv = TRUE): w modelu konfiguracyjnym czynniki mają w każdej grupie średnią 0 i wariancję 1, a gdy zrównasz ładunki (i wyrazy wolne), lavaan uwolni wariancje (i średnie) czynników w drugiej grupie. Grupą odniesienia są mężczyźni, więc średnie czynników u kobiet wyjdą w odchyleniach standardowych czynnika u mężczyzn. Pełny kod znajdziesz w sekcji Pełny kod R.
Krok 1. Model konfiguracyjny
Model konfiguracyjny ma w obu grupach ten sam układ czynników i pozycji, ale wszystkie parametry szacuje osobno. Sprawdza, czy struktura pasuje do danych każdej grupy, i jest punktem odniesienia dla kolejnych kroków. Jeśli dopiero ustalasz strukturę skali, zacznij od analizy w jednej grupie (zob. analiza czynnikowa EFA i CFA).
Dopasowanie było dobre: χ²(102) = 122.41, p = .082, CFI = .992, TLI = .989, RMSEA = .026, 90% CI [.000, .041], SRMR = .033 (MLR; skalowany χ², odporne CFI, TLI i RMSEA). Wartości spełniają progi Hu i Bentlera (1999): CFI i TLI około .95 lub więcej, RMSEA do około .06, SRMR do około .08 (zob. hasła CFI, TLI, RMSEA i SRMR). Przy słabym dopasowaniu nie przechodź dalej: sprawdź indeksy modyfikacji i reszty w każdej grupie osobno. Każda zmiana wprowadzona po obejrzeniu danych, np. dodana kowariancja reszt, ma charakter eksploracyjny i wymaga replikacji (Putnick i Bornstein, 2016).
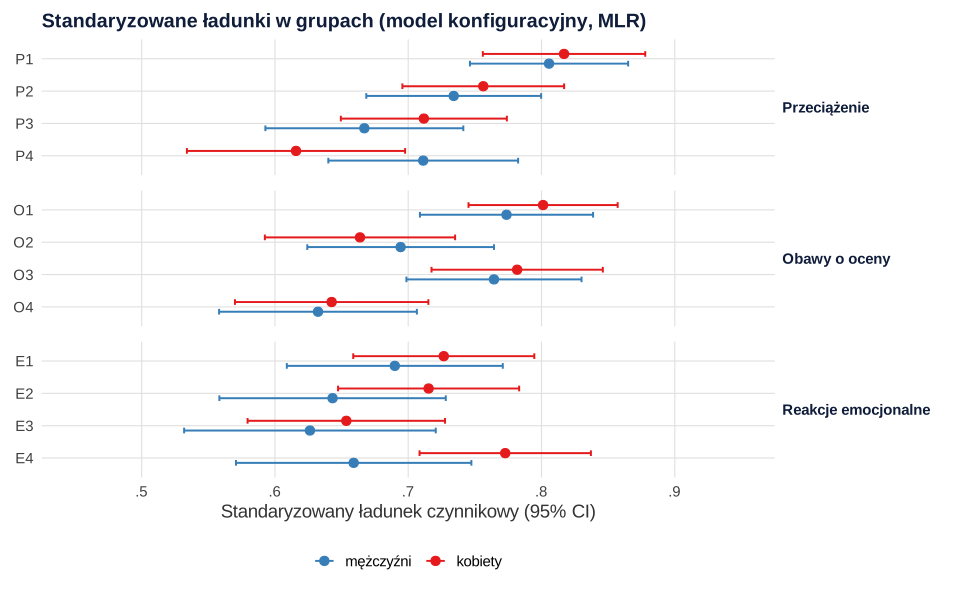
Ładunki mieściły się u mężczyzn w przedziale .63–.81, a u kobiet .62–.82. Największe różnice dotyczyły pozycji E4 (.66 i .77) i P4 (.71 i .62), ale przedziały ufności się nakładają. Rysunek 1 to dobra diagnostyka wstępna, nie test – o równości ładunków rozstrzyga model metryczny.
Krok 2. Inwariancja metryczna: równe ładunki
Model metryczny zrównuje ładunki (group.equal = "loadings"). Jeśli to nie pogarsza dopasowania, jednostka skali czynnika jest w grupach taka sama i wolno porównywać kowariancje, korelacje oraz ścieżki z udziałem czynników – na przykład sprawdzać w modelu SEM, czy związek stresu z wypaleniem jest silniejszy u kobiet.
Dopasowanie praktycznie się nie zmieniło: χ²(111) = 130.26, CFI = .992, RMSEA = .024, SRMR = .037; względem modelu konfiguracyjnego Δχ²(9) = 7.57, p = .578, ΔCFI = .001, ΔRMSEA = −.002. Przyjmujemy inwariancję metryczną. Zwróć uwagę, że Δdf = 9, a nie 12: zrównanie 12 ładunków dodaje 12 stopni swobody, ale lavaan uwalnia w grupie kobiet trzy wariancje czynników. W kroku skalarnym zrównanie 12 wyrazów wolnych podobnie uwalnia trzy średnie czynników.
Krok 3. Inwariancja skalarna i testy punktowe
Model skalarny dodaje równość wyrazów wolnych (group.equal = c("loadings", "intercepts")). Wyrazy wolne mówią, jakiej odpowiedzi oczekujemy od osoby o danym poziomie czynnika; jeśli są równe, różnice średnich pozycji wynikają wyłącznie z różnic średnich czynników.
Tym razem dopasowanie wyraźnie się pogorszyło: χ²(120) = 190.50, CFI = .972, RMSEA = .044, SRMR = .046; względem modelu metrycznego Δχ²(9) = 58.91, p < .001, ΔCFI = −.020, ΔRMSEA = .020. Pełnej inwariancji skalarnej nie ma. Które wyrazy wolne za to odpowiadają?
Testy punktowe: które ograniczenie psuje dopasowanie?
Funkcja lavTestScore() liczy dla każdego ograniczenia równości jednostopniowy test punktowy (mnożnika Lagrange’a) – przybliżony spadek chi-kwadrat po uwolnieniu tego jednego parametru. To odpowiednik indeksów modyfikacji dla ograniczeń między grupami. Kandydatami są tylko wyrazy wolne, bo ładunki przyjęliśmy w poprzednim kroku.
| Ograniczony parametr | χ²(1) | p |
|---|---|---|
| wyraz wolny pozycji E3 | 46.25 | < .001 |
| wyraz wolny pozycji E1 | 8.35 | .004 |
| wyraz wolny pozycji P4 | 5.21 | .022 |
| wyraz wolny pozycji E2 | 3.81 | .051 |
| wyraz wolny pozycji O3 | 2.81 | .094 |
| wyraz wolny pozycji O1 | 2.66 | .103 |
Wyraz wolny E3 dominuje (χ²(1) = 46.25, p < .001). Uwalniamy go argumentem group.partial = "E3~1", czyli szacujemy go w każdej grupie osobno. Model częściowej inwariancji skalarnej: χ²(119) = 142.99, CFI = .991, RMSEA = .026, SRMR = .039; względem modelu metrycznego Δχ²(8) = 12.61, p = .126, ΔCFI = −.002, ΔRMSEA = .002. Jedno uwolnienie wystarczyło do częściowej inwariancji skalarnej – pozostałe 11 wyrazów wolnych można uznać za równoważne.
Dlaczego test dla E1 też był istotny? W modelu z wymuszoną równością część przesunięcia pozycji E3 przejęła średnia czynnika reakcji emocjonalnych, przez co pozostałe pozycje tego czynnika wydawały się niedopasowane. Po uwolnieniu E3 test dla E1 spadł z 8.35 do 0.77. Wyraz wolny P4 nadal ma χ²(1) = 5.21, p = .022, ale go nie uwalniamy: kryteria są spełnione, a kolejne uwolnienia podyktowane samą istotnością dopasowywałyby model do przypadkowych cech próby.
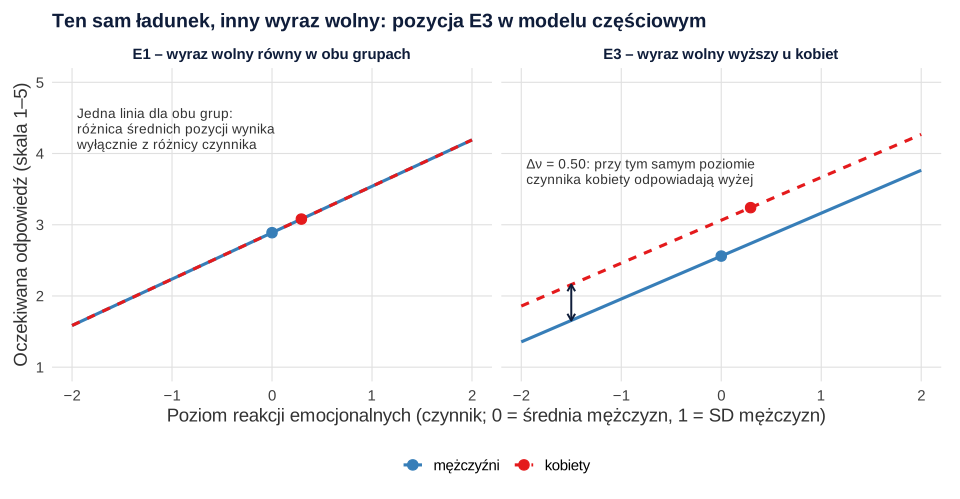
Rysunek 2 pokazuje sens nierównego wyrazu wolnego. Dla E1 obie grupy mają tę samą linię, a kobiety odpowiadają średnio wyżej tylko dlatego, że mają wyższą średnią czynnika. Dla E3 linie są równoległe (ładunek jest ten sam), ale linia kobiet leży wyżej: wyraz wolny wyniósł 3.06 u kobiet i 2.56 u mężczyzn, różnica 0.50 punktu, 95% CI [0.36, 0.65] (w populacji 0.45). Putnick i Bornstein (2016) zachęcają, by nieinwariantną pozycję traktować jako informację o konstrukcie, a nie tylko przeszkodę. Tu można przypuszczać, że płacz jako reakcja na stres wiąże się w grupach z innymi normami wyrażania emocji – w dyskusji przedstaw to jako hipotezę.
Krok 4. Inwariancja ścisła: równe wariancje reszt
Model ścisły dodaje równość wariancji reszt ("residuals"), z zachowaniem uwolnionego wyrazu wolnego E3: χ²(131) = 159.37, CFI = .989, RMSEA = .027, SRMR = .042; względem modelu częściowej inwariancji skalarnej Δχ²(12) = 16.48, p = .170, ΔCFI = −.002, ΔRMSEA = .001. Pozycje mierzą więc czynniki w obu grupach z podobną precyzją.
W przeglądzie Putnick i Bornstein (2016) ten krok obejmowała mniej niż połowa testów, bo nie jest on warunkiem porównania średnich czynników. Ma znaczenie, gdy porównujesz wyniki obserwowane albo rzetelność w grupach – Meredith (1993) argumentował, że sprawiedliwe porównania wyników wymagają ścisłej inwariancji czynnikowej. W tej procedurze krok ścisły wykonujemy tylko dla pozycji ciągłych. Wyniki wszystkich kroków zestawia tabela 1, w układzie zalecanym przez Putnick i Bornstein (2016).
Tabela 1
Testy inwariancji pomiaru skali stresu akademickiego między mężczyznami i kobietami
| Model | χ² (df) | CFI | RMSEA | SRMR | Δχ² (Δdf); p | ΔCFI | ΔRMSEA | Spełniona |
|---|---|---|---|---|---|---|---|---|
| Konfiguracyjna | 122.41 (102) | .992 | .026 | .033 | — | — | — | — |
| Metryczna | 130.26 (111) | .992 | .024 | .037 | 7.57 (9); .578 | .001 | −.002 | tak |
| Skalarna | 190.50 (120) | .972 | .044 | .046 | 58.91 (9); < .001 | −.020 | .020 | nie |
| Skalarna częściowa | 142.99 (119) | .991 | .026 | .039 | 12.61 (8); .126 | −.002 | .002 | tak |
| Ścisła* | 159.37 (131) | .989 | .027 | .042 | 16.48 (12); .170 | −.002 | .001 | tak |
Uwaga. N = 600 (po 300 mężczyzn i kobiet); dane symulowane. Estymator MLR: χ² – skalowany chi-kwadrat, CFI i RMSEA – wersje odporne. Ograniczenia: metryczna – równe ładunki; skalarna – dodatkowo równe wyrazy wolne; ścisła – dodatkowo równe wariancje reszt. Inwariancja częściowa: uwolniono wyraz wolny pozycji E3. * – z zachowaniem parametru uwolnionego we wcześniejszym kroku. Każdy model porównano z ostatnim przyjętym (skalarny i skalarny częściowy – z metrycznym, ścisły – ze skalarnym częściowym); poziom uznawano za spełniony przy ΔCFI ≥ −.010 i ΔRMSEA ≤ .015 (Cheung i Rensvold, 2002; Chen, 2007). Δχ² – skalowany test różnicy (Satorra, 2000), podany informacyjnie.
Krok 5. Porównanie średnich czynników
Przy pełnej albo częściowej inwariancji skalarnej możesz porównać średnie czynników; Byrne i in. (1989) pokazali, jak testować je także przy częściowej inwariancji, z nieinwariantnymi parametrami szacowanymi osobno w grupach. Przy std.lv = TRUE czynniki w grupie odniesienia (mężczyźni) mają średnią 0 i wariancję 1, więc średnia czynnika u kobiet jest od razu różnicą w odchyleniach standardowych czynnika u mężczyzn. To miara wielkości efektu podobna do d Cohena; Putnick i Bornstein (2016) zalecają podawanie takiej miary przy każdym porównaniu średnich.
Kobiety miały wyższą średnią obaw o oceny, d = 0.23, 95% CI [0.06, 0.41], z = 2.56, p = .010, i reakcji emocjonalnych, d = 0.29, 95% CI [0.09, 0.50], z = 2.82, p = .005, a w przeciążeniu obowiązkami grupy się nie różniły, d = 0.02, 95% CI [−0.16, 0.20], p = .837. Przedziały obejmują wartości z populacji (0.25, 0.30 i 0).
Tabela 2
Różnice średnich czynników między kobietami i mężczyznami w modelu częściowej inwariancji skalarnej
| Czynnik | d | 95% CI | z | p | |
|---|---|---|---|---|---|
| LL | UL | ||||
| Przeciążenie obowiązkami | 0.02 | −0.16 | 0.20 | 0.21 | .837 |
| Obawy o oceny | 0.23 | 0.06 | 0.41 | 2.56 | .010 |
| Reakcje emocjonalne | 0.29 | 0.09 | 0.50 | 2.82 | .005 |
Uwaga. N = 600; dane symulowane. Model częściowej inwariancji skalarnej z wyrazem wolnym pozycji E3 szacowanym osobno w grupach. d – średnia czynnika u kobiet względem mężczyzn w jednostkach odchylenia standardowego czynnika u mężczyzn (w grupie odniesienia średnia = 0, wariancja = 1). Przedziały ufności i testy z oparto na odpornych błędach standardowych (MLR). LL i UL – dolna i górna granica przedziału ufności.
Co by było, gdyby zignorować pozycję E3?
Gdy wymusimy pełną inwariancję skalarną (model, który nie spełnił kryteriów), różnica w reakcjach emocjonalnych rośnie do d = 0.46, 95% CI [0.24, 0.68] – o 0.17 SD więcej niż w modelu częściowym, bo przesunięcie jednej pozycji zostaje przypisane całemu czynnikowi. Podobny błąd popełnisz, porównując testem t średnie wyników skali: d = 0.40, 95% CI [0.24, 0.56], t(598) = 4.89, p < .001, choć w populacji różnica czynnika wynosi 0.30, a różnice wyników skal są zwykle mniejsze od różnic czynników, bo zawierają błąd pomiaru. W czynnikach bez nieinwariantnych pozycji wszystkie trzy podejścia dają zbliżone wyniki (rysunek 3).
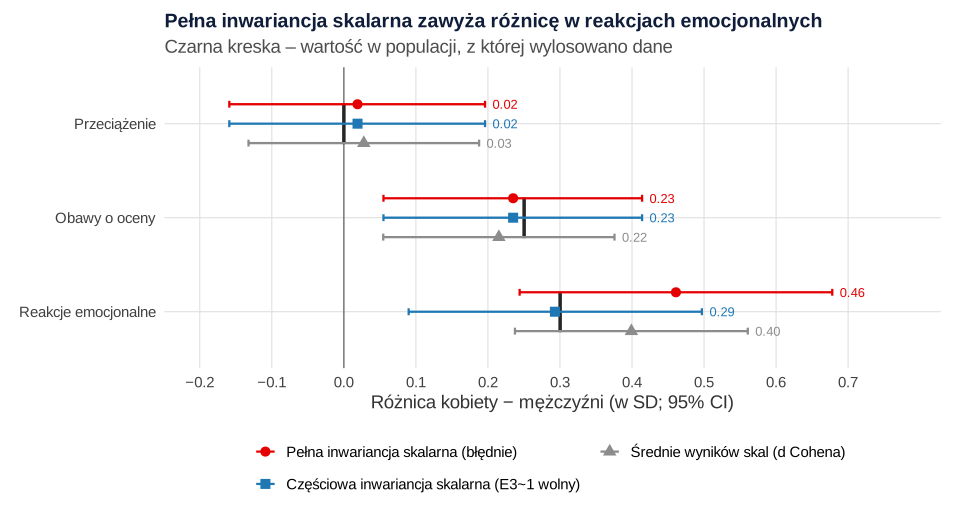
Przy częściowej inwariancji skalarnej porównuj średnie czynników w modelu, a nie sumy punktów. Jeśli podajesz także wyniki skal, zaznacz, że ich porównanie między grupami obciąża nieinwariantna pozycja. Putnick i Bornstein (2016) opisują prostą analizę wrażliwości: porównaj wnioski z modelu częściowego i pełnego. W przykładzie kierunek i istotność różnic się zgadzają, ale wielkość efektu w reakcjach emocjonalnych różni się o 0.17 SD.
Pozycje porządkowe: progi, WLSMV i measEq.syntax
Pozycje z czterema lub mniej kategoriami traktuj jako porządkowe: model zakłada, że za odpowiedzią stoi ciągła zmienna ukryta, którą progi (ang. thresholds) dzielą na kategorie. Svetina i in. (2020) pokazują, jak testować inwariancję takich pozycji w pakietach lavaan i semTools. Wu i Estabrook (2016) wykazali, że typowe ograniczenia identyfikujące model bazowy same działają jak ograniczenia inwariancji, więc wynik testu może zależeć od arbitralnej parametryzacji. Zalecają, by przy więcej niż dwóch kategoriach najpierw testować równość progów; przy równych progach, ładunkach i wyrazach wolnych można porównywać średnie i wariancje czynników. Składnię kolejnych modeli wygeneruje funkcja measEq.syntax() z pakietu semTools:
ordered = pozycje,estimator = "WLSMV",parameterization = "theta";ID.fac = "std.lv"iID.cat = "Wu.Estabrook.2016"– identyfikacja według Wu i Estabrooka;- kolejno
group.equal = "","thresholds",c("thresholds", "loadings")ic("thresholds", "loadings", "intercepts"); return.fit = TRUE– funkcja od razu dopasowuje model.
Wylosowaliśmy drugą próbę (300 + 300 osób) o tej samej strukturze, ale z odpowiedziami 1–4 i tym samym przesunięciem pozycji E3. CFI i RMSEA podajemy w wersjach skalowanych, bo w modelach z ograniczeniami lavaan 0.7-2 nie zwrócił dla WLSMV wersji odpornych, a w sekwencji trzeba porównywać ten sam typ wskaźnika.
| Model | χ² (df) | CFI | RMSEA | Δχ² (Δdf); p | ΔCFI | ΔRMSEA | Spełniona |
|---|---|---|---|---|---|---|---|
| Konfiguracyjna | 108.56 (102) | .998 | .015 | — | — | — | — |
| Progów | 117.93 (114) | .999 | .011 | 7.89 (12); .793 | .001 | −.004 | tak |
| Metryczna | 122.59 (123) | 1.000 | .000 | 6.34 (9); .706 | .001 | −.011 | tak |
| Skalarna | 215.84 (132) | .976 | .046 | 77.95 (9); < .001 | −.024 | .046 | nie |
| Skalarna częściowa (E3) | 126.90 (131) | 1.000 | .000 | 4.86 (8); .772 | .000 | .000 | tak |
Uwaga na pułapkę: w składni z measEq.syntax() wyrazy wolne zmiennych ukrytych w modelu skalarnym nie są zrównywane, tylko ustalane na 0 w obu grupach. Test punktowy nie pokaże więc „wyrazu wolnego E3”, a nierówność ujawni się w progach tej pozycji: E3|t2, χ²(1) = 30.33, E3|t1, χ²(1) = 22.86, i E3|t3, χ²(1) = 17.92 (wszystkie p < .001). Procedura zamienia wskazany próg na wyraz wolny tej samej pozycji i uwalnia E3~1, po czym model skalarny spełnia kryteria. Średnie czynników u kobiet wyniosły 0.12, 95% CI [−0.07, 0.30], p = .210 (przeciążenie), 0.30, 95% CI [0.12, 0.48], p = .001 (obawy o oceny), i 0.23, 95% CI [0.02, 0.45], p = .035 (reakcje emocjonalne) – przedziały obejmują wartości z populacji. Kroku ścisłego tu nie wykonujemy, bo do porównania średnich wystarczy równość progów, ładunków i wyrazów wolnych (Wu i Estabrook, 2016).
Ograniczenia kryteriów ΔCFI i ΔRMSEA
Progi ΔCFI ≥ −.010 i ΔRMSEA ≤ .015 są wygodne, ale nie są prawem natury:
- Pochodzą z symulacji o określonych warunkach. Cheung i Rensvold (2002) porównali 20 wskaźników przy dwóch grupach i polecili ΔCFI m.in. dlatego, że nie zależał od złożoności modelu ani wielkości próby. Chen (2007) pokazała, że zmiany wskaźników zależą od wzoru braku inwariancji, odsetka pozycji nieinwariantnych i równoliczności grup – przy nierównych grupach są mniejsze, więc te same progi rzadziej wykrywają problem.
- Nie ma zgody co do progów. Meade i in. (2008) uzyskali dobre wyniki dla zmiany CFI o .002 – pięć razy mniejszej niż .010. Putnick i Bornstein (2016) podsumowują, że żadne wskaźniki i progi nie sprawdzają się we wszystkich warunkach, a wyniki każdej symulacji dotyczą tylko zbadanych w niej warunków. Opisują też symulacje, w których przy 10–20 grupach zmiany CFI malały, a zmiany RMSEA rosły.
- Δχ² zależy od liczebności. Testy oparte na chi-kwadrat są bardzo wrażliwe na wielkość próby (Meade i in., 2008): w dużych próbach odrzucą inwariancję przy trywialnych różnicach, w małych mogą przeoczyć ważne.
- Kryteria globalne mogą ukryć lokalny problem. Jedna nieinwariantna pozycja w dużym modelu może nieznacznie zmienić CFI, a wyraźnie przesunąć średnią czynnika. Oglądaj więc też testy punktowe, ładunki w grupach i wpływ uwolnień na wyniki.
Kryteria wybierz przed analizą i opisz je w metodzie. Zmienianie progów po zobaczeniu wyników, aż „wyjdzie” inwariancja, to odmiana p-hackingu.
Co zrobić, gdy inwariancji nie ma
Brak inwariancji nie musi kończyć analizy, ale zawęża wnioski. Putnick i Bornstein (2016) zachęcają recenzentów, by traktowali testy inwariancji jako źródło informacji o konstrukcie, a nie bramkę. Możliwości zależą od poziomu, na którym procedura się zatrzymała:
- Brak inwariancji konfiguracyjnej. Nie porównuj grup na tej skali; możesz analizować grupy osobno albo przedefiniować narzędzie, pamiętając o replikacji.
- Brak (częściowej) inwariancji metrycznej. Nie porównuj korelacji ani ścieżek z udziałem czynnika. Sprawdź treść pozycji o nierównych ładunkach – czasem przyczyną jest tłumaczenie (zob. właściwa adaptacja i budowa i walidacja skali).
- Brak (częściowej) inwariancji skalarnej. Porównuj związki, ale nie średnie; różnice na poziomie pozycji opisz jako wynik.
- Usunięcie pozycji. Porównaj wnioski z modelu częściowego i z wersji skali bez pozycji nieinwariantnych – gdy są zgodne, wybór wersji ma mniejsze znaczenie (Putnick i Bornstein, 2016). Pamiętaj, że usunięcie pozycji zmienia treść konstruktu.
- Wiele grup. Przy kilkunastu krajach czy kohortach model skalarny jest zwykle słabo dopasowany, a dużych indeksów modyfikacji jest zbyt wiele. Asparouhov i Muthén (2014) zaproponowali na tę sytuację metodę alignment, która szacuje średnie i wariancje czynników bez wymogu dokładnej inwariancji.
- Inne podejścia. Zróżnicowane funkcjonowanie pozycji zbadasz też modelem MIMIC albo w IRT, a w PLS-SEM odpowiednikiem jest procedura MICOM.
Jeśli recenzent kwestionuje porównania grup, a procedura zatrzymuje się na niskim poziomie, możemy pomóc w ramach analiz statystycznych dla badaczy: wykonać dodatkowe obliczenia do recenzji i wyjaśnić, jakie wnioski są uprawnione. Taką pomoc opisz zgodnie z zasadami czasopisma, np. w podziękowaniach.
Jak opisać inwariancję pomiaru w artykule (APA)
Putnick i Bornstein (2016) stwierdzili, że raportowanie inwariancji bywa niekompletne – około 20% testów w ich przeglądzie nie podawało nawet stopni swobody. Ich minimalny zakres informacji to dobra lista kontrolna:
- liczebność próby w modelach i w każdej grupie oraz sposób postępowania z brakami danych (np. FIML);
- estymator, rodzaj wskaźników (odporne czy skalowane) i kryteria oceny modeli;
- tabela kolejnych modeli z χ² i df, wskaźnikami, modelem odniesienia, Δχ² z Δdf, ΔCFI, ΔRMSEA i decyzją;
- przy inwariancji częściowej – uwolnione parametry, uzasadnienie i uprawnione porównania.
Gotowy opis dla przykładu (tabele 1 i 2 skopiujesz przyciskami pod nimi; formatowanie opisuje hasło tabela dopasowania modelu CFA w APA):
Wersja angielska (cytowania w formie narracyjnej):
Jeśli recenzent zapyta o inwariancję po złożeniu artykułu, wzory odpowiedzi znajdziesz w poradniku odpowiedź recenzentom w sprawach statystycznych.
Pełny kod R
Kod odtwarza wszystkie liczby z tekstu, tabel i rysunków. Uruchom przepisy po kolei w jednej sesji R – każdy korzysta z obiektów utworzonych wcześniej (dane, model, funkcje procedury). Cała sekwencja liczy się kilka sekund. Przepis 3 zawiera funkcje procedury, które możesz zastosować do własnych danych: zmień model, nazwę zmiennej grupującej i etykiety grup w dopasuj().
1. Dane symulowane
R
options(width = 120)   # szerszy wydruk tabel w konsoli

# Dane symulowane: skala stresu akademickiego, 12 pozycji z odpowiedziami 1–5 i trzema czynnikami:
# przeciążenie (P1–P4), obawy o oceny (O1–O4), reakcje emocjonalne (E1–E4); 300 mężczyzn i 300 kobiet.
# W populacji pozycja E3 („Kiedy jestem zestresowany(-a), chce mi się płakać”) ma u kobiet wyraz wolny
# wyższy o 0.45 punktu: przy tym samym poziomie reakcji emocjonalnych kobiety wybierają wyższe odpowiedzi.
set.seed(2046)
pozycje <- c(paste0("P", 1:4), paste0("O", 1:4), paste0("E", 1:4))
lambda  <- c(0.80, 0.75, 0.70, 0.70,  0.80, 0.75, 0.75, 0.65,  0.75, 0.70, 0.65, 0.75)  # ładunki
nu      <- c(3.1, 2.9, 3.2, 2.8,  3.0, 3.3, 2.7, 3.1,  2.9, 3.2, 2.6, 3.0)              # wyrazy wolne
R_czyn  <- matrix(c(1, .45, .50,  .45, 1, .55,  .50, .55, 1), 3)                          # korelacje czynników
czynnik <- rep(1:3, each = 4)

generuj <- function(n, srednie, wariancje, przesuniecie = rep(0, 12), progi = c(1.5, 2.5, 3.5, 4.5)) {
  S   <- diag(sqrt(wariancje)) %*% R_czyn %*% diag(sqrt(wariancje))
  eta <- MASS::mvrnorm(n, srednie, S)                                     # wyniki czynników
  e   <- sapply(1:12, function(j) rnorm(n, sd = sqrt(1 - lambda[j]^2)))   # błędy pomiaru
  wsp <- rnorm(n, sd = sqrt(0.12)); e[, 1:2] <- e[, 1:2] + wsp            # wspólna wariancja P1 i P2
  y   <- sapply(1:12, function(j) nu[j] + przesuniecie[j] + lambda[j] * eta[, czynnik[j]] + e[, j])
  y[, 7] <- y[, 7] + 0.15 * eta[, 3]                                      # słaby ładunek krzyżowy O3
  y <- apply(y, 2, function(x) findInterval(x, progi) + 1)                # kategorie odpowiedzi
  setNames(as.data.frame(y), pozycje)
}
mezczyzni <- generuj(300, srednie = c(0, 0, 0), wariancje = c(1, 1, 1))
kobiety   <- generuj(300, srednie = c(0, 0.25, 0.30), wariancje = c(1.10, 1, 1.20),
                     przesuniecie = c(rep(0, 10), 0.45, 0))               # przesunięcie tylko dla E3
dane <- rbind(cbind(mezczyzni, plec = "mężczyzna"), cbind(kobiety, plec = "kobieta"))
table(dane$plec)

# Średnie i odchylenia standardowe pozycji w grupach
opis <- do.call(cbind, lapply(c("mężczyzna", "kobieta"), function(g) {
  d <- dane[dane$plec == g, pozycje]
  cbind(M = colMeans(d), SD = apply(d, 2, sd))
}))
colnames(opis) <- c("M_mezczyzni", "SD_mezczyzni", "M_kobiety", "SD_kobiety")
round(opis, 2)
Wynik w R
  kobieta mężczyzna
      300       300
   M_mezczyzni SD_mezczyzni M_kobiety SD_kobiety
P1        3.09         1.06      3.10       1.04
P2        2.95         1.03      2.88       1.12
P3        3.21         1.08      3.22       1.01
P4        2.70         1.01      2.84       1.02
O1        3.02         1.03      3.14       0.99
O2        3.34         1.00      3.45       0.95
O3        2.68         1.06      2.95       1.05
O4        3.08         0.96      3.29       1.07
E1        2.91         1.00      3.06       1.02
E2        3.21         0.98      3.39       1.02
E3        2.56         0.99      3.24       1.05
E4        2.96         0.96      3.20       1.05
2. Model konfiguracyjny i ładunki w grupach
R
library(lavaan)   # cfa(), fitMeasures(), standardizedSolution()

model <- '
  przeciazenie =~ P1 + P2 + P3 + P4
  obawy        =~ O1 + O2 + O3 + O4
  emocje       =~ E1 + E2 + E3 + E4
'
# Model konfiguracyjny: ta sama struktura w obu grupach, wszystkie parametry szacowane osobno.
# std.lv = TRUE: w każdej grupie czynniki mają średnią 0 i wariancję 1; MLR – odporne SE i indeksy
fit_konf <- cfa(model, data = dane, group = "plec", group.label = c("mężczyzna", "kobieta"),
                estimator = "MLR", std.lv = TRUE)
round(fitMeasures(fit_konf, c("chisq.scaled", "df.scaled", "pvalue.scaled", "cfi.robust", "tli.robust",
                              "rmsea.robust", "rmsea.ci.lower.robust", "rmsea.ci.upper.robust", "srmr")), 3)

# Standaryzowane ładunki z 95% CI, oszacowane osobno w każdej grupie
lad <- standardizedSolution(fit_konf, level = .95)
lad <- lad[lad$op == "=~", ]
lad$grupa <- lavInspect(fit_konf, "group.label")[lad$group]
pokaz <- function(g) with(lad[lad$grupa == g, ], sprintf("%.2f [%.2f, %.2f]", est.std, ci.lower, ci.upper))
data.frame(czynnik = lad$lhs[lad$group == 1], pozycja = lad$rhs[lad$group == 1],
           mezczyzni = pokaz("mężczyzna"), kobiety = pokaz("kobieta"))
Wynik w R
This is lavaan 0.7-2
lavaan is FREE software! Please report any bugs.
         chisq.scaled             df.scaled         pvalue.scaled            cfi.robust            tli.robust
              122.410               102.000                 0.082                 0.992                 0.989
         rmsea.robust rmsea.ci.lower.robust rmsea.ci.upper.robust                  srmr
                0.026                 0.000                 0.041                 0.033
        czynnik pozycja         mezczyzni           kobiety
1  przeciazenie      P1 0.81 [0.75, 0.87] 0.82 [0.76, 0.88]
2  przeciazenie      P2 0.73 [0.67, 0.80] 0.76 [0.70, 0.82]
3  przeciazenie      P3 0.67 [0.59, 0.74] 0.71 [0.65, 0.77]
4  przeciazenie      P4 0.71 [0.64, 0.78] 0.62 [0.53, 0.70]
5         obawy      O1 0.77 [0.71, 0.84] 0.80 [0.75, 0.86]
6         obawy      O2 0.69 [0.62, 0.76] 0.66 [0.59, 0.74]
7         obawy      O3 0.76 [0.70, 0.83] 0.78 [0.72, 0.85]
8         obawy      O4 0.63 [0.56, 0.71] 0.64 [0.57, 0.72]
9        emocje      E1 0.69 [0.61, 0.77] 0.73 [0.66, 0.79]
10       emocje      E2 0.64 [0.56, 0.73] 0.72 [0.65, 0.78]
11       emocje      E3 0.63 [0.53, 0.72] 0.65 [0.58, 0.73]
12       emocje      E4 0.66 [0.57, 0.75] 0.77 [0.71, 0.84]
3. Sekwencja testów i inwariancja częściowa
R
# Model wielogrupowy z ograniczeniami równości (group.equal) i wyjątkami (group.partial) – pozycje ciągłe
dopasuj <- function(rownosci = "", uwolnione = character(0)) {
  cfa(model, data = dane, group = "plec", group.label = c("mężczyzna", "kobieta"),
      estimator = "MLR", std.lv = TRUE, group.equal = rownosci,
      group.partial = if (length(uwolnione)) uwolnione else "")
}

# Indeksy dopasowania: skalowany chi-kwadrat oraz odporne (MLR) albo skalowane (WLSMV) CFI i RMSEA
indeksy <- function(fit, typ = "robust") {
  fm <- fitMeasures(fit)
  c(chi2 = fm[["chisq.scaled"]], df = fm[["df.scaled"]], CFI = fm[[paste0("cfi.", typ)]],
    RMSEA = fm[[paste0("rmsea.", typ)]], SRMR = fm[["srmr"]])
}

# Porównanie z ostatnim przyjętym modelem: skalowany test różnicy chi-kwadrat, ΔCFI i ΔRMSEA
porownaj <- function(fit0, fit1, typ = "robust") {
  lrt <- lavTestLRT(fit0, fit1, method = "satorra.2000")
  i0 <- indeksy(fit0, typ); i1 <- indeksy(fit1, typ)
  c(dchi2 = lrt[["Chisq diff"]][2], ddf = lrt[["Df diff"]][2], p = lrt[["Pr(>Chisq)"]][2],
    dCFI = i1[["CFI"]] - i0[["CFI"]], dRMSEA = i1[["RMSEA"]] - i0[["RMSEA"]])
}

# Kryteria: ΔCFI ≥ −0.010 (Cheung i Rensvold, 2002) oraz ΔRMSEA ≤ 0.015 (Chen, 2007)
spelniona <- function(por) por[["dCFI"]] >= -0.010 && por[["dRMSEA"]] <= 0.015

# Testy punktowe (lavTestScore): o ile spadłby chi-kwadrat po zniesieniu jednego ograniczenia równości
testy_ograniczen <- function(fit) {
  ts <- lavTestScore(fit)$uni
  pt <- parTable(fit)
  ts$parametr <- sapply(ts$lhs, function(e) with(pt[pt$plabel == e, ], paste0(lhs, op, rhs)))
  ts[order(-ts$X2), c("parametr", "X2", "p.value")]
}

# Co wolno uwolnić: tylko ograniczenia dodane na danym poziomie. Przy pozycjach porządkowych
# wyrazy wolne modelu skalarnego są ustalone na 0 (a nie zrównane), więc ich nierówność widać
# w testach progów – wtedy uwalniamy wyraz wolny tej pozycji
do_uwolnienia <- function(parametr, poziom, porzadkowe = FALSE) {
  if (porzadkowe && poziom == "skalarna")
    return(ifelse(grepl("|", parametr, fixed = TRUE), sub("\\|.*$", "~1", parametr), NA))
  wzorzec <- c(progow = "\\|", metryczna = "=~", skalarna = "~1$", scisla = "^(\\w+)~~\\1$")[[poziom]]
  ifelse(grepl(wzorzec, parametr), parametr, NA)
}

# Procedura: kolejne poziomy porównujemy z ostatnim przyjętym modelem. Gdy poziom nie spełnia kryteriów,
# uwalniamy po jednym (najwyżej 3) ograniczenia o największym χ² w teście punktowym (p < .05).
# Uwolnione parametry zostają wolne na dalszych poziomach; bez udanej korekty dalsze kroki są informacyjne
testuj_inwariancje <- function(dopasuj, poziomy, typ = "robust", porzadkowe = FALSE,
                               maks_uwolnien = 3, alfa = .05) {
  wiersze <- list(); diagnostyka <- list()
  dodaj <- function(nazwa, fit, por = NULL, uwolnione = character(0), informacyjnie = FALSE)
    wiersze[[length(wiersze) + 1]] <<- list(nazwa = nazwa, fit = fit, por = por,
                                            spelniona = if (is.null(por)) NA else spelniona(por),
                                            uwolnione = uwolnione, informacyjnie = informacyjnie)
  przyjety <- dopasuj(poziomy[[1]]); dodaj(names(poziomy)[1], przyjety)
  uwolnione <- character(0); informacyjnie <- FALSE
  for (poziom in names(poziomy)[-1]) {
    fit <- dopasuj(poziomy[[poziom]], uwolnione)
    por <- porownaj(przyjety, fit, typ)
    dodaj(poziom, fit, por, uwolnione, informacyjnie)
    if (spelniona(por) || informacyjnie) { przyjety <- fit; next }
    nowe <- character(0); fit_cz <- fit; por_cz <- NULL          # inwariancja częściowa
    for (krok in seq_len(maks_uwolnien)) {
      ts <- testy_ograniczen(fit_cz)
      ts$uwolnij <- do_uwolnienia(ts$parametr, poziom, porzadkowe)
      ts <- ts[!is.na(ts$uwolnij), ]
      if (krok == 1) diagnostyka[[poziom]] <- head(ts, 6)
      ts <- ts[ts$p.value < alfa & !ts$uwolnij %in% c(uwolnione, nowe), ]
      if (!nrow(ts)) break
      nowe <- c(nowe, ts$uwolnij[1])
      fit_cz <- dopasuj(poziomy[[poziom]], c(uwolnione, nowe))
      por_cz <- porownaj(przyjety, fit_cz, typ)
      if (spelniona(por_cz)) break
    }
    if (!is.null(por_cz)) dodaj(paste(poziom, "częściowa"), fit_cz, por_cz, c(uwolnione, nowe))
    if (!is.null(por_cz) && spelniona(por_cz)) {
      przyjety <- fit_cz; uwolnione <- c(uwolnione, nowe)
    } else {
      przyjety <- fit; informacyjnie <- TRUE
    }
  }
  list(wiersze = wiersze, diagnostyka = diagnostyka, uwolnione = uwolnione)
}

# Zestawienie kroków: χ² (df), CFI, RMSEA, SRMR, Δχ² (Δdf) i p, ΔCFI, ΔRMSEA, decyzja
podsumuj <- function(wynik, typ = "robust") {
  do.call(rbind, lapply(wynik$wiersze, function(w) {
    i <- indeksy(w$fit, typ); p <- if (is.null(w$por)) rep(NA, 5) else unname(w$por)
    data.frame(model = paste0(w$nazwa, if (w$informacyjnie) " (informacyjnie)" else ""),
               chi2 = round(i[["chi2"]], 2), df = i[["df"]], CFI = round(i[["CFI"]], 3),
               RMSEA = round(i[["RMSEA"]], 3), SRMR = round(i[["SRMR"]], 3),
               dchi2 = round(p[1], 2), ddf = p[2], p = round(p[3], 3), dCFI = round(p[4], 3),
               dRMSEA = round(p[5], 3), spelniona = c("tak", "nie")[2 - w$spelniona],
               uwolnione = paste(w$uwolnione, collapse = ", "))
  }))
}

poziomy <- list(konfiguracyjna = "",
                metryczna      = "loadings",
                skalarna       = c("loadings", "intercepts"),
                scisla         = c("loadings", "intercepts", "residuals"))
wynik <- testuj_inwariancje(dopasuj, poziomy)
print(podsumuj(wynik), row.names = FALSE)
wynik$diagnostyka   # testy punktowe na poziomie, który nie spełnił kryteriów
wynik$uwolnione     # parametry szacowane osobno w każdej grupie
Wynik w R
              model   chi2  df   CFI RMSEA  SRMR dchi2 ddf     p   dCFI dRMSEA spelniona uwolnione
     konfiguracyjna 122.41 102 0.992 0.026 0.033    NA  NA    NA     NA     NA      <NA>
          metryczna 130.26 111 0.992 0.024 0.037  7.57   9 0.578  0.001 -0.002       tak
           skalarna 190.50 120 0.972 0.044 0.046 58.91   9 0.000 -0.020  0.020       nie
 skalarna częściowa 142.99 119 0.991 0.026 0.039 12.61   8 0.126 -0.002  0.002       tak      E3~1
             scisla 159.37 131 0.989 0.027 0.042 16.48  12 0.170 -0.002  0.001       tak      E3~1
$skalarna
   parametr     X2 p.value uwolnij
23     E3~1 46.252   0.000    E3~1
21     E1~1  8.349   0.004    E1~1
16     P4~1  5.214   0.022    P4~1
22     E2~1  3.811   0.051    E2~1
19     O3~1  2.805   0.094    O3~1
17     O1~1  2.664   0.103    O1~1

[1] "E3~1"
4. Średnie czynników i wyniki skal
R
# Średnie czynników u kobiet względem mężczyzn. W grupie odniesienia (mężczyźni) czynniki mają
# średnią 0 i wariancję 1, więc różnica jest wyrażona w odchyleniach standardowych czynnika u mężczyzn
srednie_czynnikow <- function(fit) {
  pe <- parameterEstimates(fit, level = .95)
  pe <- pe[pe$op == "~1" & pe$lhs %in% lavNames(fit, "lv") & pe$group == 2,
           c("lhs", "est", "se", "z", "pvalue", "ci.lower", "ci.upper")]
  pe[, -1] <- round(pe[, -1], 3)
  setNames(pe, c("czynnik", "d", "SE", "z", "p", "CI_dolna", "CI_gorna"))
}
skalarne <- Filter(function(w) grepl("^skalarna", w$nazwa) && isTRUE(w$spelniona) && !w$informacyjnie,
                   wynik$wiersze)
fit_czesciowy <- skalarne[[length(skalarne)]]$fit       # częściowa inwariancja skalarna (E3~1 uwolniony)
fit_pelny     <- dopasuj(c("loadings", "intercepts"))   # pełna inwariancja skalarna – tylko dla porównania
print(srednie_czynnikow(fit_czesciowy), row.names = FALSE)
print(srednie_czynnikow(fit_pelny), row.names = FALSE)

# Wyraz wolny pozycji E3 w obu grupach (model częściowej inwariancji skalarnej)
pe <- parameterEstimates(fit_czesciowy)
round(pe[pe$lhs == "E3" & pe$op == "~1", c("group", "est", "se", "ci.lower", "ci.upper")], 3)

# Dla porównania: wyniki skal (średnia z czterech pozycji) i d Cohena z 95% CI
skale <- list(przeciazenie = paste0("P", 1:4), obawy = paste0("O", 1:4), emocje = paste0("E", 1:4))
d_skali <- function(poz) {
  w <- rowMeans(dane[, poz]); k <- w[dane$plec == "kobieta"]; m <- w[dane$plec == "mężczyzna"]
  n1 <- length(k); n2 <- length(m)
  sd_p <- sqrt(((n1 - 1) * var(k) + (n2 - 1) * var(m)) / (n1 + n2 - 2))
  d <- (mean(k) - mean(m)) / sd_p
  se <- sqrt((n1 + n2) / (n1 * n2) + d^2 / (2 * (n1 + n2)))
  c(M_kobiety = mean(k), M_mezczyzni = mean(m), d = d, CI_dolna = d - 1.96 * se, CI_gorna = d + 1.96 * se,
    p = t.test(k, m, var.equal = TRUE)$p.value)
}
round(t(sapply(skale, d_skali)), 3)
Wynik w R
      czynnik     d    SE     z     p CI_dolna CI_gorna
 przeciazenie 0.019 0.090 0.206 0.837   -0.159    0.196
        obawy 0.235 0.092 2.564 0.010    0.055    0.414
       emocje 0.293 0.104 2.824 0.005    0.090    0.497
      czynnik     d    SE     z     p CI_dolna CI_gorna
 przeciazenie 0.019 0.090 0.206 0.837   -0.159    0.196
        obawy 0.235 0.092 2.564 0.010    0.055    0.414
       emocje 0.461 0.111 4.157 0.000    0.244    0.678
   group   est    se ci.lower ci.upper
41     1 2.560 0.057    2.448    2.672
86     2 3.063 0.066    2.933    3.193
             M_kobiety M_mezczyzni     d CI_dolna CI_gorna     p
przeciazenie     3.011       2.987 0.028   -0.132    0.188 0.734
obawy            3.207       3.032 0.215    0.055    0.376 0.009
emocje           3.222       2.909 0.399    0.238    0.561 0.000
5. Pozycje porządkowe: measEq.syntax i WLSMV
R
suppressPackageStartupMessages(library(semTools))   # measEq.syntax()

# Ta sama struktura, ale odpowiedzi na skali 1–4 (druga próba, dane symulowane: 300 + 300 osób)
set.seed(3046)
m_p <- generuj(300, srednie = c(0, 0, 0), wariancje = c(1, 1, 1), progi = c(2, 3, 4))
k_p <- generuj(300, srednie = c(0, 0.25, 0.30), wariancje = c(1.10, 1, 1.20),
               przesuniecie = c(rep(0, 10), 0.45, 0), progi = c(2, 3, 4))
dane_p <- rbind(cbind(m_p, plec = "mężczyzna"), cbind(k_p, plec = "kobieta"))
sapply(dane_p[, pozycje], function(x) table(factor(x, levels = 1:4)))   # liczebności kategorii

# Pozycje porządkowe: WLSMV, parametryzacja theta, identyfikacja według Wu i Estabrooka (2016)
dopasuj_p <- function(rownosci = "", uwolnione = character(0)) {
  measEq.syntax(configural.model = model, data = dane_p, ordered = pozycje, estimator = "WLSMV",
                parameterization = "theta", ID.fac = "std.lv", ID.cat = "Wu.Estabrook.2016",
                group = "plec", group.label = c("mężczyzna", "kobieta"), group.equal = rownosci,
                group.partial = if (length(uwolnione)) uwolnione else "", return.fit = TRUE)
}
poziomy_p <- list(konfiguracyjna = "",
                  progow         = "thresholds",
                  metryczna      = c("thresholds", "loadings"),
                  skalarna       = c("thresholds", "loadings", "intercepts"))
wynik_p <- testuj_inwariancje(dopasuj_p, poziomy_p, typ = "scaled", porzadkowe = TRUE)
print(podsumuj(wynik_p, typ = "scaled"), row.names = FALSE)
wynik_p$diagnostyka   # w modelu skalarnym testy wskazują progi E3, więc uwalniamy wyraz wolny E3

skalarne_p <- Filter(function(w) grepl("^skalarna", w$nazwa) && isTRUE(w$spelniona) && !w$informacyjnie,
                     wynik_p$wiersze)
print(srednie_czynnikow(skalarne_p[[length(skalarne_p)]]$fit), row.names = FALSE)
Wynik w R
   P1  P2  P3  P4  O1  O2  O3  O4  E1  E2  E3  E4
1  85 123  76 119  86  49 128  74 107  47 124  85
2 198 200 149 216 202 180 225 207 195 189 204 192
3 190 187 244 177 210 222 171 194 193 225 184 209
4 127  90 131  88 102 149  76 125 105 139  88 114
              model   chi2  df   CFI RMSEA  SRMR dchi2 ddf     p   dCFI dRMSEA spelniona uwolnione
     konfiguracyjna 108.56 102 0.998 0.015 0.036    NA  NA    NA     NA     NA      <NA>
             progow 117.93 114 0.999 0.011 0.036  7.89  12 0.793  0.001 -0.004       tak
          metryczna 122.59 123 1.000 0.000 0.037  6.34   9 0.706  0.001 -0.011       tak
           skalarna 215.84 132 0.976 0.046 0.037 77.95   9 0.000 -0.024  0.046       nie
 skalarna częściowa 126.90 131 1.000 0.000 0.037  4.86   8 0.772  0.000  0.000       tak      E3~1
$skalarna
   parametr     X2 p.value uwolnij
44    E3|t2 30.325   0.000    E3~1
43    E3|t1 22.863   0.000    E3~1
45    E3|t3 17.921   0.000    E3~1
42    E2|t3  9.346   0.002    E2~1
47    E4|t2  6.575   0.010    E4~1
14    P1|t2  2.207   0.137    P1~1

      czynnik     d    SE     z     p CI_dolna CI_gorna
 przeciazenie 0.117 0.094 1.253 0.210   -0.066    0.301
        obawy 0.301 0.093 3.226 0.001    0.118    0.484
       emocje 0.231 0.109 2.110 0.035    0.016    0.445
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7-2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- semTools (wersja 0.5-8): Jorgensen, T. D., Pornprasertmanit, S., Schoemann, A. M., & Rosseel, Y. (2026). semTools: Useful tools for structural equation modeling (Version 0.5-8) [R package]. https://doi.org/10.32614/CRAN.package.semTools
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer.
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Porównywanie średnich bez testu inwariancji. Różnica wyników może wynikać z działania pojedynczych pozycji – w przykładzie pominięcie nieinwariantnej pozycji zawyżyło różnicę w reakcjach emocjonalnych z 0.29 do 0.46 SD.
- Porównywanie każdego modelu z konfiguracyjnym. Model skalarny porównuj z ostatnim przyjętym (metrycznym albo częściowo metrycznym), inaczej trudno wskazać, który krok zawiódł.
- Decyzja na podstawie samego Δχ². Przy kilkuset osobach test wykrywa drobne różnice; decyzję opieraj na kryteriach przyjętych przed analizą.
- Uwalnianie parametrów hurtem albo bez końca. Uwalniaj po jednym, według testów punktowych, i zatrzymaj się, gdy kryteria są spełnione. Każde uwolnienie uzasadnij treścią pozycji.
- Porównywanie sum punktów przy częściowej inwariancji. Nierówne wyrazy wolne zniekształcają różnice wyników złożonych (Steinmetz, 2013).
- Pozycje porządkowe potraktowane jak ciągłe. Przy dwóch–czterech kategoriach użyj WLSMV i identyfikacji Wu i Estabrooka (2016).
- Za małe grupy. Przy kilkudziesięciu osobach w grupie częściej pojawiają się problemy ze zbieżnością, ujemne wariancje (przypadek Heywooda) i bardzo szerokie przedziały.
- Mieszanie typów wskaźników. Nie porównuj odpornego CFI jednego modelu ze skalowanym albo zwykłym CFI drugiego.
- Brak informacji o identyfikacji i uwolnionych parametrach. Wynik, zwłaszcza przy pozycjach porządkowych, zależy od identyfikacji – podaj ją w metodzie razem z listą parametrów szacowanych osobno w grupach.
Najczęstsze pytania
Jak sprawdzić inwariancję pomiaru w lavaan?
Oszacuj ten sam model CFA w grupach (argument group) i dodawaj kolejne ograniczenia argumentem group.equal: bez ograniczeń (model konfiguracyjny), "loadings" (metryczny), c("loadings", "intercepts") (skalarny) i dodatkowo "residuals" (ścisły). Każdy model porównaj z ostatnim przyjętym: lavTestLRT() da test różnicy chi-kwadrat, a fitMeasures() – CFI i RMSEA do obliczenia ΔCFI i ΔRMSEA. Przy pozycjach porządkowych składnię wygeneruj funkcją measEq.syntax() z pakietu semTools.
Co zrobić, gdy nie ma inwariancji skalarnej?
Sprawdź testami punktowymi (lavTestScore()), które wyrazy wolne najbardziej pogarszają dopasowanie, i uwalniaj je po jednym argumentem group.partial – w opisanej procedurze najwyżej trzy. Jeśli model częściowej inwariancji skalarnej spełnia kryteria, porównuj średnie czynników w modelu, a nie sumy punktów. Gdy korekta nie pomaga, ogranicz się do porównań związków między zmiennymi i opisz różnice na poziomie pozycji.
Jakie kryteria ΔCFI i ΔRMSEA przyjąć w teście inwariancji?
Najczęściej poziom uznaje się za spełniony, gdy jednocześnie ΔCFI ≥ −.010 (Cheung i Rensvold, 2002) i ΔRMSEA ≤ .015 (Chen, 2007), a każdy model porównuje się z ostatnim przyjętym. Δχ² podawaj informacyjnie, bo w dużych próbach wykrywa nawet drobne różnice. Progi wybierz przed analizą – proponowano też ostrzejsze, np. zmianę CFI rzędu .002 (Meade i in., 2008).
Ile osób w grupie potrzeba do wielogrupowej CFA?
Model musi dać się oszacować w każdej grupie osobno, dlatego w opisanej procedurze pomijamy grupy mniejsze niż 100 osób, a zalecamy 100–200 osób i więcej. Przy małych próbach RMSEA i TLI zbyt często odrzucają poprawne modele (Hu i Bentler, 1999). Chen (2007) pokazała ponadto, że przy nierównych liczebnościach grup zmiany wskaźników są mniejsze, więc testy rzadziej wykrywają brak inwariancji.
Czy przy częściowej inwariancji można porównywać średnie?
Tak, ale średnie czynników w modelu częściowej inwariancji skalarnej, a nie sumy punktów. Byrne i in. (1989) pokazali, jak testować średnie przy częściowej inwariancji, a Steinmetz (2013) – że nierówne wyrazy wolne zniekształcają porównania wyników złożonych. W przykładzie z tego wpisu model pełnej inwariancji skalarnej zawyżył różnicę w reakcjach emocjonalnych z 0.29 do 0.46 SD.
Czym różni się inwariancja metryczna od skalarnej?
Inwariancja metryczna oznacza równe ładunki czynnikowe w grupach: jednostka skali czynnika jest taka sama, więc można porównywać korelacje, kowariancje i ścieżki regresji. Inwariancja skalarna dodaje równe wyrazy wolne (przy pozycjach porządkowych – także progi): przy tym samym poziomie czynnika oczekiwana odpowiedź jest w grupach taka sama, więc można porównywać średnie czynników.
Powiązane hasła
Przeczytaj też
CB-SEM w R: kompletny przykład w pakiecie lavaan
Odtwarzalny przykład CB-SEM w R i lavaan: model pomiarowy, ścieżki, MLR, FIML, wskaźniki dopasowania, reszty i interpretacja APA 7.
Czytaj →PoradnikZarzuty recenzentów do statystyki
Piętnaście typowych uwag recenzentów do analiz – jak brzmią, skąd się biorą i jak im zapobiec, z symulacjami w R i listą kontrolną przed wysłaniem.
Czytaj →PoradnikOdpowiedź recenzentom – wzory PL i EN
Zasady i struktura odpowiedzi oraz wzory PL/EN na 12 sytuacji: moc post hoc, korekta porównań, model mieszany, braki danych, CMV i przyznanie się do błędu.
Czytaj →Recenzent pyta o inwariancję pomiaru?
Przeprowadzimy wielogrupową CFA, sprawdzimy kolejne poziomy inwariancji i wyjaśnimy, jakie porównania grup są uprawnione w Twoim artykule.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Asparouhov, T., & Muthén, B. (2014). Multiple-group factor analysis alignment. Structural Equation Modeling: A Multidisciplinary Journal, 21(4), 495–508. https://doi.org/10.1080/10705511.2014.919210
- Byrne, B. M., Shavelson, R. J., & Muthén, B. (1989). Testing for the equivalence of factor covariance and mean structures: The issue of partial measurement invariance. Psychological Bulletin, 105(3), 456–466. https://doi.org/10.1037/0033-2909.105.3.456
- Chen, F. F. (2007). Sensitivity of goodness of fit indexes to lack of measurement invariance. Structural Equation Modeling: A Multidisciplinary Journal, 14(3), 464–504. https://doi.org/10.1080/10705510701301834
- Cheung, G. W., & Rensvold, R. B. (2002). Evaluating goodness-of-fit indexes for testing measurement invariance. Structural Equation Modeling: A Multidisciplinary Journal, 9(2), 233–255. https://doi.org/10.1207/s15328007sem0902_5
- Hu, L., & Bentler, P. M. (1999). Cutoff criteria for fit indexes in covariance structure analysis: Conventional criteria versus new alternatives. Structural Equation Modeling: A Multidisciplinary Journal, 6(1), 1–55. https://doi.org/10.1080/10705519909540118
- Meade, A. W., Johnson, E. C., & Braddy, P. W. (2008). Power and sensitivity of alternative fit indices in tests of measurement invariance. Journal of Applied Psychology, 93(3), 568–592. https://doi.org/10.1037/0021-9010.93.3.568
- Meredith, W. (1993). Measurement invariance, factor analysis and factorial invariance. Psychometrika, 58(4), 525–543. https://doi.org/10.1007/bf02294825
- Putnick, D. L., & Bornstein, M. H. (2016). Measurement invariance conventions and reporting: The state of the art and future directions for psychological research. Developmental Review, 41, 71–90. https://doi.org/10.1016/j.dr.2016.06.004 ● Otwarty dostęp: pełny tekst
- Rhemtulla, M., Brosseau-Liard, P. É., & Savalei, V. (2012). When can categorical variables be treated as continuous? A comparison of robust continuous and categorical SEM estimation methods under suboptimal conditions. Psychological Methods, 17(3), 354–373. https://doi.org/10.1037/a0029315
- Satorra, A. (2000). Scaled and adjusted restricted tests in multi-sample analysis of moment structures. In R. D. H. Heijmans, D. S. G. Pollock, & A. Satorra (Eds.), Innovations in multivariate statistical analysis: A Festschrift for Heinz Neudecker (pp. 233–247). Kluwer Academic Publishers. https://doi.org/10.1007/978-1-4615-4603-0_17 ● Otwarty dostęp: pełny tekst
- Steinmetz, H. (2013). Analyzing observed composite differences across groups: Is partial measurement invariance enough? Methodology, 9(1), 1–12. https://doi.org/10.1027/1614-2241/a000049
- Svetina, D., Rutkowski, L., & Rutkowski, D. (2020). Multiple-group invariance with categorical outcomes using updated guidelines: An illustration using Mplus and the lavaan/semTools packages. Structural Equation Modeling: A Multidisciplinary Journal, 27(1), 111–130. https://doi.org/10.1080/10705511.2019.1602776
- Vandenberg, R. J., & Lance, C. E. (2000). A review and synthesis of the measurement invariance literature: Suggestions, practices, and recommendations for organizational research. Organizational Research Methods, 3(1), 4–70. https://doi.org/10.1177/109442810031002
- Wu, H., & Estabrook, R. (2016). Identification of confirmatory factor analysis models of different levels of invariance for ordered categorical outcomes. Psychometrika, 81(4), 1014–1045. https://doi.org/10.1007/s11336-016-9506-0 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{asparouhov2014multiple, author={Asparouhov, Tihomir and Muthén, Bengt}, title={{Multiple-group factor analysis alignment}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2014}, volume={21}, number={4}, pages={495--508}, doi={10.1080/10705511.2014.919210}}@article{byrne1989testing, author={Byrne, Barbara M. and Shavelson, Richard J. and Muthén, Bengt}, title={{Testing for the equivalence of factor covariance and mean structures: The issue of partial measurement invariance}}, journal={Psychological Bulletin}, year={1989}, volume={105}, number={3}, pages={456--466}, doi={10.1037/0033-2909.105.3.456}}@article{chen2007sensitivity, author={Chen, Fang Fang}, title={{Sensitivity of goodness of fit indexes to lack of measurement invariance}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2007}, volume={14}, number={3}, pages={464--504}, doi={10.1080/10705510701301834}}@article{cheung2002evaluating, author={Cheung, Gordon W. and Rensvold, Roger B.}, title={{Evaluating goodness-of-fit indexes for testing measurement invariance}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2002}, volume={9}, number={2}, pages={233--255}, doi={10.1207/s15328007sem0902_5}}@article{hu1999cutoff, author={Hu, Li-tze and Bentler, Peter M.}, title={{Cutoff criteria for fit indexes in covariance structure analysis: Conventional criteria versus new alternatives}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={1999}, volume={6}, number={1}, pages={1--55}, doi={10.1080/10705519909540118}}@article{meade2008power, author={Meade, Adam W. and Johnson, Emily C. and Braddy, Phillip W.}, title={{Power and sensitivity of alternative fit indices in tests of measurement invariance}}, journal={Journal of Applied Psychology}, year={2008}, volume={93}, number={3}, pages={568--592}, doi={10.1037/0021-9010.93.3.568}}@article{meredith1993measurement, author={Meredith, William}, title={{Measurement invariance, factor analysis and factorial invariance}}, journal={Psychometrika}, year={1993}, volume={58}, number={4}, pages={525--543}, doi={10.1007/bf02294825}}@article{putnick2016measurement, author={Putnick, Diane L. and Bornstein, Marc H.}, title={{Measurement invariance conventions and reporting: The state of the art and future directions for psychological research}}, journal={Developmental Review}, year={2016}, volume={41}, pages={71--90}, doi={10.1016/j.dr.2016.06.004}}@article{rhemtulla2012when, author={Rhemtulla, Mijke and Brosseau-Liard, Patricia É. and Savalei, Victoria}, title={{When can categorical variables be treated as continuous? A comparison of robust continuous and categorical SEM estimation methods under suboptimal conditions}}, journal={Psychological Methods}, year={2012}, volume={17}, number={3}, pages={354--373}, doi={10.1037/a0029315}}@incollection{satorra2000scaled, author={Satorra, Albert}, title={{Scaled and adjusted restricted tests in multi-sample analysis of moment structures}}, booktitle={Innovations in multivariate statistical analysis: A Festschrift for Heinz Neudecker}, year={2000}, pages={233--247}, publisher={Kluwer Academic Publishers}, doi={10.1007/978-1-4615-4603-0_17}}@article{steinmetz2013analyzing, author={Steinmetz, Holger}, title={{Analyzing observed composite differences across groups: Is partial measurement invariance enough?}}, journal={Methodology}, year={2013}, volume={9}, number={1}, pages={1--12}, doi={10.1027/1614-2241/a000049}}@article{svetina2020multiple, author={Svetina, Dubravka and Rutkowski, Leslie and Rutkowski, David}, title={{Multiple-group invariance with categorical outcomes using updated guidelines: An illustration using Mplus and the lavaan/semTools packages}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2020}, volume={27}, number={1}, pages={111--130}, doi={10.1080/10705511.2019.1602776}}@article{vandenberg2000review, author={Vandenberg, Robert J. and Lance, Charles E.}, title={{A review and synthesis of the measurement invariance literature: Suggestions, practices, and recommendations for organizational research}}, journal={Organizational Research Methods}, year={2000}, volume={3}, number={1}, pages={4--70}, doi={10.1177/109442810031002}}@article{wu2016identification, author={Wu, Hao and Estabrook, Ryne}, title={{Identification of confirmatory factor analysis models of different levels of invariance for ordered categorical outcomes}}, journal={Psychometrika}, year={2016}, volume={81}, number={4}, pages={1014--1045}, doi={10.1007/s11336-016-9506-0}}