Przykład: czy Słowacy ufają marce mniej niż Polacy?
Fikcyjna marka małego AGD – nazwijmy ją Norvi – sprzedaje ekspresy i odkurzacze w Polsce, Czechach i na Słowacji. Dział marketingu zlecił ankietę: w każdym kraju 400 klientów oceniło sześć zdań o zaufaniu do marki na skali od 1 („zdecydowanie się nie zgadzam”) do 7 („zdecydowanie się zgadzam”). Zdania brzmią np. „Ufam marce Norvi”, „Norvi dotrzymuje obietnic składanych klientom” i „Gdyby coś poszło nie tak, Norvi zachowa się uczciwie” (pozycja z4). Ankietę przetłumaczono na czeski i słowacki.
Pytanie biznesowe brzmi: w którym kraju zaufanie do marki jest niższe i trzeba je odbudować? Zaufanie to nie ozdobnik. Chaudhuri i Holbrook (2001) na danych o 107 markach pokazali, że zaufanie i emocjonalny stosunek do marki wyznaczają lojalność klientów, a ta wiąże się z udziałem w rynku i wyższą ceną. Najprościej byłoby zsumować sześć odpowiedzi i porównać średnie sumy: Polska 27.52, Czechy 28.53, Słowacja 26.54 punktu. Ale to porównanie ma sens tylko wtedy, gdy ankieta mierzy to samo w każdym kraju. Sprawdza to analiza niezmienności pomiarowej.
Dane są fikcyjne i wiemy, co w nich ukryliśmy. Ręcznie ustaliliśmy prawdziwe zaufanie: w Czechach wyższe niż w Polsce o 0.30 SD, na Słowacji niższe o 0.20 SD. Ustaliliśmy też jedną pułapkę. W słowackiej wersji pozycja z4 brzmi jak „Norvi rozpatrzy reklamację”. Na Słowacji sieć sprzedaży daje trzyletnią gwarancję, więc klienci zgadzają się z tym zdaniem częściej, niezależnie od zaufania: przy tym samym zaufaniu odpowiedź jest wyższa o 1 punkt. Wszystkie parametry są w przepisie 1 kodu, a ziarno 628 ustaliliśmy raz i go nie zmienialiśmy. Dane pobierzesz jako postawy-wobec-marki-trzy-kraje.csv. Kolumna zaufanie_prawdziwe istnieje tylko w symulacji.
Rysunek 1: trzy poziomy niezmienności
Zaufanie do marki to zmienna ukryta. Widzimy tylko odpowiedzi na pozycje, a model konfirmacyjnej analizy czynnikowej (CFA) opisuje każdą z nich prostą: odpowiedź = wyraz wolny + ładunek × zaufanie + błąd. W wielogrupowej CFA każdy kraj ma własną prostą dla każdej pozycji. Steenkamp i Baumgartner (1998) zaproponowali dla badań konsumenckich w kilku krajach procedurę, która krok po kroku sprawdza, które części tych prostych są wspólne.
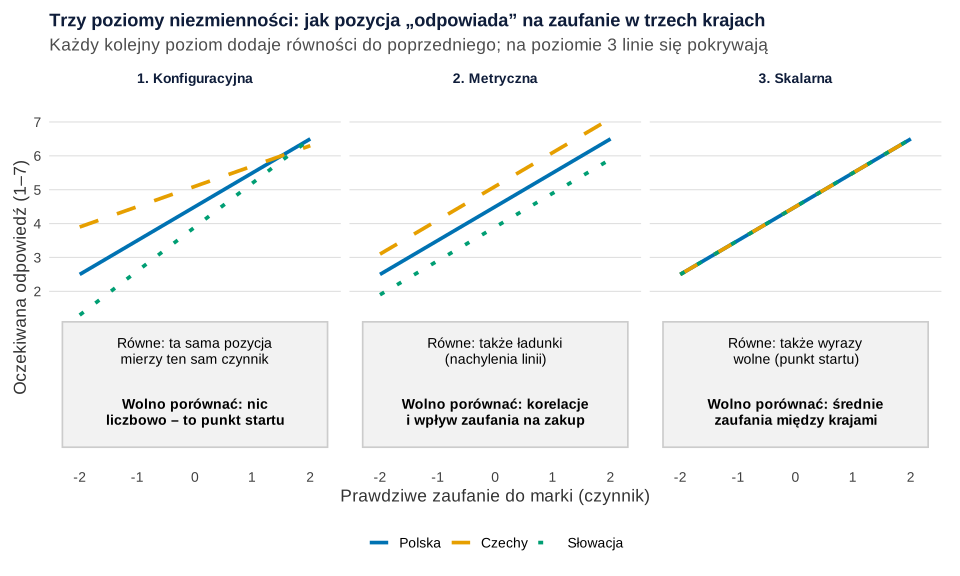
Co widać. Każdy poziom dodaje równości do poprzedniego. Konfiguracyjna: w każdym kraju te same pozycje mierzą jeden czynnik, ale proste mogą się dowolnie różnić. Metryczna: równe ładunki, czyli proste są równoległe – wzrost zaufania o jednostkę podnosi odpowiedź tak samo w każdym kraju. Wtedy wolno porównywać korelacje i ścieżki, np. wpływ zaufania na lojalność w modelu satysfakcji i lojalności. Skalarna: równe także wyrazy wolne, czyli proste się pokrywają. Dopiero wtedy ta sama odpowiedź znaczy ten sam poziom zaufania, a różnica średnich dotyczy zaufania, nie ankiety.
Jak może zmylić. Schemat pokazuje jedną pozycję. W praktyce niezmienność może zawieść tylko dla jednej pozycji w jednym kraju – to częściowa niezmienność (Byrne i in., 1989), którą zobaczysz na rysunku 3. Pomijamy tu poziom ścisły (równe wariancje błędów). Jego rolę i pełną procedurę naukową opisuje wpis inwariancja pomiaru krok po kroku, a definicję – hasło inwariancja pomiaru w CB-SEM.
Podpis do pracy:
Zdanie do Metody:
Rysunek 2: dopasowanie kolejnych modeli
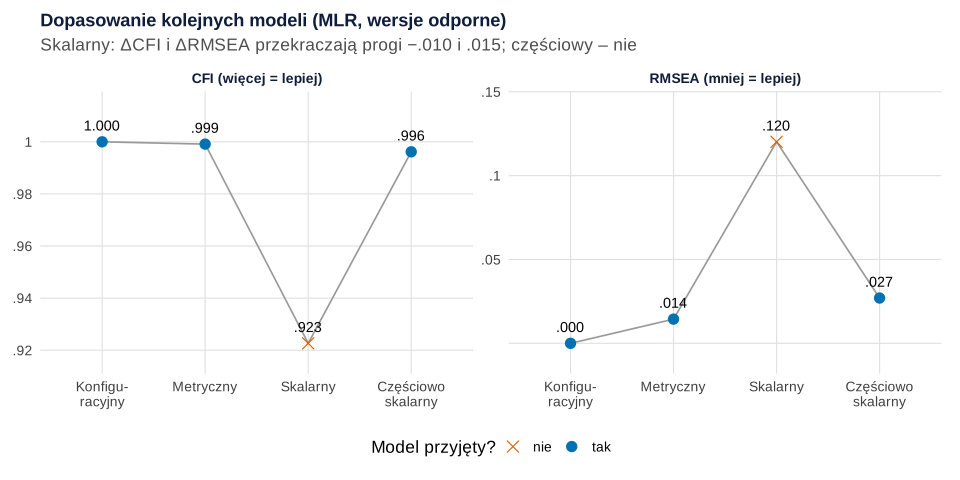
set.seed(628)).Co widać. Modele oszacowaliśmy w pakiecie lavaan (Rosseel, 2012) estymatorem MLR, bo odpowiedzi na skali 1–7 nie są normalne. Model konfiguracyjny pasuje bardzo dobrze: χ²(27) = 26.74, CFI = 1.000, RMSEA = .000. Zrównanie ładunków prawie nic nie zmienia: CFI spada o .001, a test różnicy χ² jest nieistotny, Δχ²(10) = 13.71, p = .187. Inaczej przy wyrazach wolnych: CFI spada do .923 (ΔCFI = −.076), RMSEA rośnie do .120, a Δχ²(10) = 281.58, p < .001. Niezmienność skalarna nie zachodzi.
Jak może zmylić. Progi ΔCFI ≥ −.010 i ΔRMSEA ≤ .015 to umowa, a nie prawo statystyki. Chen (2007) pokazała w symulacjach, że zmiany wskaźników zależą od wzoru i odsetka pozycji nieinwariantnych, a przy nierównych liczebnościach grup są mniejsze. Według przeglądu Putnick i Bornstein (2016) większość badań testuje kolejno te trzy poziomy, zwykle wskaźnikami przybliżonymi, a mniej więcej co trzeci test kończy się częściową niezmiennością. Ostatni punkt to model częściowy z rysunku 3. Porównujemy go z metrycznym: ΔCFI = −.003, ΔRMSEA = .013, ale Δχ²(9) = 19.35, p = .022. Przy 1200 osobach test χ² wychwytuje nawet drobne różnice, dlatego o decyzji przesądziły wskaźniki przybliżone, a wynik testu raportujemy obok.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: która pozycja zawodzi?
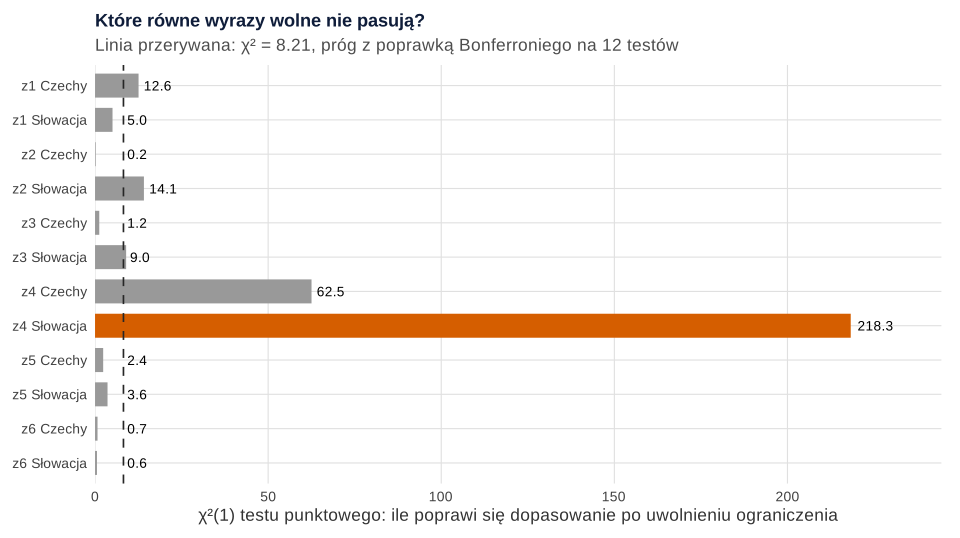
Co widać. W modelu skalarnym jest 12 ograniczeń równości wyrazów wolnych: każda z sześciu pozycji w Czechach i na Słowacji jest zrównana z Polską. Test punktowy (funkcja lavTestScore()) mówi, o ile spadłoby χ², gdyby uwolnić jedno ograniczenie. Zdecydowanie najwięcej daje z4 na Słowacji: χ²(1) = 218.27, p < .001. Po uwolnieniu tylko tego parametru wyraz wolny z4 wynosi 4.55 w Polsce i Czechach oraz 5.49 na Słowacji. Różnica 0.95 punktu jest bliska ukrytemu 1 punktowi.
Jak może zmylić. Ponad próg z korektą Bonferroniego (8.21) wychodzi też z4 w Czechach (62.53), z2 na Słowacji, z1 w Czechach i z3 na Słowacji. W tych miejscach niczego nie ukryliśmy. Jedna zła pozycja „ciągnie” wspólne oszacowanie i zniekształca sąsiednie ograniczenia. Dlatego uwalniaj parametry po jednym i za każdym razem licz testy od nowa. W modelu częściowym największy test dotyczy z1 w Czechach: χ²(1) = 6.91, p = .009, poniżej progu 9.23 dla 21 ograniczeń. Podobną diagnostykę dają indeksy modyfikacji. W prawdziwych danych przyczynę wskaże dopiero tłumacz albo zespół w danym kraju, a nie statystyka.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: średnie latentne a surowe sumy
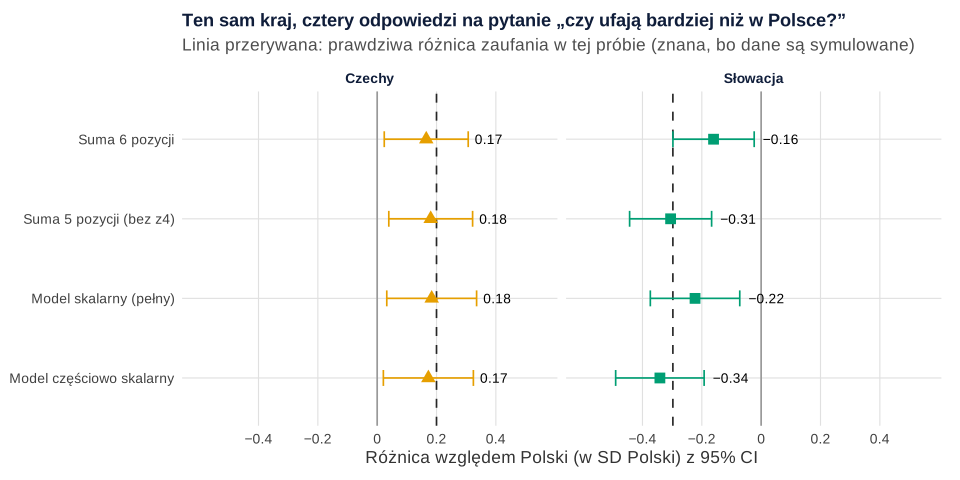
Co widać. Różnice podajemy w odchyleniach standardowych Polski. Linia przerywana to prawdziwa różnica zaufania w tej próbie: 0.20 dla Czech i −0.30 dla Słowacji. Wartości populacyjne wynosiły 0.30 i −0.20, ale 400 losowych osób na kraj nie odtwarza ich co do setnej. Dla Czech wszystkie metody są zgodne (0.17–0.18). Dla Słowacji suma sześciu pozycji pokazuje −0.16, 95% CI [−0.30, −0.02], p = .022, czyli o połowę mniej niż model częściowo skalarny: −0.34, 95% CI [−0.49, −0.19]. Zawyżona pozycja z4 maskuje połowę problemu. Pełny model skalarny też jest obciążony (−0.22), bo na siłę zrównuje z4.
Jak może zmylić. Suma pięciu pozycji bez z4 trafia tu dobrze (−0.31), ale tylko dlatego, że pozostałe pozycje są niezmiennicze. Bez analizy niezmienności nie wiesz, którą pozycję usunąć. Steinmetz (2013) w symulacji pokazał, że już jeden lub dwa nierówne wyrazy wolne zniekształcają różnice sum. Dlatego zalecał porównywanie średnich latentnych. Gdy krajów jest kilkanaście, zamiast uwalniać parametry po jednym, sięgnij po metodę alignment.
Podpis do pracy:
Zdanie do Wyników:
Co z tym zrobić w marketingu
- Słowacja – realny problem z zaufaniem (−0.34 SD). Na podstawie sum budżet trafiłby gdzie indziej. Sprawdź, czego dotyczą najniższe pozycje (dotrzymywanie obietnic, poleganie na marce), i zaplanuj komunikację o niezawodności z grupą kontrolną (test A/B).
- Pozycja z4 na Słowacji – popraw przekład. W obecnej wersji mierzy znajomość gwarancji, a nie zaufanie. Zleć nowy przekład i tłumaczenie zwrotne albo przenieś to pytanie do osobnego bloku o obsłudze posprzedażowej.
- Czechy – zaufanie wyższe o 0.17 SD. Przedział zaczyna się jednak przy 0.02, więc różnica może być niewielka. To argument do testu kampanii premium, a nie dowód, że ona się opłaci.
- Kolejne fale badania. W badaniu trackingowym marki trzymaj tę samą wersję pozycji i sprawdzaj niezmienność także między falami.
Rysunek 5: 1000 badań – różnica, której nie ma
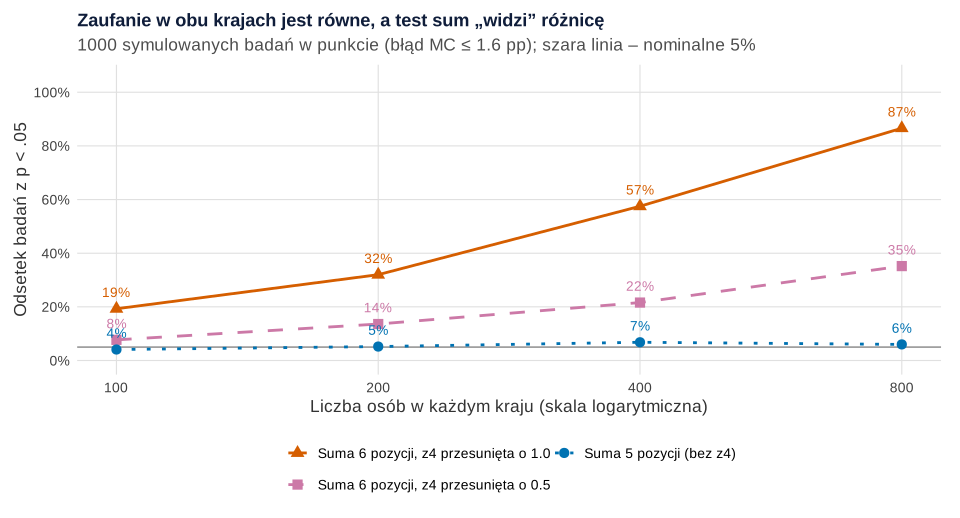
set.seed(628)).Co widać. Tu zaufanie w obu krajach jest takie samo, a w drugim kraju przesunęliśmy tylko wyraz wolny z4. Każdy punkt to 1000 symulowanych badań porównujących sumy testem t Welcha. Przy przesunięciu o 1 punkt i 100 osobach w kraju fałszywą różnicę „wykrywa” 19.3% badań, a przy 800 osobach – 86.6%. Przy przesunięciu o 0.5 punktu odpowiednio 7.7% i 35.2%. Suma bez z4 daje 4.1–6.8% istotnych wyników, blisko nominalnych 5%. Błąd Monte Carlo nie przekracza 1.6 punktu procentowego.
Jak może zmylić. Większa próba nie leczy tego błędu, tylko go utrwala: test coraz pewniej wskazuje różnicę wynikającą z przekładu. Symulacja dotyczy przesunięcia wyrazu wolnego jednej pozycji. Inne źródła różnic też działają na wszystkie pozycje naraz. Przykładem są style odpowiedzi, np. skłonność do skrajnych ocen. W badaniu konsumentów z 11 krajów Unii Europejskiej Baumgartner i Steenkamp (2001) wykazali, że systematycznie zniekształcają one wyniki skal.
Podpis do pracy:
Zdanie do Dyskusji:
Pułapki
- Porównanie sum bez sprawdzenia niezmienności – rysunki 4 i 5. To samo dotyczy średnich pozycji.
- Uwalnianie wszystkich podejrzanych parametrów naraz. Uwolnienie z4 w Czechach byłoby tu błędem (rysunek 3).
- Częściowa niezmienność „do skutku”. Gdy uwalniasz połowę wyrazów wolnych, porównanie średnich opiera się na kilku pozycjach. Zgłoś liczbę uwolnionych parametrów i uzasadnij każdy.
- Dobry przekład = brak problemu. Przekład i adaptację opisuje wpis adaptacja kulturowa kwestionariusza, ale dopiero dane pokazują, czy pozycje działają tak samo. Na poziomie pojedynczych pozycji to samo zjawisko nazywa się DIF.
- Skala z 4 lub mniej kategoriami jak ciągła. Wtedy zamiast wyrazów wolnych testuje się progi i szacuje model estymatorem WLSMV.
Jak opisać w pracy
W Metodzie podaj estymator, kolejność modeli i kryteria decyzji, w Wynikach – tabelę dopasowania i średnie latentne. Wzór tabeli znajdziesz w haśle tabela dopasowania modelu CFA w APA, a składnię lavaan – we wpisie CB-SEM w R (lavaan). Inne analizy do prac z marketingu zebraliśmy we wpisie statystyka w pracy z marketingu.
| Model | χ² | df | CFI | RMSEA | SRMR | ΔCFI | ΔRMSEA | Decyzja |
|---|---|---|---|---|---|---|---|---|
| Konfiguracyjny | 26.74 | 27 | 1.000 | .000 | .012 | – | – | przyjęty |
| Metryczny | 40.19 | 37 | .999 | .014 | .030 | −.001 | .014 | przyjęty |
| Skalarny | 326.00 | 47 | .923 | .120 | .077 | −.076 | .106 | odrzucony |
| Częściowo skalarny | 59.78 | 46 | .996 | .027 | .034 | −.003 | .013 | przyjęty |
Podpis tabeli:
Do Metody:
Gdy niezmienność już masz, różnice w postrzeganiu marek na tle konkurencji pokaże mapa percepcji marek.
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw i dane, przepis 3 – modele, z których korzysta przepis 4. Każdy przepis z rysunkiem kończy się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p5, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Przepisy, które losują (1 i 5), mają własne set.seed(628). Ziarno 628 ustalono raz i nie zmieniano go. Dane losujemy przed pierwszym wywołaniem lavaan, a symulacja nie korzysta z lavaan – liczby nie zależą więc od tego, czy wcześniej dopasowano modele. Ręcznie ustalono: 400 osób w kraju, ładunki (1.00, 1.10, 0.90, 1.00, 1.20, 0.80), wyrazy wolne (4.6, 4.4, 4.8, 4.5, 4.3, 4.7), odchylenia błędów (0.80, 0.75, 0.85, 0.80, 0.70, 0.90), średnie zaufania (Polska 0, Czechy 0.30, Słowacja −0.20 SD przy SD = 1 w każdym kraju), przesunięcie wyrazu wolnego z4 na Słowacji o 1.0 punktu, zaokrąglenie do skali 1–7, a w symulacji liczebności 100–800 i przesunięcia 0.5 oraz 1.0. Cały kod liczy się w kilka sekund.
1. Paleta, motyw i dane z trzech krajów
R
# Przepis 1. Paleta, motyw i dane: skala zaufania do marki w trzech krajach (dane fikcyjne, symulowane)
library(ggplot2)
kol <- c(Polska = "#0072B2", Czechy = "#E69F00", "Słowacja" = "#009E73",   # Okabe–Ito
         ciemny = "#262626", szary = "grey60", akcent = "#D55E00", roz = "#CC79A7")
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        plot.title = element_text(face = "bold"))

# Ręcznie ustalone parametry populacji (model czynnikowy jednego czynnika „zaufanie do marki”)
kraje <- c("Polska", "Czechy", "Słowacja")
n_kraj <- 400                                         # osób w każdym kraju
pozycje <- paste0("z", 1:6)
tresc <- c(z1 = "Ufam marce Norvi",
           z2 = "Norvi dotrzymuje obietnic składanych klientom",
           z3 = "Sprzęt Norvi działa tak, jak zapowiada producent",
           z4 = "Gdyby coś poszło nie tak, Norvi zachowa się uczciwie",
           z5 = "Mogę polegać na marce Norvi",
           z6 = "Norvi dba o interesy klientów")
ladunki   <- c(1.00, 1.10, 0.90, 1.00, 1.20, 0.80)
wyrazy    <- c(4.6, 4.4, 4.8, 4.5, 4.3, 4.7)         # wyrazy wolne (odpowiedź przy zaufaniu = 0)
sd_reszt  <- c(0.80, 0.75, 0.85, 0.80, 0.70, 0.90)
srednia_prawdziwa <- c(Polska = 0, Czechy = 0.30, "Słowacja" = -0.20)   # w SD czynnika
przesun_z4_sk <- 1.0   # Słowacja: przekład z4 brzmi „rozpatrzy reklamację” – pozycja reaguje na gwarancję

losuj_kraj <- function(kraj, n) {
  eta <- rnorm(n, srednia_prawdziwa[[kraj]], 1)
  nu <- wyrazy
  if (kraj == "Słowacja") nu[4] <- nu[4] + przesun_z4_sk
  ciagle <- sweep(outer(eta, ladunki), 2, nu, "+") + sweep(matrix(rnorm(n * 6), n), 2, sd_reszt, "*")
  odp <- pmin(pmax(round(ciagle), 1), 7)              # skala 1–7
  colnames(odp) <- pozycje
  data.frame(kraj = kraj, odp, zaufanie_prawdziwe = round(eta, 3))
}
set.seed(628)                                          # dane losujemy PRZED jakimkolwiek wywołaniem lavaan
dane <- do.call(rbind, lapply(kraje, losuj_kraj, n = n_kraj))
dane$kraj <- factor(dane$kraj, levels = kraje)
dane$suma6 <- rowSums(dane[, pozycje])
dane$suma5 <- rowSums(dane[, setdiff(pozycje, "z4")])
write.csv(dane[, c("kraj", pozycje, "suma6", "zaufanie_prawdziwe")], "postawy-wobec-marki-trzy-kraje.csv",
          row.names = FALSE, fileEncoding = "UTF-8")

# Średnie pozycji i sumy w krajach
round(sapply(split(dane[, c(pozycje, "suma6")], dane$kraj), colMeans), 2)
table(dane$kraj)
round(c(odsetek_odp_7 = 100 * mean(as.matrix(dane[, pozycje]) == 7),
        odsetek_odp_1 = 100 * mean(as.matrix(dane[, pozycje]) == 1)), 1)
Wynik w R
      Polska Czechy Słowacja
z1      4.56   4.88     4.33
z2      4.51   4.57     4.05
z3      4.83   4.96     4.47
z4      4.58   4.67     5.17
z5      4.32   4.57     4.00
z6      4.71   4.88     4.51
suma6  27.52  28.53    26.54

  Polska   Czechy Słowacja
     400      400      400
odsetek_odp_7 odsetek_odp_1
          7.6           1.0
2. Grafika: trzy poziomy niezmienności – Rysunek 1
R
# Przepis 2. Grafika: trzy poziomy niezmienności pomiarowej na przykładzie jednej pozycji (Rysunek 1)
# Dane wejściowe: kraje, kol i motyw z przepisu 1. Linie są schematem (wartości wymyślone), nie wynikiem modelu.
poziomy <- c("1. Konfiguracyjna", "2. Metryczna", "3. Skalarna")
schemat <- data.frame(poziom = rep(poziomy, each = 3), kraj = rep(kraje, 3),
                      nachylenie = c(1.0, 0.6, 1.3,   1, 1, 1,   1, 1, 1),
                      wyraz = c(4.5, 5.1, 3.9,   4.5, 5.1, 3.9,   4.5, 4.5, 4.5))
x <- seq(-2, 2, length.out = 2)
linie <- do.call(rbind, lapply(seq_len(nrow(schemat)), function(i)
  data.frame(poziom = schemat$poziom[i], kraj = schemat$kraj[i], zaufanie = x, odp = schemat$wyraz[i] + schemat$nachylenie[i] * x)))
linie$kraj <- factor(linie$kraj, levels = kraje)
karty <- data.frame(poziom = poziomy,
  rowne = c("Równe: ta sama pozycja\nmierzy ten sam czynnik", "Równe: także ładunki\n(nachylenia linii)",
            "Równe: także wyrazy\nwolne (punkt startu)"),
  wolno = c("Wolno porównać: nic\nliczbowo – to punkt startu", "Wolno porównać: korelacje\ni wpływ zaufania na zakup",
            "Wolno porównać: średnie\nzaufania między krajami"))
p1 <- ggplot(linie, aes(zaufanie, odp)) +
  annotate("rect", xmin = -2.3, xmax = 2.3, ymin = -2.6, ymax = 1.1, fill = "grey95", colour = "grey80") +
  geom_line(aes(colour = kraj, linetype = kraj), linewidth = 1.3) +
  geom_text(data = karty, aes(x = 0, y = 0.25, label = rowne), size = 3.7, lineheight = 0.95) +
  geom_text(data = karty, aes(x = 0, y = -1.55, label = wolno), size = 3.7, lineheight = 0.95, fontface = "bold") +
  facet_wrap(~ poziom) +
  scale_colour_manual(values = kol[kraje], name = NULL) +
  scale_linetype_manual(values = c(Polska = "solid", Czechy = "dashed", "Słowacja" = "dotted"), name = NULL) +
  scale_y_continuous(breaks = 2:7, limits = c(-2.6, 7.4)) +
  labs(x = "Prawdziwe zaufanie do marki (czynnik)", y = "Oczekiwana odpowiedź (1–7)",
       title = "Trzy poziomy niezmienności: jak pozycja „odpowiada” na zaufanie w trzech krajach",
       subtitle = "Każdy kolejny poziom dodaje równości do poprzedniego; na poziomie 3 linie się pokrywają") +
  motyw + theme(panel.grid.major.x = element_blank())
p1   # ggsave("niezmiennosc-schemat-poziomow.svg", p1, width = 10, height = 6)
3. Modele niezmienności i testy punktowe – Rysunki 2 i 3
R
# Przepis 3. Sekwencja modeli: konfiguracyjny, metryczny, skalarny i częściowo skalarny (Rysunki 2 i 3)
# Dane wejściowe: dane, pozycje, kraje, kol i motyw z przepisu 1.
library(lavaan)
model <- "zaufanie =~ z1 + z2 + z3 + z4 + z5 + z6"
dopasuj <- function(...) cfa(model, data = dane, group = "kraj", estimator = "MLR", ...)
m_konf <- dopasuj()
m_metr <- dopasuj(group.equal = "loadings")
m_skal <- dopasuj(group.equal = c("loadings", "intercepts"))

# Które ograniczenie równości najbardziej psuje dopasowanie? Testy punktowe (score tests, wersja odporna)
testy_punktowe <- function(m) {
  pt <- parTable(m)
  u <- lavTestScore(m)$uni
  par <- pt[match(u$rhs, pt$plabel), ]                 # parametr kraju porównywanego z Polską
  data.frame(pozycja = ifelse(par$op == "~1", par$lhs, par$rhs),
             parametr = ifelse(par$op == "~1", "wyraz wolny", "ładunek"),
             kraj = kraje[par$group], X2 = round(u$X2.scaled, 2), p = u$p.value.scaled)
}
st <- testy_punktowe(m_skal)
st <- st[st$parametr == "wyraz wolny", ]
print(transform(st[order(-st$X2), ][1:4, ], p = format.pval(p, eps = .001, digits = 2)), row.names = FALSE)

# Częściowa inwariancja skalarna: wyraz wolny z4 uwolniony tylko na Słowacji (etykiety parametrów)
model_cz <- "
zaufanie =~ c(l1, l1, l1)*z1 + c(l2, l2, l2)*z2 + c(l3, l3, l3)*z3 +
            c(l4, l4, l4)*z4 + c(l5, l5, l5)*z5 + c(l6, l6, l6)*z6
z1 ~ c(i1, i1, i1)*1
z2 ~ c(i2, i2, i2)*1
z3 ~ c(i3, i3, i3)*1
z4 ~ c(i4, i4, i4sk)*1
z5 ~ c(i5, i5, i5)*1
z6 ~ c(i6, i6, i6)*1
zaufanie ~ c(0, NA, NA)*1
"
m_cz <- cfa(model_cz, data = dane, group = "kraj", estimator = "MLR")

modele <- list(Konfiguracyjny = m_konf, Metryczny = m_metr, Skalarny = m_skal, "Częściowo skalarny" = m_cz)
miary <- c("chisq.scaled", "df", "cfi.robust", "rmsea.robust", "srmr")
dop <- as.data.frame(t(sapply(modele, fitMeasures, fit.measures = miary)))
dop$delta_cfi <- c(NA, diff(dop$cfi.robust)[1:2], dop$cfi.robust[4] - dop$cfi.robust[2])     # względem poprzedniego
dop$delta_rmsea <- c(NA, diff(dop$rmsea.robust)[1:2], dop$rmsea.robust[4] - dop$rmsea.robust[2])
round(dop, 3)
lrt <- rbind(metr_vs_konf = lavTestLRT(m_konf, m_metr)[2, c("Chisq diff", "Df diff", "Pr(>Chisq)")],
             skal_vs_metr = lavTestLRT(m_metr, m_skal)[2, c("Chisq diff", "Df diff", "Pr(>Chisq)")],
             czesc_vs_metr = lavTestLRT(m_metr, m_cz)[2, c("Chisq diff", "Df diff", "Pr(>Chisq)")])
round(lrt, 3)
# Wyraz wolny z4 w krajach (model częściowy): Polska = Czechy, Słowacja osobno
pe <- parameterEstimates(m_cz)
round(c(z4_PL_CZ = pe$est[pe$label == "i4"][1], z4_SK = pe$est[pe$label == "i4sk"][1],
        roznica = pe$est[pe$label == "i4sk"][1] - pe$est[pe$label == "i4"][1]), 2)

# Rysunek 2. Dopasowanie kolejnych modeli
dd <- data.frame(model = factor(rep(rownames(dop), 2), levels = rownames(dop)),
                 miara = rep(c("CFI (więcej = lepiej)", "RMSEA (mniej = lepiej)"), each = 4),
                 wartosc = c(dop$cfi.robust, dop$rmsea.robust),
                 przyjety = rep(c("tak", "tak", "nie", "tak"), 2))
dd$etykieta <- sub("^0", "", sprintf("%.3f", dd$wartosc))
p2 <- ggplot(dd, aes(model, wartosc, group = 1)) +
  geom_line(colour = kol[["szary"]]) +
  geom_point(aes(shape = przyjety, colour = przyjety), size = 3.6) +
  geom_text(aes(label = etykieta), vjust = -1.1, size = 3.8) +
  facet_wrap(~ miara, scales = "free_y") +
  scale_y_continuous(expand = expansion(mult = c(0.15, 0.25)), labels = function(x) sub("^0", "", x)) +
  scale_shape_manual(values = c(tak = 16, nie = 4), name = "Model przyjęty?") +
  scale_colour_manual(values = c(tak = kol[["Polska"]], nie = kol[["akcent"]]), name = "Model przyjęty?") +
  scale_x_discrete(labels = c("Konfigu-\nracyjny", "Metryczny", "Skalarny", "Częściowo\nskalarny")) +
  labs(x = NULL, y = NULL, title = "Dopasowanie kolejnych modeli (MLR, wersje odporne)",
       subtitle = "Skalarny: ΔCFI i ΔRMSEA przekraczają progi −.010 i .015; częściowy – nie") + motyw
p2   # ggsave("niezmiennosc-dopasowanie.svg", p2, width = 10, height = 5)

# Rysunek 3. Testy punktowe dla 12 ograniczeń równości wyrazów wolnych (każdy kraj względem Polski)
st$para <- factor(paste(st$pozycja, st$kraj), levels = rev(paste(st$pozycja, st$kraj)))
st$wyrozniony <- ifelse(st$X2 == max(st$X2), "największy", "pozostałe")
krytyczne <- qchisq(1 - .05 / nrow(st), 1)           # 12 testów: próg χ² z poprawką Bonferroniego
p3 <- ggplot(st, aes(X2, para, fill = wyrozniony)) +
  geom_col(width = 0.7) +
  geom_vline(xintercept = krytyczne, linetype = "dashed", colour = kol[["ciemny"]]) +
  geom_text(aes(x = pmax(X2, krytyczne), label = sprintf("%.1f", X2)), hjust = -0.2, size = 3.6) +
  scale_fill_manual(values = c("największy" = kol[["akcent"]], "pozostałe" = kol[["szary"]]), guide = "none") +
  scale_x_continuous(expand = expansion(mult = c(0, 0.12))) +
  labs(x = "χ²(1) testu punktowego: ile poprawi się dopasowanie po uwolnieniu ograniczenia", y = NULL,
       title = "Które równe wyrazy wolne nie pasują?",
       subtitle = sprintf("Linia przerywana: χ² = %.2f, próg z poprawką Bonferroniego na 12 testów", krytyczne)) + motyw
p3   # ggsave("niezmiennosc-testy-punktowe.svg", p3, width = 10, height = 5.6)
Wynik w R
 pozycja    parametr     kraj     X2      p
      z4 wyraz wolny Słowacja 218.27 <0.001
      z4 wyraz wolny   Czechy  62.53 <0.001
      z2 wyraz wolny Słowacja  14.12 <0.001
      z1 wyraz wolny   Czechy  12.57 <0.001
                   chisq.scaled df cfi.robust rmsea.robust  srmr delta_cfi
Konfiguracyjny           26.742 27      1.000        0.000 0.012        NA
Metryczny                40.185 37      0.999        0.014 0.030    -0.001
Skalarny                326.003 47      0.923        0.120 0.077    -0.076
Częściowo skalarny       59.779 46      0.996        0.027 0.034    -0.003
                   delta_rmsea
Konfiguracyjny              NA
Metryczny                0.014
Skalarny                 0.106
Częściowo skalarny       0.013
              Chisq diff Df diff Pr(>Chisq)
metr_vs_konf      13.711      10      0.187
skal_vs_metr     281.582      10     <2e-16 ***
czesc_vs_metr     19.349       9      0.022 *
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
z4_PL_CZ    z4_SK  roznica
    4.55     5.49     0.95
4. Średnie latentne a sumy – Rysunek 4
R
# Przepis 4. Średnie latentne a surowe sumy: różnice względem Polski (Rysunek 4)
# Dane wejściowe: dane, kraje, kol i motyw z przepisu 1; m_skal, m_cz i testy_punktowe() z przepisu 3.
# Po uwolnieniu z4 na Słowacji: czy inne ograniczenie nadal odstaje? (największy test punktowy)
st_cz <- testy_punktowe(m_cz)                          # wszystkie 21 ograniczeń (ładunki i wyrazy wolne)
print(transform(st_cz[which.max(st_cz$X2), ], p = round(p, 3)), row.names = FALSE)
round(qchisq(1 - .05 / nrow(st_cz), 1), 2)             # próg z poprawką Bonferroniego

# Średnie czynnika (Polska = 0) w jednostkach SD czynnika w Polsce
srednie_lat <- function(m) {
  pe <- parameterEstimates(m)
  sd_pl <- sqrt(pe$est[pe$lhs == "zaufanie" & pe$op == "~~" & pe$group == 1])
  w <- pe[pe$lhs == "zaufanie" & pe$op == "~1" & pe$group > 1, ]
  data.frame(kraj = kraje[w$group], roznica = w$est / sd_pl,
             dolna = w$ci.lower / sd_pl, gorna = w$ci.upper / sd_pl)
}
# Surowe sumy: różnica średnich względem Polski / SD sumy w Polsce, 95% CI z testu Welcha
srednie_sum <- function(zm) {
  sd_pl <- sd(dane[[zm]][dane$kraj == "Polska"])
  do.call(rbind, lapply(kraje[-1], function(k) {
    t <- t.test(dane[[zm]][dane$kraj == k], dane[[zm]][dane$kraj == "Polska"])
    data.frame(kraj = k, roznica = unname(diff(rev(t$estimate))) / sd_pl,
               dolna = t$conf.int[1] / sd_pl, gorna = t$conf.int[2] / sd_pl, p = t$p.value)
  }))
}
wyn <- rbind(
  cbind(metoda = "Suma 6 pozycji", srednie_sum("suma6")[, 1:4]),
  cbind(metoda = "Suma 5 pozycji (bez z4)", srednie_sum("suma5")[, 1:4]),
  cbind(metoda = "Model skalarny (pełny)", srednie_lat(m_skal)),
  cbind(metoda = "Model częściowo skalarny", srednie_lat(m_cz)))
wyn$metoda <- factor(wyn$metoda, levels = rev(unique(wyn$metoda)))
wyn$kraj <- factor(wyn$kraj, levels = kraje[-1])
print(cbind(wyn[, 1:2], round(wyn[, 3:5], 2)), row.names = FALSE)
round(srednie_sum("suma6")$p, 4)
# Prawdziwe średnie zaufania w próbie (znane tylko w symulacji), też w SD Polski
pr <- tapply(dane$zaufanie_prawdziwe, dane$kraj, mean)
round((pr - pr[["Polska"]]) / sd(dane$zaufanie_prawdziwe[dane$kraj == "Polska"]), 2)
prawda <- data.frame(kraj = factor(kraje[-1], levels = kraje[-1]),
                     wartosc = ((pr - pr[["Polska"]]) / sd(dane$zaufanie_prawdziwe[dane$kraj == "Polska"]))[-1])

p4 <- ggplot(wyn, aes(roznica, metoda)) +
  geom_vline(xintercept = 0, colour = kol[["szary"]]) +
  geom_vline(data = prawda, aes(xintercept = wartosc), linetype = "dashed", colour = kol[["ciemny"]]) +
  geom_errorbar(aes(xmin = dolna, xmax = gorna, colour = kraj), width = 0.2, orientation = "y") +
  geom_point(aes(colour = kraj, shape = kraj), size = 3.4) +
  geom_text(aes(x = gorna, label = sub("-", "−", sprintf("%.2f", roznica))), hjust = -0.25, size = 3.6) +
  facet_wrap(~ kraj) +
  scale_x_continuous(limits = c(-0.6, 0.55), breaks = c(-0.4, -0.2, 0, 0.2, 0.4), labels = c("−0.4", "−0.2", "0", "0.2", "0.4")) +
  scale_colour_manual(values = kol[c("Czechy", "Słowacja")], guide = "none") +
  scale_shape_manual(values = c(Czechy = 17, "Słowacja" = 15), guide = "none") +
  labs(x = "Różnica względem Polski (w SD Polski) z 95% CI", y = NULL,
       title = "Ten sam kraj, cztery odpowiedzi na pytanie „czy ufają bardziej niż w Polsce?”",
       subtitle = "Linia przerywana: prawdziwa różnica zaufania w tej próbie (znana, bo dane są symulowane)") + motyw
p4   # ggsave("niezmiennosc-srednie-latentne-i-sumy.svg", p4, width = 10, height = 5)
Wynik w R
 pozycja    parametr   kraj   X2     p
      z1 wyraz wolny Czechy 6.91 0.009
[1] 9.23
                   metoda     kraj roznica dolna gorna
           Suma 6 pozycji   Czechy    0.17  0.02  0.31
           Suma 6 pozycji Słowacja   -0.16 -0.30 -0.02
  Suma 5 pozycji (bez z4)   Czechy    0.18  0.04  0.32
  Suma 5 pozycji (bez z4) Słowacja   -0.31 -0.44 -0.17
   Model skalarny (pełny)   Czechy    0.18  0.03  0.34
   Model skalarny (pełny) Słowacja   -0.22 -0.37 -0.07
 Model częściowo skalarny   Czechy    0.17  0.02  0.32
 Model częściowo skalarny Słowacja   -0.34 -0.49 -0.19
[1] 0.0221 0.0218
  Polska   Czechy Słowacja
     0.0      0.2     -0.3
5. Symulacja 1000 badań – Rysunek 5
R
# Przepis 5. Symulacja 1000 badań: fałszywa różnica sum, gdy zaufanie w krajach jest równe (Rysunek 5)
# Dane wejściowe: ladunki, wyrazy, sd_reszt, kol i motyw z przepisu 1 (bez lavaan – liczymy tylko sumy).
symuluj <- function(n, przesun, powt = 1000) {
  sapply(seq_len(powt), function(r) {
    kraj_dane <- function(nu) {                         # zaufanie ~ N(0, 1) w obu krajach
      eta <- rnorm(n)
      odp <- pmin(pmax(round(sweep(outer(eta, ladunki), 2, nu, "+") +
                               sweep(matrix(rnorm(n * 6), n), 2, sd_reszt, "*")), 1), 7)
      cbind(suma6 = rowSums(odp), suma5 = rowSums(odp[, -4]))
    }
    a <- kraj_dane(wyrazy)
    b <- kraj_dane(wyrazy + c(0, 0, 0, przesun, 0, 0))   # inny przekład z4 w drugim kraju
    c(suma6 = t.test(a[, 1], b[, 1])$p.value < .05, suma5 = t.test(a[, 2], b[, 2])$p.value < .05)
  })
}
set.seed(628)
siatka <- expand.grid(n = c(100, 200, 400, 800), przesun = c(0.5, 1.0))
wyniki <- do.call(rbind, lapply(seq_len(nrow(siatka)), function(i) {
  s <- symuluj(siatka$n[i], siatka$przesun[i])
  data.frame(n = siatka$n[i], przesun = siatka$przesun[i],
             miara = c("Suma 6 pozycji", "Suma 5 pozycji (bez z4)"), odsetek = rowMeans(s))
}))
wyniki$blad_mc <- sqrt(wyniki$odsetek * (1 - wyniki$odsetek) / 1000)   # błąd Monte Carlo odsetka
wyniki$grupa <- ifelse(wyniki$miara == "Suma 6 pozycji",
                       sprintf("Suma 6 pozycji, z4 przesunięta o %.1f", wyniki$przesun), "Suma 5 pozycji (bez z4)")
wyniki <- wyniki[!(wyniki$miara == "Suma 5 pozycji (bez z4)" & wyniki$przesun == 1.0), ]   # bez z4 przesunięcie nie gra roli
wyniki$grupa <- factor(wyniki$grupa, levels = c("Suma 6 pozycji, z4 przesunięta o 1.0",
                                                "Suma 6 pozycji, z4 przesunięta o 0.5", "Suma 5 pozycji (bez z4)"))
data.frame(wyniki[, c("grupa", "n")], proc = round(100 * wyniki$odsetek, 1), mc_pp = round(100 * wyniki$blad_mc, 1),
           row.names = NULL)

p5 <- ggplot(wyniki, aes(n, 100 * odsetek, colour = grupa, shape = grupa, linetype = grupa)) +
  geom_hline(yintercept = 5, colour = kol[["szary"]]) +
  geom_line(linewidth = 1) +
  geom_point(size = 3.2) +
  geom_text(aes(label = sprintf("%.0f%%", 100 * odsetek)), vjust = -1.2, size = 3.6, show.legend = FALSE) +
  scale_x_log10(breaks = c(100, 200, 400, 800)) +
  scale_y_continuous(limits = c(0, 105), breaks = seq(0, 100, 20), labels = function(x) paste0(x, "%")) +
  scale_colour_manual(values = unname(kol[c("akcent", "roz", "Polska")]), name = NULL) +
  scale_shape_manual(values = c(17, 15, 16), name = NULL) +
  scale_linetype_manual(values = c("solid", "dashed", "dotted"), name = NULL) +
  labs(x = "Liczba osób w każdym kraju (skala logarytmiczna)", y = "Odsetek badań z p < .05",
       title = "Zaufanie w obu krajach jest równe, a test sum „widzi” różnicę",
       subtitle = sprintf("1000 symulowanych badań w punkcie (błąd MC ≤ %.1f pp); szara linia – nominalne 5%%",
                          100 * max(wyniki$blad_mc))) +
  motyw + guides(colour = guide_legend(nrow = 2), shape = guide_legend(nrow = 2), linetype = guide_legend(nrow = 2))
p5   # ggsave("niezmiennosc-symulacja-falszywa-roznica.svg", p5, width = 10, height = 5.4)
Wynik w R
                                  grupa   n proc mc_pp
1  Suma 6 pozycji, z4 przesunięta o 0.5 100  7.7   0.8
2               Suma 5 pozycji (bez z4) 100  4.1   0.6
3  Suma 6 pozycji, z4 przesunięta o 0.5 200 13.6   1.1
4               Suma 5 pozycji (bez z4) 200  5.2   0.7
5  Suma 6 pozycji, z4 przesunięta o 0.5 400 21.6   1.3
6               Suma 5 pozycji (bez z4) 400  6.8   0.8
7  Suma 6 pozycji, z4 przesunięta o 0.5 800 35.2   1.5
8               Suma 5 pozycji (bez z4) 800  6.0   0.8
9  Suma 6 pozycji, z4 przesunięta o 1.0 100 19.3   1.2
10 Suma 6 pozycji, z4 przesunięta o 1.0 200 32.0   1.5
11 Suma 6 pozycji, z4 przesunięta o 1.0 400 57.5   1.6
12 Suma 6 pozycji, z4 przesunięta o 1.0 800 86.6   1.1
6. Kontrola palety: symulacja zaburzeń widzenia barw
R
# Przepis 6. Kontrola palety: symulacja zaburzeń widzenia barw (pakiet colorspace)
library(colorspace)
pary <- list("niebieski – pomarańczowy (Polska / Czechy)" = c("#0072B2", "#E69F00"),
             "niebieski – zielony (Polska / Słowacja)" = c("#0072B2", "#009E73"),
             "pomarańczowy – zielony (Czechy / Słowacja)" = c("#E69F00", "#009E73"),
             "cynober – szary (wyróżnienie / reszta)" = c("#D55E00", "#999999"),
             "cynober – niebieski (model odrzucony / przyjęty)" = c("#D55E00", "#0072B2"),
             "cynober – różowy (z4 przesunięta o 1.0 / o 0.5)" = c("#D55E00", "#CC79A7"),
             "różowy – niebieski (z4 o 0.5 / suma bez z4)" = c("#CC79A7", "#0072B2"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                                 widzenie_typowe deuteranopia
niebieski – pomarańczowy (Polska / Czechy)                 120.2        121.5
niebieski – zielony (Polska / Słowacja)                     70.1         55.4
pomarańczowy – zielony (Czechy / Słowacja)                  88.7         66.3
cynober – szary (wyróżnienie / reszta)                      77.2         62.9
cynober – niebieski (model odrzucony / przyjęty)           114.6        108.3
cynober – różowy (z4 przesunięta o 1.0 / o 0.5)             74.3         70.2
różowy – niebieski (z4 o 0.5 / suma bez z4)                 53.6         42.0
czerwony – zielony (do unikania)                           121.7         21.1
                                                 protanopia
niebieski – pomarańczowy (Polska / Czechy)            109.3
niebieski – zielony (Polska / Słowacja)                58.0
pomarańczowy – zielony (Czechy / Słowacja)             51.5
cynober – szary (wyróżnienie / reszta)                 56.0
cynober – niebieski (model odrzucony / przyjęty)       91.9
cynober – różowy (z4 przesunięta o 1.0 / o 0.5)        71.9
różowy – niebieski (z4 o 0.5 / suma bez z4)            22.5
czerwony – zielony (do unikania)                       31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Modele CFA, testy różnicy χ² i testy punktowe oszacowano pakietem lavaan, test t Welcha – funkcją t.test() (pakiet stats). Rysunki wykonano w ggplot2 i zapisano pakietem svglite; paletę sprawdzono w symulacji zaburzeń widzenia barw pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7-2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czy mogę porównać średnie wyniki ankiety o marce między krajami bez sprawdzania niezmienności?
Ryzykujesz, że porównasz przekład, a nie postawy. W przykładzie z trzema krajami jedna pozycja inaczej rozumiana na Słowacji sprawiła, że suma punktów pokazała zaufanie niższe od polskiego o 0.16 SD, a model częściowej niezmienności – o 0.34 SD. Porównanie średnich wymaga co najmniej częściowej niezmienności skalarnej.
Co zrobić, gdy model skalarny w wielogrupowej CFA jest źle dopasowany?
Sprawdź testy punktowe (w lavaan lavTestScore()) i uwolnij jedno ograniczenie z największą wartością χ², potem policz testy od nowa. W przykładzie po uwolnieniu wyrazu wolnego jednej pozycji w jednym kraju CFI wzrosło z .923 do .996. Średnie porównuj w modelu częściowo skalarnym i zgłoś, który parametr uwolniono i dlaczego.
Jaka różnica między niezmiennością metryczną a skalarną w badaniach marketingowych?
Metryczna oznacza równe ładunki: wolno wtedy porównywać korelacje i ścieżki, np. wpływ zaufania na lojalność w kilku krajach. Skalarna dodaje równe wyrazy wolne: dopiero wtedy wolno porównywać średnie, np. który rynek ufa marce bardziej.
Czy duża próba chroni przed błędnym porównaniem sum między krajami?
Nie, pogarsza sprawę. W symulacji 1000 badań, w których zaufanie w dwóch krajach było równe, a jedna pozycja miała w drugim kraju wyraz wolny wyższy o 1 punkt, test różnicy sum był istotny w 19.3% badań przy 100 osobach w kraju i w 86.6% przy 800 osobach.
Czy wystarczy usunąć pozycję, która działa inaczej w jednym kraju?
Czasem tak – w przykładzie suma pięciu pozycji dała różnicę −0.31 SD, blisko modelu częściowego. Ale zmieniasz wtedy narzędzie, a bez analizy niezmienności nie wiesz, którą pozycję usunąć. Lepiej zostawić pełną skalę, uwolnić parametr w modelu i porównać średnie latentne.
Powiązane hasła
Przeczytaj też
Inwariancja pomiaru krok po kroku
Wielogrupowa CFA w lavaan: model konfiguracyjny, metryczny, skalarny i ścisły, kryteria ΔCFI i ΔRMSEA, testy punktowe, częściowa inwariancja i opis APA.
Czytaj →PoradnikSatysfakcja i lojalność w PLS-SEM
Ankieta 450 kursantów szkoły językowej w modelu w stylu ECSI: diagram ścieżek, pomiar, efekty pośrednie, f² i mapa IPMA – pięć rysunków z kodem R.
Czytaj →PoradnikMapa percepcji marek
Sześć marek, 10 cech: analiza korespondencji, pułapka wielkości marki, indeksy, biplot PCA z efektem halo i bootstrap mapy – sześć rysunków z kodem R.
Czytaj →PoradnikStatystyka w pracy z marketingu
Skala postaw wobec marki, NPS z przedziałem ufności, test A/B, intencja zakupu, mediacja i segmentacja: testy, zdania APA, dane XLSX i kod R.
Czytaj →Porównujesz wyniki ankiety między krajami lub grupami?
Pomożemy sprawdzić niezmienność pomiarową w lavaan, wybrać parametry do uwolnienia, porównać średnie latentne i opisać wyniki z tabelą dopasowania – tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Baumgartner, H., & Steenkamp, J.-B. E. M. (2001). Response styles in marketing research: A cross-national investigation. Journal of Marketing Research, 38(2), 143–156. https://doi.org/10.1509/jmkr.38.2.143.18840 ● Otwarty dostęp: pełny tekst
- Byrne, B. M., Shavelson, R. J., & Muthén, B. (1989). Testing for the equivalence of factor covariance and mean structures: The issue of partial measurement invariance. Psychological Bulletin, 105(3), 456–466. https://doi.org/10.1037/0033-2909.105.3.456
- Chaudhuri, A., & Holbrook, M. B. (2001). The chain of effects from brand trust and brand affect to brand performance: The role of brand loyalty. Journal of Marketing, 65(2), 81–93. https://doi.org/10.1509/jmkg.65.2.81.18255 ● Otwarty dostęp: pełny tekst
- Chen, F. F. (2007). Sensitivity of goodness of fit indexes to lack of measurement invariance. Structural Equation Modeling: A Multidisciplinary Journal, 14(3), 464–504. https://doi.org/10.1080/10705510701301834
- Putnick, D. L., & Bornstein, M. H. (2016). Measurement invariance conventions and reporting: The state of the art and future directions for psychological research. Developmental Review, 41, 71–90. https://doi.org/10.1016/j.dr.2016.06.004 ● Otwarty dostęp: pełny tekst
- Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02 ● Otwarty dostęp
- Steenkamp, J.-B. E. M., & Baumgartner, H. (1998). Assessing measurement invariance in cross-national consumer research. Journal of Consumer Research, 25(1), 78–107. https://doi.org/10.1086/209528 ● Otwarty dostęp: pełny tekst
- Steinmetz, H. (2013). Analyzing observed composite differences across groups: Is partial measurement invariance enough? Methodology, 9(1), 1–12. https://doi.org/10.1027/1614-2241/a000049
Cytowania BibTeX
@article{baumgartner2001response, author={Baumgartner, Hans and Steenkamp, Jan-Benedict E. M.}, title={{Response styles in marketing research: A cross-national investigation}}, journal={Journal of Marketing Research}, year={2001}, volume={38}, number={2}, pages={143--156}, doi={10.1509/jmkr.38.2.143.18840}}@article{byrne1989testing, author={Byrne, Barbara M. and Shavelson, Richard J. and Muthén, Bengt}, title={{Testing for the equivalence of factor covariance and mean structures: The issue of partial measurement invariance}}, journal={Psychological Bulletin}, year={1989}, volume={105}, number={3}, pages={456--466}, doi={10.1037/0033-2909.105.3.456}}@article{chaudhuri2001chain, author={Chaudhuri, Arjun and Holbrook, Morris B.}, title={{The chain of effects from brand trust and brand affect to brand performance: The role of brand loyalty}}, journal={Journal of Marketing}, year={2001}, volume={65}, number={2}, pages={81--93}, doi={10.1509/jmkg.65.2.81.18255}}@article{chen2007sensitivity, author={Chen, Fang Fang}, title={{Sensitivity of goodness of fit indexes to lack of measurement invariance}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2007}, volume={14}, number={3}, pages={464--504}, doi={10.1080/10705510701301834}}@article{putnick2016measurement, author={Putnick, Diane L. and Bornstein, Marc H.}, title={{Measurement invariance conventions and reporting: The state of the art and future directions for psychological research}}, journal={Developmental Review}, year={2016}, volume={41}, pages={71--90}, doi={10.1016/j.dr.2016.06.004}}@article{rosseel2012lavaan, author={Rosseel, Yves}, title={{lavaan: An R package for structural equation modeling}}, journal={Journal of Statistical Software}, year={2012}, volume={48}, number={2}, pages={1--36}, doi={10.18637/jss.v048.i02}}@article{steenkamp1998assessing, author={Steenkamp, Jan-Benedict E. M. and Baumgartner, Hans}, title={{Assessing measurement invariance in cross-national consumer research}}, journal={Journal of Consumer Research}, year={1998}, volume={25}, number={1}, pages={78--107}, doi={10.1086/209528}}@article{steinmetz2013analyzing, author={Steinmetz, Holger}, title={{Analyzing observed composite differences across groups: Is partial measurement invariance enough?}}, journal={Methodology}, year={2013}, volume={9}, number={1}, pages={1--12}, doi={10.1027/1614-2241/a000049}}