Co to jest test score?
Test mnożnika Lagrange’a (ang. Lagrange multiplier test, LM), nazywany też testem score albo testem Rao, sprawdza hipotezę o parametrach modelu na podstawie samego modelu ograniczonego, czyli dopasowanego przy prawdziwej hipotezie zerowej. Opisał go Rao (1948). Pyta, jak stromo rośnie logarytm wiarygodności w punkcie H0: jeśli nachylenie (score) jest duże, uwolnienie parametru wyraźnie poprawiłoby dopasowanie.
Trzy testy z jednej wiarygodności
Test score tworzy trójkę z testem Walda i testem ilorazu wiarygodności. Wszystkie korzystają z metody największej wiarygodności i w dużych próbach mają rozkład χ² z liczbą stopni swobody równą liczbie testowanych parametrów. Różnią się tym, który model trzeba dopasować:
- Wald – tylko model pełny (oszacowanie i błąd standardowy);
- LRT – oba modele (różnica dewiancji);
- score – tylko model ograniczony.
Buse (1982) pokazuje na wykresach, że przy kwadratowym logarytmie wiarygodności trzy statystyki są identyczne. W innych przypadkach różnią się, zwłaszcza w małych próbach.
Przykład
W symulowanych danych 120 osób remisję osiągnęło 19 z 60 w grupie kontrolnej i 34 z 60 w grupie terapii. W regresji logistycznej test Walda dał χ²(1) = 7.43, p = .006, test ilorazu wiarygodności χ²(1) = 7.69, p = .006, a test score χ²(1) = 7.60, p = .006. Test score dał tu praktycznie tę samą wartość co chi-kwadrat Pearsona dla tej tabeli 2 × 2 (7.60).
Na rysunku
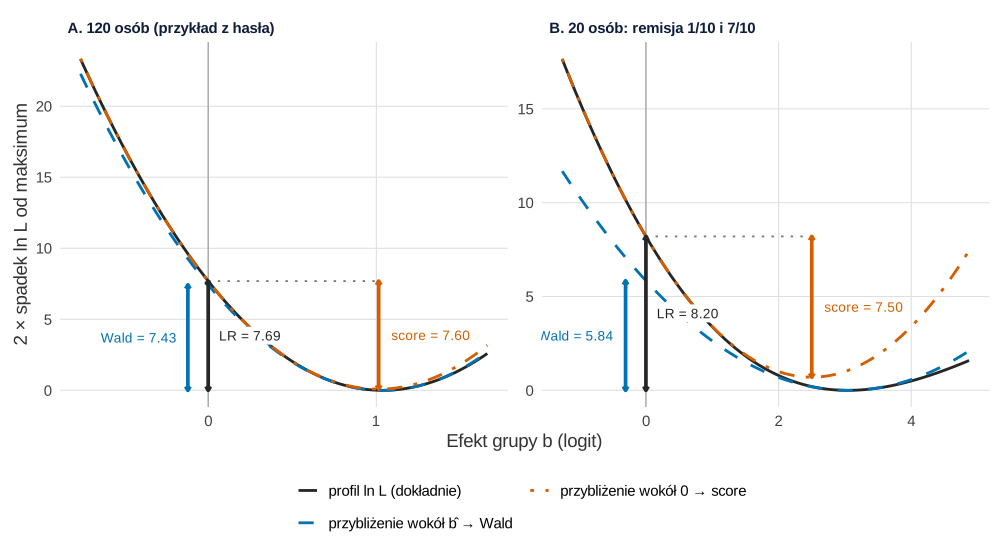
set.seed(510); panel B: tabela ułożona ręcznie).Rysunek przenosi na dane obraz, którym Buse (1982) tłumaczy trójkę testów. Czarna krzywa to profil log-wiarygodności dla efektu grupy b, narysowany jako dwukrotny spadek ln L od maksimum. W oszacowaniu b̂ krzywa ma wartość 0.
Co widać. Statystyka LR to wysokość krzywej w punkcie H0 (b = 0), czyli korzysta z obu modeli. Test Walda zna krzywą tylko w b̂: zastępuje ją parabolą o krzywiźnie 1/SE² (linia przerywana) i odczytuje jej wysokość w b = 0. Test score zna krzywą tylko w b = 0: bierze jej nachylenie i krzywiznę w tym punkcie (parabola kropkowo-kreskowana) i pyta, o ile mogłaby spaść, gdyby parametr uwolnić. W danych z przykładu (panel A) krzywa jest prawie parabolą, więc trzy liczby są bliskie: Wald 7.43, score 7.60, LR 7.69. W małej próbie (panel B: remisja u 1 z 10 i 7 z 10 osób, tabelę ułożono ręcznie, by różnica była widoczna) krzywa jest wyraźnie niesymetryczna. Wald daje wtedy 5.84, score 7.50, a LR 8.20.
Na co uważać. Różnica między testami mierzy, jak bardzo log-wiarygodność odbiega od paraboli. Nie mówi natomiast, który test ma w danej próbie poprawny błąd I rodzaju. Rysunek dotyczy jednego parametru, a przy kilku parametrach ta sama geometria działa w wielu wymiarach. Ten sam profil wykorzystuje przedział ufności z profilu wiarygodności.
Podpis do pracy:
Rysunek na stronie powstał z tego samego obiektu p z motywem serwisu (krój, siatka); dane, geometrie i skale są identyczne. Pochodne w b = 0 liczone są numerycznie; kontrolnie kod podaje też test score z anova(..., test = "Rao") dla panelu B (7.50).
Kod R rysunku 1
# Rysunek 1. Trzy testy jako trzy odległości na krzywej log-wiarygodności (profil dla efektu grupy)
library(ggplot2)

# Paleta Okabe–Ito i prosty motyw
kol <- c(krzywa = "grey15", Wald = "#0072B2", score = "#D55E00", LR = "grey15")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", hjust = 0), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA))

# Profil log-wiarygodności: dla każdego b efekt grupy jest ustalony (offset), wyraz wolny dopasowany
profil <- function(d, b) sapply(b, function(bb)
  as.numeric(logLik(glm(remisja ~ 1, offset = bb * grupa, family = binomial, data = d))))

trzy_testy <- function(d, nazwa) {
  m1 <- glm(remisja ~ grupa, family = binomial, data = d)
  b_hat <- unname(coef(m1)["grupa"]); se <- coef(summary(m1))["grupa", "Std. Error"]
  h  <- 1e-3                                              # krok pochodnych numerycznych
  l0 <- profil(d, c(-h, 0, h))                            # nachylenie (score) i krzywizna w b = 0
  U0 <- (l0[3] - l0[1]) / (2 * h); I0 <- -(l0[3] - 2 * l0[2] + l0[1]) / h^2
  lmax <- as.numeric(logLik(m1))
  siatka <- seq(-0.5 - 0.25 * b_hat, 1.6 * b_hat, length.out = 300)
  krzywe <- data.frame(b = siatka,
                       prawdziwa = 2 * (lmax - profil(d, siatka)),          # 2 × spadek ln L od maksimum
                       Wald  = (siatka - b_hat)^2 / se^2,                    # parabola wokół b z modelu pełnego
                       score = 2 * (lmax - l0[2]) - 2 * U0 * siatka + I0 * siatka^2)  # parabola wokół b = 0
  stat <- c(Wald = b_hat^2 / se^2, LR = 2 * (lmax - l0[2]), score = U0^2 / I0)
  list(krzywe = cbind(panel = nazwa, krzywe), stat = stat, b_hat = b_hat, U0 = U0, I0 = I0, panel = nazwa,
       przes = 0.05 * diff(range(siatka)))                   # odsunięcie strzałki Walda od osi b = 0
}

# A: dane z przykładu (120 osób, set.seed(510)); B: mała tabela ułożona ręcznie (1/10 i 7/10 remisji)
set.seed(510)
n <- 120
grupa <- rep(c(0, 1), each = n / 2)
remisja <- rbinom(n, 1, plogis(-0.6 + 0.8 * grupa))
A <- trzy_testy(data.frame(grupa, remisja), "A. 120 osób (przykład z hasła)")
B <- trzy_testy(data.frame(grupa = rep(0:1, each = 10), remisja = c(rep(1:0, c(1, 9)), rep(1:0, c(7, 3)))),
                "B. 20 osób: remisja 1/10 i 7/10")
round(rbind(A = c(b = A$b_hat, A$stat), B = c(b = B$b_hat, B$stat)), 2)
# kontrola: test score z anova(..., test = "Rao") dla panelu B
dB <- data.frame(grupa = rep(0:1, each = 10), remisja = c(rep(1:0, c(1, 9)), rep(1:0, c(7, 3))))
round(anova(glm(remisja ~ 1, binomial, dB), glm(remisja ~ grupa, binomial, dB), test = "Rao")$Rao[2], 2)

dl <- do.call(rbind, lapply(list(A, B), function(x)
  data.frame(panel = x$panel, b = x$krzywe$b,
             y = c(x$krzywe$prawdziwa, x$krzywe$Wald, x$krzywe$score),
             krzywa = rep(c("profil ln L (dokładnie)", "przybliżenie wokół b̂ → Wald", "przybliżenie wokół 0 → score"),
                          each = nrow(x$krzywe)))))
dl$krzywa <- factor(dl$krzywa, levels = c("profil ln L (dokładnie)", "przybliżenie wokół b̂ → Wald", "przybliżenie wokół 0 → score"))
# odcinki: LR i Wald = wysokość w b = 0; score = głębokość paraboli score poniżej jej wartości w b = 0
odc <- do.call(rbind, lapply(list(A, B), function(x) {
  bS <- x$U0 / x$I0
  data.frame(panel = x$panel, test = c("LR", "Wald", "score"),
             x = c(0, -x$przes, bS), y = c(0, 0, x$stat[["LR"]] - x$stat[["score"]]),
             yend = c(x$stat[["LR"]], x$stat[["Wald"]], x$stat[["LR"]]),
             lab = sprintf("%s = %.2f", c("LR", "Wald", "score"), x$stat[c("LR", "Wald", "score")]),
             hjust = c(-0.1, 1.1, -0.1))
}))
poziom <- subset(odc, test == "score")                   # poziom LR (wartość obu krzywych w b = 0)
p <- ggplot(dl, aes(b, y)) +
  geom_vline(xintercept = 0, colour = "grey60", linewidth = 0.4) +
  geom_segment(data = poziom, aes(x = 0, xend = x, y = yend, yend = yend), inherit.aes = FALSE,
               colour = "grey45", linetype = "dotted") +
  geom_line(aes(colour = krzywa, linetype = krzywa), linewidth = 1) +
  geom_segment(data = odc, aes(x = x, xend = x, y = y, yend = yend, colour = test), inherit.aes = FALSE,
               linewidth = 1.3, arrow = arrow(ends = "both", length = unit(0.12, "cm")), show.legend = FALSE) +
  geom_label(data = odc, aes(x = x, y = (y + yend) / 2, label = lab, hjust = hjust, colour = test),
             inherit.aes = FALSE, size = 3.6, linewidth = 0, fill = "white", show.legend = FALSE) +
  facet_wrap(~ panel, scales = "free") +
  scale_colour_manual(values = c("profil ln L (dokładnie)" = kol[["krzywa"]], "przybliżenie wokół b̂ → Wald" = kol[["Wald"]],
                                 "przybliżenie wokół 0 → score" = kol[["score"]],
                                 LR = kol[["LR"]], Wald = kol[["Wald"]], score = kol[["score"]]),
                      breaks = levels(dl$krzywa), name = NULL) +
  scale_linetype_manual(values = c("solid", "dashed", "dotdash"), name = NULL) +
  coord_cartesian(ylim = c(0, NA)) +
  guides(colour = guide_legend(nrow = 2), linetype = guide_legend(nrow = 2)) +
  labs(x = "Efekt grupy b (logit)", y = "2 × spadek ln L od maksimum") +
  motyw
p
Wynik w R
     b Wald   LR score
A 1.04 7.43 7.69   7.6
B 3.04 5.84 8.20   7.5
[1] 7.5
Jak opisać w pracy
Na co uważać
- Gdzie go spotkasz. Test score przydaje się, gdy model pełny trudno dopasować. Test Walda bywa zawodny przy dużych współczynnikach i w małych próbach (Bewick i in., 2005), a skrajnie przy separacji. Na tej samej logice opierają się indeksy modyfikacji w SEM.
- Bez nazwy. Wiele testów zna się pod innymi nazwami, a są testami score – choćby chi-kwadrat Pearsona w powyższym przykładzie. Podawaj więc, który test policzono.
- Rozbieżne wyniki. Gdy trzy testy dają różne wnioski, próba jest za mała na przybliżenie χ²; nie wybieraj testu z najmniejszym p.
Wald, LRT i test score w R
Kod symuluje remisję w dwóch grupach po 60 osób, dopasowuje regresję logistyczną i liczy trzy testy dla predyktora grupy. Test score daje anova(..., test = "Rao") dla obiektów glm (dokumentacja anova.glm opisuje go jako Rao’s efficient score test).
Trzy testy dla jednego predyktora
R
set.seed(510)
n <- 120
grupa <- rep(c(0, 1), each = n / 2)                   # 0 = kontrola, 1 = terapia
remisja <- rbinom(n, 1, plogis(-0.6 + 0.8 * grupa))
m0 <- glm(remisja ~ 1, family = binomial)             # model bez predyktora
m1 <- glm(remisja ~ grupa, family = binomial)
table(grupa, remisja)
z <- coef(summary(m1))["grupa", "z value"]
c(wald = z^2, p = 2 * pnorm(-abs(z)))                 # test Walda (model z predyktorem)
anova(m0, m1, test = "LRT")                           # test ilorazu wiarygodności (oba modele)
anova(m0, m1, test = "Rao")                           # test score (wystarczy model zerowy)
chisq.test(table(grupa, remisja), correct = FALSE)    # chi-kwadrat Pearsona dla tej tabeli
Wynik w R
     remisja
grupa  0  1
    0 41 19
    1 26 34
       wald           p
7.427393037 0.006423834
Analysis of Deviance Table

Model 1: remisja ~ 1
Model 2: remisja ~ grupa
  Resid. Df Resid. Dev Df Deviance Pr(>Chi)
1       119     164.72
2       118     157.03  1   7.6907 0.005551 **
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
Analysis of Deviance Table

Model 1: remisja ~ 1
Model 2: remisja ~ grupa
  Resid. Df Resid. Dev Df Deviance    Rao Pr(>Chi)
1       119     164.72
2       118     157.03  1   7.6907 7.6036 0.005825 **
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

	Pearson's Chi-squared test

data:  table(grupa, remisja)
X-squared = 7.6035, df = 1, p-value = 0.005826
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (testy – bez dodatkowych pakietów). Rysunek 1 wykonano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze pytania
Dlaczego test score wymaga dopasowania tylko jednego modelu?
Mierzy nachylenie logarytmu wiarygodności w modelu ograniczonym przez H₀. Nie trzeba więc szacować modelu pełnego – wystarczy sprawdzić, czy uwolnienie parametru wyraźnie poprawiłoby dopasowanie.
Który z testów Walda, LRT i score wybrać?
W dużych próbach dają podobne wyniki. LRT jest zwykle domyślnym wyborem, test score – gdy model pełny trudno dopasować. Wybierz test przed analizą, nie według najmniejszego p.
Jak policzyć test score w R?
Dla modeli glm porównaj model ograniczony z pełnym: anova(m0, m1, test = "Rao"). W przykładzie dla 120 osób dało to χ²(1) = 7.60, p = .006.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Bewick, V., Cheek, L., & Ball, J. (2005). Statistics review 14: Logistic regression. Critical Care, 9(1), 112–118. https://doi.org/10.1186/cc3045 ● Otwarty dostęp
- Buse, A. (1982). The likelihood ratio, Wald, and Lagrange multiplier tests: An expository note. The American Statistician, 36(3a), 153–157. https://doi.org/10.1080/00031305.1982.10482817
- Rao, C. R. (1948). Large sample tests of statistical hypotheses concerning several parameters with applications to problems of estimation. Mathematical Proceedings of the Cambridge Philosophical Society, 44(1), 50–57. https://doi.org/10.1017/s0305004100023987
Cytowania BibTeX
@article{bewick2005statistics, author={Bewick, Viv and Cheek, Liz and Ball, Jonathan}, title={{Statistics review 14: Logistic regression}}, journal={Critical Care}, year={2005}, volume={9}, number={1}, pages={112--118}, doi={10.1186/cc3045}}@article{buse1982likelihood, author={Buse, A.}, title={{The likelihood ratio, Wald, and Lagrange multiplier tests: An expository note}}, journal={The American Statistician}, year={1982}, volume={36}, number={3a}, pages={153--157}, doi={10.1080/00031305.1982.10482817}}@article{rao1948large, author={Rao, C. Radhakrishna}, title={{Large sample tests of statistical hypotheses concerning several parameters with applications to problems of estimation}}, journal={Mathematical Proceedings of the Cambridge Philosophical Society}, year={1948}, volume={44}, number={1}, pages={50--57}, doi={10.1017/s0305004100023987}}