Co to jest przedział z profilu wiarygodności?
Przedział ufności z profilu wiarygodności (ang. profile likelihood confidence interval) to przedział ufności wyznaczany wprost z funkcji wiarygodności, a nie ze wzoru oszacowanie ± 1.96·SE. Interesujący parametr β ustala się na kolejnych wartościach, a pozostałe parametry modelu za każdym razem szacuje się od nowa metodą największej wiarygodności. Tak powstaje profil log-wiarygodności ℓp(β). 95% przedział obejmuje wartości β, dla których spadek log-wiarygodności od maksimum jest mały:
Jest to więc odwrócenie testu ilorazu wiarygodności, tak jak przedział Walda jest odwróceniem testu Walda. Venzon i Moolgavkar (1988) opisali metodę obliczania takich granic w modelach z wieloma parametrami.
Po co, skoro jest przedział Walda?
Przedział Walda zakłada, że log-wiarygodność wokół maksimum ma kształt paraboli, więc na skali współczynnika jest zawsze symetryczny. W małych próbach, przy rzadkich zdarzeniach i dużych efektach to przybliżenie zawodzi. Profil podąża za rzeczywistym kształtem funkcji wiarygodności, dlatego bywa asymetryczny. Nie zależy też od parametryzacji: granice dla β po przeliczeniu exp() są dokładnie granicami dla ilorazu szans. Cole, Chu i Greenland (2014) omawiają profil wiarygodności jako jedno z praktycznych rozszerzeń metody największej wiarygodności.
Przykład
W symulowanych danych 50 osób zdarzenie wystąpiło u 3 z 26 nienarażonych i u 12 z 24 narażonych. Regresja logistyczna dała OR = 7.67. Przedział Walda to [1.81, 32.52], a przedział z profilu wiarygodności – [1.99, 38.70]. Jest przesunięty w górę, bo wiarygodność opada wolniej w stronę dużych efektów. Na obu granicach profilu podwojony spadek log-wiarygodności wynosi dokładnie 3.84.
Na rysunku
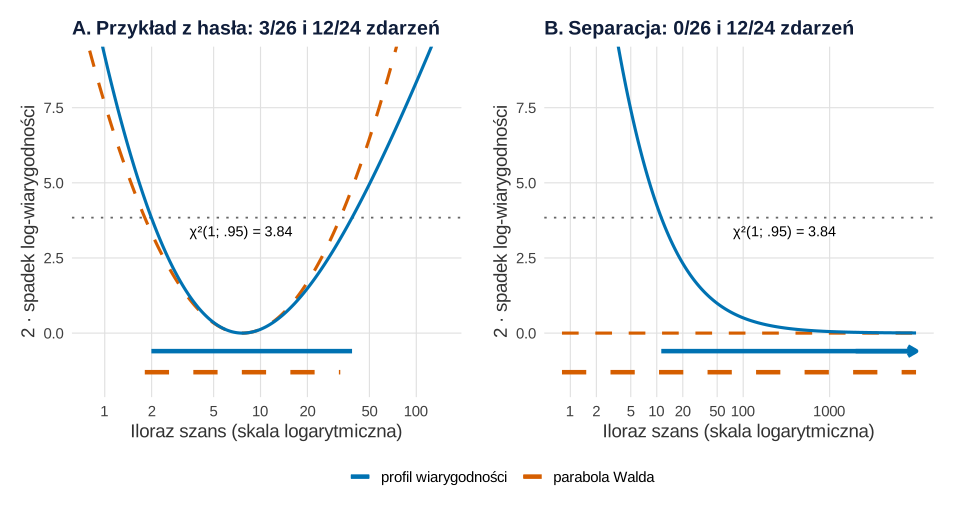
Co widać. Przedział to te wartości OR, przy których krzywa leży pod linią 3.84. W panelu A parabola Walda jest symetryczna na skali logarytmu OR, a profil w prawo rośnie wolniej. Dlatego górna granica profilu (38.69) leży dalej niż Walda (32.52), a dolna niewiele się różni (1.99 wobec 1.81). confint() podaje 1.99 i 38.70 – różnica 0.01 bierze się z interpolacji profilu w tej funkcji. W panelu B grupa nienarażona nie ma zdarzeń. Profil opada w prawo, ale nigdy nie dochodzi do zera (przy OR = 10 000 brakuje 0.01), więc przedział ma tylko dolną granicę: OR ≥ 11.28. glm() podaje wtedy b = 19.57 przy SE = 2109, a przedział Walda obejmuje całą oś i niczego nie mówi.
Na co uważać. Krzywe opierają się na przybliżeniu χ²; przy bardzo małych liczebnościach także profil może mieć pokrycie inne niż 95%. Tablicę w panelu B (0/26 i 12/24) ustawiono ręcznie, przesuwając 3 zdarzenia z przykładu. Separację w regresji logistycznej szerzej pokazuje wpis Regresja logistyczna w obrazkach. Ten sam profil przeliczony na p = P(χ²1 > spadek) daje funkcję wartości p – przedziały na wszystkich poziomach ufności naraz.
Podpis do pracy:
Kod R rysunków
# Rysunek 1: profil wiarygodności a parabola Walda dla ilorazu szans; profil przy separacji
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c("profil wiarygodności" = "#0072B2", "parabola Walda" = "#D55E00")
motyw <- theme_minimal(base_size = 14) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(0.95)),
        plot.background = element_rect(fill = "white", colour = NA))
chi <- qchisq(0.95, 1)                                  # 3.84

# Panel A: dane z przykładu w haśle (te same co w kodzie hasła)
set.seed(601)
n <- 50
x <- rbinom(n, 1, 0.5)
y <- rbinom(n, 1, plogis(-2 + 2 * x))
m <- glm(y ~ x, family = binomial)
b <- unname(coef(m)["x"]); se <- sqrt(vcov(m)["x", "x"])
# profil: przy ustalonym b0 wyraz wolny a szacujemy od nowa (minimum dewiancji po a)
dev_prof <- function(b0, x, y, dmin) {
  dev_a <- function(a) -2 * sum(dbinom(y, 1, plogis(a + b0 * x), log = TRUE))
  optimize(dev_a, c(-40, 10), tol = 1e-10)$objective - dmin
}
siatka <- seq(log(0.8), log(150), length.out = 200)
dA <- rbind(data.frame(b = siatka, d = sapply(siatka, dev_prof, x = x, y = y, dmin = deviance(m)),
                       krzywa = "profil wiarygodności"),
            data.frame(b = siatka, d = ((siatka - b) / se)^2, krzywa = "parabola Walda"))
prof <- sapply(c(-1, 1), function(s) uniroot(function(b0) dev_prof(b0, x, y, deviance(m)) - chi,
                                               sort(c(b, b + s * 6 * se)), tol = 1e-10)$root)
wald <- b + c(-1, 1) * qnorm(0.975) * se
round(exp(rbind(OR = c(b, b), Wald = wald, profil = prof, profil_confint = suppressMessages(confint(m))["x", ])), 2)
przedz <- data.frame(krzywa = names(kol), lo = exp(c(prof[1], wald[1])), hi = exp(c(prof[2], wald[2])),
                     yy = c(-0.6, -1.3))
rysuj <- function(d, przedz, tytul, x_etyk) {
  ggplot(d, aes(exp(b), d, colour = krzywa, linetype = krzywa)) +
    geom_hline(yintercept = chi, colour = "grey40", linetype = "dotted") +
    annotate("text", x = x_etyk, y = chi - 0.45, size = 3.8, label = "χ²(1; .95) = 3.84") +
    geom_line(linewidth = 1.1) +
    geom_segment(data = przedz, aes(x = lo, xend = hi, y = yy, yend = yy), linewidth = 1.6) +
    scale_colour_manual(values = kol, limits = names(kol), name = NULL) +
    scale_linetype_manual(values = c("profil wiarygodności" = "solid", "parabola Walda" = "dashed"),
                          limits = names(kol), name = NULL) +
    scale_x_log10(breaks = c(1, 2, 5, 10, 20, 50, 100, 1000)) +
    coord_cartesian(ylim = c(-1.6, 9)) +
    labs(title = tytul, x = "Iloraz szans (skala logarytmiczna)", y = "2 · spadek log-wiarygodności") + motyw
}
pA <- rysuj(dA, przedz, "A. Przykład z hasła: 3/26 i 12/24 zdarzeń", x_etyk = 7.5)

# Panel B: separacja – w grupie nienarażonej 0 zdarzeń (tablica ustawiona ręcznie: 0/26 i 12/24)
xs <- rep(0:1, c(26, 24)); ys <- c(rep(0, 26), rep(1, 12), rep(0, 12))
p_gr <- ave(ys, xs)                                     # odsetki w grupach = granica wiarygodności dla OR → ∞
dmin <- -2 * sum(ifelse(ys == 1, log(p_gr), ifelse(p_gr < 1, log(1 - p_gr), 0)))
ms <- suppressWarnings(glm(ys ~ xs, family = binomial))
siatkaB <- seq(log(0.8), log(1e4), length.out = 200)
bs <- unname(coef(ms)["xs"]); ses <- sqrt(vcov(ms)["xs", "xs"])   # glm: ogromne b i SE
dB <- rbind(data.frame(b = siatkaB, d = sapply(siatkaB, dev_prof, x = xs, y = ys, dmin = dmin),
                       krzywa = "profil wiarygodności"),
            data.frame(b = siatkaB, d = ((siatkaB - bs) / ses)^2, krzywa = "parabola Walda"))
dolnaB <- uniroot(function(b0) dev_prof(b0, xs, ys, dmin) - chi, c(0, 10), tol = 1e-10)$root
round(c(b_glm = bs, SE_glm = ses, Wald_dolna_b = bs - qnorm(0.975) * ses, Wald_gorna_b = bs + qnorm(0.975) * ses,
        OR_dolna_profil = exp(dolnaB), spadek_przy_OR_1e4 = dev_prof(log(1e4), xs, ys, dmin)), 2)
# przedział Walda obejmuje całą oś, profilowy nie ma górnej granicy (strzałka)
przedzB <- data.frame(krzywa = names(kol), lo = c(exp(dolnaB), 0.8), hi = c(1e4, 1e4), yy = c(-0.6, -1.3))
pB <- rysuj(dB, przedzB, "B. Separacja: 0/26 i 12/24 zdarzeń", x_etyk = 300) +
  annotate("segment", x = 2000, xend = 1e4, y = -0.6, yend = -0.6, colour = kol[[1]], linewidth = 1.6,
           arrow = arrow(length = unit(0.25, "cm")))
p1 <- pA + pB + plot_layout(guides = "collect") & theme(legend.position = "bottom")

p1   # zapis: ggsave("przedzial-z-profilu-wiarygodnosci-profil.svg", p1, width = 10, height = 5.4)
Wynik w R
               2.5 % 97.5 %
OR              7.67   7.67
Wald            1.81  32.52
profil          1.99  38.69
profil_confint  1.99  38.70
             b_glm             SE_glm       Wald_dolna_b       Wald_gorna_b
             19.57            2109.04           -4114.07            4153.20
   OR_dolna_profil spadek_przy_OR_1e4
             11.28               0.01
Rysunki na stronie powstały z tego kodu z motywem serwisu (dane, geometrie i skale identyczne).
Na co uważać
- Separacja. Gdy w jednej z grup nie ma zdarzeń, wiarygodność nie ma skończonego maksimum (separacja), a profil nie ma jednej z granic. Heinze i Schemper (2002) wskazują, że w regresji Firtha przedziały z profilu karanej wiarygodności są często lepsze od przedziałów Walda.
- Nazwij metodę. Wiele programów domyślnie podaje przedział Walda. W R
confint()dla modeluglmliczy profil, aconfint.default()– przedział Walda. W pracy napisz, który przedział raportujesz. - To nadal przybliżenie. Profil też korzysta z rozkładu χ², tylko zwykle trafniej niż wzór Walda. Przy dużych próbach oba przedziały są niemal takie same.
Profil wiarygodności w R
Kod symuluje 50 osób, dopasowuje regresję logistyczną i porównuje 95% przedział Walda (confint.default()) z przedziałem z profilu wiarygodności (confint()). Na końcu ręcznie sprawdza, że na granicach profilu dewiancja rośnie o 3.84. Liczby w tekście pochodzą z tego kodu.
Przedział Walda a przedział z profilu
R
set.seed(601)                                      # 50 osób; rzadkie zdarzenie, silny predyktor
n <- 50
x <- rbinom(n, 1, 0.5)                             # ekspozycja 0/1
y <- rbinom(n, 1, plogis(-2 + 2 * x))              # prawdziwy OR = exp(2) ≈ 7.4
table(x, y)
m <- glm(y ~ x, family = binomial)
wald <- confint.default(m)["x", ]                  # b ± 1.96·SE
prof <- suppressMessages(confint(m))["x", ]        # profil wiarygodności
tab <- exp(rbind(OR = rep(coef(m)["x"], 2), Wald = wald, profil = prof))
colnames(tab) <- c("dolna", "gorna"); round(tab, 2)
# sprawdzenie ręczne: przy b ustalonym na granicy (offset) dewiancja rośnie o 3.84
dev_prof <- function(b) deviance(glm(y ~ 1, offset = b * x, family = binomial)) - deviance(m)
round(c(dolna = dev_prof(prof[1]), gorna = dev_prof(prof[2]), chi2_95 = qchisq(0.95, 1)), 2)
Wynik w R
   y
x    0  1
  0 23  3
  1 12 12
       dolna gorna
OR      7.67  7.67
Wald    1.81 32.52
profil  1.99 38.70
  dolna   gorna chi2_95
   3.84    3.84    3.84
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek wykonano w pakiecie ggplot2, panele połączono pakietem patchwork, a plik zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czym przedział z profilu wiarygodności różni się od przedziału Walda?
Przedział Walda to b ± 1.96·SE i zawsze jest symetryczny na skali współczynnika. Przedział profilowy powstaje z odwrócenia testu ilorazu wiarygodności i podąża za kształtem funkcji wiarygodności, więc może być asymetryczny – w przykładzie [1.81, 32.52] wobec [1.99, 38.70].
Jak policzyć przedział z profilu wiarygodności w R?
Dla modelu glm wystarczy confint(model) – R wyświetla wtedy komunikat o profilowaniu. Funkcja confint.default(model) daje przedział Walda. Granice dla ilorazu szans otrzymasz, przeliczając obie granice przez exp().
Kiedy przedział profilowy i przedział Walda dają różne wyniki?
Głównie w małych próbach, przy rzadkich zdarzeniach i dużych efektach. Przy separacji przedział Walda bywa absurdalnie szeroki, a profil nie ma jednej z granic – wtedy pomaga regresja Firtha z profilem karanej wiarygodności. Przy dużych próbach oba przedziały są niemal takie same.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Cole, S. R., Chu, H., & Greenland, S. (2014). Maximum likelihood, profile likelihood, and penalized likelihood: A primer. American Journal of Epidemiology, 179(2), 252–260. https://doi.org/10.1093/aje/kwt245 ● Otwarty dostęp
- Heinze, G., & Schemper, M. (2002). A solution to the problem of separation in logistic regression. Statistics in Medicine, 21(16), 2409–2419. https://doi.org/10.1002/sim.1047
- Venzon, D. J., & Moolgavkar, S. H. (1988). A method for computing profile-likelihood-based confidence intervals. Applied Statistics, 37(1), 87–94. https://doi.org/10.2307/2347496
Cytowania BibTeX
@article{cole2014maximum, author={Cole, Stephen R. and Chu, Haitao and Greenland, Sander}, title={{Maximum likelihood, profile likelihood, and penalized likelihood: A primer}}, journal={American Journal of Epidemiology}, year={2014}, volume={179}, number={2}, pages={252--260}, doi={10.1093/aje/kwt245}}@article{heinze2002solution, author={Heinze, Georg and Schemper, Michael}, title={{A solution to the problem of separation in logistic regression}}, journal={Statistics in Medicine}, year={2002}, volume={21}, number={16}, pages={2409--2419}, doi={10.1002/sim.1047}}@article{venzon1988method, author={Venzon, D. J. and Moolgavkar, S. H.}, title={{A method for computing profile-likelihood-based confidence intervals}}, journal={Applied Statistics}, year={1988}, volume={37}, number={1}, pages={87--94}, doi={10.2307/2347496}}