Co to jest funkcja wartości p?
Funkcja wartości p (ang. p-value function; jej wykres nazywa się też wykresem konfluencji albo krzywą ufności) pokazuje wartość p nie dla jednej hipotezy zerowej, lecz dla każdej możliwej wartości parametru, np. różnicy średnich. Na osi poziomej leży testowana wartość, na pionowej – dwustronne p. Infanger i Schmidt-Trucksäss (2019) zwracają uwagę, że jedna krzywa zawiera oszacowanie punktowe, granice przedziałów ufności na każdym poziomie i wartości p dla hipotez zerowych i niezerowych.
Jak czytać wykres
- Szczyt (p = 1) leży w oszacowaniu punktowym.
- Wysokość krzywej nad zerem to zwykła wartość p z testu.
- Poziomy przekrój na wysokości p = .05 wyznacza 95% przedział ufności, na .20 – 80%, na .50 – 50%. Prawa oś może pokazywać od razu poziom ufności (1 − p).
- Szerokość krzywej to precyzja: im węższa, tym mniejszy błąd standardowy.
- Wartość przeciwzerowa (ang. counternull) leży po drugiej stronie szczytu na tej samej wysokości co zero – dane są z nią tak samo zgodne jak z brakiem efektu.
Przykład
Symulowano badanie z dwiema grupami po 40 osób (trening i kontrola), wynik dobrostanu na skali o SD = 10, prawdziwa różnica 5 punktów (parametry ustawione ręcznie, ziarno 764). Test t dla prób niezależnych dał różnicę 6.03 punktu, t(78) = 2.81, p = .006. Przedziały: 50% CI [4.58, 7.48], 80% CI [3.26, 8.80], 95% CI [1.76, 10.30]. Dla hipotezy „różnica = 5 punktów” p = .632, a dla wartości przeciwzerowej (12.06 punktu) – tyle samo co dla zera, p = .006.
Do drugiego panelu wzięto dwa fikcyjne badania o statystykach dobranych ręcznie tak, by miały tę samą statystykę t: małe (25 + 25 osób, różnica 6.0 punktu, p = .039, 95% CI [0.31, 11.69]) i duże (400 + 400 osób, różnica 1.5 punktu, p = .034, 95% CI [0.11, 2.89]).
Na rysunku
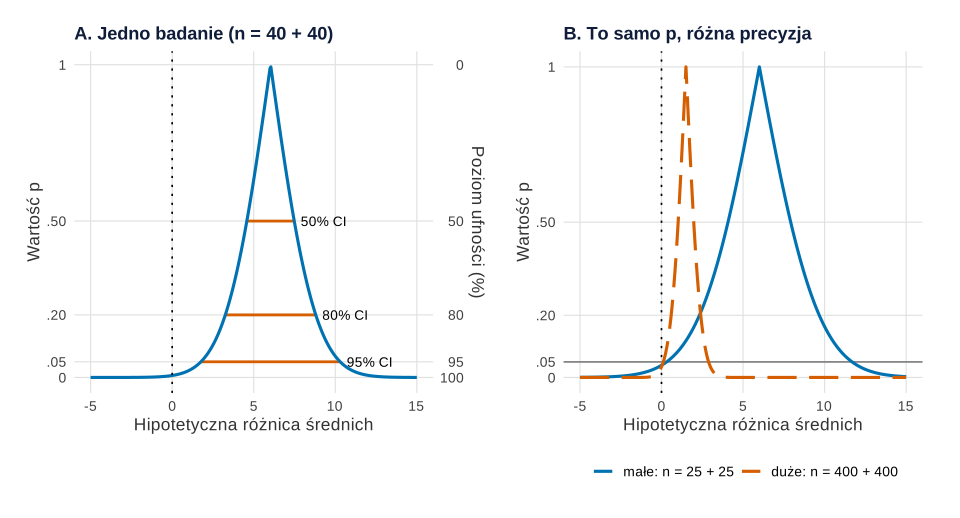
set.seed(764), i fikcyjne statystyki).Co widać. W panelu A trzy przedziały ufności to trzy przekroje tej samej krzywej, zagnieżdżone jeden w drugim – nie trzeba wybierać jednego poziomu. Linia kropkowana przy zerze przecina krzywą nisko, a wartości z 50% przedziału (4.58–7.48 punktu) leżą blisko szczytu. W panelu B obie krzywe przecinają zero prawie na tej samej wysokości, a mówią co innego: małe badanie jest zgodne z różnicami od 0.31 do 11.69 punktu, duże – tylko od 0.11 do 2.89. Samo p tych badań nie odróżnia.
Na co uważać. Wysokość krzywej to nie prawdopodobieństwo, że dana wartość jest prawdziwa (Greenland i in., 2016). Krzywa opiera się na całym modelu: Rafi i Greenland (2020) proponują czytać p jako miarę zgodności danych z hipotezą razem z wszystkimi założeniami analizy. Jeśli dane wybrano selektywnie albo założenia testu nie są spełnione, cała krzywa jest przesunięta lub zbyt wąska.
Podpis do pracy:
Jak opisać w pracy
Podaj zwykły wynik testu, a funkcję wartości p potraktuj jako rozwinięcie estymacji przedziałowej. Dodaj p dla wartości ważnej praktycznie, nie tylko dla zera.
Na co uważać
Nie wybieraj poziomu przedziału po obejrzeniu wyniku – zaletą wykresu jest to, że pokazuje wszystkie naraz. Nie traktuj p dla zera jako jedynej informacji: Rafi i Greenland (2020) zalecają liczyć p także dla hipotez alternatywnych, np. dla najmniejszego efektu, który ma znaczenie (to samo pytanie zadaje test równoważności TOST). Wynik nieistotny przy szerokiej krzywej oznacza mało informacji, a nie brak efektu – zamiast „mocy post hoc” pokaż przedział lub całą krzywą, jak we wpisie moc po fakcie – co podać zamiast.
Funkcja wartości p w R
Funkcja wartości p dla testu t to jedna linijka: 2 * pt(-abs((roznica - delta) / se), df) dla siatki wartości delta. Kod sprawdza, że przekroje krzywej to te same granice, które daje t.test() z argumentem conf.level. Rysunek na stronie powstał z obiektu p1 z motywem serwisu (krój, siatka); dane, geometrie i skale są identyczne.
Krzywa wartości p, przedziały i dwa badania o tym samym t
R
# Funkcja wartości p (wykres konfluencji) dla różnicy dwóch średnich
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
kol <- c(krzywa = "#0072B2", przedzial = "#D55E00")   # Okabe–Ito; badania różnią się też rodzajem linii
motyw <- theme_minimal(base_size = 13) + theme(panel.grid.minor = element_blank(), legend.position = "bottom")
# p dla każdej hipotezy H0: różnica = delta (test t, dwustronnie)
funkcja_p <- function(delta, roznica, se, df) 2 * pt(-abs((roznica - delta) / se), df)
# A. Jedno badanie: dobrostan po treningu vs kontrola, n = 40 w grupie
set.seed(764)
kontrola <- rnorm(40, mean = 50, sd = 10)
trening <- rnorm(40, mean = 55, sd = 10)
tt <- t.test(trening, kontrola, var.equal = TRUE)
roznica <- unname(diff(rev(tt$estimate))); se <- unname(tt$stderr); df <- unname(tt$parameter)
poziomy <- c(0.50, 0.80, 0.95)
ci <- t(sapply(poziomy, function(cl) t.test(trening, kontrola, var.equal = TRUE, conf.level = cl)$conf.int))
ci <- data.frame(poziom = poziomy, p = 1 - poziomy, dolna = ci[, 1], gorna = ci[, 2],
                 etykieta = paste0(poziomy * 100, "% CI"))
siatka <- data.frame(delta = seq(-5, 15, by = 0.05))
siatka$p <- funkcja_p(siatka$delta, roznica, se, df)
pA <- ggplot(siatka, aes(delta, p)) +
  geom_segment(data = ci, aes(x = dolna, xend = gorna, y = p, yend = p), colour = kol[["przedzial"]], linewidth = 1) +
  geom_text(data = ci, aes(x = gorna + 0.4, y = p, label = etykieta), hjust = 0, size = 3.6) +
  geom_line(colour = kol[["krzywa"]], linewidth = 1.1) + geom_vline(xintercept = 0, linetype = "dotted") +
  scale_y_continuous(breaks = c(0, 0.05, 0.2, 0.5, 1), labels = c("0", ".05", ".20", ".50", "1"),
                     sec.axis = sec_axis(~ (1 - .) * 100, name = "Poziom ufności (%)", breaks = c(0, 50, 80, 95, 100))) +
  labs(title = "A. Jedno badanie (n = 40 + 40)", x = "Hipotetyczna różnica średnich", y = "Wartość p")
# B. Dwa badania o (prawie) tym samym p dla H0: 0, ale różnej precyzji (SD = 10 w obu)
dwa <- data.frame(badanie = c("małe: n = 25 + 25", "duże: n = 400 + 400"), n = c(25, 400), roznica = c(6, 1.5))
dwa$se <- 10 * sqrt(2 / dwa$n); dwa$df <- 2 * dwa$n - 2
krzywe <- do.call(rbind, lapply(1:2, function(i) data.frame(badanie = dwa$badanie[i], delta = siatka$delta,
  p = funkcja_p(siatka$delta, dwa$roznica[i], dwa$se[i], dwa$df[i]))))
krzywe$badanie <- factor(krzywe$badanie, levels = dwa$badanie)
pB <- ggplot(krzywe, aes(delta, p, colour = badanie, linetype = badanie)) +
  geom_hline(yintercept = 0.05, colour = "grey50") + geom_vline(xintercept = 0, linetype = "dotted") +
  geom_line(linewidth = 1.1) + scale_colour_manual(values = unname(kol), name = NULL) +
  scale_linetype_manual(values = c("solid", "longdash"), name = NULL) +
  scale_y_continuous(breaks = c(0, 0.05, 0.2, 0.5, 1), labels = c("0", ".05", ".20", ".50", "1")) +
  labs(title = "B. To samo p, różna precyzja", x = "Hipotetyczna różnica średnich", y = "Wartość p")
p1 <- (pA + pB) & motyw
round(c(roznica = roznica, se = se, df = df, t = unname(tt$statistic), p = tt$p.value), 3)
ci[, 1:4] <- round(ci[, 1:4], 2); print(ci[, c("etykieta", "dolna", "gorna")], row.names = FALSE)
przeciwzerowa <- 2 * roznica                    # wartość z tym samym p co zero, po drugiej stronie szczytu
round(c(p_dla_0 = funkcja_p(0, roznica, se, df), p_dla_5 = funkcja_p(5, roznica, se, df),
        przeciwzerowa = przeciwzerowa, p_dla_przeciwzerowej = funkcja_p(przeciwzerowa, roznica, se, df)), 3)
dwa$t <- dwa$roznica / dwa$se; dwa$p <- funkcja_p(0, dwa$roznica, dwa$se, dwa$df)
dwa$dolna95 <- dwa$roznica - qt(0.975, dwa$df) * dwa$se; dwa$gorna95 <- dwa$roznica + qt(0.975, dwa$df) * dwa$se
print(cbind(dwa[, c("badanie", "roznica")], round(dwa[, c("se", "t", "p", "dolna95", "gorna95")], 3)), row.names = FALSE)
p1
Wynik w R
roznica      se      df       t       p
  6.031   2.145  78.000   2.811   0.006
 etykieta dolna gorna
   50% CI  4.58  7.48
   80% CI  3.26  8.80
   95% CI  1.76 10.30
             p_dla_0              p_dla_5        przeciwzerowa
               0.006                0.632               12.062
p_dla_przeciwzerowej
               0.006
             badanie roznica    se     t     p dolna95 gorna95
   małe: n = 25 + 25     6.0 2.828 2.121 0.039   0.313  11.687
 duże: n = 400 + 400     1.5 0.707 2.121 0.034   0.112   2.888
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje bazowe t.test(), pt(), qt(); rysunek – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Co pokazuje funkcja wartości p?
Wartość p dla każdej możliwej hipotezy o parametrze, np. dla różnicy średnich równej 0, 2, 5 czy 10 punktów. Szczyt krzywej leży w oszacowaniu punktowym, a wysokość krzywej nad zerem to zwykłe p z testu.
Jak odczytać przedział ufności z funkcji wartości p?
Poprowadź poziomą linię na wysokości p = α. Punkty, w których przecina krzywą, to granice przedziału ufności (1 − α)·100%: na wysokości .05 – 95% CI, na .20 – 80% CI, na .50 – 50% CI.
Czy dwa badania z tym samym p dają te same wnioski?
Nie. Badanie małe z dużą różnicą i badanie duże z małą różnicą mogą mieć prawie to samo p, ale ich funkcje wartości p mają inną szerokość i inny szczyt – zgodne z danymi są zupełnie inne wielkości efektu.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Moc po fakcie – co podać zamiast
Dlaczego moc post hoc to inny zapis p, co zrobić z kolumną Observed Power w SPSS i co podać zamiast: przedział ufności, analizę wrażliwości i odpowiedź dla promotora – z R.
Czytaj →PoradnikKalkulator wartości p
Dokładne p z z, t, χ², F i r, jedno- i dwustronnie, z wartością krytyczną dla α, przykładem w R i gotowym zapisem APA.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Greenland, S., Senn, S. J., Rothman, K. J., Carlin, J. B., Poole, C., Goodman, S. N., & Altman, D. G. (2016). Statistical tests, P values, confidence intervals, and power: A guide to misinterpretations. European Journal of Epidemiology, 31(4), 337–350. https://doi.org/10.1007/s10654-016-0149-3 ● Otwarty dostęp
- Infanger, D., & Schmidt-Trucksäss, A. (2019). P value functions: An underused method to present research results and to promote quantitative reasoning. Statistics in Medicine, 38(21), 4189–4197. https://doi.org/10.1002/sim.8293
- Rafi, Z., & Greenland, S. (2020). Semantic and cognitive tools to aid statistical science: Replace confidence and significance by compatibility and surprise. BMC Medical Research Methodology, 20(1), Article 244. https://doi.org/10.1186/s12874-020-01105-9 ● Otwarty dostęp
Cytowania BibTeX
@article{greenland2016statistical, author={Greenland, Sander and Senn, Stephen J. and Rothman, Kenneth J. and Carlin, John B. and Poole, Charles and Goodman, Steven N. and Altman, Douglas G.}, title={{Statistical tests, P values, confidence intervals, and power: A guide to misinterpretations}}, journal={European Journal of Epidemiology}, year={2016}, volume={31}, number={4}, pages={337--350}, doi={10.1007/s10654-016-0149-3}}@article{infanger2019p, author={Infanger, Denis and Schmidt-Trucksäss, Arno}, title={{P value functions: An underused method to present research results and to promote quantitative reasoning}}, journal={Statistics in Medicine}, year={2019}, volume={38}, number={21}, pages={4189--4197}, doi={10.1002/sim.8293}}@article{rafi2020semantic, author={Rafi, Zad and Greenland, Sander}, title={{Semantic and cognitive tools to aid statistical science: Replace confidence and significance by compatibility and surprise}}, journal={BMC Medical Research Methodology}, year={2020}, volume={20}, number={1}, eid={244}, doi={10.1186/s12874-020-01105-9}}