Co to jest bootstrap parametryczny?
Bootstrap parametryczny (ang. parametric bootstrap) to odmiana bootstrapu, w której nowe próby nie powstają przez losowanie obserwacji ze zwracaniem, tylko są symulowane z dopasowanego modelu. Najpierw szacuje się parametry modelu, zwykle metodą największej wiarygodności. Potem generuje się B zbiorów danych z rozkładu o tych parametrach i w każdym liczy statystykę od nowa. Davison i Hinkley (1997) odróżniają podejście parametryczne, gdy model z parametrami w pełni określa rozkład danych, od nieparametrycznego, które zakłada tylko niezależność obserwacji i ten sam rozkład.
Do czego służy?
- Testy, gdy rozkład statystyki jest nieznany. Dane symuluje się z modelu zgodnego z H0, a wartość p to odsetek symulowanych statystyk co najmniej tak dużych jak obserwowana. Klasyczny przykład to bootstrapowanie testu ilorazu wiarygodności dla liczby składowych mieszaniny rozkładów normalnych (McLachlan, 1987), czyli test BLRT w analizie profili latentnych.
- Błędy standardowe i przedziały ufności dla złożonych funkcji parametrów, np. kwantyli. Przedziały można dalej poprawiać metodą BCa (Efron i Tibshirani, 1993).
- Małe próby, w których losowanie z kilkunastu obserwacji słabo odtwarza ogony rozkładu – o ile model jest wiarygodny.
Przykład
W symulowanych danych 80 osób średnia liczba wizyt u lekarza wyniosła 2.60, a wariancja 3.43. Test ilorazu wiarygodności modelu ujemnego dwumianowego wobec modelu Poissona dał LR = 2.99, a z rozkładu χ²(1) p = .084. Model Poissona leży jednak na granicy przestrzeni parametrów (zerowa nadmierna dyspersja), więc χ²(1) nie pasuje. W 999 próbach symulowanych z dopasowanego modelu Poissona 56.5% statystyk LR wyniosło 0, a 95. centyl – 2.64 zamiast 3.84. Bootstrapowe p = .047, blisko połowy p z χ² (.042).
Na rysunku
Rysunek pokazuje przykład z hasła: liczbę wizyt 80 osób, statystykę LR = 2.99 i 999 prób symulowanych z dopasowanego modelu Poissona (set.seed(602)). Dla porównania dodano 999 prób losowanych ze zwracaniem z tych samych danych (set.seed(6020)).
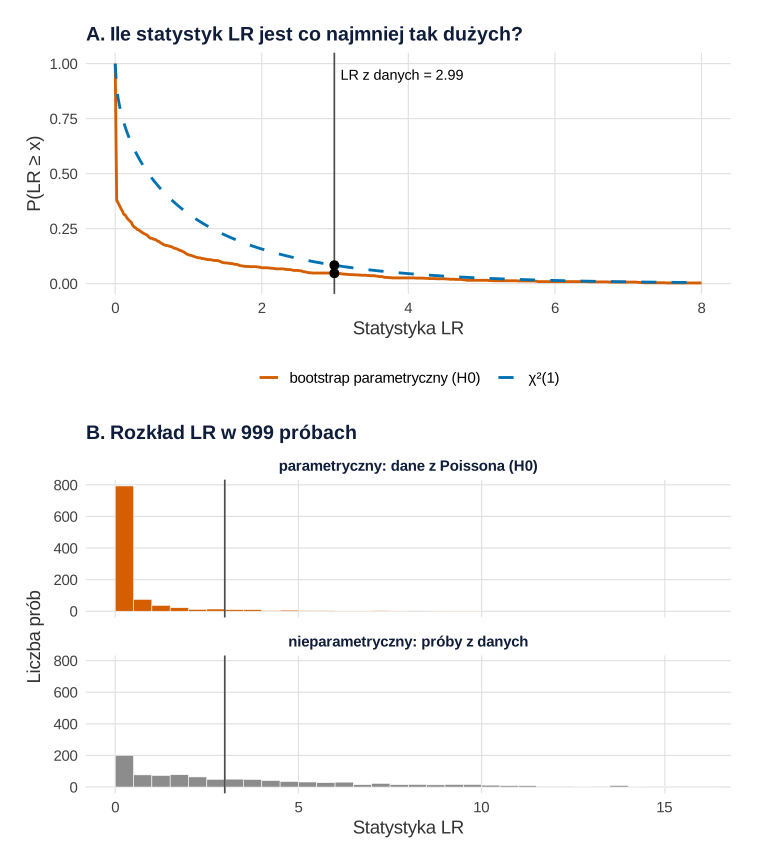
set.seed(602), set.seed(6020)).Co widać. Panel A to dwie „maszynki do wartości p”: wysokość krzywej nad obserwowaną statystyką LR jest wartością p. Krzywa z bootstrapu spada przy zerze, bo 56.5% symulowanych statystyk wyniosło dokładnie 0, i nad LR = 2.99 daje .047. Krzywa χ²(1) tego skoku nie ma i daje .084. Panel B pokazuje, skąd ta różnica, i ostrzega przed skrótem. Próby z modelu Poissona odtwarzają świat, w którym H0 jest prawdziwa (mediana LR = 0). Próby losowane ze zwracaniem z obserwowanych danych niosą ich nadmierną dyspersję: zer jest tylko 7.7%, mediana wynosi 2.57, a co najmniej tak dużych LR jak obserwowane jest 45.7%.
Na co uważać. Odsetek z dolnego histogramu nie jest wartością p – rozkład nie powstał pod H0, więc nic nie mówi o tym, jak często tak duże LR zdarza się przypadkiem. Do testu dane symuluje się z modelu ograniczonego. Rysunek zakłada też, że model Poissona dobrze opisuje świat H0. Ogólną ideę losowania ze zwracaniem pokazuje wpis Bootstrap – wizualizacja na obrazkach, a nadmierną dyspersję w danych zliczeniowych – regresja Poissona – wizualizacja.
Podpis do pracy:
Kod poniżej odtwarza rysunek i liczby z tego akapitu. Jest samowystarczalny: prosty motyw definiuje sam. Rysunek na stronie powstał z tego samego obiektu p1 z motywem serwisu – dane, geometrie i skale są identyczne, różni się tylko krój czcionki i siatka. Kod losuje w dwóch miejscach, każde z własnym ziarnem: set.seed(602) odtwarza przykład hasła, set.seed(6020) – próby losowane z danych. Ziaren nie zmieniano.
Kod R rysunku 1
# Rysunek 1. Rozkład statystyki LR z bootstrapu parametrycznego pod H0 na tle χ²(1) (A)
# i ten sam rozkład obok losowania ze zwracaniem z obserwowanych danych (B)
library(MASS)
library(ggplot2)
suppressPackageStartupMessages(library(patchwork))

motyw <- theme_minimal(base_size = 14) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        plot.title = element_text(face = "bold"))

set.seed(602)                                      # te same dane i próby co w przykładzie hasła
n <- 80
y <- rnbinom(n, mu = 3, size = 15)                  # liczba wizyt u lekarza w roku
lrt <- function(y) {                               # LR: Poisson (H0) vs ujemny dwumianowy
  ll0 <- sum(dpois(y, mean(y), log = TRUE))
  ll1 <- as.numeric(logLik(suppressWarnings(glm.nb(y ~ 1))))
  max(0, 2 * (ll1 - ll0))
}
LR_obs <- lrt(y)
LR_boot <- replicate(999, lrt(rpois(n, mean(y))))  # bootstrap parametryczny: dane z Poissona pod H0

set.seed(6020)                                     # dla porównania: losowanie ze zwracaniem z danych
LR_npar <- replicate(999, lrt(sample(y, replace = TRUE)))
p_chi2 <- pchisq(LR_obs, 1, lower.tail = FALSE)
p_boot <- (1 + sum(LR_boot >= LR_obs)) / 1000
round(c(LR_obs = LR_obs, p_chi2 = p_chi2, p_boot_param = p_boot,
        odsetek_zer_param = mean(LR_boot == 0), mediana_param = median(LR_boot),
        odsetek_zer_npar = mean(LR_npar == 0), mediana_npar = median(LR_npar),
        odsetek_npar_ponad_obs = mean(LR_npar >= LR_obs)), 3)

# A: P(LR >= x) – bootstrap parametryczny pod H0 vs rozkład χ²(1); w punkcie LR_obs to są wartości p
x <- seq(0, 8, by = 0.02)
ogony <- rbind(data.frame(x, p = sapply(x, function(v) mean(LR_boot >= v)), rozklad = "bootstrap parametryczny (H0)"),
               data.frame(x, p = pchisq(x, 1, lower.tail = FALSE), rozklad = "χ²(1)"))
ogony$p[ogony$x == 0] <- 1
pa <- ggplot(ogony, aes(x, p, linetype = rozklad, colour = rozklad)) +
  geom_line(linewidth = 1) +
  geom_vline(xintercept = LR_obs, linewidth = 0.6, colour = "grey30") +
  annotate("text", x = LR_obs, y = 0.95, label = sprintf("LR z danych = %.2f", LR_obs), hjust = -0.05, size = 3.8) +
  annotate("point", x = LR_obs, y = c(p_boot, p_chi2), size = 2.6) +
  scale_colour_manual(values = c("#D55E00", "#0072B2"), name = NULL) +
  scale_linetype_manual(values = c("solid", "dashed"), name = NULL) +
  labs(title = "A. Ile statystyk LR jest co najmniej tak dużych?", x = "Statystyka LR",
       y = "P(LR ≥ x)") + motyw

# B: rozkład LR – symulacja pod H0 vs losowanie ze zwracaniem z danych (nie pod H0)
oba <- rbind(data.frame(LR = LR_boot, zrodlo = "parametryczny: dane z Poissona (H0)"),
             data.frame(LR = LR_npar, zrodlo = "nieparametryczny: próby z danych"))
oba$zrodlo <- factor(oba$zrodlo, levels = unique(oba$zrodlo))
pb <- ggplot(oba, aes(LR, fill = zrodlo)) +
  geom_histogram(binwidth = 0.5, boundary = 0, colour = "white", linewidth = 0.2) +
  geom_vline(xintercept = LR_obs, linewidth = 0.6, colour = "grey30") +
  facet_wrap(~ zrodlo, ncol = 1) +
  scale_fill_manual(values = c("#D55E00", "grey55"), guide = "none") +
  coord_cartesian(xlim = c(0, 16)) +
  labs(title = "B. Rozkład LR w 999 próbach", x = "Statystyka LR", y = "Liczba prób") + motyw

p1 <- pa / pb + plot_layout(heights = c(1, 1.3))
p1   # zapis: ggsave("bootstrap-parametryczny-rozklad-lr.svg", p1, width = 8, height = 9)
Wynik w R
                LR_obs                 p_chi2           p_boot_param
                 2.990                  0.084                  0.047
     odsetek_zer_param          mediana_param       odsetek_zer_npar
                 0.565                  0.000                  0.077
          mediana_npar odsetek_npar_ponad_obs
                 2.570                  0.457
Na co uważać
- Wynik zależy od modelu. Źle określony model przenosi błąd do każdej symulowanej próby. Gdy nie ufasz modelowi, bezpieczniejszy jest bootstrap nieparametryczny.
- Do testu symuluj pod H0. Dane generuje się z modelu ograniczonego, nie z pełnego.
- Inne dane, inna odmiana. Szeregi czasowe i heteroskedastyczne reszty wymagają bootstrapu blokowego lub wild, a porównanie grup bez założeń o rozkładzie – testu permutacyjnego.
Bootstrap parametryczny w R
Kod symuluje liczbę wizyt 80 osób, liczy statystykę LR modelu ujemnego dwumianowego wobec Poissona, a potem generuje 999 prób z dopasowanego modelu Poissona (H0) i wyznacza bootstrapową wartość p. Liczby w tekście pochodzą z tego kodu.
Test LR na granicy przestrzeni parametrów
R
library(MASS)
set.seed(602)                                      # 80 osób: liczba wizyt u lekarza w roku
n <- 80
y <- rnbinom(n, mu = 3, size = 15)                  # dane z nadmierną dyspersją
lrt <- function(y) {                               # LR: Poisson (H0) vs ujemny dwumianowy
  ll0 <- sum(dpois(y, mean(y), log = TRUE))
  ll1 <- as.numeric(logLik(suppressWarnings(glm.nb(y ~ 1))))
  max(0, 2 * (ll1 - ll0))
}
LR_obs <- lrt(y)
lam <- mean(y)                                     # parametr modelu H0 oszacowany z danych
B <- 999
LR_boot <- replicate(B, lrt(rpois(n, lam)))        # bootstrap parametryczny: dane z Poissona(lam)
p_boot <- (1 + sum(LR_boot >= LR_obs)) / (B + 1)
round(c(srednia = lam, wariancja = var(y), LR = LR_obs,
        p_chi2_1df = pchisq(LR_obs, 1, lower.tail = FALSE), p_boot = p_boot), 4)
round(c(kwantyl95_boot = unname(quantile(LR_boot, 0.95)), kwantyl95_chi2 = qchisq(0.95, 1),
        odsetek_zer = mean(LR_boot == 0)), 3)
Wynik w R
   srednia  wariancja         LR p_chi2_1df     p_boot
    2.6000     3.4329     2.9901     0.0838     0.0470
kwantyl95_boot kwantyl95_chi2    odsetek_zer
         2.639          3.841          0.565
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiet MASS; rysunek 1 – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Czym bootstrap parametryczny różni się od zwykłego bootstrapu?
Zwykły (nieparametryczny) bootstrap losuje ze zwracaniem obserwacje z próby. Parametryczny symuluje nowe dane z dopasowanego modelu, np. z rozkładu Poissona o oszacowanej średniej. Jest dokładniejszy, gdy model jest trafny, i zawodzi, gdy model jest źle określony.
Jak policzyć bootstrapową wartość p z bootstrapu parametrycznego?
Dopasuj model zgodny z H0, wygeneruj z niego B zbiorów danych, w każdym policz statystykę testu i zastosuj wzór p = (1 + liczba statystyk ≥ obserwowanej) / (B + 1). Przy B = 999 najmniejsza możliwa wartość to .001.
Kiedy bootstrap parametryczny jest lepszy od rozkładu χ²?
Gdy rozkład χ² nie pasuje, np. przy parametrze na granicy przestrzeni parametrów: przy teście Poissona wobec modelu ujemnego dwumianowego czy porównaniu liczby klas w modelach mieszanin (test BLRT). W przykładzie 95. centyl statystyki LR wyniósł 2.64 zamiast 3.84.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Regresja dla zliczeń krok po kroku
Poisson z offsetem, rozproszenie, ujemna dwumianowa, ZIP, ZINB i hurdle na jednym przykładzie: rootogram, IRR, przewidywane średnie, tabela APA i kod R.
Czytaj →PoradnikBootstrap i test permutacyjny krok po kroku
Bootstrap różnicy median i korelacji z BCa, test permutacyjny zamiast testu t, liczba permutacji i kiedy bootstrap zawodzi – na jednym przykładzie w R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Davison, A. C., & Hinkley, D. V. (1997). Bootstrap methods and their application. Cambridge University Press. https://doi.org/10.1017/cbo9780511802843 ● Otwarty dostęp: pełny tekst
- Efron, B., & Tibshirani, R. J. (1993). An introduction to the bootstrap. Chapman & Hall.
- McLachlan, G. J. (1987). On bootstrapping the likelihood ratio test statistic for the number of components in a normal mixture. Applied Statistics, 36(3), 318–324. https://doi.org/10.2307/2347790
Cytowania BibTeX
@book{davison1997bootstrap, author={Davison, A. C. and Hinkley, D. V.}, title={{Bootstrap methods and their application}}, year={1997}, publisher={Cambridge University Press}, doi={10.1017/cbo9780511802843}}@book{efron1993introduction, author={Efron, Bradley and Tibshirani, Robert J.}, title={{An introduction to the bootstrap}}, year={1993}, publisher={Chapman \& Hall}}@article{mclachlan1987bootstrapping, author={McLachlan, G. J.}, title={{On bootstrapping the likelihood ratio test statistic for the number of components in a normal mixture}}, journal={Applied Statistics}, year={1987}, volume={36}, number={3}, pages={318--324}, doi={10.2307/2347790}}