Po co Ci bootstrap i test permutacyjny
Promotor napisał na marginesie: „rozkład skośny – policz bootstrap” albo „zamiast testu t zrób test permutacyjny”. Definicje znajdziesz w hasłach bootstrap, przedział bootstrapowy BCa i test permutacyjny. Wpis analiza na małej próbie wyjaśnia, czego obie metody nie naprawią przy 10–30 osobach. Tutaj przechodzimy przez całą analizę na jednym zbiorze danych: od pierwszego losowania do zdania w rozdziale wyników. Pełny wykład obu metod, z przedziałami BCa i testami permutacyjnymi, zawiera podręcznik Efrona i Tibshiraniego (1993).
Obie metody korzystają z losowania, ale robią co innego. Bootstrap szacuje niepewność wyniku i daje przedział ufności. Test permutacyjny sprawdza hipotezę zerową i daje wartość p. Bootstrap losuje osoby ze zwracaniem, a test permutacyjny tasuje etykiety grup bez zwracania.
Krok 1. Zrozum losowanie ze zwracaniem
Efron (1979) zaproponował, by rozkład statystyki z próby przybliżać na podstawie samych danych. Skoro nie możesz powtórzyć badania tysiąc razy, losujesz z własnej próby nowe próby tej samej wielkości. Zobacz to na ośmiu osobach, które podały czas zasypiania: 11, 15, 15, 19, 20, 23, 43 i 45 minut (dane symulowane, mediana 19.5). Trzy pierwsze próby bootstrapowe miały mediany 15.0, 17.0 i 19.0. W każdej ktoś wystąpił dwa razy, a ktoś inny wcale. Gdy powtórzysz to tysiące razy, rozrzut median pokaże, jak bardzo mediana zmieniałaby się w kolejnych próbach.
Dwie liczby z przepisu 1 pomagają zrozumieć ograniczenia metody. Z 8 obserwacji można wylosować tylko 6435 różnych prób (kolejność się nie liczy), a z 5 – zaledwie 126. Przy 20 osobach jest ich już ponad 68 miliardów. Poza tym każda konkretna osoba nie trafia do mniej więcej 34–36% prób bootstrapowych. To przyda się w kroku 6.
Przykład: fiszki czy ponowne czytanie
Czterdzieści osób studiujących losowo przydzielono do dwóch sposobów nauki: 20 uczyło się z fiszek, a 20 ponownie czytało notatki. Po tygodniu wszyscy rozwiązali test wiedzy (0–30 punktów) i zapisano czas rozwiązywania. Przed badaniem osoby wypełniły też skalę lęku testowego (0–40) i podały średnią liczbę godzin snu. Dane są symulowane i można je pobrać jako plik CSV. Wszystkie liczby pochodzą z kodu na końcu strony.
Krok 2. Bootstrap różnicy median
Czas rozwiązania testu ma rozkład prawoskośny (zob. rozkład logarytmiczno-normalny), więc porównujemy mediany. W grupie czytającej mediana wyniosła 26.4 min, w grupie z fiszkami 23.0 min. Różnica wynosi −3.45 min. Na różnicę median nie ma prostego wzoru na błąd standardowy, dlatego właśnie tu bootstrap się przydaje.
W pakiecie boot potrzebujesz dwóch rzeczy. Pierwsza to funkcja, która dostaje dane i numery wylosowanych wierszy i, a zwraca statystykę. Druga to wywołanie boot() z liczbą prób R. Argument strata = grupa sprawia, że losowanie odbywa się osobno w każdej grupie. Każda próba bootstrapowa ma wtedy, tak jak badanie, 20 + 20 osób. Z 9999 prób wyszedł bootstrapowy błąd standardowy 3.22 min i obciążenie 0.01 min, czyli praktycznie zerowe.
Funkcja boot.ci() liczy kilka rodzajów przedziałów naraz:
| Przedział | Jak powstaje | 95% CI |
|---|---|---|
| Normalny | oszacowanie (po korekcie obciążenia) ± 1.96 × SE z bootstrapu | [−9.78, 2.85] |
| Podstawowy (basic) | odbicie centyli wokół oszacowania z próby | [−10.20, 2.60] |
| Percentylowy | 2.5. i 97.5. centyl 9999 różnic | [−9.50, 3.30] |
| BCa | centyle przesunięte o korektę obciążenia i przyspieszenie | [−9.55, 3.25] |
DiCiccio i Efron (1996) opisują BCa jako przedział, który ma być wyraźnie dokładniejszy od standardowego „oszacowanie ± z × SE” i nadal da się go stosować rutynowo. Dlatego w pracy dyplomowej zwykle wybierasz BCa. Przedział percentylowy jest najprostszy do wyjaśnienia, ale przy małych próbach bywa mniej dokładny niż zwykły przedział t (Hesterberg, 2015). Tu wszystkie cztery przedziały obejmują zero. Fiszki mogły skracać czas o prawie 10 minut albo wydłużać go o około 3 minuty. Dane nie rozstrzygają kierunku.
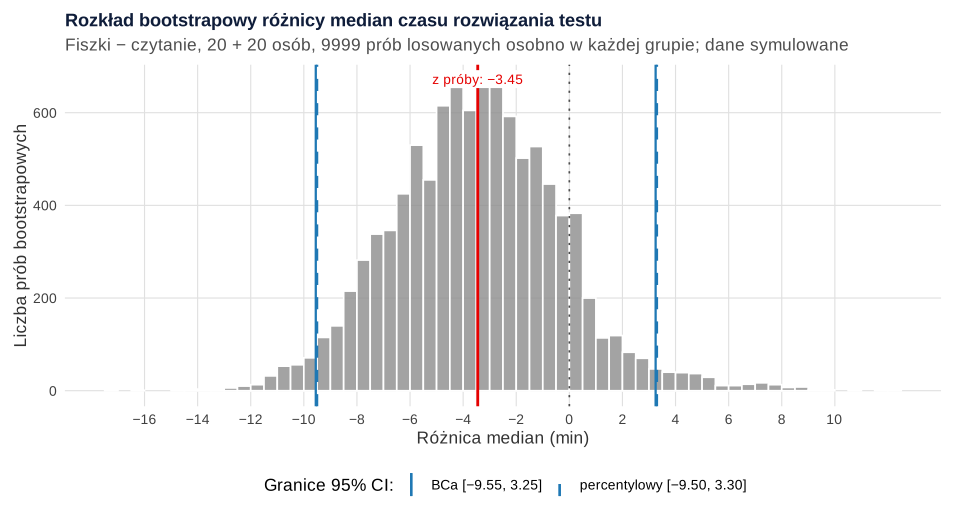
Zwróć uwagę na „schodkowy” kształt histogramu. Mediana z 20 osób przyjmuje tylko wartości obserwowane albo średnie dwóch sąsiednich, więc 9999 różnic median układa się w zaledwie 688 różnych wartości. Przy średniej rozkład byłby gładki. Im mniejsza grupa, tym bardziej schodkowy rozkład i tym mniej pewne granice przedziału.
Krok 3. Bootstrap korelacji: losuj całe wiersze
Lęk testowy i liczba godzin snu korelują ujemnie: korelacja Pearsona r = −.40, p = .012. Klasyczny 95% CI z transformacji Fishera to [−.63, −.10]. Bootstrap daje błąd standardowy .13 i przedziały: percentylowy [−.62, −.12] oraz BCa [−.63, −.13]. Przy 40 osobach i dość regularnych danych wyniki są zbliżone. Bootstrap jest wtedy sprawdzeniem, a nie zmianą wniosku. Większą różnicę zobaczysz przy obserwacjach odstających albo przy statystykach bez prostego wzoru.
Losuj osoby, nie pojedyncze zmienne. Funkcja statystyki dostaje numery wierszy i bierze z każdego wiersza oba wyniki tej samej osoby. Jeśli wylosujesz lęk i sen osobno, rozbijesz pary i zniszczysz związek. W przepisie 3 taki błędny bootstrap dał średnio r = .003, a 95% wyników mieściło się między −.305 a .318. Tak wygląda rozkład korelacji przy braku związku, a nie niepewność Twojego wyniku.
Krok 4. Test permutacyjny różnicy średnich
Wynik testu wiedzy ma rozkład zbliżony do normalnego. Grupa z fiszkami uzyskała M = 19.80 (SD = 3.56), a grupa czytająca M = 17.10 (SD = 4.58). Różnica wynosi 2.70 punktu. Test permutacyjny odpowiada na to samo pytanie co test t dla prób niezależnych, ale rozkład statystyki przy hipotezie zerowej buduje z danych:
- Policz różnicę średnich w danych: 2.70.
- Przetasuj etykiety „fiszki” i „czytanie” między 40 osobami. Liczba osób w grupach się nie zmienia, a każdy zachowuje swój wynik.
- Policz różnicę średnich po przetasowaniu i powtórz to B = 9999 razy.
- Policz b, czyli liczbę permutacji z różnicą co najmniej tak dużą co do wartości bezwzględnej jak 2.70. Przyjmij p = (b + 1)/(B + 1).
Wyszło b = 491, więc p = 492/10 000 = .049. Dodanie jedynki wynika stąd, że obserwowany podział też jest jedną z możliwych permutacji. Phipson i Smyth (2010) pokazali, że p liczone bez tej poprawki jest zaniżone i nigdy nie powinno wynosić zero. Dla porównania test t Studenta dał t(38) = 2.08, p = .044, a test Welcha t(35.85) = 2.08, p = .045. Przy danych bez wyraźnej skośności oba podejścia dają prawie ten sam wynik. Jeśli zastanawiasz się, kiedy skośność naprawdę szkodzi testowi t, przeczytaj wpis test t przy rozkładzie nienormalnym.
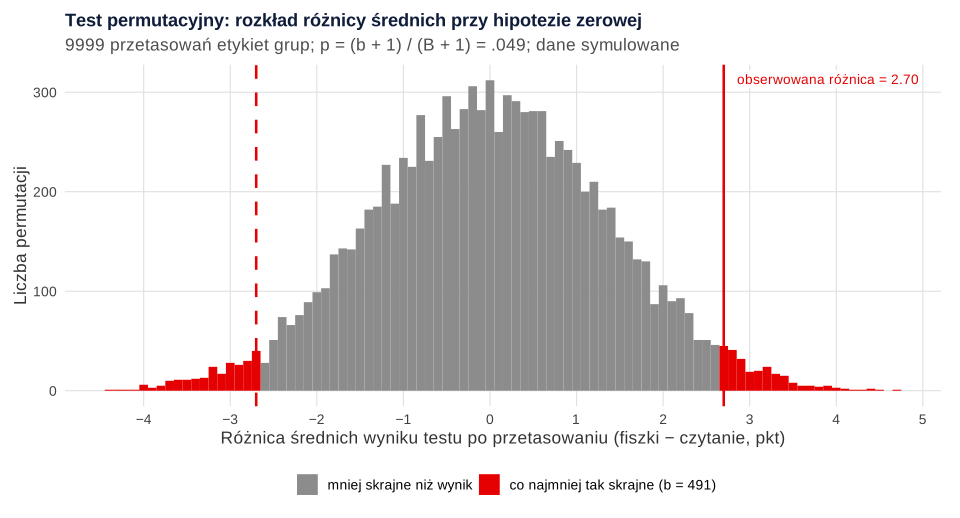
Logika testu wymaga wymienialności. Jeśli hipoteza zerowa jest prawdziwa, zamiana etykiet nie zmienia rozkładu danych. W eksperymencie z randomizacją wynika to z samego planu. Test jest wtedy dokładny, choć nie zakłada normalności (Ernst, 2004).
Krok 5. Ile permutacji i ile prób bootstrapowych
Podział 40 osób na dwie grupy po 20 można zrobić na 137 846 528 820 sposobów. Nie sprawdzisz wszystkich, więc losujesz ich część. Losowe p ma własny błąd Monte Carlo, równy √[p(1 − p)/B]. Przy 9999 permutacjach wynosi on .0022. Tabela 2 pokazuje, co się dzieje, gdy ten sam test powtórzysz pięć razy z różnymi ziarnami.
| B | Najmniejsze p | Największe p | Najmniejsze możliwe p |
|---|---|---|---|
| 99 | .040 | .070 | .01 |
| 999 | .050 | .057 | .001 |
| 9999 | .0471 | .0521 | .0001 |
| 99 999 | .0476 | .0490 | .00001 |
Przy 99 permutacjach ten sam wynik raz jest istotny, a raz nie. Przy 9999 wciąż zdarza się p powyżej .05, a przy 99 999 wszystkie powtórzenia są poniżej .05. Gdy p wypada blisko progu, zwiększ B, zanim napiszesz wniosek. Ustal przy tym B i ziarno przed analizą, a nie powtarzaj losowania, aż wyjdzie wynik istotny. Do przedziałów bootstrapowych użyj co najmniej kilku tysięcy prób, bo BCa i przedział percentylowy opierają się na skrajnych centylach. Liczby typu 9999 zamiast 10 000 są wygodne, bo (B + 1) daje okrągły mianownik.
Krok 6. Kiedy bootstrap zawodzi
Bickel i Freedman (1981) wykazali, że bootstrap działa w wielu sytuacjach, ale podali też kontrprzykłady, w których przybliżenie zawodzi. Trzy z nich spotkasz w praktyce.
Bardzo mała próba. W symulacji z przepisu 5 losowano dane z rozkładu prawoskośnego. Przy n = 5 95% przedział percentylowy dla średniej objął prawdziwą wartość tylko w 79.0% badań, a zwykły przedział t w 89.8%. Przy n = 10 było to 87.7% i 89.2%, a przy n = 40 – 92.0% i 93.1%. Dla średniej ze skośnego rozkładu żaden z tych przedziałów nie osiąga 95%, ale bootstrap przy kilku osobach jest wyraźnie gorszy. Mediana z 5 obserwacji w 9999 próbach bootstrapowych przyjęła tylko 5 wartości, czyli same obserwowane wyniki. Przedział dla niej to w praktyce rozstęp danych.
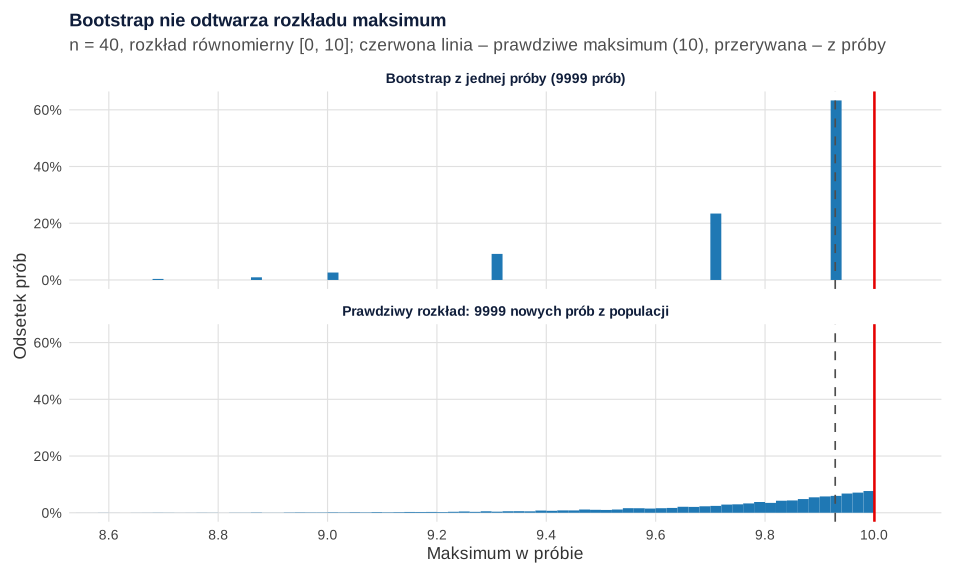
Maksimum i minimum. Próba bootstrapowa nigdy nie da wartości większej niż największa obserwacja. W przykładzie z 40 wynikami z rozkładu równomiernego [0, 10] maksimum z próby wyniosło 9.93. W 63.3% prób bootstrapowych maksimum było dokładnie tą samą liczbą (teoretycznie 1 − (1 − 1/n)n = .637). Przedział percentylowy dla maksimum nie objął prawdziwej wartości 10 w żadnym z 2000 symulowanych badań. Pokrycie wyniosło 0%. To samo dotyczy minimum, skrajnych centyli i statystyk zależnych od pojedynczych obserwacji.
Dane zależne. Zwykły bootstrap zakłada niezależne obserwacje o tym samym rozkładzie (Davison i Hinkley, 1997). Gdy jedna osoba ma kilka pomiarów albo uczniowie są zagnieżdżeni w klasach, losuj całe osoby lub klasy. Dla szeregów czasowych i regresji ze zmienną wariancją reszt są osobne odmiany, opisane w haśle bootstrap blokowy i wild bootstrap. Test permutacyjny ma tu analogiczne ograniczenie: w pomiarach powtarzanych tasuje się wyniki w obrębie osoby.
Krok 7. Jak opisać bootstrap i test permutacyjny w pracy
Czytelnik musi móc odtworzyć Twoje obliczenia. W rozdziale metodologicznym podaj cztery rzeczy: statystykę, liczbę prób lub permutacji, rodzaj przedziału albo sposób liczenia p oraz ziarno generatora i program. Jeśli losowanie było warstwowe albo obejmowało całe skupienia, też to napisz. Ogólne zasady zapisu wyników są we wpisie jak opisać wyniki w stylu APA.
Bootstrap stosuje się także w analizie mediacji. Tam liczba prób i rodzaj przedziału opisuje się tak samo, a ponowne szacowanie modelu omawia hasło bootstrap w SEM.
Najczęstsze błędy
- „Bootstrap, bo próba jest mała”. Bootstrap nie tworzy nowych danych, a przy kilku osobach działa gorzej niż przedział t.
- Brak liczby prób i ziarna. Bez nich nikt nie odtworzy granic przedziału ani wartości p.
- p = 0 albo „p = .000”. Najmniejsze możliwe p to 1/(B + 1).
- Mylenie obu metod. Bootstrap szacuje niepewność oszacowania, a test permutacyjny sprawdza hipotezę zerową. Napisz, którą metodą liczysz przedział, a którą wartość p.
- Losowanie wierszy przy danych zagnieżdżonych albo rozbijanie par przy korelacji.
- Wybór rodzaju przedziału po obejrzeniu wyników. Rodzaj przedziału (np. BCa) wpisz do planu analizy, zanim zobaczysz dane.
Jeśli zastanawiasz się, czy w ogóle potrzebujesz metod opartych na losowaniu, zajrzyj do wpisu testy nieparametryczne krok po kroku. Opisuje on klasyczne alternatywy dla danych o rozkładzie innym niż normalny.
Wszystkie obliczenia w R
Pięć przepisów liczy wszystkie liczby z tekstu i z tabel. Uruchamiasz je po kolei z jednego folderu, bo przepis 2 zapisuje plik CSV, z którego korzystają przepisy 3 i 4. Rysunki powstały w ggplot2 z tych samych danych i ziaren.
1. Idea: trzy próby bootstrapowe z ośmiu obserwacji
R
# B327 – idea bootstrapu: losowanie ze zwracaniem z ośmiu obserwacji
# Czas zasypiania w minutach u 8 osób (dane symulowane)
set.seed(3270)
x <- sort(round(rlnorm(8, log(20), 0.6)))
x
c(mediana = median(x), srednia = mean(x))
for (b in 1:3) {
  xb <- sort(sample(x, replace = TRUE))                 # próba bootstrapowa: n = 8, ze zwracaniem
  cat(sprintf("Próba %d: %s | mediana = %.1f\n", b, paste(xb, collapse = " "), median(xb)))
}
# Ile różnych prób bootstrapowych (bez względu na kolejność) da się wylosować z n obserwacji
n <- c(5, 8, 20, 40)
data.frame(n = n, rozne_proby = format(choose(2 * n - 1, n), big.mark = " ", scientific = FALSE))
# Szansa, że dana osoba nie trafi do próby bootstrapowej: (1 − 1/n)^n
round(data.frame(n = n, brak_osoby = (1 - 1 / n)^n), 3)
Wynik w R
[1] 11 15 15 19 20 23 43 45
mediana srednia
 19.500  23.875
Próba 1: 11 11 15 15 15 20 20 43 | mediana = 15.0
Próba 2: 11 11 15 15 19 23 23 43 | mediana = 17.0
Próba 3: 15 15 19 19 19 20 43 45 | mediana = 19.0
   n                    rozne_proby
1  5                            126
2  8                          6 435
3 20                 68 923 264 410
4 40 53 753 604 366 668 402 786 304
   n brak_osoby
1  5      0.328
2  8      0.344
3 20      0.358
4 40      0.363
2. Dane i bootstrap różnicy median (tabela 1)
R
# B327 – przykład: fiszki a ponowne czytanie, 20 + 20 studentów (dane symulowane)
# Bootstrap różnicy median czasu rozwiązania testu: cztery rodzaje 95% CI
suppressPackageStartupMessages(library(boot))
set.seed(3279)
n <- 20
grupa <- factor(rep(c("czytanie", "fiszki"), each = n), levels = c("czytanie", "fiszki"))
wynik <- round(pmin(30, pmax(0, rnorm(2 * n, ifelse(grupa == "fiszki", 19.5, 16.5), 4.5))))   # test wiedzy 0–30
czas <- round(rlnorm(2 * n, log(ifelse(grupa == "fiszki", 21, 25)), 0.40), 1)               # czas rozwiązania testu (min)
lek <- round(pmin(40, pmax(0, rnorm(2 * n, 20, 7))))                                         # lęk testowy 0–40
sen <- round(pmin(9.5, 7.6 - 0.07 * lek + rgamma(2 * n, 2, 2) - 1 + rnorm(2 * n, 0, 0.5)), 1) # sen (h na dobę)
dane <- data.frame(id = seq_len(2 * n), grupa, wynik_testu = wynik, czas_min = czas,
                   lek_testowy = lek, sen_h = sen)
write.csv(dane, "../bootstrap-permutacja-dane.csv", row.names = FALSE, fileEncoding = "UTF-8")

# Statystyki opisowe czasu rozwiązania testu
aggregate(czas_min ~ grupa, dane, function(y) round(c(M = mean(y), Mdn = median(y), min = min(y), max = max(y)), 1))

# Statystyka: różnica median (fiszki − czytanie); i = numery wierszy w próbie bootstrapowej
roznica_median <- function(d, i) {
  dd <- d[i, ]
  median(dd$czas_min[dd$grupa == "fiszki"]) - median(dd$czas_min[dd$grupa == "czytanie"])
}
set.seed(3272)
b_med <- boot(dane, roznica_median, R = 9999, strata = dane$grupa)   # losowanie osobno w każdej grupie
b_med
ci <- boot.ci(b_med, conf = 0.95, type = c("norm", "basic", "perc", "bca"))
round(rbind(normalny = ci$normal[2:3], podstawowy = ci$basic[4:5],
            percentylowy = ci$percent[4:5], BCa = ci$bca[4:5]), 2)
# Rozkład bootstrapowy mediany jest „schodkowy”: ile różnych wartości przyjęła różnica median
length(unique(b_med$t))
Wynik w R
     grupa czas_min.M czas_min.Mdn czas_min.min czas_min.max
1 czytanie       25.5         26.4          8.6         43.4
2   fiszki       24.1         23.0         10.3         41.1

STRATIFIED BOOTSTRAP


Call:
boot(data = dane, statistic = roznica_median, R = 9999, strata = dane$grupa)


Bootstrap Statistics :
    original     bias    std. error
t1*    -3.45 0.01484648    3.220817
               [,1] [,2]
normalny      -9.78 2.85
podstawowy   -10.20 2.60
percentylowy  -9.50 3.30
BCa           -9.55 3.25
[1] 688
3. Bootstrap korelacji Pearsona
R
# B327 – bootstrap korelacji Pearsona: lęk testowy a sen (40 osób, dane symulowane)
# Losujemy całe wiersze (pary wartości), a nie każdą zmienną osobno
suppressPackageStartupMessages(library(boot))
dane <- read.csv("../bootstrap-permutacja-dane.csv")
ct <- cor.test(dane$lek_testowy, dane$sen_h)                  # klasyczny test i CI z transformacji Fishera
round(c(r = unname(ct$estimate), CI_dol = ct$conf.int[1], CI_gor = ct$conf.int[2], p = ct$p.value), 3)
korelacja <- function(d, i) cor(d$lek_testowy[i], d$sen_h[i])
set.seed(3273)
b_r <- boot(dane, korelacja, R = 9999)
round(c(r = b_r$t0, obciazenie = mean(b_r$t) - b_r$t0, SE_boot = sd(b_r$t)), 3)
ci_r <- boot.ci(b_r, conf = 0.95, type = c("perc", "bca"))
round(rbind(Fisher_z = ct$conf.int, percentylowy = ci_r$percent[4:5], BCa = ci_r$bca[4:5]), 3)
# Błąd: losowanie zmiennych niezależnie od siebie niszczy związek – rozkład wokół zera
set.seed(3274)
r_zle <- replicate(9999, cor(sample(dane$lek_testowy, replace = TRUE), sample(dane$sen_h, replace = TRUE)))
round(c(srednia_r = mean(r_zle), q025 = unname(quantile(r_zle, 0.025)), q975 = unname(quantile(r_zle, 0.975))), 3)
Wynik w R
     r CI_dol CI_gor      p
-0.396 -0.630 -0.096  0.012
         r obciazenie    SE_boot
    -0.396      0.007      0.128
               [,1]   [,2]
Fisher_z     -0.630 -0.096
percentylowy -0.616 -0.117
BCa          -0.627 -0.132
srednia_r      q025      q975
    0.003    -0.305     0.318
4. Test permutacyjny różnicy średnich (tabela 2)
R
# B327 – test permutacyjny różnicy średnich zamiast testu t: wynik testu wiedzy 0–30
dane <- read.csv("../bootstrap-permutacja-dane.csv")
dane$grupa <- factor(dane$grupa, levels = c("czytanie", "fiszki"))
aggregate(wynik_testu ~ grupa, dane, function(y) round(c(n = length(y), M = mean(y), SD = sd(y)), 2))
roznica <- function(y, g) mean(y[g == "fiszki"]) - mean(y[g == "czytanie"])
obs <- roznica(dane$wynik_testu, dane$grupa)
# Krok 1–3: tasujemy etykiety grup (bez zwracania), liczymy różnicę, powtarzamy B razy
set.seed(3275)
B <- 9999
perm <- replicate(B, roznica(dane$wynik_testu, sample(dane$grupa)))
b <- sum(abs(perm) >= abs(obs) - 1e-9)                       # permutacje co najmniej tak skrajne (dwustronnie)
p_perm <- (b + 1) / (B + 1)
mcse <- sqrt(p_perm * (1 - p_perm) / B)                      # błąd Monte Carlo wartości p
round(c(roznica = obs, b = b, p_perm = p_perm, MCSE = mcse), 4)
# Dla porównania: test t Studenta i test t Welcha
fi <- dane$wynik_testu[dane$grupa == "fiszki"]; cz <- dane$wynik_testu[dane$grupa == "czytanie"]
ts <- t.test(fi, cz, var.equal = TRUE); tw <- t.test(fi, cz)
round(c(t_Studenta = unname(ts$statistic), df = unname(ts$parameter), p_Studenta = ts$p.value,
        t_Welcha = unname(tw$statistic), df_Welcha = unname(tw$parameter), p_Welcha = tw$p.value), 3)
# Wszystkich podziałów 40 osób na dwie grupy po 20 jest za dużo, by sprawdzić każdy
format(choose(40, 20), big.mark = " ")
# Jak p zależy od liczby permutacji: pięć powtórzeń dla każdego B
wyn <- do.call(rbind, lapply(c(99, 999, 9999, 99999), function(B) {
  p <- sapply(1:5, function(k) {
    set.seed(3276 + k)
    pr <- replicate(B, roznica(dane$wynik_testu, sample(dane$grupa)))
    (sum(abs(pr) >= abs(obs) - 1e-9) + 1) / (B + 1)
  })
  data.frame(B = B, p_min = round(min(p), 4), p_max = round(max(p), 4), najmniejsze_mozliwe_p = format(1 / (B + 1), scientific = FALSE))
}))
print(wyn, row.names = FALSE)
Wynik w R
     grupa wynik_testu.n wynik_testu.M wynik_testu.SD
1 czytanie         20.00         17.10           4.58
2   fiszki         20.00         19.80           3.56
 roznica        b   p_perm     MCSE
  2.7000 491.0000   0.0492   0.0022
t_Studenta         df p_Studenta   t_Welcha  df_Welcha   p_Welcha
     2.082     38.000      0.044      2.082     35.847      0.045
[1] "137 846 528 820"
     B  p_min  p_max najmniejsze_mozliwe_p
    99 0.0400 0.0700                  0.01
   999 0.0500 0.0570                 0.001
  9999 0.0471 0.0521                0.0001
 99999 0.0476 0.0490               0.00001
5. Kiedy bootstrap zawodzi: mała próba i maksimum
R
# B327 – kiedy bootstrap zawodzi: bardzo małe n (mediana) i maksimum
# Symulacja pokrycia 95% przedziału percentylowego: 2000 badań, w każdym 1999 prób bootstrapowych
mediana_wierszy <- function(m) {                         # szybka mediana każdego wiersza macierzy
  s <- matrix(m[order(row(m), m)], nrow = nrow(m), byrow = TRUE); k <- ncol(m)
  (s[, ceiling(k / 2)] + s[, floor(k / 2) + 1]) / 2
}
max_wierszy <- function(m) do.call(pmax, as.data.frame(m))
pokrycie_perc <- function(n, stat_wierszy, losuj, prawda, R = 2000, B = 1999) {
  mean(replicate(R, {
    x <- losuj(n)
    xb <- matrix(sample(x, n * B, replace = TRUE), nrow = B)   # B prób bootstrapowych naraz
    q <- quantile(stat_wierszy(xb), c(0.025, 0.975))
    q[1] <= prawda && prawda <= q[2]
  }))
}
# 1) Średnia z rozkładu skośnego (logarytmiczno-normalnego, prawdziwa średnia = 20·e^0.18 ≈ 23.94):
#    pokrycie przedziału percentylowego i klasycznego przedziału t, a także mediany (percentylowy)
set.seed(3277)
losuj_ln <- function(n) rlnorm(n, log(20), 0.6)
sr_prawda <- 20 * exp(0.6^2 / 2)
pokrycie_t <- function(n, R = 2000) mean(replicate(R, {
  ci <- t.test(losuj_ln(n))$conf.int; ci[1] <= sr_prawda && sr_prawda <= ci[2] }))
tab <- t(sapply(c(5, 10, 20, 40), function(n)
  c(n = n, srednia_perc = pokrycie_perc(n, rowMeans, losuj_ln, prawda = sr_prawda),
    srednia_t = pokrycie_t(n),
    mediana_perc = pokrycie_perc(n, mediana_wierszy, losuj_ln, prawda = 20))))
print(round(tab, 3))
# Przy n = 5 mediana bootstrapowa może przyjąć tylko jedną z 5 obserwowanych wartości
set.seed(3278)
x5 <- round(losuj_ln(5), 1)
table(replicate(9999, median(sample(x5, replace = TRUE))))

# 2) Maksimum: rozkład równomierny na [0, 10], n = 40, prawdziwe maksimum rozkładu = 10
set.seed(3279)
x <- runif(40, 0, 10)
max_boot <- replicate(9999, max(sample(x, replace = TRUE)))
round(c(max_z_proby = max(x), odsetek_rowny_max = mean(max_boot == max(x)),
        teoria = 1 - (1 - 1 / 40)^40), 3)
set.seed(3280)
pok_max <- pokrycie_perc(40, max_wierszy, function(n) runif(n, 0, 10), prawda = 10)
round(c(pokrycie_max = pok_max), 3)
Wynik w R
      n srednia_perc srednia_t mediana_perc
[1,]  5        0.790     0.898        0.934
[2,] 10        0.877     0.892        0.934
[3,] 20        0.897     0.916        0.926
[4,] 40        0.920     0.931        0.947

  11 12.6 16.7 25.3 69.2
 589 2567 3676 2615  552
      max_z_proby odsetek_rowny_max            teoria
            9.928             0.633             0.637
pokrycie_max
           0
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietem boot; rysunki przygotowano w pakietach ggplot2 i svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- boot (wersja 1.3-32): Canty, A., & Ripley, B. (2025). boot: Bootstrap functions [R package]. https://doi.org/10.32614/CRAN.package.boot
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Ile prób bootstrapowych wystarczy do pracy magisterskiej?
Do przedziałów ufności użyj co najmniej kilku tysięcy prób, np. 9999. Przedziały percentylowy i BCa opierają się na skrajnych centylach, więc kilkaset prób daje niestabilne granice. Liczbę prób i ziarno generatora (set.seed) podaj w opisie metody.
Który przedział bootstrapowy wybrać: percentylowy czy BCa?
Zwykle BCa, bo koryguje przesunięcie i skośność rozkładu bootstrapowego. Przedział percentylowy jest najprostszy, ale przy małych próbach mniej dokładny. W przykładzie dla różnicy median oba dały prawie to samo: [−9.50, 3.30] i [−9.55, 3.25]. Wybierz rodzaj przedziału przed analizą i podaj go w pracy.
Ile permutacji zrobić w teście permutacyjnym?
Zwykle 9999 lub więcej. Losowe p ma błąd Monte Carlo √[p(1 − p)/B]. W przykładzie przy 99 permutacjach p wahało się od .040 do .070, a przy 99 999 – od .0476 do .0490. Gdy p jest blisko .05, zwiększ liczbę permutacji, ale ustal ją i ziarno przed analizą.
Czym się różni bootstrap od testu permutacyjnego?
Bootstrap losuje osoby ze zwracaniem i szacuje niepewność wyniku, czyli daje błąd standardowy i przedział ufności. Test permutacyjny tasuje etykiety grup bez zwracania i buduje rozkład statystyki przy hipotezie zerowej, czyli daje wartość p. Często raportuje się oba: p z permutacji i CI z bootstrapu.
Kiedy nie używać bootstrapu?
Przy bardzo małej próbie, przy statystykach zależnych od pojedynczych skrajnych obserwacji (maksimum, minimum) i przy danych zależnych, jeśli losujesz pojedyncze wiersze. W symulacji przedział percentylowy dla maksimum nie objął prawdziwej wartości ani razu, a przy 5 osobach przedział dla średniej objął ją w 79.0% badań zamiast w 95%.
Powiązane hasła
Przeczytaj też
Bootstrap – wizualizacja na obrazkach
Kulki losowane ze zwracaniem, rozkład średniej i mediany, 1000 badań o tym, kiedy przedział percentylowy zawodzi, różnica median i korelacja – pięć rysunków z kodem R.
Czytaj →PoradnikBootstrap w SPSS krok po kroku
Okno Bootstrap od pliku .sav po zdanie APA: liczba prób, ziarno, BCa, losowanie warstwowe i kolumny Bias oraz Std. Error.
Czytaj →PoradnikAnaliza na małej próbie
Moc i szerokość CI przy 10–30 osobach, przeszacowane efekty, test permutacyjny, Fisher i bootstrap oraz wzór opisu ograniczenia – na pilotażu 10 + 10 w R.
Czytaj →PoradnikTest t przy rozkładzie nienormalnym
Kiedy skośność naprawdę szkodzi testowi t: symulacja w R, test Welcha, bootstrap, test Yuena i Mann–Whitney na jednym przykładzie oraz opis APA.
Czytaj →PoradnikTesty nieparametryczne krok po kroku
Kiedy test rangowy ma sens, Mann–Whitney, Wilcoxon, Kruskal–Wallis z testem Dunna i Friedman na jednym badaniu – z wielkością efektu i opisem APA.
Czytaj →Promotor kazał policzyć bootstrap albo test permutacyjny?
Dobierzemy metodę do Twoich danych, policzymy przedziały i wartości p w R i wyjaśnimy wyniki tak, żebyś umiał(a) je samodzielnie opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Bickel, P. J., & Freedman, D. A. (1981). Some asymptotic theory for the bootstrap. The Annals of Statistics, 9(6), 1196–1217. https://doi.org/10.1214/aos/1176345637 ● Otwarty dostęp
- Davison, A. C., & Hinkley, D. V. (1997). Bootstrap methods and their application. Cambridge University Press. https://doi.org/10.1017/cbo9780511802843 ● Otwarty dostęp: pełny tekst
- DiCiccio, T. J., & Efron, B. (1996). Bootstrap confidence intervals. Statistical Science, 11(3), 189–228. https://doi.org/10.1214/ss/1032280214 ● Otwarty dostęp
- Efron, B. (1979). Bootstrap methods: Another look at the jackknife. The Annals of Statistics, 7(1), 1–26. https://doi.org/10.1214/aos/1176344552 ● Otwarty dostęp
- Efron, B., & Tibshirani, R. J. (1993). An introduction to the bootstrap. Chapman & Hall.
- Ernst, M. D. (2004). Permutation methods: A basis for exact inference. Statistical Science, 19(4), 676–685. https://doi.org/10.1214/088342304000000396 ● Otwarty dostęp
- Hesterberg, T. C. (2015). What teachers should know about the bootstrap: Resampling in the undergraduate statistics curriculum. The American Statistician, 69(4), 371–386. https://doi.org/10.1080/00031305.2015.1089789 ● Otwarty dostęp
- Phipson, B., & Smyth, G. K. (2010). Permutation p-values should never be zero: Calculating exact p-values when permutations are randomly drawn. Statistical Applications in Genetics and Molecular Biology, 9(1), Article 39. https://doi.org/10.2202/1544-6115.1585 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{bickel1981some, author={Bickel, Peter J. and Freedman, David A.}, title={{Some asymptotic theory for the bootstrap}}, journal={The Annals of Statistics}, year={1981}, volume={9}, number={6}, pages={1196--1217}, doi={10.1214/aos/1176345637}}@book{davison1997bootstrap, author={Davison, A. C. and Hinkley, D. V.}, title={{Bootstrap methods and their application}}, year={1997}, publisher={Cambridge University Press}, doi={10.1017/cbo9780511802843}}@article{diciccio1996bootstrap, author={DiCiccio, Thomas J. and Efron, Bradley}, title={{Bootstrap confidence intervals}}, journal={Statistical Science}, year={1996}, volume={11}, number={3}, pages={189--228}, doi={10.1214/ss/1032280214}}@article{efron1979bootstrap, author={Efron, Bradley}, title={{Bootstrap methods: Another look at the jackknife}}, journal={The Annals of Statistics}, year={1979}, volume={7}, number={1}, pages={1--26}, doi={10.1214/aos/1176344552}}@book{efron1993introduction, author={Efron, Bradley and Tibshirani, Robert J.}, title={{An introduction to the bootstrap}}, year={1993}, publisher={Chapman \& Hall}}@article{ernst2004permutation, author={Ernst, Michael D.}, title={{Permutation methods: A basis for exact inference}}, journal={Statistical Science}, year={2004}, volume={19}, number={4}, pages={676--685}, doi={10.1214/088342304000000396}}@article{hesterberg2015what, author={Hesterberg, Tim C.}, title={{What teachers should know about the bootstrap: Resampling in the undergraduate statistics curriculum}}, journal={The American Statistician}, year={2015}, volume={69}, number={4}, pages={371--386}, doi={10.1080/00031305.2015.1089789}}@article{phipson2010permutation, author={Phipson, Belinda and Smyth, Gordon K.}, title={{Permutation p-values should never be zero: Calculating exact p-values when permutations are randomly drawn}}, journal={Statistical Applications in Genetics and Molecular Biology}, year={2010}, volume={9}, number={1}, eid={39}, doi={10.2202/1544-6115.1585}}