Kiedy bootstrap w SPSS
Bootstrap szacuje niepewność wyniku przez wielokrotne losowanie ze zwracaniem z Twoich danych. Daje bootstrapowy błąd standardowy i przedział ufności bez założenia o normalnym rozkładzie statystyki. Samą metodę – losowanie, przedziały percentylowe i BCa, różnicę median i test permutacyjny w R – omawia wpis bootstrap i test permutacyjny krok po kroku. Tu zajmujemy się tylko tym, co klikasz w SPSS i co z tego przepisać do pracy. Ogólne zasady czytania wydruku są we wpisie jak czytać wyniki z SPSS.
Bootstrap przydaje się najczęściej w trzech sytuacjach: gdy zmienna jest wyraźnie skośna, a próba średniej wielkości (dziesiątki osób w grupie, nie kilka); gdy chcesz przedziału dla statystyki bez prostego wzoru, np. mediany; gdy reszty regresji mają nierówną wariancję. Nie jest za to sposobem na „uratowanie” wyniku, który wyszedł nieistotny.
Nazwy okien, opcji i tabel sprawdziliśmy w dokumentacji IBM SPSS Statistics 32 (IBM Corp., b.d.-a, b.d.-b, b.d.-d) i w studiach przypadku IBM (IBM Corp., b.d.-c). Podajemy je po angielsku. W polskiej wersji interfejsu mogą brzmieć inaczej.
Które procedury mają przycisk Bootstrap
Bootstrap nie ma osobnego menu. To wspólne okno, które otwierasz przyciskiem Bootstrap w oknie procedury (IBM Corp., b.d.-a). Dokumentacja wymienia procedury, które go obsługują, i dla każdej podaje, które tabele dostają oszacowania bootstrapowe (IBM Corp., b.d.-b). Najczęstsze w pracach dyplomowych:
| Procedura | Tabela i statystyki | Testy istotności w dokumentacji |
|---|---|---|
| Explore | Descriptives: średnia, średnia 5% obcięta, SD, wariancja, mediana, skośność, kurtoza, IQR; także M-Estimators i Percentiles | nie wymieniono |
| Independent-Samples T Test | Group Statistics: średnia i SD; tabela testu: różnica średnich | tak, dla różnicy średnich |
| Paired-Samples T Test | Statistics, Correlations; tabela testu: średnia różnic | nie wymieniono |
| One-Way ANOVA | Descriptive Statistics; Multiple Comparisons: różnice średnich; Contrast Tests | tak, dla kontrastów |
| Bivariate Correlations | Correlations: współczynniki korelacji | tak |
| Linear Regression | Coefficients: B; także Descriptive Statistics, Correlations, Model Summary (Durbin-Watson), Residuals Statistics | tak, dla B |
| Binary Logistic Regression | Variables in the Equation: B (opcja Regression) | tak |
Lista obejmuje też m.in. Frequencies, Descriptives, Crosstabs, Means, GLM Univariate, korelacje cząstkowe, regresję porządkową i wielomianową, a w opcji Advanced Statistics modele mieszane, uogólnione modele liniowe i regresję Coxa (IBM Corp., b.d.-b). Brakuje różnicy median: Explore da przedział dla mediany w każdej grupie osobno, ale nie dla ich różnicy. Tę policzysz w R (wpis o bootstrapie i teście permutacyjnym).
Trzy ograniczenia z dokumentacji (IBM Corp., b.d.-b): bootstrap nie działa na zbiorach po wielokrotnej imputacji (okno jest wtedy nieaktywne) ani przy wagach niecałkowitych, a braki danych usuwa zawsze przypadkami (listwise), niezależnie od ustawień procedury. Bootstrap efektu pośredniego w mediacji to osobne ustawienie makra – zob. mediacja i moderacja w SPSS z PROCESS.
Okno Bootstrap krok po kroku
- Otwórz procedurę, np. Analyze → Descriptive Statistics → Explore (ścieżka ze studium przypadku IBM, b.d.-c), ustaw zmienne jak zwykle i kliknij Bootstrap.
- Perform bootstrapping – włącza losowanie (IBM Corp., b.d.-a).
- Number of samples – liczba prób bootstrapowych. Dla przedziałów percentylowych i BCa dokumentacja zaleca co najmniej 1000 (IBM Corp., b.d.-a), a 1000 to też wartość domyślna w składni (IBM Corp., b.d.-d). Do pracy weź 2000 lub więcej.
- Set seed for Mersenne Twister – zaznacz i wpisz liczbę. Ziarno pozwala odtworzyć analizę, a po jej zakończeniu SPSS przywraca poprzedni stan generatora (IBM Corp., b.d.-a). Ustal je przed analizą i nie zmieniaj „aż wyjdzie”.
- Confidence Intervals – poziom (zwykle 95) i rodzaj: Percentile albo Bias corrected accelerated (BCa). Przedział percentylowy bierze po prostu odpowiednie percentyle wartości z prób, np. 2.5. i 97.5. BCa to przedział skorygowany, dokładniejszy kosztem dłuższych obliczeń (IBM Corp., b.d.-a). Teorię korekty opisuje hasło przedział bootstrapowy BCa, a jej źródłem jest Efron (1987).
- Sampling – Simple losuje przypadki ze zwracaniem z całego zbioru. Stratified losuje osobno w warstwach wyznaczonych przez zmienne warstwujące (IBM Corp., b.d.-a). Warstwuj po grupie, gdy liczebności grup ustalono w planie badania.
- Continue, potem OK albo Paste. SPSS wkleja wtedy osobną komendę
BOOTSTRAPprzed procedurą (IBM Corp., b.d.-a).
Dwie pułapki. Ustawienia okna obowiązują także w kolejnych procedurach, więc bootstrap może być włączony, choć o tym nie pamiętasz. A przy włączonym bootstrapie SPSS nie tworzy wykresów (IBM Corp., b.d.-a). Histogramy i wykresy reszt zrób w osobnym uruchomieniu. Bootstrap resztowy i typu wild są dostępne tylko w składni (IBM Corp., b.d.-a).
Przykład i pliki do pobrania
Dane są fikcyjne. 100 osób studiujących (60 stacjonarnie, 40 niestacjonarnie) podało, ile minut dziennie spędza w mediach społecznościowych, ile godzin w tygodniu pracuje zarobkowo i ile ma lat. Pobierz plik .sav z etykietami albo ten sam zbiór w pliku CSV (format opisuje hasło plik .sav).
Czas w mediach jest prawoskośny: w grupie stacjonarnej M = 143.4 min, Mdn = 118.5, skośność 0.97, a w niestacjonarnej M = 60.3, Mdn = 45.5, skośność 1.19. Liczby policzono w R pakietem boot, nie w SPSS. Oszacowania z kolumny Statistic będą w SPSS identyczne. Bias, Std. Error i granice przedziałów będą się nieco różnić, bo inny jest generator liczb losowych i inne próby. Ziarna (556, 5561–5565) i parametry danych ustawiliśmy przed obliczeniami i nie dobieraliśmy ich pod wynik.
Kolumny Bootstrap. Kolumna Statistic to wynik z oryginalnych danych. Bias to różnica między średnią statystyki we wszystkich próbach a tym wynikiem. Std. Error to odchylenie standardowe statystyki w próbach, a przedział ufności powstaje z uporządkowanych wartości z prób (IBM Corp., b.d.-c). W tabelach, dla których dokumentacja wymienia testy istotności (tabela testu t, Coefficients), SPSS dodaje też bootstrapową istotność (Sig.) (IBM Corp., b.d.-b, b.d.-c). Jej algorytmu nie odtwarzamy, więc w tabelach poniżej jej nie ma. Układ tabel jest uproszczony, a nagłówki kolumn odpowiadają opisowi IBM.
Krok 1: różnica średnich w teście t
W Analyze → Compare Means → Independent-Samples T Test wybierz media jako zmienną testowaną i tryb jako grupującą (kody 1 i 2). Zwykły test daje różnicę 83.13 min, t(98) = 5.10, 95% CI [50.80, 115.47], a wiersz bez założenia równych wariancji (test Welcha) – t(87.62) = 5.84, 95% CI [54.86, 111.41]. Czytanie tych wierszy omawia wpis test t w SPSS. Po włączeniu bootstrapu (2000 prób) dochodzą kolumny:
| Sampling | Statistic | Bias | Std. Error | 95% CI percentylowy | 95% CI BCa |
|---|---|---|---|---|---|
| Simple | 83.13 | 0.40 | 13.73 | [56.75, 110.66] | [57.00, 110.72] |
| Stratified (tryb) | 83.13 | 0.41 | 14.13 | [56.32, 111.10] | [56.83, 111.45] |
Bias jest mały (0.4 min przy różnicy 83 min), a przedziały bootstrapowe są zbliżone do przedziału Welcha. To typowe: przy 40–60 osobach w grupie i umiarkowanej skośności bootstrap tylko potwierdza wynik klasyczny. Losowanie proste zmienia liczebności grup – w naszych próbach liczba osób stacjonarnych wahała się od 43 do 76. Losowanie warstwowe po zmiennej tryb zachowuje 60 i 40 osób w każdej próbie, tak jak w badaniu. Tu oba warianty dały prawie to samo, ale przy małej grupie różnica bywa większa.
Krok 2: mediany w Explore
Przy skośnych danych średnia słabo opisuje „typową” osobę. Studium przypadku IBM pokazuje właśnie przedział BCa dla mediany w Explore (IBM Corp., b.d.-c). Wybierz media jako Dependent List, tryb jako Factor List, w Display zaznacz Statistics, w oknie Bootstrap – BCa. Wiersz Median w tabeli Descriptives wygląda tak:
| Statystyka | Statistic | Bias | Std. Error | 95% CI BCa |
|---|---|---|---|---|
| Mediana, stacjonarne | 118.5 | 0.62 | 15.34 | [98, 154] |
| Mediana, niestacjonarne | 45.5 | 2.74 | 10.33 | [34, 72] |
| Różnica median (tylko R) | 73.0 | −2.12 | 18.58 | [36.0, 113.8] |
Przedziały są wyraźnie niesymetryczne: dla grupy stacjonarnej 20.5 min w dół i 35.5 min w górę. Tak wygląda rozkład mediany przy prawoskośnych danych. Przy medianie BCa i przedział percentylowy często wychodzą identyczne, bo mediana w próbach przyjmuje niewiele różnych wartości. Różnicy median SPSS w oknach nie poda, a nie wolno jej „odczytać” z dwóch osobnych przedziałów.
Krok 3: współczynniki regresji przy skośnych resztach
W Analyze → Regression → Linear wybierz media jako zmienną zależną, a wiek i praca jako niezależne (klasyczne okno omawia wpis korelacja i regresja w SPSS). Model wyjaśnia 16.4% wariancji, ale reszty są prawoskośne (skośność 1.16) i mają różną wariancję: SD reszt wynosi 98.9 w grupie stacjonarnej i 45.2 w niestacjonarnej. Losowanie Simple losuje całe przypadki, czyli pary wartości zmiennej zależnej i predyktorów.
| Predyktor | B | SE klasyczny | 95% CI klasyczny | Bias | Std. Error | 95% CI BCa |
|---|---|---|---|---|---|---|
| (Constant) | 204.60 | 40.56 | [124.11, 285.10] | −0.15 | 27.14 | [153.45, 257.55] |
| wiek | −1.98 | 1.92 | [−5.80, 1.84] | −0.01 | 1.20 | [−4.36, 0.46] |
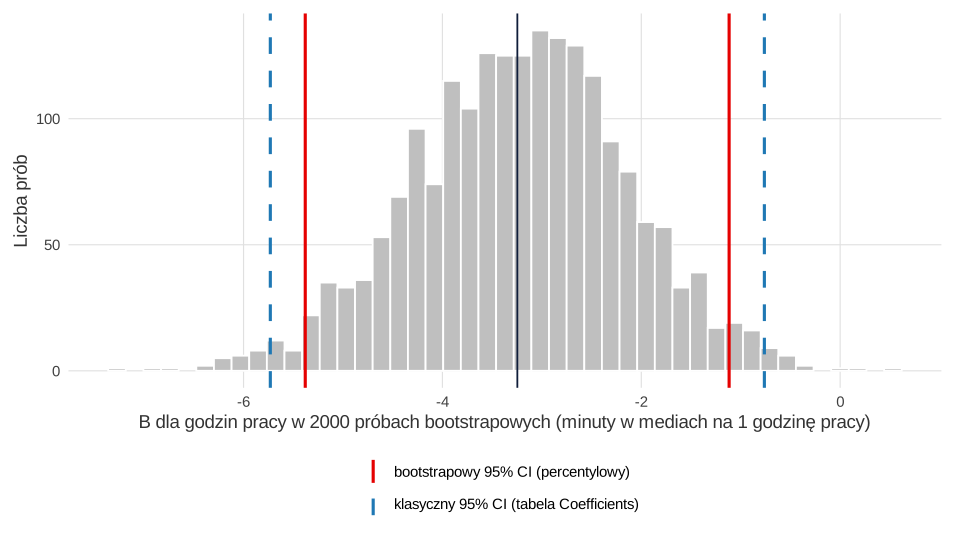
| praca | −3.25 | 1.25 | [−5.73, −0.76] | 0.02 | 1.08 | [−5.61, −1.33] |
Bootstrapowe błędy standardowe są tu mniejsze od klasycznych, a nie większe. Bootstrap nie „poszerza” przedziałów z zasady. Klasyczny wzór zakłada jednakową wariancję reszt, a bootstrap przypadków odtwarza ich rzeczywisty rozrzut. Dlatego jego wyniki są bliskie odpornym błędom standardowym HC3 (1.19 dla wieku i 1.07 dla pracy w naszym kodzie). Studium przypadku IBM pokazuje to samo w obie strony: parametryczne SE bywają za małe albo za duże (IBM Corp., b.d.-c). Rysunek 1 pokazuje rozkład B dla pracy w 2000 próbach. Wnioski się nie zmieniają: każda godzina pracy wiąże się z około 3 minutami mniej w mediach, a przedział dla wieku obejmuje 0.
Kiedy wybrać bootstrap, a kiedy błędy HC3 lub bootstrap typu wild (tylko składnia, hasło o bootstrapie wild) – to porównują krok po kroku w SPSS Rajh-Weber i in. (2026).
Kiedy bootstrap nie ratuje
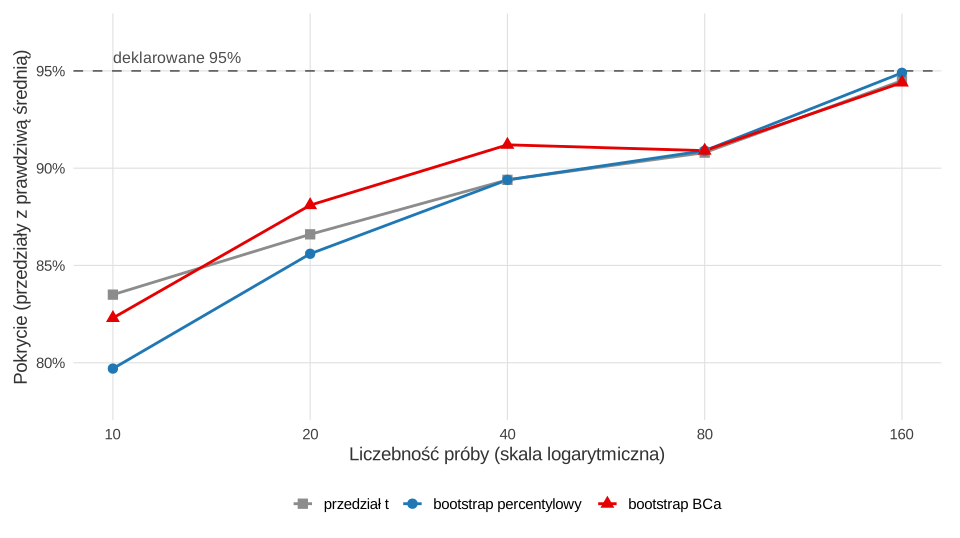
Mała próba. Bootstrap losuje tylko z osób, które masz. Przy kilkunastu obserwacjach próby słabo odtwarzają ogony rozkładu. Hesterberg (2015) pokazuje, że przy małych próbach przedział percentylowy jest mniej dokładny niż zwykły przedział t, a przewagę zyskuje dopiero przy większych. Sprawdziliśmy to symulacją (rysunek 2): 1000 zbiorów z silnie skośnego rozkładu logarytmiczno-normalnego dla każdej liczebności i 999 prób w każdym. Przy n = 10 prawdziwą średnią obejmowało 83.5% przedziałów t, 79.7% percentylowych i 82.3% BCa. Przy n = 40 – odpowiednio 89.4%, 89.4% i 91.2%, a dopiero przy n = 160 wszystkie trzy zbliżyły się do 95%. Co zrobić z kilkunastoma osobami, opisuje wpis analiza na małej próbie.
Wartości odstające. Bootstrap nie usuwa ich wpływu, tylko go powiela: jedna skrajna osoba trafia do większości prób. Jeśli średnia zależy od kilku skrajnych wartości, zmień statystykę (mediana, średnia obcięta albo M-estymatory – Explore bootstrapuje je wszystkie) albo wyjaśnij, skąd te wartości (wpis wartości odstające).
Zależne obserwacje. Simple i Stratified losują pojedyncze wiersze. Gdy każda osoba ma kilka pomiarów w formacie długim albo uczniowie są w klasach, losowanie wierszy traktuje je jak niezależne i daje zbyt wąskie przedziały (pseudoreplikacja). Okno nie oferuje losowania całych skupień. Zamiast tego użyj modelu mieszanego albo GEE w SPSS.
Zła próba i zły model. Bootstrap nie naprawi doboru próby, pominiętej zmiennej ani nieliniowej zależności. Gdy model chcesz traktować jako prawdziwy, rozważ też bootstrap parametryczny.
Zapis wyników w stylu APA
Podaj liczbę prób, rodzaj przedziału, sposób losowania i ziarno. Wzór do dostosowania:
Liczby w zdaniu pochodzą z R. Po uruchomieniu w SPSS wpisz własne granice z wydruku. Inne zdania przygotuje generator opisu wyników APA.
Składnia SPSS i kod R
Przepis 1 to składnia do wklejenia w edytorze składni SPSS. Napisaliśmy ją według opisu komend BOOTSTRAP i SET w Command Syntax Reference (IBM Corp., b.d.-d), ale nie uruchamialiśmy jej w SPSS. Komenda BOOTSTRAP działa tylko dla jednej następnej procedury, dlatego powtarzamy ją przed każdą. Przepis 2 w R tworzy pliki do pobrania i liczy liczby z tabel pakietem boot (Bias jako średnia z prób minus wynik z danych, Std. Error jako SD z prób, przedziały funkcją boot.ci()). Przepis 3 to symulacja pokrycia z rysunku 2 (liczy się około półtorej minuty). Kodu rysunków nie pokazujemy.
1. Składnia SPSS: BOOTSTRAP przed testem t, Explore i regresją
SPSS
* Składnia zgodna z opisem BOOTSTRAP i SET w Command Syntax Reference; nie była uruchamiana w SPSS.
* Ziarno generatora Mersenne Twister (odpowiednik Set seed for Mersenne Twister w oknie).
SET RNG=MT MTINDEX=556.

* 1. Test t: różnica średnich, losowanie warstwowe w grupach trybu studiów, przedział BCa.
BOOTSTRAP
  /SAMPLING METHOD=STRATIFIED(STRATA=tryb)
  /VARIABLES TARGET=media INPUT=tryb
  /CRITERIA CILEVEL=95 CITYPE=BCA NSAMPLES=2000
  /MISSING USERMISSING=EXCLUDE.
T-TEST GROUPS=tryb(1,2)
  /VARIABLES=media.

* 2. Explore: mediana w każdej grupie, przedział BCa.
BOOTSTRAP
  /SAMPLING METHOD=SIMPLE
  /VARIABLES TARGET=media INPUT=tryb
  /CRITERIA CILEVEL=95 CITYPE=BCA NSAMPLES=2000.
EXAMINE VARIABLES=media BY tryb
  /STATISTICS=DESCRIPTIVES
  /PLOT=NONE.

* 3. Regresja liniowa: bootstrap przypadków dla współczynników B.
BOOTSTRAP
  /SAMPLING METHOD=SIMPLE
  /VARIABLES TARGET=media INPUT=wiek praca
  /CRITERIA CILEVEL=95 CITYPE=BCA NSAMPLES=2000.
REGRESSION
  /DEPENDENT=media
  /METHOD=ENTER wiek praca.
2. Te same liczby w R i pliki .sav oraz CSV
R
# Bootstrap w SPSS: liczby do tabel z kolumnami Bootstrap (dane symulowane, fikcyjne)
suppressPackageStartupMessages({ library(boot); library(haven) })
set.seed(556)
tryb <- rep(1:2, times = c(60, 40))                       # 1 = stacjonarne (60 osób), 2 = niestacjonarne (40 osób)
wiek <- ifelse(tryb == 1, round(runif(100, 19, 25)), round(runif(100, 21, 40)))
praca <- ifelse(tryb == 1, rbinom(100, 30, 0.25), rbinom(100, 40, 0.6))   # godziny pracy zarobkowej w tygodniu
media <- round(exp(4.6 - 0.03 * (wiek - 24) - 0.012 * praca + rnorm(100, 0, 0.75)))  # minuty dziennie
dane <- data.frame(id = 1:100, tryb = tryb, wiek = wiek, praca = praca, media = media)

# Plik .sav z etykietami zmiennych i wartości oraz ten sam zbiór w CSV
sav <- dane
sav$id <- labelled(sav$id, label = "Numer osoby")
sav$tryb <- labelled(sav$tryb, labels = c("stacjonarne" = 1, "niestacjonarne" = 2), label = "Tryb studiów")
sav$wiek <- labelled(sav$wiek, label = "Wiek (lata)")
sav$praca <- labelled(sav$praca, label = "Praca zarobkowa (godziny w tygodniu)")
sav$media <- labelled(sav$media, label = "Czas w mediach społecznościowych (minuty dziennie)")
write_sav(sav, "bootstrap-spss-dane.sav")
write.csv(dane, "bootstrap-spss-dane.csv", row.names = FALSE, fileEncoding = "UTF-8")

# 0. Opis: rozkład czasu w mediach jest prawoskośny
skosnosc <- function(x) mean((x - mean(x))^3) / sd(x)^3
opis <- aggregate(media ~ tryb, dane, function(x) c(n = length(x), M = mean(x), SD = sd(x), Mdn = median(x),
                                                       skosnosc = skosnosc(x)))
print(round(do.call(cbind, opis), 2))

# 1. Independent-Samples T Test: różnica średnich (stacjonarne − niestacjonarne)
t_row <- t.test(media ~ tryb, dane, var.equal = TRUE)
t_wel <- t.test(media ~ tryb, dane, var.equal = FALSE)
cat(sprintf("\nRóżnica średnich = %.2f\n", diff(rev(t_row$estimate))))
cat(sprintf("Equal variances assumed:     t(%.0f) = %.2f, p = %.2g, 95%% CI [%.2f, %.2f]\n",
            t_row$parameter, t_row$statistic, t_row$p.value, t_row$conf.int[1], t_row$conf.int[2]))
cat(sprintf("Equal variances not assumed: t(%.2f) = %.2f, p = %.2g, 95%% CI [%.2f, %.2f]\n",
            t_wel$parameter, t_wel$statistic, t_wel$p.value, t_wel$conf.int[1], t_wel$conf.int[2]))

roznica <- function(d, i) { d <- d[i, ]; mean(d$media[d$tryb == 1]) - mean(d$media[d$tryb == 2]) }
kolumny <- function(b, indeks = 1) {                       # kolumny Bootstrap: Bias, Std. Error, CI
  ci <- suppressWarnings(boot.ci(b, conf = 0.95, type = c("perc", "bca"), index = indeks))
  round(c(Statistic = unname(b$t0[indeks]), Bias = mean(b$t[, indeks]) - unname(b$t0[indeks]), Std_Error = sd(b$t[, indeks]),
          Perc_Lower = ci$percent[4], Perc_Upper = ci$percent[5], BCa_Lower = ci$bca[4], BCa_Upper = ci$bca[5]), 2)
}
set.seed(5561)
b_prosty <- boot(dane, roznica, R = 2000)                         # Sampling: Simple
set.seed(5562)
b_warstwy <- boot(dane, roznica, R = 2000, strata = dane$tryb)    # Sampling: Stratified (strata: tryb)
print(rbind(prosty = kolumny(b_prosty), warstwowy = kolumny(b_warstwy)))
liczba_1 <- apply(boot.array(b_prosty), 1, function(w) sum(w[dane$tryb == 1]))
cat("Osoby stacjonarne w próbach prostych: min", min(liczba_1), "maks", max(liczba_1),
    "| w próbach warstwowych zawsze", unique(apply(boot.array(b_warstwy), 1, function(w) sum(w[dane$tryb == 1]))), "\n")

# 2. Explore z czynnikiem tryb: mediana w każdej grupie (BCa); różnicy median SPSS w oknach nie podaje
mediany <- function(d, i) {
  d <- d[i, ]; m1 <- median(d$media[d$tryb == 1]); m2 <- median(d$media[d$tryb == 2])
  c(m1, m2, m1 - m2)
}
set.seed(5563)
b_med <- boot(dane, mediany, R = 2000)
print(rbind(mediana_stacjonarne = kolumny(b_med, 1), mediana_niestacjonarne = kolumny(b_med, 2),
            roznica_median_tylko_R = kolumny(b_med, 3)))

# 3. Linear Regression: tabela Coefficients (B) i kolumny Bootstrap (bootstrap przypadków, czyli par)
model <- lm(media ~ wiek + praca, dane)
klasyczne <- cbind(B = coef(model), SE = summary(model)$coefficients[, 2], confint(model))
print(round(klasyczne, 3))
cat(sprintf("Skośność reszt = %.2f; R2 = %.3f\n", skosnosc(resid(model)), summary(model)$r.squared))
wspolczynniki <- function(d, i) coef(lm(media ~ wiek + praca, d[i, ]))
set.seed(5564)
b_reg <- boot(dane, wspolczynniki, R = 2000)
print(rbind(Constant = kolumny(b_reg, 1), wiek = kolumny(b_reg, 2), praca = kolumny(b_reg, 3)))
# Dlaczego bootstrapowe SE są mniejsze: wariancja reszt różni się między grupami (heteroskedastyczność),
# a bootstrap przypadków zachowuje się podobnie do błędów standardowych odpornych HC3
print(round(tapply(resid(model), dane$tryb, sd), 1))
print(round(sqrt(diag(car::hccm(model, type = "hc3"))), 2))
Wynik:
     tryb  n      M    SD   Mdn skosnosc
[1,]    1 60 143.38 96.73 118.5     0.97
[2,]    2 40  60.25 43.10  45.5     1.19

Różnica średnich = 83.13
Equal variances assumed:     t(98) = 5.10, p = 1.6e-06, 95% CI [50.80, 115.47]
Equal variances not assumed: t(87.62) = 5.84, p = 8.6e-08, 95% CI [54.86, 111.41]
          Statistic Bias Std_Error Perc_Lower Perc_Upper BCa_Lower BCa_Upper
prosty        83.13 0.40     13.73      56.75     110.66     57.00    110.72
warstwowy     83.13 0.41     14.13      56.32     111.10     56.83    111.45
Osoby stacjonarne w próbach prostych: min 43 maks 76 | w próbach warstwowych zawsze 60
                       Statistic  Bias Std_Error Perc_Lower Perc_Upper BCa_Lower BCa_Upper
mediana_stacjonarne        118.5  0.62     15.34         98        154        98    154.00
mediana_niestacjonarne      45.5  2.74     10.33         34         72        34     72.00
roznica_median_tylko_R      73.0 -2.12     18.58         33        112        36    113.75
                  B     SE   2.5 %  97.5 %
(Intercept) 204.603 40.556 124.110 285.095
wiek         -1.977  1.924  -5.795   1.842
praca        -3.246  1.252  -5.731  -0.762
Skośność reszt = 1.16; R2 = 0.164
         Statistic  Bias Std_Error Perc_Lower Perc_Upper BCa_Lower BCa_Upper
Constant    204.60 -0.15     27.14     152.37     256.48    153.45    257.55
wiek         -1.98 -0.01      1.20      -4.38       0.42     -4.36      0.46
praca        -3.25  0.02      1.08      -5.38      -1.12     -5.61     -1.33
   1    2
98.9 45.2
(Intercept)        wiek       praca
      27.79        1.19        1.07
3. Symulacja: pokrycie przedziałów przy małej próbie
R
# Kiedy bootstrap nie ratuje: pokrycie 95% przedziałów dla średniej przy silnie skośnym rozkładzie
# (rozkład logarytmiczno-normalny, prawdziwa średnia exp(0.5); 1000 zbiorów na każdą liczebność, 999 prób bootstrapowych)
suppressPackageStartupMessages(library(boot))
set.seed(5565)
mu <- exp(0.5)
pokrycie <- function(n, zbiory = 1000, B = 999) {
  trafienia <- replicate(zbiory, {
    x <- rlnorm(n)
    b <- boot(x, function(d, i) mean(d[i]), R = B)
    ci <- suppressWarnings(boot.ci(b, conf = 0.95, type = c("perc", "bca")))
    tt <- t.test(x)$conf.int
    c(t = tt[1] <= mu & mu <= tt[2],
      percentylowy = ci$percent[4] <= mu & mu <= ci$percent[5],
      BCa = ci$bca[4] <= mu & mu <= ci$bca[5])
  })
  rowMeans(trafienia)
}
wyniki <- t(sapply(c(10, 20, 40, 80, 160), pokrycie))
wyniki <- data.frame(n = c(10, 20, 40, 80, 160), round(wyniki, 3))
print(wyniki, row.names = FALSE)
Wynik:
   n     t percentylowy   BCa
  10 0.835        0.797 0.823
  20 0.866        0.856 0.881
  40 0.894        0.894 0.912
  80 0.908        0.909 0.909
 160 0.945        0.949 0.944
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki wykonano w pakiecie ggplot2 i zapisano pakietem svglite. Składni SPSS nie uruchamiano. W pracy podaj wersję SPSS lub R, której faktycznie użyłeś.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- boot (wersja 1.3-32): Canty, A., & Ripley, B. (2025). boot: Bootstrap functions [R package]. https://doi.org/10.32614/CRAN.package.boot
- haven (wersja 2.5.5): Wickham, H., Miller, E., & Smith, D. (2025). haven: Import and export 'SPSS', 'Stata' and 'SAS' files [R package]. https://doi.org/10.32614/CRAN.package.haven
- car (wersja 3.1.5): Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). Sage. https://www.john-fox.ca/Companion/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Typowe błędy i lista kontrolna
- Bootstrap bez ziarna – granice zmieniają się przy każdym uruchomieniu i nikt ich nie odtworzy.
- Szukanie ziarna „pod wynik” – kilka uruchomień i wybór najlepszego przedziału to manipulacja. Ustal ziarno i liczbę prób z góry.
- Za mało prób – poniżej 1000 przedziały percentylowe i BCa są niestabilne.
- Zapomniany bootstrap – ustawienie przechodzi na kolejne procedury i wyłącza wykresy.
- Losowanie wierszy przy pomiarach powtarzanych – zależne obserwacje wymagają innego modelu.
- Różnica median „z dwóch przedziałów” – nakładanie się przedziałów dla dwóch median nie jest testem różnicy.
- Brak w opisie metody – liczba prób, rodzaj przedziału, sposób losowania i ziarno muszą być w tekście.
Lista kontrolna: (1) procedura obsługuje bootstrap dla potrzebnej statystyki; (2) brak wielokrotnej imputacji i wag niecałkowitych; (3) co najmniej 1000 prób, lepiej 2000+; (4) ziarno ustalone przed analizą; (5) BCa lub percentylowy – świadomy wybór; (6) losowanie warstwowe, gdy grupy mają stałe liczebności; (7) niezależne obserwacje; (8) wykresy w osobnym uruchomieniu; (9) wersja SPSS w opisie.
Najczęstsze pytania
Gdzie w SPSS jest bootstrap?
Nie ma osobnego menu. Przycisk Bootstrap znajduje się w oknach procedur, które go obsługują, np. Explore, Independent-Samples T Test, One-Way ANOVA, Bivariate Correlations i Linear Regression. W jego oknie zaznacz Perform bootstrapping. Pełną listę procedur i tabel podaje dokumentacja IBM. Jeśli przycisk jest nieaktywny, sprawdź, czy zbiór nie pochodzi z wielokrotnej imputacji.
Przedział percentylowy czy BCa?
Domyślnie SPSS liczy przedział percentylowy. BCa dodaje korektę obciążenia i skośności, a dokumentacja IBM opisuje go jako dokładniejszy kosztem dłuższych obliczeń. Przy skośnych danych wybierz BCa i co najmniej 1000 prób, a do pracy raczej 2000 lub więcej. Przy medianie oba przedziały często wychodzą takie same, bo mediana z prób przyjmuje niewiele różnych wartości.
Dlaczego za każdym razem dostaję inne granice przedziału?
Bo każde uruchomienie losuje inne próby. Zaznacz Set seed for Mersenne Twister i wpisz dowolną liczbę, ustaloną przed analizą. Wtedy SPSS powtórzy te same próby. W pracy podaj liczbę prób, rodzaj przedziału i ziarno. Wyniki z R albo z innej wersji programu będą się nieco różnić, bo inny jest generator liczb losowych.
Czy bootstrap uratuje małą próbę?
Nie. Bootstrap losuje wyłącznie z osób, które już masz. W naszej symulacji przy 10 obserwacjach ze skośnego rozkładu 95-procentowy przedział percentylowy obejmował prawdziwą średnią tylko w 79.7% prób, czyli rzadziej niż zwykły przedział t (83.5%). Przewaga bootstrapu pojawia się dopiero przy większych próbach.
Dlaczego po włączeniu bootstrapu zniknęły wykresy?
Dokumentacja IBM podaje, że przy włączonym bootstrapie SPSS nie tworzy wykresów. Ustawienie zostaje też włączone w kolejnych procedurach. Wykresy reszt czy histogramy zrób w osobnym uruchomieniu, po odznaczeniu Perform bootstrapping.
Powiązane hasła
Przeczytaj też
Bootstrap i test permutacyjny krok po kroku
Bootstrap różnicy median i korelacji z BCa, test permutacyjny zamiast testu t, liczba permutacji i kiedy bootstrap zawodzi – na jednym przykładzie w R.
Czytaj →PoradnikAnaliza na małej próbie
Moc i szerokość CI przy 10–30 osobach, przeszacowane efekty, test permutacyjny, Fisher i bootstrap oraz wzór opisu ograniczenia – na pilotażu 10 + 10 w R.
Czytaj →PoradnikKorelacja i regresja w SPSS
Bivariate i Linear Regression krok po kroku: które opcje zaznaczyć, jak czytać Model Summary, Coefficients i Collinearity Diagnostics, wykresy reszt i zapis APA.
Czytaj →Promotor kazał „policzyć bootstrap”, a Ty nie wiesz, co wpisać w okno?
Sprawdzimy, czy bootstrap pasuje do Twoich danych i pytania, ustawimy liczbę prób, ziarno i rodzaj przedziału oraz przygotujemy opis wyników i wyjaśnimy je tak, żebyś umiał(a) samodzielnie je przedstawić i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Efron, B. (1987). Better bootstrap confidence intervals. Journal of the American Statistical Association, 82(397), 171–185. https://doi.org/10.1080/01621459.1987.10478410
- Hesterberg, T. C. (2015). What teachers should know about the bootstrap: Resampling in the undergraduate statistics curriculum. The American Statistician, 69(4), 371–386. https://doi.org/10.1080/00031305.2015.1089789 ● Otwarty dostęp
- IBM Corp. (b.d.-a). Bootstrapping. IBM SPSS Statistics 32.0.0 documentation. https://www.ibm.com/docs/en/SSLVMB_32.0.0/statistics_mainhelp_ddita/spss/bootstrapping/idh_idd_bootstrap.html ● Otwarty dostęp
- IBM Corp. (b.d.-b). Procedures that support bootstrapping. IBM SPSS Statistics 32.0.0 documentation. https://www.ibm.com/docs/en/SSLVMB_32.0.0/statistics_mainhelp_ddita/spss/bootstrapping/bootstrap_analysis.html ● Otwarty dostęp
- IBM Corp. (b.d.-c). Using bootstrapping to obtain confidence intervals for medians (case studies). IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_casestudies_project_ddita/spss/tutorials/bootstrap_employee01_intro.html ● Otwarty dostęp
- IBM Corp. (b.d.-d). BOOTSTRAP (Command Syntax Reference). IBM SPSS Statistics 32.0.0 documentation. https://www.ibm.com/docs/en/SSLVMB_32.0.0/statistics_reference_project_ddita/spss/bootstrapping/syn_bootstrap.html ● Otwarty dostęp
- Rajh-Weber, H., Huber, S. E., & Arendasy, M. (2026). Using heteroskedasticity-consistent standard errors and the bootstrap for linear regression analysis available in SPSS: A tutorial. Advances in Methods and Practices in Psychological Science, 9(1), Article 25152459251408046. https://doi.org/10.1177/25152459251408046 ● Otwarty dostęp
Cytowania BibTeX
@article{efron1987better, author={Efron, Bradley}, title={{Better bootstrap confidence intervals}}, journal={Journal of the American Statistical Association}, year={1987}, volume={82}, number={397}, pages={171--185}, doi={10.1080/01621459.1987.10478410}}@article{hesterberg2015what, author={Hesterberg, Tim C.}, title={{What teachers should know about the bootstrap: Resampling in the undergraduate statistics curriculum}}, journal={The American Statistician}, year={2015}, volume={69}, number={4}, pages={371--386}, doi={10.1080/00031305.2015.1089789}}@misc{ibmnd32bootstrapokno, author={{IBM Corp.}}, title={{Bootstrapping}}, howpublished={IBM SPSS Statistics 32.0.0 documentation}, year={b.d.-a}, publisher={IBM}, url={https://www.ibm.com/docs/en/SSLVMB_32.0.0/statistics_mainhelp_ddita/spss/bootstrapping/idh_idd_bootstrap.html}}@misc{ibmnd32bootstrapprocedury, author={{IBM Corp.}}, title={{Procedures that support bootstrapping}}, howpublished={IBM SPSS Statistics 32.0.0 documentation}, year={b.d.-b}, publisher={IBM}, url={https://www.ibm.com/docs/en/SSLVMB_32.0.0/statistics_mainhelp_ddita/spss/bootstrapping/bootstrap_analysis.html}}@misc{ibmnd31bootstrapstudium, author={{IBM Corp.}}, title={{Using bootstrapping to obtain confidence intervals for medians (case studies)}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-c}, publisher={IBM}, url={https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_casestudies_project_ddita/spss/tutorials/bootstrap_employee01_intro.html}}@misc{ibmnd32bootstrapskladnia, author={{IBM Corp.}}, title={{BOOTSTRAP (Command Syntax Reference)}}, howpublished={IBM SPSS Statistics 32.0.0 documentation}, year={b.d.-d}, publisher={IBM}, url={https://www.ibm.com/docs/en/SSLVMB_32.0.0/statistics_reference_project_ddita/spss/bootstrapping/syn_bootstrap.html}}@article{rajhweber2026using, author={Rajh-Weber, Hanna and Huber, Stefan Ernest and Arendasy, Martin}, title={{Using heteroskedasticity-consistent standard errors and the bootstrap for linear regression analysis available in SPSS: A tutorial}}, journal={Advances in Methods and Practices in Psychological Science}, year={2026}, volume={9}, number={1}, eid={25152459251408046}, doi={10.1177/25152459251408046}}