Do czego służy MIXED
Procedura Linear Mixed Models (w składni: MIXED) rozszerza ogólny model liniowy: pozwala modelować nie tylko średnie, lecz także wariancje i kowariancje danych (IBM Corp., b.d.-a). W pracy dyplomowej przydaje się zwykle w badaniu z grupami i kilkoma pomiarami tych samych osób, gdy ktoś opuścił pomiar. ANOVA z powtarzanymi pomiarami w SPSS usuwa wtedy całą osobę. Model mieszany wykorzystuje wszystkie dostępne pomiary i wprost uwzględnia ich korelację (Gueorguieva i Krystal, 2004). Kiedy wybrać który model, wyjaśnia wpis ANOVA z powtarzanymi pomiarami czy model mieszany.
Nazwy menu, okien i tabel sprawdziliśmy w dokumentacji IBM SPSS Statistics 31 (IBM Corp., b.d.-a, b.d.-b, b.d.-c) i podajemy po angielsku. Procedura wymaga wersji Standard Edition albo modułu Advanced Statistics. Polska dokumentacja nazywa ją „Liniowe modele mieszane”; etykiety polskiego interfejsu mogą się różnić. Ogólne zasady czytania wydruku opisuje wpis jak czytać wyniki z SPSS.
Przykład i pliki do pobrania
Dane są fikcyjne. 60 osób studiujących wylosowano do warsztatów oswajania ze statystyką (n = 30) albo do grupy kontrolnej (n = 30). Lęk przed statystyką (0–60 pkt) zmierzono trzy razy: przed, po 8 tygodniach i po kolejnych 3 miesiącach. Na pomiar „po” nie przyszły 4 osoby, a na pomiar „po 3 mies.” – 9. Pełne dane ma 47 osób, a 13 osób ma dwa pomiary. Czy grupy różnią się zmianą lęku w czasie?
Pobierz plik .sav z etykietami zmiennych i wartości albo ten sam zbiór w CSV. Plik ma 167 wierszy i zmienne id, grupa (1 = warsztaty, 2 = kontrolna), czas (1 = przed, 2 = po, 3 = po 3 mies.) i lek.
Format długi zamiast szerokiego
GLM Repeated Measures wymaga jednego wiersza na osobę i osobnej kolumny na każdy pomiar. MIXED potrzebuje formatu długiego: jeden wiersz to jeden pomiar jednej osoby. Brakujący pomiar to po prostu brak wiersza, a osoba z dwoma pomiarami zostaje w analizie. Plik szeroki przekształcisz kreatorem Data → Restructure, wybierając Restructure selected variables into cases (IBM Corp., b.d.-d). Kolumny pomiarów trafiają do listy Variable to be Transposed, a zmienna indeksu staje się naszym czas. Zmienna zależna powinna być ilościowa, a czynniki – jakościowe (IBM Corp., b.d.-a).
Okna procedury krok po kroku
- Analyze → Mixed Models → Linear (IBM Corp., b.d.-a).
- Specify Subjects and Repeated. Do listy Subjects przenieś
id. W modelu z losowym wyrazem wolnym pole Repeated zostaw puste. W modelu ze strukturą kowariancji reszt przenieś tamczasi wybierz Repeated Covariance Type, np. AR(1), Compound Symmetry albo Unstructured. Dokumentacja wymienia ponad 20 struktur. - Okno główne. Jako zmienną zależną wybierz
lek, agrupaiczaswskaż jako czynniki (factors). - Fixed. Dokumentacja podkreśla, że nie ma tu modelu domyślnego (IBM Corp., b.d.-a). W Build terms zaznacz oba czynniki, wybierz metodę budowania członów i kliknij Add, tak by model objął
grupa,czasigrupa*czas. Zostaw Include Intercept i Type III. - Random. Tylko w modelu z losowym wyrazem wolnym. Zaznacz Include intercept, a w grupie Subject Groupings wybierz
id. W składni domyślny Covariance type to Variance Components (IBM Corp., b.d.-c). - Estimation. Wybierasz metodę (REML albo ML) i stopnie swobody: Residual method, Satterthwaite approximation albo Kenward-Roger approximation. W składni domyślne są REML i Satterthwaite (IBM Corp., b.d.-c).
- Statistics. Zaznacz Descriptive statistics, Parameter estimates for fixed effects i Tests for covariance parameters. Przy Repeated dodaj Covariances of residuals, a przy efekcie losowym – Covariances of random effects (IBM Corp., b.d.-a).
- EM Means. Przenieś
grupa*czasdo Display Means for. Okno porównuje tylko poziomy efektów głównych (Compare Main Effects). Porównanie grup w każdym pomiarze zamówisz w składni (COMPARE(grupa), przepis 1).
Wyniki pokazujemy w tabelach o układzie tabel SPSS. Liczby policzono w R tymi samymi metodami co SPSS; układ tabeli jak w SPSS. Nazwy tabel i kolumn tabeli testów wzięliśmy z przykładów IBM (IBM Corp., b.d.-b). Pozostałe nagłówki odtworzyliśmy z typowego wydruku.
Krok 1: model pusty i ICC
Najpierw uruchom model bez predyktorów: w Fixed nic nie dodawaj, a w Random zostaw sam losowy wyraz wolny osoby. Tabela Estimates of Covariance Parameters pokaże dwie wariancje: między osobami (wyraz wolny) i wewnątrz osób (reszta).
| Parametr | Estimate |
|---|---|
| Reszta (Residual) | 39.068 |
| Wariancja wyrazu wolnego osoby (subject = id) | 41.698 |
ICC = 41.698 / (41.698 + 39.068) = .52. Około połowy zmienności lęku to stałe różnice między osobami, więc pomiary tej samej osoby są wyraźnie skorelowane. Według opisu składni od wersji 29 wydruk MIXED zawiera ICC i miary pseudo-R², „gdy jest to właściwe” (IBM Corp., b.d.-c). Jeśli twoja wersja go nie wypisuje, policz go ręcznie jak wyżej.
Krok 2: losowy wyraz wolny
Teraz dodaj w Fixed efekty grupa, czas i grupa*czas, a efekt losowy zostaw bez zmian. Tabela Model Dimension wypisuje dla każdego efektu liczbę poziomów i parametrów, strukturę kowariancji oraz zmienną definiującą osoby (IBM Corp., b.d.-b). Tu 6 parametrów efektów stałych i 2 parametry kowariancji. −2 Restricted Log Likelihood z tabeli Information Criteria wynosi w R 1116.42.
| Source | Numerator df | Denominator df | F | Sig. |
|---|---|---|---|---|
| grupa | 1 | 58.934 | 6.248 | .015 |
| czas | 2 | 106.086 | 10.261 | .000 |
| grupa * czas | 2 | 106.086 | 6.174 | .003 |
Najważniejsza jest interakcja: grupy różnią się przebiegiem zmian. Ułamkowe Denominator df wynikają z przybliżenia Satterthwaite’a. Luke (2017) pokazał w symulacjach, że REML z tym przybliżeniem albo z Kenwardem–Rogerem daje odsetek błędów I rodzaju najbliższy .05. Pakiet lmerTest liczy tę samą metodę, ale IBM nie podaje wzoru na stronach HTML, więc ostatnie miejsca po przecinku mogą się różnić.
| Parameter | Estimate | Std. Error | df | t | Sig. | 95% Confidence Interval | |
|---|---|---|---|---|---|---|---|
| Lower Bound | Upper Bound | ||||||
| Intercept | 37.436 | 1.602 | 114.241 | 23.369 | .000 | 34.262 | 40.609 |
| [grupa=1] | −5.569 | 2.280 | 115.769 | −2.443 | .016 | −10.084 | −1.054 |
| [czas=1] | −.369 | 1.506 | 105.895 | −.245 | .807 | −3.354 | 2.616 |
| [czas=2] | −1.530 | 1.562 | 107.703 | −.980 | .329 | −4.626 | 1.566 |
| [grupa=1] * [czas=1] | 4.969 | 2.144 | 106.135 | 2.317 | .022 | .718 | 9.220 |
| [grupa=1] * [czas=2] | −2.108 | 2.197 | 107.350 | −.960 | .339 | −6.462 | 2.247 |
Tę tabelę czytaj ostrożnie. Ostatnia kategoria każdego czynnika jest nadmiarowa, ma parametr 0 i służy jako odniesienie (IBM Corp., b.d.-b). Odniesieniem są więc grupa kontrolna i pomiar „po 3 mies.”. [grupa=1] = −5.57 to różnica grup w ostatnim pomiarze, a nie efekt „ogólny”. [grupa=1] * [czas=1] = 4.97 mówi, o ile różnica przed warsztatami była większa niż po 3 miesiącach: −0.60 − (−5.57). Pytania o konkretne pomiary łatwiej zadać przez EM Means (krok 4).
W tym modelu wariancja wyrazu wolnego wynosi 39.757, a reszt 30.775. Losowy wyraz wolny zakłada, że każde dwa pomiary osoby korelują tak samo: 39.757 / (39.757 + 30.775) = .56.
Krok 3: struktura kowariancji pomiarów
Pomiary bliskie w czasie zwykle korelują silniej niż odległe. Littell i in. (1998) podkreślają, że przy pomiarach powtarzanych warto tę strukturę modelować, bo od niej zależą poprawne błędy standardowe. W SPSS robisz to w oknie Specify Subjects and Repeated: czas do pola Repeated i wybór Repeated Covariance Type. Okno Random zostaje wtedy puste. Bez REPEATED reszty mają strukturę Scaled Identity. W składni domyślną strukturą dla REPEATED jest Diagonal (IBM Corp., b.d.-c).
| Model kowariancji | Parametry kowariancji | −2 Restricted Log Likelihood | AIC |
|---|---|---|---|
| Random: losowy wyraz wolny | 2 | 1116.42 | 1120.42 |
| Repeated: Compound Symmetry | 2 | 1116.42 | 1120.42 |
| Repeated: AR(1) | 2 | 1107.67 | 1111.67 |
| Repeated: Unstructured | 6 | 1102.93 | 1114.93 |
Tabela Information Criteria zawiera −2 Restricted Log Likelihood, AIC, AICC, BIC i CAIC. Mniejsza wartość oznacza lepszy model (IBM Corp., b.d.-b). AIC policzyliśmy jako −2RLL + 2 × liczba parametrów kowariancji. Jeśli SPSS dolicza też parametry efektów stałych, wszystkie AIC przesuną się o tę samą liczbę, więc porównuj różnice. Kryteria z REML porównuj tylko przy tych samych efektach stałych.
Losowy wyraz wolny i Compound Symmetry dają to samo −2RLL, bo przy dodatniej korelacji to ten sam model. AR(1) ma najmniejsze AIC. Unstructured szacuje 6 parametrów, a nie jest istotnie lepsza od AR(1). Test ilorazu wiarygodności liczysz ręcznie jak w przykładzie IBM: różnica −2RLL, df = różnica liczby parametrów (IBM Corp., b.d.-b). Dla AR(1) wobec UN: 1107.67 − 1102.93 = 4.74, df = 4, p = .315. Dla CS wobec UN: χ²(4) = 13.50, p = .009. Wybieramy AR(1). Rysunek 1 pokazuje, skąd ta różnica.
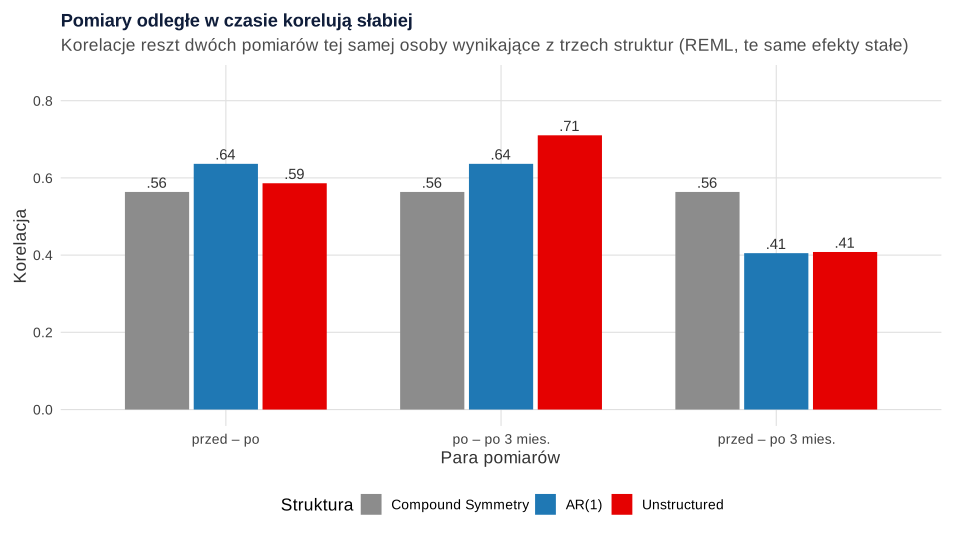
W modelu Unstructured tabela Estimates of Covariance Parameters podaje wprost elementy macierzy. UN(1,1) to wariancja w pierwszym pomiarze, a UN(2,1) – kowariancja pomiarów 1 i 2 (IBM Corp., b.d.-b). U nas wariancje rosną z 52.54 do 83.09. Korelacja przed–po wynosi .59, a przed–po 3 mies. tylko .41. W AR(1) tabela ma dwa parametry: wspólną wariancję (69.549) i autokorelację sąsiednich pomiarów (ρ = .636). Testy Walda tych parametrów opierają się na asymptotycznych błędach standardowych (IBM Corp., b.d.-a), więc przy małej próbie traktuj je ostrożnie.
Przy dwóch pomiarach przed–po wybór struktury niewiele zmienia. Przykład IBM z dietą pokazuje, że test efektu czasu w modelu z REPEATED i strukturą Unstructured odpowiada wtedy testowi t dla prób zależnych (IBM Corp., b.d.-b). Przy dwóch pomiarach i grupie kontrolnej rozważ też ANCOVA z pomiarem wyjściowym jako kowariantą.
Krok 4: model końcowy i średnie brzegowe
| Source | Numerator df | Denominator df | F | Sig. |
|---|---|---|---|---|
| grupa | 1 | 62.82 | 6.107 | .016 |
| czas | 2 | 101.36 | 13.665 | .000 |
| grupa * czas | 2 | 101.36 | 7.105 | .001 |
Dla modelu z REPEATED df liczył pakiet emmeans. Oszacowania i błędy standardowe pochodzą z tego samego estymatora REML co w SPSS, ale df mogą się różnić w częściach dziesiętnych. Interakcja pozostaje wyraźna. Teraz sprawdź, w których pomiarach grupy się różnią. Średnie brzegowe to średnie przewidywane przez model, a nie obserwowane. Porównanie z COMPARE podaje różnicę, błąd standardowy, df, istotność i przedział ufności (IBM Corp., b.d.-c).
| czas | (I) grupa | (J) grupa | Mean Difference (I-J) | Std. Error | df | Sig. | 95% Confidence Interval for Difference | |
|---|---|---|---|---|---|---|---|---|
| Lower Bound | Upper Bound | |||||||
| przed | warsztaty | kontrolna | −.600 | 2.153 | 105.09 | .781 | −4.870 | 3.670 |
| po | warsztaty | kontrolna | −7.629 | 2.186 | 110.09 | .001 | −11.962 | −3.297 |
| po 3 mies. | warsztaty | kontrolna | −5.323 | 2.264 | 116.39 | .020 | −9.807 | −.839 |
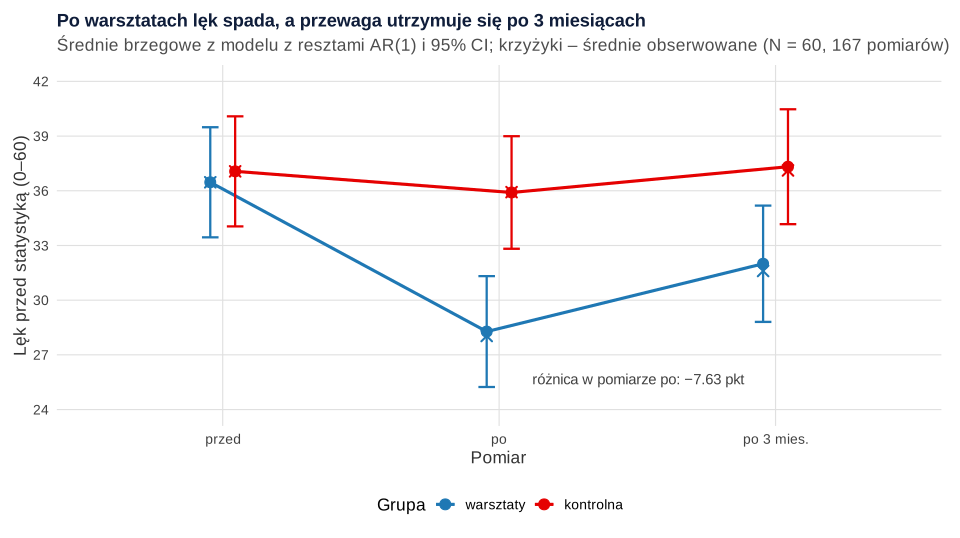
Przed warsztatami grupy startowały z tego samego poziomu (różnica −0.60 pkt). Po 8 tygodniach grupa warsztatowa miała o 7.63 pkt niższy lęk, a po 3 miesiącach różnica wynosiła 5.32 pkt. Przy brakach średnie brzegowe odbiegają od obserwowanych: w grupie warsztatowej w pomiarze „po” 28.28 wobec 28.03, bo model korzysta też z innych pomiarów osób z brakami. Rysunek 2 zestawia obie.
Porównania w trzech pomiarach to trzy testy. Jeśli nie zostały zaplanowane jako główne, użyj korekty ADJ(BONFERRONI) albo ADJ(SIDAK). Dokumentacja dopuszcza też porównania z kategorią odniesienia (REFCAT).
Losowe nachylenie i REML a ML
Przy kilku pomiarach w różnych odstępach czasu czas często wpisuje się jako kowariantę i dodaje losowe nachylenie: w oknie Random zaznaczasz Include intercept i dodajesz kowariantę czasu. Przykład IBM z dietą tak buduje model losowych współczynników, ze strukturą Unstructured dla wyrazu wolnego i nachylenia (IBM Corp., b.d.-b). Przy trzech pomiarach na osobę taki model łatwo przestaje się zbiegać. Modele z czasem jako zmienną ciągłą opisuje wpis modele wzrostu w lme4.
REML jest domyślne i właściwe do raportowania oszacowań. ML przyda się, gdy porównujesz testem ilorazu wiarygodności modele z różnymi efektami stałymi.
Zapis wyników w stylu APA
W Metodzie podaj program i procedurę, efekty stałe, strukturę kowariancji i powód jej wyboru, metodę estymacji i stopnie swobody. Opisz też, ile osób miało niepełne dane i jakie założenie o brakach przyjmujesz (MAR). Wzór do dostosowania:
Tabelę efektów stałych i parametrów kowariancji przygotujesz według wpisu jak opisać wyniki modelu mieszanego. Zdania do innych analiz przygotuje generator opisu wyników APA.
Składnia SPSS i kod R
Przepis 1 to składnia do wklejenia w edytorze składni SPSS. Napisaliśmy ją według wykresu składni MIXED i opisu podkomend CRITERIA, FIXED, METHOD, PRINT, RANDOM, REPEATED i EMMEANS w Command Syntax Reference (IBM Corp., b.d.-c), ale nie uruchamialiśmy jej w SPSS. Przepis 2 tworzy fikcyjne dane i pliki do pobrania. Przepis 3 liczy wszystkie liczby z tabel: model pusty i losowy wyraz wolny w lmerTest (REML, df Satterthwaite’a), struktury CS, AR(1) i UN w nlme oraz średnie brzegowe w emmeans. Uruchom przepisy po kolei w folderze, w którym ma powstać plik CSV.
1. Składnia SPSS: MIXED z RANDOM, REPEATED i EMMEANS
SPSS
* Składnia zgodna z opisem MIXED w Command Syntax Reference; nie była uruchamiana w SPSS.
* Plik model-mieszany-spss-dane.sav w formacie długim (jeden wiersz = jeden pomiar).
* Krok 1. Model pusty: losowy wyraz wolny osoby (ICC z Estimates of Covariance Parameters).
MIXED lek
  /METHOD=REML
  /PRINT=SOLUTION TESTCOV
  /RANDOM=INTERCEPT | SUBJECT(id) COVTYPE(VC).

* Krok 2. Grupa, pomiar i interakcja z losowym wyrazem wolnym.
MIXED lek BY grupa czas
  /CRITERIA=DFMETHOD(SATTERTHWAITE)
  /FIXED=grupa czas grupa*czas | SSTYPE(3)
  /METHOD=REML
  /PRINT=DESCRIPTIVES SOLUTION TESTCOV G
  /RANDOM=INTERCEPT | SUBJECT(id) COVTYPE(VC).

* Krok 3 i 4. Struktura kowariancji reszt AR(1) i różnice grup w każdym pomiarze.
* Do porównania zmień COVTYPE(AR1) na COVTYPE(CS) albo COVTYPE(UN) i zestaw tabele Information Criteria.
MIXED lek BY grupa czas
  /CRITERIA=DFMETHOD(SATTERTHWAITE)
  /FIXED=grupa czas grupa*czas | SSTYPE(3)
  /METHOD=REML
  /PRINT=SOLUTION TESTCOV R
  /REPEATED=czas | SUBJECT(id) COVTYPE(AR1)
  /EMMEANS=TABLES(grupa*czas) COMPARE(grupa) ADJ(LSD).
2. Dane w formacie długim i pliki .sav oraz CSV
R
# B535 – model mieszany (MIXED) w SPSS: dane do pobrania w formacie długim
# Dane symulowane, set.seed(5350): lęk przed statystyką (skala 0–60) u 60 osób studiujących,
# losowo przydzielonych do warsztatów (n = 30) albo grupy kontrolnej (n = 30).
# Trzy pomiary: przed (czas = 1), po 8 tygodniach (czas = 2) i 3 miesiące później (czas = 3).
# Część osób nie przyszła na pomiar 2 lub 3 – w formacie długim te wiersze po prostu nie istnieją.
suppressPackageStartupMessages(library(haven))
set.seed(5350)
n <- 60
grupa <- rep(1:2, each = n / 2)                     # 1 = warsztaty, 2 = kontrolna
sr <- rbind(c(38, 30, 32),                          # średnie w populacji: warsztaty
            c(38, 36, 36))                          # kontrolna
odch <- c(8, 9, 10)                                 # odchylenia rosną w czasie
kor <- matrix(c(1, .70, .50,
                .70, 1, .70,
                .50, .70, 1), 3)                    # bliższe pomiary silniej skorelowane
S <- diag(odch) %*% kor %*% diag(odch)
Y <- t(sapply(1:n, function(i) MASS::mvrnorm(1, sr[grupa[i], ], S)))
Y[] <- round(pmin(60, pmax(0, Y)))
szer <- data.frame(id = 1:n, grupa = grupa, y1 = Y[, 1], y2 = Y[, 2], y3 = Y[, 3])
szer$y2[sample(n, 4)] <- NA                         # 4 osoby bez pomiaru po warsztatach
szer$y3[sample(which(!is.na(szer$y2)), 9)] <- NA    # 9 osób bez pomiaru po 3 miesiącach

# Format długi: jeden wiersz = jeden pomiar jednej osoby; braki usuwamy
dl <- data.frame(id = rep(szer$id, each = 3), grupa = rep(szer$grupa, each = 3),
                 czas = rep(1:3, n), lek = as.vector(t(szer[, c("y1", "y2", "y3")])))
dl <- dl[!is.na(dl$lek), ]
rownames(dl) <- NULL

sav <- dl
sav$id <- labelled(sav$id, label = "Numer osoby")
sav$grupa <- labelled(sav$grupa, labels = c("warsztaty" = 1, "kontrolna" = 2), label = "Grupa")
sav$czas <- labelled(sav$czas, labels = c("przed" = 1, "po" = 2, "po 3 mies." = 3), label = "Pomiar")
sav$lek <- labelled(sav$lek, label = "Lęk przed statystyką (0–60)")
write_sav(sav, "model-mieszany-spss-dane.sav")
write.csv(dl, "model-mieszany-spss-dane.csv", row.names = FALSE, fileEncoding = "UTF-8")

cat("wierszy w formacie długim:", nrow(dl), "; osób:", length(unique(dl$id)), "\n")
print(table(pomiary_na_osobe = table(dl$id)))
print(head(dl, 6), row.names = FALSE)
# Descriptive Statistics: N, średnia i odchylenie w każdej kombinacji grupa × czas
opis <- aggregate(lek ~ grupa + czas, data = dl, FUN = function(x) c(N = length(x), M = mean(x), SD = sd(x)))
print(do.call(data.frame, opis), digits = 4, row.names = FALSE)
Wynik:
wierszy w formacie długim: 167 ; osób: 60
pomiary_na_osobe
 2  3
13 47
 id grupa czas lek
  1     1    1  41
  1     1    2  40
  2     1    1  38
  2     1    2  23
  2     1    3  28
  3     1    1  36
 grupa czas lek.N lek.M lek.SD
     1    1    30 36.47  6.516
     2    1    30 37.07  7.913
     1    2    29 28.03 10.547
     2    2    27 35.93  6.551
     1    3    25 31.60 10.603
     2    3    26 37.12  7.825
3. Te same liczby co w tabelach MIXED
R
# B535 – liczby do tabel w układzie Linear Mixed Models (MIXED) w SPSS
# Ustawienia jak domyślne w MIXED: estymacja REML, stopnie swobody Satterthwaite'a, sumy kwadratów typu III;
# w Estimates of Fixed Effects ostatnia kategoria czynnika (kontrolna, czas = 3) jest kategorią odniesienia.
suppressPackageStartupMessages({ library(lme4); library(lmerTest); library(nlme); library(emmeans) })
emm_options(msg.interaction = FALSE, lmer.df = "satterthwaite")
dl <- read.csv("model-mieszany-spss-dane.csv")
dl$grupa <- factor(dl$grupa, levels = 1:2, labels = c("warsztaty", "kontrolna"))
dl$czas <- factor(dl$czas, levels = 1:3, labels = c("przed", "po", "po3m"))
dl$t <- as.integer(dl$czas)                          # numer pomiaru dla struktur AR(1) i UN
ostatnia <- function(f) { k <- nlevels(f); contr.treatment(k, base = k) }
kontr <- list(grupa = ostatnia(dl$grupa), czas = ostatnia(dl$czas))

# Krok 1. Model pusty: tylko wyraz wolny i losowy wyraz wolny osoby -> ICC z Estimates of Covariance Parameters
m0 <- lmer(lek ~ 1 + (1 | id), data = dl, REML = TRUE)
vc0 <- as.data.frame(VarCorr(m0))
print(vc0[, c("grp", "vcov")], digits = 6, row.names = FALSE)
cat(sprintf("ICC = %.3f\n", vc0$vcov[1] / sum(vc0$vcov)))

# Krok 2. Model z losowym wyrazem wolnym: grupa, czas, grupa*czas
m1 <- lmer(lek ~ grupa * czas + (1 | id), data = dl, REML = TRUE, contrasts = kontr)
# Type III Tests of Fixed Effects (Numerator df, Denominator df, F, Sig.)
print(anova(m1, type = 3, ddf = "Satterthwaite"), digits = 5)
# Estimates of Fixed Effects: Estimate, Std. Error, df, t, Sig., 95% CI z tych samych df
wsp <- summary(m1, ddf = "Satterthwaite")$coefficients
q <- qt(.975, wsp[, "df"])
print(round(cbind(wsp, lower = wsp[, 1] - q * wsp[, 2], upper = wsp[, 1] + q * wsp[, 2]), 3))
vc1 <- as.data.frame(VarCorr(m1))
print(vc1[, c("grp", "vcov")], digits = 6, row.names = FALSE)
cat(sprintf("-2 Restricted Log Likelihood = %.3f\n", REMLcrit(m1)))

# Krok 3. Struktury kowariancji reszt (okno Subjects and Repeated: Repeated = czas, Subjects = id), REML
# Te same efekty stałe, więc modele wolno porównać kryteriami informacyjnymi z REML.
g_cs  <- gls(lek ~ grupa * czas, data = dl, method = "REML", correlation = corCompSymm(form = ~ t | id))
g_ar1 <- gls(lek ~ grupa * czas, data = dl, method = "REML", correlation = corAR1(form = ~ t | id))
g_un  <- gls(lek ~ grupa * czas, data = dl, method = "REML", correlation = corSymm(form = ~ t | id),
             weights = varIdent(form = ~ 1 | czas))
l_ri  <- lme(lek ~ grupa * czas, random = ~ 1 | id, data = dl, method = "REML")
ic <- function(m, nazwa, k) data.frame(model = nazwa, param_kow = k, m2RLL = -2 * as.numeric(logLik(m)),
                                     AIC = -2 * as.numeric(logLik(m)) + 2 * k)
tab_ic <- rbind(ic(l_ri, "losowy wyraz wolny (Random)", 2), ic(g_cs, "Repeated: Compound Symmetry", 2),
                ic(g_ar1, "Repeated: AR(1)", 2), ic(g_un, "Repeated: Unstructured", 6))
print(tab_ic, digits = 6, row.names = FALSE)
# Test ilorazu wiarygodności UN vs CS na -2RLL (te same efekty stałe)
lr <- tab_ic$m2RLL[2] - tab_ic$m2RLL[4]
cat(sprintf("LR = %.3f, df = 4, p = %s\n", lr, sub("^0", "", sprintf("%.4f", pchisq(lr, 4, lower.tail = FALSE)))))

# AR(1) jest szczególnym przypadkiem UN: test ilorazu wiarygodności AR(1) vs UN
lr2 <- tab_ic$m2RLL[3] - tab_ic$m2RLL[4]
cat(sprintf("LR = %.3f, df = 4, p = %s\n", lr2, sub("^0", "", sprintf("%.4f", pchisq(lr2, 4, lower.tail = FALSE)))))

# Krok 4. Macierz kowariancji reszt w modelu UN: wariancje UN(1,1), UN(2,2), UN(3,3) i kowariancje,
# a obok korelacje – maleją wraz z odległością pomiarów
V <- getVarCov(g_un, individual = dl$id[dl$t == 3][1])
print(round(V, 3))
print(round(cov2cor(V), 3))
# Parametry AR(1): wspólna wariancja reszt i autokorelacja rho
cat(sprintf("AR(1): wariancja = %.3f, rho = %.3f\n", g_ar1$sigma^2,
            coef(g_ar1$modelStruct$corStruct, unconstrained = FALSE)))

# Krok 5. Model końcowy AR(1): testy efektów stałych; przybliżone df Satterthwaite'a dla gls liczy emmeans
print(joint_tests(g_ar1, mode = "satterthwaite"), digits = 5)
# EM Means: TABLES(grupa*czas) COMPARE(grupa) – różnica grup w każdym pomiarze (LSD = bez korekty)
em <- emmeans(g_ar1, ~ grupa | czas, mode = "satterthwaite")
print(summary(em), digits = 5)
print(summary(pairs(em), infer = TRUE), digits = 5)
# Ta sama różnica w modelu z losowym wyrazem wolnym – dla porównania
em1 <- emmeans(m1, ~ grupa | czas)
print(summary(pairs(em1), infer = TRUE), digits = 5)
Wynik:
      grp    vcov
       id 41.6980
 Residual 39.0684
ICC = 0.516
Type III Analysis of Variance Table with Satterthwaite's method
           Sum Sq Mean Sq NumDF   DenDF F value    Pr(>F)
grupa      192.27  192.27     1  58.934  6.2475  0.015242 *
czas       631.56  315.78     2 106.086 10.2608 8.437e-05 ***
grupa:czas 380.00  190.00     2 106.086  6.1738  0.002908 **
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
             Estimate Std. Error      df t value Pr(>|t|)   lower  upper
(Intercept)    37.436      1.602 114.241  23.369    0.000  34.262 40.609
grupa1         -5.569      2.280 115.769  -2.443    0.016 -10.084 -1.054
czas1          -0.369      1.506 105.895  -0.245    0.807  -3.354  2.616
czas2          -1.530      1.562 107.703  -0.980    0.329  -4.626  1.566
grupa1:czas1    4.969      2.144 106.135   2.317    0.022   0.718  9.220
grupa1:czas2   -2.108      2.197 107.350  -0.960    0.339  -6.462  2.247
      grp    vcov
       id 39.7573
 Residual 30.7753
-2 Restricted Log Likelihood = 1116.422
                       model param_kow   m2RLL     AIC
 losowy wyraz wolny (Random)         2 1116.42 1120.42
 Repeated: Compound Symmetry         2 1116.42 1120.42
             Repeated: AR(1)         2 1107.67 1111.67
      Repeated: Unstructured         6 1102.93 1114.93
LR = 13.497, df = 4, p = .0091
LR = 4.743, df = 4, p = .3147
Marginal variance covariance matrix
       [,1]   [,2]   [,3]
[1,] 52.540 37.375 26.967
[2,] 37.375 77.374 56.959
[3,] 26.967 56.959 83.093
  Standard Deviations: 7.2484 8.7962 9.1155
Marginal variance covariance matrix
      [,1]  [,2]  [,3]
[1,] 1.000 0.586 0.408
[2,] 0.586 1.000 0.710
[3,] 0.408 0.710 1.000
  Standard Deviations: 1 1 1
AR(1): wariancja = 69.549, rho = 0.636
 model term df1    df2 F.ratio p.value
 grupa        1  62.82   6.107  0.0162
 czas         2 101.36  13.665 <0.0001
 grupa:czas   2 101.36   7.105  0.0013

czas = przed:
 grupa     emmean     SE     df lower.CL upper.CL
 warsztaty 36.467 1.5226 105.09   33.448   39.486
 kontrolna 37.067 1.5226 105.09   34.048   40.086

czas = po:
 grupa     emmean     SE     df lower.CL upper.CL
 warsztaty 28.277 1.5337 107.48   25.237   31.317
 kontrolna 35.906 1.5582 112.65   32.819   38.994

czas = po3m:
 grupa     emmean     SE     df lower.CL upper.CL
 warsztaty 31.998 1.6108 117.74   28.808   35.187
 kontrolna 37.320 1.5911 115.02   34.169   40.472

Degrees-of-freedom method: satterthwaite
Confidence level used: 0.95
czas = przed:
 contrast              estimate     SE     df lower.CL upper.CL t.ratio p.value
 warsztaty - kontrolna  -0.6000 2.1533 105.09  -4.8695  3.66951  -0.279  0.7811

czas = po:
 contrast              estimate     SE     df lower.CL upper.CL t.ratio p.value
 warsztaty - kontrolna  -7.6293 2.1863 110.09 -11.9621 -3.29650  -3.490  0.0007

czas = po3m:
 contrast              estimate     SE     df lower.CL upper.CL t.ratio p.value
 warsztaty - kontrolna  -5.3229 2.2641 116.39  -9.8071 -0.83865  -2.351  0.0204

Degrees-of-freedom method: satterthwaite
Confidence level used: 0.95
czas = przed:
 contrast              estimate     SE     df lower.CL upper.CL t.ratio p.value
 warsztaty - kontrolna  -0.6000 2.1684 103.25  -4.9005   3.7005  -0.277  0.7826

czas = po:
 contrast              estimate     SE     df lower.CL upper.CL t.ratio p.value
 warsztaty - kontrolna  -7.6766 2.2149 108.63 -12.0666  -3.2866  -3.466  0.0008

czas = po3m:
 contrast              estimate     SE     df lower.CL upper.CL t.ratio p.value
 warsztaty - kontrolna  -5.5687 2.2796 115.77 -10.0839  -1.0535  -2.443  0.0161

Degrees-of-freedom method: satterthwaite
Confidence level used: 0.95
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki wykonano w pakietach ggplot2 i svglite (kodu rysunków nie pokazujemy). Składni SPSS nie uruchamiano. W pracy podaj wersję SPSS lub R, której faktycznie użyłeś.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- lmerTest (wersja 3.2.1): Kuznetsova, A., Brockhoff, P. B., & Christensen, R. H. B. (2017). lmerTest package: Tests in linear mixed effects models. Journal of Statistical Software, 82(13), 1–26. https://doi.org/10.18637/jss.v082.i13
- nlme (wersja 3.1.168): Pinheiro, J., Bates, D., & R Core Team. (2025). nlme: Linear and nonlinear mixed effects models [R package]. https://doi.org/10.32614/CRAN.package.nlme
- emmeans (wersja 2.0.2): Lenth, R. V., & Piaskowski, J. (2026). emmeans: Estimated marginal means, aka least-squares means [R package]. https://doi.org/10.32614/CRAN.package.emmeans
- haven (wersja 2.5.5): Wickham, H., Miller, E., & Smith, D. (2025). haven: Import and export 'SPSS', 'Stata' and 'SAS' files [R package]. https://doi.org/10.32614/CRAN.package.haven
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Typowe błędy
- Dane w formacie szerokim. MIXED potrzebuje wiersza na pomiar. Najpierw przekształć plik kreatorem Restructure.
- Puste okno Fixed. Model domyślny zawiera tylko wyraz wolny (IBM Corp., b.d.-c), więc bez dodania efektów nie przetestujesz hipotez.
czasw Repeated, ale bez Subjects. Według składni analiza zREPEATEDwymagaSUBJECT(IBM Corp., b.d.-c).- Interpretacja [grupa=1] jako efektu ogólnego. To różnica w kategorii odniesienia drugiego czynnika, czyli tutaj w ostatnim pomiarze.
- Wybór struktury po wynikach testu grupy. Wybieraj ją kryteriami informacyjnymi, zanim spojrzysz na efekty stałe, i opisz w pracy.
- „Sig. = .000” przepisane dosłownie. Pisz p < .001.
Planując liczbę osób do takiego badania, skorzystaj z wpisu analiza mocy dla modelu mieszanego. Gdy wynik jest binarny albo jest liczbą zdarzeń, potrzebny jest uogólniony model mieszany (GLMM). Gdy pomiarów przed i po nie da się połączyć w pary, zobacz wpis nie da się połączyć pomiaru przed i po. Analizę dobierzesz w kreatorze doboru testu.
Najczęstsze pytania
Czym różni się w SPSS pole Random od pola Repeated?
Efekty losowe modelują kowariancję zmiennej zależnej, a pomiary powtarzane – kowariancję reszt (IBM Corp., b.d.-a). Przy pomiarach powtarzanych możesz użyć losowego wyrazu wolnego osoby albo czasu w polu Repeated ze strukturą, np. AR(1). Losowy wyraz wolny odpowiada strukturze Compound Symmetry z dodatnią korelacją. W przykładzie oba modele dały to samo −2RLL = 1116.42.
Którą strukturę kowariancji wybrać: AR(1), Compound Symmetry czy Unstructured?
Dopasuj kilka struktur z tymi samymi efektami stałymi metodą REML i porównaj tabele Information Criteria – mniejsza wartość oznacza lepszy model (IBM Corp., b.d.-b). Modele zagnieżdżone porównasz testem ilorazu wiarygodności z różnicy −2RLL. W przykładzie AR(1) miała najmniejsze AIC (1111.67), a Unstructured nie była od niej istotnie lepsza, χ²(4) = 4.74, p = .315.
Dlaczego w tabeli Type III Tests of Fixed Effects df mianownika ma ułamki?
Domyślnie MIXED wyznacza stopnie swobody przybliżeniem Satterthwaite’a (IBM Corp., b.d.-c), które daje df niecałkowite, np. F(2, 106.09) = 6.17. W oknie Estimation możesz wybrać też metodę Kenwarda–Rogera albo Residual method. Przepisz df z dwoma miejscami po przecinku.
Czy model mieszany w SPSS poradzi sobie z brakującymi pomiarami?
Tak, jeśli dane są w formacie długim: osoba z dwoma pomiarami zostaje w analizie, a GLM Repeated Measures usunęłaby ją w całości. Modele mieszane wykorzystują wszystkie dostępne dane (Gueorguieva i Krystal, 2004). W przykładzie analiza objęła 167 pomiarów 60 osób, w tym 13 osób z jednym brakiem. Wynik jest wiarygodny przy założeniu, że braki są losowe w sensie MAR.
Jak w SPSS porównać grupy w każdym pomiarze osobno?
Okno EM Means porównuje tylko poziomy efektów głównych. Porównania grup w każdym pomiarze zamówisz w składni: /EMMEANS=TABLES(grupa*czas) COMPARE(grupa) ADJ(LSD), BONFERRONI albo SIDAK (IBM Corp., b.d.-c). Wydruk poda różnicę średnich brzegowych, błąd standardowy, df, p i przedział ufności.
Powiązane hasła
Przeczytaj też
Model mieszany w jamovi (GAMLj) krok po kroku
Moduł GAMLj w jamovi: format długi, klaster, losowy wyraz wolny i nachylenie, ICC w Random Components, średnie brzegowe, simple effects i różnice wobec MIXED w SPSS.
Czytaj →PoradnikANOVA z powtarzanymi pomiarami czy model mieszany?
Ten sam przykład 2 × 4 w afex i lmerTest, symulacja odpadania MAR, struktura efektów losowych, stopnie swobody, R² i gotowy opis do artykułu.
Czytaj →PoradnikANOVA z powtarzanymi pomiarami i mieszana w SPSS
GLM Repeated Measures od formatu szerokiego po opis APA: Define Factors, test Mauchly’ego, Greenhouse–Geisser, η² cząstkowe i efekty proste z EMMEANS – z plikiem .sav do pobrania.
Czytaj →PoradnikJak opisać wyniki modelu mieszanego
Co przepisać z wydruku lmer do pracy: struktura modelu, REML, df Satterthwaite’a, efekty stałe z CI, wariancje losowe, ICC i R² Nakagawy – z tabelą APA i wzorami zdań.
Czytaj →Masz pomiary powtarzane i nie wiesz, jak opisać model mieszany z SPSS?
Sprawdzimy format danych, efekty stałe i losowe, wybór struktury kowariancji i opis wyników oraz wyjaśnimy je tak, żebyś umiał(a) samodzielnie je przedstawić i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Gueorguieva, R., & Krystal, J. H. (2004). Move over ANOVA: Progress in analyzing repeated-measures data and its reflection in papers published in the Archives of General Psychiatry. Archives of General Psychiatry, 61(3), 310–317. https://doi.org/10.1001/archpsyc.61.3.310
- IBM Corp. (b.d.-a). Linear Mixed Models. IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_mainhelp_ddita/spss/advanced/idh_mixl.html ● Otwarty dostęp
- IBM Corp. (b.d.-b). Linear Mixed Models (case studies). IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_casestudies_project_ddita/spss/tutorials/mixed_table.html ● Otwarty dostęp
- IBM Corp. (b.d.-c). MIXED (Command Syntax Reference). IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_reference_project_ddita/spss/advanced/syn_mixed.html ● Otwarty dostęp
- IBM Corp. (b.d.-d). To restructure data. IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_mainhelp_ddita/spss/base/rd_howto.html ● Otwarty dostęp
- Littell, R. C., Henry, P. R., & Ammerman, C. B. (1998). Statistical analysis of repeated measures data using SAS procedures. Journal of Animal Science, 76(4), 1216–1231. https://doi.org/10.2527/1998.7641216x
- Luke, S. G. (2017). Evaluating significance in linear mixed-effects models in R. Behavior Research Methods, 49(4), 1494–1502. https://doi.org/10.3758/s13428-016-0809-y ● Otwarty dostęp
Cytowania BibTeX
@article{gueorguieva2004move, author={Gueorguieva, Ralitza and Krystal, John H.}, title={{Move over ANOVA: Progress in analyzing repeated-measures data and its reflection in papers published in the Archives of General Psychiatry}}, journal={Archives of General Psychiatry}, year={2004}, volume={61}, number={3}, pages={310--317}, doi={10.1001/archpsyc.61.3.310}}@misc{ibmnd31mixedokna, author={{IBM Corp.}}, title={{Linear Mixed Models}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-a}, publisher={IBM}, url={https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_mainhelp_ddita/spss/advanced/idh_mixl.html}}@misc{ibmnd31mixedprzyklady, author={{IBM Corp.}}, title={{Linear Mixed Models (case studies)}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-b}, publisher={IBM}, url={https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_casestudies_project_ddita/spss/tutorials/mixed_table.html}}@misc{ibmnd31mixedskladnia, author={{IBM Corp.}}, title={{MIXED (Command Syntax Reference)}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-c}, publisher={IBM}, url={https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_reference_project_ddita/spss/advanced/syn_mixed.html}}@misc{ibmnd31restructure, author={{IBM Corp.}}, title={{To restructure data}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-d}, publisher={IBM}, url={https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_mainhelp_ddita/spss/base/rd_howto.html}}@article{littell1998statistical, author={Littell, R. C. and Henry, P. R. and Ammerman, C. B.}, title={{Statistical analysis of repeated measures data using SAS procedures}}, journal={Journal of Animal Science}, year={1998}, volume={76}, number={4}, pages={1216--1231}, doi={10.2527/1998.7641216x}}@article{luke2017evaluating, author={Luke, Steven G.}, title={{Evaluating significance in linear mixed-effects models in R}}, journal={Behavior Research Methods}, year={2017}, volume={49}, number={4}, pages={1494--1502}, doi={10.3758/s13428-016-0809-y}}