/EMMEANS=TABLES(grupa*czas) COMPARE(czas) ADJ(BONFERRONI). Opcja Estimates of effect size daje η² cząstkowe.Do czego służy GLM Repeated Measures
Procedura GLM Repeated Measures w SPSS liczy analizę wariancji, gdy ten sam pomiar wykonujesz kilka razy u każdej osoby (IBM Corp., b.d.). W jednym oknie zrobisz ANOVA z powtarzanymi pomiarami (sam czynnik wewnątrzobiektowy, np. czas) i ANOVA mieszaną (dochodzi czynnik międzyobiektowy, np. grupa). Logikę obu analiz, założenia i obliczenia w R omawiają poradniki ANOVA z powtarzanymi pomiarami krok po kroku i ANOVA mieszana krok po kroku. Tutaj zajmujemy się tylko SPSS: oknami, składnią i tym, co przepisać z wydruku.
Ścieżki menu i nazwy opcji sprawdziliśmy w dokumentacji IBM SPSS Statistics 31 (IBM Corp., b.d.; IBM, 2026) i podajemy je po angielsku. Polska dokumentacja podaje ścieżkę Analizuj → Ogólny model liniowy → Powtarzane pomiary (IBM, 2026). Pozostałe polskie etykiety w programie mogą brzmieć inaczej niż w tłumaczeniu dokumentacji. Ogólne zasady czytania wydruku opisuje wpis jak czytać wyniki z SPSS.
Przykład i pliki do pobrania
Wszystkie liczby pochodzą z jednego zbioru symulowanego. 60 osób studiujących trzy razy wypełniło skalę stresu (wynik 10–50): na początku semestru (T1), tydzień przed sesją (T2) i po sesji (T3). Połowa osób (n = 30) wzięła udział w warsztacie radzenia sobie ze stresem, druga połowa była grupą kontrolną. Czy przebieg stresu różnił się między grupami?
Pobierz plik .sav z etykietami zmiennych i wartości albo ten sam zbiór w pliku CSV. Format SPSS opisuje hasło plik .sav.
Przygotowanie danych: format szeroki
W odróżnieniu od jednoczynnikowej ANOVA ta procedura wymaga formatu szerokiego. Jeden wiersz to jedna osoba, a każdy pomiar to osobna kolumna: stres1, stres2, stres3. Dokumentacja IBM opisuje to jako zestaw zmiennych z jedną zmienną dla każdego powtórzenia pomiaru (IBM Corp., b.d.). Zmienna grupa ma kody 1 i 2 z etykietami wartości. Etykiety i braki danych opisuje wpis przygotowanie danych w SPSS.
Czasu nie zapisujesz jako zmiennej w pliku. Czynnik wewnątrzobiektowy nie istnieje w danych. Nadajesz mu nazwę dopiero w oknie definiowania czynników (IBM, 2026).
Okna procedury krok po kroku
- Analyze → General Linear Model → Repeated Measures (IBM Corp., b.d.). Najpierw otworzy się okno Define Factors.
- Define Factors. Wpisz nazwę czynnika wewnątrzobiektowego, np.
czas, i liczbę poziomów3. Kliknij Add, a potem Define (IBM, 2026). Nazwa nie może powtarzać nazwy żadnej zmiennej z pliku. - Okno główne. Przenieś
stres1,stres2istres3na listę zmiennych wewnątrzobiektowych, w kolejności pomiarów. SPSS przypisuje zmienne do poziomów według kolejności (IBM, 2026). Do ANOVA mieszanej przenieśgrupado pola Between-Subjects Factor(s). Do analizy z jednym czynnikiem to pole zostaw puste. - Options. W grupie Display zaznacz Descriptive statistics, Estimates of effect size i – w ANOVA mieszanej – Homogeneity tests (IBM, 2026).
- EM Means. Przenieś
czas(lubgrupa*czas) na listę Display Means For. Zaznacz Compare main effects albo Compare simple main effects i wybierz korektę Bonferroni. Pole efektów prostych jest aktywne tylko dla interakcji (IBM, 2026). - Plots. Umieść
czasna osi poziomej, agrupajako osobne linie (IBM, 2026). Powstanie wykres interakcji.
Test Mauchly’ego SPSS wyświetla automatycznie (IBM Corp., b.d.).
Część 1: ANOVA z powtarzanymi pomiarami
Najpierw uruchom analizę tylko z czynnikiem czas, jak w badaniu z jedną grupą. Tabele niżej mają układ tabel wynikowych SPSS. Liczby policzono w R tymi samymi metodami co SPSS; układ tabeli jak w SPSS. Pogrubiono liczby, które trafią do pracy.
Test sferyczności Mauchly’ego
| Within Subjects Effect | Mauchly’s W | Approx. Chi-Square | df | Sig. | Epsilon | ||
|---|---|---|---|---|---|---|---|
| Greenhouse-Geisser | Huynh-Feldt | Lower-bound | |||||
| czas | .764 | 15.629 | 2 | .000 | .809 | .828 | .500 |
Test Mauchly’ego (Mauchly, 1940) sprawdza założenie sferyczności, czyli równość wariancji różnic między pomiarami. Tu jest istotny, χ²(2) = 15.63, p < .001, więc założenie nie jest spełnione. Według studium przypadku IBM przy istotności poniżej .05 trzeba skorygować stopnie swobody, mnożąc je przez epsilon (IBM, 2026). Ważniejsza od samego p jest wartość ε. Przy pełnej sferyczności ε = 1. Dolna granica (Lower-bound) to 1/(liczba poziomów − 1), tu .500.
Nie traktuj testu Mauchly’ego jak bramki. Blanca i in. (2023) zalecają domyślnie poprawkę Greenhouse’a–Geissera bez względu na jego wynik. Przy rozbieżnych wnioskach proponują wybierać według ε: dla ε̂ < .60 Greenhouse–Geisser, a dla .60–.90 Huynh–Feldt.
Tests of Within-Subjects Effects
| Source | Type III Sum of Squares | df | Mean Square | F | Sig. | Partial Eta Squared | |
|---|---|---|---|---|---|---|---|
| czas | Sphericity Assumed | 508.133 | 2 | 254.067 | 20.350 | .000 | .256 |
| Greenhouse-Geisser | 508.133 | 1.618 | 314.081 | 20.350 | .000 | .256 | |
| Huynh-Feldt | 508.133 | 1.657 | 306.700 | 20.350 | .000 | .256 | |
| Lower-bound | 508.133 | 1.000 | 508.133 | 20.350 | .000 | .256 | |
| Error(czas) | Sphericity Assumed | 1473.200 | 118 | 12.485 | |||
| Greenhouse-Geisser | 1473.200 | 95.453 | 15.434 | ||||
| Huynh-Feldt | 1473.200 | 97.751 | 15.071 | ||||
| Lower-bound | 1473.200 | 59.000 | 24.969 |
Cztery wiersze różnią się tylko stopniami swobody i p. Suma kwadratów, F i η² cząstkowe są w nich takie same. Poprawka Greenhouse’a–Geissera (Greenhouse i Geisser, 1959) mnoży df licznika i mianownika przez ε = .809: 2 × .809 = 1.618 i 118 × .809 = 95.45. Poprawka Huynha–Feldta (Huynh i Feldt, 1976) jest mniej konserwatywna. Tu oba wiersze dają ten sam wniosek, więc przepisz wiersz Greenhouse-Geisser: F(1.62, 95.45) = 20.35, p < .001, η²p = .26.
SPSS drukuje też tabelę Multivariate Tests – podejście wielowymiarowe, które nie zakłada sferyczności. Raportuj tylko tę tabelę, którą zapowiadasz w metodzie.
Porównania par z poprawką Bonferroniego
| (I) czas | (J) czas | Mean Difference (I-J) | Std. Error | Sig. | 95% Confidence Interval for Difference | |
|---|---|---|---|---|---|---|
| Lower Bound | Upper Bound | |||||
| 1 | 2 | −3.967* | .527 | .000 | −5.264 | −2.669 |
| 1 | 3 | −1.033 | .783 | .576 | −2.963 | .896 |
| 2 | 3 | 2.933* | .598 | .000 | 1.459 | 4.408 |
Stres wzrósł przed sesją i spadł po niej, a T1 i T3 nie różnią się istotnie. Korekta Bonferroniego dotyczy tu zarówno p, jak i przedziałów ufności (IBM, 2026). SPSS wypisuje każdą parę w obu kierunkach, my zostawiliśmy po jednym wierszu.
Część 2: ANOVA mieszana grupa × czas
Teraz dodaj grupa w polu Between-Subjects Factor(s). Kluczowym wynikiem jest interakcja czas × grupa, bo to ona mówi, czy zmiana przebiegała inaczej w obu grupach.
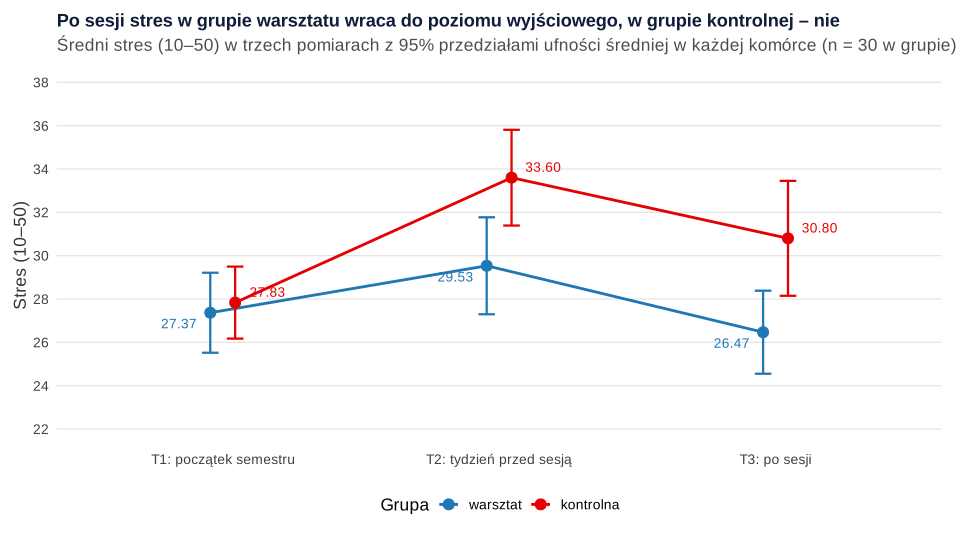
| grupa | Mean | Std. Deviation | N | |
|---|---|---|---|---|
| stres1 (T1) | warsztat | 27.37 | 4.944 | 30 |
| kontrolna | 27.83 | 4.450 | 30 | |
| stres2 (T2) | warsztat | 29.53 | 5.993 | 30 |
| kontrolna | 33.60 | 5.917 | 30 | |
| stres3 (T3) | warsztat | 26.47 | 5.131 | 30 |
| kontrolna | 30.80 | 7.102 | 30 |
SPSS dodaje też wiersze Total dla każdego pomiaru. W ANOVA mieszanej test Mauchly’ego liczony jest na wariancjach wewnątrz grup: W = .746, χ²(2) = 16.70, p < .001, ε Greenhouse’a–Geissera = .797, ε Huynha–Feldta = .831. W R pakiet car podaje dla Huynha–Feldta .816, bo stosuje poprawkę Lecoutre’a. Jeśli Twój wydruk różni się tylko tą liczbą, to jest powód.
| Source | Type III Sum of Squares | df | Mean Square | F | Sig. | Partial Eta Squared | |
|---|---|---|---|---|---|---|---|
| czas | Sphericity Assumed | 508.133 | 2 | 254.067 | 22.105 | .000 | .276 |
| Greenhouse-Geisser | 508.133 | 1.595 | 318.600 | 22.105 | .000 | .276 | |
| Huynh-Feldt | 508.133 | 1.661 | 305.905 | 22.105 | .000 | .276 | |
| czas * grupa | Sphericity Assumed | 139.911 | 2 | 69.956 | 6.086 | .003 | .095 |
| Greenhouse-Geisser | 139.911 | 1.595 | 87.724 | 6.086 | .006 | .095 | |
| Huynh-Feldt | 139.911 | 1.661 | 84.229 | 6.086 | .005 | .095 | |
| Error(czas) | Sphericity Assumed | 1333.289 | 116 | 11.494 | |||
| Greenhouse-Geisser | 1333.289 | 92.504 | 14.413 | ||||
| Huynh-Feldt | 1333.289 | 96.343 | 13.839 |
| Source | Type III Sum of Squares | df | Mean Square | F | Sig. | Partial Eta Squared |
|---|---|---|---|---|---|---|
| Intercept | 154176.800 | 1 | 154176.800 | 2112.621 | .000 | .973 |
| grupa | 393.089 | 1 | 393.089 | 5.386 | .024 | .085 |
| Error | 4232.778 | 58 | 72.979 |
Interakcja jest istotna: F(1.59, 92.50) = 6.09, p = .006, η²p = .10. Efekt główny grupy (p = .024) dotyczy średniej z trzech pomiarów i przy istotnej interakcji niewiele mówi. Wiersza Intercept nie raportuj. Test Levene’a z opcji Homogeneity tests nie wykazał różnic wariancji w żadnym pomiarze (p = .430, .963 i .087). SPSS doda też test M Boxa równości macierzy kowariancji w grupach (IBM, 2026).
Efekty proste: EMMEANS z COMPARE
Istotną interakcję rozkładasz na efekty proste. W składni służy do tego podkomenda /EMMEANS=TABLES(grupa*czas) COMPARE(czas) ADJ(BONFERRONI). Według Command Syntax Reference COMPARE przy interakcji porównuje poziomy wskazanego czynnika w obrębie każdego poziomu pozostałych (IBM, 2026). COMPARE(czas) pokaże więc zmiany w czasie osobno w każdej grupie, a COMPARE(grupa) – różnice grup w każdym pomiarze. Najprościej wkleić obie linie w składni (przepis 1 niżej).
| grupa | (I) czas | (J) czas | Mean Difference (I-J) | Std. Error | Sig. | 95% Confidence Interval for Difference | |
|---|---|---|---|---|---|---|---|
| Lower Bound | Upper Bound | ||||||
| warsztat | 1 | 2 | −2.167* | .673 | .006 | −3.825 | −.508 |
| 1 | 3 | .900 | 1.057 | 1.000 | −1.707 | 3.507 | |
| 2 | 3 | 3.067* | .853 | .002 | .963 | 5.170 | |
| kontrolna | 1 | 2 | −5.767* | .673 | .000 | −7.425 | −4.108 |
| 1 | 3 | −2.967* | 1.057 | .020 | −5.574 | −.360 | |
| 2 | 3 | 2.800* | .853 | .005 | .697 | 4.904 | |
| czas | (I) grupa | (J) grupa | Mean Difference (I-J) | Std. Error | Sig. | 95% Confidence Interval for Difference | |
|---|---|---|---|---|---|---|---|
| Lower Bound | Upper Bound | ||||||
| 1 | warsztat | kontrolna | −.467 | 1.214 | .702 | −2.898 | 1.964 |
| 2 | warsztat | kontrolna | −4.067* | 1.538 | .011 | −7.144 | −.989 |
| 3 | warsztat | kontrolna | −4.333* | 1.600 | .009 | −7.535 | −1.131 |
W obu grupach stres wzrósł przed sesją i spadł po niej. Tylko w grupie kontrolnej był jednak po sesji wyższy niż na początku semestru (o 2.97 punktu). Grupy nie różniły się w T1, a w T2 i T3 grupa warsztatu miała stres niższy o około 4 punkty (przy jednym porównaniu korekta Bonferroniego nic nie zmienia). W odtworzeniu błąd standardowy porównań w czasie jest wspólny dla obu grup, bo pochodzi z połączonej macierzy kowariancji obu grup, jak w wielowymiarowym ujęciu GLM. Jak opisać taki wzór, pokazuje wpis interakcja w ANOVA – jak ją zinterpretować.
Wielkość efektu: η² cząstkowe i uogólnione
Opcja Estimates of effect size daje η² cząstkowe dla każdego efektu (IBM, 2026). W schematach z powtarzanymi pomiarami bywa wyraźnie wyższe niż η² z badań z niezależnymi grupami. Bakeman (2005) zaleca dlatego η² uogólnione (Olejnik i Algina, 2003), porównywalne między schematami. SPSS go nie podaje. Policzysz je z sum kwadratów z obu tabel: η²G dla czasu = 508.133 / (508.133 + 4232.778 + 1333.289) = .08, a dla interakcji = 139.911 / (139.911 + 4232.778 + 1333.289) = .02. Wybierz jedną miarę i nazwij ją w tekście.
Zapis wyników w stylu APA
Podaj średnie i odchylenia, wynik testu Mauchly’ego, użytą poprawkę z ε, wielkość efektu i efekty proste z przedziałami ufności. Wzór do dostosowania:
Więcej gotowych zdań zawiera wpis jak opisać wyniki w stylu APA, a zdania do innych testów przygotuje generator opisu wyników APA. Wzór tabeli do pracy pokazuje hasło tabela ANOVA w APA.
Składnia SPSS i kod R
Przepis 1 to składnia do wklejenia w edytorze składni SPSS (tym, który otwiera przycisk Paste). Napisaliśmy ją według opisu polecenia GLM dla powtarzanych pomiarów w Command Syntax Reference (IBM, 2026), ale nie uruchamialiśmy jej w SPSS. Przepis 2 w R tworzy pliki do pobrania i liczy wszystkie liczby z tabel: test Mauchly’ego i trzy epsilony, sumy kwadratów typu III, η² cząstkowe i uogólnione oraz porównania par z poprawką Bonferroniego (pakiety afex, car i emmeans).
1. Składnia SPSS: GLM z WSFACTOR, WSDESIGN i EMMEANS
SPSS
* Składnia zgodna z opisem GLM: Repeated Measures w Command Syntax Reference; nie była uruchamiana w SPSS.
* Część 1. ANOVA z powtarzanymi pomiarami: jeden czynnik czas (3 poziomy).
GLM stres1 stres2 stres3
  /WSFACTOR=czas 3 POLYNOMIAL
  /METHOD=SSTYPE(3)
  /EMMEANS=TABLES(czas) COMPARE ADJ(BONFERRONI)
  /PRINT=DESCRIPTIVE ETASQ
  /WSDESIGN=czas.

* Część 2. ANOVA mieszana: czas (wewnątrzobiektowy) x grupa (międzyobiektowy) z efektami prostymi.
GLM stres1 stres2 stres3 BY grupa
  /WSFACTOR=czas 3 POLYNOMIAL
  /METHOD=SSTYPE(3)
  /EMMEANS=TABLES(grupa*czas) COMPARE(czas) ADJ(BONFERRONI)
  /EMMEANS=TABLES(grupa*czas) COMPARE(grupa) ADJ(BONFERRONI)
  /PRINT=DESCRIPTIVE ETASQ HOMOGENEITY
  /WSDESIGN=czas
  /DESIGN=grupa.
2. Te same liczby w R i pliki .sav oraz CSV
R
# B291 – ANOVA z powtarzanymi pomiarami i ANOVA mieszana: liczby do tabel w układzie SPSS
# Dane symulowane, set.seed(2926): stres studentów (skala 10–50) w trzech pomiarach,
# grupa warsztatu radzenia sobie ze stresem (n = 30) i grupa kontrolna (n = 30).
# Metody jak w GLM Repeated Measures w SPSS: sumy kwadratów typu III, test Mauchly'ego,
# epsilon Greenhouse'a–Geissera, Huynha–Feldta (wzór z 1976 r.) i dolna granica,
# cząstkowe eta kwadrat, porównania par EMMEANS z poprawką Bonferroniego.
suppressPackageStartupMessages({ library(haven); library(car); library(afex); library(emmeans); library(MASS) })
afex_options(include_aov = FALSE)
set.seed(2926)
n <- 30
S <- diag(c(5, 6, 7.5)) %*% matrix(c(1, .75, .35, .75, 1, .7, .35, .7, 1), 3) %*% diag(c(5, 6, 7.5))
x <- rbind(mvrnorm(n, c(28, 30, 26), S), mvrnorm(n, c(28, 33, 30.5), S))
x[] <- round(pmin(50, pmax(10, x)))
dane <- data.frame(id = 1:(2 * n), grupa = rep(1:2, each = n), stres1 = x[, 1], stres2 = x[, 2], stres3 = x[, 3])

# Krok 1. Plik .sav (format szeroki) z etykietami zmiennych i wartości – i ten sam zbiór w CSV
sav <- dane
sav$id <- labelled(sav$id, label = "Numer osoby")
sav$grupa <- labelled(sav$grupa, labels = c("warsztat" = 1, "kontrolna" = 2), label = "Grupa")
sav$stres1 <- labelled(sav$stres1, label = "Stres – początek semestru (10–50)")
sav$stres2 <- labelled(sav$stres2, label = "Stres – tydzień przed sesją (10–50)")
sav$stres3 <- labelled(sav$stres3, label = "Stres – po sesji (10–50)")
write_sav(sav, "../anova-rm-spss-dane.sav")
write.csv(dane, "../anova-rm-spss-dane.csv", row.names = FALSE, fileEncoding = "UTF-8")

# Krok 2. Statystyki opisowe (opcja Descriptive statistics): średnia, SD i N w grupach i łącznie
Y <- as.matrix(dane[, c("stres1", "stres2", "stres3")])
gr <- factor(dane$grupa, levels = 1:2, labels = c("warsztat", "kontrolna"))
opis <- do.call(rbind, lapply(colnames(Y), function(v) rbind(
  data.frame(pomiar = v, grupa = levels(gr), M = tapply(Y[, v], gr, mean), SD = tapply(Y[, v], gr, sd), N = as.vector(table(gr))),
  data.frame(pomiar = v, grupa = "Total", M = mean(Y[, v]), SD = sd(Y[, v]), N = nrow(Y)))))
print(opis, digits = 4, row.names = FALSE)

# Funkcje pomocnicze: test Mauchly'ego i trzy epsilony z macierzy SSCP błędu
C <- contr.poly(3)                                   # ortonormalne kontrasty (SPSS: POLYNOMIAL)
sferycznosc <- function(E, df_err, N, g) {           # E – SSCP błędu w kolumnach Y
  Tm <- t(C) %*% E %*% C / df_err; p <- ncol(C)
  W <- det(Tm) / (sum(diag(Tm)) / p)^p
  chi <- -(df_err - (2 * p^2 + p + 2) / (6 * p)) * log(W); dfc <- p * (p + 1) / 2 - 1
  gg <- sum(diag(Tm))^2 / (p * sum(Tm^2))
  hf <- min(1, (N * p * gg - 2) / (p * (N - g - p * gg)))                 # Huynh i Feldt (1976)
  hf_lecoutre <- min(1, ((N - g + 1) * p * gg - 2) / (p * (N - g - p * gg)))  # wariant w car::Anova
  c(W = W, chi2 = chi, df = dfc, p = pchisq(chi, dfc, lower.tail = FALSE),
    GG = gg, HF = hf, HF_car = hf_lecoutre, dolna = 1 / p)
}
wiersze <- function(SS, df, SSe, dfe, eps) {         # wiersze Sphericity Assumed / GG / HF / Lower-bound
  e <- c("Sphericity Assumed" = 1, "Greenhouse-Geisser" = eps[["GG"]], "Huynh-Feldt" = eps[["HF"]], "Lower-bound" = eps[["dolna"]])
  F <- (SS / df) / (SSe / dfe)
  data.frame(korekta = names(e), SS = SS, df = df * e, MS = SS / (df * e), F = F,
             p = pf(F, df * e, dfe * e, lower.tail = FALSE), eta2p = SS / (SS + SSe),
             df_bledu = dfe * e, MS_bledu = SSe / (dfe * e), row.names = NULL)
}
dl <- reshape(dane, direction = "long", varying = c("stres1", "stres2", "stres3"), v.names = "stres",
              timevar = "czas", times = 1:3, idvar = "id")
dl$czas <- factor(dl$czas, labels = c("T1", "T2", "T3")); dl$grupa <- factor(dl$grupa, labels = c("warsztat", "kontrolna"))

# Krok 3. ANOVA z powtarzanymi pomiarami (jeden czynnik czas, wszystkie 60 osób)
E1 <- crossprod(scale(Y, scale = FALSE))
s1 <- sferycznosc(E1, df_err = nrow(Y) - 1, N = nrow(Y), g = 1); round(s1, 3)
a1 <- aov_ez("id", "stres", dl, within = "czas", type = 3)
t1 <- nice(a1, correction = "none", es = "pes"); t1
SSc <- sum(nrow(Y) * (colMeans(Y) - mean(Y))^2)
SSe1 <- sum((Y - outer(rowMeans(Y), rep(1, 3)) - outer(rep(1, nrow(Y)), colMeans(Y)) + mean(Y))^2)
print(wiersze(SSc, 2, SSe1, 2 * (nrow(Y) - 1), s1), digits = 5)
round(c(SS_czas = SSc, SS_Error_czas = SSe1), 3)
# Pairwise Comparisons (EMMEANS z COMPARE i ADJ(BONFERRONI)): różnice par i przedziały z Bonferronim
pc1 <- pairs(emmeans(a1, ~ czas, model = "multivariate"), adjust = "bonferroni")
print(summary(pc1, infer = TRUE), digits = 4)

# Krok 4. ANOVA mieszana: czas (wewnątrzobiektowy) × grupa (międzyobiektowy)
E2 <- crossprod(Y - apply(Y, 2, function(k) ave(k, gr)))       # SSCP wewnątrz grup
s2 <- sferycznosc(E2, df_err = nrow(Y) - 2, N = nrow(Y), g = 2); round(s2, 3)
a2 <- aov_ez("id", "stres", dl, between = "grupa", within = "czas", type = 3)
nice(a2, correction = "none", es = "pes")
nice(a2, correction = "GG", es = "pes")
nice(a2, correction = "GG", es = "ges")            # uogólnione eta kwadrat (Olejnik i Algina, 2003) – SPSS go nie podaje
# kontrola epsilonów: car::Anova podaje HF z poprawką Lecoutre'a (w schemacie z grupami nieco wyższy)
summary(car::Anova(lm(Y ~ gr, contrasts = list(gr = "contr.sum")), idata = data.frame(czas = factor(1:3)),
                   idesign = ~ czas, type = 3), multivariate = FALSE)$pval.adjustments[, 1:4]
# Tabela Tests of Within-Subjects Effects: sumy kwadratów typu III
M <- tapply(dl$stres, list(dl$grupa, dl$czas), mean)
SS_czas <- 2 * n * sum((colMeans(M) - mean(M))^2)
SS_int <- n * sum((M - outer(rowMeans(M), rep(1, 3)) - outer(rep(1, 2), colMeans(M)) + mean(M))^2)
Yc <- Y - apply(Y, 2, function(k) ave(k, gr))
SSe2 <- sum((Yc - outer(rowMeans(Yc), rep(1, 3)))^2)
print(rbind(cbind(efekt = "czas", wiersze(SS_czas, 2, SSe2, 2 * (nrow(Y) - 2), s2)),
            cbind(efekt = "czas * grupa", wiersze(SS_int, 2, SSe2, 2 * (nrow(Y) - 2), s2))), digits = 5)
round(c(SS_czas = SS_czas, SS_czas_grupa = SS_int, SS_Error_czas = SSe2), 3)
# Tests of Between-Subjects Effects (średnia z trzech pomiarów na osobę, przeskalowana jak w SPSS)
sr <- rowMeans(Y)
SS_gr <- 3 * n * sum((tapply(sr, gr, mean) - mean(sr))^2); SS_b_err <- 3 * sum((sr - ave(sr, gr))^2)
SS_int0 <- 3 * nrow(Y) * mean(sr)^2
round(c(SS_Intercept = SS_int0, SS_grupa = SS_gr, SS_Error = SS_b_err, df_err = nrow(Y) - 2,
        F_grupa = SS_gr / (SS_b_err / (nrow(Y) - 2)), p = pf(SS_gr / (SS_b_err / (nrow(Y) - 2)), 1, nrow(Y) - 2, lower.tail = FALSE),
        F_Intercept = SS_int0 / (SS_b_err / (nrow(Y) - 2)),
        eta2p_grupa = SS_gr / (SS_gr + SS_b_err), eta2p_Intercept = SS_int0 / (SS_int0 + SS_b_err)), 4)
# Levene (opcja Homogeneity tests): osobno dla każdego pomiaru, od średniej
for (v in colnames(Y)) print(leveneTest(Y[, v] ~ gr, center = mean))

# Krok 5. Efekty proste: EMMEANS=TABLES(grupa*czas) COMPARE(czas) i COMPARE(grupa) ADJ(BONFERRONI)
em <- emmeans(a2, ~ czas | grupa, model = "multivariate")
print(summary(pairs(em, adjust = "bonferroni"), infer = TRUE), digits = 4)
em_g <- emmeans(a2, ~ grupa | czas, model = "multivariate")
print(summary(pairs(em_g, adjust = "bonferroni"), infer = TRUE), digits = 4)
Wynik:
 pomiar     grupa     M    SD  N
 stres1  warsztat 27.37 4.944 30
 stres1 kontrolna 27.83 4.450 30
 stres1     Total 27.60 4.669 60
 stres2  warsztat 29.53 5.993 30
 stres2 kontrolna 33.60 5.917 30
 stres2     Total 31.57 6.250 60
 stres3  warsztat 26.47 5.131 30
 stres3 kontrolna 30.80 7.102 30
 stres3     Total 28.63 6.520 60
     W   chi2     df      p     GG     HF HF_car  dolna
 0.764 15.629  2.000  0.000  0.809  0.828  0.828  0.500
Anova Table (Type 3 tests)

Response: stres
  Effect     df   MSE         F  pes p.value
1   czas 2, 118 12.48 20.35 *** .256   <.001
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘+’ 0.1 ‘ ’ 1
             korekta     SS     df     MS     F          p   eta2p df_bledu MS_bledu
1 Sphericity Assumed 508.13 2.0000 254.07 20.35 2.5524e-08 0.25646  118.000   12.485
2 Greenhouse-Geisser 508.13 1.6178 314.08 20.35 3.8219e-07 0.25646   95.453   15.434
3        Huynh-Feldt 508.13 1.6568 306.70 20.35 2.8990e-07 0.25646   97.751   15.071
4        Lower-bound 508.13 1.0000 508.13 20.35 3.1258e-05 0.25646   59.000   24.969
      SS_czas SS_Error_czas
      508.133      1473.200
 contrast estimate     SE df lower.CL upper.CL t.ratio p.value
 T1 - T2    -3.967 0.5267 59   -5.264  -2.6689  -7.532 <0.0001
 T1 - T3    -1.033 0.7829 59   -2.963   0.8959  -1.320  0.5760
 T2 - T3     2.933 0.5984 59    1.459   4.4080   4.902 <0.0001

Confidence level used: 0.95
Conf-level adjustment: bonferroni method for 3 estimates
P value adjustment: bonferroni method for 3 tests
     W   chi2     df      p     GG     HF HF_car  dolna
 0.746 16.703  2.000  0.000  0.797  0.831  0.816  0.500
Contrasts set to contr.sum for the following variables: grupa
Anova Table (Type 3 tests)

Response: stres
      Effect     df   MSE         F  pes p.value
1      grupa  1, 58 72.98    5.39 * .085    .024
2       czas 2, 116 11.49 22.10 *** .276   <.001
3 grupa:czas 2, 116 11.49   6.09 ** .095    .003
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘+’ 0.1 ‘ ’ 1
Anova Table (Type 3 tests)

Response: stres
      Effect          df   MSE         F  pes p.value
1      grupa       1, 58 72.98    5.39 * .085    .024
2       czas 1.59, 92.50 14.41 22.10 *** .276   <.001
3 grupa:czas 1.59, 92.50 14.41   6.09 ** .095    .006
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘+’ 0.1 ‘ ’ 1

Sphericity correction method: GG
Anova Table (Type 3 tests)

Response: stres
      Effect          df   MSE         F  ges p.value
1      grupa       1, 58 72.98    5.39 * .066    .024
2       czas 1.59, 92.50 14.41 22.10 *** .084   <.001
3 grupa:czas 1.59, 92.50 14.41   6.09 ** .025    .006
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘+’ 0.1 ‘ ’ 1

Sphericity correction method: GG
           GG eps   Pr(>F[GG])   HF eps   Pr(>F[HF])
czas    0.7974467 1.650554e-07 0.816404 1.232948e-07
gr:czas 0.7974467 6.061294e-03 0.816404 5.685397e-03
         efekt            korekta     SS     df      MS       F          p    eta2p df_bledu MS_bledu
1         czas Sphericity Assumed 508.13 2.0000 254.067 22.1045 7.3572e-09 0.275946  116.000   11.494
2         czas Greenhouse-Geisser 508.13 1.5949 318.600 22.1045 1.6506e-07 0.275946   92.504   14.413
3         czas        Huynh-Feldt 508.13 1.6611 305.905 22.1045 9.9198e-08 0.275946   96.343   13.839
4         czas        Lower-bound 508.13 1.0000 508.133 22.1045 1.6368e-05 0.275946   58.000   22.988
5 czas * grupa Sphericity Assumed 139.91 2.0000  69.956  6.0863 3.0650e-03 0.094971  116.000   11.494
6 czas * grupa Greenhouse-Geisser 139.91 1.5949  87.724  6.0863 6.0613e-03 0.094971   92.504   14.413
7 czas * grupa        Huynh-Feldt 139.91 1.6611  84.229  6.0863 5.4205e-03 0.094971   96.343   13.839
8 czas * grupa        Lower-bound 139.91 1.0000 139.911  6.0863 1.6597e-02 0.094971   58.000   22.988
      SS_czas SS_czas_grupa SS_Error_czas
      508.133       139.911      1333.289
   SS_Intercept        SS_grupa        SS_Error          df_err         F_grupa               p
    154176.8000        393.0889       4232.7778         58.0000          5.3863          0.0238
    F_Intercept     eta2p_grupa eta2p_Intercept
      2112.6208          0.0850          0.9733
Levene's Test for Homogeneity of Variance (center = mean)
      Df F value Pr(>F)
group  1  0.6307 0.4303
      58
Levene's Test for Homogeneity of Variance (center = mean)
      Df F value Pr(>F)
group  1  0.0022 0.9632
      58
Levene's Test for Homogeneity of Variance (center = mean)
      Df F value  Pr(>F)
group  1  3.0385 0.08661 .
      58
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
grupa = warsztat:
 contrast estimate     SE df lower.CL upper.CL t.ratio p.value
 T1 - T2    -2.167 0.6728 58  -3.8253  -0.5080  -3.221  0.0063
 T1 - T3     0.900 1.0574 58  -1.7070   3.5070   0.851  1.0000
 T2 - T3     3.067 0.8532 58   0.9632   5.1702   3.594  0.0020

grupa = kontrolna:
 contrast estimate     SE df lower.CL upper.CL t.ratio p.value
 T1 - T2    -5.767 0.6728 58  -7.4253  -4.1080  -8.572 <0.0001
 T1 - T3    -2.967 1.0574 58  -5.5737  -0.3596  -2.805  0.0205
 T2 - T3     2.800 0.8532 58   0.6965   4.9035   3.282  0.0052

Confidence level used: 0.95
Conf-level adjustment: bonferroni method for 3 estimates
P value adjustment: bonferroni method for 3 tests
czas = T1:
 contrast             estimate    SE df lower.CL upper.CL t.ratio p.value
 warsztat - kontrolna  -0.4667 1.214 58   -2.898    1.964  -0.384  0.7022

czas = T2:
 contrast             estimate    SE df lower.CL upper.CL t.ratio p.value
 warsztat - kontrolna  -4.0667 1.538 58   -7.144   -0.989  -2.645  0.0105

czas = T3:
 contrast             estimate    SE df lower.CL upper.CL t.ratio p.value
 warsztat - kontrolna  -4.3333 1.600 58   -7.535   -1.131  -2.709  0.0089

Confidence level used: 0.95
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek wykonano w pakiecie ggplot2. Składni SPSS nie uruchamiano. W pracy podaj wersję SPSS lub R, której faktycznie użyłeś.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- afex (wersja 1.5.1): Singmann, H., Bolker, B., Westfall, J., Aust, F., & Ben-Shachar, M. S. (2025). afex: Analysis of factorial experiments [R package]. https://doi.org/10.32614/CRAN.package.afex
- car (wersja 3.1.5): Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). Sage. https://www.john-fox.ca/Companion/
- emmeans (wersja 2.0.2): Lenth, R. V., & Piaskowski, J. (2026). emmeans: Estimated marginal means, aka least-squares means [R package]. https://doi.org/10.32614/CRAN.package.emmeans
- haven (wersja 2.5.5): Wickham, H., Miller, E., & Smith, D. (2025). haven: Import and export 'SPSS', 'Stata' and 'SAS' files [R package]. https://doi.org/10.32614/CRAN.package.haven
- MASS (wersja 7.3.65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Typowe błędy
- Dane w formacie długim. Procedura potrzebuje osobnej kolumny dla każdego pomiaru.
- Zmienne przypisane w złej kolejności w oknie głównym. SPSS nie wie, który pomiar był pierwszy – kolejność ustalasz Ty.
- Przepisanie wiersza Sphericity Assumed mimo naruszonej sferyczności. Taki test daje zbyt wiele fałszywych alarmów (Blanca i in., 2023).
- Całkowite stopnie swobody po poprawce. Po poprawce df są ułamkowe: F(1.59, 92.50), a nie F(2, 116).
- Interpretacja efektów głównych przy istotnej interakcji bez efektów prostych.
- η² cząstkowe opisane jako η² albo porównywane z η² z badań międzyobiektowych.
- „Sig. = .000” przepisane dosłownie. Pisz p < .001.
Przy brakach w pomiarach rozważ model mieszany (zob. ANOVA z powtarzanymi pomiarami czy model mieszany). Przy wynikach porządkowych zobacz testy nieparametryczne w SPSS (test Friedmana). Gdy pomiary są tylko dwa, wystarczy test t dla prób zależnych w SPSS. Analizę dobierzesz w kreatorze doboru testu. Zobacz też ANOVA jednoczynnikowa w SPSS i korelacja i regresja w SPSS.
Najczęstsze pytania
Jak ustawić dane do ANOVA z powtarzanymi pomiarami w SPSS?
W formacie szerokim: jeden wiersz to jedna osoba, a każdy pomiar to osobna kolumna, np. stres1, stres2, stres3. Czynnika czasu nie tworzysz jako zmiennej – nadajesz mu nazwę i liczbę poziomów w oknie Define Factors, a potem przypisujesz kolumny do poziomów w kolejności pomiarów (IBM Corp., b.d.; IBM, 2026).
Który wiersz tabeli Tests of Within-Subjects Effects przepisać do pracy?
Gdy test Mauchly’ego jest istotny albo ε wyraźnie odbiega od 1, przepisz wiersz Greenhouse-Geisser z ułamkowymi stopniami swobody, np. F(1.59, 92.50) = 6.09. Blanca i in. (2023) zalecają tę poprawkę domyślnie, a przy rozbieżnych wnioskach i ε między .60 a .90 – wiersz Huynh-Feldt. Wiersz Sphericity Assumed jest poprawny tylko przy spełnionej sferyczności.
Jak w SPSS zrobić efekty proste w ANOVA mieszanej?
W oknie EM Means przenieś interakcję grupa*czas, zaznacz Compare simple main effects i korektę Bonferroni albo wklej w składni dwie linie: /EMMEANS=TABLES(grupa*czas) COMPARE(czas) ADJ(BONFERRONI) oraz to samo z COMPARE(grupa). Pierwsza porówna pomiary w każdej grupie, druga grupy w każdym pomiarze (IBM, 2026).
Czy SPSS podaje wielkość efektu w ANOVA z powtarzanymi pomiarami?
Tak, opcja Estimates of effect size w oknie Options dodaje kolumnę Partial Eta Squared, czyli η² cząstkowe (IBM, 2026). η² uogólnionego SPSS nie liczy. Policzysz je ręcznie: suma kwadratów efektu podzielona przez sumę tej wartości i sum kwadratów błędów z tabel efektów wewnątrz- i międzyobiektowych (Olejnik i Algina, 2003).
Dlaczego ε Huynha–Feldta z SPSS różni się od wyniku w R?
W ANOVA mieszanej pakiet car w R podaje ε Huynha–Feldta z poprawką Lecoutre’a, a nie według pierwotnego wzoru Huynha i Feldta (1976). W przykładzie to .816 zamiast .831. Przy jednej grupie oba wzory dają tę samą liczbę, a ε Greenhouse’a–Geissera jest wszędzie takie samo.
Powiązane hasła
Przeczytaj też
Jak czytać wyniki z SPSS
Osiem najczęstszych tabel SPSS: co odczytać, który wiersz wybrać, co znaczy Sig. = .000 i jak przepisać wynik w stylu APA.
Czytaj →PoradnikANOVA z powtarzanymi pomiarami krok po kroku
Cztery warunki, te same osoby: sferyczność i poprawka GG, η²G, porównania parami w emmeans, wykres z CI wewnątrzosobowymi, schemat mieszany i opis APA.
Czytaj →PoradnikANOVA mieszana krok po kroku
Sferyczność, test M Boxa, interakcja grupa × czas, efekty proste w emmeans i wzór opisu APA – na przykładzie trzech grup i trzech pomiarów.
Czytaj →Masz wydruk GLM Repeated Measures i nie wiesz, który wiersz przepisać?
Sprawdzimy układ danych, wybór poprawki i efektów prostych oraz opis wyników i wyjaśnimy je tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Bakeman, R. (2005). Recommended effect size statistics for repeated measures designs. Behavior Research Methods, 37(3), 379–384. https://doi.org/10.3758/BF03192707 ● Otwarty dostęp
- Blanca, M. J., Arnau, J., García-Castro, F. J., Alarcón, R., & Bono, R. (2023). Repeated measures ANOVA and adjusted F-tests when sphericity is violated: Which procedure is best? Frontiers in Psychology, 14, Article 1192453. https://doi.org/10.3389/fpsyg.2023.1192453 ● Otwarty dostęp
- Greenhouse, S. W., & Geisser, S. (1959). On methods in the analysis of profile data. Psychometrika, 24(2), 95–112. https://doi.org/10.1007/BF02289823
- Huynh, H., & Feldt, L. S. (1976). Estimation of the Box correction for degrees of freedom from sample data in randomized block and split-plot designs. Journal of Educational Statistics, 1(1), 69–82. https://doi.org/10.3102/10769986001001069
- IBM Corp. (b.d.). GLM Repeated Measures. IBM SPSS Statistics 31.0.0 documentation. Pobrano 1 listopada 2026 z https://www.ibm.com/docs/en/spss-statistics/31.0.0?topic=statistics-glm-repeated-measures ● Otwarty dostęp
- IBM. (2026). GLM Repeated Measures: Options, Estimated Marginal Means and GLM: Repeated Measures command syntax (IBM SPSS Statistics 31.0.0). https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_reference_project_ddita/spss/advanced/syn_glm_repeated_measures.html ● Otwarty dostęp
- Mauchly, J. W. (1940). Significance test for sphericity of a normal n-variate distribution. The Annals of Mathematical Statistics, 11(2), 204–209. https://doi.org/10.1214/aoms/1177731915 ● Otwarty dostęp
- Olejnik, S., & Algina, J. (2003). Generalized eta and omega squared statistics: Measures of effect size for some common research designs. Psychological Methods, 8(4), 434–447. https://doi.org/10.1037/1082-989X.8.4.434
Cytowania BibTeX
@article{bakeman2005recommended, author={Bakeman, Roger}, title={{Recommended effect size statistics for repeated measures designs}}, journal={Behavior Research Methods}, year={2005}, volume={37}, number={3}, pages={379--384}, doi={10.3758/bf03192707}}@article{blanca2023repeated, author={Blanca, María J. and Arnau, Jaume and García-Castro, F. Javier and Alarcón, Rafael and Bono, Roser}, title={{Repeated measures ANOVA and adjusted F-tests when sphericity is violated: Which procedure is best?}}, journal={Frontiers in Psychology}, year={2023}, volume={14}, eid={1192453}, doi={10.3389/fpsyg.2023.1192453}}@article{greenhouse1959methods, author={Greenhouse, Samuel W. and Geisser, Seymour}, title={{On methods in the analysis of profile data}}, journal={Psychometrika}, year={1959}, volume={24}, number={2}, pages={95--112}, doi={10.1007/bf02289823}}@article{huynh1976estimation, author={Huynh, Huynh and Feldt, Leonard S.}, title={{Estimation of the Box correction for degrees of freedom from sample data in randomized block and split-plot designs}}, journal={Journal of Educational Statistics}, year={1976}, volume={1}, number={1}, pages={69--82}, doi={10.3102/10769986001001069}}@misc{ibmndglmrepeated, author={{IBM Corp.}}, title={{GLM Repeated Measures}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, publisher={IBM}, url={https://www.ibm.com/docs/en/spss-statistics/31.0.0?topic=statistics-glm-repeated-measures}}@misc{ibm2026glmrmokna, author={{IBM}}, title={{GLM Repeated Measures: Options, Estimated Marginal Means and GLM: Repeated Measures command syntax (IBM SPSS Statistics 31.0.0)}}, year={2026}, url={https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_reference_project_ddita/spss/advanced/syn_glm_repeated_measures.html}}@article{mauchly1940significance, author={Mauchly, John W.}, title={{Significance test for sphericity of a normal n-variate distribution}}, journal={The Annals of Mathematical Statistics}, year={1940}, volume={11}, number={2}, pages={204--209}, doi={10.1214/aoms/1177731915}}@article{olejnik2003generalized, author={Olejnik, Stephen and Algina, James}, title={{Generalized eta and omega squared statistics: Measures of effect size for some common research designs}}, journal={Psychological Methods}, year={2003}, volume={8}, number={4}, pages={434--447}, doi={10.1037/1082-989x.8.4.434}}