Który test i które okno w SPSS
Kiedy testy rangowe mają sens, co sprawdzają i jak policzyć je w R, opisuje poradnik testy nieparametryczne krok po kroku. Tutaj zajmujemy się tylko SPSS: oknami, wydrukiem i tym, co z niego przepisać.
| Schemat | Test | Stare okno (Legacy Dialogs) | Nowe okno |
|---|---|---|---|
| 2 grupy niezależne | Manna–Whitneya | 2 Independent Samples | Independent Samples |
| 3+ grupy niezależne | Kruskala–Wallisa | K Independent Samples | Independent Samples + porównania parami |
| 2 pomiary tych samych osób | Wilcoxona | 2 Related Samples | Related Samples |
| 3+ pomiary tych samych osób | Friedmana | K Related Samples | Related Samples + porównania parami |
Ścieżki menu, nazwy opcji i składnię sprawdziliśmy w oficjalnej dokumentacji IBM SPSS Statistics 32 (IBM Corp., b.d.-a, b.d.-b, b.d.-c, b.d.-d, b.d.-e, b.d.-f, b.d.-g). Podajemy je po angielsku; polska dokumentacja IBM tłumaczy je niejednolicie, więc w polskim interfejsie mogą wyglądać inaczej. Nazw kolumn w tabelach wynikowych (np. Asymp. Sig., Adj. Sig.) dokumentacja nie wymienia w całości – odtwarzamy typowy układ wydruku, więc w Twojej wersji mogą się nieco różnić. Ogólne zasady czytania wydruku opisuje wpis jak czytać wyniki z SPSS.
Przykład i pliki do pobrania
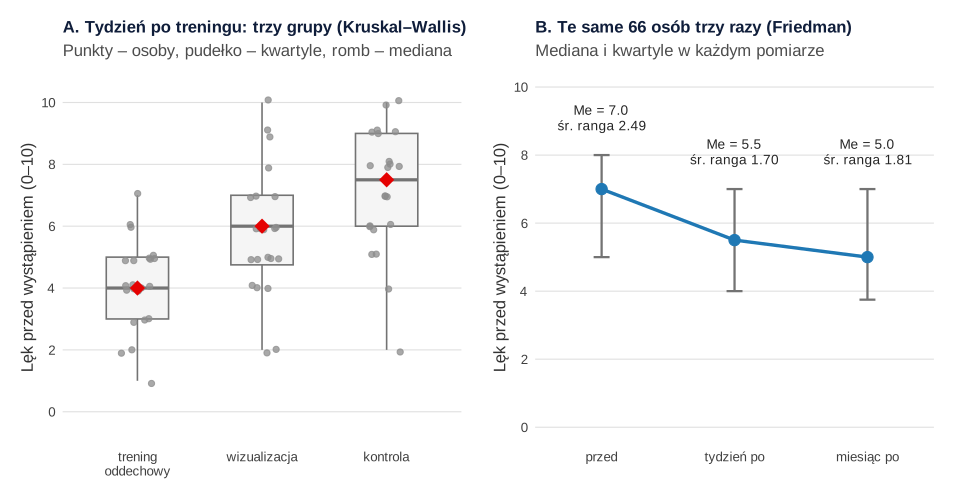
Wszystkie liczby pochodzą z jednego zbioru symulowanego. 66 osób studiujących przed pierwszym wystąpieniem na seminarium losowo przydzielono do trzech warunków po 22 osoby: trening oddechowy (kod 1), wizualizacja (2) i kontrola (3). Lęk przed wystąpieniem oceniły na skali 0–10 trzy razy: przed treningiem (lek_przed), tydzień po nim (lek_po) i miesiąc po nim (lek_miesiac). Krótka skala daje dużo remisów.
Pobierz plik .sav z etykietami zmiennych i wartości albo ten sam zbiór w pliku CSV. Format SPSS wyjaśnia hasło plik .sav.
Przygotowanie danych
- Grupy niezależne – format długi: wynik w jednej kolumnie, kod grupy w drugiej (zob. format długi i szeroki danych).
- Pomiary powtarzane – format szeroki: każdy pomiar w osobnej kolumnie.
- Poziom pomiaru w Variable View. Ważny w nowych oknach: zmienne testowane muszą być ilościowe (Scale) lub porządkowe (Ordinal), a zmienna grupująca – nominalna lub porządkowa (IBM Corp., b.d.-b). Grupująca zapisana jako Scale powoduje w składni NPTESTS błąd (IBM Corp., b.d.-e).
Pułapka: przy automatycznym wyborze testów okno Related Samples dla zmiennych porządkowych nie wykonuje żadnego testu (IBM Corp., b.d.-e). Przy pozycjach Likerta z poziomem Ordinal wybierz testy ręcznie (Customize tests). W przykładzie pomiary lęku mają poziom Scale, a grupa – Nominal. Etykiety i kody braków pokazuje wpis przygotowanie danych w SPSS.
Stare czy nowe okna?
Stare okna (Analyze → Nonparametric Tests → Legacy Dialogs; w polskiej dokumentacji: Analiza → Testy nieparametryczne → Okna dialogowe starszej wersji) dają zwykłe tabele Ranks i Test Statistics. Mają Define Groups i kwartyle w Options (IBM Corp., b.d.-c), ale nie liczą porównań parami.
Nowe okna (Analyze → Nonparametric Tests → Independent Samples albo Related Samples; zakładki Objective, Fields, Settings) liczą porównania parami: All pairwise albo Stepwise step-down (IBM Corp., b.d.-b, b.d.-f). Wynik trafia do obiektu modelu: po dwukrotnym kliknięciu widzisz Hypothesis Test Summary i widoki pomocnicze, m.in. Pairwise Comparisons. Zwykłe tabele dostaniesz, wybierając Pivot tables and charts w Edit → Options → Output (IBM Corp., b.d.-g).
Dokładne p. Przycisk Exact z metodą dokładną i Monte Carlo wymaga opcji Exact Tests (IBM Corp., b.d.-a). Bez niej SPSS podaje istotność asymptotyczną; tylko w teście Manna–Whitneya przy 40 lub mniej obserwacjach liczy też dokładną (IBM Corp., b.d.-d). W przykładzie porównujemy 44 osoby.
Test Manna–Whitneya krok po kroku
Pytanie: czy tydzień po treningu oddechowym lęk był mniejszy niż w grupie kontrolnej?
- Analyze → Nonparametric Tests → Legacy Dialogs → 2 Independent Samples. Przenieś
lek_podo Test Variable List, agrupado Grouping Variable. Zostaw zaznaczony test Mann-Whitney U. - Define Groups: wpisz 1 i 3. Osoby z kodem 2 SPSS pominie (IBM Corp., b.d.-c).
- Options → Quartiles, potem Paste zamiast OK.
Nowe okno Independent Samples nie ma Define Groups i nie wykona testu Manna–Whitneya, gdy zmienna grupująca ma więcej niż dwie wartości (IBM Corp., b.d.-b) – najpierw wybierz dwie grupy przez Data → Select Cases.
| grupa | N | Mean Rank | Sum of Ranks |
|---|---|---|---|
| trening oddechowy | 22 | 13.95 | 307.00 |
| kontrola | 22 | 31.05 | 683.00 |
| Total | 44 |
| lek_po | |
|---|---|
| Mann-Whitney U | 54.000 |
| Wilcoxon W | 307.000 |
| Z | −4.453 |
| Asymp. Sig. (2-tailed) | .000 |
Sprawdź N (44). U to mniejsza z dwóch liczb par, w których wynik jednej grupy wyprzedza drugą, a W Wilcoxona – suma rang grupy z mniejszą średnią rangą (IBM Corp., b.d.-c). Do pracy wystarczy U. Kierunek odczytaj ze średnich rang, nie ze znaku Z. Wartość .000 zapisz jako p < .001 (dokładnie p = 8.5 × 10⁻⁶). Mediany [kwartyle]: 4.0 [3.0, 5.0] wobec 7.5 [6.0, 9.0].
Test sprawdza równość rozkładów, a jako test położenia wymaga tego samego kształtu (IBM Corp., b.d.-c). Nie pisz „mediany różnią się istotnie” – to nie jest test median (Divine i in., 2018).
Test Kruskala–Wallisa i porównania parami
Pytanie: czy trzy warunki różnią się lękiem tydzień po treningu? W starym oknie K Independent Samples przenieś lek_po i grupa, a w Define Range wpisz minimum 1 i maksimum 3. Obserwacje spoza zakresu SPSS wykluczy (IBM Corp., b.d.-c).
| grupa | N | Mean Rank |
|---|---|---|
| trening oddechowy | 22 | 19.36 |
| wizualizacja | 22 | 34.89 |
| kontrola | 22 | 46.25 |
| Total | 66 | |
| Kruskal-Wallis H | 22.194 | |
| df | 2 | |
| Asymp. Sig. | .000 | |
H(2) = 22.19, p < .001 mówi tylko, że co najmniej jedna grupa się wyróżnia. Pary sprawdzisz w nowym oknie:
- Analyze → Nonparametric Tests → Independent Samples (w polskiej dokumentacji: Analiza → Testy nieparametryczne → Próbki niezależne).
- Fields: Use custom field assignments,
lek_podo Test Fields,grupado Groups. - Settings → Choose Tests → Customize tests: zaznacz Kruskal-Wallis 1-way ANOVA (k samples) i w Multiple comparisons wybierz All pairwise (IBM Corp., b.d.-b). Paste albo Run.
| Sample 1-Sample 2 | Test Statistic | Std. Error | Std. Test Statistic | Sig. | Adj. Sig. |
|---|---|---|---|---|---|
| trening oddechowy-wizualizacja | −15.523 | 5.730 | −2.709 | .007 | .020 |
| trening oddechowy-kontrola | −26.886 | 5.730 | −4.692 | .000 | .000 |
| wizualizacja-kontrola | −11.364 | 5.730 | −1.983 | .047 | .142 |
Test Statistic to tu różnica średnich rang dwóch grup (19.36 − 34.89 = −15.52), a Std. Test Statistic – wartość z. Porównania korzystają ze wspólnego rangowania wszystkich 66 osób, jak u Dunna (1964), a nie z osobnych testów Manna–Whitneya. Przepisz skorygowane p. Sprawdzona dokumentacja nie nazywa metody korekty – odczytaj ją z przypisu pod tabelą. Tabelę policzyliśmy z korektą Bonferroniego: różnica wizualizacja–kontrola jest nieistotna (.142), a przy korekcie Holma byłoby p = .047 (zob. test Dunna).
Test Wilcoxona krok po kroku
Pytanie: czy lęk zmienił się między pomiarem przed treningiem a tydzień później (66 osób)?
- Analyze → Nonparametric Tests → Legacy Dialogs → 2 Related Samples: para
lek_przedilek_po, test Wilcoxon, Options → Quartiles, Paste.
| N | Mean Rank | Sum of Ranks | |
|---|---|---|---|
| Negative Ranks (lek_po < lek_przed) | 42 | 24.54 | 1030.50 |
| Positive Ranks (lek_po > lek_przed) | 6 | 24.25 | 145.50 |
| Ties | 18 | ||
| Total | 66 |
| lek_po − lek_przed | |
|---|---|
| Z | −4.631 |
| Asymp. Sig. (2-tailed) | .000 |
Test rangował wartości bezwzględne różnic i porównał sumy rang dodatnich i ujemnych (IBM Corp., b.d.-d). Co jest „ujemne”, zależy od kolejności zmiennych w parze – sprawdź przypis pod tabelą Ranks. Lęk spadł u 42 osób, wzrósł u 6, a 18 remisów test pominął – napisz o tym. Mediany: 7.0 [5.0, 8.0] przed i 5.5 [4.0, 7.0] tydzień po. Dokumentacja zakłada symetryczny rozkład różnic (IBM Corp., b.d.-c).
Test Friedmana i porównania parami
Czy lęk różnił się w trzech pomiarach? W starym oknie K Related Samples przenieś lek_przed, lek_po i lek_miesiac do Test Variables. Zaznacz Friedman i Kendall's W – unormowaną statystykę Friedmana od 0 do 1 (IBM Corp., b.d.-c).
| Mean Rank | |
|---|---|
| lek_przed | 2.49 |
| lek_po | 1.70 |
| lek_miesiac | 1.81 |
| N | 66 |
| Chi-Square | 30.140 |
| df | 2 |
| Asymp. Sig. | .000 |
W każdym wierszu SPSS rangował pomiary od 1 do 3 (IBM Corp., b.d.-d); najniższa średnia ranga to najmniejszy lęk. Pary sprawdzisz w nowym oknie Related Samples (polska dokumentacja: Próbki powiązane): w Fields trzy pomiary, w Settings → Customize tests zaznacz Friedman's 2-way ANOVA by ranks (k samples) i All pairwise (IBM Corp., b.d.-f).
| Sample 1-Sample 2 | Test Statistic | Std. Error | Std. Test Statistic | Sig. | Adj. Sig. |
|---|---|---|---|---|---|
| lek_przed-lek_po | .795 | .174 | 4.570 | .000 | .000 |
| lek_przed-lek_miesiac | .682 | .174 | 3.917 | .000 | .000 |
| lek_po-lek_miesiac | −.114 | .174 | −.653 | .514 | 1.000 |
Lęk był niższy tydzień i miesiąc po treningu niż przed nim, a dwa późniejsze pomiary się nie różniły. Inne procedury porównań omawia hasło test Friedmana.
Wielkość efektu – policz ręcznie
Poza Kendall's W SPSS nie poda tu wielkości efektu – policz ją z wydruku:
| Test | Miara i wzór | Przykład |
|---|---|---|
| Mann–Whitney | r = |Z|/√N; korelacja rangowo-biseryjna 1 − 2U/(n1n2) | r = 4.453/√44 = .67; rrb = 1 − 108/484 = .78, 95% CI [.60, .88] |
| Wilcoxon | r = |Z|/√n (podaj n); rrb = (T− − T+)/(T− + T+) | r = .67 dla 48 par bez remisów albo .57 dla 66; rrb = 885/1176 = .75, 95% CI [.61, .85] |
| Kruskal–Wallis | ε² = H/(N − 1) | 22.194/65 = .34 |
| Friedman | W Kendalla = χ²/[n(k − 1)] | 30.140/132 = .23 |
Korelacja rangowo-biseryjna to odsetek par zgodnych z hipotezą minus odsetek niezgodnych (Kerby, 2014); w przykładzie z Manna–Whitneya w 89% par (remisy po połowie) wyższy lęk miała osoba z grupy kontrolnej. Przy r = Z/√N napisz, jakie N przyjąłeś – .67 i .57 w teście Wilcoxona różnią się tylko tym. Przedziały ufności policzyliśmy w R. Wybór miary, przeliczenia i progi omawia wpis wielkość efektu dla testów nieparametrycznych.
Zapis wyników w stylu APA
Podaj mediany z kwartylami, statystykę testu, p, wielkość efektu z nazwą i porównania parami z nazwą korekty. Wzory:
Jeśli przypis w SPSS podaje inną korektę, zmień nazwę i liczby. Zdania do innych analiz przygotuje generator opisu wyników APA, a test do hipotezy podpowie kreator doboru testu.
Składnia SPSS i kod R
Przepis 1 to składnia do wklejenia w edytorze składni SPSS. Napisaliśmy ją według opisu poleceń NPAR TESTS i NPTESTS w Command Syntax Reference (IBM Corp., b.d.-d, b.d.-e), ale nie uruchamialiśmy jej w SPSS. Przepis 2 w R tworzy pliki do pobrania i liczy liczby z tabel tymi samymi metodami co SPSS: rangi średnie przy remisach, Z z poprawką na rangi wiązane (pakiet coin), pominięcie różnic zerowych w teście Wilcoxona i porównania parami ze wspólnego rangowania z korektą Bonferroniego.
1. Składnia SPSS: NPAR TESTS i NPTESTS
SPSS
* Testy nieparametryczne: lęk przed wystąpieniem (0–10), grupa 1 = trening oddechowy, 2 = wizualizacja, 3 = kontrola.
* Składnia zgodna z opisem NPAR TESTS, NPTESTS i VARIABLE LEVEL w Command Syntax Reference; nie była uruchamiana w SPSS.
VARIABLE LEVEL lek_przed lek_po lek_miesiac (SCALE)
  /grupa (NOMINAL).

* Stare okna (Legacy Dialogs): Mann–Whitney dla grup 1 i 3, Kruskal–Wallis dla kodów 1–3.
NPAR TESTS
  /M-W=lek_po BY grupa(1,3)
  /STATISTICS=QUARTILES
  /MISSING=ANALYSIS.
NPAR TESTS
  /K-W=lek_po BY grupa(1,3)
  /STATISTICS=QUARTILES
  /MISSING=ANALYSIS.

* Wilcoxon (para przed – tydzień po) oraz Friedman i W Kendalla dla trzech pomiarów.
NPAR TESTS
  /WILCOXON=lek_przed WITH lek_po (PAIRED)
  /FRIEDMAN=lek_przed lek_po lek_miesiac
  /KENDALL=lek_przed lek_po lek_miesiac
  /STATISTICS=QUARTILES
  /MISSING=ANALYSIS.

* Nowe okna: Kruskal–Wallis i Friedman ze wszystkimi porównaniami parami.
NPTESTS
  /INDEPENDENT TEST(lek_po) GROUP(grupa) KRUSKAL_WALLIS(COMPARE=PAIRWISE)
  /MISSING SCOPE=ANALYSIS USERMISSING=EXCLUDE
  /CRITERIA ALPHA=0.05 CILEVEL=95.
NPTESTS
  /RELATED TEST(lek_przed lek_po lek_miesiac) FRIEDMAN(COMPARE=PAIRWISE)
  /MISSING SCOPE=ANALYSIS USERMISSING=EXCLUDE
  /CRITERIA ALPHA=0.05 CILEVEL=95.
2. Te same liczby w R i pliki .sav oraz CSV
R
# B290 – testy nieparametryczne w SPSS: liczby do tabel w układzie SPSS
# Dane symulowane, set.seed(2903): 66 osób studiujących przed pierwszym wystąpieniem na seminarium,
# trzy warunki po 22 osoby (1 = trening oddechowy, 2 = wizualizacja, 3 = kontrola);
# lęk przed wystąpieniem (0–10) przed treningiem, tydzień po nim i miesiąc po nim.
# Metody jak w SPSS: rangi średnie przy remisach, U = mniejsza z dwóch wartości, Z z poprawką na rangi
# wiązane (bez poprawki na ciągłość), H i chi-kwadrat Friedmana z poprawką na remisy, zera w teście
# Wilcoxona pomijane, porównania parami ze wspólnego rangowania (Dunn) z korektą Bonferroniego.
suppressPackageStartupMessages({ library(haven); library(coin); library(effectsize); library(rstatix) })   # coin:: wskazujemy wprost, bo rstatix ma funkcje o tych samych nazwach
set.seed(2903)
n <- 22
grupa <- rep(1:3, each = n)
ogr <- function(x) pmin(10, pmax(0, round(x)))
baza <- rnorm(3 * n, 6.2, 1.6)
lek_przed <- ogr(baza)
lek_po <- ogr(baza + c(-1.9, -0.9, -0.2)[grupa] + rnorm(3 * n, 0, 1.3))
lek_miesiac <- ogr(baza + c(-1.6, -1.0, -0.4)[grupa] + rnorm(3 * n, 0, 1.5))
dane <- data.frame(id = seq_len(3 * n), grupa, lek_przed, lek_po, lek_miesiac)

# Krok 1. Plik .sav z etykietami zmiennych i wartości (formaty liczb całkowitych) – i ten sam zbiór w CSV
sav <- dane
sav$grupa <- labelled(sav$grupa, labels = c("trening oddechowy" = 1, "wizualizacja" = 2, "kontrola" = 3),
                      label = "Warunek")
etykiety <- c(id = "Numer osoby", lek_przed = "Lęk przed wystąpieniem (0–10) – przed treningiem",
              lek_po = "Lęk przed wystąpieniem (0–10) – tydzień po treningu",
              lek_miesiac = "Lęk przed wystąpieniem (0–10) – miesiąc po treningu")
for (v in names(etykiety)) attr(sav[[v]], "label") <- etykiety[[v]]
for (v in names(sav)) attr(sav[[v]], "format.spss") <- "F2.0"
write_sav(sav, "../testy-nieparametryczne-spss-dane.sav")
write.csv(dane, "../testy-nieparametryczne-spss-dane.csv", row.names = FALSE, fileEncoding = "UTF-8")
sapply(read_sav("../testy-nieparametryczne-spss-dane.sav"), function(x) names(attributes(x)))   # tylko etykiety i format

# Krok 2. Opis: mediana i kwartyle jak w SPSS (percentyle metodą średniej ważonej = type 6 w R)
kw <- function(x) quantile(x, c(.25, .5, .75), type = 6)
round(do.call(rbind, lapply(split(dane$lek_po, dane$grupa), kw)), 2)
round(sapply(dane[, c("lek_przed", "lek_po", "lek_miesiac")], kw), 2)

# Krok 3. Mann–Whitney (Legacy Dialogs → 2 Independent Samples, grupy 1 i 3): Ranks i Test Statistics
mw <- subset(dane, grupa %in% c(1, 3))
rg <- rank(mw$lek_po)
n1 <- sum(mw$grupa == 1); n3 <- sum(mw$grupa == 3)
R1 <- sum(rg[mw$grupa == 1]); R3 <- sum(rg[mw$grupa == 3])
rbind(N = c(n1, n3), mean_rank = c(R1 / n1, R3 / n3), sum_ranks = c(R1, R3))
U1 <- R1 - n1 * (n1 + 1) / 2; U <- min(U1, n1 * n3 - U1)
W <- if (R1 / n1 < R3 / n3) R1 else R3          # suma rang grupy z mniejszą średnią rangą
mw_test <- coin::wilcox_test(lek_po ~ factor(grupa), data = mw)   # coin: Z z poprawką na remisy, bez poprawki na ciągłość
Z <- statistic(mw_test)
round(c(U = U, W = W, Z = unname(Z), N = nrow(mw)), 3)
format.pval(pvalue(mw_test), digits = 3)
# wielkość efektu ręcznie: r = Z/√N oraz korelacja rangowo-biseryjna (dla grupy 1 względem 3)
round(c(r = abs(unname(Z)) / sqrt(nrow(mw)), rrb = 2 * U1 / (n1 * n3) - 1), 3)
print(rank_biserial(lek_po ~ grupa, data = transform(mw, grupa = factor(grupa))), digits = 3)

# Krok 4. Kruskal–Wallis (K Independent Samples, zakres 1–3): Ranks i Test Statistics
rk <- rank(dane$lek_po)
round(rbind(N = tapply(rk, dane$grupa, length), mean_rank = tapply(rk, dane$grupa, mean)), 2)
kw_test <- kruskal.test(lek_po ~ factor(grupa), data = dane)   # H z poprawką na remisy
round(c(H = unname(kw_test$statistic), df = unname(kw_test$parameter)), 3)
format.pval(kw_test$p.value, digits = 3)
round(c(epsilon2 = unname(kw_test$statistic) / (nrow(dane) - 1)), 3)

# Krok 5. Porównania parami jak w nowym oknie (Independent Samples → Kruskal-Wallis, All pairwise):
# różnica średnich rang, błąd standardowy z poprawką na remisy, z, p i p po korekcie Bonferroniego
N <- nrow(dane); tt <- table(rk); popr <- sum(tt^3 - tt) / (12 * (N - 1))
mr <- tapply(rk, dane$grupa, mean); ng <- tapply(rk, dane$grupa, length)
pary <- list(c(1, 2), c(1, 3), c(2, 3))
dunn <- t(sapply(pary, function(p) {
  roz <- unname(mr[p[1]] - mr[p[2]])
  se <- unname(sqrt((N * (N + 1) / 12 - popr) * (1 / ng[p[1]] + 1 / ng[p[2]])))
  z <- roz / se; pp <- 2 * pnorm(-abs(z))
  c(test_stat = roz, se = se, z = z, p = pp, p_bonf = min(1, pp * length(pary)))
}))
rownames(dunn) <- c("1-2", "1-3", "2-3"); round(dunn, 3)
dunn_test(transform(dane, grupa = factor(grupa)), lek_po ~ grupa, p.adjust.method = "holm")[, c("group1", "group2", "statistic", "p", "p.adj")]

# Krok 6. Wilcoxon (2 Related Samples: lek_przed i lek_po): Ranks i Test Statistics
d <- dane$lek_po - dane$lek_przed               # druga zmienna pary minus pierwsza
nz <- d != 0; rd <- rank(abs(d[nz]))
c(negative = sum(d < 0), positive = sum(d > 0), ties = sum(d == 0), total = length(d))
round(c(mean_neg = mean(rd[d[nz] < 0]), sum_neg = sum(rd[d[nz] < 0]),
        mean_pos = mean(rd[d[nz] > 0]), sum_pos = sum(rd[d[nz] > 0])), 2)
wx <- coin::wilcoxsign_test(lek_po ~ lek_przed, data = dane, zero.method = "Wilcoxon")  # zera pomijane
round(c(Z = unname(statistic(wx))), 3)
format.pval(pvalue(wx), digits = 3)
Tm <- sum(rd[d[nz] < 0]); Tp <- sum(rd[d[nz] > 0])
round(c(r_n_niezerowe = abs(unname(statistic(wx))) / sqrt(sum(nz)), r_n_wszystkie = abs(unname(statistic(wx))) / sqrt(length(d)),
        rrb_pary = (Tm - Tp) / (Tm + Tp)), 3)
print(rank_biserial(dane$lek_przed, dane$lek_po, paired = TRUE), digits = 3)

# Krok 7. Friedman (K Related Samples: trzy pomiary) z W Kendalla
m <- as.matrix(dane[, c("lek_przed", "lek_po", "lek_miesiac")])
rr <- t(apply(m, 1, rank))
round(colMeans(rr), 2)
fr <- friedman.test(m)
round(c(N = nrow(m), chi2 = unname(fr$statistic), df = unname(fr$parameter)), 3)
format.pval(fr$p.value, digits = 3)
round(c(W_Kendalla = unname(fr$statistic) / (nrow(m) * (ncol(m) - 1))), 3)

# Krok 8. Porównania parami po teście Friedmana jak w nowym oknie (Related Samples → All pairwise):
# różnica średnich rang, SE = √[k(k + 1)/(6n)], z, p i p po korekcie Bonferroniego
k <- ncol(m); se_f <- sqrt(k * (k + 1) / (6 * nrow(m))); mrf <- colMeans(rr)
fp <- t(sapply(list(c(1, 2), c(1, 3), c(2, 3)), function(p) {
  roz <- unname(mrf[p[1]] - mrf[p[2]]); z <- roz / se_f; pp <- 2 * pnorm(-abs(z))
  c(test_stat = roz, se = se_f, z = z, p = pp, p_bonf = min(1, 3 * pp))
}))
rownames(fp) <- c("przed-po", "przed-miesiac", "po-miesiac"); round(fp, 3)
Wynik w R
$id
[1] "label"       "format.spss"

$grupa
[1] "label"       "format.spss" "class"       "labels"

$lek_przed
[1] "label"       "format.spss"

$lek_po
[1] "label"       "format.spss"

$lek_miesiac
[1] "label"       "format.spss"

   25% 50% 75%
1 3.00 4.0   5
2 4.75 6.0   7
3 6.00 7.5   9
    lek_przed lek_po lek_miesiac
25%         5    4.0        3.75
50%         7    5.5        5.00
75%         8    7.0        7.00
               [,1]      [,2]
N          22.00000  22.00000
mean_rank  13.95455  31.04545
sum_ranks 307.00000 683.00000
      U       W       Z       N
 54.000 307.000  -4.453  44.000
[1] "8.48e-06"
     r    rrb
 0.671 -0.777
r (rank biserial) |           95% CI
------------------------------------
-0.777            | [-0.881, -0.599]
              1     2     3
N         22.00 22.00 22.00
mean_rank 19.36 34.89 46.25
     H     df
22.194  2.000
[1] "1.52e-05"
epsilon2
   0.341
    test_stat   se      z     p p_bonf
1-2   -15.523 5.73 -2.709 0.007  0.020
1-3   -26.886 5.73 -4.692 0.000  0.000
2-3   -11.364 5.73 -1.983 0.047  0.142
# A tibble: 3 × 5
  group1 group2 statistic          p      p.adj
  <chr>  <chr>      <dbl>      <dbl>      <dbl>
1 1      2           2.71 0.00675    0.0135
2 1      3           4.69 0.00000270 0.00000810
3 2      3           1.98 0.0473     0.0473
negative positive     ties    total
      42        6       18       66
mean_neg  sum_neg mean_pos  sum_pos
   24.54  1030.50    24.25   145.50
     Z
-4.631
[1] "3.64e-06"
r_n_niezerowe r_n_wszystkie      rrb_pary
        0.668         0.570         0.753
r (rank biserial) |         95% CI
----------------------------------
0.753             | [0.605, 0.850]
  lek_przed      lek_po lek_miesiac
       2.49        1.70        1.81
    N  chi2    df
66.00 30.14  2.00
[1] "2.85e-07"
W_Kendalla
     0.228
              test_stat    se      z     p p_bonf
przed-po          0.795 0.174  4.570 0.000      0
przed-miesiac     0.682 0.174  3.917 0.000      0
po-miesiac       -0.114 0.174 -0.653 0.514      1
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek przygotowano w pakietach ggplot2 i patchwork. Składni SPSS nie uruchamialiśmy. W pracy podaj wersję programu, którego faktycznie użyłeś.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- haven (wersja 2.5.5): Wickham, H., Miller, E., & Smith, D. (2025). haven: Import and export 'SPSS', 'Stata' and 'SAS' files [R package]. https://doi.org/10.32614/CRAN.package.haven
- coin (wersja 1.4.3): Hothorn, T., Hornik, K., van de Wiel, M. A., & Zeileis, A. (2008). Implementing a class of permutation tests: The coin package. Journal of Statistical Software, 28(8), 1–23. https://doi.org/10.18637/jss.v028.i08
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- rstatix (wersja 0.7.3): Kassambara, A. (2023). rstatix: Pipe-friendly framework for basic statistical tests [R package]. https://doi.org/10.32614/CRAN.package.rstatix
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Typowe błędy
- Pomiary przed i po w jednej kolumnie z „grupą” 1 = przed, 2 = po i test Manna–Whitneya. Te same osoby to Wilcoxon albo Friedman.
- Seria testów Manna–Whitneya po teście Kruskala–Wallisa bez korekty zamiast porównań parami z nowego okna.
- Brak wyniku w nowym oknie przez zły poziom pomiaru albo więcej niż dwa kody grup przy teście Manna–Whitneya.
- „Sig. = .000” przepisane dosłownie. W pracy pisz p < .001 (zob. wartość p).
Czy potrzebujesz testu rangowego, podpowie wpis test t przy rozkładzie innym niż normalny. Odpowiedniki parametryczne pokazują wpisy test t w SPSS i ANOVA w SPSS. Z serii zob. też alfa Cronbacha, korelacja i regresja i chi-kwadrat w SPSS.
Najczęstsze pytania
Gdzie w SPSS są testy Manna–Whitneya, Wilcoxona, Kruskala–Wallisa i Friedmana?
W starych oknach: Analyze → Nonparametric Tests → Legacy Dialogs → 2 Independent Samples (Mann–Whitney), 2 Related Samples (Wilcoxon), K Independent Samples (Kruskal–Wallis) i K Related Samples (Friedman). Te same testy uruchomisz w nowych oknach Analyze → Nonparametric Tests → Independent Samples albo Related Samples. W polskiej dokumentacji IBM stare okna to Analiza → Testy nieparametryczne → Okna dialogowe starszej wersji.
Dlaczego nowe okno Independent Samples w SPSS nie pokazuje testu Manna–Whitneya?
Najczęściej z dwóch powodów. Zmienna grupująca ma więcej niż dwie wartości – wtedy według dokumentacji IBM test Manna–Whitneya nie jest wykonywany i trzeba wybrać przypadki dwóch grup albo użyć starego okna z Define Groups. Albo zmienne mają zły poziom pomiaru w Variable View: testowana musi być ilościowa lub porządkowa, a grupująca – nominalna lub porządkowa.
Jak zrobić porównania parami po teście Kruskala–Wallisa w SPSS?
Stare okno K Independent Samples ich nie liczy. Użyj Analyze → Nonparametric Tests → Independent Samples, w zakładce Settings wybierz Customize tests, Kruskal-Wallis 1-way ANOVA i Multiple comparisons: All pairwise. W składni odpowiada temu KRUSKAL_WALLIS(COMPARE=PAIRWISE). Do pracy przepisz skorygowane p i nazwij metodę korekty podaną pod tabelą.
Czy SPSS podaje wielkość efektu dla testów nieparametrycznych?
W opisanych tu procedurach nie ma opcji wielkości efektu, więc policz ją sam z wydruku: r = |Z|/√N albo korelację rangowo-biseryjną dla Manna–Whitneya i Wilcoxona, ε² = H/(N − 1) dla Kruskala–Wallisa i W Kendalla dla Friedmana (W możesz zaznaczyć w oknie K Related Samples). W przykładzie wyszło r = .67, ε² = .34 i W = .23.
Kiedy SPSS podaje dokładne p w teście Manna–Whitneya?
Według opisu polecenia NPAR TESTS dokładny poziom istotności testu Manna–Whitneya jest liczony, gdy w analizie jest 40 lub mniej obserwacji; przy większej próbie zostaje przybliżenie normalne. Przycisk Exact z metodą dokładną i Monte Carlo dla pozostałych testów wymaga opcji Exact Tests. Przy małych próbach podaj p dokładne i napisz, którą wartość raportujesz.
Powiązane hasła
Przeczytaj też
Jak czytać wyniki z SPSS
Osiem najczęstszych tabel SPSS: co odczytać, który wiersz wybrać, co znaczy Sig. = .000 i jak przepisać wynik w stylu APA.
Czytaj →PoradnikTesty nieparametryczne krok po kroku
Kiedy test rangowy ma sens, Mann–Whitney, Wilcoxon, Kruskal–Wallis z testem Dunna i Friedman na jednym badaniu – z wielkością efektu i opisem APA.
Czytaj →PoradnikWielkość efektu w testach nieparametrycznych
r = Z/√N, korelacja rangowo-biseryjna, delta Cliffa, A Varghi–Delaneya, ε² i W Kendalla: co mierzą, jak je przeliczać i podać z CI – z kodem R.
Czytaj →Masz wydruk testu nieparametrycznego z SPSS i nie wiesz, co przepisać?
Sprawdzimy układ danych, wybór testu i porównań parami, wielkość efektu oraz opis wyników i wyjaśnimy je tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Divine, G. W., Norton, H. J., Barón, A. E., & Juarez-Colunga, E. (2018). The Wilcoxon–Mann–Whitney procedure fails as a test of medians. The American Statistician, 72(3), 278–286. https://doi.org/10.1080/00031305.2017.1305291 ● Otwarty dostęp
- Dunn, O. J. (1964). Multiple comparisons using rank sums. Technometrics, 6(3), 241–252. https://doi.org/10.1080/00401706.1964.10490181
- IBM Corp. (b.d.-a). Exact Tests. IBM SPSS Statistics 32.0.0 documentation. https://www.ibm.com/docs/en/spss-statistics/32.0.0?topic=edition-exact-tests ● Otwarty dostęp
- IBM Corp. (b.d.-b). Independent-Samples Nonparametric Tests. IBM SPSS Statistics 32.0.0 documentation. https://www.ibm.com/docs/en/spss-statistics/32.0.0?topic=tests-independent-samples-nonparametric ● Otwarty dostęp
- IBM Corp. (b.d.-c). Legacy Dialogs (Nonparametric Tests). IBM SPSS Statistics 32.0.0 documentation. https://www.ibm.com/docs/en/spss-statistics/32.0.0?topic=tests-legacy-dialogs-nonparametric ● Otwarty dostęp
- IBM Corp. (b.d.-d). NPAR TESTS. IBM SPSS Statistics 32.0.0 Command Syntax Reference. https://www.ibm.com/docs/en/spss-statistics/32.0.0?topic=reference-npar-tests ● Otwarty dostęp
- IBM Corp. (b.d.-e). NPTESTS. IBM SPSS Statistics 32.0.0 Command Syntax Reference. https://www.ibm.com/docs/en/spss-statistics/32.0.0?topic=reference-nptests ● Otwarty dostęp
- IBM Corp. (b.d.-f). Related-Samples Nonparametric Tests. IBM SPSS Statistics 32.0.0 documentation. https://www.ibm.com/docs/en/spss-statistics/32.0.0?topic=tests-related-samples-nonparametric ● Otwarty dostęp
- IBM Corp. (b.d.-g). Using Nonparametric Tests to Study Credit Card Data. IBM SPSS Statistics 32.0.0 documentation. https://www.ibm.com/docs/en/spss-statistics/32.0.0?topic=tests-using-nonparametric-study-credit-card-data ● Otwarty dostęp
- Kerby, D. S. (2014). The simple difference formula: An approach to teaching nonparametric correlation. Comprehensive Psychology, 3, Article 11.IT.3.1. https://doi.org/10.2466/11.IT.3.1 ● Otwarty dostęp
Cytowania BibTeX
@article{divine2018wilcoxon, author={Divine, George W. and Norton, H. James and Barón, Anna E. and Juarez-Colunga, Elizabeth}, title={{The Wilcoxon–Mann–Whitney procedure fails as a test of medians}}, journal={The American Statistician}, year={2018}, volume={72}, number={3}, pages={278--286}, doi={10.1080/00031305.2017.1305291}}@article{dunn1964multiple, author={Dunn, Olive Jean}, title={{Multiple comparisons using rank sums}}, journal={Technometrics}, year={1964}, volume={6}, number={3}, pages={241--252}, doi={10.1080/00401706.1964.10490181}}@misc{ibmndexacttests32, author={{IBM Corp.}}, title={{Exact Tests}}, howpublished={IBM SPSS Statistics 32.0.0 documentation}, year={b.d.-a}, publisher={IBM}, url={https://www.ibm.com/docs/en/spss-statistics/32.0.0?topic=edition-exact-tests}}@misc{ibmndnptestsindependent32, author={{IBM Corp.}}, title={{Independent-Samples Nonparametric Tests}}, howpublished={IBM SPSS Statistics 32.0.0 documentation}, year={b.d.-b}, publisher={IBM}, url={https://www.ibm.com/docs/en/spss-statistics/32.0.0?topic=tests-independent-samples-nonparametric}}@misc{ibmndnparlegacy32, author={{IBM Corp.}}, title={{Legacy Dialogs (Nonparametric Tests)}}, howpublished={IBM SPSS Statistics 32.0.0 documentation}, year={b.d.-c}, publisher={IBM}, url={https://www.ibm.com/docs/en/spss-statistics/32.0.0?topic=tests-legacy-dialogs-nonparametric}}@misc{ibmndnpartestssyntax32, author={{IBM Corp.}}, title={{NPAR TESTS}}, howpublished={IBM SPSS Statistics 32.0.0 Command Syntax Reference}, year={b.d.-d}, publisher={IBM}, url={https://www.ibm.com/docs/en/spss-statistics/32.0.0?topic=reference-npar-tests}}@misc{ibmndnptestssyntax32, author={{IBM Corp.}}, title={{NPTESTS}}, howpublished={IBM SPSS Statistics 32.0.0 Command Syntax Reference}, year={b.d.-e}, publisher={IBM}, url={https://www.ibm.com/docs/en/spss-statistics/32.0.0?topic=reference-nptests}}@misc{ibmndnptestsrelated32, author={{IBM Corp.}}, title={{Related-Samples Nonparametric Tests}}, howpublished={IBM SPSS Statistics 32.0.0 documentation}, year={b.d.-f}, publisher={IBM}, url={https://www.ibm.com/docs/en/spss-statistics/32.0.0?topic=tests-related-samples-nonparametric}}@misc{ibmndnparcreditcard32, author={{IBM Corp.}}, title={{Using Nonparametric Tests to Study Credit Card Data}}, howpublished={IBM SPSS Statistics 32.0.0 documentation}, year={b.d.-g}, publisher={IBM}, url={https://www.ibm.com/docs/en/spss-statistics/32.0.0?topic=tests-using-nonparametric-study-credit-card-data}}@article{kerby2014simple, author={Kerby, Dave S.}, title={{The simple difference formula: An approach to teaching nonparametric correlation}}, journal={Comprehensive Psychology}, year={2014}, volume={3}, eid={11.IT.3.1}, doi={10.2466/11.it.3.1}}