Po co osobne miary efektu dla testów rangowych
Test rangowy mówi, czy różnica jest większa, niż dałby przypadek. Nie mówi, jak duża jest. Fritz i in. (2012) pokazali, że w artykułach z czołowego czasopisma psychologicznego wielkość efektu podano dla mniej niż połowy analiz. Przy testach rangowych dochodzi problem wyboru miary, bo d Cohena i η² opierają się na średnich i wariancjach. Test rangowy pracuje na rangach, więc i miara efektu powinna mówić o rangach albo o porównaniu par osób.
Ten wpis rozwija krok 6 poradnika testy nieparametryczne krok po kroku. Tu porównujemy same miary efektu: co mierzą, jak je przeliczać, skąd biorą się progi i jak liczyć przedziały ufności. Ogólne zasady interpretacji opisuje wpis wielkość efektu – interpretacja.
Który test, jaka miara
| Test | Miara | Wzór | Zakres (brak efektu) |
|---|---|---|---|
| U Manna–Whitneya | korelacja rangowo-biseryjna rrb | 2U/(n1n2) − 1 | −1 do 1 (0) |
| delta Cliffa δ | P(X > Y) − P(X < Y) | −1 do 1 (0) | |
| A Varghi–Delaneya | P(X > Y) + ½P(X = Y) | 0 do 1 (.50) | |
| r z Z | Z/√N | zwykle 0 do 1 (0) | |
| Wilcoxon dla par | rrb dla par | (T+ − T−)/(T+ + T−) | −1 do 1 (0) |
| r z Z | Z/√n (n trzeba podać) | zwykle 0 do 1 (0) | |
| Kruskal–Wallis | ε² (porządkowe) | H/(N − 1) | 0 do 1 (0) |
| η²H | (H − k + 1)/(N − k) | do 1 (0) | |
| Friedman | W Kendalla | χ²F/[n(k − 1)] | 0 do 1 (0) |
Oznaczenia: U to statystyka dla pierwszej grupy, n1 i n2 to liczebności grup, N to łączna liczba osób, k to liczba grup albo pomiarów, a T+ i T− to sumy rang dodatnich i ujemnych różnic. Pierwsze trzy miary to ta sama informacja w różnych skalach.
Dane przykładowe
Wszystkie liczby pochodzą z kodu R na końcu wpisu (dane symulowane). W pierwszym badaniu 90 osób studiujących dostało po kolokwium jedną z trzech form informacji zwrotnej: brak, ogólną albo szczegółową (po 30 osób). Potem oceniły motywację do nauki w jednej pozycji na skali 1–7. Takie dane mają dużo remisów, co jest typowe dla skali porządkowej. Mediany wyniosły 4 (Q1–Q3: 3–5) przy braku informacji, 4 (3–5) przy ogólnej i 5 (4–6) przy szczegółowej.
W drugim badaniu 26 osób oceniło stres przed egzaminem (0–10) trzy razy: na początku semestru, w sesji i po sesji. Mediany wyniosły 4, 5.5 i 4.
Porównanie par: delta Cliffa, rrb i A
Zestaw każdą osobę z grupy „szczegółowa” z każdą osobą z grupy „brak”: 30 × 30 = 900 par. W każdej parze wyższy wynik ma osoba z pierwszej grupy, osoba z drugiej albo jest remis. Na tym policzeniu opierają się trzy miary.
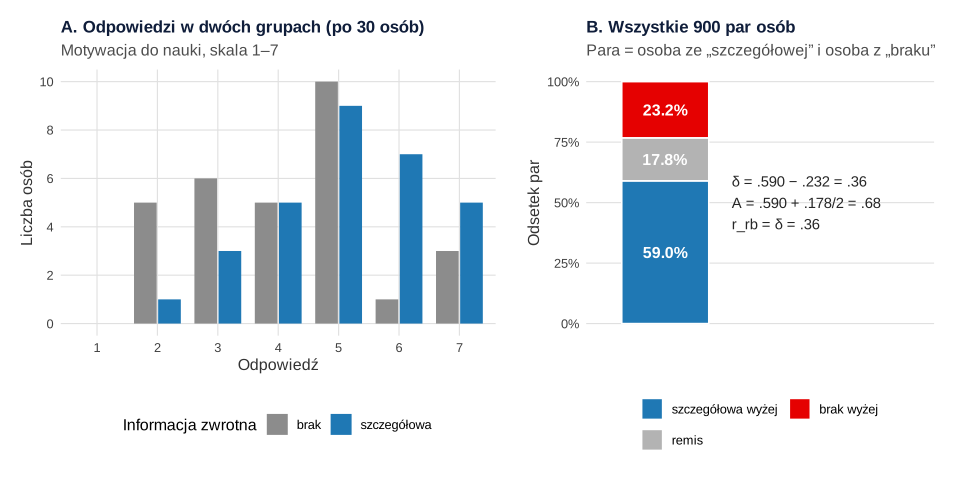
Delta Cliffa. Cliff (1993) zaproponował porządkową statystykę, która porównuje, jak często wynik z jednej grupy jest wyższy niż wynik z drugiej, z sytuacją odwrotną. Jest odporna na wartości skrajne, nie zmienia się po monotonicznym przekształceniu skali i często lepiej niż średnie odpowiada hipotezie badacza. W przykładzie δ = .590 − .232 = .36.
Korelacja rangowo-biseryjna. Kerby (2014) opisuje ją wzorem prostej różnicy: odsetek par zgodnych z hipotezą minus odsetek par niezgodnych. Przy dwóch grupach niezależnych to dokładnie δ. Ze statystyki testu: rrb = 2 × 611/900 − 1 = .36, 95% CI [.08, .58].
A Varghi–Delaneya. McGraw i Wong (1992) zaproponowali wskaźnik „w języku potocznym”: prawdopodobieństwo, że wynik wylosowany z jednego rozkładu jest większy niż wynik z drugiego. Vargha i Delaney (2000) uogólnili go na dowolną zmienną co najmniej porządkową, także dyskretną, z remisami liczonymi po połowie. Tak powstała miara A przewagi stochastycznej. W przykładzie A = .590 + .178/2 = .68, 95% CI [.54, .79]. Czytamy to tak: losowo wybrana osoba po szczegółowej informacji zwrotnej ma wyższą motywację niż losowa osoba bez informacji z prawdopodobieństwem .68 (remisy liczone po połowie).
Ta sama wielkość, P(X1 < X2) + ½P(X1 = X2), wyjaśnia, co naprawdę sprawdza test Manna–Whitneya. Divine i in. (2018) pokazali, że nie jest to test median. Dlatego δ, rrb i A pasują do tego testu lepiej niż różnica median.
r = Z/√N i jego pułapki
Najczęściej spotykaną miarą jest r = Z/√N, czyli statystyka Z z przybliżenia normalnego podzielona przez pierwiastek z liczebności. Opisuje ją m.in. przegląd Fiel Peres (2026) dla testów Manna–Whitneya i Wilcoxona. W przykładzie U = 611 (dla grupy szczegółowej; SPSS poda mniejszą wartość, 900 − 611 = 289), Z = 2.44, p = .015, a r = 2.44/√60 = .31.
Dlaczego .31, a nie .36? Bez remisów r ≈ rrb × √[3n1n2/(N(N + 1))]. Przy równych grupach czynnik ten zbliża się do 0.87, a przy N = 60 wynosi 0.86. W przykładzie daje to .358 × 0.86 = .307. Korekta Z na remisy nieco podnosi wynik, do .314. Nie porównuj więc r z jednego badania z rrb z innego.
Przy teście Wilcoxona dla par pułapka jest poważniejsza. W drugim badaniu stres w sesji był wyższy niż na początku semestru u 16 osób, niższy u 8, a u 2 bez zmian. V = 222.5, Z = 2.10, p = .037. Ile wynosi r? Zależy, przez co podzielisz Z.
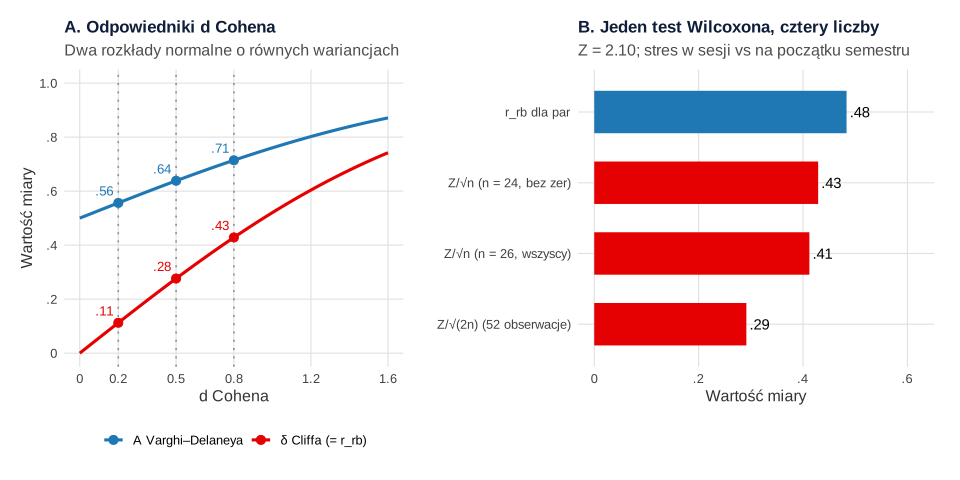
Przy 24 parach z niezerową różnicą r = .43, przy wszystkich 26 parach r = .41, a przy 52 obserwacjach r = .29 (rysunek 2B). Korelacja rangowo-biseryjna dla par ma jedną definicję: (T+ − T−)/(T+ + T−) = (222.5 − 77.5)/300 = .48, 95% CI [.09, .75]. Jeśli podajesz r = Z/√N, zawsze napisz, jakie N przyjęto.
ε² po teście Kruskala–Wallisa
Dla trzech grup test Kruskala–Wallisa dał H(2) = 11.42, p = .003. Porządkowe epsilon kwadrat to ε² = H/(N − 1) = 11.42/89 = .13, 95% CI [.04, .30]. Alternatywą jest η²H = (H − k + 1)/(N − k) = .11. Obie miary opisuje przegląd Fiel Peres (2026) i zaznacza, że porządkowego ε² nie wolno mylić z ε² z ANOVA. Tamto liczy się z sum kwadratów, a to z rang.
ε² mówi, jak silnie przynależność do grupy wiąże się z rangami wyników. Nie mówi jednak, które grupy się różnią. Po istotnym wyniku wykonaj test Dunna z korektą (zob. testy post hoc) i dla każdej pary podaj rrb. W przykładzie: ogólna a brak rrb = −.10, 95% CI [−.38, .19]; szczegółowa a brak .36 [.08, .58]; szczegółowa a ogólna .48 [.22, .67]. To pokazuje, skąd bierze się efekt łączny: z przewagi informacji szczegółowej nad dwiema pozostałymi.
W Kendalla po teście Friedmana
Dla trzech pomiarów stresu test Friedmana dał χ²F(2, N = 26) = 6.34, p = .042. W Kendalla = χ²F/[n(k − 1)] = 6.34/(26 × 2) = .12, 95% CI [.02, .37]. W mówi, na ile osoby podobnie porządkują pomiary. Wartość 1 oznaczałaby, że u każdej osoby kolejność trzech pomiarów jest taka sama, a 0 – brak wspólnego wzoru. Średnie rangi pomiarów wyniosły 1.83, 2.38 i 1.79. Wynik .12 oznacza słabą zgodność: stres w sesji był zwykle najwyższy, ale u wielu osób kolejność była inna. Dla par pomiarów podaj rrb dla par, jak w poprzedniej sekcji.
Przeliczenia i progi
Dla dwóch grup niezależnych obowiązują dokładne zależności:
Przybliżone są dwa przeliczenia. Pierwsze to r z Z na rrb według wzoru z poprzedniej sekcji. Drugie to d na A. McGraw i Wong (1992) liczyli prawdopodobieństwo przewagi ze średnich i wariancji. Dla dwóch rozkładów normalnych o równych wariancjach daje to A = Φ(d/√2), gdzie Φ to dystrybuanta rozkładu normalnego. Przeliczenie ma sens tylko przy tym założeniu. Przy skośnych danych, z powodu których wybrano test rangowy, nie zamieniaj δ na d. Inne przeliczenia (d, r, OR) policzysz w konwerterze wielkości efektu.
Progi „mały, średni, duży” podawaj tylko ze źródłem. Fiel Peres (2026) przypomina, że takie progi to heurystyki. Jeśli promotor wymaga odniesienia, przelicz progi Cohena dla d (0.2, 0.5 i 0.8; Cohen, 1992) wzorem A = Φ(d/√2):
| Efekt według Cohena | d | A | δ = rrb |
|---|---|---|---|
| mały | 0.20 | .56 | .11 |
| średni | 0.50 | .64 | .28 |
| duży | 0.80 | .71 | .43 |
Według tej tabeli δ = .36 leży między efektem średnim a dużym, ale ważniejsze jest zdanie o treści: w 59% par wyższą motywację miała osoba po szczegółowej informacji zwrotnej. Dla ε² i W nie podajemy progów, bo w zweryfikowanych źródłach nie znaleźliśmy takich, które dałoby się uzasadnić. Interpretuj je przez porównania par i wcześniejsze badania (zob. też wynik istotny, ale efekt mały).
Przedziały ufności: analityczne i bootstrap
Przy 30 osobach w grupie sama wartość bez przedziału ufności niewiele mówi: δ = .36 jest zgodne z efektem bliskim zera (.08) i dużym (.58). Pakiety R liczą przedziały na dwa sposoby:
- Analitycznie:
effectsize::rank_biserial(),cliffs_delta()ivd_a()dają dla δ 95% CI [.08, .58], a dla A [.54, .79]. - Bootstrapem:
rcompanion::cliffDelta()ivda()zci = TRUElosują próby i biorą percentyle. Przy 2000 powtórzeniach δ miało 95% CI [.09, .62], a A [.55, .81].
Różnice są niewielkie, ale wynik bootstrapu zależy od ziarna losowania. Ustaw set.seed() i podaj w pracy liczbę powtórzeń. Dla ε² i W funkcje rank_epsilon_squared() i kendalls_w() z pakietu effectsize też używają bootstrapu. Domyślnie zwracają przedział jednostronny z górną granicą 1, więc do dwustronnego 95% CI dodaj alternative = "two.sided". Dla ε² effectsize dał [.04, .30], a rcompanion::epsilonSquared() [.03, .29].
Jak opisać wynik w pracy
Przy każdej grupie podaj medianę i kwartyle, potem statystykę testu, p i miarę efektu z 95% CI. Napisz też, jak liczono przedział. Gotowe zdania dla innych testów składa generator opisu wyników APA. Liczy on już r z Z i ε² z H, więc nie powtarzamy tu jego wzorów. Ogólne zasady zapisu zebraliśmy we wpisie jak opisać wyniki w stylu APA.
Wielkość efektu po testach rangowych w R
Kod odtwarza wszystkie liczby z tekstu i rysunków. Testy liczy bazowy R, statystykę Z z poprawką na remisy – pakiet coin, miary efektu z analitycznym CI – pakiet effectsize, a przedziały bootstrapowe – pakiet rcompanion.
Od testu do miary efektu z 95% CI
R
# B229 – wielkość efektu dla testów nieparametrycznych (dane symulowane, set.seed(2291))
# Badanie 1: 90 osób studiujących, trzy warunki informacji zwrotnej po kolokwium
#   (brak, ogólna, szczegółowa; po 30 osób); motywacja do nauki w jednej pozycji 1–7.
# Badanie 2: 26 osób, stres przed egzaminem (0–10) na początku semestru, w sesji i po sesji.
suppressPackageStartupMessages({ library(effectsize); library(rcompanion); library(coin) })
set.seed(2291)
n <- 30
lik <- function(m) pmin(7, pmax(1, round(rnorm(n, m, 1.5))))
b1 <- data.frame(warunek = factor(rep(c("brak", "ogólna", "szczegółowa"), each = n),
                                  levels = c("brak", "ogólna", "szczegółowa")),
                 motywacja = c(lik(3.9), lik(4.3), lik(5.0)))

# Krok 1. Opis: mediany i kwartyle
aggregate(motywacja ~ warunek, b1, function(v) c(Me = median(v), Q1 = quantile(v, .25, names = FALSE),
                                                  Q3 = quantile(v, .75, names = FALSE)))

# Krok 2. Dwie grupy: szczegółowa vs brak – test U Manna–Whitneya
d2 <- droplevels(subset(b1, warunek != "ogólna"))
d2$warunek <- relevel(d2$warunek, ref = "szczegółowa")   # pierwsza grupa = szczegółowa
x <- d2$motywacja[d2$warunek == "szczegółowa"]; y <- d2$motywacja[d2$warunek == "brak"]
mw <- wilcox.test(x, y, exact = FALSE)
c(U = unname(mw$statistic), p = round(mw$p.value, 4))
Z <- statistic(wilcox_test(motywacja ~ warunek, data = d2))   # Z z poprawką na remisy
N <- length(x) + length(y)
round(c(Z = Z, N = N, r = Z / sqrt(N)), 3)

# Krok 3. Pary obserwacji: przewaga, remisy, porażki
pary <- outer(x, y, "-")
P <- c(wieksze = mean(pary > 0), rowne = mean(pary == 0), mniejsze = mean(pary < 0))
round(P, 3)
round(c(delta = unname(P["wieksze"] - P["mniejsze"]),
        A = unname(P["wieksze"] + P["rowne"] / 2),
        rrb_z_U = unname(2 * mw$statistic / (length(x) * length(y)) - 1)), 3)

# Krok 4. Te same miary z pakietów (CI: effectsize – analitycznie, rcompanion – bootstrap percentylowy)
rank_biserial(x, y)
cliffs_delta(x, y)
vd_a(x, y)
set.seed(2292)
cliffDelta(x = x, y = y, ci = TRUE, R = 2000)
set.seed(2293)
vda(x = x, y = y, ci = TRUE, R = 2000)

# Krok 5. Przeliczenia: r ≈ rrb × √(3·n1·n2 / (N(N + 1))) (bez remisów) oraz A ↔ d przy normalności
rrb <- 2 * mw$statistic / (length(x) * length(y)) - 1
round(c(r_z_rrb = unname(rrb * sqrt(3 * length(x) * length(y) / (N * (N + 1))))), 3)
d_cohen <- c(0.2, 0.5, 0.8)
round(rbind(d = d_cohen, A = pnorm(d_cohen / sqrt(2)), delta = 2 * pnorm(d_cohen / sqrt(2)) - 1), 3)

# Krok 6. Trzy grupy: test Kruskala–Wallisa, ε² (CI bootstrap) i η²H
kw <- kruskal.test(motywacja ~ warunek, b1)
H <- unname(kw$statistic); Nk <- nrow(b1); k <- 3
round(c(H = H, df = unname(kw$parameter), p = kw$p.value, eps2 = H / (Nk - 1),
        eta2H = (H - k + 1) / (Nk - k)), 4)
set.seed(2294)
rank_epsilon_squared(motywacja ~ warunek, data = b1, iterations = 2000, alternative = "two.sided")
set.seed(2295)
epsilonSquared(x = b1$motywacja, g = b1$warunek, ci = TRUE, R = 2000)
# Porównania par: rrb dla każdej pary grup
for (pr in list(c("ogólna", "brak"), c("szczegółowa", "brak"), c("szczegółowa", "ogólna"))) {
  rb <- rank_biserial(b1$motywacja[b1$warunek == pr[1]], b1$motywacja[b1$warunek == pr[2]])
  cat(pr[1], "vs", pr[2], ": rrb =", round(rb$r_rank_biserial, 3), "[", round(rb$CI_low, 3), ",", round(rb$CI_high, 3), "]\n")
}

# Badanie 2: pomiary powtarzane
set.seed(2296)
m <- 26
osoba <- rnorm(m, 0, 1.4)
st <- function(srednia) pmin(10, pmax(0, round(5 + osoba + srednia + rnorm(m, 0, 1.3))))
b2 <- data.frame(id = 1:m, poczatek = st(-0.3), sesja = st(0.6), po_sesji = st(-0.5))
sapply(b2[, -1], median)

# Krok 7. Dwa pomiary: test Wilcoxona dla par (sesja vs początek)
roz <- b2$sesja - b2$poczatek
c(wzrost = sum(roz > 0), spadek = sum(roz < 0), zero = sum(roz == 0))
wx <- wilcox.test(b2$sesja, b2$poczatek, paired = TRUE, exact = FALSE)
c(V = unname(wx$statistic), p = round(wx$p.value, 4))
Zw <- statistic(wilcoxsign_test(sesja ~ poczatek, data = b2, zero.method = "Wilcoxon"))
round(c(Z = Zw, r_n_bez_zer = Zw / sqrt(sum(roz != 0)), r_n_wszyscy = Zw / sqrt(m),
        r_2n_obserwacji = Zw / sqrt(2 * m)), 3)
rank_biserial(b2$sesja, b2$poczatek, paired = TRUE)

# Krok 8. Trzy pomiary: test Friedmana i W Kendalla (CI bootstrap)
mac <- as.matrix(b2[, -1])
round(colMeans(t(apply(mac, 1, rank))), 2)              # średnie rangi pomiarów (w obrębie osoby)
fr <- friedman.test(mac)
round(c(chi2 = unname(fr$statistic), df = unname(fr$parameter), p = fr$p.value,
        W = unname(fr$statistic) / (m * (ncol(mac) - 1))), 4)
set.seed(2297)
kendalls_w(mac, iterations = 2000, alternative = "two.sided", verbose = FALSE)
Wynik w R
      warunek motywacja.Me motywacja.Q1 motywacja.Q3
1        brak            4            3            5
2      ogólna            4            3            5
3 szczegółowa            5            4            6
       U        p
611.0000   0.0152
     Z      N      r
 2.436 60.000  0.314
 wieksze    rowne mniejsze
   0.590    0.178    0.232
  delta       A rrb_z_U
  0.358   0.679   0.358
r (rank biserial) |       95% CI
--------------------------------
0.36              | [0.08, 0.58]
r (rank biserial) |       95% CI
--------------------------------
0.36              | [0.08, 0.58]
Pr(superiority) |       95% CI
------------------------------
0.68            | [0.54, 0.79]

- Non-parametric CLES  Cliff.delta lower.ci upper.ci
1       0.358   0.0892    0.621
    VDA lower.ci upper.ci
1 0.679    0.546    0.807
r_z_rrb
  0.307
       [,1]  [,2]  [,3]
d     0.200 0.500 0.800
A     0.556 0.638 0.714
delta 0.112 0.276 0.428
      H      df       p    eps2   eta2H
11.4221  2.0000  0.0033  0.1283  0.1083
Epsilon2 (rank) |       95% CI
------------------------------
0.13            | [0.04, 0.30]
  epsilon.squared lower.ci upper.ci
1           0.128   0.0324    0.292
ogólna vs brak : rrb = -0.103 [ -0.378 , 0.189 ]
szczegółowa vs brak : rrb = 0.358 [ 0.08 , 0.584 ]
szczegółowa vs ogólna : rrb = 0.48 [ 0.224 , 0.674 ]
poczatek    sesja po_sesji
     4.0      5.5      4.0
wzrost spadek   zero
    16      8      2
       V        p
222.5000   0.0369
              Z     r_n_bez_zer     r_n_wszyscy r_2n_obserwacji
          2.101           0.429           0.412           0.291
r (rank biserial) |       95% CI
--------------------------------
0.48              | [0.09, 0.75]
poczatek    sesja po_sesji
    1.83     2.38     1.79
  chi2     df      p      W
6.3368 2.0000 0.0421 0.1219
Kendall's W |       95% CI
--------------------------
0.12        | [0.02, 0.37]
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- rcompanion (wersja 2.5.2): Mangiafico, S. S. (2026). rcompanion: Functions to support extension education program evaluation (R package version 2.5.2) [Computer software]. https://CRAN.R-project.org/package=rcompanion
- coin (wersja 1.4.3): Hothorn, T., Hornik, K., van de Wiel, M. A., & Zeileis, A. (2006). A Lego system for conditional inference. The American Statistician, 60(3), 257–263. https://doi.org/10.1198/000313006X118430
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots (R package version 1.3.2) [Computer software]. https://CRAN.R-project.org/package=patchwork
Najczęstsze błędy
- Samo p bez miary efektu. Po każdym teście rangowym podaj miarę efektu z 95% CI.
- r = Z/√N bez informacji o N. Przy teście Wilcoxona różnica między .43 a .29 bierze się tylko z wyboru mianownika.
- Znak bez opisu kierunku. δ i rrb mają znak zależny od tego, która grupa jest pierwsza. Napisz, która grupa ma wyższe wyniki.
- ε² z rang mylone z ε² z ANOVA albo raportowane bez porównań par. Sam efekt łączny nie mówi, które grupy się różnią.
- Jednostronny przedział z effectsize podany jako 95% CI. Górna granica 1.00 to sygnał, że brakuje
alternative = "two.sided". - Progi bez źródła. Etykieta „duży efekt” wymaga cytowania i uzasadnienia, a przy skośnych danych przeliczenie z d jest tylko orientacyjne.
Plan całej analizy znajdziesz w przewodniku po statystyce w pracy dyplomowej i w przewodniku po wyborze testu. Sprawdzenie doboru miar i opisu wyników obejmuje oferta analizy statystyczne dla studentów; wyniki musisz jednak rozumieć i obronić samodzielnie.
Najczęstsze pytania
Jaką wielkość efektu podać dla testu Manna-Whitneya?
Najprościej korelację rangowo-biseryjną rrb z 95% CI. Dla dwóch grup niezależnych jest równa delcie Cliffa: to odsetek par, w których wyższy wynik ma osoba z pierwszej grupy, minus odsetek par odwrotnych (Kerby, 2014; Cliff, 1993). Jeśli promotor oczekuje r = Z/√N, podaj je obok i napisz, że N to łączna liczba osób.
Czym różni się delta Cliffa od A Varghi-Delaneya?
Obie miary liczy się z tych samych par obserwacji. Delta Cliffa ma zakres od −1 do 1, a 0 oznacza brak przewagi. A Varghi–Delaneya to prawdopodobieństwo, że losowa osoba z pierwszej grupy ma wyższy wynik niż losowa osoba z drugiej, z remisami liczonymi po połowie; ma zakres 0–1, a brak przewagi to .50 (Vargha i Delaney, 2000). Przelicznik: A = (δ + 1)/2.
Jak policzyć epsilon kwadrat dla testu Kruskala-Wallisa?
Podziel statystykę H przez N − 1, gdzie N to łączna liczba osób: ε² = H/(N − 1). Dla H = 11.42 i N = 90 wychodzi ε² = .13. To miara porządkowa, inna niż ε² z ANOVA (Fiel Peres, 2026). Przedział ufności policz bootstrapem, np. funkcją rank_epsilon_squared().
Jakie progi małego, średniego i dużego efektu przyjąć dla delty Cliffa?
Nie ma progów, które obowiązują w każdej dziedzinie. Jeśli potrzebujesz punktu odniesienia, przelicz progi d Cohena (0.2, 0.5 i 0.8; Cohen, 1992) przy założeniu dwóch rozkładów normalnych. Daje to δ ≈ .11, .28 i .43 oraz A ≈ .56, .64 i .71. W pracy napisz, skąd wzięły się progi, i interpretuj efekt w kontekście badania.
Dlaczego r = Z/√N dla testu Wilcoxona wychodzi różnie w różnych programach?
Bo nie ma zgody, co jest N: liczba par bez zerowych różnic, wszystkie pary czy liczba obserwacji (2n). W przykładzie z tego wpisu to samo Z = 2.10 daje r = .43, .41 albo .29. Napisz, które N przyjęto, albo podaj korelację rangowo-biseryjną dla par z 95% CI.
Powiązane hasła
Przeczytaj też
Testy nieparametryczne krok po kroku
Kiedy test rangowy ma sens, Mann–Whitney, Wilcoxon, Kruskal–Wallis z testem Dunna i Friedman na jednym badaniu – z wielkością efektu i opisem APA.
Czytaj →PoradnikWielkość efektu – interpretacja
d, g, r, η², OR i NNT na jednym przykładzie, przeliczenia, przedziały ufności, progi Cohena i interpretacja na tle SESOI – z kodem R.
Czytaj →PoradnikGenerator opisu wyników APA
Statystyka, df i liczebności zamienione w zdanie APA 7 z p i wielkością efektu oraz kontrolą, czy p zgadza się ze statystyką.
Czytaj →Nie wiesz, jaką wielkość efektu podać po teście rangowym?
Sprawdzimy dobór testu i miary efektu, policzymy przedziały ufności i wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Cliff, N. (1993). Dominance statistics: Ordinal analyses to answer ordinal questions. Psychological Bulletin, 114(3), 494–509. https://doi.org/10.1037/0033-2909.114.3.494
- Cohen, J. (1992). A power primer. Psychological Bulletin, 112(1), 155–159. https://doi.org/10.1037/0033-2909.112.1.155
- Divine, G. W., Norton, H. J., Barón, A. E., & Juarez-Colunga, E. (2018). The Wilcoxon–Mann–Whitney procedure fails as a test of medians. The American Statistician, 72(3), 278–286. https://doi.org/10.1080/00031305.2017.1305291 ● Otwarty dostęp
- Fiel Peres, F. (2026). Effect sizes for nonparametric tests. Biochemia Medica, 36(1), 5–16. https://doi.org/10.11613/bm.2026.010101 ● Otwarty dostęp
- Fritz, C. O., Morris, P. E., & Richler, J. J. (2012). Effect size estimates: Current use, calculations, and interpretation. Journal of Experimental Psychology: General, 141(1), 2–18. https://doi.org/10.1037/a0024338
- Kerby, D. S. (2014). The simple difference formula: An approach to teaching nonparametric correlation. Comprehensive Psychology, 3, Article 11.IT.3.1. https://doi.org/10.2466/11.IT.3.1 ● Otwarty dostęp
- McGraw, K. O., & Wong, S. P. (1992). A common language effect size statistic. Psychological Bulletin, 111(2), 361–365. https://doi.org/10.1037/0033-2909.111.2.361
- Vargha, A., & Delaney, H. D. (2000). A critique and improvement of the CL common language effect size statistics of McGraw and Wong. Journal of Educational and Behavioral Statistics, 25(2), 101–132. https://doi.org/10.3102/10769986025002101
Cytowania BibTeX
@article{cliff1993dominance, author={Cliff, Norman}, title={{Dominance statistics: Ordinal analyses to answer ordinal questions}}, journal={Psychological Bulletin}, year={1993}, volume={114}, number={3}, pages={494--509}, doi={10.1037/0033-2909.114.3.494}}@article{cohen1992power, author={Cohen, Jacob}, title={{A power primer}}, journal={Psychological Bulletin}, year={1992}, volume={112}, number={1}, pages={155--159}, doi={10.1037/0033-2909.112.1.155}}@article{divine2018wilcoxon, author={Divine, George W. and Norton, H. James and Barón, Anna E. and Juarez-Colunga, Elizabeth}, title={{The Wilcoxon–Mann–Whitney procedure fails as a test of medians}}, journal={The American Statistician}, year={2018}, volume={72}, number={3}, pages={278--286}, doi={10.1080/00031305.2017.1305291}}@article{peres2026effect, author={Fiel Peres, Fernanda}, title={{Effect sizes for nonparametric tests}}, journal={Biochemia Medica}, year={2026}, volume={36}, number={1}, pages={5--16}, doi={10.11613/bm.2026.010101}}@article{fritz2012effect, author={Fritz, Catherine O. and Morris, Peter E. and Richler, Jennifer J.}, title={{Effect size estimates: Current use, calculations, and interpretation}}, journal={Journal of Experimental Psychology: General}, year={2012}, volume={141}, number={1}, pages={2--18}, doi={10.1037/a0024338}}@article{kerby2014simple, author={Kerby, Dave S.}, title={{The simple difference formula: An approach to teaching nonparametric correlation}}, journal={Comprehensive Psychology}, year={2014}, volume={3}, eid={11.IT.3.1}, doi={10.2466/11.it.3.1}}@article{mcgraw1992common, author={McGraw, Kenneth O. and Wong, S. P.}, title={{A common language effect size statistic}}, journal={Psychological Bulletin}, year={1992}, volume={111}, number={2}, pages={361--365}, doi={10.1037/0033-2909.111.2.361}}@article{vargha2000critique, author={Vargha, András and Delaney, Harold D.}, title={{A critique and improvement of the CL common language effect size statistics of McGraw and Wong}}, journal={Journal of Educational and Behavioral Statistics}, year={2000}, volume={25}, number={2}, pages={101--132}, doi={10.3102/10769986025002101}}