Dlaczego mały efekt bywa istotny
Wartość p zależy od dwóch rzeczy: od wielkości efektu i od liczebności próby. Gdy próba rośnie, nawet niewielka różnica daje małe p. Oświadczenie American Statistical Association mówi wprost, że wartość p nie mierzy wielkości efektu ani jego znaczenia (Wasserstein i Lazar, 2016). Lin i in. (2013) zauważają, że w bardzo dużych próbach wartości p szybko spadają do zera. Kto opiera się tylko na nich, może ogłosić poparcie dla wyniku bez praktycznego znaczenia.
Rysunek 1 pokazuje ten sam efekt, d = 0.24, przy różnych liczebnościach. Przy 40 osobach p = .453, przy 400 osobach p = .017, a od 900 osób p < .001. Efekt się nie zmienia. Zmienia się tylko precyzja oszacowania, czyli szerokość przedziału ufności.
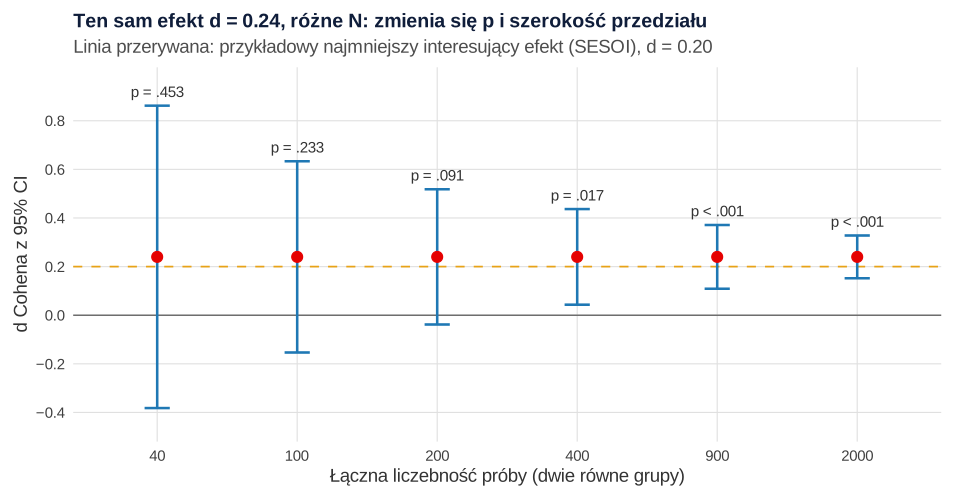
Wniosek jest prosty. Istotność odpowiada na pytanie, czy efekt jest różny od zera. Nie mówi, czy jest duży ani czy jest ważny. To drugie oceniasz na podstawie wielkości efektu i jej przedziału ufności (Cumming, 2014).
Przykład: ankieta online z 900 osobami
Wyobraź sobie pracę magisterską o samotności studentów (dane symulowane). Ankietę wypełniło 900 osób. Mierzono poczucie samotności skalą od 10 do 40 punktów oraz czas spędzany dziennie w mediach społecznościowych.
- Korelacja. Czas w mediach wiązał się z samotnością: r = .14, 95% CI [.07, .20], p < .001. Związek jest istotny, ale r² wynosi zaledwie 1.8%. Każda dodatkowa godzina w mediach to średnio 0.54 punktu samotności więcej, 95% CI [0.28, 0.80], na skali o rozpiętości 30 punktów.
- Różnica płci. Kobiety (n = 533, M = 25.17, SD = 6.04) miały wyższe wyniki niż mężczyźni (n = 367, M = 23.67, SD = 6.34). Test t Welcha dał t(761.39) = 3.54, p < .001. Różnica wynosi 1.49 punktu, 95% CI [0.67, 2.32], a d = 0.24, 95% CI [0.11, 0.38]. Prawdopodobieństwo, że losowo wybrana kobieta ma wyższy wynik niż losowo wybrany mężczyzna, wynosi .57 (przy braku różnicy byłoby to .50). Rozkłady obu grup pokrywają się w 90%.
Oba wyniki są istotne i oba są małe. Nie musisz tego ukrywać. Wystarczy opisać efekt uczciwie: podać jego wielkość, przedział ufności i to, co oznacza w jednostkach skali.
Czy mały efekt to efekt nieważny?
Niekoniecznie. Funder i Ozer (2019) proponują oceniać efekty przez porównanie z dobrze znanymi punktami odniesienia, a nie przez sztywne progi. Według nich r = .10 to efekt mały, r = .20 średni, a r = .30 duży. Efekty rzędu r = .40 i wyższe w psychologii są prawdopodobnie zawyżone. Götz i in. (2022) twierdzą, że złożone zjawiska psychologiczne mają wiele przyczyn, więc pojedyncza przyczyna ma zwykle mały efekt. Takie efekty mogą mieć poważne konsekwencje, gdy dotyczą wielu osób albo kumulują się w czasie. Kirk (1996) odróżnia istotność statystyczną od praktycznej. Pierwsza dotyczy tego, czy wynik da się wyjaśnić przypadkiem. Druga – tego, czy wynik jest użyteczny w rzeczywistości.
Oceniając swój efekt, zadaj sobie trzy pytania:
- Ile to jest w jednostkach skali? 1.49 punktu na skali 10–40 łatwiej ocenić niż samo d. Do przeliczania miar przyda się konwerter wielkości efektu.
- Czy przekracza najmniejszy efekt, który ma znaczenie? Jeśli przed badaniem ustalono SESOI albo dla danego narzędzia znana jest minimalna istotna klinicznie różnica, porównaj z nią cały przedział ufności. Na rysunku 1 przy 2000 osobach przedział [0.15, 0.33] obejmuje też wartości poniżej przykładowego progu 0.20.
- Jak wypada na tle podobnych badań? Mały efekt typowy dla danej dziedziny to co innego niż efekt znacznie mniejszy od spodziewanego.
| Źle | Dobrze |
|---|---|
| „Wykazano silny związek (p < .001)” | „Związek był istotny statystycznie, ale słaby (r = .14)” |
| „Kobiety są znacznie bardziej samotne” | „Kobiety miały średnio o 1.49 punktu wyższe wyniki (d = 0.24)” |
| „Media społecznościowe powodują samotność” | „Dłuższy czas w mediach wiązał się z nieco wyższą samotnością” (zob. korelacja a przyczynowość) |
| „Efekt jest mały, więc wynik nie ma znaczenia” | „Efekt jest mały; jego znaczenie zależy od…” i konkretny argument |
Pełne omówienie miar, przedziałów ufności, konwersji i progów znajdziesz w poradniku wielkość efektu – interpretacja. Jeśli Twoim problemem jest ocena samej korelacji, zajrzyj do wpisu czy korelacja .30 to dużo?, a przy wyniku odwrotnym – do wpisu jak opisać wynik nieistotny.
Jak to opisać w pracy
W wynikach podaj statystykę testu, dokładne p, wielkość efektu z przedziałem ufności i różnicę w jednostkach skali. W dyskusji oceń znaczenie efektu jednym lub dwoma argumentami. Nie kończ na samym „efekt był mały”.
Więcej o całym rozdziale wyników znajdziesz w przewodniku po statystyce w pracy dyplomowej. Jeśli chcesz, żeby ktoś sprawdził Twoje obliczenia i interpretację, zajrzyj do oferty analiz statystycznych dla studentów. Wnioski musisz jednak umieć obronić sam(a).
Mały, ale istotny efekt w R
Pierwszy przepis liczy wszystkie wyniki z przykładu: korelację z przedziałem ufności i r², nachylenie w jednostkach skali, test t Welcha, d z przedziałem ufności oraz prawdopodobieństwo przewagi i wspólną część rozkładów. Wielkości efektu liczy pakiet effectsize. Drugi przepis podaje liczby z rysunku 1.
1. Korelacja, test t i wielkość efektu
R
# Wynik istotny, ale efekt mały (dane symulowane, set.seed(1470))
# Ankieta online: 900 osób studiujących, poczucie samotności (skala 10–40) i czas w mediach społecznościowych (godziny dziennie)
library(effectsize)
set.seed(1470)
n <- 900
media <- round(pmin(10, pmax(0, rnorm(n, 3.5, 1.6))), 1)
plec  <- factor(sample(c("kobiety", "mezczyzni"), n, replace = TRUE, prob = c(.6, .4)))
samotnosc <- round(pmin(40, pmax(10, 24 + 0.45 * (media - 3.5) + ifelse(plec == "kobiety", 0.9, 0) + rnorm(n, 0, 6))))

# 1. Korelacja: istotna, ale słaba
k <- cor.test(media, samotnosc)
round(c(r = unname(k$estimate), CI_dolna = k$conf.int[1], CI_gorna = k$conf.int[2],
        t = unname(k$statistic), df = unname(k$parameter), p = k$p.value, r2_proc = 100 * unname(k$estimate)^2), 4)
m <- lm(samotnosc ~ media)
round(coef(m), 2)                                   # o ile punktów rośnie samotność na godzinę w mediach
round(confint(m)["media", ], 2)

# 2. Różnica płci: istotna, ale mała
round(tapply(samotnosc, plec, function(x) c(n = length(x), M = mean(x), SD = sd(x))) |> simplify2array(), 2)
t.test(samotnosc ~ plec)
d <- cohens_d(samotnosc ~ plec, pooled_sd = FALSE)
round(c(d = d$Cohens_d, CI_dolna = d$CI_low, CI_gorna = d$CI_high), 2)
round(p_superiority(samotnosc ~ plec)$p_superiority, 2)   # P(losowa kobieta > losowy mężczyzna)
round(p_overlap(samotnosc ~ plec)$Overlap, 2)             # wspólna część rozkładów
Wynik w R
       r CI_dolna CI_gorna        t       df        p  r2_proc
  0.1355   0.0708   0.1991   4.0978 898.0000   0.0000   1.8356
(Intercept)       media
      22.66        0.54
 2.5 % 97.5 %
  0.28   0.80
   kobiety mezczyzni
n   533.00    367.00
M    25.17     23.67
SD    6.04      6.34

	Welch Two Sample t-test

data:  samotnosc by plec
t = 3.5447, df = 761.39, p-value = 0.000417
alternative hypothesis: true difference in means between group kobiety and group mezczyzni is not equal to 0
95 percent confidence interval:
 0.6669756 2.3226313
sample estimates:
  mean in group kobiety mean in group mezczyzni
                25.1651                 23.6703

       d CI_dolna CI_gorna
    0.24     0.11     0.38
[1] 0.57
[1] 0.9
2. Ten sam efekt przy różnych liczebnościach
R
# Ten sam efekt d = 0.24 przy różnych liczebnościach (dwie równe grupy): wartość p i przybliżony 95% CI dla d
d <- 0.24
N <- c(40, 100, 200, 400, 900, 2000)
wynik <- t(sapply(N, function(nn) {
  n1 <- nn / 2
  t  <- d * sqrt(n1 * n1 / nn)                      # statystyka t odpowiadająca d przy równych grupach
  se <- sqrt(nn / (n1 * n1) + d^2 / (2 * nn))       # przybliżony błąd standardowy d
  c(N = nn, t = t, p = 2 * pt(-t, nn - 2), CI_dolna = d - 1.96 * se, CI_gorna = d + 1.96 * se)
}))
round(wynik, 4)
Wynik w R
        N      t      p CI_dolna CI_gorna
[1,]   40 0.7589 0.4526  -0.3820   0.8620
[2,]  100 1.2000 0.2330  -0.1534   0.6334
[3,]  200 1.6971 0.0913  -0.0382   0.5182
[4,]  400 2.4000 0.0169   0.0433   0.4367
[5,]  900 3.6000 0.0003   0.1089   0.3711
[6,] 2000 5.3666 0.0000   0.1520   0.3280
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje cor.test(), lm() i t.test() z pakietu stats); rysunek przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze pytania
Czy słaba korelacja może być istotna statystycznie?
Tak. Przy 900 osobach korelacja r = .14 daje p < .001, choć wyjaśnia tylko 1.8% zmienności. Istotność zależy od liczebności próby, a siłę związku opisuje sam współczynnik r z przedziałem ufności. W pracy napisz, że związek był istotny, ale słaby.
Jak napisać w pracy, że efekt jest mały, ale istotny?
Podaj statystykę testu i dokładne p, wielkość efektu z 95% CI i różnicę w jednostkach skali, np. „różnica wynosiła 1.49 punktu na skali 10–40, d = 0.24, 95% CI [0.11, 0.38]”. Nazwij efekt małym, a w dyskusji jednym lub dwoma argumentami oceń jego znaczenie praktyczne.
Czym się różni istotność statystyczna od praktycznej?
Istotność statystyczna dotyczy tego, czy wynik da się wyjaśnić przypadkiem. Istotność praktyczna dotyczy tego, czy wynik jest użyteczny w rzeczywistości (Kirk, 1996). Pierwszą ocenia wartość p, drugą – wielkość efektu w odniesieniu do najmniejszego efektu, który ma znaczenie, np. SESOI albo MCID.
Czy mały efekt oznacza, że wynik nie ma znaczenia?
Nie. W psychologii większość prawdziwych efektów jest mała, a mały efekt może być ważny, gdy dotyczy wielu osób albo kumuluje się w czasie (Götz i in., 2022). Znaczenie oceń na tle podobnych badań, w jednostkach skali i względem z góry ustalonego progu.
Powiązane hasła
Przeczytaj też
Wielkość efektu – interpretacja
d, g, r, η², OR i NNT na jednym przykładzie, przeliczenia, przedziały ufności, progi Cohena i interpretacja na tle SESOI – z kodem R.
Czytaj →PoradnikCzy korelacja .30 to dużo?
Jak ocenić r = .30: konwencja Cohena a typowe korelacje w psychologii, R² = .09, przedział ufności przy różnej liczebności próby i wzór opisu APA.
Czytaj →PoradnikWartość p – interpretacja
Błędne odczytania p na jednym przykładzie, symulacja p pod H0 i H1, replikacje, p a przedział ufności i wielkość efektu – z kodem R.
Czytaj →Masz istotny wynik i nie wiesz, jak opisać jego wielkość?
Policzymy wielkość efektu z przedziałem ufności i wyjaśnimy, co oznacza w Twoim badaniu, tak żebyś umiał(a) to opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Cumming, G. (2014). The new statistics: Why and how. Psychological Science, 25(1), 7–29. https://doi.org/10.1177/0956797613504966
- Funder, D. C., & Ozer, D. J. (2019). Evaluating effect size in psychological research: Sense and nonsense. Advances in Methods and Practices in Psychological Science, 2(2), 156–168. https://doi.org/10.1177/2515245919847202 ● Otwarty dostęp
- Götz, F. M., Gosling, S. D., & Rentfrow, P. J. (2022). Small effects: The indispensable foundation for a cumulative psychological science. Perspectives on Psychological Science, 17(1), 205–215. https://doi.org/10.1177/1745691620984483 ● Otwarty dostęp: pełny tekst
- Kirk, R. E. (1996). Practical significance: A concept whose time has come. Educational and Psychological Measurement, 56(5), 746–759. https://doi.org/10.1177/0013164496056005002
- Lin, M., Lucas, H. C., & Shmueli, G. (2013). Research commentary—Too big to fail: Large samples and the p-value problem. Information Systems Research, 24(4), 906–917. https://doi.org/10.1287/isre.2013.0480
- Wasserstein, R. L., & Lazar, N. A. (2016). The ASA statement on p-values: Context, process, and purpose. The American Statistician, 70(2), 129–133. https://doi.org/10.1080/00031305.2016.1154108 ● Otwarty dostęp
Cytowania BibTeX
@article{cumming2014new, author={Cumming, Geoff}, title={{The new statistics: Why and how}}, journal={Psychological Science}, year={2014}, volume={25}, number={1}, pages={7--29}, doi={10.1177/0956797613504966}}@article{funder2019evaluating, author={Funder, David C. and Ozer, Daniel J.}, title={{Evaluating effect size in psychological research: Sense and nonsense}}, journal={Advances in Methods and Practices in Psychological Science}, year={2019}, volume={2}, number={2}, pages={156--168}, doi={10.1177/2515245919847202}}@article{gotz2022small, author={Götz, Friedrich M. and Gosling, Samuel D. and Rentfrow, Peter J.}, title={{Small effects: The indispensable foundation for a cumulative psychological science}}, journal={Perspectives on Psychological Science}, year={2022}, volume={17}, number={1}, pages={205--215}, doi={10.1177/1745691620984483}}@article{kirk1996practical, author={Kirk, Roger E.}, title={{Practical significance: A concept whose time has come}}, journal={Educational and Psychological Measurement}, year={1996}, volume={56}, number={5}, pages={746--759}, doi={10.1177/0013164496056005002}}@article{lin2013too, author={Lin, Mingfeng and Lucas, Henry C. and Shmueli, Galit}, title={{Research commentary—Too big to fail: Large samples and the p-value problem}}, journal={Information Systems Research}, year={2013}, volume={24}, number={4}, pages={906--917}, doi={10.1287/isre.2013.0480}}@article{wasserstein2016asa, author={Wasserstein, Ronald L. and Lazar, Nicole A.}, title={{The ASA statement on p-values: Context, process, and purpose}}, journal={The American Statistician}, year={2016}, volume={70}, number={2}, pages={129--133}, doi={10.1080/00031305.2016.1154108}}