Co podać przy wyniku nieistotnym
Wynik nieistotny opisujesz tak samo starannie jak istotny. Różni się tylko wniosek. W rozdziale wyników podaj trzy rzeczy:
- Pełny wynik testu: statystykę, stopnie swobody i dokładną wartość p (np. p = .270, a nie „p > .05” ani „n.s.”).
- Wielkość efektu z 95% przedziałem ufności, np. d Cohena. To on mówi, jakie efekty są zgodne z danymi.
- Wniosek dopasowany do szerokości przedziału. Wąski przedział wokół zera pozwala mówić o braku efektu o praktycznym znaczeniu. Szeroki – tylko o tym, że badanie nie rozstrzygnęło pytania.
Najczęstszy błąd to zdanie „grupy nie różnią się”. Wartość p powyżej .05 nie dowodzi braku różnicy. Amrhein i in. (2019) wraz z ponad 800 sygnatariuszami apelują, by nie wyciągać takiego wniosku z samego p > .05 i omawiać wszystkie wartości z przedziału ufności. Greenland i in. (2016) opisują ten i inne częste błędy w interpretacji wartości p i przedziałów ufności.
Przykład: aplikacja do medytacji a stres
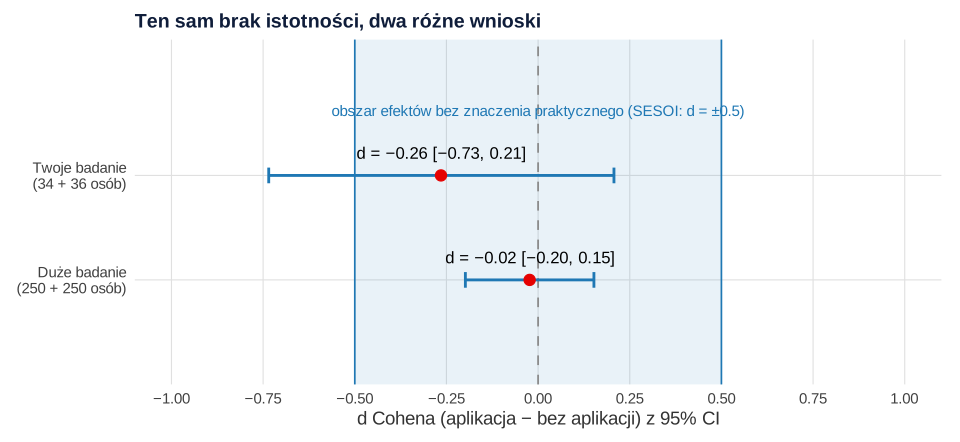
Studentka porównuje stres (PSS-10, wynik 0–40) u 34 osób korzystających z aplikacji do medytacji i 36 osób bez aplikacji (dane symulowane). Osoby z aplikacją miały nieco niższy stres (M = 18.76, SD = 4.81) niż osoby bez niej (M = 20.17, SD = 5.71). Test Welcha dał t(67.12) = −1.11, p = .270. Różnica średnich wyniosła −1.40 punktu, 95% CI [−3.92, 1.11], a d = −0.26, 95% CI [−0.73, 0.21].
Przedział dla d obejmuje zero, ale też różnice sięgające prawie trzech czwartych odchylenia standardowego (−0.73). Dane nie wykluczają więc ani braku efektu, ani całkiem wyraźnej korzyści z aplikacji. Wynik jest nierozstrzygający.
Dwie dodatkowe liczby pomagają to pokazać:
- Czułość badania. Przy około 35 osobach w grupie test miał moc 80% dopiero dla d = 0.68. Mniejszych efektów to badanie najpewniej by nie wykryło. To analiza wrażliwości liczona z założonej wielkości efektu, a nie „moc post hoc” z efektu zaobserwowanego. Tę drugą Hoenig i Heisey (2001) uznają za podejście z gruntu błędne (zob. analiza mocy post hoc).
- Test równoważności. Jeśli przed analizą ustalisz najmniejszy interesujący efekt, np. d = ±0.5 (tu ±2.65 punktu), test TOST sprawdzi, czy efekt jest od niego mniejszy (Lakens i in., 2018). W przykładzie t(67.12) = 0.99, p = .163, a 90% CI różnicy [−3.50, 0.70] wychodzi poza dolną granicę. Równoważności więc też nie wykazano.
Rysunek 1 zestawia ten wynik z dużym badaniem tej samej populacji (250 osób w grupie). Tam też p = .797, ale d = −0.02, 95% CI [−0.20, 0.15], mieści się w granicach ±0.5, a TOST daje p < .001. Oba wyniki są nieistotne, lecz tylko duże badanie pozwala napisać, że ewentualny efekt jest zbyt mały, by miał praktyczne znaczenie.
Dienes (2014) proponuje do tego samego pytania czynnik Bayesa, który odróżnia dane przemawiające za hipotezą zerową od danych po prostu niewrażliwych. W pracy licencjackiej zwykle wystarczy przedział ufności i zdanie o czułości badania. TOST i czynnik Bayesa krok po kroku pokazujemy w poradniku hipoteza się nie potwierdziła – co dalej.
Źle i dobrze: sformułowania
| Źle | Dlaczego | Dobrze |
|---|---|---|
| „Grupy nie różnią się poziomem stresu”. | Brak istotności to nie dowód braku różnicy. | „Nie wykazano istotnej różnicy; dane są zgodne zarówno z brakiem efektu, jak i z umiarkowaną różnicą”. |
| „p > .05, n.s.” | Czytelnik nie zna statystyki ani wielkości efektu. | Pełny zapis: t(67.12) = −1.11, p = .270, d = −0.26, 95% CI [−0.73, 0.21]. |
| „Wynik był bliski istotności (tendencja)”. | Próg ustalasz przed analizą. Tego samego zwrotu nikt nie używa przy p = .04. | Podaj dokładne p i opisz przedział ufności. |
| „Hipoteza została odrzucona”. | Testujesz hipotezę zerową, nie badawczą. | „Hipoteza 2 nie znalazła potwierdzenia w danych”. |
| „Moc post hoc wyniosła 20%, więc próba była za mała”. | Moc z zaobserwowanego efektu wynika wprost z p i nic nie dodaje. | Podaj, jaki efekt badanie wykrywało z mocą 80% (tu d = 0.68). |
W dyskusji wróć do tego wyniku krótko. Omów wielkość efektu i liczebność próby, a nie samo p. Gotowe zdania znajdziesz we wpisie jak napisać dyskusję wyników. Odwrotną sytuację, czyli wynik istotny przy bardzo małym efekcie, omawiamy we wpisie wynik istotny, ale efekt mały.
Jak to opisać w pracy
Wzór dla wyniku nierozstrzygającego (wersja z testem równoważności jest opcjonalna, ale granicę równoważności musisz ustalić i uzasadnić przed analizą):
Jeśli przedział ufności jest wąski i mieści się w granicach równoważności, jak w dużym badaniu z rysunku 1, możesz napisać mocniej: „Ewentualna różnica jest mniejsza niż najmniejszy efekt uznany za praktycznie istotny”. Jak ustalić tę granicę i zaplanować liczebność na przyszłość, opisujemy w przewodniku statystyka w pracy dyplomowej. Jeśli chcesz, żeby ktoś sprawdził Twoje wyniki i pomógł Ci je zrozumieć przed obroną, zajrzyj do oferty dla studentów.
Wynik nieistotny w R
Kod odtwarza wszystkie liczby z tekstu: test Welcha, d i g z przedziałami ufności (pakiet effectsize), czułość badania (power.t.test()) i test równoważności złożony z dwóch jednostronnych testów t Welcha.
Test Welcha, wielkość efektu, czułość i TOST
R
# B149 – wynik nieistotny: test Welcha, wielkość efektu z CI, czułość badania i test równoważności
# Dane symulowane: 70 osób studiujących; stres (PSS-10, 0–40) w grupie korzystającej
# z aplikacji do medytacji (n = 34) i w grupie bez aplikacji (n = 36).
library(effectsize)
set.seed(1501)
stres <- function(n, m, s) pmin(40, pmax(0, round(rnorm(n, m, s))))
dane <- data.frame(grupa = factor(rep(c("aplikacja", "bez aplikacji"), c(34, 36)),
                                  levels = c("aplikacja", "bez aplikacji")),
                   pss = c(stres(34, 18.5, 6), stres(36, 20, 6)))

# 1. Statystyki opisowe
aggregate(pss ~ grupa, dane, function(x) round(c(n = length(x), M = mean(x), SD = sd(x)), 2))

# 2. Test Welcha: t, df, p i 95% CI różnicy średnich
tt <- t.test(pss ~ grupa, data = dane)
tt
round(unname(tt$estimate[1] - tt$estimate[2]), 2)   # różnica średnich (aplikacja − bez)

# 3. Wielkość efektu z 95% CI (d Cohena na łącznym SD i g Hedgesa)
cohens_d(pss ~ grupa, data = dane, pooled_sd = TRUE)
hedges_g(pss ~ grupa, data = dane, pooled_sd = TRUE)

# 4. Czułość: jaki efekt to badanie wykrywało z mocą 80% (α = .05, dwustronnie)?
#    power.t.test zakłada równe grupy – przyjmujemy n = 35 na grupę (średnia z 34 i 36)
round(power.t.test(n = 35, sd = 1, sig.level = .05, power = .80)$delta, 2)

# 5. Test równoważności (TOST) z SESOI d = ±0.5, przeliczonym na punkty skali
sd_l <- sqrt(((34 - 1) * var(dane$pss[dane$grupa == "aplikacja"]) +
              (36 - 1) * var(dane$pss[dane$grupa == "bez aplikacji"])) / (70 - 2))
granica <- 0.5 * sd_l
round(c(SD_laczne = sd_l, granica_pkt = granica), 2)
p_dolna <- t.test(pss ~ grupa, data = dane, mu = -granica, alternative = "greater")
p_gorna <- t.test(pss ~ grupa, data = dane, mu =  granica, alternative = "less")
round(c(t_dolna = unname(p_dolna$statistic), p_dolna = p_dolna$p.value,
        t_gorna = unname(p_gorna$statistic), p_gorna = p_gorna$p.value,
        df = unname(p_dolna$parameter)), 3)
round(t.test(pss ~ grupa, data = dane, conf.level = .90)$conf.int, 2)   # 90% CI używany w TOST

# 6. Dla porównania: to samo pytanie w dużym badaniu (250 osób w grupie), ta sama populacja
set.seed(1491)
duze <- data.frame(grupa = factor(rep(c("aplikacja", "bez aplikacji"), each = 250),
                                  levels = c("aplikacja", "bez aplikacji")),
                   pss = c(stres(250, 19.5, 6), stres(250, 20, 6)))
round(t.test(pss ~ grupa, data = duze)$p.value, 3)
cohens_d(pss ~ grupa, data = duze, pooled_sd = TRUE)
sd_d <- sqrt((249 * var(duze$pss[duze$grupa == "aplikacja"]) +
              249 * var(duze$pss[duze$grupa == "bez aplikacji"])) / 498)
g_d <- 0.5 * sd_d
round(c(granica_pkt = g_d,
        p_TOST = max(t.test(pss ~ grupa, data = duze, mu = -g_d, alternative = "greater")$p.value,
                     t.test(pss ~ grupa, data = duze, mu =  g_d, alternative = "less")$p.value)), 3)
Wynik w R
          grupa pss.n pss.M pss.SD
1     aplikacja 34.00 18.76   4.81
2 bez aplikacji 36.00 20.17   5.71

	Welch Two Sample t-test

data:  pss by grupa
t = -1.1131, df = 67.123, p-value = 0.2696
alternative hypothesis: true difference in means between group aplikacja and group bez aplikacji is not equal to 0
95 percent confidence interval:
 -3.915890  1.111968
sample estimates:
    mean in group aplikacja mean in group bez aplikacji
                   18.76471                    20.16667

[1] -1.4
Cohen's d |        95% CI
-------------------------
-0.26     | [-0.73, 0.21]

- Estimated using pooled SD.Hedges' g |        95% CI
-------------------------
-0.26     | [-0.73, 0.20]

- Estimated using pooled SD.[1] 0.68
  SD_laczne granica_pkt
       5.29        2.65
t_dolna p_dolna t_gorna p_gorna      df
  0.988   0.163  -3.214   0.001  67.123
[1] -3.5  0.7
attr(,"conf.level")
[1] 0.9
[1] 0.797
Cohen's d |        95% CI
-------------------------
-0.02     | [-0.20, 0.15]

- Estimated using pooled SD.granica_pkt      p_TOST
      3.122       0.000
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje t.test() i power.t.test() z pakietu stats); rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze pytania
Czy przy p > .05 można napisać, że grupy się nie różnią?
Nie. Wynik nieistotny oznacza tylko, że dane nie pozwoliły odrzucić hipotezy zerowej. Napisz, że nie wykazano istotnej różnicy, i opisz przedział ufności dla wielkości efektu. O braku różnicy o praktycznym znaczeniu możesz mówić dopiero po teście równoważności albo przy wąskim przedziale, który mieści się w przyjętych granicach.
Czy wynik p = .06 można nazwać tendencją statystyczną?
Lepiej nie. Próg istotności ustalasz przed analizą, a określenia „tendencja” czy „prawie istotny” zwykle stosuje się tylko wtedy, gdy wynik jest po myśli autora. Podaj dokładną wartość p, wielkość efektu z przedziałem ufności i opisz, jakie efekty są zgodne z danymi.
Czy po nieistotnym wyniku trzeba policzyć moc post hoc?
Nie licz mocy z zaobserwowanego efektu, bo wynika ona wprost z wartości p i niczego nie wyjaśnia (Hoenig i Heisey, 2001). Zamiast tego podaj, jaki efekt badanie mogło wykryć z mocą 80% przy Twojej liczebności, np. d = 0.68 przy 35 osobach w grupie.
Jak zapisać nieistotny wynik testu t w stylu APA?
Tak samo jak istotny: t, stopnie swobody, dokładne p, różnicę średnich i wielkość efektu z 95% CI, np. t(67.12) = −1.11, p = .270, d = −0.26, 95% CI [−0.73, 0.21]. Nie zastępuj wyniku skrótem „n.s.” ani zapisem „p > .05”.
Powiązane hasła
Przeczytaj też
Hipoteza się nie potwierdziła – co dalej
Jak sprawdzić, co mówi wynik nieistotny: przedział ufności, analiza wrażliwości, test równoważności TOST, czynnik Bayesa i gotowe zdania do wyników.
Czytaj →PoradnikWynik istotny, ale efekt mały
Dlaczego przy dużej próbie słaby efekt daje p < .001, jak ocenić jego znaczenie praktyczne i jak go uczciwie opisać w pracy – przykład w R.
Czytaj →PoradnikJak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →Wynik wyszedł nieistotny i nie wiesz, co z nim zrobić?
Policzymy wielkość efektu z przedziałem ufności i czułość badania, a potem wyjaśnimy wynik tak, żebyś umiał(a) go samodzielnie opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Amrhein, V., Greenland, S., & McShane, B. (2019). Scientists rise up against statistical significance. Nature, 567(7748), 305–307. https://doi.org/10.1038/d41586-019-00857-9 ● Otwarty dostęp
- Dienes, Z. (2014). Using Bayes to get the most out of non-significant results. Frontiers in Psychology, 5, Article 781. https://doi.org/10.3389/fpsyg.2014.00781 ● Otwarty dostęp
- Greenland, S., Senn, S. J., Rothman, K. J., Carlin, J. B., Poole, C., Goodman, S. N., & Altman, D. G. (2016). Statistical tests, P values, confidence intervals, and power: A guide to misinterpretations. European Journal of Epidemiology, 31(4), 337–350. https://doi.org/10.1007/s10654-016-0149-3 ● Otwarty dostęp
- Hoenig, J. M., & Heisey, D. M. (2001). The abuse of power: The pervasive fallacy of power calculations for data analysis. The American Statistician, 55(1), 19–24. https://doi.org/10.1198/000313001300339897
- Lakens, D., Scheel, A. M., & Isager, P. M. (2018). Equivalence testing for psychological research: A tutorial. Advances in Methods and Practices in Psychological Science, 1(2), 259–269. https://doi.org/10.1177/2515245918770963 ● Otwarty dostęp
Cytowania BibTeX
@article{amrhein2019scientists, author={Amrhein, Valentin and Greenland, Sander and McShane, Blake}, title={{Scientists rise up against statistical significance}}, journal={Nature}, year={2019}, volume={567}, number={7748}, pages={305--307}, doi={10.1038/d41586-019-00857-9}}@article{dienes2014using, author={Dienes, Zoltan}, title={{Using Bayes to get the most out of non-significant results}}, journal={Frontiers in Psychology}, year={2014}, volume={5}, eid={781}, doi={10.3389/fpsyg.2014.00781}}@article{greenland2016statistical, author={Greenland, Sander and Senn, Stephen J. and Rothman, Kenneth J. and Carlin, John B. and Poole, Charles and Goodman, Steven N. and Altman, Douglas G.}, title={{Statistical tests, P values, confidence intervals, and power: A guide to misinterpretations}}, journal={European Journal of Epidemiology}, year={2016}, volume={31}, number={4}, pages={337--350}, doi={10.1007/s10654-016-0149-3}}@article{hoenig2001abuse, author={Hoenig, John M. and Heisey, Dennis M.}, title={{The abuse of power: The pervasive fallacy of power calculations for data analysis}}, journal={The American Statistician}, year={2001}, volume={55}, number={1}, pages={19--24}, doi={10.1198/000313001300339897}}@article{lakens2018equivalence, author={Lakens, Daniël and Scheel, Anne M. and Isager, Peder M.}, title={{Equivalence testing for psychological research: A tutorial}}, journal={Advances in Methods and Practices in Psychological Science}, year={2018}, volume={1}, number={2}, pages={259--269}, doi={10.1177/2515245918770963}}