Co to jest test Welcha?
Test t Welcha (ang. Welch’s t-test, unequal variances t-test) porównuje średnie dwóch niezależnych grup bez założenia, że wariancje w populacjach są równe. Wariancję każdej grupy szacuje osobno, a stopnie swobody koryguje wzorem Welcha–Satterthwaite’a – dlatego zwykle nie są liczbą całkowitą, np. t(18.42). Źródłem pierwotnym testu jest praca Welcha (1947), uogólniająca problem „Studenta” na sytuację, w której wariancje populacji są różne.
Ta sama idea działa dla trzech i więcej grup jako ANOVA Welcha (test F Welcha). W R test Welcha jest ustawieniem domyślnym funkcji t.test(), a w SPSS jego wynik pojawia się w wierszu Equal variances not assumed tabeli testu t. To hasło uzupełnia opis testu t dla prób niezależnych.
Wzór: statystyka t i stopnie swobody Welcha–Satterthwaite’a
- M1, M2 – średnie grup; s1², s2² – wariancje w próbach; n1, n2 – liczebności,
- df – skorygowane stopnie swobody; mieszczą się między mniejszym z n1 − 1 i n2 − 1 a n1 + n2 − 2.
Klasyczny test t Studenta łączy obie wariancje w jedną, ważoną liczebnościami: sp² = [(n1 − 1)s1² + (n2 − 1)s2²] / (n1 + n2 − 2), i używa n1 + n2 − 2 stopni swobody. Wspólna wariancja jest zdominowana przez większą grupę. Jeśli to mniejsza grupa ma większy rozrzut, test Studenta zaniża błąd standardowy różnicy i zbyt często ogłasza istotność. Test Welcha nie ma tej słabości, bo każda grupa wnosi do błędu standardowego własną wariancję.
Dlaczego test Welcha powinien być domyślny?
Delacre i in. (2017) argumentują, że założenie równych wariancji rzadko jest w psychologii spełnione, a dobór testu na podstawie wstępnego testu równości wariancji często zawodzi. Test Welcha lepiej kontroluje błąd I rodzaju przy nierównych wariancjach i niewiele traci, gdy założenia są spełnione – dlatego powinien być wyborem domyślnym. W 2022 r. autorzy opublikowali korektę artykułu (Delacre i in., 2022): zawęzili niektóre uogólnienia (np. porównanie z testem Yuena dotyczy tylko rozkładów symetrycznych) i poprawili kilka definicji, zaznaczając, że błędy nie zmieniają głównego przesłania pracy.
Zimmerman (2004) pokazał, że procedura dwuetapowa – najpierw test Levene’a, potem test Studenta albo Welcha – nie chroni poziomu istotności i zwykle pogarsza sytuację. Najlepszą ochronę daje bezwarunkowe stosowanie testu dla oddzielnych wariancji, gdy liczebności grup są nierówne. Mimo to test Welcha wciąż bywa pomijany: Ruxton (2006) policzył, że w artykułach z Behavioral Ecology test t Studenta użyto 67 razy, test U Manna–Whitneya 43 razy, a test dla nierównych wariancji tylko 9 razy, choć test Studenta źle działa przy różnych wariancjach.
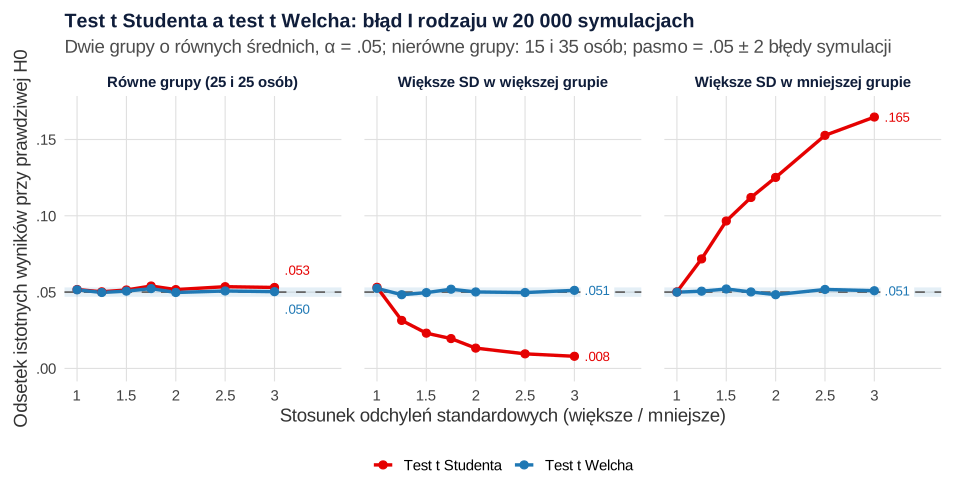
Symulacja z rysunku 1 pokazuje, kiedy wybór testu ma znaczenie. Przy równych liczebnościach test Studenta jest odporny na różne wariancje (od .050 do .054 fałszywych alarmów). Przy nierównych liczebnościach wszystko zależy od tego, która grupa ma większy rozrzut. Jeśli większa grupa, test Studenta staje się zbyt zachowawczy (.008 przy trzykrotnej różnicy odchyleń standardowych), więc traci moc. Jeśli mniejsza – staje się zbyt liberalny: przy dwukrotnej różnicy odchyleń daje .125, a przy trzykrotnej .165 fałszywych alarmów, ponad trzy razy więcej, niż obiecuje α. Test Welcha we wszystkich wariantach trzymał się poziomu .05 (od .048 do .052).
Przykład krok po kroku
Porównujemy poczucie samotności (skala 20–80 punktów) u 16 osób pracujących zdalnie i 44 osób pracujących stacjonarnie (dane symulowane). Osoby pracujące zdalnie mają wyższą średnią i znacznie większy rozrzut wyników:
- praca zdalna: n = 16, M = 53.06, SD = 13.87 (wariancja 192.33),
- praca stacjonarna: n = 44, M = 46.59, SD = 7.65 (wariancja 58.53).
- Składniki błędu standardowego: 192.33 / 16 = 12.02 oraz 58.53 / 44 = 1.33.
- Błąd standardowy różnicy: √(12.02 + 1.33) = 3.65.
- Statystyka t: (53.06 − 46.59) / 3.65 = 6.47 / 3.65 = 1.77.
- Stopnie swobody: (12.02 + 1.33)² / (12.02²/15 + 1.33²/43) = 178.24 / (9.633 + 0.041) = 18.42.
- Wynik: t(18.42) = 1.77, p = .093; 95% przedział ufności dla różnicy [−1.19, 14.14].
Test Studenta na tych samych danych daje t(58) = 2.30, p = .025, 95% CI [0.83, 12.11]. Łączone odchylenie standardowe (9.65) jest bliższe rozrzutowi dużej grupy stacjonarnej, więc błąd standardowy różnicy wynosi tylko 2.82 zamiast 3.65. To dokładnie sytuacja z prawego panelu rysunku 1: mniejsza grupa ma większy rozrzut, a test Studenta jest zbyt liberalny. Test Levene’a jest tu istotny (p = .014), ale nie to jest powodem wyboru testu Welcha – powinien on być zaplanowany od początku.
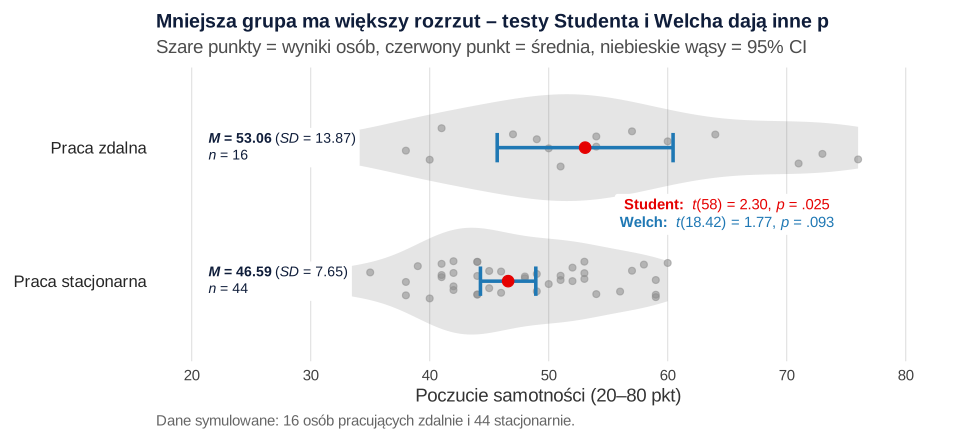
Nieistotny wynik testu Welcha nie oznacza, że grupy się nie różnią. Różnica wynosi 6.47 punktu, a d Cohena liczone bez założenia równych wariancji – 0.58, 95% CI [−0.10, 1.24]. Szeroki przedział pokazuje, że 16 osób to za mało, by precyzyjnie oszacować efekt.
ANOVA Welcha dla trzech i więcej grup
Przy trzech lub więcej grupach stosuje się test F Welcha. Każda grupa dostaje wagę nj/sj², a mianownikowe stopnie swobody są korygowane, podobnie jak w teście t. Delacre i in. (2019) pokazują, że przy realistycznym zróżnicowaniu wariancji klasyczny test F daje obciążone wyniki, i spośród alternatyw rekomendują domyślne stosowanie testu Welcha. W R służy do tego funkcja oneway.test(), a w SPSS opcja Welch w oknie One-Way ANOVA. Porównania par wykonuje się wtedy testem Gamesa–Howella, który również nie zakłada równych wariancji (zob. testy post hoc). Pełny przykład z wynikiem F(2, 56.24) = 12.02 znajdziesz w poradniku ANOVA krok po kroku, a ogólną logikę testu F – w haśle ANOVA.
Jak opisać wynik testu Welcha (APA)
Napisz, że użyto testu Welcha, i podaj stopnie swobody z dwoma miejscami po przecinku. Dodaj średnie, odchylenia standardowe, różnicę z 95% CI i wielkość efektu:
Przy wyniku istotnym zapis wygląda tak samo – zmienia się tylko wniosek. W tabeli dodaj notę „test t Welcha dla nierównych wariancji” (wzór tabeli: tabela testu t w APA). Więcej gotowych zdań znajdziesz we wpisie jak opisać wyniki w stylu APA.
Test Welcha w R
Kod wykonuje test Welcha i – dla porównania – test Studenta, liczy stopnie swobody Welcha–Satterthwaite’a „ręcznie” i wyznacza d Cohena bez założenia równych wariancji. Liczby w haśle pochodzą z tego kodu.
Test t Welcha a test t Studenta
R
# Dane symulowane: poczucie samotności (20–80 pkt) – praca zdalna i stacjonarna
set.seed(2)
zdalna      <- pmin(pmax(round(rnorm(16, 52, 12)), 20), 80)
stacjonarna <- pmin(pmax(round(rnorm(44, 46, 6.5)), 20), 80)
round(c(M_zdalna = mean(zdalna), SD_zdalna = sd(zdalna),
        M_stacj = mean(stacjonarna), SD_stacj = sd(stacjonarna)), 2)

t.test(zdalna, stacjonarna)                     # test Welcha (domyślny w R)
t.test(zdalna, stacjonarna, var.equal = TRUE)   # test t Studenta – dla porównania

# Stopnie swobody Welcha–Satterthwaite'a „ręcznie”
a <- var(zdalna) / 16
b <- var(stacjonarna) / 44
(a + b)^2 / (a^2 / 15 + b^2 / 43)

# d Cohena bez założenia równych wariancji (średnia z dwóch wariancji)
effectsize::cohens_d(zdalna, stacjonarna, pooled_sd = FALSE)
Wynik w R
 M_zdalna SD_zdalna   M_stacj  SD_stacj
    53.06     13.87     46.59      7.65

	Welch Two Sample t-test

data:  zdalna and stacjonarna
t = 1.7712, df = 18.425, p-value = 0.09307
alternative hypothesis: true difference in means is not equal to 0
95 percent confidence interval:
 -1.192229 14.135411
sample estimates:
mean of x mean of y
 53.06250  46.59091


	Two Sample t-test

data:  zdalna and stacjonarna
t = 2.2971, df = 58, p-value = 0.02524
alternative hypothesis: true difference in means is not equal to 0
95 percent confidence interval:
  0.8321216 12.1110603
sample estimates:
mean of x mean of y
 53.06250  46.59091

[1] 18.42465
Cohen's d |        95% CI
-------------------------
0.58      | [-0.10, 1.24]

- Estimated using un-pooled SD.
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakietach ggplot2 i ggtext. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- ggtext (wersja 0.1.2): Wilke, C. O., & Wiernik, B. M. (2022). ggtext: Improved text rendering support for ggplot2 [R package]. https://doi.org/10.32614/CRAN.package.ggtext
Najczęstsze błędy
- Wybór testu na podstawie testu Levene’a – procedura dwuetapowa nie chroni poziomu istotności (Zimmerman, 2004); test Welcha zaplanuj od początku.
- Zaokrąglanie stopni swobody do liczb całkowitych albo podawanie n1 + n2 − 2 przy wyniku testu Welcha.
- Błędna nazwa testu w raporcie – R domyślnie liczy test Welcha (
Welch Two Sample t-test), a SPSS pokazuje oba wyniki w dwóch wierszach; sprawdź, który przepisujesz. - Traktowanie testu Welcha jak testu nieparametrycznego – nadal porównuje średnie; przy danych porządkowych rozważ test Manna–Whitneya.
- Test Welcha dla prób zależnych – pomiary tych samych osób analizuje się testem t dla prób zależnych.
- „Brak różnicy” na podstawie nieistotnego wyniku – przy małej grupie przedział ufności dla różnicy bywa bardzo szeroki.
Najczęstsze pytania
Kiedy stosować test Welcha zamiast testu t Studenta?
Domyślnie zawsze, gdy porównujesz dwie niezależne grupy. Delacre i in. (2017) pokazują, że test Welcha lepiej kontroluje błąd I rodzaju przy nierównych wariancjach i niewiele traci, gdy są one równe. Różnica jest największa przy nierównych liczebnościach – zwłaszcza gdy mniejsza grupa ma większy rozrzut.
Dlaczego test Welcha ma ułamkowe stopnie swobody?
Stopnie swobody liczy się wzorem Welcha–Satterthwaite’a z wariancji i liczebności obu grup, a nie jako n1 + n2 − 2. Wynik leży między mniejszym z n1 − 1 i n2 − 1 a n1 + n2 − 2 i zwykle nie jest liczbą całkowitą. W raporcie podaj go z dwoma miejscami po przecinku, np. t(18.42).
Jak zrobić test Welcha w SPSS?
Wykonaj zwykły test t dla prób niezależnych (Analyze → Compare Means → Independent-Samples T Test). SPSS pokaże dwa wiersze wyników – test Welcha to wiersz Equal variances not assumed. Dla trzech i więcej grup użyj okna One-Way ANOVA i zaznacz Welch w Options.
Jak zapisać wynik testu Welcha w APA?
Napisz, że użyto testu t Welcha, i podaj ułamkowe stopnie swobody, np. „t(18.42) = 1.77, p = .093; różnica = 6.47 pkt, 95% CI [−1.19, 14.14], d = 0.58”. Dodaj średnie i odchylenia standardowe obu grup.
Czy test Welcha wymaga normalności rozkładu?
Tak, podobnie jak test t Studenta porównuje średnie i zakłada w przybliżeniu normalny rozkład w populacjach; nie jest testem nieparametrycznym. W większych próbach jest odporny na umiarkowane odstępstwa, ale przy małych i silnie skośnych grupach rozważ metody odporne albo test Manna–Whitneya.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
ANOVA krok po kroku
Jednoczynnikowa i dwuczynnikowa ANOVA na przykładach: założenia, test Welcha, post hoc, η² i ω², efekty proste, typy sum kwadratów i opis APA.
Czytaj →PoradnikJak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Delacre, M., Lakens, D., & Leys, C. (2017). Why psychologists should by default use Welch's t-test instead of Student's t-test. International Review of Social Psychology, 30(1), 92–101. https://doi.org/10.5334/irsp.82 ● Otwarty dostęp
- Delacre, M., Lakens, D., & Leys, C. (2022). Correction: Why psychologists should by default use Welch’s t-test instead of Student’s t-test. International Review of Social Psychology, 35(1), Article 21. https://doi.org/10.5334/irsp.661 ● Otwarty dostęp
- Delacre, M., Leys, C., Mora, Y. L., & Lakens, D. (2019). Taking parametric assumptions seriously: Arguments for the use of Welch's F-test instead of the classical F-test in one-way ANOVA. International Review of Social Psychology, 32(1), Article 13. https://doi.org/10.5334/irsp.198 ● Otwarty dostęp
- Ruxton, G. D. (2006). The unequal variance t-test is an underused alternative to Student's t-test and the Mann–Whitney U test. Behavioral Ecology, 17(4), 688–690. https://doi.org/10.1093/beheco/ark016
- Welch, B. L. (1947). The generalization of 'Student's' problem when several different population variances are involved. Biometrika, 34(1–2), 28–35. https://doi.org/10.1093/biomet/34.1-2.28
- Zimmerman, D. W. (2004). A note on preliminary tests of equality of variances. British Journal of Mathematical and Statistical Psychology, 57(1), 173–181. https://doi.org/10.1348/000711004849222
Cytowania BibTeX
@article{delacre2017why, author={Delacre, Marie and Lakens, Daniël and Leys, Christophe}, title={{Why psychologists should by default use Welch's t-test instead of Student's t-test}}, journal={International Review of Social Psychology}, year={2017}, volume={30}, number={1}, pages={92--101}, doi={10.5334/irsp.82}}@article{delacre2022correction, author={Delacre, Marie and Lakens, Daniël and Leys, Christophe}, title={{Correction: Why psychologists should by default use Welch’s t-test instead of Student’s t-test}}, journal={International Review of Social Psychology}, year={2022}, volume={35}, number={1}, eid={21}, doi={10.5334/irsp.661}}@article{delacre2019taking, author={Delacre, Marie and Leys, Christophe and Mora, Youri L. and Lakens, Daniël}, title={{Taking parametric assumptions seriously: Arguments for the use of Welch's F-test instead of the classical F-test in one-way ANOVA}}, journal={International Review of Social Psychology}, year={2019}, volume={32}, number={1}, eid={13}, doi={10.5334/irsp.198}}@article{ruxton2006unequal, author={Ruxton, Graeme D.}, title={{The unequal variance t-test is an underused alternative to Student's t-test and the Mann–Whitney U test}}, journal={Behavioral Ecology}, year={2006}, volume={17}, number={4}, pages={688--690}, doi={10.1093/beheco/ark016}}@article{welch1947generalization, author={Welch, B. L.}, title={{The generalization of 'Student's' problem when several different population variances are involved}}, journal={Biometrika}, year={1947}, volume={34}, number={1–2}, pages={28--35}, doi={10.1093/biomet/34.1-2.28}}@article{zimmerman2004note, author={Zimmerman, Donald W.}, title={{A note on preliminary tests of equality of variances}}, journal={British Journal of Mathematical and Statistical Psychology}, year={2004}, volume={57}, number={1}, pages={173--181}, doi={10.1348/000711004849222}}