Symulacja to eksperyment – i trzeba go zaplanować
Badanie symulacyjne to eksperyment, w którym badanymi są metody statystyczne. Generujesz wiele zbiorów danych z modelu o znanych parametrach, analizujesz każdy kilkoma metodami i sprawdzasz, która lepiej odtwarza znaną „prawdę”. Na danych rzeczywistych tego nie zrobisz, bo prawdziwej wartości parametru nie znasz (Burton i in., 2006). Szczególnym przypadkiem jest symulacyjna analiza mocy, opisana w haśle parametr niecentralności i symulacyjna analiza mocy oraz we wpisach o liczebności próby do SEM i o mocy modelu mieszanego.
Jak każdy eksperyment, symulację można źle zaprojektować i niejasno opisać. Siepe i in. (2024) przejrzeli 321 artykułów z trzech czasopism metodologicznych w psychologii z lat 2021–2022. Symulację zawierało 100 z nich. Wiele nie uzasadniało liczby powtórzeń, nie podawało niepewności Monte Carlo ani kodu, który pozwoliłby odtworzyć wyniki. Burton i in. (2006) zalecali już wcześniej, by przed symulacją napisać szczegółowy protokół: jak badanie zostanie wykonane, przeanalizowane i opisane.
Ten wpis pokazuje, jak taki protokół ułożyć według schematu ADEMP. Przykładem jest porównanie testu t Studenta i Welcha. Sam wynik jest znany i opisują go hasło test Welcha oraz wpis o testach odpornych dla dwóch grup. Tutaj służy jako prosty poligon dla decyzji projektowych.
ADEMP: pięć decyzji przed pierwszą linijką kodu
Morris i in. (2019) proponują planować i raportować symulacje według pięciu elementów: cele (Aims), mechanizm generowania danych (Data-generating mechanisms), estymandy (Estimands), metody (Methods) i miary jakości (Performance measures). Siepe i in. (2024) przenieśli ten schemat do psychologii i przygotowali szablon ADEMP-PreReg do planowania, prerejestracji i raportowania symulacji.
| Element | Pytanie | W przykładzie |
|---|---|---|
| A – cele | Co chcesz sprawdzić i w jakich warunkach? | Czy trzy sposoby porównania dwóch średnich utrzymują błąd I rodzaju .05 i pokrycie 95% CI przy nierównych wariancjach i liczebnościach i jaką mają moc |
| D – dane | Z jakiego modelu losujesz dane i które czynniki zmieniasz? | Rozkład normalny, N = 60; liczebności A/B: 30/30, 45/15, 15/45; SD grupy B równe 10 albo 20 (A zawsze 10); różnica średnich 0 albo 6 punktów; 3 × 2 × 2 = 12 warunków |
| E – estymandy | Jaką wielkość metody mają oszacować albo przetestować? | Różnica średnich w populacji Δ = μB − μA i hipoteza zerowa Δ = 0 |
| M – metody | Które analizy porównujesz? | Test t Studenta, test t Welcha i procedura dwuetapowa: test Levene’a, a potem Welch albo Student |
| P – miary | Po czym poznasz, że metoda działa? | Obciążenie, empiryczny SE, odsetek odrzuceń H0 (błąd I rodzaju lub moc), pokrycie 95% CI, względny błąd modelowego SE – każda z błędem Monte Carlo |
Cele i mechanizm generowania danych
Cel określa zakres wniosku. Zamiast „sprawdzić test Welcha” napisz: „sprawdzić, czy przy N = 60 i ilorazie SD do 2 test Welcha utrzymuje nominalny błąd I rodzaju, także gdy grupy są nierówne”. Taki cel od razu wyznacza czynniki symulacji.
Wartości czynników w mechanizmie generowania danych bierz z literatury albo z danych z Twojej dziedziny, a nie z wygody. Zawsze dodaj warunek „łatwy”, w którym wszystkie metody powinny działać (tu: 30/30 i równe SD). Jeśli któraś zawodzi już tam, masz błąd w kodzie, a nie odkrycie. Warunki krzyżuj w pełni, by zobaczyć interakcje czynników. W przykładzie problem pojawia się tylko przy połączeniu nierównych n i nierównych SD. Heterogeniczność wariancji przy równych grupach prawie nie szkodzi.
Warunek z różnicą 0 jest konieczny: bez błędu I rodzaju nie wiesz, czy wysoka moc jest prawdziwa.
Estymandy i metody
Estymanda to wielkość, którą metoda ma oszacować. W przykładzie to różnica średnich populacyjnych. Wszystkie trzy metody liczą ją tak samo, jako różnicę średnich z próby. Dlatego obciążenie i empiryczny błąd standardowy są w nich identyczne. Metody różnią się tylko tym, jak szacują niepewność: błąd standardowy, stopnie swobody, przedział ufności i p. To podpowiada, które miary jakości mają sens.
Metody wybierz tak, by odpowiadały realnym decyzjom badaczy. Procedura dwuetapowa, czyli najpierw test Levene’a, a potem wybór testu t, wciąż jest popularna. Zimmerman (2004) pokazał jednak, że nie chroni poziomu istotności. Delacre i in. (2017) zalecają test Welcha jako domyślny. Symulacja pozwala sprawdzić oba twierdzenia w Twoich warunkach. Metodę zapisz w kodzie dokładnie tak, jak użyłby jej badacz, razem z progiem testu wstępnego.
Miary jakości i ich błąd Monte Carlo
Każda miara z symulacji jest oszacowaniem z R powtórzeń, więc ma własny błąd standardowy – błąd Monte Carlo (MCSE). Morris i in. (2019) podają wzory dla najczęstszych miar. Najważniejsze zebraliśmy w tabeli. θ to prawdziwa wartość, θ̂i – oszacowanie w powtórzeniu i, a p̂ – zaobserwowany odsetek.
| Miara | Definicja | Błąd Monte Carlo |
|---|---|---|
| Obciążenie | średnia θ̂i − θ | EmpSE / √R |
| Empiryczny SE (EmpSE) | SD oszacowań θ̂i | EmpSE / √(2(R − 1)) |
| Błąd średniokwadratowy (MSE) | średnia (θ̂i − θ)²; RMSE = √MSE | √(Σ[(θ̂i − θ)² − MSE]² / (R(R − 1))) |
| Błąd I rodzaju, moc, pokrycie | odsetek p < α albo odsetek CI zawierających θ | √(p̂(1 − p̂) / R) |
| Względny błąd modelowego SE | 100 × (ModSE / EmpSE − 1), gdzie ModSE = √(średnia SE²i) | wzór w kodzie niżej (Morris i in., 2019) |
MSE i jego pierwiastek, RMSE, łączą obciążenie i zmienność. Przydają się, gdy metody różnią się estymatorem punktowym. W przykładzie estymator jest wspólny, więc RMSE niczego nie rozróżni. Względny błąd modelowego SE mówi, czy błąd standardowy podawany przez metodę zgadza się z rzeczywistą zmiennością oszacowań. To on wyjaśnia, dlaczego test się myli. Błąd I rodzaju i pokrycie mówią, jak bardzo.
Uwaga na powiązanie miar. Przy Δ = 0 pokrycie 95% CI wynosi dokładnie 1 minus odsetek odrzuceń, bo test odrzuca H0 wtedy, gdy CI nie zawiera zera. Takich miar nie licz podwójnie. W przykładzie pokrycie raportujemy więc dla Δ = 6.
Ile powtórzeń? Licz z wymaganej precyzji
Liczbę powtórzeń wyznacz przed symulacją z błędu Monte Carlo, który uznasz za wystarczający (Siepe i in., 2024). Dla odsetka R = p(1 − p) / MCSE². Chcieliśmy, by błąd I rodzaju .05 miał MCSE ≤ .005. To daje 1900 powtórzeń. Moc w najgorszym przypadku, czyli przy .50, z MCSE ≤ .010 wymaga 2500 powtórzeń. Przyjęliśmy więc R = 2500 w każdym z 12 warunków.
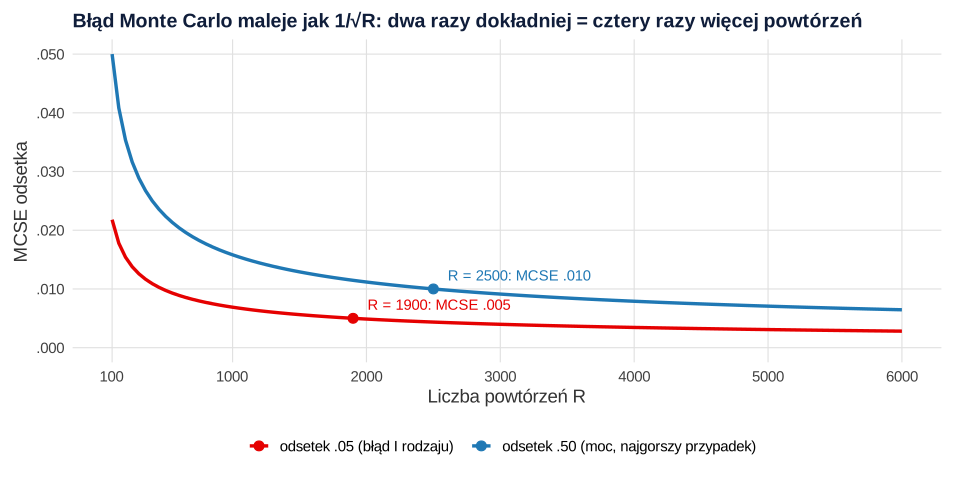
Krzywa szybko się spłaszcza. Przy 500 powtórzeniach MCSE odsetka .05 wynosi .0097, przy 1000 – .0069, przy 5000 – .0031. Z 500 powtórzeniami nie odróżnisz więc rzetelnie .05 od .065. Obciążenie wymaga zwykle więcej powtórzeń, bo jego MCSE zależy od zmienności oszacowań. Przy empirycznym SE od 2.561 do 5.492 punktu MCSE równe 0.05 punktu wymagałoby od 2625 do 12065 powtórzeń. W przykładzie obciążenie nie jest celem, więc wystarczy nam jego MCSE do 0.110.
Wyniki: co pokazała symulacja
Obciążenie różnicy średnich było bliskie zera we wszystkich warunkach. Największe co do wartości bezwzględnej wyniosło 0.127 punktu przy MCSE 0.083, czyli mieściło się w granicach błędu losowego. Różnice pojawiają się tam, gdzie metody szacują niepewność.
| Liczebności A/B | SD A/B | α Student | α Welch | α dwuetapowa | Moc Student | Moc Welch | Moc dwuetapowa |
|---|---|---|---|---|---|---|---|
| 30/30 | 10/10 | .049 (.004) | .049 (.004) | .049 (.004) | .637 (.010) | .636 (.010) | .637 (.010) |
| 45/15 | 10/10 | .054 (.005) | .048 (.004) | .054 (.005) | .498 (.010) | .480 (.010) | .499 (.010) |
| 15/45 | 10/10 | .050 (.004) | .048 (.004) | .050 (.004) | .512 (.010) | .504 (.010) | .508 (.010) |
| 30/30 | 10/20 | .058 (.005) | .057 (.005) | .058 (.005) | .304 (.009) | .297 (.009) | .298 (.009) |
| 45/15 | 10/20 | .159 (.007) | .051 (.004) | .068 (.005) | .379 (.010) | .176 (.008) | .201 (.008) |
| 15/45 | 10/20 | .011 (.002) | .052 (.004) | .044 (.004) | .124 (.007) | .315 (.009) | .284 (.009) |
Test Welcha utrzymał błąd I rodzaju w przedziale od .048 do .057 we wszystkich warunkach. Test Studenta zawodził tylko przy połączeniu nierównych n i nierównych SD. Gdy mniejsza grupa miała większe SD, odrzucał prawdziwą H0 w 15.9% powtórzeń. Gdy większa grupa miała większe SD, odrzucał ją w 1.1%. Procedura dwuetapowa poprawiła sytuację, ale nie usunęła problemu: .068 przy MCSE .005, zgodnie z wnioskiem Zimmermana (2004).
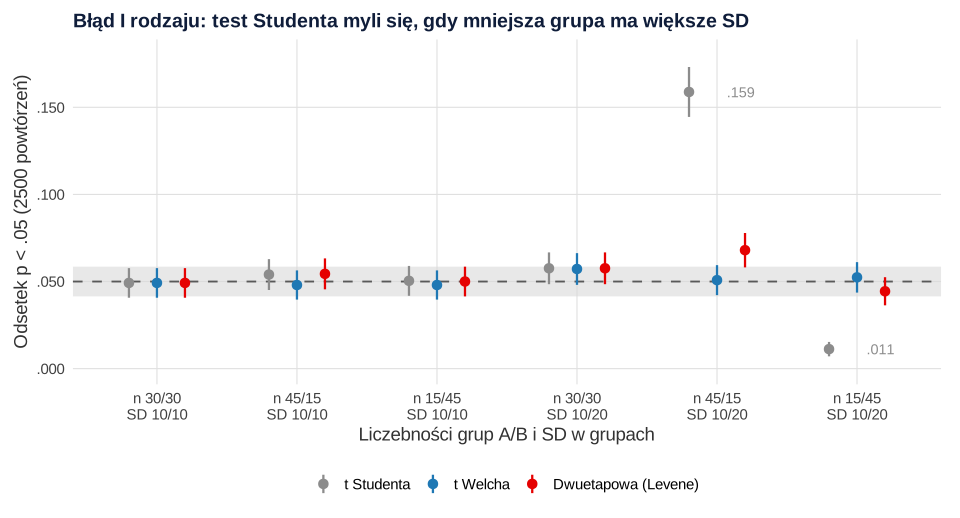
Czytając tabelę, patrz najpierw na błąd I rodzaju, a dopiero potem na moc. Test Studenta ma w warunku 45/15 „moc” .379, a test Welcha .176. To nie jest przewaga Studenta, tylko skutek tego, że odrzuca on H0 zbyt łatwo także wtedy, gdy jest prawdziwa. Moc porównuj tylko między metodami, które utrzymują nominalny błąd I rodzaju. Przy równych SD koszt Welcha jest mały: .480 zamiast .498 w warunku 45/15.
Rysunek 3 pokazuje mechanizm. W warunku 45/15 z SD 10/20 wspólna wariancja zaniża błąd standardowy testu Studenta o 27.7% (MCSE 1.0), a w warunku 15/45 zawyża go o 34.5% (MCSE 1.9). Stąd pokrycie 95% CI wynosi odpowiednio .851 i .991. Test Welcha ma względny błąd SE od −2.2% do 0.2% i pokrycie od .944 do .952.
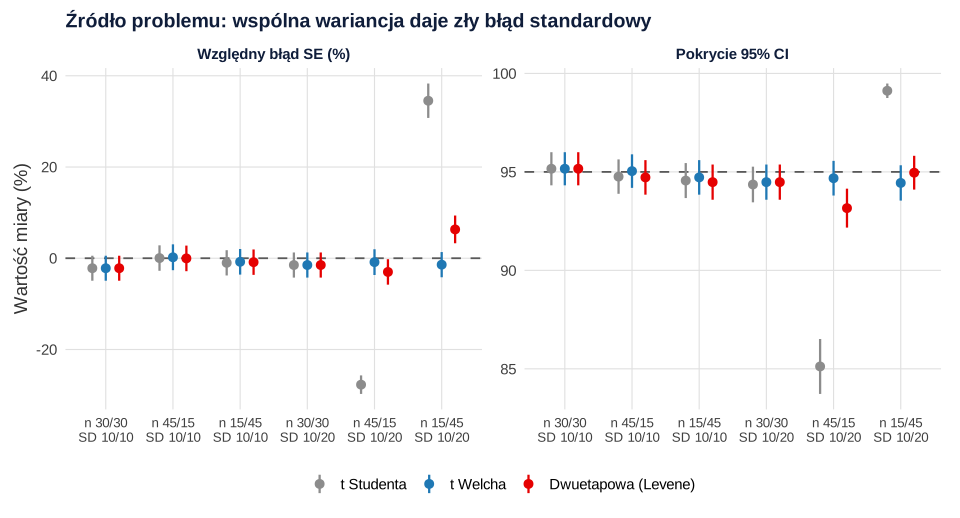
Przy 36 komórkach kilka wartości odejdzie od nominalnej o około dwa MCSE przypadkiem, jak .058 i .057 w warunku 30/30 z SD 10/20. Interpretuj wzór powtarzający się w warunkach, a nie pojedyncze odchylenia.
Ziarno, stany RNG i kod do udostępnienia
Symulacja ma być odtwarzalna co do liczby. Kilka praktyk, które to zapewniają:
- Osobne ziarno dla każdego warunku. W przykładzie to 34001–34012. Wynik warunku nie zależy wtedy od kolejności obliczeń ani od tego, czy liczysz na jednym rdzeniu, czy równolegle.
- Zapis stanów generatora. Pakiet SimDesign (Chalmers i Adkins, 2020) z opcją
store_Random.seeds = TRUEzapisuje stan generatora przed każdym powtórzeniem. W przykładzie odtworzyliśmy w ten sposób 34. powtórzenie warunku 45/15. Test Studenta dał tam p = .047, a test Welcha p = .155. Po odtworzeniu stanu dostaliśmy identyczne liczby. Tak szuka się błędów, które pojawiają się raz na tysiąc powtórzeń. - Najpierw mało powtórzeń. Sprawdź kod na kilkudziesięciu powtórzeniach i warunku łatwym, potem puść pełną symulację.
- Zapis wersji. Podaj wersję R, pakietów i rodzaj generatora liczb losowych. W przykładzie: R 4.5.3, SimDesign 2.28, generator Mersenne-Twister.
- Protokół przed wynikami. Symulacja ma własny ogród rozwidlających się ścieżek: można dobierać warunki i miary, aż ulubiona metoda wypadnie dobrze. Prerejestracja oddziela przewidywanie od wyjaśniania po fakcie (Nosek i in., 2018). Szablon ADEMP-PreReg (Siepe i in., 2024) możesz złożyć tak jak plan analizy statystycznej.
- Kod i wyniki surowe. Udostępnij skrypt, plik z wynikami każdego powtórzenia i tabelę podsumowań. Jak uporządkować folder, opisuje wpis o pakiecie replikacyjnym. Wilson i in. (2017) zebrali „wystarczająco dobre” praktyki pracy z kodem dla badaczy bez przygotowania informatycznego.
SimDesign porządkuje symulację w tabelę warunków i trzy funkcje: generowanie danych, analizę jednego zbioru i podsumowanie powtórzeń. Ten sam układ napiszesz we własnej pętli, ale pakiet dokłada obsługę błędów, zapis ziaren i obliczenia równoległe. Przy symulacji mocy dla interakcji układ ADEMP jest ten sam.
Jak opisać badanie symulacyjne
Opis idzie kolejno przez elementy ADEMP i podaje liczbę powtórzeń z uzasadnieniem, MCSE oraz miejsce udostępnienia kodu. Jeśli chcesz, żeby ktoś sprawdził protokół lub kod symulacji przed wysłaniem artykułu, zajrzyj do oferty analiz statystycznych dla badaczy.
Przykład w R
Dwa przepisy uruchamiasz po kolei w jednej sesji R. Pierwszy to cała symulacja w pakiecie SimDesign i zapis wyników do pliku b340-wyniki-symulacji.csv (możesz go pobrać tutaj). Drugi liczy precyzję Monte Carlo i odtwarza jedno powtórzenie z zapisanego stanu generatora. Pełna symulacja (30 000 powtórzeń) trwa niecałą minutę na jednym rdzeniu.
1. Symulacja według ADEMP
R
# Krok 1. Badanie symulacyjne według ADEMP w pakiecie SimDesign (dane symulowane)
# A (cele): czy test t Studenta, test t Welcha i procedura dwuetapowa (Levene → Student/Welch)
#   utrzymują błąd I rodzaju .05 i pokrycie 95% CI przy nierównych wariancjach i liczebnościach
#   oraz jaką mają moc.
suppressPackageStartupMessages(library(SimDesign))

# Liczba powtórzeń z wymaganej precyzji: błąd Monte Carlo (MCSE) odsetka p to sqrt(p(1 - p)/R)
R_alfa <- ceiling(.05 * .95 / .005^2)   # błąd I rodzaju .05 z MCSE <= .005
R_moc  <- ceiling(.50 * .50 / .010^2)   # moc w najgorszym przypadku (.50) z MCSE <= .010
c(R_alfa = R_alfa, R_moc = R_moc)
R <- max(R_alfa, R_moc)

# D (mechanizm generowania danych): rozkład normalny, SD grupy A = 10,
#   SD grupy B = 10 albo 20, liczebności A/B: 30/30, 45/15, 15/45, różnica średnich 0 albo 6
Design <- createDesign(n_A = c(30, 45, 15), sd_ratio = c(1, 2), delta = c(0, 6))
Design$n_B <- 60 - Design$n_A
Design <- Design[, c("n_A", "n_B", "sd_ratio", "delta")]

Generate <- function(condition, fixed_objects) {
  with(condition, data.frame(
    grupa = factor(rep(c("A", "B"), c(n_A, n_B))),
    y = c(rnorm(n_A, mean = 50, sd = 10), rnorm(n_B, mean = 50 + delta, sd = 10 * sd_ratio))))
}

# E (estymanda): delta = średnia B − średnia A; M (metody): trzy analizy tych samych danych
Analyse <- function(condition, dat, fixed_objects) {
  st <- t.test(y ~ grupa, data = dat, var.equal = TRUE)
  we <- t.test(y ~ grupa, data = dat, var.equal = FALSE)
  # test Levene'a (odchylenia od mediany grupy) decyduje o wyborze testu w procedurze dwuetapowej
  odch <- abs(dat$y - ave(dat$y, dat$grupa, FUN = median))
  p_lev <- anova(lm(odch ~ dat$grupa))[["Pr(>F)"]][1]
  dw <- if (p_lev < .05) we else st
  est <- unname(diff(st$estimate))             # średnia B − średnia A
  # t.test podaje CI dla A − B, więc dla B − A odwracamy granice i znak
  out <- c(est = est)
  for (m in c("Student", "Welch", "Dwuetapowa")) {
    tt <- switch(m, Student = st, Welch = we, Dwuetapowa = dw)
    out[paste0(c("p_", "se_", "lo_", "hi_"), m)] <- c(tt$p.value, tt$stderr, -rev(tt$conf.int))
  }
  out
}

# P (miary jakości) z błędem Monte Carlo (wzory: Morris i in., 2019)
Summarise <- function(condition, results, fixed_objects) {
  R <- nrow(results); th <- condition$delta; est <- results[, "est"]
  emp_se <- sd(est)
  wynik <- c(bias = mean(est) - th, mcse_bias = emp_se / sqrt(R),
             emp_se = emp_se, mcse_emp_se = emp_se / sqrt(2 * (R - 1)))
  for (m in c("Student", "Welch", "Dwuetapowa")) {
    odrz <- mean(results[, paste0("p_", m)] < .05)
    pokr <- mean(results[, paste0("lo_", m)] <= th & th <= results[, paste0("hi_", m)])
    se2 <- results[, paste0("se_", m)]^2
    mod_se <- sqrt(mean(se2))
    blad_se <- 100 * (mod_se / emp_se - 1)
    mcse_blad_se <- 100 * (mod_se / emp_se) * sqrt(var(se2) / (4 * R * mod_se^4) + 1 / (2 * (R - 1)))
    wynik[paste0(c("odrz_", "mcse_odrz_", "pokr_", "mcse_pokr_", "bladSE_", "mcse_bladSE_"), m)] <-
      c(odrz, sqrt(odrz * (1 - odrz) / R), pokr, sqrt(pokr * (1 - pokr) / R), blad_se, mcse_blad_se)
  }
  wynik
}

# Uruchomienie: osobne ziarno dla każdego warunku i zapis stanów .Random.seed każdego powtórzenia
ziarna <- 34000 + seq_len(nrow(Design))
sym <- runSimulation(design = Design, replications = R, generate = Generate, analyse = Analyse,
                     summarise = Summarise, seed = ziarna, save = FALSE, progress = FALSE,
                     verbose = FALSE, control = list(store_Random.seeds = TRUE))
wyn <- as.data.frame(sym)
kol <- c("n_A", "n_B", "sd_ratio", "delta")

# Obciążenie i empiryczny SE oszacowania różnicy średnich (takie samo we wszystkich metodach)
print(round(wyn[, c(kol, "bias", "mcse_bias", "emp_se", "mcse_emp_se")], 3), row.names = FALSE)

# Miary jakości w formacie długim: warunek × metoda
dlugi <- do.call(rbind, lapply(c("Student", "Welch", "Dwuetapowa"), function(m)
  data.frame(wyn[, kol], metoda = m,
             odrz = wyn[[paste0("odrz_", m)]], mcse_odrz = wyn[[paste0("mcse_odrz_", m)]],
             pokr = wyn[[paste0("pokr_", m)]], mcse_pokr = wyn[[paste0("mcse_pokr_", m)]],
             bladSE = wyn[[paste0("bladSE_", m)]], mcse_bladSE = wyn[[paste0("mcse_bladSE_", m)]])))
write.csv(dlugi, "b340-wyniki-symulacji.csv", row.names = FALSE)

# Tabele: wartość miary i w nawiasie jej błąd Monte Carlo
tab <- function(d, miara, cyfry = 3) {
  f <- function(m) { x <- d[d$metoda == m, ]
    sprintf(paste0("%.", cyfry, "f (%.", cyfry, "f)"), x[[miara]], x[[paste0("mcse_", miara)]]) }
  data.frame(d[d$metoda == "Student", kol], Student = f("Student"), Welch = f("Welch"),
             Dwuetapowa = f("Dwuetapowa"))
}
cat("Błąd I rodzaju (delta = 0):\n");  print(tab(subset(dlugi, delta == 0), "odrz"), row.names = FALSE)
cat("Moc (delta = 6):\n");             print(tab(subset(dlugi, delta == 6), "odrz"), row.names = FALSE)
cat("Pokrycie 95% CI (delta = 6):\n"); print(tab(subset(dlugi, delta == 6), "pokr"), row.names = FALSE)
cat("Względny błąd modelowego SE, % (delta = 6):\n")
print(tab(subset(dlugi, delta == 6), "bladSE", cyfry = 1), row.names = FALSE)
Wynik w R
R_alfa  R_moc
  1900   2500
 n_A n_B sd_ratio delta   bias mcse_bias emp_se mcse_emp_se
  30  30        1     0  0.005     0.051  2.561       0.036
  45  15        1     0 -0.079     0.061  3.036       0.043
  15  45        1     0  0.030     0.059  2.959       0.042
  30  30        2     0  0.127     0.083  4.147       0.059
  45  15        2     0 -0.007     0.110  5.492       0.078
  15  45        2     0  0.037     0.078  3.921       0.055
  30  30        1     6  0.071     0.053  2.639       0.037
  45  15        1     6  0.021     0.060  2.983       0.042
  15  45        1     6  0.041     0.060  3.012       0.043
  30  30        2     6 -0.043     0.083  4.138       0.059
  45  15        2     6 -0.124     0.108  5.401       0.076
  15  45        2     6 -0.098     0.080  4.011       0.057
Błąd I rodzaju (delta = 0):
 n_A n_B sd_ratio delta       Student         Welch    Dwuetapowa
  30  30        1     0 0.049 (0.004) 0.049 (0.004) 0.049 (0.004)
  45  15        1     0 0.054 (0.005) 0.048 (0.004) 0.054 (0.005)
  15  45        1     0 0.050 (0.004) 0.048 (0.004) 0.050 (0.004)
  30  30        2     0 0.058 (0.005) 0.057 (0.005) 0.058 (0.005)
  45  15        2     0 0.159 (0.007) 0.051 (0.004) 0.068 (0.005)
  15  45        2     0 0.011 (0.002) 0.052 (0.004) 0.044 (0.004)
Moc (delta = 6):
 n_A n_B sd_ratio delta       Student         Welch    Dwuetapowa
  30  30        1     6 0.637 (0.010) 0.636 (0.010) 0.637 (0.010)
  45  15        1     6 0.498 (0.010) 0.480 (0.010) 0.499 (0.010)
  15  45        1     6 0.512 (0.010) 0.504 (0.010) 0.508 (0.010)
  30  30        2     6 0.304 (0.009) 0.297 (0.009) 0.298 (0.009)
  45  15        2     6 0.379 (0.010) 0.176 (0.008) 0.201 (0.008)
  15  45        2     6 0.124 (0.007) 0.315 (0.009) 0.284 (0.009)
Pokrycie 95% CI (delta = 6):
 n_A n_B sd_ratio delta       Student         Welch    Dwuetapowa
  30  30        1     6 0.952 (0.004) 0.952 (0.004) 0.952 (0.004)
  45  15        1     6 0.948 (0.004) 0.950 (0.004) 0.947 (0.004)
  15  45        1     6 0.946 (0.005) 0.947 (0.004) 0.945 (0.005)
  30  30        2     6 0.944 (0.005) 0.945 (0.005) 0.945 (0.005)
  45  15        2     6 0.851 (0.007) 0.947 (0.004) 0.932 (0.005)
  15  45        2     6 0.991 (0.002) 0.944 (0.005) 0.950 (0.004)
Względny błąd modelowego SE, % (delta = 6):
 n_A n_B sd_ratio delta     Student      Welch Dwuetapowa
  30  30        1     6  -2.2 (1.4) -2.2 (1.4) -2.2 (1.4)
  45  15        1     6   0.0 (1.4)  0.2 (1.4) -0.0 (1.4)
  15  45        1     6  -1.0 (1.4) -0.8 (1.4) -0.9 (1.4)
  30  30        2     6  -1.5 (1.4) -1.5 (1.4) -1.5 (1.4)
  45  15        2     6 -27.7 (1.0) -0.9 (1.4) -3.0 (1.4)
  15  45        2     6  34.5 (1.9) -1.4 (1.4)  6.3 (1.6)
2. Liczba powtórzeń i odtworzenie powtórzenia ze stanu RNG
R
# Krok 2. Precyzja Monte Carlo i odtworzenie pojedynczego powtórzenia (wymaga obiektów z kroku 1)

# a) MCSE odsetka (błąd I rodzaju, pokrycie, moc) dla różnych liczb powtórzeń R
mcse_odsetka <- function(p, R) sqrt(p * (1 - p) / R)
siatka_R <- c(500, 1000, 2500, 5000)
tab_mcse <- sapply(c(alfa_.05 = .05, moc_.50 = .50, moc_.80 = .80, pokrycie_.95 = .95),
                   function(p) mcse_odsetka(p, siatka_R))
rownames(tab_mcse) <- paste0("R = ", siatka_R)
round(tab_mcse, 4)

# b) Ile powtórzeń, żeby obciążenie miało MCSE <= 0.05 punktu? R = (empiryczny SE / 0.05)^2
emp_se <- setNames(wyn$emp_se, with(wyn, paste0(n_A, "/", n_B, ", sd x", sd_ratio, ", delta ", delta)))
round(c(min_emp_se = min(emp_se), max_emp_se = max(emp_se)), 3)
ceiling((range(emp_se) / 0.05)^2)

# c) Odtworzenie jednego powtórzenia z zapisanego stanu .Random.seed
#    Warunek 5: n 45/15, SD grupy B dwa razy większe, delta = 0 (test Studenta liberalny)
wyniki_5 <- subset(as.data.frame(SimExtract(sym, "results")), n_A == 45 & sd_ratio == 2 & delta == 0)
ktore <- which(wyniki_5$p_Student < .05 & wyniki_5$p_Welch >= .05)[1]   # pierwszy „fałszywy alarm” Studenta
ktore
stany <- SimExtract(sym, "Random.seeds")[[5]]
assign(".Random.seed", stany[ktore, ], envir = .GlobalEnv)
dane <- Generate(Design[5, ], NULL)
odtw <- Analyse(Design[5, ], dane, NULL)
rbind(zapisane = unlist(wyniki_5[ktore, c("est", "p_Student", "p_Welch")]),
      odtworzone = odtw[c("est", "p_Student", "p_Welch")])
tapply(dane$y, dane$grupa, sd)

# d) Co zapisać w raporcie z symulacji
c(R = R.version.string, SimDesign = as.character(packageVersion("SimDesign")),
  RNG = paste(RNGkind()[1:2], collapse = " / "), ziarna = paste(range(ziarna), collapse = "–"))
Wynik w R
         alfa_.05 moc_.50 moc_.80 pokrycie_.95
R = 500    0.0097  0.0224  0.0179       0.0097
R = 1000   0.0069  0.0158  0.0126       0.0069
R = 2500   0.0044  0.0100  0.0080       0.0044
R = 5000   0.0031  0.0071  0.0057       0.0031
min_emp_se max_emp_se
     2.561      5.492
[1]  2625 12065
[1] 34
                 est  p_Student   p_Welch
zapisane   -7.098687 0.04729764 0.1547516
odtworzone -7.098687 0.04729764 0.1547516
        A         B
 9.083976 17.675670
                             R                      SimDesign
"R version 4.5.3 (2026-03-11)"                         "2.28"
                           RNG                         ziarna
"Mersenne-Twister / Inversion"                  "34001–34012"
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia przepisów 1–2 w R 4.5.3 z pakietem SimDesign; rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- SimDesign (wersja 2.28): Chalmers, R. P., & Adkins, M. C. (2020). Writing effective and reliable Monte Carlo simulations with the SimDesign package. The Quantitative Methods for Psychology, 16(4), 248–280. https://doi.org/10.20982/tqmp.16.4.p248
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy w badaniach symulacyjnych
- Liczba powtórzeń „z sufitu”. 1000 powtórzeń to zwyczaj, nie uzasadnienie. Wylicz R z wymaganego MCSE i podaj MCSE przy wynikach.
- Moc bez błędu I rodzaju. Metoda liberalna zawsze „wygra” na mocy. Najpierw sprawdź warunek z efektem zerowym.
- Warunki tylko korzystne dla nowej metody. Ustal w protokole także warunki, w których metoda może zawieść.
- Jedno ziarno na całą symulację. Utrudnia odtworzenie pojedynczego powtórzenia i obliczenia równoległe.
- Pominięte nieudane powtórzenia. Jeśli model się nie zbiega albo zwraca błąd, raportuj, ile takich powtórzeń było i co z nimi zrobiono.
- Same tabele bez kodu. Bez skryptu nikt nie sprawdzi, czy wniosek nie wynika z błędu w kodzie.
Najczęstsze pytania
Co oznacza skrót ADEMP w badaniach symulacyjnych?
To pięć elementów planu i raportu symulacji według Morrisa i in. (2019): cele (Aims), mechanizm generowania danych (Data-generating mechanisms), estymandy (Estimands), metody (Methods) i miary jakości (Performance measures). Siepe i in. (2024) przygotowali na tej podstawie szablon ADEMP-PreReg do prerejestracji symulacji w psychologii.
Ile powtórzeń potrzeba w badaniu symulacyjnym?
Wylicz je z błędu Monte Carlo, który uznasz za wystarczający. Dla odsetka (błąd I rodzaju, moc, pokrycie) R = p(1 − p)/MCSE². Błąd I rodzaju .05 z MCSE .005 wymaga 1900 powtórzeń, a moc .50 z MCSE .010 – 2500. Obciążenie zwykle wymaga więcej, bo jego MCSE to empiryczny SE podzielony przez √R.
Jak policzyć błąd Monte Carlo dla obciążenia i pokrycia?
MCSE obciążenia to odchylenie standardowe oszacowań z powtórzeń podzielone przez √R. MCSE pokrycia, błędu I rodzaju i mocy to √(p̂(1 − p̂)/R). Wzory dla pozostałych miar, np. MSE i względnego błędu SE, podają Morris i in. (2019).
Czy badanie symulacyjne warto prerejestrować?
Tak, zwłaszcza gdy porównujesz własną metodę z innymi. Wybór warunków i miar po obejrzeniu wyników może sprawić, że ulubiona metoda wypadnie lepiej, niż powinna. Protokół według ADEMP (np. szablon ADEMP-PreReg) złożony przed uruchomieniem pełnej symulacji oddziela plan od eksploracji.
SimDesign czy własna pętla w R – co wybrać do symulacji?
Logika jest ta sama: tabela warunków, funkcja generująca dane, funkcja analizy i podsumowanie powtórzeń. Własna pętla wystarczy w prostych projektach. SimDesign (Chalmers i Adkins, 2020) dokłada obsługę błędów, osobne ziarna dla warunków, zapis stanów generatora i obliczenia równoległe, co ułatwia odtwarzanie i szukanie błędów.
Powiązane hasła
Przeczytaj też
Analiza mocy dla modelu mieszanego
Własna pętla symulacyjna w lme4: parametry z pilotażu, siatka osób i prób, krzywa mocy, błąd Monte Carlo i analiza wrażliwości.
Czytaj →PoradnikLiczebność próby do SEM – symulacja Monte Carlo
Model populacyjny, simulateData() i pętla w lavaan: moc dla wybranej ścieżki, zbieżność, rozwiązania niewłaściwe, krzywa mocy i wzór opisu.
Czytaj →PoradnikPakiet replikacyjny: dane i kod do artykułu
Struktura folderów, README, książka kodowa, skrypty R działające od zera, anonimizacja i RODO, licencje, OSF i deklaracja dostępności danych + szablon ZIP.
Czytaj →Planujesz symulację do artykułu metodologicznego albo recenzent pyta o jej szczegóły?
Pomożemy ułożyć protokół ADEMP, dobrać liczbę powtórzeń, sprawdzić kod i opisać wyniki z błędem Monte Carlo tak, żebyś mógł(a) samodzielnie uzasadnić każdą decyzję przed recenzentami.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Burton, A., Altman, D. G., Royston, P., & Holder, R. L. (2006). The design of simulation studies in medical statistics. Statistics in Medicine, 25(24), 4279–4292. https://doi.org/10.1002/sim.2673
- Chalmers, R. P., & Adkins, M. C. (2020). Writing effective and reliable Monte Carlo simulations with the SimDesign package. The Quantitative Methods for Psychology, 16(4), 248–280. https://doi.org/10.20982/tqmp.16.4.p248 ● Otwarty dostęp
- Delacre, M., Lakens, D., & Leys, C. (2017). Why psychologists should by default use Welch's t-test instead of Student's t-test. International Review of Social Psychology, 30(1), 92–101. https://doi.org/10.5334/irsp.82 ● Otwarty dostęp
- Morris, T. P., White, I. R., & Crowther, M. J. (2019). Using simulation studies to evaluate statistical methods. Statistics in Medicine, 38(11), 2074–2102. https://doi.org/10.1002/sim.8086 ● Otwarty dostęp
- Nosek, B. A., Ebersole, C. R., DeHaven, A. C., & Mellor, D. T. (2018). The preregistration revolution. Proceedings of the National Academy of Sciences, 115(11), 2600–2606. https://doi.org/10.1073/pnas.1708274114 ● Otwarty dostęp: pełny tekst
- Siepe, B. S., Bartoš, F., Morris, T. P., Boulesteix, A.-L., Heck, D. W., & Pawel, S. (2024). Simulation studies for methodological research in psychology: A standardized template for planning, preregistration, and reporting. Psychological Methods. https://doi.org/10.1037/met0000695 ● Otwarty dostęp: pełny tekst
- Wilson, G., Bryan, J., Cranston, K., Kitzes, J., Nederbragt, L., & Teal, T. K. (2017). Good enough practices in scientific computing. PLOS Computational Biology, 13(6), Article e1005510. https://doi.org/10.1371/journal.pcbi.1005510 ● Otwarty dostęp
- Zimmerman, D. W. (2004). A note on preliminary tests of equality of variances. British Journal of Mathematical and Statistical Psychology, 57(1), 173–181. https://doi.org/10.1348/000711004849222
Cytowania BibTeX
@article{burton2006design, author={Burton, Andrea and Altman, Douglas G. and Royston, Patrick and Holder, Roger L.}, title={{The design of simulation studies in medical statistics}}, journal={Statistics in Medicine}, year={2006}, volume={25}, number={24}, pages={4279--4292}, doi={10.1002/sim.2673}}@article{chalmers2020writing, author={Chalmers, R. Philip and Adkins, Mark C.}, title={{Writing effective and reliable Monte Carlo simulations with the SimDesign package}}, journal={The Quantitative Methods for Psychology}, year={2020}, volume={16}, number={4}, pages={248--280}, doi={10.20982/tqmp.16.4.p248}}@article{delacre2017why, author={Delacre, Marie and Lakens, Daniël and Leys, Christophe}, title={{Why psychologists should by default use Welch's t-test instead of Student's t-test}}, journal={International Review of Social Psychology}, year={2017}, volume={30}, number={1}, pages={92--101}, doi={10.5334/irsp.82}}@article{morris2019using, author={Morris, Tim P. and White, Ian R. and Crowther, Michael J.}, title={{Using simulation studies to evaluate statistical methods}}, journal={Statistics in Medicine}, year={2019}, volume={38}, number={11}, pages={2074--2102}, doi={10.1002/sim.8086}}@article{nosek2018preregistration, author={Nosek, Brian A. and Ebersole, Charles R. and DeHaven, Alexander C. and Mellor, David T.}, title={{The preregistration revolution}}, journal={Proceedings of the National Academy of Sciences}, year={2018}, volume={115}, number={11}, pages={2600--2606}, doi={10.1073/pnas.1708274114}}@article{siepe2024simulation, author={Siepe, Björn S. and Bartoš, František and Morris, Tim P. and Boulesteix, Anne-Laure and Heck, Daniel W. and Pawel, Samuel}, title={{Simulation studies for methodological research in psychology: A standardized template for planning, preregistration, and reporting}}, journal={Psychological Methods}, year={2024}, doi={10.1037/met0000695}}@article{wilson2017good, author={Wilson, Greg and Bryan, Jennifer and Cranston, Karen and Kitzes, Justin and Nederbragt, Lex and Teal, Tracy K.}, title={{Good enough practices in scientific computing}}, journal={PLOS Computational Biology}, year={2017}, volume={13}, number={6}, eid={e1005510}, doi={10.1371/journal.pcbi.1005510}}@article{zimmerman2004note, author={Zimmerman, Donald W.}, title={{A note on preliminary tests of equality of variances}}, journal={British Journal of Mathematical and Statistical Psychology}, year={2004}, volume={57}, number={1}, pages={173--181}, doi={10.1348/000711004849222}}