Co to są miary błędu prognozy?
Miary błędu prognozy podsumowują różnice e = y − ŷ między obserwacjami a prognozami w jedną liczbę. Trzy najczęstsze:
- MAE (średni błąd bezwzględny) = średnia |e| – w jednostkach zmiennej;
- RMSE (pierwiastek błędu średniokwadratowego) = √(średnia e²) – też w jednostkach zmiennej, ale silniej karze duże błędy, więc RMSE ≥ MAE;
- MAPE (średni bezwzględny błąd procentowy) = 100 · średnia |e/y| – w procentach, więc pozwala porównać szeregi o różnej skali.
Willmott i Matsuura (2005) zalecają MAE, bo RMSE zależy też od zmienności błędów i liczby obserwacji. Chai i Draxler (2014) odpowiadają, że RMSE lepiej pasuje przy błędach o rozkładzie normalnym, i radzą podawać kilka miar. Nie myl tych miar z błędem standardowym (precyzja estymatora) ani z RMSEA (dopasowanie modelu SEM).
Przykład
Na 48 symulowanych miesiącach z sezonowością prognozowano ostatnie 12. Prognoza sezonowa naiwna (wartość sprzed roku) miała MAE = 3.80, RMSE = 4.66 i MAPE = 8.29%; prognoza średnią z okresu uczącego – MAE = 7.23, RMSE = 8.07 i MAPE = 14.87%. Gdy obserwacje wynoszą 0.5, 20 i 30, a każda prognoza jest o 2 za wysoka, MAE = 2.0, ale MAPE = 138.9% – sama pierwsza obserwacja wnosi 400%.
Na rysunku
Rysunek pokazuje dwie sytuacje, w których wybór miary zmienia wniosek: dwie prognozy o innym układzie błędów (A) i MAPE przy wartości bliskiej zera (B).
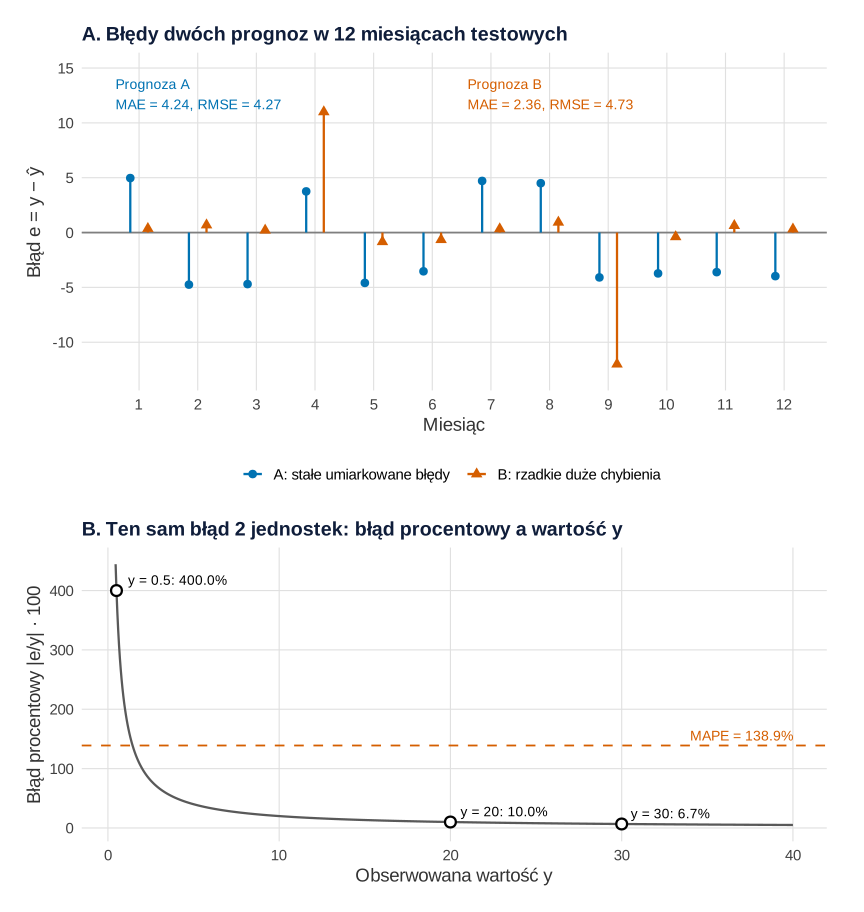
set.seed(6361)).Co widać. W panelu A prognoza A myli się co miesiąc o 3–5 jednostek, a prognoza B prawie zawsze trafia, ale dwa razy wyraźnie chybia. MAE wskazuje B jako lepszą (2.36 wobec 4.24), MAPE także (4.64% wobec 8.32%). RMSE odwraca ranking (4.73 wobec 4.27), bo podnosi błędy do kwadratu i dwa chybienia ważą w nim najwięcej. Która prognoza jest lepsza, zależy więc od tego, czy rzadki duży błąd kosztuje więcej niż częste małe. Parametry błędów ustawiono ręcznie, żeby rozbieżność była wyraźna; ziarna nie zmieniano. Panel B rysuje przykład z hasła: przy tym samym błędzie 2 jednostek błąd procentowy wynosi 400% dla y = 0.5, a 10% i 6.7% dla y = 20 i 30. Jedna mała obserwacja podnosi MAPE do 138.9%.
Na co uważać. Rysunek nie mówi, która miara jest „prawdziwa”. Każda odpowiada na inne pytanie, dlatego warto podać co najmniej dwie i porównać je z prostą prognozą odniesienia (np. przez MASE). Przy 12 punktach testowych o RMSE mogą przesądzić jeden lub dwa miesiące, więc jedna różnica w tabeli nie przesądza o wyższości metody. Wykres błędów w czasie pokazuje też coś, czego żadna miara nie oddaje: czy błędy mają stały znak, czyli czy prognoza jest systematycznie za wysoka. Forma rysunku to wykres lizakowy.
Podpis do pracy:
Kod jest samowystarczalny: prosty motyw i paletę definiuje sam, a jedyny losujący blok zaczyna się od set.seed(6361). Rysunek na stronie powstał z tego samego obiektu p z motywem serwisu – dane, geometrie i skale są identyczne, różni się tylko krój czcionki.
Kod R rysunku
# Rysunek 1. MAE a RMSE dla dwóch prognoz tego samego szeregu (A) i MAPE przy wartościach bliskich zera (B)
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito i prosty motyw
kol <- c("A: stałe umiarkowane błędy" = "#0072B2", "B: rzadkie duże chybienia" = "#D55E00")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA))

# 12 miesięcy testowych i dwie prognozy (dane symulowane). Parametry błędów ustawiono ręcznie:
# prognoza A myli się w każdym miesiącu o 3–5 jednostek, prognoza B zwykle prawie trafia,
# ale w miesiącach 4 i 9 chybia o 11 i 12 jednostek; ziarna nie zmieniano.
set.seed(6361)
obs <- 50 + 10 * sin(2 * pi * (1:12) / 12) + rnorm(12, sd = 3)
bladA <- sample(c(-1, 1), 12, replace = TRUE) * runif(12, 3, 5)
bladB <- rnorm(12, sd = 0.8); bladB[c(4, 9)] <- c(11, -12)
miary <- function(e, y) c(MAE = mean(abs(e)), RMSE = sqrt(mean(e^2)), MAPE = 100 * mean(abs(e / y)))
tab <- round(rbind(A = miary(bladA, obs), B = miary(bladB, obs)), 2)
tab

# Panel B: ten sam błąd bezwzględny (2 jednostki) przy obserwacjach 0.5, 20 i 30 jak w przykładzie hasła
obs0 <- c(0.5, 20, 30)
bp <- 100 * 2 / obs0                           # błąd procentowy każdej obserwacji
round(c(bp, MAPE = mean(bp)), 1)

bledy <- rbind(data.frame(m = 1:12 - 0.15, e = bladA, prognoza = names(kol)[1]),
               data.frame(m = 1:12 + 0.15, e = bladB, prognoza = names(kol)[2]))
etyk <- data.frame(prognoza = names(kol), x = c(0.6, 6.6), y = 14,
                   tekst = sprintf("%s\nMAE = %.2f, RMSE = %.2f", c("Prognoza A", "Prognoza B"), tab[, "MAE"], tab[, "RMSE"]))
pA <- ggplot(bledy, aes(m, e, colour = prognoza, shape = prognoza)) +
  geom_hline(yintercept = 0, colour = "grey50") +
  geom_segment(aes(xend = m, yend = 0), linewidth = 0.8) +
  geom_point(size = 2.6) +
  geom_text(data = etyk, aes(x, y, label = tekst), hjust = 0, vjust = 1, size = 3.7, show.legend = FALSE) +
  scale_colour_manual(values = kol, name = NULL) +
  scale_shape_manual(values = c(16, 17), name = NULL) +
  scale_x_continuous(breaks = 1:12) +
  scale_y_continuous(limits = c(-13, 15)) +
  labs(title = "A. Błędy dwóch prognoz w 12 miesiącach testowych", x = "Miesiąc", y = "Błąd e = y − ŷ") +
  motyw

krzywa <- data.frame(y = seq(0.45, 40, by = 0.05))
krzywa$bp <- 100 * 2 / krzywa$y
punkty <- data.frame(y = obs0, bp = bp, tekst = sprintf("y = %s: %.1f%%", obs0, bp))
pB <- ggplot(krzywa, aes(y, bp)) +
  geom_line(colour = "grey35", linewidth = 0.8) +
  geom_hline(yintercept = mean(bp), linetype = "dashed", colour = "#D55E00") +
  annotate("text", x = 40, y = mean(bp), label = sprintf("MAPE = %.1f%%", mean(bp)), hjust = 1, vjust = -0.5,
           size = 3.7, colour = "#D55E00") +
  geom_point(data = punkty, shape = 21, fill = "white", size = 3, stroke = 1.2) +
  geom_text(data = punkty, aes(label = tekst), hjust = -0.12, vjust = -0.6, size = 3.6) +
  scale_y_continuous(limits = c(0, 450)) +
  labs(title = "B. Ten sam błąd 2 jednostek: błąd procentowy a wartość y", x = "Obserwowana wartość y",
       y = "Błąd procentowy |e/y| · 100") +
  motyw

p <- pA / pB + plot_layout(heights = c(1.15, 1))
p
Wynik w R
   MAE RMSE MAPE
A 4.24 4.27 8.32
B 2.36 4.73 4.64
                   MAPE
400.0  10.0   6.7 138.9
Jak opisać w pracy
Na co uważać
- MAPE przy zerach. Dla y = 0 MAPE jest nieokreślone, a przy wartościach bliskich zera eksploduje. Hyndman i Koehler (2006) wskazują, że wiele popularnych miar w typowych sytuacjach zawodzi, i proponują MASE: MAE podzielone przez MAE prognozy naiwnej w próbie uczącej.
- Licz błędy na danych odłożonych (walidacja), nie na dopasowaniu – inaczej nagradzasz przeuczenie.
- RMSE jest wrażliwe na obserwacje odstające; MAE mniej.
- Porównuj z prostą prognozą, np. naiwną albo z wygładzania wykładniczego.
Miary błędu prognozy w R
Kod liczy MAE, RMSE, MAPE i MASE ręcznie dla dwóch prognoz, sprawdza wynik funkcją accuracy() z pakietu forecast i pokazuje zachowanie MAPE przy wartości bliskiej zera. Liczby w tekście pochodzą z tego kodu.
MAE, RMSE, MAPE i MASE ręcznie i funkcją accuracy()
R
suppressMessages(library(forecast))
set.seed(636)
y <- 50 + 10 * sin(2 * pi * (1:48) / 12) + rnorm(48, sd = 3)   # 4 lata danych miesięcznych
ucz <- ts(y[1:36], frequency = 12); obs <- y[37:48]
p_snaive <- y[25:36]                            # prognoza sezonowa naiwna: wartość sprzed roku
p_sr     <- rep(mean(y[1:36]), 12)              # prognoza: średnia z okresu uczącego
e1 <- obs - p_snaive; e2 <- obs - p_sr
skala <- mean(abs(diff(y[1:36], lag = 12)))     # MAE sezonowej prognozy naiwnej w próbie uczącej
miary <- function(e) c(MAE = mean(abs(e)), RMSE = sqrt(mean(e^2)),
                       MAPE = 100 * mean(abs(e / obs)), MASE = mean(abs(e)) / skala)
round(rbind(sezonowa_naiwna = miary(e1), srednia = miary(e2)), 2)
round(accuracy(snaive(ucz, h = 12), ts(obs, start = c(4, 1), frequency = 12))["Test set", c("MAE", "RMSE", "MAPE", "MASE")], 2)  # kontrola
# MAPE przy wartościach bliskich zera: ten sam błąd bezwzględny, inne obserwacje
obs0 <- c(0.5, 20, 30); p0 <- obs0 + 2
round(c(MAE = mean(abs(obs0 - p0)), MAPE = 100 * mean(abs((obs0 - p0) / obs0))), 1)
Wynik w R
                 MAE RMSE  MAPE MASE
sezonowa_naiwna 3.80 4.66  8.29 1.03
srednia         7.23 8.07 14.87 1.97
 MAE RMSE MAPE MASE
3.80 4.66 8.29 1.03
  MAE  MAPE
  2.0 138.9
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietem forecast 9.0.2. Rysunek 1 wykonano w pakietach ggplot2 i patchwork i zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- forecast (wersja 9.0.2): Hyndman, R., Athanasopoulos, G., Bergmeir, C., Caceres, G., Chhay, L., O’Hara-Wild, M., Petropoulos, F., Razbash, S., Wang, E., & Yasmeen, F. (2026). forecast: Forecasting functions for time series and linear models (R package version 9.0.2) [Computer software]. https://doi.org/10.32614/CRAN.package.forecast
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czy RMSE zawsze jest większe od MAE?
RMSE nigdy nie jest mniejsze od MAE; obie miary są równe tylko wtedy, gdy wszystkie błędy mają tę samą wartość bezwzględną. Im większa przewaga RMSE nad MAE, tym bardziej błędy różnią się wielkością, np. przez kilka dużych pomyłek.
Czego użyć zamiast MAPE, gdy w danych są zera?
Najprościej MAE, jeśli porównujesz prognozy jednego szeregu. Do porównań między szeregami o różnej skali Hyndman i Koehler (2006) zalecają MASE, czyli MAE odniesione do błędu prostej prognozy naiwnej. MASE poniżej 1 oznacza prognozę trafniejszą od tej punktu odniesienia.
Którą miarę błędu prognozy podać w pracy?
Najlepiej co najmniej dwie, np. MAE i RMSE, liczone na danych nieużytych do estymacji, wraz z wynikiem prostej prognozy porównawczej. MAPE dodaj tylko wtedy, gdy wartości są wyraźnie dodatnie i dalekie od zera.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Modele predykcyjne: walidacja i kalibracja
Liczebność, przeuczenie, walidacja krzyżowa i bootstrap, LASSO i ridge, kalibracja, wynik Briera i TRIPOD+AI – na danych do pobrania, z kodem R.
Czytaj →PoradnikPrognoza sprzedaży: sezonowość, święta i promocje
Sklep z zabawkami, trzy lata dziennych zamówień: STL, ETS i ARIMA z regresorami, MAE i MAPE na teście, przeciek danych i prognoza z przedziałami w R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Chai, T., & Draxler, R. R. (2014). Root mean square error (RMSE) or mean absolute error (MAE)? – Arguments against avoiding RMSE in the literature. Geoscientific Model Development, 7(3), 1247–1250. https://doi.org/10.5194/gmd-7-1247-2014 ● Otwarty dostęp
- Hyndman, R. J., & Koehler, A. B. (2006). Another look at measures of forecast accuracy. International Journal of Forecasting, 22(4), 679–688. https://doi.org/10.1016/j.ijforecast.2006.03.001 ● Otwarty dostęp: pełny tekst
- Willmott, C. J., & Matsuura, K. (2005). Advantages of the mean absolute error (MAE) over the root mean square error (RMSE) in assessing average model performance. Climate Research, 30, 79–82. https://doi.org/10.3354/cr030079 ● Otwarty dostęp
Cytowania BibTeX
@article{chai2014root, author={Chai, T. and Draxler, R. R.}, title={{Root mean square error (RMSE) or mean absolute error (MAE)? – Arguments against avoiding RMSE in the literature}}, journal={Geoscientific Model Development}, year={2014}, volume={7}, number={3}, pages={1247--1250}, doi={10.5194/gmd-7-1247-2014}}@article{hyndman2006another, author={Hyndman, Rob J. and Koehler, Anne B.}, title={{Another look at measures of forecast accuracy}}, journal={International Journal of Forecasting}, year={2006}, volume={22}, number={4}, pages={679--688}, doi={10.1016/j.ijforecast.2006.03.001}}@article{willmott2005advantages, author={Willmott, Cort J. and Matsuura, Kenji}, title={{Advantages of the mean absolute error (MAE) over the root mean square error (RMSE) in assessing average model performance}}, journal={Climate Research}, year={2005}, volume={30}, pages={79--82}, doi={10.3354/cr030079}}