Co to jest wygładzanie wykładnicze?
Wygładzanie wykładnicze prognozuje kolejną wartość szeregu czasowego jako średnią ważoną przeszłych obserwacji, w której wagi maleją wykładniczo z wiekiem obserwacji. Tym różni się od średniej ruchomej, która daje jednakowe wagi kilku ostatnim wartościom.
- Proste wygładzanie (SES) ma jeden parametr α (0–1) dla poziomu: im bliżej 1, tym silniej prognoza reaguje na ostatnią obserwację.
- Metoda Holta dodaje parametr β dla trendu.
- Metoda Holta–Wintersa dodaje parametr γ dla sezonowości (Winters, 1960) – addytywnej (stała amplituda) albo multiplikatywnej (amplituda rośnie z poziomem).
W przeglądzie Gardnera (1985) dane empiryczne przemawiały za metodą Holta dla trendu i za Holtem–Wintersem dla danych sezonowych, z zastrzeżeniem, że trend warto tłumić przy długich horyzontach.
Przykład
Dane AirPassengers (miesięczna liczba pasażerów, tys., 1949–1960) zlogarytmowano, aby sezonowość multiplikatywna stała się addytywna (transformacja logarytmiczna). Model dopasowany do lat 1949–1959 dał α = 0.339, β = 0.007 i γ = 0.850. Prognoza na 1960 r. miała średni błąd bezwzględny 17.4 tys. pasażerów (MAPE = 3.6%). Proste wygładzanie (α = 1.000, czyli powtarzanie ostatniej wartości) dało MAE = 76.0 i MAPE = 14.3% – zob. miary błędu prognozy.
Na rysunku
Rysunek pokazuje model z przykładu: ostatnie lata danych uczących z dopasowaniem, prognozę na 1960 r. i to, jak szybko model „zapomina” starsze obserwacje.
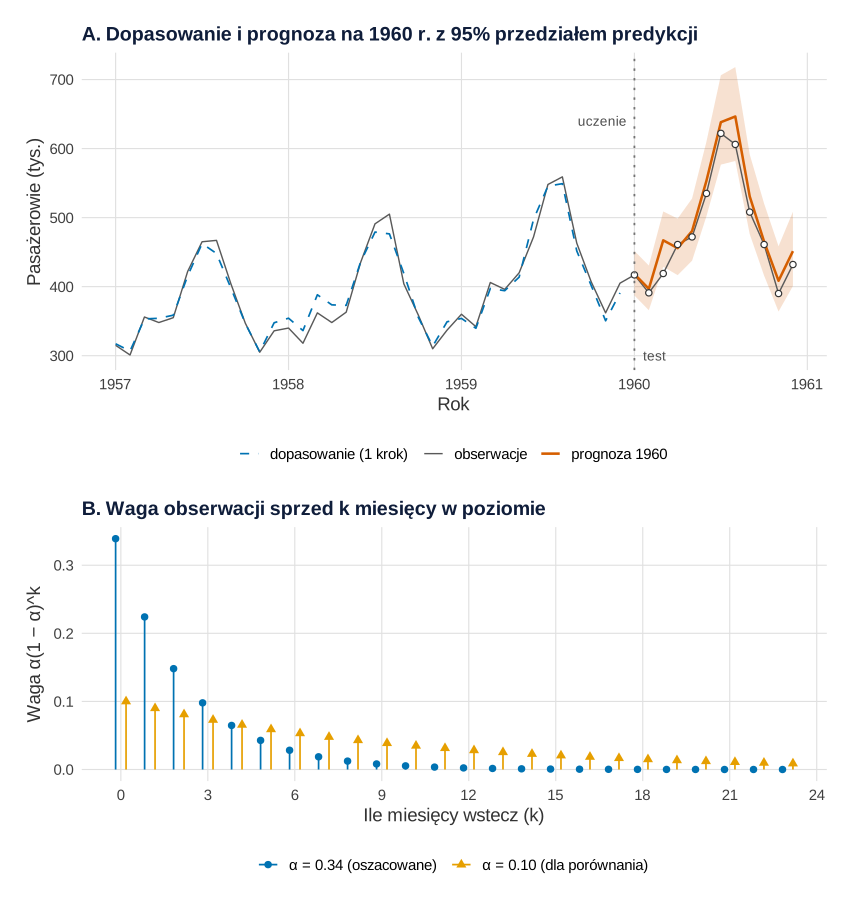
AirPassengers: dopasowanie, prognoza na 1960 r. z 95% przedziałem predykcji (A) i wagi obserwacji w równaniu poziomu (B). Obliczenia: R, pakiety stats, ggplot2 i patchwork (dane wbudowane).Co widać. W panelu A przerywana linia dopasowania o jeden krok prawie pokrywa się z obserwacjami, bo model w każdym miesiącu poprawia się o świeżą wartość. Prognoza na 1960 r. powtarza kształt sezonu, a pasmo przedziału predykcji rośnie z horyzontem: ze 65 tys. w styczniu do 108 tys. w grudniu. W paśmie mieści się 11 z 12 obserwacji. Panel B tłumaczy nazwę metody. Przy oszacowanym α = 0.34 ostatnie 12 miesięcy dostaje łącznie 99.3% wagi w równaniu poziomu, a przy α = 0.10 – tylko 71.8%. Wartość α = 0.10 dobrano ręcznie, wyłącznie dla porównania.
Na co uważać. Wagi w panelu B opisują tylko poziom (po usunięciu sezonowości); trend i sezonowość mają własne parametry β i γ. Przedział predykcji z predict() zakłada, że model jest poprawny i błędy mają stałą wariancję na skali logarytmicznej. Nie uwzględnia niepewności oszacowań α, β i γ, więc bywa zbyt wąski. Na rysunku prognoza leży zwykle nieco powyżej obserwacji z 1960 r.; przy długim horyzoncie takie przestrzelenie trendu może narastać, stąd rada Gardnera (1985) o tłumieniu trendu. Pasmo predykcji to co innego niż pasmo ufności dla średniej – różnicę opisuje hasło pasmo ufności i pasmo predykcji.
Podpis do pracy:
Kod używa danych wbudowanych w R, więc nic nie jest losowane. Jest samowystarczalny: prosty motyw i paletę definiuje sam. Rysunek na stronie powstał z tego samego obiektu p z motywem serwisu – dane, geometrie i skale są identyczne, różni się tylko krój czcionki.
Kod R rysunku
# Rysunek 1. Holt–Winters dla AirPassengers: dopasowanie, prognoza na 1960 r. z 95% przedziałem predykcji i wagi wygładzania
# Dane wbudowane w R – nic tu nie jest losowane
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito i prosty motyw
kol <- c("obserwacje" = "grey35", "dopasowanie (1 krok)" = "#0072B2", "prognoza 1960" = "#D55E00")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA))

# Model jak w przykładzie hasła: log(AirPassengers), uczenie 1949–1959, test 1960
y <- log(AirPassengers)
ucz <- window(y, end = c(1959, 12))
hw <- HoltWinters(ucz)
pr <- predict(hw, n.ahead = 12, prediction.interval = TRUE, level = 0.95)   # na skali log

czas <- function(x) as.numeric(time(x))
obs <- data.frame(t = czas(AirPassengers), y = as.numeric(AirPassengers))
obs <- obs[obs$t >= 1957, ]                      # panel A: lata 1957–1960 (model uczony na 1949–1959)
dop <- data.frame(t = czas(hw$fitted), y = exp(as.numeric(hw$fitted[, "xhat"])))
dop <- dop[dop$t >= 1957, ]
prog <- data.frame(t = czas(pr), fit = exp(as.numeric(pr[, "fit"])), lo = exp(as.numeric(pr[, "lwr"])), hi = exp(as.numeric(pr[, "upr"])),
                   obs = as.numeric(window(AirPassengers, start = c(1960, 1))))

# Ile z 12 obserwacji 1960 r. mieści się w 95% przedziale predykcji i jak szeroki jest przedział
prog$w_przedziale <- prog$obs >= prog$lo & prog$obs <= prog$hi
c(w_przedziale = sum(prog$w_przedziale), z = nrow(prog))
round(data.frame(miesiac = c(1, 12), prognoza = prog$fit[c(1, 12)], dolna = prog$lo[c(1, 12)],
                 gorna = prog$hi[c(1, 12)], szerokosc = (prog$hi - prog$lo)[c(1, 12)]), 0)

# Wagi poziomu: obserwacja sprzed k okresów dostaje wagę alfa · (1 − alfa)^k
alfa <- unname(hw$alpha)
wagi <- rbind(data.frame(k = 0:23, waga = alfa * (1 - alfa)^(0:23), model = sprintf("α = %.2f (oszacowane)", alfa), x = 0:23 - 0.18),
              data.frame(k = 0:23, waga = 0.1 * 0.9^(0:23), model = "α = 0.10 (dla porównania)", x = 0:23 + 0.18))
wagi$model <- factor(wagi$model, levels = unique(wagi$model))
round(c(alfa = alfa, suma_wag_12_ost = 1 - (1 - alfa)^12, suma_wag_12_ost_alfa01 = 1 - 0.9^12), 3)

pA <- ggplot() +
  geom_ribbon(data = prog, aes(t, ymin = lo, ymax = hi), fill = "#D55E00", alpha = 0.18) +
  geom_line(data = obs, aes(t, y, colour = "obserwacje", linetype = "obserwacje"), linewidth = 0.5) +
  geom_line(data = dop, aes(t, y, colour = "dopasowanie (1 krok)", linetype = "dopasowanie (1 krok)"), linewidth = 0.6) +
  geom_line(data = prog, aes(t, fit, colour = "prognoza 1960", linetype = "prognoza 1960"), linewidth = 0.9) +
  geom_point(data = prog, aes(t, obs), shape = 21, fill = "white", colour = "grey20", size = 1.8) +
  geom_vline(xintercept = 1960, colour = "grey45", linetype = "dotted") +
  annotate("text", x = 1959.95, y = 640, label = "uczenie  ", hjust = 1, size = 3.6, colour = "grey30") +
  annotate("text", x = 1960.05, y = 300, label = "test", hjust = 0, size = 3.6, colour = "grey30") +
  scale_colour_manual(values = kol, name = NULL) +
  scale_linetype_manual(values = c("obserwacje" = "solid", "dopasowanie (1 krok)" = "dashed", "prognoza 1960" = "solid"), name = NULL) +
  scale_x_continuous(breaks = 1957:1961) +
  labs(title = "A. Dopasowanie i prognoza na 1960 r. z 95% przedziałem predykcji", x = "Rok",
       y = "Pasażerowie (tys.)") +
  motyw

pB <- ggplot(wagi, aes(x, waga, colour = model, shape = model)) +
  geom_segment(aes(xend = x, yend = 0), linewidth = 0.6) +
  geom_point(size = 2.2) +
  scale_colour_manual(values = c("#0072B2", "#E69F00"), name = NULL) +
  scale_shape_manual(values = c(16, 17), name = NULL) +
  scale_x_continuous(breaks = seq(0, 24, 3)) +
  labs(title = "B. Waga obserwacji sprzed k miesięcy w poziomie",
       x = "Ile miesięcy wstecz (k)", y = "Waga α(1 − α)^k") +
  motyw

p <- pA / pB + plot_layout(heights = c(1.25, 1))
p
Wynik w R
w_przedziale            z
          11           12
  miesiac prognoza dolna gorna szerokosc
1       1      418   387   452        65
2      12      451   401   508       108
                  alfa        suma_wag_12_ost suma_wag_12_ost_alfa01
                 0.339                  0.993                  0.718
Jak opisać w pracy
Na co uważać
- Oceniaj prognozy na danych odłożonych, a nie na dopasowaniu do próby uczącej – dopasowanie w próbie zawsze wygląda lepiej.
- Parametry bliskie 0 lub 1 to informacja: β ≈ 0 oznacza niemal stały trend, α ≈ 1 – szereg zbliżony do błądzenia losowego.
- Wariant dobieraj danymi, nie zwyczajem. Funkcja
ets()z pakietu forecast wybiera automatycznie spośród modeli przestrzeni stanów wygładzania wykładniczego (Hyndman i Khandakar, 2008); alternatywą jest ARIMA.
Holt–Winters w R
Kod dopasowuje model Holta–Wintersa i proste wygładzanie do lat 1949–1959, prognozuje 1960 r. i porównuje błędy. Liczby w tekście pochodzą z tego kodu.
Holt–Winters a proste wygładzanie wykładnicze
R
set.seed(635)                                   # dane wbudowane; ziarno tylko dla porządku
y <- log(AirPassengers)                         # log: sezonowość addytywna
ucz <- window(y, end = c(1959, 12)); test <- window(y, start = c(1960, 1))
hw  <- HoltWinters(ucz)                          # alfa, beta, gamma szacowane z SSE prognoz o 1 krok
ses <- HoltWinters(ucz, beta = FALSE, gamma = FALSE)   # proste wygładzanie wykładnicze
round(c(alfa = unname(hw$alpha), beta = unname(hw$beta), gamma = unname(hw$gamma), alfa_SES = unname(ses$alpha)), 3)
p_hw  <- exp(predict(hw, n.ahead = 12))         # prognoza na 1960 r. w pasażerach (tys.)
p_ses <- exp(predict(ses, n.ahead = 12))
obs <- exp(test)
mae  <- function(p) mean(abs(obs - p))
mape <- function(p) 100 * mean(abs((obs - p) / obs))
data.frame(metoda = c("Holt-Winters", "proste (SES)"),
           MAE = round(c(mae(p_hw), mae(p_ses)), 1), MAPE = round(c(mape(p_hw), mape(p_ses)), 1))
round(cbind(miesiac = 1:12, obs = obs, HW = p_hw), 0)[c(1, 6, 7, 12), ]
Wynik w R
    alfa     beta    gamma alfa_SES
   0.339    0.007    0.850    1.000
        metoda  MAE MAPE
1 Holt-Winters 17.4  3.6
2 proste (SES) 76.0 14.3
     miesiac obs  HW
[1,]       1 417 418
[2,]       6 535 553
[3,]       7 622 638
[4,]      12 432 451
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (bazowy pakiet stats). Rysunek 1 wykonano w pakietach ggplot2 i patchwork i zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czym wygładzanie wykładnicze różni się od średniej ruchomej?
Średnia ruchoma daje jednakowe wagi kilku obserwacjom w oknie i pomija starsze. Wygładzanie wykładnicze uwzględnia całą historię, ale z wagami malejącymi wykładniczo, więc nie trzeba wybierać szerokości okna – rolę tę pełni parametr α.
Kiedy wybrać sezonowość multiplikatywną w metodzie Holta–Wintersa?
Gdy wahania sezonowe rosną wraz z poziomem szeregu, np. szczyt wakacyjny jest tym wyższy, im więcej pasażerów jest średnio. Przy stałej amplitudzie wahań wystarczy wariant addytywny. Alternatywą jest wariant addytywny na zlogarytmowanych danych.
Czy wybrać metodę Holta–Wintersa, czy model ARIMA?
Obie rodziny często dają podobne prognozy. Wygładzanie wykładnicze jest łatwiejsze do wyjaśnienia (poziom, trend, sezon), ARIMA lepiej opisuje złożoną autokorelację. Rozstrzygnij porównaniem błędów prognoz na danych odłożonych, nie dopasowaniem do próby uczącej.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Szeregi czasowe i ARIMA w praktyce
Trend, sezonowość, ACF i test Ljunga–Boxa, wybór modelu ARIMA w stats::arima, prognoza kontrfaktyczna i regresja segmentowa z kodem R.
Czytaj →PoradnikPrognoza sprzedaży: sezonowość, święta i promocje
Sklep z zabawkami, trzy lata dziennych zamówień: STL, ETS i ARIMA z regresorami, MAE i MAPE na teście, przeciek danych i prognoza z przedziałami w R.
Czytaj →PoradnikPrognoza hierarchiczna i uzgadnianie MinT
Sieć 36 aptek: prognozy aptek, regionów i sieci, które się nie sumują, macierz S, od dołu, od góry i MinT ręcznie – z kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Gardner, E. S. (1985). Exponential smoothing: The state of the art. Journal of Forecasting, 4(1), 1–28. https://doi.org/10.1002/for.3980040103
- Hyndman, R. J., & Khandakar, Y. (2008). Automatic time series forecasting: The forecast package for R. Journal of Statistical Software, 27(3). https://doi.org/10.18637/jss.v027.i03 ● Otwarty dostęp
- Winters, P. R. (1960). Forecasting sales by exponentially weighted moving averages. Management Science, 6(3), 324–342. https://doi.org/10.1287/mnsc.6.3.324
Cytowania BibTeX
@article{gardner1985exponential, author={Gardner, Everette S.}, title={{Exponential smoothing: The state of the art}}, journal={Journal of Forecasting}, year={1985}, volume={4}, number={1}, pages={1--28}, doi={10.1002/for.3980040103}}@article{hyndman2008automatic, author={Hyndman, Rob J. and Khandakar, Yeasmin}, title={{Automatic time series forecasting: The forecast package for R}}, journal={Journal of Statistical Software}, year={2008}, volume={27}, number={3}, doi={10.18637/jss.v027.i03}}@article{winters1960forecasting, author={Winters, Peter R.}, title={{Forecasting sales by exponentially weighted moving averages}}, journal={Management Science}, year={1960}, volume={6}, number={3}, pages={324--342}, doi={10.1287/mnsc.6.3.324}}