Kiedy dane są szeregiem czasowym
O szeregu czasowym mówimy, gdy ta sama wielkość jest mierzona w równych odstępach czasu, a kolejność pomiarów ma znaczenie. Przykłady to miesięczna liczba zgłoszeń do poradni, dzienne oceny nastroju z dzienniczka albo tygodniowa liczba wejść na stronę z pomocą psychologiczną. Jebb i in. (2015) pokazują, że analiza szeregów czasowych pozwala opisać wzorzec zmian, efekty sezonowe i wpływ zdarzeń oraz prognozować. Zauważają też, że psycholodzy często nie mają przygotowania do analizy takich danych.
Ten wpis prowadzi przez cztery kroki: opis trendu i sezonowości, ocenę autokorelacji, dobór modelu ARIMA w stats::arima i ocenę interwencji jako przerwanego szeregu czasowego. Porównanie z grupą kontrolną (różnicę w różnicach) opisuje wpis o quasi-eksperymencie i DiD. Krótkie szeregi jednej osoby w fazach A i B omawia wpis o badaniu jednego przypadku.
Przykład: konsultacje w poradni akademickiej
Dane są symulowane. Akademicka poradnia psychologiczna liczy konsultacje w każdym miesiącu od stycznia 2016 do grudnia 2025 (120 miesięcy). W styczniu 2023 wprowadziła zapisy online. Pytanie brzmi: czy po tej zmianie konsultacji przybyło bardziej, niż wynikałoby z dotychczasowego trendu i rytmu roku akademickiego? Średnia miesięczna wzrosła ze 126.25 w 2016 roku do 168.92 w 2022 roku, a potem do 195.75 w 2023 i 218.75 w 2025 roku. Samo porównanie tych liczb niczego nie dowodzi, bo konsultacji przybywało także przed zmianą.
Krok 1. Trend i sezonowość
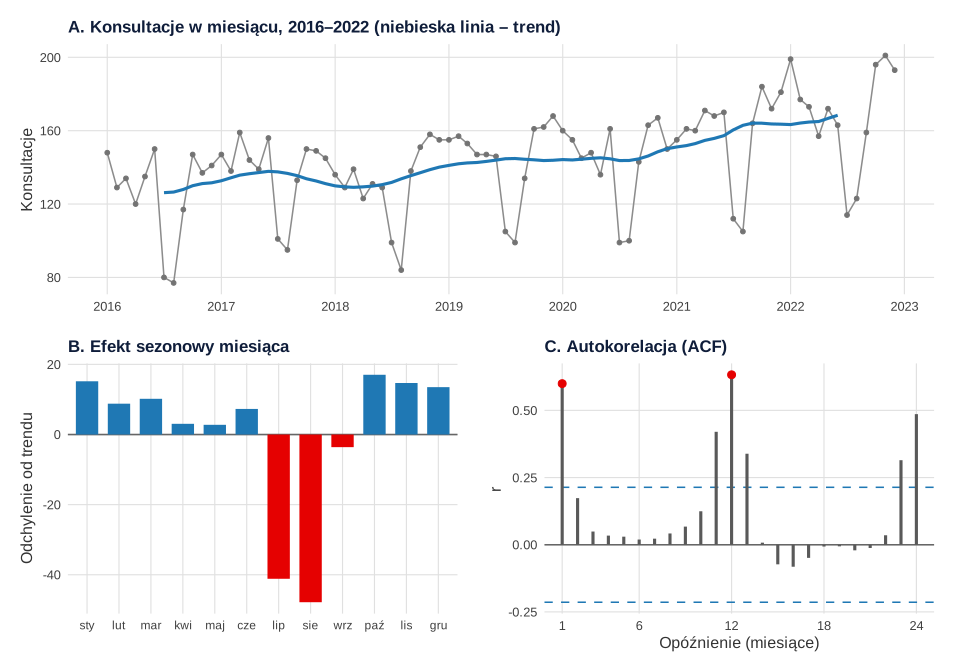
Zacznij od wykresu i dekompozycji okresu sprzed interwencji (84 miesiące). Klasyczna dekompozycja addytywna (decompose()) rozkłada szereg na trend (średnia ruchoma 2 × 12), stały profil sezonowy i resztę. W przykładzie trend rośnie ze 126.2 do 168.4 konsultacji. Sezonowość odpowiada rytmowi roku akademickiego: w lipcu jest o 41.1, a w sierpniu o 47.8 konsultacji mniej niż wynikałoby z trendu, w październiku o 17.0, a w styczniu o 15.2 więcej. Taki profil musi znaleźć się w modelu. Bez niego interwencja wprowadzona we wrześniu wyglądałaby na sukces tylko dlatego, że po wakacjach zawsze przybywa konsultacji.
Krok 2. Autokorelacja i stacjonarność
Autokorelacja to korelacja szeregu z nim samym przesuniętym o k okresów. Funkcja ACF pokazuje ją dla kolejnych opóźnień, a PACF – po usunięciu wpływu opóźnień pośrednich. W surowym szeregu r = .600 przy opóźnieniu 1 i r = .633 przy opóźnieniu 12, wyraźnie poza granicą ±.214. Test Ljunga–Boxa dla 24 opóźnień daje Q = 147.75, p < .001, więc wartości nie są niezależne. Ljung i Box (1978) zaproponowali tę statystykę jako poprawioną wersję ogólnego testu braku dopasowania modeli ARMA.
Wysoka autokorelacja przy opóźnieniu 1 wynika tu z dwóch źródeł: trendu i rzeczywistej zależności sąsiednich miesięcy. Szereg z trendem nie jest stacjonarny, a model ARMA wymaga stacjonarności. Są dwie drogi: różnicowanie albo uwzględnienie trendu i sezonowości w części regresyjnej modelu. Po różnicowaniu sezonowym (wynik minus wynik sprzed 12 miesięcy) ACF przy opóźnieniu 1 wynosi .499, a przy opóźnieniu 12 spada do −.447. Wyraźna ujemna autokorelacja przy opóźnieniu sezonowym to pierwszy sygnał, że różnicowanie mogło być zbyt silne.
Krok 3. Model ARIMA w stats::arima
Model ARIMA(p, d, q)(P, D, Q)12 łączy składnik autoregresyjny (AR, rząd p), różnicowanie (d) i średnią ruchomą błędów (MA, rząd q), a druga trójka to te same elementy dla opóźnień sezonowych. Pierwsza próba to model (1, 0, 0)(0, 1, 1)12 z dryfem. Współczynnik sezonowej średniej ruchomej wyszedł równy −1.000, czyli na granicy dopuszczalnych wartości. Taki wynik zwykle oznacza, że różnicowanie sezonowe było zbędne: profil sezonowy jest stały z roku na rok, więc lepiej opisać go zmiennymi zero-jedynkowymi dla miesięcy niż usuwać różnicowaniem.
Drugie podejście to regresja z błędami ARMA: trend liniowy i 11 zmiennych miesięcy w części regresyjnej (xreg), a zależność w czasie w składniku ARMA. Ponieważ część regresyjna jest we wszystkich modelach taka sama, ich kryteria informacyjne można porównać (zob. AIC i BIC).
| Błędy | AIC | BIC | ΔAIC |
|---|---|---|---|
| AR(2) | 613.06 | 651.95 | 0.00 |
| ARMA(1,1) | 613.93 | 652.83 | 0.87 |
| AR(1) | 615.50 | 651.97 | 2.44 |
| MA(1) | 621.35 | 657.81 | 8.29 |
| ARMA(0,0), czyli zwykła regresja | 629.80 | 663.83 | 16.74 |
AR(2) ma najniższe AIC i minimalnie niższe BIC niż AR(1). O wyborze rozstrzyga diagnostyka reszt. Po AR(1) test Ljunga–Boxa dla 24 opóźnień daje p = .042, więc w resztach zostaje zależność. Po AR(2) Q(22) = 22.49, p = .431 (stopnie swobody pomniejszone o dwa parametry ARMA). Współczynniki wynoszą φ1 = 0.331 (SE = 0.106) i φ2 = 0.234 (SE = 0.109), a trend to 0.553 konsultacji na miesiąc (SE = 0.075). Automatyczny dobór rzędów, krok po kroku, oferuje funkcja auto.arima() z pakietu forecast (Hyndman i Khandakar, 2008). Wynik automatu warto jednak sprawdzić tak samo jak model dobrany ręcznie.
Krok 4. Prognoza: czego oczekiwalibyśmy bez zmiany
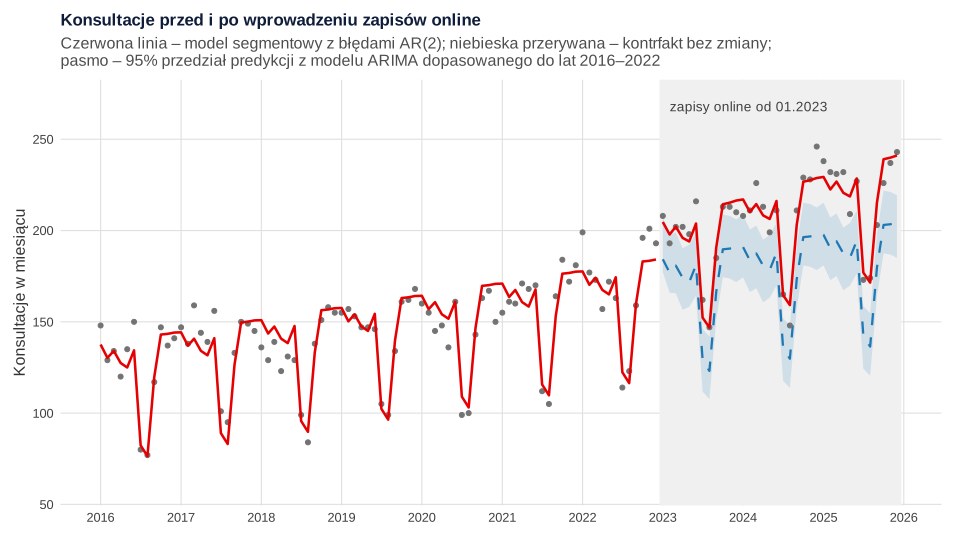
Model dopasowany tylko do lat 2016–2022 prognozuje 36 kolejnych miesięcy. To scenariusz kontrfaktyczny: przebieg, jakiego należałoby się spodziewać, gdyby nic się nie zmieniło. Średnia prognoza wynosi 178.70 konsultacji, a obserwowana średnia 207.47, czyli o 28.77 więcej. W pierwszym roku różnica wynosi średnio 22.42, a w trzecim 34.06 konsultacji. W 32 z 36 miesięcy wynik leżał powyżej górnej granicy 95% przedziału predykcji. Przedział ma szerokość 30.08 w pierwszym miesiącu prognozy i 34.32 w ostatnim, więc niepewność rośnie z horyzontem. Schaffer i in. (2021) pokazują, że modele ARIMA pozwalają oceniać duże interwencje z uwzględnieniem trendu, autokorelacji i sezonowości, a kształt wpływu interwencji modelują funkcjami transferu.
Krok 5. Przerwany szereg czasowy: regresja segmentowa
Prognoza pokazuje, że zmiana nastąpiła, ale nie mówi, jaka była. Do tego służy regresja segmentowa. Wagner i in. (2002) opisują przerwany szereg czasowy jako najsilniejszy schemat quasi-eksperymentalny do oceny podłużnych efektów interwencji, a regresję segmentową jako metodę szacowania tych efektów. Model ma dwa parametry efektu: skok poziomu w chwili interwencji i zmianę nachylenia trendu:
Zmienna „po” przyjmuje 1 od stycznia 2023, a „czas_po” liczy miesiące od zmiany. Lopez Bernal i in. (2016) radzą, aby kształt wpływu (skok, zmiana nachylenia, opóźnienie) określić przed analizą, a nie wybierać go po obejrzeniu danych. Zwracają też uwagę na autokorelację, sezonowość i zmienne zakłócające zmieniające się w czasie. Kontopantelis i in. (2015) omawiają założenia różnych podejść do modelowania takich danych.
Zwykła regresja liniowa daje skok o 23.36 konsultacji (SE = 3.70) i wzrost nachylenia o 0.378 na miesiąc (SE = 0.151, p = .014). Jej reszty są jednak skorelowane: r = .385 przy opóźnieniu 1, test Ljunga–Boxa p < .001. Taka autokorelacja reszt (klasycznie sprawdzana testem Durbina–Watsona) zaniża błędy standardowe. Ten sam model z błędami AR(2), dopasowany w stats::arima z argumentem xreg, daje następujące wyniki:
| Parametr | b | SE | 95% CI | p |
|---|---|---|---|---|
| Trend przed zmianą (na miesiąc) | 0.556 | 0.065 | [0.428, 0.683] | < .001 |
| Skok poziomu (styczeń 2023) | 19.947 | 5.630 | [8.912, 30.983] | < .001 |
| Zmiana nachylenia (na miesiąc) | 0.472 | 0.235 | [0.012, 0.932] | .044 |
| AR(1) / AR(2) | 0.332 / 0.156 | 0.091 / 0.094 | – | – |
Błąd standardowy skoku wzrósł z 3.70 do 5.63, a zmiany nachylenia z 0.151 do 0.235. Zmiana nachylenia jest na granicy istotności, a dolna granica jej przedziału ufności leży tuż nad zerem, więc wniosek o „przyspieszeniu” jest słabszy niż o samym skoku. Reszty modelu z błędami AR(2) nie wykazują już zależności (Q(22) = 27.19, p = .204). Łączny efekt w 12. miesiącu po zmianie (skok plus 12 × zmiana nachylenia) wynosi 25.61 konsultacji, 95% CI [16.47, 34.76], a w 36. miesiącu 36.95, 95% CI [23.16, 50.74]. Przy krótkich szeregach pamiętaj, że sama autokorelacja jest szacowana niedokładnie, a typowe estymatory dają w małych próbach obciążone wyniki i błędne odsetki błędów I rodzaju (Huitema i McKean, 1991).
Model nie usuwa zagrożeń schematu quasi-eksperymentalnego. Jeśli razem z zapisami online zmienił się sposób rejestrowania konsultacji albo w tym samym czasie zatrudniono nowych psychologów, efekt należy przypisać całemu pakietowi zmian. To typowa zmienna zakłócająca. Wzmocnieniem jest szereg kontrolny, np. poradnia bez zapisów online, czyli połączenie z logiką DiD.
Jak opisać wynik
W metodzie podaj okres i częstotliwość pomiarów, datę interwencji, przyjęty z góry kształt wpływu, sposób uwzględnienia trendu i sezonowości oraz strukturę błędów i jej diagnostykę. W wynikach pokaż wykres całego szeregu z linią interwencji, oszacowania z 95% CI i efekt w wybranym horyzoncie. Skoki poziomu i zmiany nachylenia z kilku podobnych szeregów, np. z poradni różnych uczelni, można później połączyć w metaanalizie, jeśli wszędzie efekt zdefiniowano tak samo.
Diagnostykę zwykłej regresji (reszty, obserwacje wpływowe) opisuje wpis diagnostyka regresji w R, a ocenę jakości prognoz – wpis o modelach predykcyjnych i walidacji. Jeśli piszesz artykuł albo rozdział doktoratu na danych z rejestrów i chcesz omówić wybór modelu, zajrzyj do oferty analiz dla badaczy i do przewodnika po doktoracie i publikacjach.
Szeregi czasowe w R: kod i wynik
Pięć przepisów uruchamiasz po kolei w jednej sesji R. Wystarczy pakiet stats: decompose(), acf(), pacf(), Box.test(), arima() i predict(). Pierwszy przepis generuje dane, kolejne korzystają z obiektów y, y_przed i poradnia. Liczby w tekście, tabelach i na rysunkach pochodzą z tych obliczeń. Dane pobierzesz jako plik szeregi-czasowe-poradnia-dane.csv (120 wierszy; kolumny: rok, miesiac, czas, po, czas_po, konsultacje).
Dane: 120 miesięcy konsultacji
R
options(width = 110)

# Dane symulowane: miesięczna liczba konsultacji w akademickiej poradni psychologicznej, 01.2016–12.2025.
# Od stycznia 2023 poradnia wprowadziła zapisy online (interwencja w 85. miesiącu szeregu).
# Składniki: trend wzrostowy, sezonowość roku akademickiego (mało konsultacji w lipcu i sierpniu,
# więcej w październiku–styczniu i w czerwcu), błędy AR(1) z phi = 0.5,
# efekt zapisów: skok poziomu o 18 konsultacji i dodatkowy wzrost o 0.4 konsultacji na miesiąc.
set.seed(1240)
n <- 120
czas <- 1:n
miesiac <- rep(1:12, 10)
sezon <- c(14, 6, 2, 0, -2, 10, -42, -48, -4, 16, 20, 16)[miesiac]
po <- as.integer(czas >= 85)                     # 0 przed zapisami online, 1 po
czas_po <- pmax(0, czas - 84)                    # miesiące od wprowadzenia zapisów
blad <- as.numeric(arima.sim(list(ar = 0.5), n = n, sd = 8))
konsultacje <- round(120 + 0.6 * czas + sezon + 18 * po + 0.4 * czas_po + blad)
poradnia <- data.frame(rok = rep(2016:2025, each = 12), miesiac, czas, po, czas_po, konsultacje)
y <- ts(konsultacje, start = c(2016, 1), frequency = 12)
y_przed <- window(y, end = c(2022, 12))          # 84 miesiące przed interwencją
c(miesiecy = length(y), przed = length(y_przed), po = sum(po))
aggregate(konsultacje ~ rok, poradnia, mean)
Wynik w R
miesiecy    przed       po
     120       84       36
    rok konsultacje
1  2016    126.2500
2  2017    138.0000
3  2018    131.0000
4  2019    144.5000
5  2020    143.9167
6  2021    158.5833
7  2022    168.9167
8  2023    195.7500
9  2024    207.9167
10 2025    218.7500
Trend, sezonowość i autokorelacja
R
# 2. Trend, sezonowość i autokorelacja – tylko okres przed interwencją
dek <- decompose(y_przed)                        # klasyczna dekompozycja addytywna
round(dek$figure, 1)                             # efekty sezonowe dla miesięcy 1–12
round(range(dek$trend, na.rm = TRUE), 1)         # trend (średnia ruchoma 2 × 12)

# Autokorelacja szeregu surowego, po różnicowaniu sezonowym i po dodatkowym zwykłym różnicowaniu
r_surowy <- acf(y_przed, lag.max = 24, plot = FALSE)$acf[-1]
d12 <- diff(y_przed, lag = 12)
r_d12 <- acf(d12, lag.max = 24, plot = FALSE)$acf[-1]
round(rbind(surowy = r_surowy[c(1, 2, 6, 12)], roznica_12 = r_d12[c(1, 2, 6, 12)]), 3)
pacf_d12 <- pacf(d12, lag.max = 24, plot = FALSE)$acf
round(pacf_d12[c(1, 2, 3, 12)], 3)
Box.test(y_przed, lag = 24, type = "Ljung-Box")
Wynik w R
 [1]  15.2   8.8  10.2   3.1   2.8   7.3 -41.1 -47.8  -3.6  17.0  14.7  13.5
[1] 126.2 168.4
            [,1]  [,2]   [,3]   [,4]
surowy     0.600 0.173  0.019  0.633
roznica_12 0.499 0.410 -0.058 -0.447
[1]  0.499  0.214 -0.034 -0.358

	Box-Ljung test

data:  y_przed
X-squared = 147.75, df = 24, p-value < 2.2e-16
ARIMA, wybór modelu i prognoza
R
# 3. ARIMA dla okresu przed interwencją, wybór modelu i prognoza kontrfaktyczna
# Najpierw sezonowe ARIMA z różnicowaniem sezonowym (D = 1) i dryfem
sarima <- arima(y_przed, order = c(1, 0, 0), seasonal = list(order = c(0, 1, 1), period = 12),
                xreg = 1:84, method = "ML")
round(sarima$coef, 3)                            # sma1 na granicy −1: różnicowanie sezonowe było zbędne

# Sezonowość jest stała, więc modelujemy ją zmiennymi miesięcy, a zależność w czasie – składnikiem ARMA
Xp <- cbind(czas = 1:84, model.matrix(~ factor(miesiac[1:84]))[, -1])
kandydaci <- list("ARMA(0,0)" = c(0, 0, 0), "AR(1)" = c(1, 0, 0), "AR(2)" = c(2, 0, 0),
                  "MA(1)" = c(0, 0, 1), "ARMA(1,1)" = c(1, 0, 1))
modele <- lapply(kandydaci, function(o) arima(y_przed, order = o, xreg = Xp, method = "ML"))
porownanie <- data.frame(model = names(modele), AIC = sapply(modele, AIC), BIC = sapply(modele, BIC))
porownanie$dAIC <- porownanie$AIC - min(porownanie$AIC)
rownames(porownanie) <- NULL
print(porownanie[order(porownanie$AIC), ], digits = 5)

# AR(1) zostawia zależność w resztach, AR(2) już nie
Box.test(residuals(modele[["AR(1)"]]), lag = 24, type = "Ljung-Box", fitdf = 1)
m <- modele[["AR(2)"]]
round(cbind(b = m$coef[1:4], SE = sqrt(diag(m$var.coef))[1:4]), 3)
# Diagnostyka reszt: test Ljunga–Boxa (stopnie swobody pomniejszone o 2 parametry ARMA)
Box.test(residuals(m), lag = 24, type = "Ljung-Box", fitdf = 2)

# Prognoza na 36 miesięcy po interwencji – czego oczekiwalibyśmy bez zapisów online
Xf <- cbind(czas = 85:120, model.matrix(~ factor(miesiac[85:120]))[, -1])
prog <- predict(m, n.ahead = 36, newxreg = Xf)
obs_po <- konsultacje[85:120]
roznica <- obs_po - prog$pred
round(c(sr_prognoza = mean(prog$pred), sr_obserwowane = mean(obs_po), sr_roznica = mean(roznica),
  roznica_rok1 = mean(roznica[1:12]), roznica_rok3 = mean(roznica[25:36]),
  ponad_95PI = sum(obs_po > prog$pred + 1.96 * prog$se), szer_PI_mies1 = 2 * 1.96 * prog$se[1],
  szer_PI_mies36 = 2 * 1.96 * prog$se[36]), 2)
Wynik w R
   ar1   sma1   1:84
 0.425 -1.000  0.543
      model    AIC    BIC    dAIC
3     AR(2) 613.06 651.95  0.0000
5 ARMA(1,1) 613.93 652.83  0.8732
2     AR(1) 615.50 651.97  2.4444
4     MA(1) 621.35 657.81  8.2854
1 ARMA(0,0) 629.80 663.83 16.7434

	Box-Ljung test

data:  residuals(modele[["AR(1)"]])
X-squared = 35.943, df = 23, p-value = 0.04181

                b    SE
ar1         0.331 0.106
ar2         0.234 0.109
intercept 137.770 4.455
czas        0.553 0.075

	Box-Ljung test

data:  residuals(m)
X-squared = 22.492, df = 22, p-value = 0.4308

   sr_prognoza sr_obserwowane     sr_roznica   roznica_rok1   roznica_rok3     ponad_95PI  szer_PI_mies1
        178.70         207.47          28.77          22.42          34.06          32.00          30.08
szer_PI_mies36
         34.32
Regresja segmentowa z błędami AR(2)
R
# 4. Przerwany szereg czasowy: regresja segmentowa ze zmianą poziomu i nachylenia
poradnia$m <- factor(poradnia$miesiac)
its_ols <- lm(konsultacje ~ czas + po + czas_po + m, data = poradnia)
round(summary(its_ols)$coefficients[2:4, ], 3)
# Czy reszty są niezależne? Autokorelacja reszt i test Ljunga–Boxa
round(acf(residuals(its_ols), plot = FALSE)$acf[2:4], 3)
Box.test(residuals(its_ols), lag = 24, type = "Ljung-Box")

# Ten sam model z błędami AR(2), jak w kroku 3: regresja z błędami ARIMA w stats::arima
X <- cbind(czas = poradnia$czas, po = poradnia$po, czas_po = poradnia$czas_po,
           model.matrix(~ m, poradnia)[, -1])
its_ar <- arima(poradnia$konsultacje, order = c(2, 0, 0), xreg = X, method = "ML")
wsp <- its_ar$coef[c("ar1", "ar2", "czas", "po", "czas_po")]
se  <- sqrt(diag(its_ar$var.coef))[c("ar1", "ar2", "czas", "po", "czas_po")]
round(cbind(b = wsp, SE = se, z = wsp / se, p = 2 * pnorm(-abs(wsp / se)),
            dolna_95 = wsp - 1.96 * se, gorna_95 = wsp + 1.96 * se), 3)
Box.test(residuals(its_ar), lag = 24, type = "Ljung-Box", fitdf = 2)

# Efekt po 12 i po 36 miesiącach: skok poziomu + 12 (36) × zmiana nachylenia, z 95% CI
V <- its_ar$var.coef[c("po", "czas_po"), c("po", "czas_po")]
efekt <- function(h) { w <- c(1, h); est <- sum(w * its_ar$coef[c("po", "czas_po")])
  s <- sqrt(drop(t(w) %*% V %*% w)); round(c(miesiecy = h, efekt = est, dolna_95 = est - 1.96 * s, gorna_95 = est + 1.96 * s), 2) }
rbind(efekt(12), efekt(36))
# Porównanie błędów standardowych: OLS a model z błędami AR(2)
round(rbind(OLS = summary(its_ols)$coefficients[c("po", "czas_po"), "Std. Error"], AR2 = se[c("po", "czas_po")]), 3)
Wynik w R
        Estimate Std. Error t value Pr(>|t|)
czas       0.544      0.041  13.353    0.000
po        23.359      3.695   6.321    0.000
czas_po    0.378      0.151   2.495    0.014
[1] 0.385 0.271 0.136

	Box-Ljung test

data:  residuals(its_ols)
X-squared = 57.335, df = 24, p-value = 0.0001504

             b    SE     z     p dolna_95 gorna_95
ar1      0.332 0.091 3.666 0.000    0.155    0.510
ar2      0.156 0.094 1.651 0.099   -0.029    0.341
czas     0.556 0.065 8.550 0.000    0.428    0.683
po      19.947 5.630 3.543 0.000    8.912   30.983
czas_po  0.472 0.235 2.011 0.044    0.012    0.932

	Box-Ljung test

data:  residuals(its_ar)
X-squared = 27.185, df = 22, p-value = 0.2043

     miesiecy efekt dolna_95 gorna_95
[1,]       12 25.61    16.47    34.76
[2,]       36 36.95    23.16    50.74
       po czas_po
OLS 3.695   0.151
AR2 5.630   0.235
Zapis pliku CSV
R
# 5. Plik do pobrania: szereg miesięczny
write.csv(poradnia[, c("rok", "miesiac", "czas", "po", "czas_po", "konsultacje")],
          "../szeregi-czasowe-poradnia-dane.csv", row.names = FALSE, fileEncoding = "UTF-8")
spr <- read.csv("../szeregi-czasowe-poradnia-dane.csv")
str(spr)
cat(R.version.string, "\n")
Wynik w R
'data.frame':	120 obs. of  6 variables:
 $ rok        : int  2016 2016 2016 2016 2016 2016 2016 2016 2016 2016 ...
 $ miesiac    : int  1 2 3 4 5 6 7 8 9 10 ...
 $ czas       : int  1 2 3 4 5 6 7 8 9 10 ...
 $ po         : int  0 0 0 0 0 0 0 0 0 0 ...
 $ czas_po    : int  0 0 0 0 0 0 0 0 0 0 ...
 $ konsultacje: int  148 129 134 120 135 150 80 77 117 147 ...
R version 4.5.3 (2026-03-11)
Bibliografia oprogramowania
Obliczenia wykonano w R 4.5.3 z pakietem stats; rysunki przygotowano w pakietach ggplot2 i patchwork (zapis SVG: svglite). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy
- Porównanie średniej „przed” i „po”. Przy rosnącym trendzie zawsze wyjdzie wzrost. Porównuj z przedłużonym trendem, a nie ze średnią.
- Pominięcie sezonowości. Interwencja wprowadzona przed sezonowym szczytem zyska fałszywy efekt, a przed spadkiem straci prawdziwy.
- Zwykłe błędy standardowe przy autokorelacji reszt. Sprawdź ACF reszt i test Ljunga–Boxa, a w razie potrzeby dodaj do modelu składnik ARMA.
- Różnicowanie „na wszelki wypadek”. Zbędne różnicowanie wprowadza ujemną autokorelację, a parametr MA na granicy −1 jest tego sygnałem.
- Kształt wpływu wybrany po obejrzeniu wykresu. Ustal z góry, czy oczekujesz skoku, zmiany nachylenia, czy efektu z opóźnieniem.
- Kryteria informacyjne bez diagnostyki. Najniższe AIC nie gwarantuje, że reszty są niezależne. Sprawdź je zawsze.
Najczęstsze pytania
Jak dobrać rząd modelu ARIMA w R bez pakietu forecast?
Dopasuj w stats::arima kilka kandydatów o tej samej części regresyjnej i tym samym różnicowaniu, porównaj ich AIC lub BIC, a potem sprawdź reszty wybranego modelu testem Ljunga–Boxa z argumentem fitdf równym liczbie parametrów ARMA. Jeśli reszty są nadal autokorelowane, wybierz bogatszy model, nawet gdy różnica AIC jest niewielka.
Co oznacza współczynnik sezonowej średniej ruchomej równy −1 w ARIMA?
Najczęściej to sygnał nadmiernego różnicowania: sezonowość jest stała z roku na rok, a różnicowanie sezonowe usunęło ją zbyt mocno i wprowadziło ujemną autokorelację. Zamiast różnicowania sezonowego rozważ zmienne zero-jedynkowe dla miesięcy w części regresyjnej modelu i składnik ARMA dla błędów.
Kiedy w przerwanym szeregu czasowym wystarczy zwykła regresja segmentowa?
Gdy reszty modelu z trendem, sezonowością i parametrami interwencji nie są autokorelowane, co sprawdzisz na wykresie ACF reszt i testem Ljunga–Boxa. Jeśli autokorelacja zostaje, zwykłe błędy standardowe są zaniżone. Wtedy dopasuj ten sam model z błędami ARMA, np. w arima() z argumentem xreg.
Jak zinterpretować skok poziomu i zmianę nachylenia w regresji segmentowej?
Skok poziomu to natychmiastowa zmiana wyniku w chwili interwencji w porównaniu z przedłużonym trendem. Zmiana nachylenia mówi, o ile szybciej lub wolniej wynik zmienia się w każdym kolejnym okresie po interwencji. Łączny efekt po h okresach to skok plus h razy zmiana nachylenia, z przedziałem ufności z macierzy kowariancji obu parametrów.
Jak sprawdzić sezonowość w danych miesięcznych w R?
Zamień dane na obiekt ts(..., frequency = 12), narysuj szereg i użyj decompose() albo stl(), aby zobaczyć trend i profil sezonowy. Na wykresie ACF sezonowość widać jako wysoką autokorelację przy opóźnieniu 12 i jego wielokrotnościach.
Powiązane hasła
Przeczytaj też
Quasi-eksperyment i różnica w różnicach (DiD)
Ocena programu bez losowania: równoległe trendy, regresja z interakcją, błędy klastrowane, model zdarzeń, test placebo, zagrożenia trafności i kod R.
Czytaj →PoradnikBadanie jednego przypadku (single-case)
Schematy ABAB i wielokrotnej linii bazowej, analiza wizualna w liczbach, NAP, Tau-U i jego pułapki, test randomizacyjny, SCRIBE i kod R.
Czytaj →PoradnikDiagnostyka regresji w R
Reszty studentyzowane, dźwignia, Cook i DFBETAS, VIF, maskowanie heteroskedastyczności, HC3 i analiza wrażliwości – z danymi i kodem R.
Czytaj →Oceniasz zmianę na danych miesięcznych lub z rejestru?
Pomożemy uwzględnić trend, sezonowość i autokorelację, dobrać model ARIMA albo regresję segmentową i opisać efekt interwencji z przedziałami ufności tak, aby wytrzymał pytania recenzentów.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Huitema, B. E., & McKean, J. W. (1991). Autocorrelation estimation and inference with small samples. Psychological Bulletin, 110(2), 291–304. https://doi.org/10.1037/0033-2909.110.2.291
- Hyndman, R. J., & Khandakar, Y. (2008). Automatic time series forecasting: The forecast package for R. Journal of Statistical Software, 27(3), 1–22. https://doi.org/10.18637/jss.v027.i03 ● Otwarty dostęp
- Jebb, A. T., Tay, L., Wang, W., & Huang, Q. (2015). Time series analysis for psychological research: Examining and forecasting change. Frontiers in Psychology, 6, Article 727. https://doi.org/10.3389/fpsyg.2015.00727 ● Otwarty dostęp
- Kontopantelis, E., Doran, T., Springate, D. A., Buchan, I., & Reeves, D. (2015). Regression based quasi-experimental approach when randomisation is not an option: Interrupted time series analysis. BMJ, 350, Article h2750. https://doi.org/10.1136/bmj.h2750 ● Otwarty dostęp
- Ljung, G. M., & Box, G. E. P. (1978). On a measure of lack of fit in time series models. Biometrika, 65(2), 297–303. https://doi.org/10.1093/biomet/65.2.297
- Lopez Bernal, J., Cummins, S., & Gasparrini, A. (2016). Interrupted time series regression for the evaluation of public health interventions: A tutorial. International Journal of Epidemiology, 46(1), 348–355. https://doi.org/10.1093/ije/dyw098 ● Otwarty dostęp
- Schaffer, A. L., Dobbins, T. A., & Pearson, S.-A. (2021). Interrupted time series analysis using autoregressive integrated moving average (ARIMA) models: A guide for evaluating large-scale health interventions. BMC Medical Research Methodology, 21(1), Article 58. https://doi.org/10.1186/s12874-021-01235-8 ● Otwarty dostęp
- Wagner, A. K., Soumerai, S. B., Zhang, F., & Ross-Degnan, D. (2002). Segmented regression analysis of interrupted time series studies in medication use research. Journal of Clinical Pharmacy and Therapeutics, 27(4), 299–309. https://doi.org/10.1046/j.1365-2710.2002.00430.x
Cytowania BibTeX
@article{huitema1991autocorrelation, author={Huitema, Bradley E. and McKean, Joseph W.}, title={{Autocorrelation estimation and inference with small samples}}, journal={Psychological Bulletin}, year={1991}, volume={110}, number={2}, pages={291--304}, doi={10.1037/0033-2909.110.2.291}}@article{hyndman2008automatic, author={Hyndman, Rob J. and Khandakar, Yeasmin}, title={{Automatic time series forecasting: The forecast package for R}}, journal={Journal of Statistical Software}, year={2008}, volume={27}, number={3}, pages={1--22}, doi={10.18637/jss.v027.i03}}@article{jebb2015time, author={Jebb, Andrew T. and Tay, Louis and Wang, Wei and Huang, Qiming}, title={{Time series analysis for psychological research: Examining and forecasting change}}, journal={Frontiers in Psychology}, year={2015}, volume={6}, eid={727}, doi={10.3389/fpsyg.2015.00727}}@article{kontopantelis2015regression, author={Kontopantelis, E. and Doran, T. and Springate, D. A. and Buchan, I. and Reeves, D.}, title={{Regression based quasi-experimental approach when randomisation is not an option: Interrupted time series analysis}}, journal={BMJ}, year={2015}, volume={350}, eid={h2750}, doi={10.1136/bmj.h2750}}@article{ljung1978measure, author={Ljung, G. M. and Box, G. E. P.}, title={{On a measure of lack of fit in time series models}}, journal={Biometrika}, year={1978}, volume={65}, number={2}, pages={297--303}, doi={10.1093/biomet/65.2.297}}@article{lopezbernal2016interrupted, author={Lopez Bernal, James and Cummins, Steven and Gasparrini, Antonio}, title={{Interrupted time series regression for the evaluation of public health interventions: A tutorial}}, journal={International Journal of Epidemiology}, year={2016}, volume={46}, number={1}, pages={348--355}, doi={10.1093/ije/dyw098}}@article{schaffer2021interrupted, author={Schaffer, Andrea L. and Dobbins, Timothy A. and Pearson, Sallie-Anne}, title={{Interrupted time series analysis using autoregressive integrated moving average (ARIMA) models: A guide for evaluating large-scale health interventions}}, journal={BMC Medical Research Methodology}, year={2021}, volume={21}, number={1}, eid={58}, doi={10.1186/s12874-021-01235-8}}@article{wagner2002segmented, author={Wagner, A. K. and Soumerai, S. B. and Zhang, F. and Ross-Degnan, D.}, title={{Segmented regression analysis of interrupted time series studies in medication use research}}, journal={Journal of Clinical Pharmacy and Therapeutics}, year={2002}, volume={27}, number={4}, pages={299--309}, doi={10.1046/j.1365-2710.2002.00430.x}}