Kiedy badanie jednego przypadku ma sens
Badanie jednego przypadku (single-case experimental design, SCED) to eksperyment, w którym jednostką analizy jest jedna osoba, a porównanie odbywa się w czasie: ta sama osoba jest mierzona wiele razy w warunkach bez interwencji i z interwencją. To nie jest opis przypadku. Badacz planuje fazy, mierzy zmienną zależną w każdej sesji i sprawdza, czy zmiana pojawia się wtedy, gdy wprowadza interwencję, a nie wcześniej. Horner i in. (2005) opisują cechy, które odróżniają wiarygodne badanie tego typu od zwykłej obserwacji, i pokazują, jak na tej podstawie dokumentować praktykę opartą na dowodach.
Taki schemat wybiera się, gdy grupa jest niedostępna (rzadkie zaburzenie, terapia indywidualna, edukacja specjalna) albo gdy ważny jest przebieg zmiany u konkretnej osoby. Najprostszy schemat AB i wskaźnik NAP omawia wpis o statystyce w pracy z logopedii. Ten wpis idzie dalej: schematy, które dają replikację efektu, ocena wizualna w liczbach, Tau-U i jego pułapki oraz test randomizacyjny.
Schematy: AB, ABAB i wielokrotna linia bazowa
Siła wniosku zależy od tego, ile razy schemat pozwala pokazać efekt. W schemacie AB zmiana zachodzi raz, więc nie odróżnisz jej od rozwoju, efektu uczenia się czy zdarzenia zbieżnego w czasie. To te same zagrożenia trafności wewnętrznej, które osłabiają schemat pretest–posttest bez grupy kontrolnej. Lepsze schematy wbudowują replikację w jeden projekt.
| Schemat | Przebieg | Ile razy widać efekt | Kiedy nie pasuje |
|---|---|---|---|
| AB | linia bazowa, potem interwencja | raz | gdy chcesz wnioskować przyczynowo – to tylko wstęp |
| ABAB (wycofanie) | interwencja wprowadzana, wycofywana i przywracana | trzy razy u jednej osoby | gdy zachowanie nie wraca do poziomu wyjściowego (nauczona umiejętność) albo wycofanie byłoby nieetyczne |
| Wielokrotna linia bazowa | interwencja wprowadzana kolejno u kilku osób, w kilku sytuacjach lub dla kilku zachowań | tyle razy, ile jest linii bazowych | gdy zmiana u jednej osoby przenosi się na pozostałe przed ich interwencją |
| Naprzemienne interwencje | szybkie przeplatanie dwóch warunków | wielokrotnie, w krótkich odstępach | gdy działanie interwencji utrzymuje się i miesza z kolejnym warunkiem |
Zwykle przyjmuje się, że przekonujące badanie pokazuje efekt co najmniej trzy razy, w trzech różnych momentach, a każda faza ma kilka pomiarów. Kratochwill i in. (2013) opisują standardy What Works Clearinghouse. Najpierw ocenia się schemat (spełnia standardy, spełnia z zastrzeżeniami, nie spełnia), a potem siłę dowodów, którą oceniają recenzenci przeszkoleni w analizie wizualnej. Zanim zaplanujesz liczbę sesji, sprawdź aktualną wersję standardów.
Przykład: trening samoobserwacji na lekcji
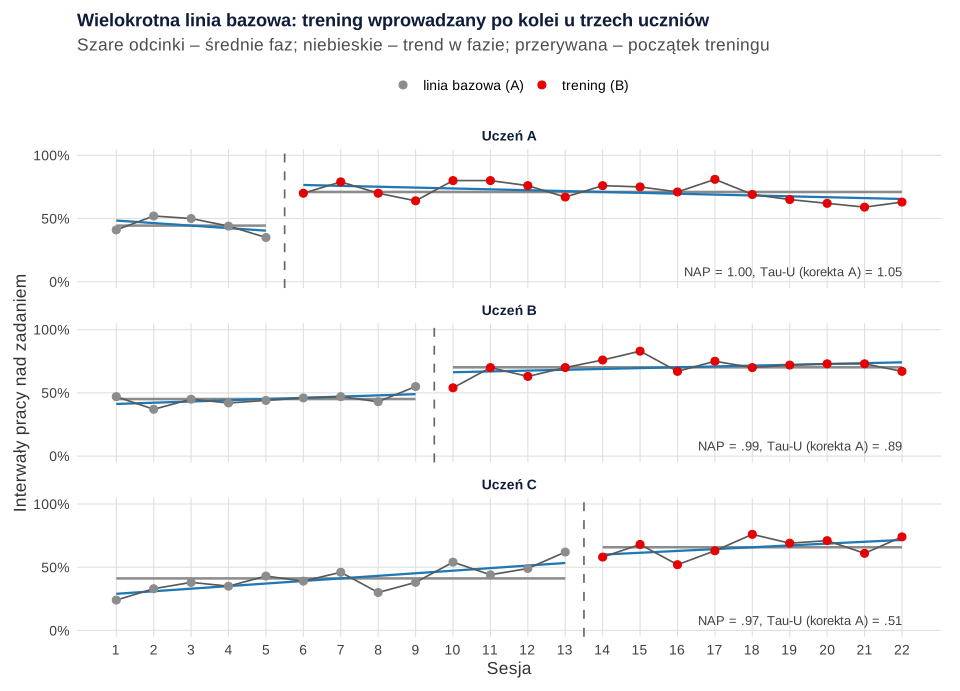
Dane są symulowane. Czworo uczniów klasy piątej uczy się na lekcji samoobserwacji: co kilka minut zaznacza na karcie, czy pracuje nad zadaniem. Zmienna zależna to odsetek 15-sekundowych interwałów, w których uczeń pracował nad zadaniem, mierzony w 22 sesjach. Uczniowie A, B i C tworzą wielokrotną linię bazową: trening zaczyna się u nich w sesji 6, 10 i 14. U ucznia D zastosowano schemat ABAB: trening w sesjach 6–11, wycofanie w sesjach 12–16 i powrót od sesji 17. Kolejne pomiary jednej osoby są skorelowane (autokorelacja), tak jak w każdym szeregu czasowym. Taki pomiar wymaga też kontroli zgodności obserwatorów, np. drugiej osoby kodującej część sesji (zob. zgodność sędziów).
Analiza wizualna: sześć cech, które trzeba opisać
Podstawą wnioskowania w SCED jest wykres przebiegu. Oceniasz na nim poziom (średnia lub mediana fazy), trend, zmienność, natychmiastowość zmiany po przejściu do nowej fazy, nakładanie się wyników z sąsiednich faz i spójność wzorca w podobnych fazach. Te cechy łatwo policzyć, dzięki czemu ocena nie opiera się tylko na wrażeniu. Natychmiastowość liczymy jako różnicę średnich z trzech ostatnich sesji poprzedniej fazy i trzech pierwszych sesji fazy następnej.
| Uczeń | Sesje A / B | M w fazie A → B | Trend A / B (pkt na sesję) | Zakres A / B | Natychmiastowość |
|---|---|---|---|---|---|
| A | 5 / 17 | 44.4 → 71.0 | −2.00 / −0.69 | 35–52 / 59–81 | +30.00 |
| B | 9 / 13 | 45.1 → 70.2 | 0.97 / 0.65 | 37–55 / 54–83 | +14.00 |
| C | 13 / 9 | 41.2 → 65.8 | 2.03 / 1.45 | 24–62 / 52–76 | +7.67 |
U uczniów A i B obraz jest czytelny: stabilna linia bazowa, wyraźny skok zaraz po wprowadzeniu treningu, bez nakładania się faz. U ucznia C wynik rósł już w linii bazowej, o 2.03 punktu na sesję, a skok po treningu jest mały (+7.67). Gdyby przedłużyć trend z fazy A, objąłby on większość wyników z fazy B. Logika wielokrotnej linii bazowej wymaga też, aby wynik ucznia C nie zmieniał się w chwili, gdy trening zaczynał uczeń A lub B. Tu wzrost jest stopniowy, więc trudno przypisać go treningowi któregokolwiek z nich. Wniosek: efekt pokazano przekonująco dwa razy, a trzecie pokazanie jest wątpliwe. Tak też trzeba to opisać.
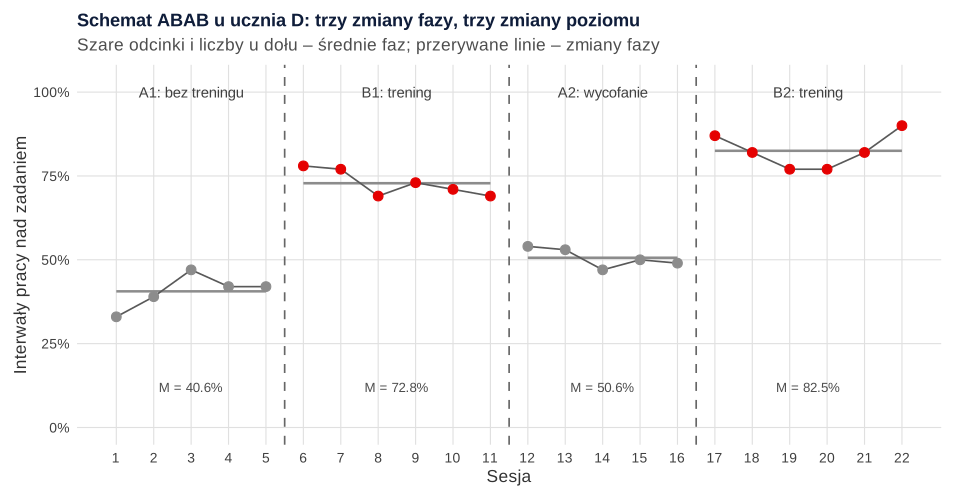
U ucznia D trzy zmiany fazy dały trzy zmiany poziomu: z 40.6% do 72.8%, spadek do 50.6% po wycofaniu treningu i wzrost do 82.5% po jego przywróceniu. Natychmiastowość wynosiła kolejno +31.00, −19.67 i +33.33 punktu. Wynik w fazie A2 nie wrócił do poziomu z fazy A1, co jest typowe, gdy uczeń przyswoił część umiejętności. Zmiana w obu kierunkach jest jednak dobrym argumentem za związkiem przyczynowym.
NAP, Tau i Tau-U: wskaźniki nienakładania
Wskaźniki nienakładania zamieniają porównanie faz w jedną liczbę. NAP (Parker i Vannest, 2009) to odsetek wszystkich par „sesja z fazy A – sesja z fazy B”, w których wynik w B jest lepszy (remisy liczą się po połowie). To przeskalowana statystyka testu Manna–Whitneya. Tau to ta sama informacja w skali od −1 do 1: Tau = 2 × NAP − 1. Żaden z tych wskaźników nie widzi trendu. Uczeń C ma NAP = .97, prawie tyle co uczniowie A i B, choć jego wykres budzi wątpliwości.
Tau-U (Parker i in., 2011) łączy nienakładanie z trendem i oparte jest na korelacji tau Kendalla. W wersji z korektą niepożądanego trendu fazy A od liczby par „B lepsze od A” (SAB) odejmuje się statystykę S Kendalla dla trendu w linii bazowej i dzieli wynik przez liczbę par:
| Kontrast | NAP | Tau | SAB / Strend A | Tau-U (korekta A) | Tau po odjęciu trendu A |
|---|---|---|---|---|---|
| Uczeń A: A–B | 1.00 | 1.00 | 85 / −4 | 1.05 | 1.00 |
| Uczeń B: A–B | .99 | .98 | 115 / 11 | .89 | .93 |
| Uczeń C: A–B | .97 | .93 | 109 / 49 | .51 | −.03 |
| Uczeń D: A1–B1 | 1.00 | 1.00 | 30 / 5 | .83 | 1.00 |
| Uczeń D: B1–A2 | 1.00 | 1.00 | 30 / 10 | .67 | 1.00 |
| Uczeń D: A2–B2 | 1.00 | 1.00 | 30 / −6 | 1.20 | 1.00 |
Tabela pokazuje dwie rzeczy. Po pierwsze, korekta trendu zmienia ocenę ucznia C: Tau-U spada do .51. Po drugie, u ucznia A Tau-U wynosi 1.05, a w ostatnim kontraście ucznia D 1.20. Gdy linia bazowa opada, czyli trend biegnie w kierunku przeciwnym do oczekiwanego, odjęcie ujemnego S podnosi wynik ponad 1. Tarlow (2017) wskazuje, że wartości Tau-U są zawyżone i nie mieszczą się w przedziale od −1 do 1, a słaba kontrola trendu daje zbyt wiele błędów I rodzaju. Brossart i in. (2018) dodają, że część wskaźników Tau-U słabo zgadza się z oceną wizualną, a nazwy wariantów bywają w publikacjach niespójne. Dlatego zawsze podaj, który wariant Tau-U liczysz, i nie porównuj go wprost z NAP ani z d Cohena.
Tarlow (2017) proponuje Tau skorygowane o linię bazową, oparte na korelacji rang i odpornej regresji. W ostatniej kolumnie pokazujemy prosty wariant tej logiki: nachylenie Theila–Sena (mediana nachyleń wszystkich par punktów) z fazy A odejmujemy od całego szeregu, a potem liczymy zwykłe Tau. U ucznia C Tau spada wtedy do −.03, bo trend 2.28 punktu na sesję przedłużony na fazę B tłumaczy całą poprawę. Taka korekta ma swoją cenę: zakłada, że trend z kilkunastu sesji trwałby dalej bez końca, a przy krótkiej linii bazowej łatwo o nadmierną korektę. Dlatego przy uczniu C nie wystarczy jedna liczba. Pomocny jest test trendu w linii bazowej: tau Kendalla dla czasu i wyniku w fazie A wynosi .63, p = .003. To p zakłada jednak niezależne pomiary, więc traktuj je orientacyjnie.
Test randomizacyjny: wnioskowanie bez założenia niezależności
Zwykłe testy, np. test t na sesjach z faz A i B, traktują kolejne pomiary jak niezależne osoby. Przy autokorelacji zawyża to istotność. Uczciwszym rozwiązaniem jest test randomizacyjny, ale tylko wtedy, gdy losowanie było częścią planu. Heyvaert i Onghena (2014) opisują dwa sposoby: losowanie momentu zmiany fazy (schematy fazowe) i losowanie kolejności warunków (schematy naprzemienne).
W przykładzie zakładamy, że przed badaniem wylosowano początek treningu każdego ucznia z czterech dopuszczalnych sesji: 5–8 dla A, 9–12 dla B i 13–16 dla C. Daje to 4 × 4 × 4 = 64 możliwe układy. Statystyką jest średnia (po uczniach) różnica między średnią fazy B i średnią fazy A, obliczona dla każdego układu. W faktycznym układzie wynosi 25.45 punktu. Co najmniej tak dużą różnicę daje 7 z 64 układów, więc p = .109. Najmniejsze możliwe p w tym planie to 1/64 = .016. Liczbę możliwych układów, a więc i moc testu, ustala się na etapie planowania. Wynik zgadza się z oceną wizualną: przy rosnącej linii bazowej ucznia C różnica średnich prawie nie zależy od tego, kiedy zaczął się trening.
Gdy przypadków jest więcej: od SCED do metaanalizy
Wyniki kilku osób lub kilku badań można połączyć. Shadish i in. (2014) przedstawiają statystykę d dla badań jednego przypadku w tej samej metryce co d z badań grupowych. Wymaga ona co najmniej trzech przypadków, uwzględnia autokorelację i pozwala włączyć SCED do metaanalizy. Ogólną procedurę opisuje wpis metaanaliza krok po kroku. Zależność wielu efektów z jednego badania wyjaśnia metaanaliza wielopoziomowa. Alternatywą jest model, w którym sesje są zagnieżdżone w osobach (zob. model wielopoziomowy krok po kroku). Gdy pomiarów jest bardzo dużo, np. dziennik prowadzony przez kilka miesięcy, przydają się metody z wpisu o szeregach czasowych i ARIMA.
Jak opisać badanie jednego przypadku
Lista SCRIBE 2016 zawiera 26 punktów raportowania badań jednego przypadku w naukach behawioralnych (Tate i in., 2016). W metodzie podaj uczestników i kryteria ich doboru, schemat i jego uzasadnienie, liczbę sesji w każdej fazie, regułę zmiany fazy (z góry ustaloną liczbę sesji, kryterium stabilności albo losowanie), definicję zmiennej zależnej i zgodność obserwatorów. W wynikach pokaż wykres wszystkich pomiarów, opis wizualny i wskaźniki liczbowe, a przy wskaźnikach podaj ich wariant.
Jeśli przygotowujesz artykuł z SCED i chcesz sprawdzić wybór wskaźników lub opis wykresów przed wysłaniem, zajrzyj do oferty analiz dla badaczy. Szerszy kontekst publikowania znajdziesz w przewodniku po doktoracie i publikacjach, a pomiar przed i po u pacjentów – w przewodniku po badaniach klinicznych.
Badanie jednego przypadku w R: kod i wynik
Pięć przepisów uruchamiasz po kolei w jednej sesji R; wystarczy pakiet stats, bo NAP, Tau-U i test randomizacyjny liczymy ze wzorów. Pierwszy przepis generuje dane, kolejne korzystają z obiektu dane. Liczby w tekście, tabelach i na rysunkach pochodzą z tych obliczeń. Dane pobierzesz jako plik badanie-jednego-przypadku-dane.csv (88 wierszy; kolumny: uczen, schemat, sesja, faza, etap, wynik). Układ danych „jedna sesja w wierszu” opisuje wpis o przygotowaniu bazy danych.
Dane: czworo uczniów, 22 sesje
R
options(width = 110)

# Dane symulowane: trening samoobserwacji na lekcji u czworga uczniów klasy 5.
# Wynik: odsetek 15-sekundowych interwałów, w których uczeń pracował nad zadaniem (0–100%),
# z obserwacji 20-minutowych fragmentów lekcji. Błędy pomiaru skorelowane w czasie (AR(1), phi = 0.3).
# Uczniowie A, B, C: wielokrotna linia bazowa (22 sesje, trening od sesji 6, 10 i 14).
# Uczeń D: schemat ABAB (wycofanie treningu w sesjach 12–16).
set.seed(1230)
szum <- function(n) as.numeric(arima.sim(list(ar = 0.3), n = n, sd = 6))
ogr  <- function(x) round(pmin(pmax(x, 0), 100))
sesja <- 1:22
start <- c(A = 6, B = 10, C = 14)
poziom_a <- c(A = 36, B = 42, C = 30)
trend_a  <- c(A = 0, B = 0, C = 1.6)          # u ucznia C wynik rośnie już w linii bazowej
poziom_b <- c(A = 71, B = 73, C = 66)
mb <- do.call(rbind, lapply(names(start), function(u) {
  faza <- ifelse(sesja < start[u], "A", "B")
  wzor <- ifelse(faza == "A", poziom_a[u] + trend_a[u] * (sesja - 1),
                 poziom_b[u] - 12 * exp(-(sesja - start[u]) / 2))   # efekt narasta przez 2–3 sesje
  data.frame(uczen = u, schemat = "wielokrotna linia bazowa", sesja, faza, etap = faza,
             wynik = ogr(wzor + szum(22)))
}))
etap_d <- rep(c("A1", "B1", "A2", "B2"), times = c(5, 6, 5, 6))
wzor_d <- c(40, 74, 50, 78)[match(etap_d, c("A1", "B1", "A2", "B2"))]
abab <- data.frame(uczen = "D", schemat = "ABAB", sesja, faza = substr(etap_d, 1, 1), etap = etap_d,
                   wynik = ogr(wzor_d + szum(22)))
dane <- rbind(mb, abab)
rownames(dane) <- NULL
with(dane, table(uczen, etap))
Wynik w R
     etap
uczen  A A1 A2  B B1 B2
    A  5  0  0 17  0  0
    B  9  0  0 13  0  0
    C 13  0  0  9  0  0
    D  0  5  5  0  6  6
Analiza wizualna w liczbach
R
# 2. Analiza wizualna w liczbach: poziom, trend, zmienność, natychmiastowość
nachylenie <- function(y) if (length(y) > 1) unname(coef(lm(y ~ seq_along(y)))[2]) else NA
opis <- do.call(rbind, lapply(split(dane, list(dane$uczen, dane$etap), drop = TRUE), function(d)
  data.frame(uczen = d$uczen[1], etap = d$etap[1], n = nrow(d), M = mean(d$wynik), Me = median(d$wynik),
             min = min(d$wynik), max = max(d$wynik), SD = sd(d$wynik), trend = nachylenie(d$wynik))))
opis <- opis[order(opis$uczen, match(opis$etap, c("A", "B", "A1", "B1", "A2", "B2"))), ]
rownames(opis) <- NULL
print(opis, digits = 3)

# Natychmiastowość: średnia 3 ostatnich sesji fazy poprzedniej vs 3 pierwszych sesji fazy następnej
natych <- function(y_przed, y_po) mean(head(y_po, 3)) - mean(tail(y_przed, 3))
zmiany <- list(A = c("A", "B"), B = c("A", "B"), C = c("A", "B"),
               D = c("A1", "B1"), D = c("B1", "A2"), D = c("A2", "B2"))
nat <- do.call(rbind, Map(function(u, e) {
  d <- dane[dane$uczen == u, ]
  data.frame(uczen = u, zmiana = paste(e, collapse = "->"),
             natychmiastowosc = natych(d$wynik[d$etap == e[1]], d$wynik[d$etap == e[2]]))
}, names(zmiany), zmiany))
rownames(nat) <- NULL
print(nat, digits = 3)
Wynik w R
   uczen etap  n    M Me min max    SD  trend
1      A    A  5 44.4 44  35  52  6.88 -2.000
2      A    B 17 71.0 70  59  81  7.02 -0.691
3      B    A  9 45.1 45  37  55  4.83  0.967
4      B    B 13 70.2 70  54  83  6.92  0.654
5      C    A 13 41.2 39  24  62 10.18  2.033
6      C    B  9 65.8 68  52  76  7.87  1.450
7      D   A1  5 40.6 42  33  47  5.13  2.100
8      D   B1  6 72.8 72  69  78  3.92 -1.686
9      D   A2  5 50.6 50  47  54  2.88 -1.300
10     D   B2  6 82.5 82  77  90  5.24  0.429
  uczen zmiana natychmiastowosc
1     A   A->B            30.00
2     B   A->B            14.00
3     C   A->B             7.67
4     D A1->B1            31.00
5     D B1->A2           -19.67
6     D A2->B2            33.33
NAP, Tau, Tau-U i korekta trendu
R
# 3. Wskaźniki nienakładania: NAP, Tau, Tau-U (z korektą trendu A) i Tau po usunięciu trendu linii bazowej
S_ab <- function(a, b) sum(sign(outer(b, a, "-")))                     # pary B > A minus pary B < A
S_tr <- function(y) { n <- length(y); s <- 0
  for (i in 1:(n - 1)) for (j in (i + 1):n) s <- s + sign(y[j] - y[i]); s }   # S Kendalla dla trendu
NAP  <- function(a, b) mean(outer(b, a, ">") + 0.5 * outer(b, a, "=="))
theil_sen <- function(y) { t <- seq_along(y); p <- combn(length(y), 2)
  median((y[p[2, ]] - y[p[1, ]]) / (t[p[2, ]] - t[p[1, ]])) }
wskazniki <- function(a, b, kierunek = 1) {
  a <- kierunek * a; b <- kierunek * b
  nA <- length(a); nB <- length(b)
  # Odporna korekta trendu: nachylenie Theila–Sena z fazy A odjęte od całego szeregu, potem zwykłe Tau
  y <- c(a, b); t <- seq_along(y)
  test_a <- cor.test(seq_along(a), a, method = "kendall", exact = FALSE)
  y_kor <- y - theil_sen(a) * t
  a_kor <- y_kor[1:nA]; b_kor <- y_kor[-(1:nA)]
  c(nA = nA, nB = nB, NAP = NAP(a, b), Tau = S_ab(a, b) / (nA * nB),
    S_AB = S_ab(a, b), S_trendA = S_tr(a), TauU_korekta_A = (S_ab(a, b) - S_tr(a)) / (nA * nB),
    tau_trend_A = unname(test_a$estimate), p_trend_A = test_a$p.value,
    nachylenie_TS_A = theil_sen(a), Tau_bez_trendu_A = S_ab(a_kor, b_kor) / (nA * nB))
}
kontrasty <- list(A = c("A", "B", 1), B = c("A", "B", 1), C = c("A", "B", 1),
                  D = c("A1", "B1", 1), D = c("B1", "A2", -1), D = c("A2", "B2", 1))
wyn <- do.call(rbind, Map(function(u, k) {
  d <- dane[dane$uczen == u, ]
  data.frame(uczen = u, kontrast = paste(k[1:2], collapse = "-"),
             t(wskazniki(d$wynik[d$etap == k[1]], d$wynik[d$etap == k[2]], as.numeric(k[3]))))
}, names(kontrasty), kontrasty))
rownames(wyn) <- NULL
print(wyn, digits = 3)

# Średni NAP i Tau dla trzech uczniów z wielokrotnej linii bazowej (ważenie równe)
round(colMeans(wyn[wyn$uczen %in% c("A", "B", "C"), c("NAP", "Tau", "TauU_korekta_A", "Tau_bez_trendu_A")]), 3)
Wynik w R
  uczen kontrast nA nB   NAP   Tau S_AB S_trendA TauU_korekta_A tau_trend_A p_trend_A nachylenie_TS_A
1     A      A-B  5 17 1.000 1.000   85       -4          1.047      -0.400   0.32719           -3.00
2     B      A-B  9 13 0.991 0.983  115       11          0.889       0.310   0.24886            1.00
3     C      A-B 13  9 0.966 0.932  109       49          0.513       0.632   0.00274            2.28
4     D    A1-B1  5  6 1.000 1.000   30        5          0.833       0.527   0.20651            1.88
5     D    B1-A2  6  5 1.000 1.000   30       10          0.667       0.690   0.05578            2.00
6     D    A2-B2  5  6 1.000 1.000   30       -6          1.200      -0.600   0.14164           -1.29
  Tau_bez_trendu_A
1           1.0000
2           0.9316
3          -0.0256
4           1.0000
5           1.0000
6           1.0000
             NAP              Tau   TauU_korekta_A Tau_bez_trendu_A
           0.986            0.972            0.816            0.635
Test randomizacyjny dla wielokrotnej linii bazowej
R
# 4. Test randomizacyjny dla wielokrotnej linii bazowej
# Założenie projektu: przed badaniem wylosowano początek treningu każdego ucznia
# z puli dopuszczalnych sesji (A: 5–8, B: 9–12, C: 13–16), czyli 4 × 4 × 4 = 64 możliwe układy.
pule <- list(A = 5:8, B = 9:12, C = 13:16)
statystyka <- function(starty) mean(sapply(names(starty), function(u) {
  y <- dane$wynik[dane$uczen == u]
  mean(y[sesja >= starty[[u]]]) - mean(y[sesja < starty[[u]]])
}))
uklady <- expand.grid(pule)
rozklad <- apply(uklady, 1, function(s) statystyka(as.list(s)))
obs <- statystyka(list(A = 6, B = 10, C = 14))
c(liczba_ukladow = nrow(uklady), obserwowana_roznica = round(obs, 2),
  ile_ukladow_co_najmniej_tak_duzych = sum(rozklad >= obs - 1e-9),
  p_randomizacyjne = round(mean(rozklad >= obs - 1e-9), 4), najmniejsze_mozliwe_p = round(1 / nrow(uklady), 4))
Wynik w R
                    liczba_ukladow                obserwowana_roznica ile_ukladow_co_najmniej_tak_duzych
                           64.0000                            25.4500                             7.0000
                  p_randomizacyjne              najmniejsze_mozliwe_p
                            0.1094                             0.0156
Zapis pliku CSV
R
# 5. Plik do pobrania: dane wszystkich sesji
write.csv(dane[, c("uczen", "schemat", "sesja", "faza", "etap", "wynik")],
          "../badanie-jednego-przypadku-dane.csv", row.names = FALSE, fileEncoding = "UTF-8")
spr <- read.csv("../badanie-jednego-przypadku-dane.csv")
str(spr)
cat(R.version.string, "\n")
Wynik w R
'data.frame':	88 obs. of  6 variables:
 $ uczen  : chr  "A" "A" "A" "A" ...
 $ schemat: chr  "wielokrotna linia bazowa" "wielokrotna linia bazowa" "wielokrotna linia bazowa" "wielokrotna linia bazowa" ...
 $ sesja  : int  1 2 3 4 5 6 7 8 9 10 ...
 $ faza   : chr  "A" "A" "A" "A" ...
 $ etap   : chr  "A" "A" "A" "A" ...
 $ wynik  : int  41 52 50 44 35 70 79 70 64 80 ...
R version 4.5.3 (2026-03-11)
Bibliografia oprogramowania
Obliczenia wykonano w R 4.5.3 z pakietem stats; rysunki przygotowano w pakiecie ggplot2 (zapis SVG: svglite). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy
- Za krótka linia bazowa. Trzy punkty nie pokażą trendu. Przedłuż fazę A, gdy wyniki są niestabilne albo zmierzają w oczekiwanym kierunku.
- Zmiana fazy w reakcji na dane bez reguły. Gdy wprowadzasz interwencję w „dobrym momencie”, łatwo wykorzystać przypadkowy dołek. Ustal regułę z góry albo losuj moment zmiany.
- Test t lub ANOVA na sesjach. Pomiary jednej osoby nie są niezależne. Używaj testu randomizacyjnego albo modelu uwzględniającego autokorelację.
- Sam NAP przy wyraźnym trendzie. Nienakładanie nie widzi trendu. Opisz trend wprost i rozważ wskaźnik z korektą.
- Tau-U bez nazwy wariantu. Wersje z korektą i bez korekty dają różne wyniki, a wartość powyżej 1 nie oznacza „bardzo dużego efektu”.
- Pominięcie przypadku, który nie zadziałał. Uczeń C też należy do wyników. Jego przebieg mówi czytelnikowi, dla kogo interwencja może nie działać.
Najczęstsze pytania
Ile pomiarów potrzeba w linii bazowej w badaniu jednego przypadku?
Tyle, aby było widać poziom i trend wyniku, zwykle co najmniej kilka sesji. Linię bazową przedłuż, gdy wyniki są niestabilne albo już zmierzają w oczekiwanym kierunku. Liczbę sesji porównaj z aktualnymi standardami oceny badań jednego przypadku, np. What Works Clearinghouse.
Czym różni się schemat ABAB od wielokrotnej linii bazowej?
W schemacie ABAB interwencję u jednej osoby wprowadza się, wycofuje i przywraca, więc efekt powinien pojawić się i zniknąć. W wielokrotnej linii bazowej interwencję wprowadza się kolejno u kilku osób, w kilku sytuacjach albo dla kilku zachowań, bez wycofywania. Drugi schemat wybierz, gdy zachowanie nie wraca do poziomu wyjściowego albo wycofanie byłoby nieetyczne.
Dlaczego Tau-U wyszło większe niż 1?
Wersja Tau-U z korektą trendu linii bazowej odejmuje od nienakładania statystykę trendu fazy A. Gdy linia bazowa opada, odejmuje się liczbę ujemną i wynik może przekroczyć 1. To znane ograniczenie tego wskaźnika, a nie dowód wyjątkowo dużego efektu. Podaj wariant Tau-U i opisz trend linii bazowej wprost.
Czy w badaniu jednego przypadku można policzyć test t na sesjach?
Nie jest to dobry pomysł, bo kolejne pomiary jednej osoby są skorelowane w czasie, a test t zakłada ich niezależność, więc zawyża istotność. Gdy moment zmiany fazy był losowany, użyj testu randomizacyjnego. W innym przypadku opieraj się na analizie wizualnej i wskaźnikach efektu albo na modelu, który uwzględnia autokorelację.
Jak opisać wyniki badania jednego przypadku w artykule?
Pokaż wykres wszystkich pomiarów z zaznaczonymi fazami i opisz poziom, trend, zmienność, natychmiastowość i nakładanie się faz u każdej osoby. Podaj wskaźniki liczbowe z nazwą wariantu, a przy schemacie z losowaniem także wynik testu randomizacyjnego. Kompletność opisu sprawdź z listą SCRIBE 2016.
Powiązane hasła
Przeczytaj też
Statystyka w pracy z logopedii
Małe próby, dokładne testy rangowe, zgodność ocen logopedów, test Crawforda–Howella i schemat AB z NAP: plan analiz, APA, dane XLSX i kod R.
Czytaj →PoradnikSzeregi czasowe i ARIMA w praktyce
Trend, sezonowość, ACF i test Ljunga–Boxa, wybór modelu ARIMA w stats::arima, prognoza kontrfaktyczna i regresja segmentowa z kodem R.
Czytaj →PoradnikMetaanaliza krok po kroku
Od pytania do PRISMA 2020: g Hedgesa, model efektów losowych, heterogeniczność i przedział predykcji, moderatory, wykres lejkowy – z kodem metafor.
Czytaj →Planujesz lub opisujesz badanie jednego przypadku?
Pomożemy dobrać schemat i regułę zmiany faz, policzyć wskaźniki efektu i test randomizacyjny oraz opisać wykresy tak, aby recenzent widział, co wynika z danych, a czego nie.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Brossart, D. F., Laird, V. C., & Armstrong, T. W. (2018). Interpreting Kendall’s Tau and Tau-U for single-case experimental designs. Cogent Psychology, 5(1), Article 1518687. https://doi.org/10.1080/23311908.2018.1518687 ● Otwarty dostęp
- Heyvaert, M., & Onghena, P. (2014). Randomization tests for single-case experiments: State of the art, state of the science, and state of the application. Journal of Contextual Behavioral Science, 3(1), 51–64. https://doi.org/10.1016/j.jcbs.2013.10.002 ● Otwarty dostęp: pełny tekst
- Horner, R. H., Carr, E. G., Halle, J., McGee, G., Odom, S., & Wolery, M. (2005). The use of single-subject research to identify evidence-based practice in special education. Exceptional Children, 71(2), 165–179. https://doi.org/10.1177/001440290507100203
- Kratochwill, T. R., Hitchcock, J. H., Horner, R. H., Levin, J. R., Odom, S. L., Rindskopf, D. M., & Shadish, W. R. (2013). Single-case intervention research design standards. Remedial and Special Education, 34(1), 26–38. https://doi.org/10.1177/0741932512452794
- Parker, R. I., & Vannest, K. (2009). An improved effect size for single-case research: Nonoverlap of all pairs. Behavior Therapy, 40(4), 357–367. https://doi.org/10.1016/j.beth.2008.10.006
- Parker, R. I., Vannest, K. J., Davis, J. L., & Sauber, S. B. (2011). Combining nonoverlap and trend for single-case research: Tau-U. Behavior Therapy, 42(2), 284–299. https://doi.org/10.1016/j.beth.2010.08.006
- Shadish, W. R., Hedges, L. V., & Pustejovsky, J. E. (2014). Analysis and meta-analysis of single-case designs with a standardized mean difference statistic: A primer and applications. Journal of School Psychology, 52(2), 123–147. https://doi.org/10.1016/j.jsp.2013.11.005
- Tarlow, K. R. (2017). An improved rank correlation effect size statistic for single-case designs: Baseline corrected Tau. Behavior Modification, 41(4), 427–467. https://doi.org/10.1177/0145445516676750
- Tate, R. L., Perdices, M., Rosenkoetter, U., Shadish, W., Vohra, S., Barlow, D. H., Horner, R., Kazdin, A., Kratochwill, T., McDonald, S., Sampson, M., Shamseer, L., Togher, L., Albin, R., Backman, C., Douglas, J., Evans, J. J., Gast, D., Manolov, R., . . . Wilson, B. (2016). The Single-Case Reporting Guideline In BEhavioural Interventions (SCRIBE) 2016 statement. Archives of Scientific Psychology, 4(1), 1–9. https://doi.org/10.1037/arc0000026 ● Otwarty dostęp
Cytowania BibTeX
@article{brossart2018interpreting, author={Brossart, Daniel F. and Laird, Vanessa C. and Armstrong, Trey W.}, title={{Interpreting Kendall’s Tau and Tau-U for single-case experimental designs}}, journal={Cogent Psychology}, year={2018}, volume={5}, number={1}, eid={1518687}, doi={10.1080/23311908.2018.1518687}}@article{heyvaert2014randomization, author={Heyvaert, Mieke and Onghena, Patrick}, title={{Randomization tests for single-case experiments: State of the art, state of the science, and state of the application}}, journal={Journal of Contextual Behavioral Science}, year={2014}, volume={3}, number={1}, pages={51--64}, doi={10.1016/j.jcbs.2013.10.002}}@article{horner2005use, author={Horner, Robert H. and Carr, Edward G. and Halle, James and McGee, Gail and Odom, Samuel and Wolery, Mark}, title={{The use of single-subject research to identify evidence-based practice in special education}}, journal={Exceptional Children}, year={2005}, volume={71}, number={2}, pages={165--179}, doi={10.1177/001440290507100203}}@article{kratochwill2013single, author={Kratochwill, Thomas R. and Hitchcock, John H. and Horner, Robert H. and Levin, Joel R. and Odom, Samuel L. and Rindskopf, David M. and Shadish, William R.}, title={{Single-case intervention research design standards}}, journal={Remedial and Special Education}, year={2013}, volume={34}, number={1}, pages={26--38}, doi={10.1177/0741932512452794}}@article{parker2009improved, author={Parker, Richard I. and Vannest, Kimberly}, title={{An improved effect size for single-case research: Nonoverlap of all pairs}}, journal={Behavior Therapy}, year={2009}, volume={40}, number={4}, pages={357--367}, doi={10.1016/j.beth.2008.10.006}}@article{parker2011combining, author={Parker, Richard I. and Vannest, Kimberly J. and Davis, John L. and Sauber, Stephanie B.}, title={{Combining nonoverlap and trend for single-case research: Tau-U}}, journal={Behavior Therapy}, year={2011}, volume={42}, number={2}, pages={284--299}, doi={10.1016/j.beth.2010.08.006}}@article{shadish2014analysis, author={Shadish, William R. and Hedges, Larry V. and Pustejovsky, James E.}, title={{Analysis and meta-analysis of single-case designs with a standardized mean difference statistic: A primer and applications}}, journal={Journal of School Psychology}, year={2014}, volume={52}, number={2}, pages={123--147}, doi={10.1016/j.jsp.2013.11.005}}@article{tarlow2017improved, author={Tarlow, Kevin R.}, title={{An improved rank correlation effect size statistic for single-case designs: Baseline corrected Tau}}, journal={Behavior Modification}, year={2017}, volume={41}, number={4}, pages={427--467}, doi={10.1177/0145445516676750}}@article{tate2016scribe, author={Tate, Robyn L. and Perdices, Michael and Rosenkoetter, Ulrike and Shadish, William and Vohra, Sunita and Barlow, David H. and Horner, Robert and Kazdin, Alan and Kratochwill, Thomas and McDonald, Skye and Sampson, Margaret and Shamseer, Larissa and Togher, Leanne and Albin, Richard and Backman, Catherine and Douglas, Jacinta and Evans, Jonathan J. and Gast, David and Manolov, Rumen and Mitchell, Geoffrey and Nickels, Lyndsey and Nikles, Jane and Ownsworth, Tamara and Rose, Miranda and Schmid, Christopher H. and Wilson, Barbara}, title={{The Single-Case Reporting Guideline In BEhavioural Interventions (SCRIBE) 2016 statement}}, journal={Archives of Scientific Psychology}, year={2016}, volume={4}, number={1}, pages={1--9}, doi={10.1037/arc0000026}}