Co to jest trafność wewnętrzna badania?
Trafność wewnętrzna (ang. internal validity) to stopień, w jakim wynik badania uprawnia do wniosku, że zmiana zmiennej niezależnej spowodowała zmianę zmiennej zależnej – a nie coś innego, co działo się w tym samym czasie. Pytanie brzmi: czy różnicę między grupami albo między pomiarem przed i po można przypisać manipulacji, czy istnieje dla niej konkurencyjne wyjaśnienie?
To pojęcie dotyczy planu badania, a nie narzędzia pomiarowego. Nie myl go z trafnością testu, która mówi, czy wynik skali znaczy to, co ma znaczyć. Badanie może mierzyć stres doskonałym kwestionariuszem i mimo to mieć niską trafność wewnętrzną, jeśli nie ma grupy kontrolnej. Pojęcie wprowadził Campbell (1957) w analizie czynników zagrażających wnioskom z eksperymentów w naukach społecznych. Rozwinięcie, razem z typologią planów eksperymentalnych i quasi-eksperymentalnych, zawiera klasyczny podręcznik Shadisha i in. (2002).
Zagrożenia trafności wewnętrznej
Campbell (1957) wyróżnił siedem kategorii zmiennych ubocznych, które mogą podszyć się pod efekt manipulacji. Do dziś to podstawowa lista kontrolna:
| Zagrożenie | Przykład | Co pomaga |
|---|---|---|
| Historia | Między pomiarami kończy się sesja egzaminacyjna i stres spada u wszystkich | Grupa kontrolna badana w tym samym czasie |
| Dojrzewanie | Uczniowie po roku lepiej czytają niezależnie od programu | Grupa kontrolna w tym samym wieku |
| Efekt testowania | Drugie wypełnienie testu wiedzy jest łatwiejsze dzięki pierwszemu | Wersje równoległe, plan Salomona |
| Zmiana narzędzia | Inny oceniający przy pomiarze końcowym, zmęczenie obserwatorów | Stałe procedury, ślepa ocena |
| Regresja statystyczna | Do programu trafiają osoby z najwyższym wynikiem, który przy kolejnym pomiarze spada | Grupa kontrolna dobrana tak samo, losowy przydział |
| Selekcja | Na warsztat zapisują się osoby bardziej zmotywowane | Randomizacja |
| Ubytek osób (mortality) | Z grupy eksperymentalnej odpadają osoby, którym interwencja nie pomaga | Analiza wszystkich przydzielonych osób, porównanie osób, które odpadły |
Do tej listy dopisuje się zwykle jeszcze dwa zagrożenia: niejasną kolejność czasową (co było przyczyną, a co skutkiem) i interakcje zagrożeń, np. selekcji z dojrzewaniem, gdy grupy różnią się tempem rozwoju. W badaniach korelacyjnych najczęstszym zagrożeniem jest zmienna zakłócająca, która tworzy korelację pozorną.
Przykład: warsztat redukcji stresu
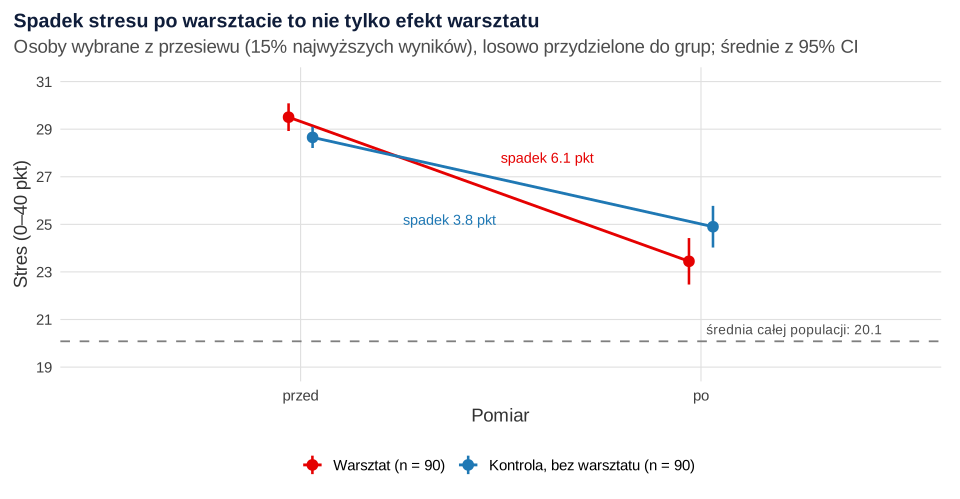
Poradnia uczelniana przebadała skalą stresu (0–40 punktów) 1200 osób studiujących w szczycie sesji (dane symulowane). Do badania zaproszono 15% osób z najwyższym wynikiem, czyli 180 osób z wynikiem co najmniej 26.13. Prawdziwy efekt warsztatu w symulacji wynosi −2 punkty. Do tego koniec sesji obniża stres u wszystkich o 1.5 punktu, a pomiar ma rzetelność ok. .76.
Plan A – tylko grupa z warsztatem, pomiar przed i po. U 90 osób z warsztatem stres spadł z 29.50 do 23.45 punktu, czyli o 6.06 punktu, 95% CI [5.26, 6.85]. Test t dla prób zależnych dał t(89) = −15.15, p < .001. Wniosek „warsztat obniża stres o 6 punktów” jest jednak trzykrotnie zawyżony.
Plan B – losowy przydział do warsztatu i grupy kontrolnej. W grupie kontrolnej, bez żadnych zajęć, stres też spadł: z 28.65 do 24.90 punktu, czyli o 3.75 punktu, 95% CI [2.95, 4.56]. Ten spadek to suma dwóch zagrożeń z tabeli. Pierwsze to historia (koniec sesji). Drugie to regresja do średniej: osoby wybrane z powodu skrajnie wysokiego wyniku przy kolejnym pomiarze wypadają przeciętnie bliżej średniej. Efekt warsztatu oszacowany w ANCOVA z wynikiem wyjściowym jako kowariantem wynosi −2.23 punktu, 95% CI [−3.37, −1.09], t(177) = −3.87, p < .001, czyli jest bliski prawdziwym −2.
Barnett i in. (2005) zwracają uwagę, że regresja do średniej jest najsilniejsza przy dużym błędzie pomiaru i wtedy, gdy do dalszego badania wybiera się osoby na podstawie skrajnego wyniku wyjściowego. Tak właśnie rekrutuje się uczestników wielu interwencji. Autorzy zalecają radzenie sobie z tym zjawiskiem już na etapie planu badania, a nie tylko w analizie.
Jak zwiększyć trafność wewnętrzną
- Losowy przydział do warunków. Randomizacja wyrównuje grupy pod względem znanych i nieznanych cech, więc eliminuje selekcję jako wyjaśnienie. To najmocniejsze narzędzie, jakim dysponuje badacz.
- Grupa kontrolna badana równolegle. Neutralizuje historię, dojrzewanie, efekt testowania i regresję, bo działają one w obu grupach tak samo.
- Stałe warunki i jedna różnica. Grupy powinny różnić się tylko manipulacją – zgodnie z kanonem jednej różnicy.
- Kontrola oczekiwań. Ślepa próba dla badanych i oceniających ogranicza wpływ oczekiwań i zmiany narzędzia.
- Kontrbalansowanie w planach wewnątrzosobowych – zob. kontrbalansowanie.
- Monitorowanie ubytku. Raportuj, ile osób odpadło z każdej grupy i czy różniły się od pozostałych na początku.
Gdy losowy przydział jest niemożliwy, np. bo interwencję dostaje cała klasa albo cały oddział, wybierz porównywalną grupę, która interwencji nie dostanie, i zmierz obie grupy przed i po. Jeszcze lepiej zrobić dwa pomiary wyjściowe: pokażą, czy grupy zmieniały się podobnie, zanim cokolwiek się wydarzyło. W dyskusji przejdź przez listę zagrożeń z tabeli i przy każdym napisz, czy plan je wyklucza, czy tylko ogranicza.
Plan badania wyznacza górną granicę trafności wewnętrznej. Schemat eksperymentalny z randomizacją daje jej najwięcej. Schemat quasi-eksperymentalny wymaga wykluczania zagrożeń jedno po drugim. Schemat korelacyjny zwykle nie pozwala na wnioski przyczynowe. Trafność wewnętrzna często konkuruje z trafnością zewnętrzną: im bardziej kontrolowane warunki, tym trudniej uogólnić wynik na codzienne sytuacje.
Jak opisać trafność wewnętrzną w pracy
W rozdziale metodologicznym opisz sposób przydziału do grup, obecność i rodzaj grupy kontrolnej oraz to, kto znał przydział. W dyskusji wymień zagrożenia, których plan nie wyklucza, i oceń, jak mogły wpłynąć na wynik. Taki zapis jest konkretny i chroni przed zarzutem recenzenta. Wzory zdań do części metodologicznej znajdziesz w poradniku Rozdział metodologiczny – jak go napisać.
Przykład w R
Kod symuluje przesiew, wybór osób z najwyższym stresem i losowy przydział do warsztatu lub grupy kontrolnej. Następnie porównuje wniosek z planu bez grupy kontrolnej (test t dla prób zależnych) z oszacowaniem z eksperymentu (ANCOVA). Liczby w tekście pochodzą z tego kodu.
Pomiar przed i po bez kontroli a eksperyment z ANCOVA
R
# R162 – trafność wewnętrzna: ten sam warsztat oceniany w planie bez grupy kontrolnej i w eksperymencie
# Dane symulowane: przesiew 1200 osób studiujących skalą stresu 0–40; do badania trafia 15% z najwyższym wynikiem
set.seed(162)
P <- 1200
stres_prawdziwy <- rnorm(P, 20, 5)
pomiar1 <- stres_prawdziwy + rnorm(P, 0, 2.9)            # rzetelność ok. .75
prog <- quantile(pomiar1, 0.85)
wyb <- which(pomiar1 >= prog)
n <- length(wyb); n
round(c(rzetelnosc = cor(pomiar1, stres_prawdziwy + rnorm(P, 0, 2.9)), prog = unname(prog)), 2)
efekt_warsztatu <- -2.0                                   # prawdziwy efekt
historia <- -1.5                                          # koniec sesji: stres spada u wszystkich
pre <- pomiar1[wyb]
grupa <- sample(rep(c("warsztat", "kontrola"), length.out = n))
post <- stres_prawdziwy[wyb] + historia + efekt_warsztatu * (grupa == "warsztat") + rnorm(n, 0, 2.9)

# Plan A: tylko grupa z warsztatem, pomiar przed i po
A <- grupa == "warsztat"
tA <- t.test(post[A], pre[A], paired = TRUE)
round(c(M_pre = mean(pre[A]), M_post = mean(post[A]), zmiana = unname(tA$estimate), dolna = tA$conf.int[1], gorna = tA$conf.int[2], t = unname(tA$statistic), df = unname(tA$parameter), p = tA$p.value), 3)
# Ta sama zmiana w grupie kontrolnej (bez warsztatu)
tK <- t.test(post[!A], pre[!A], paired = TRUE)
round(c(M_pre = mean(pre[!A]), M_post = mean(post[!A]), zmiana = unname(tK$estimate), dolna = tK$conf.int[1], gorna = tK$conf.int[2], p = tK$p.value), 3)

# Plan B: randomizacja + ANCOVA (wynik po, kontrola wyniku przed)
d <- data.frame(pre, post, grupa = factor(grupa, levels = c("kontrola", "warsztat")))
mB <- lm(post ~ pre + grupa, data = d)
round(cbind(b = coef(mB), confint(mB))["grupawarsztat", ], 2)
s <- summary(mB)$coefficients["grupawarsztat", ]
round(c(t = unname(s["t value"]), df = mB$df.residual, p = unname(s["Pr(>|t|)"])), 3)
Wynik w R
[1] 180
rzetelnosc       prog
      0.76      26.13
  M_pre  M_post  zmiana   dolna   gorna       t      df       p
 29.503  23.447  -6.056  -6.851  -5.262 -15.145  89.000   0.000
 M_pre M_post zmiana  dolna  gorna      p
28.654 24.900 -3.754 -4.556 -2.952  0.000
     b  2.5 % 97.5 %
 -2.23  -3.37  -1.09
      t      df       p
 -3.868 177.000   0.000
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietu stats: t.test(), lm()); rysunek przygotowano w ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Pomiar przed i po bez grupy kontrolnej jako dowód skuteczności. W przykładzie taki plan pokazał spadek o 6.06 punktu, z czego warsztat odpowiadał za około 2.
- Rekrutacja na podstawie skrajnego wyniku i porównanie z grupą „normalną”. Grupa wybrana z powodu wysokiego wyniku obniży go przy kolejnym pomiarze nawet bez interwencji.
- Grupy utworzone przez samych badanych. Ochotnicy różnią się od osób, które się nie zgłosiły, więc porównanie grup jest porównaniem dwóch populacji.
- Usuwanie osób, które przerwały udział. Analiza tylko osób, które „dotrwały”, może sztucznie poprawić wynik grupy eksperymentalnej.
- Język przyczynowy w badaniu korelacyjnym. Zdania „stres powoduje” albo „wsparcie chroni” wymagają planu z manipulacją. W badaniu korelacyjnym pisz o związku.
- Mylenie trafności wewnętrznej badania z trafnością narzędzia. Dobrze zwalidowany kwestionariusz nie naprawi słabego planu badania.
Najczęstsze pytania
Co zagraża trafności wewnętrznej badania?
Klasyczna lista Campbella obejmuje historię, dojrzewanie, efekt testowania, zmianę narzędzia, regresję statystyczną, selekcję i ubytek osób. Każde z tych zjawisk może wywołać zmianę wyników, którą łatwo pomylić z efektem manipulacji. W badaniach korelacyjnych głównym zagrożeniem są zmienne zakłócające.
Jak zwiększyć trafność wewnętrzną eksperymentu?
Przydzielaj osoby do warunków losowo, badaj grupę kontrolną równolegle z eksperymentalną, utrzymuj stałe procedury i pozwól, by grupy różniły się tylko manipulacją. Tam, gdzie to możliwe, stosuj ślepą próbę i raportuj ubytek osób w każdej grupie.
Dlaczego badanie przed i po bez grupy kontrolnej ma niską trafność wewnętrzną?
Bo zmiany między pomiarami mogą wynikać z wielu przyczyn poza interwencją: zdarzeń zewnętrznych, dojrzewania, oswojenia z testem i regresji do średniej. W symulacji na tej stronie stres w grupie z warsztatem spadł o 6.06 punktu, ale w grupie kontrolnej bez warsztatu też spadł – o 3.75 punktu.
Czy badanie korelacyjne może mieć trafność wewnętrzną?
Pojęcie odnosi się do wniosków przyczynowych, więc w badaniu korelacyjnym trafność wewnętrzna jest zwykle niska. Bez manipulacji i losowego przydziału nie da się wykluczyć zmiennych zakłócających ani ustalić kierunku zależności. Kontrola statystyczna częściowo pomaga, ale nie zastępuje eksperymentu.
Czy trafność wewnętrzna i zewnętrzna się wykluczają?
Nie wykluczają się, ale często ze sobą konkurują. Ścisła kontrola warunków w laboratorium zwiększa trafność wewnętrzną, a jednocześnie utrudnia uogólnianie wyników na codzienne sytuacje. Dobry program badań łączy eksperymenty kontrolowane z badaniami w warunkach naturalnych.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Metodologia badań – zadania z rozwiązaniami
Dziesięć zadań: zmienne i skale, schemat badania, zagrożenia trafności, regresja do średniej, hipotezy, operacjonalizacja, dobór próby, mediator i moderator.
Czytaj →PoradnikQuasi-eksperyment i różnica w różnicach (DiD)
Ocena programu bez losowania: równoległe trendy, regresja z interakcją, błędy klastrowane, model zdarzeń, test placebo, zagrożenia trafności i kod R.
Czytaj →PoradnikRozdział metodologiczny – jak go napisać
Co napisać w każdym podrozdziale metody: hipotezy, zmienne, próba, narzędzia, procedura, etyka i plan analiz – z wzorami zdań i listą JARS.
Czytaj →PoradnikPytania badawcze i hipotezy
Od problemu do hipotezy, którą da się sprawdzić: rodzaje pytań, hipotezy kierunkowe, H0 i H1, test jednostronny, przykłady źle i dobrze oraz wzory zapisu.
Czytaj →PoradnikPytania z metodologii na obronę
Pytania promotora, recenzenta i komisji ułożone według typu badania – od eksperymentu i sondażu po przegląd systematyczny – oraz pojęcia, o które pytają „z definicji”.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Barnett, A. G., van der Pols, J. C., & Dobson, A. J. (2005). Regression to the mean: What it is and how to deal with it. International Journal of Epidemiology, 34(1), 215–220. https://doi.org/10.1093/ije/dyh299 ● Otwarty dostęp
- Campbell, D. T. (1957). Factors relevant to the validity of experiments in social settings. Psychological Bulletin, 54(4), 297–312. https://doi.org/10.1037/h0040950
- Shadish, W. R., Cook, T. D., & Campbell, D. T. (2002). Experimental and quasi-experimental designs for generalized causal inference. Houghton Mifflin.
Cytowania BibTeX
@article{barnett2005regression, author={Barnett, Adrian G. and van der Pols, Jolieke C. and Dobson, Annette J.}, title={{Regression to the mean: What it is and how to deal with it}}, journal={International Journal of Epidemiology}, year={2005}, volume={34}, number={1}, pages={215--220}, doi={10.1093/ije/dyh299}}@article{campbell1957factors, author={Campbell, Donald T.}, title={{Factors relevant to the validity of experiments in social settings}}, journal={Psychological Bulletin}, year={1957}, volume={54}, number={4}, pages={297--312}, doi={10.1037/h0040950}}@book{shadish2002experimental, author={Shadish, William R. and Cook, Thomas D. and Campbell, Donald T.}, title={{Experimental and quasi-experimental designs for generalized causal inference}}, year={2002}, publisher={Houghton Mifflin}}