Co to jest trafność zbieżna?
Trafność zbieżna (ang. convergent validity) to dowód, że wyniki testu są zgodne z wynikami innych miar tego samego konstruktu. Jeśli nowa skala empatii mierzy empatię, to osoby z wysokim wynikiem powinny mieć wysokie wyniki także w uznanym kwestionariuszu empatii i w ocenach osób, które dobrze je znają.
Trafność zbieżna jest jednym ze źródeł dowodów trafności i niemal zawsze sprawdza się ją razem z trafnością różnicową. Wysoka korelacja z miarą tego samego konstruktu niewiele znaczy, jeśli równie wysoka jest korelacja z miarą czegoś innego. Obie idee opisali razem Campbell i Fiske (1959), wprowadzając macierz wielu cech i wielu metod (MTMM). Clark i Watson (2019) wśród zaleceń budowy skal wymieniają sprawdzanie trafności zbieżnej i różnicowej oraz testowanie puli pozycji względem bliskich konstruktów.
Trafność zbieżną łatwo pomylić z trafnością kryterialną. Różnica dotyczy tego, z czym porównujesz wynik. W trafności zbieżnej jest to inna miara tego samego konstruktu. W kryterialnej – zewnętrzne kryterium praktyczne, np. diagnoza, oceny w pracy czy liczba nieobecności.
Jak silna powinna być korelacja?
Nie ma jednego progu, bo oczekiwana siła związku zależy od tego, jak bardzo różnią się porównywane miary:
- Ta sama metoda, podobne pozycje (np. krótka i długa wersja tego samego kwestionariusza) – oczekuj korelacji bardzo wysokich, często powyżej .80. Taki wynik jest jednak słabym dowodem, bo obie miary dzielą metodę i treść.
- Ta sama metoda, inna operacjonalizacja (dwa różne kwestionariusze samoopisowe) – zwykle .50–.70.
- Różne metody (samoopis i ocena innej osoby, kwestionariusz i obserwacja) – korelacje .30–.60 bywają dobrym wynikiem. To najmocniejszy dowód, bo zgodności nie da się wytłumaczyć wspólnym stylem odpowiadania.
Podane zakresy to orientacyjne wartości z praktyki, a nie normy. Lepiej niż porównywać wynik z progiem jest zapisać przed badaniem, jakiej korelacji oczekujesz i dlaczego. Pamiętaj też, że obserwowana korelacja jest obniżona przez nierzetelność obu miar, a podwyższona przez wspólną wariancję metody.
Macierz wielu cech i wielu metod (MTMM)
W macierzy MTMM co najmniej dwie cechy mierzy się co najmniej dwiema metodami i zestawia wszystkie korelacje w jednej tabeli. Wyróżnia się w niej cztery rodzaje wartości:
- przekątna rzetelności – rzetelność każdej miary;
- przekątna trafności – ta sama cecha, różne metody; to właśnie dowody trafności zbieżnej;
- różne cechy, ta sama metoda – pokazują, ile zgodności daje sama metoda;
- różne cechy, różne metody – tło, czyli związki, których nie łączy ani cecha, ani metoda.
Trafność zbieżna jest przekonująca, gdy wartości na przekątnej trafności są wyraźnie różne od zera i wyższe niż korelacje różnych cech mierzonych tą samą metodą. Gdy jest odwrotnie, miary więcej łączy metoda niż cecha.
Przykład: empatia w samoopisie i w oczach współlokatora
Sto osiemdziesiąt par współlokatorów (dane symulowane) wypełniło po dwie 6-pozycyjne skale: empatii i asertywności. Każda osoba opisała siebie, a współlokator ocenił ją tymi samymi skalami. Powstała macierz 4 × 4:
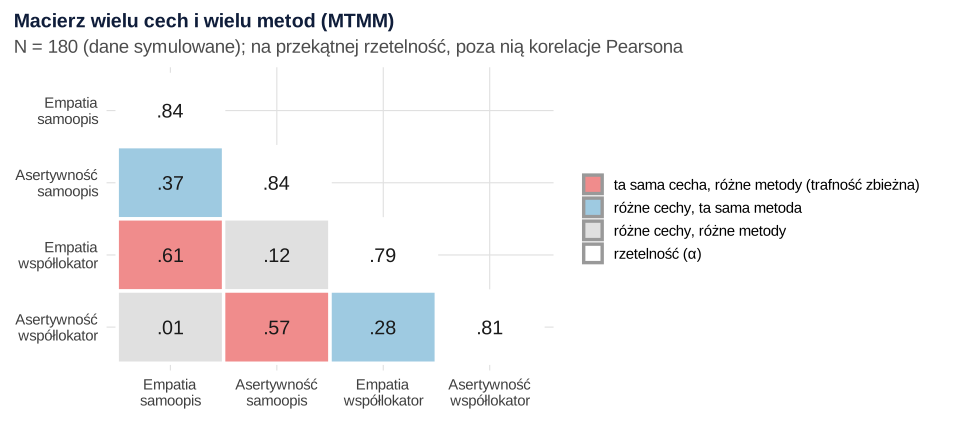
Samoopis empatii korelował z oceną współlokatora na poziomie r = .61, 95% CI [.51, .70], p < .001, a samoopis asertywności – na poziomie r = .57, 95% CI [.46, .66], p < .001. Średnia z przekątnej trafności (.59) jest wyraźnie wyższa niż średnia korelacja różnych cech mierzonych tą samą metodą (.32). Ta z kolei przewyższa tło (.06). Taki układ to dobry dowód trafności zbieżnej.
Jedna wartość wymaga komentarza: empatia i asertywność w samoopisie korelują na poziomie .37, a w ocenach współlokatora – .28. Osoby badane i oceniający mają pewien ogólny styl oceniania („wszystko dobrze” albo „wszystko średnio”). Dlatego korelacje dwóch skal z tego samego kwestionariusza są wyższe, niż wynikałoby z samych cech. Bez drugiej metody nie dałoby się tego zauważyć.
Skorygowana na nierzetelność korelacja dwóch miar empatii wynosi .61 / √(.84 × .79) = .75. Ta wartość opisuje zgodność samych konstruktów i pokazuje, ile miejsca na rozbieżność zostawia błąd pomiaru (zob. rzetelność).
Trafność zbieżna w modelach CFA i SEM
W modelach z ukrytymi zmiennymi trafność zbieżną ocenia się także wewnątrz jednej skali: czy pozycje silnie ładują swój czynnik. Fornell i Larcker (1981) zaproponowali w tym celu miary wariancji wspólnej, z których najczęściej używa się średniej wyodrębnionej wariancji (AVE), czyli średniego kwadratu standaryzowanych ładunków czynnikowych. Konwencjonalnie oczekuje się AVE co najmniej .50, czyli sytuacji, w której czynnik wyjaśnia przeciętnie co najmniej połowę wariancji pozycji. To jednak dowód spójności pozycji, a nie zbieżności z niezależną miarą tego samego konstruktu. W pracy, która waliduje skalę, podawaj obie rzeczy: AVE z CFA i korelacje z innymi miarami.
Jak zaplanować badanie trafności zbieżnej
- Wybierz miarę porównawczą o znanej trafności. Najlepiej uznane narzędzie z polską adaptacją i opublikowanymi danymi o rzetelności.
- Dodaj inną metodę, jeśli tylko się da. Ocena bliskiej osoby, obserwacja, zadanie behawioralne albo dane z dokumentacji dają mocniejszy dowód niż drugi kwestionariusz.
- Dołóż miarę konstruktu pokrewnego, ale innego. Bez niej nie sprawdzisz, czy zbieżność nie wynika z ogólnego stylu odpowiadania.
- Zapisz przewidywania. Określ, które korelacje mają być wysokie, które umiarkowane, a które bliskie zera.
- Zaplanuj liczebność. Przy 100 osobach 95% przedział dla r = .50 ma szerokość około .30, a przy 180 osobach – około .22.
Jak opisać trafność zbieżną w pracy (APA)
Podaj, z jaką miarą porównano wynik i dlaczego jest to miara tego samego konstruktu, a potem korelację z 95% CI. Napisz, jakiej siły związku oczekiwano. Gdy masz kilka miar, zestaw korelacje w tabeli (wzór: tabela korelacji w APA) i umieść rzetelności na przekątnej.
Jak zaplanować walidację nowej skali – od wyboru miar porównawczych po ich analizę – pokazuje wpis Jak zbudować i zwalidować skalę psychometryczną?
Przykład w R
Kod symuluje dwie cechy mierzone dwiema metodami, buduje macierz MTMM z rzetelnościami na przekątnej, liczy korelacje na przekątnej trafności z 95% CI, średnie w blokach macierzy i korelację skorygowaną na nierzetelność. Liczby w tekście pochodzą z tego kodu.
Macierz MTMM i przekątna trafności
R
# R163 – trafność zbieżna: macierz wielu cech i wielu metod (MTMM), dane symulowane
# Cechy: empatia (EMP) i asertywność (ASE); metody: samoopis (S) i ocena współlokatora (W); N = 180 par
suppressPackageStartupMessages(library(psych))
set.seed(163)
N <- 180
cechy <- MASS::mvrnorm(N, c(0, 0), matrix(c(1, .20, .20, 1), 2))
met_S <- rnorm(N); met_W <- rnorm(N)                       # styl odpowiadania w samoopisie / styl oceniającego
skala <- function(cecha, metoda, l_c, l_m, k = 6) {
  poz <- sapply(1:k, function(j) findInterval(l_c * cecha + l_m * metoda + rnorm(N, 0, 0.75), c(-1.5, -0.5, 0.5, 1.5)) + 1)
  list(wynik = rowMeans(poz), alfa = psych::alpha(as.data.frame(poz), warnings = FALSE)$total$raw_alpha)
}
EMP_S <- skala(cechy[, 1], met_S, .62, .40); ASE_S <- skala(cechy[, 2], met_S, .62, .40)
EMP_W <- skala(cechy[, 1], met_W, .55, .35); ASE_W <- skala(cechy[, 2], met_W, .58, .35)
miary <- list(EMP_S = EMP_S, ASE_S = ASE_S, EMP_W = EMP_W, ASE_W = ASE_W)
R <- cor(sapply(miary, `[[`, "wynik"))
diag(R) <- sapply(miary, `[[`, "alfa")           # na przekątnej rzetelność (α)
round(R, 2)

# Przekątna trafności (ta sama cecha, różne metody) z 95% CI
ct <- function(a, b) { t <- cor.test(a, b); round(c(r = unname(t$estimate), dolna = t$conf.int[1], gorna = t$conf.int[2], p = t$p.value), 3) }
rbind(empatia = ct(EMP_S$wynik, EMP_W$wynik), asertywnosc = ct(ASE_S$wynik, ASE_W$wynik))
# Średnie w blokach porównawczych
c(trafnosc_zbiezna = mean(c(R["EMP_S", "EMP_W"], R["ASE_S", "ASE_W"])),
  rozne_cechy_ta_sama_metoda = mean(c(R["EMP_S", "ASE_S"], R["EMP_W", "ASE_W"])),
  rozne_cechy_rozne_metody = mean(c(R["EMP_S", "ASE_W"], R["ASE_S", "EMP_W"]))) |> round(2)

# Korekta na nierzetelność dla empatii
round(R["EMP_S", "EMP_W"] / sqrt(EMP_S$alfa * EMP_W$alfa), 2)

# Planowanie: szerokość 95% CI dla r = .50 przy N = 100 i N = 180 (transformacja Fishera)
szer <- function(N, r = .50) diff(tanh(atanh(r) + c(-1, 1) * qnorm(0.975) / sqrt(N - 3)))
round(c(N100 = szer(100), N180 = szer(180)), 2)
Wynik w R
      EMP_S ASE_S EMP_W ASE_W
EMP_S  0.84  0.37  0.61  0.01
ASE_S  0.37  0.84  0.12  0.57
EMP_W  0.61  0.12  0.79  0.28
ASE_W  0.01  0.57  0.28  0.81
                r dolna gorna p
empatia     0.612 0.512 0.696 0
asertywnosc 0.571 0.463 0.662 0
          trafnosc_zbiezna rozne_cechy_ta_sama_metoda
                      0.59                       0.32
  rozne_cechy_rozne_metody
                      0.06
[1] 0.75
N100 N180
0.30 0.22
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3; α policzono w pakiecie psych, dane wygenerowano funkcją mvrnorm() z pakietu MASS, a rysunek przygotowano w ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Korelacja z prawie identyczną skalą jako dowód. Krótka wersja kwestionariusza zawsze silnie koreluje z długą, bo dzieli z nią pozycje. To dowód zgodności wersji, a nie trafności zbieżnej konstruktu.
- Tylko jedna metoda. Gdy wszystkie miary są samoopisowe, część zgodności wynika ze stylu odpowiadania. W przykładzie różne cechy w samoopisie korelowały na poziomie .37.
- Brak porównania z trafnością różnicową. Korelacja .55 z miarą tego samego konstruktu traci wartość, jeśli korelacja z miarą innego konstruktu wynosi .50.
- AVE jako jedyny dowód trafności zbieżnej. AVE mówi o spójności pozycji jednej skali, a nie o zgodności z niezależną miarą konstruktu.
- Brak przewidywań. Bez zapisanej z góry oczekiwanej siły związku każdy wynik można uznać za „zadowalający”.
- Sama wartość p. Istotna korelacja .20 przy dużej próbie to słaby dowód zbieżności. Podawaj siłę związku z przedziałem ufności (zob. przedział ufności).
Najczęstsze pytania
Jaka korelacja świadczy o trafności zbieżnej?
Nie ma jednego progu. Dla dwóch różnych kwestionariuszy samoopisowych tego samego konstruktu typowe są korelacje .50–.70, a dla różnych metod (np. samoopis i ocena innej osoby) dobrym wynikiem bywa już .30–.60. Zapisz oczekiwaną siłę związku przed badaniem i podaj korelację z 95% przedziałem ufności.
Czym jest macierz MTMM?
Macierz wielu cech i wielu metod (multitrait-multimethod) zestawia korelacje co najmniej dwóch cech mierzonych co najmniej dwiema metodami. Trafność zbieżną pokazuje przekątna trafności, czyli korelacje tej samej cechy mierzonej różnymi metodami. Powinny one przewyższać korelacje różnych cech mierzonych tą samą metodą.
Czy AVE powyżej .50 oznacza trafność zbieżną?
AVE powyżej .50 oznacza, że czynnik wyjaśnia przeciętnie co najmniej połowę wariancji swoich pozycji, więc pozycje są spójne. W modelach SEM nazywa się to często trafnością zbieżną, ale nie jest to dowód zgodności z niezależną miarą tego samego konstruktu. W walidacji skali podawaj oba rodzaje dowodów.
Czym różni się trafność zbieżna od kryterialnej?
W trafności zbieżnej porównujesz test z inną miarą tego samego konstruktu, np. dwoma kwestionariuszami empatii. W trafności kryterialnej porównujesz go z zewnętrznym kryterium praktycznym, np. diagnozą, ocenami w pracy albo liczbą nieobecności, które test ma przewidywać lub odtwarzać.
Czy korelacja krótkiej i długiej wersji skali to trafność zbieżna?
To słaby dowód. Wersja krótka dzieli z długą pozycje i metodę, więc wysoka korelacja jest niemal zagwarantowana. Pokazuje ona zgodność wersji, a nie to, że skala mierzy zamierzony konstrukt. Trafność zbieżną wykaż porównaniem z niezależną miarą, najlepiej inną metodą.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Jak zbudować i zwalidować skalę psychometryczną?
Od definicji konstruktu i tworzenia pozycji po pilotaż, EFA, CFA, rzetelność, trafność teoretyczną, różnicową i niezmienniczość.
Czytaj →PoradnikCB-SEM – założenia i interpretacja
Identyfikacja, ML, MLR i WLSMV, test χ² i indeksy dopasowania bez magicznych progów, moc, modele równoważne i raport – z symulacjami w R.
Czytaj →PoradnikTrafność zbieżna i różnicowa: AVE i HTMT
AVE i rzetelność złożona z ładunków lavaan, HTMT z bootstrapem, krytyka Fornella–Larckera i co zrobić, gdy dwa konstrukty są trudne do odróżnienia.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Campbell, D. T., & Fiske, D. W. (1959). Convergent and discriminant validation by the multitrait-multimethod matrix. Psychological Bulletin, 56(2), 81–105. https://doi.org/10.1037/h0046016 ● Otwarty dostęp: pełny tekst
- Clark, L. A., & Watson, D. (2019). Constructing validity: New developments in creating objective measuring instruments. Psychological Assessment, 31(12), 1412–1427. https://doi.org/10.1037/pas0000626 ● Otwarty dostęp
- Fornell, C., & Larcker, D. F. (1981). Evaluating structural equation models with unobservable variables and measurement error. Journal of Marketing Research, 18(1), 39–50. https://doi.org/10.1177/002224378101800104
Cytowania BibTeX
@article{campbell1959convergent, author={Campbell, Donald T. and Fiske, Donald W.}, title={{Convergent and discriminant validation by the multitrait-multimethod matrix}}, journal={Psychological Bulletin}, year={1959}, volume={56}, number={2}, pages={81--105}, doi={10.1037/h0046016}}@article{clark2019constructing, author={Clark, Lee Anna and Watson, David}, title={{Constructing validity: New developments in creating objective measuring instruments}}, journal={Psychological Assessment}, year={2019}, volume={31}, number={12}, pages={1412--1427}, doi={10.1037/pas0000626}}@article{fornell1981evaluating, author={Fornell, Claes and Larcker, David F.}, title={{Evaluating structural equation models with unobservable variables and measurement error}}, journal={Journal of Marketing Research}, year={1981}, volume={18}, number={1}, pages={39--50}, doi={10.1177/002224378101800104}}