Co to jest korelacja tau Kendalla?
Korelacja tau Kendalla (τ, współczynnik korelacji rang Kendalla; ang. Kendall’s tau) mierzy siłę i kierunek monotonicznego związku dwóch zmiennych na podstawie par obserwacji. Dla każdej pary osób sprawdza, czy obie zmienne zmieniają się w tym samym kierunku (para zgodna), czy w przeciwnych (para niezgodna). Miarę tę zaproponował Kendall (1938) jako nowy współczynnik korelacji rang. Przyjmuje wartości od −1 do +1.
Tau Kendalla należy do tej samej rodziny co korelacja Spearmana: obie zależą wyłącznie od uporządkowania wyników (rang), więc nadają się do danych ze skali porządkowej i do związków monotonicznych, ale nieliniowych. Ma za to prostą interpretację probabilistyczną: bez rang wiązanych τ to różnica między prawdopodobieństwem, że losowo wybrana para osób jest zgodna, a prawdopodobieństwem, że jest niezgodna. Ogólne pojęcie i inne współczynniki opisujemy w haśle korelacja.
Pary zgodne i niezgodne – wzór i przykład krok po kroku
Para osób (i, j) jest zgodna, gdy osoba z wyższym wynikiem w X ma też wyższy wynik w Y, a niezgodna, gdy ma wynik niższy. Jeśli C to liczba par zgodnych, D – niezgodnych, a n – liczba osób, to w danych bez rang wiązanych:
Mianownik to liczba wszystkich par. Przykład: sześć osób podało, ile godzin spało przed badaniem (5, 6, 7, 8, 9 i 10 godzin), i rozwiązało test uwagi (12, 15, 11, 18, 17 i 20 punktów). Sześć osób tworzy 15 par. Niezgodne są tylko trzy: osoby 1 i 3 (osoba 3 spała dłużej, ale miała gorszy wynik), 2 i 3 oraz 4 i 5. Pozostałe 12 par jest zgodnych (rysunek 1).
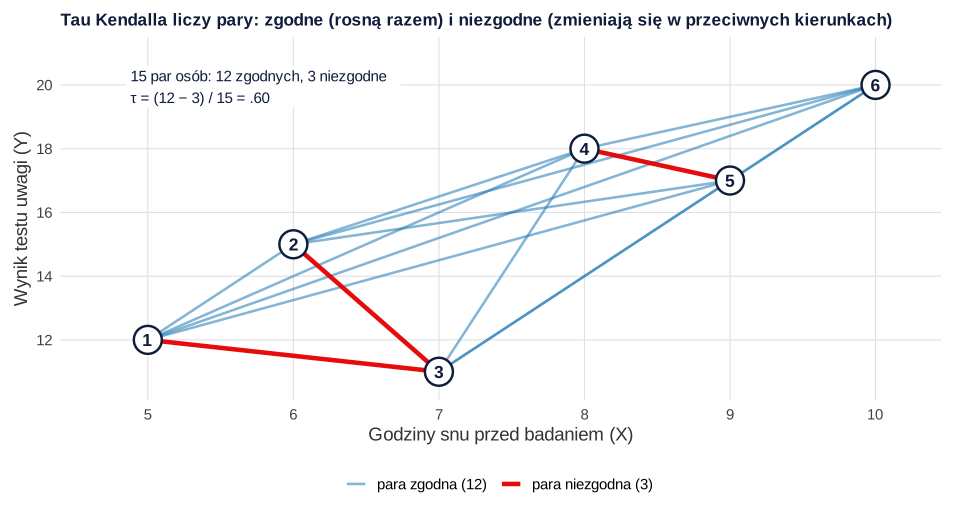
Interpretacja jest bezpośrednia: 12 z 15 par (80%) jest zgodnych, a 3 (20%) niezgodne, więc dla losowo wybranej pary osób zgodność kierunku jest o 60 punktów procentowych bardziej prawdopodobna niż niezgodność. Dla tych samych danych korelacja Spearmana wynosi .77 – tau jest liczbowo mniejsze, choć opisuje ten sam związek. Przy sześciu osobach dokładny test nie wykazał istotności (T = 12, p = .136), co dobrze pokazuje, jak mało informacji niesie tak mała próba.
Rangi wiązane: tau-a, tau-b i tau-c
Gdy osoby mają te same wyniki, część par nie jest ani zgodna, ani niezgodna – to pary wiązane. Wpływ rang wiązanych na współczynniki korelacji rang analizował Kendall (1945). Stosuje się trzy warianty współczynnika:
- τa – wzór podstawowy; przy wiązaniach zaniża wartość bezwzględną, bo pary wiązane są w mianowniku, ale nie w liczniku;
- τb – koryguje mianownik o wiązania w każdej zmiennej osobno; to ten wariant liczy R (
cor(x, y, method = "kendall")) i najczęściej SPSS; - τc (Stuarta) – wersja dla tabel krzyżowych o różnej liczbie wierszy i kolumn.
gdzie n0 = n(n − 1)/2, a n1 i n2 to liczby par wiązanych w X i w Y. Różnica bywa wyraźna: w przykładzie niżej, z dużą liczbą wiązań, τa = −.34, a τb = −.40.
Przykład: nieobecności na zajęciach a ocena końcowa
Trzydziestu studentów (dane symulowane) miało od 0 do 7 nieobecności, a ocenę końcową wystawiono w skali 2–5 z połówkami. Oceny to typowa zmienna porządkowa z wieloma wiązaniami: najczęstsza była ocena 3.5 (9 osób). Spośród 435 par osób 83 były zgodne, 231 niezgodne, a 121 wiązane.
Więcej nieobecności wiązało się z niższą oceną: τb = −.40, 95% CI [−.59, −.17], z = −2.75, p = .006. R wypisał przy tym ostrzeżenie, że przy rangach wiązanych nie może policzyć dokładnej wartości p – dlatego test opiera się na przybliżeniu normalnym (statystyka z). Dla porównania: korelacja Spearmana wyniosła −.51, a Pearsona −.50.
Tau Kendalla a korelacja Spearmana
Tau i rho opisują ten sam typ związku, ale tau ma zwykle mniejszą wartość bezwzględną. Dla dwuwymiarowego rozkładu normalnego zależność jest znana: τ = (2/π) arcsin(r), a rs = (6/π) arcsin(r/2). Przy korelacji w populacji równej .50 daje to rho ≈ .48 i tau ≈ .33 (rysunek 2). Nie oceniaj więc tau według progów przyjętych dla r Pearsona – τ = .33 może opisywać ten sam związek co r = .50.
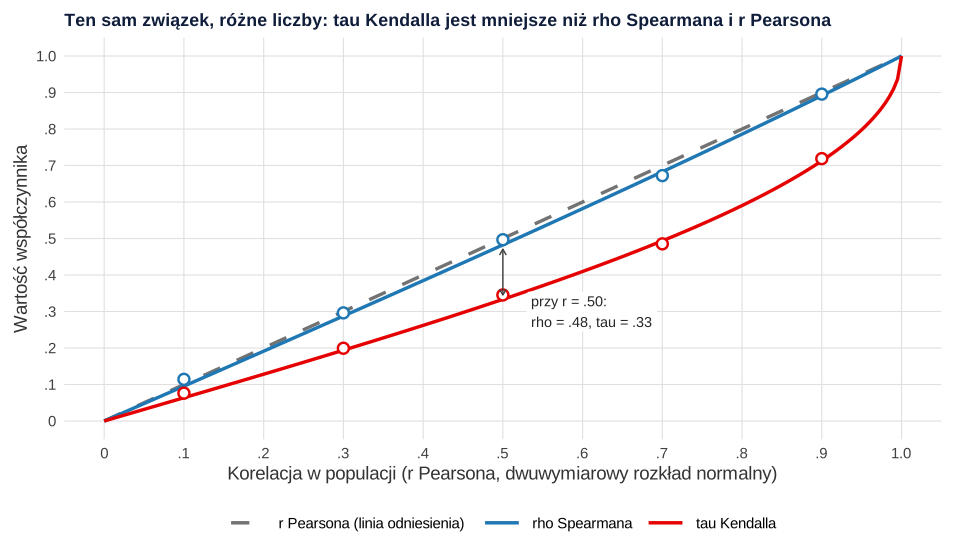
Co do jakości wnioskowania oba współczynniki wypadają podobnie. W symulacjach Putha i in. (2015) rho Spearmana i tau Kendalla działały podobnie przy testowaniu braku związku monotonicznego. Bez rang wiązanych tau dawało węższe przedziały ufności i może być preferowane, natomiast przy licznych rangach wiązanych przedziały dla rho lepiej zachowywały nominalne pokrycie. Croux i Dehon (2010) pokazali z kolei, że oba współczynniki łączą odporność na obserwacje odstające (ograniczoną funkcję wpływu) z wysoką efektywnością przy rozkładzie normalnym.
Kiedy stosować tau Kendalla?
- Dane porządkowe i związek monotoniczny – np. oceny, rangi, pojedyncze pozycje skali Likerta, liczba objawów.
- Małe próby bez wielu wiązań – tau ma prosty dokładny test i, według Putha i in. (2015), węższe przedziały ufności niż rho.
- Gdy zależy ci na interpretacji w kategoriach par: „o ile częściej pary są zgodne niż niezgodne”.
- Przy bardzo licznych wiązaniach używaj τb, ale rozważ też rho Spearmana – jego przedziały ufności w takich warunkach lepiej zachowywały pokrycie (Puth i in., 2015).
Tau nie wykryje związku niemonotonicznego (np. w kształcie litery U) – zawsze zacznij od wykresu. Gdy zmienne są ilościowe, a związek liniowy, lepszym wyborem bywa korelacja Pearsona.
Jak opisać tau Kendalla w pracy (APA)
Zaznacz wariant (zwykle τb), podaj wartość z 95% przedziałem ufności, statystykę testu i p. Przedział ufności można wyznaczyć przez transformację Fishera z poprawką dla tau (tak liczy go funkcja cor_test() z pakietu correlation). Wzór dla przykładu:
W tabeli korelacji zaznacz w nocie, że podajesz współczynniki tau-b Kendalla – wzór znajdziesz w haśle tabela korelacji w APA.
Przykład w R
Kod liczy pary zgodne i niezgodne w przykładzie ręcznym, sprawdza wynik funkcją cor(), wykonuje test dla danych z rangami wiązanymi, podaje przedział ufności dla tau-b i porównuje tau-a, tau-b, rho Spearmana oraz r Pearsona. Liczby w tekście pochodzą z tego kodu.
Tau Kendalla: pary, test i rangi wiązane
R
library(correlation)   # cor_test(): tau z 95% przedziałem ufności

# 1. Przykład ręczny: 6 osób – godziny snu przed badaniem (X) i wynik testu uwagi (Y)
sen <- c(5, 6, 7, 8, 9, 10)
uwaga <- c(12, 15, 11, 18, 17, 20)
pary <- t(combn(6, 2))                                   # wszystkie 15 par osób
znak <- sign(sen[pary[, 2]] - sen[pary[, 1]]) * sign(uwaga[pary[, 2]] - uwaga[pary[, 1]])
data.frame(osoba_i = pary[, 1], osoba_j = pary[, 2], para = ifelse(znak > 0, "zgodna", "niezgodna"))
C <- sum(znak > 0); D <- sum(znak < 0)
c(C = C, D = D, tau = (C - D) / choose(6, 2))
c(tau_Kendalla = cor(sen, uwaga, method = "kendall"), rho_Spearmana = cor(sen, uwaga, method = "spearman"))
cor.test(sen, uwaga, method = "kendall")                 # test dokładny (mała próba, brak wiązań)

# 2. Dane z rangami wiązanymi: nieobecności na zajęciach i ocena końcowa (2–5), N = 30 (dane symulowane)
set.seed(786)
n <- 30
nieobecnosci <- pmin(rpois(n, 3), 10)
lat <- 4 - 0.18 * nieobecnosci + rnorm(n, sd = 0.6)
ocena <- as.numeric(as.character(cut(lat, breaks = c(-Inf, 2.75, 3.25, 3.75, 4.25, 4.75, Inf),
                                     labels = c(2, 3, 3.5, 4, 4.5, 5))))
dane <- data.frame(nieobecnosci, ocena)
range(dane$nieobecnosci)
table(dane$ocena)
cor.test(nieobecnosci, ocena, method = "kendall")        # tau-b; przy wiązaniach test z przybliżeniem normalnym
cor_test(dane, "nieobecnosci", "ocena", method = "kendall")

# tau-a (bez poprawki na wiązania) a tau-b oraz porównanie z rho Spearmana i r Pearsona
pary <- t(combn(n, 2))
s <- sign(nieobecnosci[pary[, 2]] - nieobecnosci[pary[, 1]]) * sign(ocena[pary[, 2]] - ocena[pary[, 1]])
round(c(zgodne = sum(s > 0), niezgodne = sum(s < 0), wiazane = sum(s == 0),
        tau_a = (sum(s > 0) - sum(s < 0)) / nrow(pary),
        tau_b = cor(nieobecnosci, ocena, method = "kendall"),
        rho = cor(nieobecnosci, ocena, method = "spearman"),
        r = cor(nieobecnosci, ocena)), 3)
Wynik w R
   osoba_i osoba_j      para
1        1       2    zgodna
2        1       3 niezgodna
3        1       4    zgodna
4        1       5    zgodna
5        1       6    zgodna
6        2       3 niezgodna
7        2       4    zgodna
8        2       5    zgodna
9        2       6    zgodna
10       3       4    zgodna
11       3       5    zgodna
12       3       6    zgodna
13       4       5 niezgodna
14       4       6    zgodna
15       5       6    zgodna
   C    D  tau
12.0  3.0  0.6
 tau_Kendalla rho_Spearmana
    0.6000000     0.7714286

	Kendall's rank correlation tau

data:  sen and uwaga
T = 12, p-value = 0.1361
alternative hypothesis: true tau is not equal to 0
sample estimates:
tau
0.6

[1] 0 7

  2   3 3.5   4 4.5   5
  4   5   9   4   4   4
Warning in cor.test.default(nieobecnosci, ocena, method = "kendall") :
  Cannot compute exact p-value with ties

	Kendall's rank correlation tau

data:  nieobecnosci and ocena
z = -2.748, p-value = 0.005996
alternative hypothesis: true tau is not equal to 0
sample estimates:
       tau
-0.4000365

Parameter1   | Parameter2 |   tau |         95% CI |     z |       p
--------------------------------------------------------------------
nieobecnosci |      ocena | -0.40 | [-0.59, -0.17] | -2.75 | 0.006**

Observations: 30
   zgodne niezgodne   wiazane     tau_a     tau_b       rho         r
   83.000   231.000   121.000    -0.340    -0.400    -0.506    -0.496
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- correlation (wersja 0.8.8): Makowski, D., Ben-Shachar, M. S., Patil, I., & Lüdecke, D. (2020). Methods and algorithms for correlation analysis in R. Journal of Open Source Software, 5(51), 2306. https://doi.org/10.21105/joss.02306
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Porównywanie tau z progami dla r Pearsona. Tau jest liczbowo mniejsze; τ = .33 nie jest „słabszym” związkiem niż r = .50 w tych samych danych normalnych.
- Brak informacji o wariancie. Przy wiązaniach τa i τb różnią się wyraźnie (w przykładzie −.34 i −.40).
- Traktowanie tau jako miary zgodności ocen. Tau między dwoma sędziami mówi, czy porządkują obiekty podobnie, a nie czy wystawiają te same oceny – do zgodności służą kappa Cohena i ICC.
- Mylenie tau Kendalla ze współczynnikiem zgodności W Kendalla, który opisuje zgodność rangowań kilku sędziów.
- Wybór tau „bo próba jest mała” bez sprawdzenia wykresu i bez przedziału ufności – przy sześciu osobach nawet τ = .60 nie było istotne.
Najczęstsze pytania
Co to jest tau Kendalla?
To współczynnik korelacji rang, który mierzy siłę i kierunek związku monotonicznego. Porównuje wszystkie pary obserwacji i sprawdza, w ilu obie zmienne zmieniają się w tym samym kierunku (pary zgodne), a w ilu w przeciwnych (pary niezgodne). Przyjmuje wartości od −1 do +1.
Jak obliczyć tau Kendalla?
Dla każdej pary osób sprawdź, czy osoba z wyższym X ma też wyższe Y (para zgodna), czy niższe (para niezgodna). Następnie odejmij liczbę par niezgodnych od zgodnych i podziel przez liczbę wszystkich par, n(n − 1)/2. Na przykład przy 12 parach zgodnych i 3 niezgodnych z 15 par τ = (12 − 3)/15 = .60. W R: cor.test(x, y, method = "kendall").
Czym różni się tau Kendalla od korelacji Spearmana?
Oba współczynniki opisują związek monotoniczny na podstawie uporządkowania wyników, ale tau liczy pary zgodne i niezgodne, a Spearman koreluje rangi. Tau ma zwykle mniejszą wartość bezwzględną – przy korelacji w populacji .50 rho wynosi około .48, a tau około .33 – więc nie porównuj ich bezpośrednio.
Co to jest tau-b Kendalla?
To wariant tau z poprawką na rangi wiązane: mianownik pomniejsza się o pary wiązane w każdej zmiennej. Przy wielu wiązaniach (np. ocenach szkolnych czy pozycjach skali Likerta) tau-b jest wyraźnie większe co do wartości bezwzględnej niż tau-a. To ten wariant liczą R i SPSS w korelacjach dwóch zmiennych.
Kiedy lepiej użyć tau Kendalla niż Spearmana?
Gdy dane są porządkowe, próba mała i bez wielu wiązań albo gdy zależy ci na interpretacji w kategoriach par. Przy licznych rangach wiązanych rozważ też rho Spearmana, którego przedziały ufności w symulacjach lepiej zachowywały nominalne pokrycie (Puth i in., 2015).
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Jak dobrać test statystyczny do hipotezy?
Skala pomiaru, liczba grup i układ badania: tabela doboru testów, trzy przykłady, założenia, skala Likerta, kod R i checklista przed analizą.
Czytaj →PoradnikAnaliza ankiety do pracy licencjackiej i magisterskiej
Analiza ankiety do pracy dyplomowej: przygotowanie bazy, kodowanie pytań, skale, testy, modele i raport wyników do licencjatu lub magisterki.
Czytaj →PoradnikJak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Croux, C., & Dehon, C. (2010). Influence functions of the Spearman and Kendall correlation measures. Statistical Methods & Applications, 19(4), 497–515. https://doi.org/10.1007/s10260-010-0142-z ● Otwarty dostęp
- Kendall, M. G. (1938). A new measure of rank correlation. Biometrika, 30(1–2), 81–93. https://doi.org/10.1093/biomet/30.1-2.81
- Kendall, M. G. (1945). The treatment of ties in ranking problems. Biometrika, 33(3), 239–251. https://doi.org/10.1093/biomet/33.3.239
- Puth, M.-T., Neuhäuser, M., & Ruxton, G. D. (2015). Effective use of Spearman's and Kendall's correlation coefficients for association between two measured traits. Animal Behaviour, 102, 77–84. https://doi.org/10.1016/j.anbehav.2015.01.010
Cytowania BibTeX
@article{croux2010influence, author={Croux, Christophe and Dehon, Catherine}, title={{Influence functions of the Spearman and Kendall correlation measures}}, journal={Statistical Methods \& Applications}, year={2010}, volume={19}, number={4}, pages={497--515}, doi={10.1007/s10260-010-0142-z}}@article{kendall1938new, author={Kendall, M. G.}, title={{A new measure of rank correlation}}, journal={Biometrika}, year={1938}, volume={30}, number={1–2}, pages={81--93}, doi={10.1093/biomet/30.1-2.81}}@article{kendall1945treatment, author={Kendall, M. G.}, title={{The treatment of ties in ranking problems}}, journal={Biometrika}, year={1945}, volume={33}, number={3}, pages={239--251}, doi={10.1093/biomet/33.3.239}}@article{puth2015effective, author={Puth, Marie-Therese and Neuhäuser, Markus and Ruxton, Graeme D.}, title={{Effective use of Spearman's and Kendall's correlation coefficients for association between two measured traits}}, journal={Animal Behaviour}, year={2015}, volume={102}, pages={77--84}, doi={10.1016/j.anbehav.2015.01.010}}