Pearson, Spearman, Kendall czy punktowo-dwuseryjna? Wybór miary
Korelacja opisuje, jak silnie i w jakim kierunku dwie zmienne zmieniają się razem. Przyjmuje wartości od −1 do +1, a zero oznacza brak związku danego typu. Miarę wybierasz na podstawie trzech rzeczy: skali pomiaru, kształtu związku na wykresie i rozkładu zmiennych. Schober i in. (2018) podsumowują to tak: korelację Pearsona stosuje się zwykle do danych o rozkładzie zbliżonym do dwuwymiarowego normalnego, a korelację rang Spearmana – do danych nienormalnych, porządkowych albo z obserwacjami odstającymi. Wtedy mierzy ona związek monotoniczny.
| Współczynnik | Dane | Co mierzy | Uwagi |
|---|---|---|---|
| r Pearsona | dwie zmienne ilościowe | związek liniowy | wrażliwy na obserwacje odstające i skośność |
| ρ Spearmana | zmienne porządkowe albo ilościowe o skośnym rozkładzie | związek monotoniczny | Pearson policzony na rangach |
| τ Kendalla | jak Spearman, zwłaszcza małe próby | przewaga par zgodnych nad niezgodnymi | wartości zwykle niższe niż ρ; w programach wersja τb z poprawką na rangi wiązane |
| punktowo-dwuseryjna | zmienna dwuwartościowa (0/1) i ilościowa | różnica średnich wyrażona jako r | to zwykły Pearson; odpowiada testowi t Studenta |
Definicje i wzory znajdziesz w hasłach słownika. Tutaj liczymy wszystkie cztery miary na jednym zbiorze danych i pokazujemy, jak czytać wykres, liczyć przedział ufności i opisać wynik w pracy. Dwie zmienne porządkowe z kilkoma kategoriami (np. pojedyncze pozycje skali Likerta w analizie czynnikowej) czasem lepiej opisuje korelacja polichoryczna, ale w typowej pracy dyplomowej wystarczą miary z tabeli.
Badanie przykładowe: stres, sen i wieczorny czas przed ekranem
W badaniu wzięło udział 120 osób studiujących. Każda wypełniła skalę stresu (0–40), skalę problemów ze snem (0–21) i skalę senności w ciągu dnia (0–24). Wszystkie skale są tak zbudowane, że wyższy wynik oznacza więcej problemów. Każda osoba podała też, ile minut spędza wieczorem przed ekranem telefonu, i zaznaczyła, czy pracuje zarobkowo. Pracowało 45 osób, a 75 nie. Dane są symulowane. Możesz je pobrać jako plik CSV (kolumny: id, praca, stres, ekran, sen, sennosc).
| Zmienna | M | SD | Me | Min–maks | Skośność |
|---|---|---|---|---|---|
| Stres (0–40) | 19.00 | 6.12 | 19 | 7–33 | 0.15 |
| Problemy ze snem (0–21) | 8.27 | 2.87 | 8 | 0–15 | −0.02 |
| Senność w ciągu dnia (0–24) | 8.00 | 3.15 | 8 | 1–15 | −0.04 |
| Czas przed ekranem (min) | 90.67 | 69.54 | 68 | 17–376 | 1.66 |
Już tabela podpowiada wybór miary. Trzy skale mają rozkłady prawie symetryczne. Czas przed ekranem jest silnie prawoskośny (skośność 1.66): średnia jest wyraźnie większa od mediany, bo kilka osób spędza przed telefonem po kilka godzin.
Krok 1. Zanim policzysz r, narysuj wykres rozrzutu
Jeden współczynnik to bardzo duże uproszczenie. Anscombe (1973) pokazał cztery zbiory danych o niemal identycznych średnich, wariancjach, korelacji i prostej regresji, które na wykresie rozrzutu wyglądają zupełnie inaczej. Dlatego każdą korelację, którą opisujesz w pracy, najpierw obejrzyj. Rysunek 1 pokazuje cztery sytuacje z naszych danych.
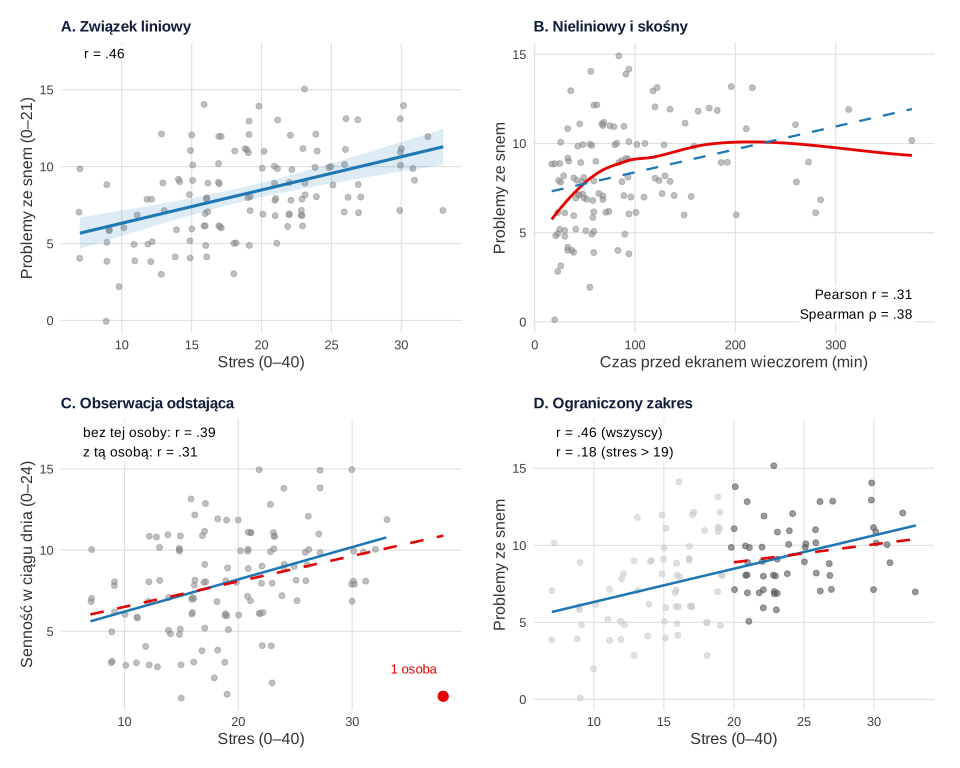
A. Liniowość
Punkty układają się wokół prostej, bez wyraźnego zakrzywienia, a rozrzut jest podobny w całym zakresie stresu. To sytuacja, w której r Pearsona dobrze opisuje związek.
B. Nieliniowość i skośność
Problemy ze snem rosną szybko przy pierwszej godzinie–dwóch przed ekranem, a potem krzywa się wypłaszcza. Do tego kilka osób z bardzo długim czasem przed ekranem mocno ciągnie prostą. Pearson (r = .31) zaniża więc siłę związku. Spearman (ρ = .38) mierzy, czy wyższy czas przed ekranem idzie w parze z wyższym wynikiem snu, bez względu na kształt krzywej. Gdy związek nie jest nawet monotoniczny (np. ma kształt litery U), żaden z tych współczynników go nie opisze. Wtedy potrzebujesz regresji krzywoliniowej.
C. Obserwacje odstające
Dopisaliśmy do danych jedną osobę z bardzo wysokim stresem (38) i bardzo niską sennością (1). Ta jedna osoba ze 121 obniża r Pearsona z .39 do .31, a ρ Spearmana z .39 do .36. Korelacje rangowe są bardziej odporne na pojedyncze skrajne wyniki (Croux i Dehon, 2010, analizują to formalnie przez funkcję wpływu), ale też nie są na nie obojętne. Obserwacji odstającej nie usuwaj tylko dlatego, że „psuje” wynik. Sprawdź, czy to błąd wprowadzania danych, i opisz decyzję w pracy. Procedurę pokazujemy w poradniku wartości odstające.
D. Ograniczony zakres
W całej próbie stres koreluje z problemami ze snem na poziomie r = .46. Wśród 54 osób ze stresem powyżej mediany (19 punktów) r = .18, 95% CI [−.09, .43]. Związek się nie zmienił. Zmniejszyło się tylko zróżnicowanie stresu: SD spadło z 6.12 do 3.57. Korelacja zależy od zakresu zmiennych w próbie. Jeśli badasz tylko osoby z wysokim nasileniem objawów, tylko najlepszych studentów albo tylko pracowników przyjętych po selekcji, uzyskasz niższe r, niż dałaby pełna populacja. To ograniczenie opisz w dyskusji.
Krok 2. Korelacja Pearsona z przedziałem ufności
Stres i problemy ze snem spełniają warunki korelacji Pearsona: obie zmienne są ilościowe, rozkłady prawie symetryczne, a związek liniowy. Wynik: r(118) = .46, p < .001. Liczba w nawiasie to stopnie swobody, N − 2.
Założenia, które sprawdzasz przed opisaniem r
- Niezależność obserwacji – każda osoba występuje w danych raz. Jeśli masz kilka pomiarów od tej samej osoby albo osoby z tych samych grup, zwykła korelacja przeszacuje pewność wyniku.
- Liniowość – oceniasz ją na wykresie rozrzutu, nie testem.
- Brak skrajnych obserwacji, które same wyznaczają kierunek prostej (rysunek 1C).
- Rozkład zbliżony do dwuwymiarowego normalnego – ważny dla testu istotności i przedziału ufności, nie dla samego opisu siły związku. W praktyce wystarczy obejrzeć histogramy i wykres rozrzutu. Uważaj, gdy rozrzut punktów wyraźnie rośnie wraz z wartościami jednej zmiennej (kształt lejka).
Gdy któreś z tych założeń jest wyraźnie naruszone, nie przekształcaj danych na siłę. Sięgnij po korelację Spearmana (krok 3) albo, przy zależnych obserwacjach, po model, który tę zależność uwzględnia.
Przedział ufności przez transformację Fishera
Rozkład r z próby jest asymetryczny, zwłaszcza gdy r leży daleko od zera, bo współczynnik nie może przekroczyć 1. Dlatego przedział ufności liczy się w trzech krokach:
- Zamień r na z Fishera: z = atanh(r) = ½ ln[(1 + r)/(1 − r)]. Dla r = .46 wychodzi z = 0.497.
- Policz symetryczny przedział dla z z błędem standardowym SE = 1/√(N − 3) = 1/√117 = 0.092: 0.497 ± 1.96 × 0.092, czyli [0.316, 0.678].
- Przelicz granice z powrotem na r funkcją tanh: [.31, .59].
Przedział [.31, .59] nie jest symetryczny wokół .46: dolne ramię ma .15, górne .13. Funkcja cor.test() w R daje dokładnie ten wynik. Panel A rysunku 2 pokazuje, skąd bierze się ta asymetria.
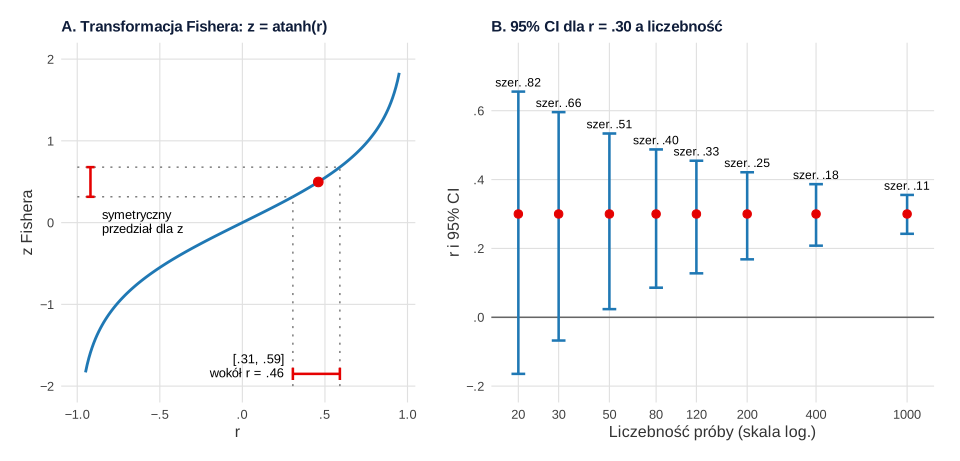
Panel B pokazuje rzecz ważną przy planowaniu badania. Przy 20 osobach i r = .30 przedział sięga od −.16 do .66, czyli prawie nic nie mówi o sile związku. Przy 120 osobach ma szerokość .33, a żeby zawęzić go do .20, potrzeba 320 osób. Sposoby uzasadniania liczebności próby opisujemy w poradniku dobór liczebności próby.
Przedział Fishera zakłada normalność. Bishara i Hittner (2017) pokazali w symulacjach, że przy danych wyraźnie nienormalnych rzeczywiste pokrycie nominalnie 95% przedziału może spaść nawet do 68%, a sygnałem ostrzegawczym była m.in. skośność co najmniej 1 lub kurtoza co najmniej 2. W pełni odporne okazały się metody rangowe, w tym przedział dla korelacji Spearmana. Dla czasu przed ekranem (skośność 1.66) policz więc Spearmana.
Krok 3. Spearman i Kendall dla danych skośnych i porządkowych
Dla czasu przed ekranem i problemów ze snem trzy współczynniki dają wyraźnie różne wartości:
| Współczynnik | Wartość | p | Komentarz |
|---|---|---|---|
| r Pearsona | .31 | < .001 | zaniżony przez nieliniowość i długi ogon rozkładu |
| ρ Spearmana | .38 | < .001 | 95% CI [.21, .53] |
| τb Kendalla | .26 | < .001 | inna skala niż ρ – nie porównuj ich wprost |
| r Pearsona po logarytmowaniu czasu | .38 | – | prostuje związek, ale zmienia interpretację na „procentowe” różnice czasu |
Którą miarę rangową wybrać? Przy rozkładach normalnych Spearman i Pearson mają podobne wartości oczekiwane, a Spearman jest nieco bardziej zmienny. Przy rozkładach o grubych ogonach, typowych dla danych ankietowych, mniej zmienny jest Spearman, który jest wtedy lepszym wyborem (de Winter i in., 2016). W symulacjach Putha i in. (2015) ρ i τ podobnie radziły sobie w testowaniu braku związku. Bez rang wiązanych τ dawało węższe przedziały ufności, a przy wielu rangach wiązanych przedziały dla ρ lepiej trzymały nominalne pokrycie. W naszych danych wynik snu przyjmuje tylko 15 różnych wartości na 120 osób, więc rang wiązanych jest dużo. To argument za Spearmanem.
Przedział ufności dla ρ liczy się podobnie jak dla Pearsona, przez transformację Fishera, ale z większym błędem standardowym. Bonett i Wright (2000) zaproponowali ulepszony błąd standardowy dla korelacji Spearmana: √[(1 + ρ²/2)/(N − 3)]. Z tym wzorem wychodzi 95% CI [.21, .53]. Funkcja cor.test() dla Spearmana przedziału nie podaje, więc w kodzie liczymy go ręcznie.
Krok 4. Korelacja punktowo-dwuseryjna: praca zarobkowa a stres
Gdy jedna zmienna ma tylko dwie wartości (pracuje / nie pracuje, kodowane 0 i 1), korelacja Pearsona staje się korelacją punktowo-dwuseryjną. Osoby pracujące miały średnio 20.38 punktu stresu, niepracujące 18.17. Korelacja wynosi r = .18, 95% CI [−.004, .344], p = .056. To ten sam test, co test t Studenta dla prób niezależnych: t(118) = 1.93 (w R z ujemnym znakiem, bo odejmuje grupę „1” od „0”) i identyczne p.
Praktyczna rada: jeśli Twoja hipoteza mówi o różnicy między grupami, opisz ją jako różnicę średnich (zob. test t Studenta krok po kroku). Korelacja punktowo-dwuseryjna przydaje się w macierzy korelacji, gdy chcesz pokazać zmienną dwuwartościową obok ilościowych. Nie twórz jej sztucznie przez dzielenie zmiennej ilościowej na pół, np. medianą. Tracisz wtedy informację i zaniżasz korelację (zob. dzielenie medianą).
Krok 5. Jak duże jest r? Interpretacja siły związku
Najczęściej cytowane progi to r = .10, .30 i .50 dla efektu małego, średniego i dużego (Cohen, 1992). Gignac i Szodorai (2016) sprawdzili je na 708 korelacjach z metaanaliz w badaniach różnic indywidualnych. 25., 50. i 75. centyl wyniosły .11, .19 i .29, a mniej niż 3% korelacji osiągało .50. Autorzy proponują więc traktować r = .10, .20 i .30 jako względnie małe, typowe i względnie duże.
| Wartość |r| | Cohen (1992) | Gignac i Szodorai (2016) |
|---|---|---|
| .10 | mały | względnie mały |
| .20 | między małym a średnim | typowy |
| .30 | średni | względnie duży |
| .50 | duży | rzadko spotykany (poniżej 3% wyników) |
W pracy możesz podać, którą konwencję stosujesz, ale ważniejsze jest odniesienie wyniku do wcześniejszych badań nad tymi samymi zmiennymi. Pamiętaj też o przedziale ufności. r = .18 z przedziałem od zera do .34 nie pozwala rozstrzygnąć, czy związek jest pomijalny, czy umiarkowany.
r² to odsetek wspólnej wariancji. Dla stresu i snu r² = .21: zmienność stresu „pokrywa się” z 21% zmienności problemów ze snem. To nie znaczy, że stres wyjaśnia 21% problemów ze snem w sensie przyczynowym. Szerzej o tym w poradniku wielkość efektu – interpretacja.
Korelacja cząstkowa: związek po kontroli trzeciej zmiennej
Stres koreluje z sennością w ciągu dnia (r = .39), ale oba wyniki wiążą się z problemami ze snem. Czy stres ma związek z sennością także u osób o tym samym poziomie problemów ze snem? Odpowiada na to korelacja cząstkowa: korelacja reszt obu zmiennych po usunięciu z nich liniowego wpływu zmiennej kontrolnej. Pakiet ppcor (Kim, 2015) liczy ją razem z testem: rstres, senność · sen = .26, t(117) = 2.96, p = .004.
Związek osłabł z .39 do .26, ale nie zniknął. Interpretacja zależy od tego, jaką rolę przypisujesz zmiennej kontrolnej. Jeśli problemy ze snem są drogą, przez którą stres prowadzi do senności (mediatorem), korelacja cząstkowa nie jest „czystszym” związkiem, tylko jego częścią. Rohrer (2018) pokazuje, że kontrolowanie mediatorów i wspólnych skutków (kolajderów) przesuwa oszacowanie dalej od interesującego efektu przyczynowego. Zanim zdecydujesz, co kontrolować, narysuj założony schemat zależności. Pokrewna miara, korelacja semicząstkowa, usuwa wpływ zmiennej kontrolnej tylko z jednej zmiennej.
Porównanie dwóch korelacji – krótko
Częsty błąd: „u osób pracujących korelacja jest nieistotna, a u niepracujących istotna, więc grupy się różnią”. W naszych danych stres koreluje z problemami ze snem na poziomie r = .26 u 45 pracujących i r = .54 u 75 niepracujących. Różnica wygląda na dużą, ale test różnicy dwóch niezależnych korelacji (oba r zamienione na z Fishera) daje z = −1.75, p = .080. Diedenhofen i Musch (2015) podkreślają, że o różnicy korelacji można wnioskować tylko z bezpośredniego testu tej różnicy. Ich pakiet R cocor obsługuje korelacje niezależne i zależne, np. gdy w jednej próbie porównujesz korelacje stresu ze snem i stresu z sennością. Jeśli pytanie brzmi, czy związek zależy od grupy, rozważ też model z interakcją (zob. efekt interakcji).
Korelacja a przyczynowość
Korelacja stresu z problemami ze snem jest zgodna z kilkoma wyjaśnieniami: stres psuje sen, zły sen podnosi stres, a obie zmienne mogą zależeć od czegoś trzeciego, np. od liczby egzaminów w danym tygodniu. Z badania korelacyjnego nie rozstrzygniesz, które wyjaśnienie jest prawdziwe. Przy danych obserwacyjnych wnioski przyczynowe zawsze opierają się na założeniach, które wymagają wiedzy dziedzinowej (Rohrer, 2018). Trzy warunki wniosku przyczynowego i przykłady dobrych i złych sformułowań omawia hasło korelacja a przyczynowość.
W praktyce pisz „wiązał się z”, „współwystępował z”, „osoby z wyższym stresem miały więcej problemów ze snem”. Unikaj zwrotów „wpływa na”, „powoduje”, „prowadzi do”. Jeśli wcześniej formułujesz hipotezę kierunkową, zaznacz w dyskusji, że plan badania nie pozwala jej sprawdzić przyczynowo.
Macierz korelacji w stylu APA
Gdy masz kilka zmiennych, zbierz korelacje w jednej tabeli. W stylu APA podajesz średnie i odchylenia standardowe, a korelacje w dolnym trójkącie, z przedziałami ufności w nawiasach albo z oznaczeniem istotności w nocie. Wzór gotowy do Worda, z wariantami i typowymi błędami, znajdziesz w haśle tabela korelacji w APA.
Tabela 1
Statystyki opisowe i korelacje stresu, snu, senności i czasu przed ekranem
| Zmienna | M | SD | 1 | 2 | 3 |
|---|---|---|---|---|---|
| 1. Stres | 19.00 | 6.12 | — | ||
| 2. Problemy ze snem | 8.27 | 2.87 | .46** [.31, .59] | — | |
| 3. Senność w ciągu dnia | 8.00 | 3.15 | .39** [.22, .53] | .37** [.20, .51] | — |
| 4. Czas przed ekranem (min) | 90.67 | 69.54 | −.14 [−.31, .04] | .31** [.14, .46] | .01 [−.17, .19] |
Uwaga. N = 120. Współczynniki korelacji Pearsona; w nawiasach kwadratowych 95% przedziały ufności. Rozkład czasu przed ekranem jest prawoskośny (skośność = 1.66); korelacje rang Spearmana dla tej zmiennej wynoszą: ze stresem −.05, z problemami ze snem .38, z sennością .03. Dane symulowane.
** p < .01.
Sprawdź też liczebności. Gdy w danych są braki i usuwasz je parami, każda korelacja może być policzona na innej grupie osób. Wtedy w nocie podaj zakres N albo – przy niewielu brakach – użyj tej samej grupy osób we wszystkich korelacjach i napisz o tym. Dzięki temu czytelnik wie, na ilu osobach opiera się każdy współczynnik.
Jeśli w tabeli jest dużo korelacji, a każdą traktujesz jako osobną hipotezę, ryzyko fałszywego alarmu rośnie z każdym testem (zob. poprawki na wielokrotne porównania). Więcej wzorów tabel do pracy zebraliśmy w poradniku tabele APA w pracy z psychologii.
Zapis wyników korelacji w stylu APA
W opisie korelacji podaj:
- nazwę współczynnika i powód jego wyboru, jeśli nie jest to Pearson;
- wartość współczynnika z dwoma miejscami po kropce, bez zera przed kropką;
- stopnie swobody (N − 2) w nawiasie przy r albo liczebność N;
- 95% przedział ufności i dokładne p;
- kierunek związku opisany słowami, bez języka przyczynowego.
Gotowe zdania dla innych analiz znajdziesz w poradniku jak opisać wyniki w stylu APA.
Korelacje w SPSS i JASP
SPSS
W SPSS wybierz Analyze → Correlate → Bivariate. W sekcji Correlation Coefficients zaznacz Pearson, Kendall’s tau-b lub Spearman. W Test of Significance zostaw Two-tailed. Opcja Flag significant correlations dodaje gwiazdki, a Show only the lower triangle daje układ jak w tabeli APA. Przycisk Confidence Interval otwiera ustawienia przedziałów ufności dla korelacji Pearsona i Spearmana (IBM Corp., b.d.). Co przepisać z tabeli wynikowej, pokazujemy w poradniku jak czytać wyniki z SPSS.
JASP
W JASP otwórz analizę Correlation i przenieś zmienne do pola Variables. W Sample Correlation Coefficient wybierz Pearson’s r, Spearman lub Kendall’s tau-b. W Additional Options zaznacz Report significance, Flag significant correlations i Confidence Intervals – według dokumentacji przedziały ufności są dostępne tylko dla Pearsona. Pole Partial out pozwala policzyć korelacje cząstkowe, a Plots → Scatter plots rysuje wykresy rozrzutu dla wszystkich par (JASP Team, b.d.). Po odznaczeniu Display pairwise wyniki pojawiają się w układzie macierzy.
Korelacje w R: Pearson, Spearman, Kendall i korelacja cząstkowa
Kod odtwarza wszystkie liczby z tekstu, tabel i rysunków. Korelacje i testy liczy funkcja cor.test() z podstawowego R, macierz z przedziałami ufności – funkcja corr.test() z pakietu psych, a korelację cząstkową – pakiet ppcor. Przedziały ufności z transformacji Fishera liczymy też ręcznie, żeby było widać, skąd się biorą. Pierwszy przepis zapisuje dane do pliku CSV, który możesz pobrać powyżej.
1. Badanie przykładowe: wszystkie korelacje z tekstu
R
# Przykład: stres, sen i wieczorny czas przed ekranem u 120 osób studiujących (dane symulowane, set.seed(4523)).
# stres: skala 0–40; sen: problemy ze snem 0–21; sennosc: senność w ciągu dnia 0–24 (wyższy wynik = więcej problemów);
# ekran: minuty przed ekranem telefonu wieczorem, od 18:00 do zaśnięcia (skośny rozkład); praca: praca zarobkowa (0 = nie, 1 = tak).
set.seed(4523)
n <- 120
praca   <- rbinom(n, 1, .4)
stres   <- 18 + 2.5 * praca + rnorm(n, 0, 6)
ekran   <- round(exp(rnorm(n, log(75), 0.7)))
sen     <- 2 + 0.22 * stres + 1.6 * log(ekran / 20) + rnorm(n, 0, 2.4)
sennosc <- 3 + 0.45 * sen + 0.08 * stres + rnorm(n, 0, 2.8)
dane <- data.frame(id = 1:n, praca, stres = pmin(40, pmax(0, round(stres))), ekran = pmin(400, ekran),
                   sen = pmin(21, pmax(0, round(sen))), sennosc = pmin(24, pmax(0, round(sennosc))))
write.csv(dane, "../korelacja-krok-po-kroku-dane.csv", row.names = FALSE)   # plik do pobrania

# Statystyki opisowe i skośność
opis <- sapply(dane[, c("stres", "sen", "sennosc", "ekran")], function(x)
  c(M = mean(x), SD = sd(x), Me = median(x), min = min(x), max = max(x), skosnosc = psych::skew(x)))
round(opis, 2)
table(praca = dane$praca)

# 1. Korelacja Pearsona: stres a problemy ze snem, z 95% CI (transformacja Fishera)
(ct <- cor.test(dane$stres, dane$sen))
r <- unname(ct$estimate); z <- atanh(r); se <- 1 / sqrt(n - 3)          # z Fishera i jego błąd standardowy
round(c(r = r, z = z, SE_z = se, z_dolna = z - 1.96 * se, z_gorna = z + 1.96 * se,
        r_dolna = tanh(z - 1.96 * se), r_gorna = tanh(z + 1.96 * se), r2 = r^2), 3)

# 2. Czas przed ekranem a problemy ze snem: Pearson, Spearman i Kendall
cor.test(dane$ekran, dane$sen)$estimate
cor.test(dane$ekran, dane$sen, method = "spearman", exact = FALSE)
cor.test(dane$ekran, dane$sen, method = "kendall", exact = FALSE)
cor(log(dane$ekran), dane$sen)                                          # Pearson po logarytmowaniu czasu
sum(duplicated(dane$sen))                                               # liczba powtórzonych wartości (rangi wiązane)
# CI dla rho Spearmana: przybliżenie Fishera z SE = sqrt((1 + rho^2 / 2) / (n - 3)) (Bonett i Wright)
rho <- cor(dane$ekran, dane$sen, method = "spearman"); se_s <- sqrt((1 + rho^2 / 2) / (n - 3))
round(c(rho = rho, dolna = tanh(atanh(rho) - 1.96 * se_s), gorna = tanh(atanh(rho) + 1.96 * se_s)), 3)

# 3. Korelacja punktowo-dwuseryjna: praca zarobkowa (0/1) a stres = Pearson z kodem 0/1
cor.test(dane$praca, dane$stres)
t.test(stres ~ praca, data = dane, var.equal = TRUE)$statistic           # ten sam wynik co test t Studenta
round(tapply(dane$stres, dane$praca, mean), 2)

# 4. Wpływ jednej obserwacji odstającej: stres a senność
r_bez <- cor(dane$stres, dane$sennosc)
z_odst <- rbind(dane[, c("stres", "sennosc")], data.frame(stres = 38, sennosc = 1))   # jedna dopisana osoba
round(c(r_bez = r_bez, r_z_odstajaca = cor(z_odst$stres, z_odst$sennosc),
        rho_bez = cor(dane$stres, dane$sennosc, method = "spearman"),
        rho_z_odstajaca = cor(z_odst$stres, z_odst$sennosc, method = "spearman")), 3)

# 5. Ograniczony zakres: tylko osoby ze stresem powyżej mediany
gora <- dane$stres > median(dane$stres)
round(c(mediana = median(dane$stres), n_gora = sum(gora), r_pelny = cor(dane$stres, dane$sen),
        r_ograniczony = cor(dane$stres[gora], dane$sen[gora]),
        SD_pelne = sd(dane$stres), SD_ograniczone = sd(dane$stres[gora])), 3)
cor.test(dane$stres[gora], dane$sen[gora])$conf.int

# 6. Korelacja cząstkowa: stres a senność po kontroli problemów ze snem
ppcor::pcor.test(dane$stres, dane$sennosc, dane$sen)

# 7. Porównanie dwóch niezależnych korelacji: stres–sen u pracujących i niepracujących (test z Fishera)
r1 <- cor(dane$stres[dane$praca == 1], dane$sen[dane$praca == 1]); n1 <- sum(dane$praca == 1)
r0 <- cor(dane$stres[dane$praca == 0], dane$sen[dane$praca == 0]); n0 <- sum(dane$praca == 0)
z_roz <- (atanh(r1) - atanh(r0)) / sqrt(1 / (n1 - 3) + 1 / (n0 - 3))
round(c(r_pracujacy = r1, n1 = n1, r_niepracujacy = r0, n0 = n0, z = z_roz, p = 2 * pnorm(-abs(z_roz))), 3)

# 8. Macierz korelacji do tabeli APA: r, p i 95% CI
zm <- dane[, c("stres", "sen", "sennosc", "ekran")]
kt <- psych::corr.test(zm, adjust = "none")
round(kt$r, 2)
round(kt$p, 3)
round(kt$ci[, c("lower", "r", "upper")], 2)
round(cor(zm, method = "spearman")["ekran", ], 2)
Wynik w R
         stres   sen sennosc  ekran
M        19.00  8.27    8.00  90.67
SD        6.12  2.87    3.15  69.54
Me       19.00  8.00    8.00  68.00
min       7.00  0.00    1.00  17.00
max      33.00 15.00   15.00 376.00
skosnosc  0.15 -0.02   -0.04   1.66
praca
 0  1
75 45

	Pearson's product-moment correlation

data:  dane$stres and dane$sen
t = 5.6247, df = 118, p-value = 1.269e-07
alternative hypothesis: true correlation is not equal to 0
95 percent confidence interval:
 0.3057700 0.5903935
sample estimates:
      cor
0.4598107

      r       z    SE_z z_dolna z_gorna r_dolna r_gorna      r2
  0.460   0.497   0.092   0.316   0.678   0.306   0.590   0.211
      cor
0.3105503

	Spearman's rank correlation rho

data:  dane$ekran and dane$sen
S = 179423, p-value = 2.198e-05
alternative hypothesis: true rho is not equal to 0
sample estimates:
      rho
0.3769604


	Kendall's rank correlation tau

data:  dane$ekran and dane$sen
z = 4.0798, p-value = 4.508e-05
alternative hypothesis: true tau is not equal to 0
sample estimates:
      tau
0.2634185

[1] 0.3833814
[1] 105
  rho dolna gorna
0.377 0.206 0.526

	Pearson's product-moment correlation

data:  dane$praca and dane$stres
t = 1.9314, df = 118, p-value = 0.05583
alternative hypothesis: true correlation is not equal to 0
95 percent confidence interval:
 -0.004320504  0.343519025
sample estimates:
      cor
0.1750564

        t
-1.931424
    0     1
18.17 20.38
          r_bez   r_z_odstajaca         rho_bez rho_z_odstajaca
          0.386           0.310           0.389           0.355
       mediana         n_gora        r_pelny  r_ograniczony       SD_pelne SD_ograniczone
        19.000         54.000          0.460          0.179          6.122          3.570
[1] -0.09367089  0.42596218
attr(,"conf.level")
[1] 0.95
   estimate     p.value statistic   n gp  Method
1 0.2635553 0.003778455  2.955273 120  1 pearson
   r_pracujacy             n1 r_niepracujacy             n0              z              p
         0.258         45.000          0.540         75.000         -1.750          0.080
        stres  sen sennosc ekran
stres    1.00 0.46    0.39 -0.14
sen      0.46 1.00    0.37  0.31
sennosc  0.39 0.37    1.00  0.01
ekran   -0.14 0.31    0.01  1.00
        stres   sen sennosc ekran
stres   0.000 0.000   0.000 0.134
sen     0.000 0.000   0.000 0.001
sennosc 0.000 0.000   0.000 0.951
ekran   0.134 0.001   0.951 0.000
            lower     r upper
stres-sen    0.31  0.46  0.59
stres-snnsc  0.22  0.39  0.53
stres-ekran -0.31 -0.14  0.04
sen-snnsc    0.20  0.37  0.51
sen-ekran    0.14  0.31  0.46
snnsc-ekran -0.17  0.01  0.18
  stres     sen sennosc   ekran
  -0.05    0.38    0.03    1.00
2. Szerokość przedziału ufności dla r a liczebność próby
R
# Jak szeroki jest 95% CI dla r = .30 przy różnej liczebności próby (transformacja Fishera)?
ci_r <- function(r, n) tanh(atanh(r) + c(-1, 1) * qnorm(.975) / sqrt(n - 3))
szer <- t(sapply(c(20, 30, 50, 80, 120, 200, 400, 1000), function(n) { g <- ci_r(.30, n)
  c(n = n, dolna = g[1], gorna = g[2], szerokosc = g[2] - g[1]) }))
round(szer, 3)
# Ile osób potrzeba, by 95% CI dla r = .30 miał szerokość najwyżej .20?
n_min <- which(sapply(10:2000, function(n) diff(ci_r(.30, n))) <= .20)[1] + 9
n_min
Wynik w R
        n  dolna gorna szerokosc
[1,]   20 -0.164 0.655     0.820
[2,]   30 -0.068 0.596     0.663
[3,]   50  0.024 0.534     0.510
[4,]   80  0.086 0.488     0.402
[5,]  120  0.128 0.455     0.327
[6,]  200  0.168 0.421     0.253
[7,]  400  0.208 0.387     0.179
[8,] 1000  0.243 0.355     0.113
[1] 320
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje cor() i cor.test() z pakietu stats); rysunki przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- ppcor (wersja 1.1): Kim, S. (2015). ppcor: Partial and semi-partial (part) correlation (R package version 1.1) [Computer software]. https://doi.org/10.32614/CRAN.package.ppcor
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots (R package version 1.3.2) [Computer software]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy przy korelacjach
- Korelacja bez wykresu rozrzutu. Jedna obserwacja odstająca albo zakrzywiony związek mogą zmienić wynik (rysunek 1).
- Spearman „bo test normalności wyszedł istotny”. Liczy się kształt związku i rozkład na wykresie, nie samo p testu. Przy prawie symetrycznych rozkładach i liniowym związku Pearson jest właściwy także przy istotnym teście Shapiro–Wilka.
- Brak przedziału ufności. Sama gwiazdka przy r = .18 nie mówi, czy związek jest pomijalny, czy umiarkowany.
- Porównywanie istotności zamiast korelacji. „Istotna w jednej grupie, nieistotna w drugiej” to nie test różnicy (w przykładzie p = .080 mimo .26 wobec .54).
- Język przyczynowy („stres powoduje bezsenność”) w badaniu korelacyjnym.
- Ignorowanie ograniczonego zakresu, np. wniosek o braku związku w próbie złożonej tylko z osób z wysokim nasileniem objawów.
- Dziesiątki korelacji bez planu i opisywanie tylko tych, które „wyszły”. To prosta droga do fałszywych odkryć.
- Zapis z zerem i przecinkiem („r = 0,46”) zamiast r = .46 oraz brak informacji, który współczynnik policzono.
Jeśli chcesz, żeby ktoś sprawdził dobór miar i opis korelacji w Twojej pracy, zajrzyj do oferty analizy statystyczne dla studentów. Wyniki musisz jednak rozumieć i umieć obronić samodzielnie.
Najczęstsze pytania
Kiedy wybrać korelację Spearmana zamiast Pearsona?
Gdy co najmniej jedna zmienna jest porządkowa, ma wyraźnie skośny rozkład albo pojedyncze skrajne wyniki, a także gdy wykres rozrzutu pokazuje związek rosnący, ale nieliniowy. Spearman mierzy związek monotoniczny i liczy się go na rangach. Przy liniowym związku i rozkładach zbliżonych do normalnego zostań przy Pearsonie, nawet gdy test normalności przy dużej próbie jest istotny.
Jak policzyć przedział ufności dla współczynnika korelacji?
Zamień r na z Fishera (z = atanh r), dodaj i odejmij 1.96/√(N − 3), a granice przelicz z powrotem funkcją tanh. Dla r = .46 i N = 120 wychodzi 95% CI [.31, .59]. W R podaje go funkcja cor.test(); dla ρ Spearmana używa się większego błędu standardowego (Bonett i Wright, 2000).
Jaka korelacja jest silna, a jaka słaba?
Według konwencji Cohena (1992) r = .10, .30 i .50 to efekty małe, średnie i duże. W badaniach różnic indywidualnych korelacje są zwykle niższe, dlatego Gignac i Szodorai (2016) proponują traktować .10, .20 i .30 jako względnie małe, typowe i względnie duże. Najlepiej odnieś wynik do wcześniejszych badań nad tymi samymi zmiennymi.
Czym jest korelacja punktowo-dwuseryjna?
To korelacja Pearsona między zmienną dwuwartościową kodowaną 0 i 1 (np. pracuje / nie pracuje) a zmienną ilościową. Daje taki sam wynik testu jak test t Studenta dla prób niezależnych. Przydaje się w macierzy korelacji, ale różnicę między grupami lepiej opisać jako różnicę średnich.
Jak sprawdzić, czy dwie korelacje różnią się istotnie?
Porównaj je bezpośrednim testem różnicy. Dla korelacji z dwóch niezależnych grup oba r zamienia się na z Fishera i dzieli różnicę przez jej błąd standardowy, a dla korelacji z jednej próby potrzebne są osobne testy, np. z pakietu R cocor (Diedenhofen i Musch, 2015). To, że jedna korelacja jest istotna, a druga nie, nie oznacza, że różnią się od siebie.
Powiązane hasła
Przeczytaj też
Test t Studenta krok po kroku
Jedna próba, próby niezależne i zależne na jednym przykładzie: założenia, test Welcha, d Cohena i d_z z 95% CI, wykres, zapis APA, R, SPSS i JASP.
Czytaj →PoradnikJak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →PoradnikWartości odstające: jak je wykryć i co z nimi zrobić
Reguły ustalone z góry, MAD zamiast ±3 SD, Mahalanobis i MCD, odległość Cooka, winsoryzacja, test Yuena, analiza wrażliwości i opis APA – z kodem R.
Czytaj →Nie wiesz, którą korelację wybrać i jak ją opisać?
Sprawdzimy dobór miar do Twoich danych, przygotujemy macierz korelacji z przedziałami ufności i wyjaśnimy wyniki tak, żebyś umiał(a) je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Anscombe, F. J. (1973). Graphs in statistical analysis. The American Statistician, 27(1), 17–21. https://doi.org/10.1080/00031305.1973.10478966
- Bishara, A. J., & Hittner, J. B. (2017). Confidence intervals for correlations when data are not normal. Behavior Research Methods, 49(1), 294–309. https://doi.org/10.3758/s13428-016-0702-8 ● Otwarty dostęp
- Bonett, D. G., & Wright, T. A. (2000). Sample size requirements for estimating Pearson, Kendall and Spearman correlations. Psychometrika, 65(1), 23–28. https://doi.org/10.1007/bf02294183
- Cohen, J. (1992). A power primer. Psychological Bulletin, 112(1), 155–159. https://doi.org/10.1037/0033-2909.112.1.155
- Croux, C., & Dehon, C. (2010). Influence functions of the Spearman and Kendall correlation measures. Statistical Methods & Applications, 19(4), 497–515. https://doi.org/10.1007/s10260-010-0142-z ● Otwarty dostęp
- de Winter, J. C. F., Gosling, S. D., & Potter, J. (2016). Comparing the Pearson and Spearman correlation coefficients across distributions and sample sizes: A tutorial using simulations and empirical data. Psychological Methods, 21(3), 273–290. https://doi.org/10.1037/met0000079 ● Otwarty dostęp: pełny tekst
- Diedenhofen, B., & Musch, J. (2015). cocor: A comprehensive solution for the statistical comparison of correlations. PLOS ONE, 10(4), Article e0121945. https://doi.org/10.1371/journal.pone.0121945 ● Otwarty dostęp
- Gignac, G. E., & Szodorai, E. T. (2016). Effect size guidelines for individual differences researchers. Personality and Individual Differences, 102, 74–78. https://doi.org/10.1016/j.paid.2016.06.069
- IBM Corp. (b.d.). Bivariate Correlations. IBM SPSS Statistics 30.0.0 documentation. Pobrano 21 października 2026 z https://www.ibm.com/docs/en/spss-statistics/30.0.0?topic=features-bivariate-correlations ● Otwarty dostęp
- JASP Team. (b.d.). Correlation [plik pomocy modułu Regression]. jaspRegression (GitHub). Pobrano 21 października 2026 z https://github.com/jasp-stats/jaspRegression/blob/master/inst/help/Correlation.md ● Otwarty dostęp
- Kim, S. (2015). ppcor: An R package for a fast calculation to semi-partial correlation coefficients. Communications for Statistical Applications and Methods, 22(6), 665–674. https://doi.org/10.5351/csam.2015.22.6.665 ● Otwarty dostęp
- Puth, M.-T., Neuhäuser, M., & Ruxton, G. D. (2015). Effective use of Spearman's and Kendall's correlation coefficients for association between two measured traits. Animal Behaviour, 102, 77–84. https://doi.org/10.1016/j.anbehav.2015.01.010
- Rohrer, J. M. (2018). Thinking clearly about correlations and causation: Graphical causal models for observational data. Advances in Methods and Practices in Psychological Science, 1(1), 27–42. https://doi.org/10.1177/2515245917745629 ● Otwarty dostęp
- Schober, P., Boer, C., & Schwarte, L. A. (2018). Correlation coefficients: Appropriate use and interpretation. Anesthesia & Analgesia, 126(5), 1763–1768. https://doi.org/10.1213/ANE.0000000000002864 ● Otwarty dostęp
Cytowania BibTeX
@article{anscombe1973graphs, author={Anscombe, Francis J.}, title={{Graphs in statistical analysis}}, journal={The American Statistician}, year={1973}, volume={27}, number={1}, pages={17--21}, doi={10.1080/00031305.1973.10478966}}@article{bishara2017confidence, author={Bishara, Anthony J. and Hittner, James B.}, title={{Confidence intervals for correlations when data are not normal}}, journal={Behavior Research Methods}, year={2017}, volume={49}, number={1}, pages={294--309}, doi={10.3758/s13428-016-0702-8}}@article{bonett2000sample, author={Bonett, Douglas G. and Wright, Thomas A.}, title={{Sample size requirements for estimating Pearson, Kendall and Spearman correlations}}, journal={Psychometrika}, year={2000}, volume={65}, number={1}, pages={23--28}, doi={10.1007/bf02294183}}@article{cohen1992power, author={Cohen, Jacob}, title={{A power primer}}, journal={Psychological Bulletin}, year={1992}, volume={112}, number={1}, pages={155--159}, doi={10.1037/0033-2909.112.1.155}}@article{croux2010influence, author={Croux, Christophe and Dehon, Catherine}, title={{Influence functions of the Spearman and Kendall correlation measures}}, journal={Statistical Methods \& Applications}, year={2010}, volume={19}, number={4}, pages={497--515}, doi={10.1007/s10260-010-0142-z}}@article{dewinter2016comparing, author={de Winter, Joost C. F. and Gosling, Samuel D. and Potter, Jeff}, title={{Comparing the Pearson and Spearman correlation coefficients across distributions and sample sizes: A tutorial using simulations and empirical data}}, journal={Psychological Methods}, year={2016}, volume={21}, number={3}, pages={273--290}, doi={10.1037/met0000079}}@article{diedenhofen2015cocor, author={Diedenhofen, Birk and Musch, Jochen}, title={{cocor: A comprehensive solution for the statistical comparison of correlations}}, journal={PLOS ONE}, year={2015}, volume={10}, number={4}, eid={e0121945}, doi={10.1371/journal.pone.0121945}}@article{gignac2016effect, author={Gignac, Gilles E. and Szodorai, Eva T.}, title={{Effect size guidelines for individual differences researchers}}, journal={Personality and Individual Differences}, year={2016}, volume={102}, pages={74--78}, doi={10.1016/j.paid.2016.06.069}}@misc{ibmndbivariatecorrelations, author={{IBM Corp.}}, title={{Bivariate Correlations}}, howpublished={IBM SPSS Statistics 30.0.0 documentation}, publisher={IBM}, url={https://www.ibm.com/docs/en/spss-statistics/30.0.0?topic=features-bivariate-correlations}}@misc{jaspndcorrelation, author={{JASP Team}}, title={{Correlation [plik pomocy modułu Regression]}}, howpublished={jaspRegression (GitHub)}, url={https://github.com/jasp-stats/jaspRegression/blob/master/inst/help/Correlation.md}}@article{kim2015ppcor, author={Kim, Seongho}, title={{ppcor: An R package for a fast calculation to semi-partial correlation coefficients}}, journal={Communications for Statistical Applications and Methods}, year={2015}, volume={22}, number={6}, pages={665--674}, doi={10.5351/csam.2015.22.6.665}}@article{puth2015effective, author={Puth, Marie-Therese and Neuhäuser, Markus and Ruxton, Graeme D.}, title={{Effective use of Spearman's and Kendall's correlation coefficients for association between two measured traits}}, journal={Animal Behaviour}, year={2015}, volume={102}, pages={77--84}, doi={10.1016/j.anbehav.2015.01.010}}@article{rohrer2018thinking, author={Rohrer, Julia M.}, title={{Thinking clearly about correlations and causation: Graphical causal models for observational data}}, journal={Advances in Methods and Practices in Psychological Science}, year={2018}, volume={1}, number={1}, pages={27--42}, doi={10.1177/2515245917745629}}@article{schober2018correlation, author={Schober, Patrick and Boer, Christa and Schwarte, Lothar A.}, title={{Correlation coefficients: Appropriate use and interpretation}}, journal={Anesthesia \& Analgesia}, year={2018}, volume={126}, number={5}, pages={1763--1768}, doi={10.1213/ane.0000000000002864}}