Mierzysz, nie manipulujesz: co z tego wynika dla opisu
Badanie korelacyjne to plan, w którym mierzysz zmienne takimi, jakie są, i analizujesz związki między nimi – bez manipulacji i bez losowego przydziału (definicja i warianty są w haśle schemat korelacyjny). W pracach dyplomowych kłopot rzadko leży w samym rachunku. Leży w opisie: temat mówi o „wpływie”, hipoteza o „zwiększaniu”, a dane pochodzą z jednej ankiety wypełnionej jednego wieczoru.
Ten wpis nie powtarza ogólnego układu rozdziału metodologicznego (jest we wpisie rozdział metodologiczny – jak go napisać) ani liczenia współczynników (korelacja Pearsona i Spearmana krok po kroku). Zajmuje się tym, co jest swoiste dla tego schematu: nazwami zmiennych, liczebnością dla r, kolejnością kwestionariuszy, kontrolowaniem zmiennych, gotowym tekstem podrozdziału „Metoda” i granicami wniosków.
Przykład przewodni (wymyślony, dane symulowane). Studentka pyta, czy wsparcie ze strony rówieśników wiąże się z zaangażowaniem w studia wśród studentów pierwszego roku. Mierzy też poczucie własnej skuteczności w nauce, wiek i tryb studiów. Zebrała 168 ankiet internetowych, a do analizy weszło 157. Wszystkie liczby poniżej pochodzą z kodu na końcu wpisu.
Jak nazwać schemat i zmienne
Słowa z pierwszych stron pracy ustawiają oczekiwania wobec wniosków. Dlatego warto je dobrać, zanim powstanie reszta tekstu.
| Element | Jak bywa napisane | Co jest nie tak | Lepiej |
|---|---|---|---|
| Temat | „Wpływ wsparcia rówieśników na zaangażowanie” | Zapowiada wniosek, którego jeden pomiar nie daje | „Wsparcie rówieśników a zaangażowanie w studia” |
| Schemat | „Badanie ankietowe” | Ankieta to technika, nie plan badania | „Badanie korelacyjne, przekrojowe, z jednym pomiarem” |
| Zmienna X | „Zmienna niezależna” | Nazwa sugeruje, że badacz ustalał jej poziom | predyktor lub zmienna objaśniająca |
| Zmienna Y | „Zmienna zależna” | Sugeruje kierunek zależności | zmienna kryterialna lub wynikowa |
| Zmienna Z | „Wyeliminowano wpływ wieku” | Kontrola statystyczna jest przybliżona i liniowa | „Uwzględniono wiek jako zmienną kontrolną” |
| Hipoteza | „Wsparcie zwiększa zaangażowanie” | Hipoteza przyczynowa, której plan nie sprawdza | „Wyższemu wsparciu towarzyszy wyższe zaangażowanie” |
Jeśli promotor lub uczelnia wymagają nazw „zmienna niezależna” i „zmienna zależna”, zostaw je – te wymagania mają pierwszeństwo – i dodaj jedno zdanie: „Określeń »zmienna niezależna« i »zmienna zależna« użyto w znaczeniu statystycznym, bez założenia o kierunku zależności”. Więcej o formułowaniu hipotez znajdziesz we wpisie pytania badawcze i hipotezy.
Ile osób: moc testu i szerokość przedziału
Najczęściej liczy się liczebność z mocy: pwr.r.test(r = .25, power = .80) daje 122.45, czyli 123 osoby. Dokładając 20% zapasu na niekompletne ankiety, planujesz 154. Założonej wartości r nie bierz z konwencji ani z własnych danych, tylko z badań o podobnym temacie. Punktem odniesienia może być zestawienie korelacji z metaanaliz w badaniach różnic indywidualnych, w którym mediana wyniosła .19, a 75. centyl .29 (Gignac i Szodorai, 2016).
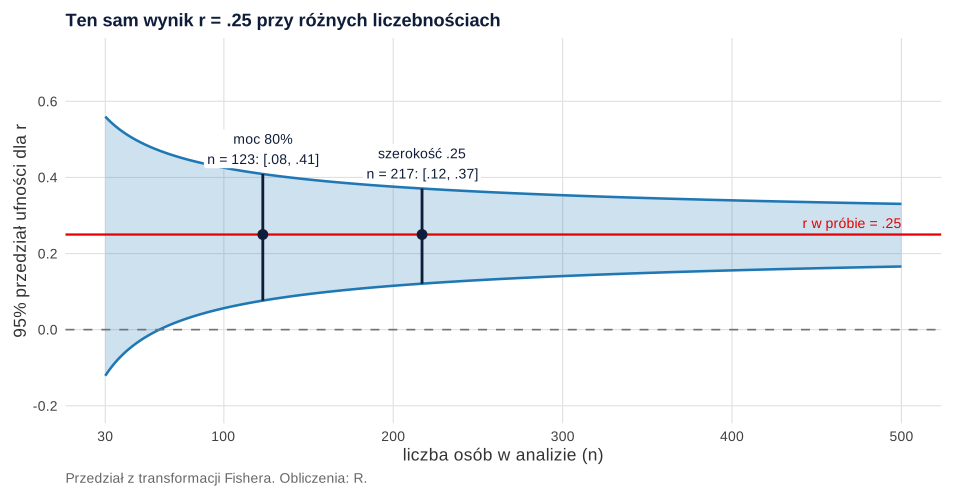
Moc odpowiada jednak tylko na pytanie, czy odróżnisz r od zera. W badaniu korelacyjnym często ważniejsze jest, jak dokładnie oszacujesz związek. Liczebność dla założonej szerokości przedziału omawiają Bonett i Wright (2000), a ogólną logikę – wpis liczebność próby z precyzji. Tabela pokazuje, co dostajesz, gdy w próbie wyjdzie r = .25.
| n | Moc dla r = .25 | 95% CI | Szerokość |
|---|---|---|---|
| 50 | .42 | [−.03, .49] | .52 |
| 100 | .71 | [.06, .43] | .37 |
| 123 | .80 | [.08, .41] | .33 |
| 150 | .87 | [.09, .39] | .30 |
| 200 | .95 | [.12, .38] | .26 |
| 300 | .99 | [.14, .35] | .21 |
| 500 | 1.00 | [.17, .33] | .16 |
Przy 123 osobach wynik będzie istotny, ale związek może być ledwie zauważalny (.08) albo wyraźny (.41). Przedział o szerokości .25 wymaga 217 osób, a .20 – 339 (rysunek 1). W pracy dyplomowej rzadko da się tyle zebrać, więc uczciwe rozwiązanie brzmi tak: podaj rachunek mocy, a przy wyniku pokaż przedział i oceń go słowami (czy korelacja .30 to dużo?).
Jedna pułapka dotyczy planu z kontrolą zmiennych. Korelacja cząstkowa bywa wyraźnie mniejsza od surowej. Dla r cząstkowego równego .15 i dwóch zmiennych kontrolnych potrzeba już 348 osób, więc 123 osoby nie wystarczą do tej hipotezy.
Kolejność kwestionariuszy i wspólna metoda
Gdy wszystkie skale wypełnia ta sama osoba w jednym podejściu, wcześniejsze pytania mogą nastawiać odpowiedzi na późniejsze (efekt kolejności pytań). W kilku prostych decyzjach da się to ograniczyć i opisać:
- Metryczka na końcu, jeśli nie służy do kwalifikacji. Pytania wrażliwe także raczej później niż wcześniej.
- Dwie wersje formularza z odwróconą kolejnością predyktora i zmiennej wynikowej, przydzielane losowo. Wiele narzędzi ankietowych pozwala to ustawić.
- Rozdzielenie skal krótką instrukcją, a jeśli to możliwe, różnym formatem odpowiedzi.
- Zapis w pracy: która wersja, ile osób, czy korelacje w wersjach były podobne.
Losowa kolejność skal nie zmienia badania w eksperyment: losujesz kolejność pytań, a nie poziom wsparcia. Sprawdzenie w naszym przykładzie dało r = .34 w wersji A i r = .26 w wersji B (z = 0.54, p = .590). Przy około 78 osobach w grupie to słaby test, więc napisz „nie stwierdzono różnicy”, a nie „kolejność nie ma znaczenia”.
Z tego samego źródła bierze się wspólna wariancja metody: związek samoopisu z samoopisem może być częściowo związkiem metody z metodą. Podsakoff i in. (2003) przeglądają jej źródła oraz proceduralne i statystyczne sposoby kontroli. Najlepiej działa to, co zrobisz przed zbieraniem danych: drugi informator, dane z dokumentacji albo rozdzielenie pomiarów w czasie. Jeśli to niemożliwe, opisz to w ograniczeniach.
Kontrolowanie zmiennych: kiedy pomaga, a kiedy myli
Kontrola statystyczna ma odpowiedzieć na pytanie: czy związek X z Y utrzymuje się u osób podobnych pod względem Z? Liczymy to korelacją cząstkową albo regresją. Dodawanie zmiennych „na wszelki wypadek” nie jest jednak bezpieczne: Becker i in. (2016) zwracają uwagę, że zmienne kontrolne mogą prowadzić do nieinterpretowalnych oszacowań i błędnych wniosków. Rozstrzygające jest pytanie o miejsce Z w mechanizmie, a nie to, czy Z koreluje z X i Y.
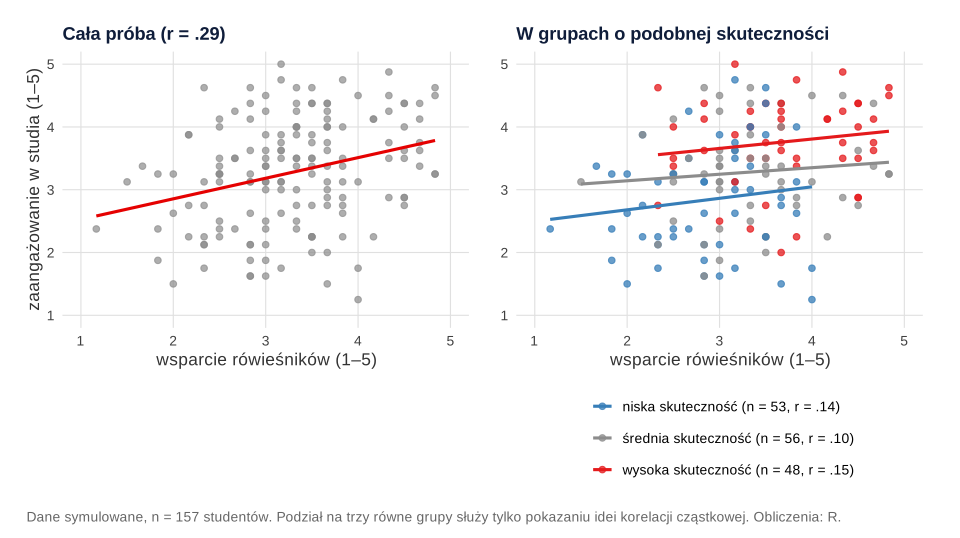
W przykładzie wsparcie i zaangażowanie korelują na poziomie r(155) = .29, 95% CI [.14, .43]. Po uwzględnieniu wieku i trybu studiów – cech, których wsparcie nie mogło zmienić – wynik się nie zmienia: r(153) = .29. Inaczej jest z poczuciem skuteczności. Koreluje ono ze wsparciem (.48) i z zaangażowaniem (.48), a po jego uwzględnieniu zostaje r(152) = .08, 95% CI [−.08, .24] (rysunek 2). Czytelnik pyta wtedy: czy skuteczność wyjaśnia ten związek, czy jest drogą, którą on działa?
Dane tego nie rozstrzygną. W symulacji (rysunek 3, 200 000 obserwacji na świat) ta sama struktura korelacji powstaje w mechanizmach o przeciwnym znaczeniu:
- Świat A: zmienna zakłócająca. Skuteczność wpływa na wsparcie i na zaangażowanie, a wsparcie na zaangażowanie nie wpływa wcale. Korelacja surowa wynosi .30, cząstkowa .00. Kontrola jest tu właściwa.
- Świat B: mediator. Wsparcie wpływa na skuteczność, a ta na zaangażowanie. Te same .30 i .00, ale całkowity wpływ wsparcia wynosi .30. Kontrola usuwa drogę, którą badasz.
- Świat C: zakłócacz zmierzony słabo. Jak w świecie A, ale skuteczność zmierzono z rzetelnością .60. Korelacja cząstkowa wynosi .15 mimo braku wpływu, a w 2000 próbach po 157 osób była istotna w 45.4% przypadków.
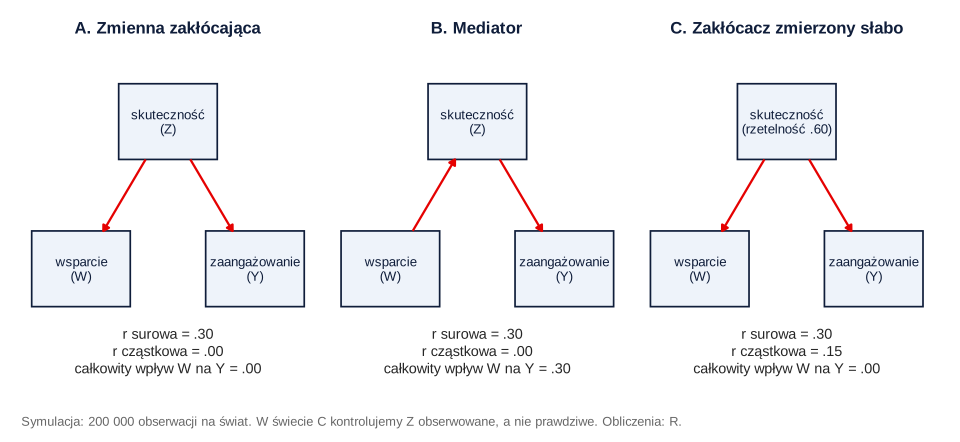
Świat B jest zgodny z ostrzeżeniem Rohrer (2018), że mediatorów i zderzaczy nie należy kontrolować, jeśli interesuje nas efekt przyczynowy. Świat C odpowiada wynikom Westfalla i Yarkoniego (2016): pomijanie nierzetelności zmiennych kontrolnych prowadzi do wysokiego odsetka błędów I rodzaju w twierdzeniach o przyrostowej trafności. W praktyce zapisz przed analizą, co kontrolujesz i z jakiego powodu, a zmienne, które mogą być skutkiem predyktora, pokaż osobno. Pomocne będą wpisy czy kontrolować wiek i płeć oraz grafy przyczynowe (DAG).
Gotowy podrozdział „Metoda” z komentarzem
Poniższy tekst to fikcyjny wzór. Nawiasy kwadratowe uzupełnij własnymi danymi, a nazwy narzędzi podaj z autorami i polską adaptacją.
Schemat badania
Komentarz. Ostatnie zdanie wykonuje połowę pracy obronnej. Słowo „przekrojowy” (schemat przekrojowy) mówi, że nie znasz kolejności zdarzeń.
Uczestnicy
Komentarz. Jawny dobór wygodny ogranicza uogólnianie, ale ukrywanie go nie pomaga. Podaj też, jak potraktowano braki danych.
Narzędzia
Komentarz. Podaj rzetelność w swojej próbie, nie tylko za autorami. Jest ona ważna podwójnie, bo rzetelność zmiennej kontrolnej decyduje o tym, ile z niej naprawdę kontrolujesz (świat C).
Procedura
Komentarz. Nie pisz, że badanie było „randomizowane”, bo czytelnik zrozumie to jako losowy przydział do warunków. Losowana była wyłącznie kolejność skal.
Plan analizy
Komentarz. To tu widać, że decyzje zapadły przed danymi. Jeśli zmiennych kontrolnych jest dużo, nie interpretuj każdego współczynnika modelu jak samodzielnego wyniku. Układ tabeli z korelacjami opisuje wpis jak opisać tabelę korelacji.
Wynik w jednym akapicie
Co wolno napisać we wnioskach
Grosz i in. (2020) opisują, że badacze formalnie unikają pytań przyczynowych, a mimo to interpretują wyniki tak, jakby były efektami – tyle że niejawnie i bez założeń. W pracy dyplomowej objawia się to „językiem rekomendacji”. Zasada: opisujesz współwystępowanie, a mechanizm przedstawiasz jako hipotezę.
| Jak bywa napisane | Co jest nie tak | Poprawione |
|---|---|---|
| „Wsparcie rówieśników zwiększa zaangażowanie” | Język przyczynowy | „Osoby deklarujące większe wsparcie były bardziej zaangażowane” |
| „Skuteczność wyjaśnia związek wsparcia z zaangażowaniem” | Rozstrzyga mechanizm, którego dane nie odróżniają | „Po uwzględnieniu skuteczności związek osłabł; dane jednego pomiaru nie pozwalają ustalić, czy skuteczność jest czynnikiem zakłócającym, czy pośredniczącym” |
| „Po kontroli nie ma związku” | Brak istotności to nie brak związku | „Przedział [−.08, .24] nie wyklucza ani braku związku, ani słabego związku dodatniego” |
| „Należy rozwijać wsparcie, aby podnieść zaangażowanie” | Rekomendacja zakłada wpływ | „Warto sprawdzić w badaniu podłużnym lub interwencyjnym, czy zmiana wsparcia poprzedza zmianę zaangażowania” |
| „Wyniki dotyczą studentów w Polsce” | Dobór wygodny, jeden kierunek | „Wyniki dotyczą osób podobnych do badanej próby” |
Pełny akapit do dyskusji lub ograniczeń:
Dalsze wzory znajdziesz we wpisach ograniczenia badania i wnioski i rekomendacje, a kontrast z planem z losowym przydziałem – w opisie eksperymentu z losowym przydziałem. Jeśli pytanie dotyczy kolejności zmian, rozważ ankietę w kilku falach.
Na co zwrócić uwagę w poszczególnych dziedzinach
To obserwacje ogólne o częstych problemach, nie reguły. Wymagania uczelni i promotora mają pierwszeństwo.
| Dziedzina | Częsty problem | Co opisać |
|---|---|---|
| Psychologia | Same samoopisy; mediacja liczona na jednym pomiarze | Właściwości skal w polskich adaptacjach, kolejność skal, zastrzeżenie, że mediacja przekrojowa nie ustala kolejności |
| Nauki o zdrowiu | Wiek, choroby współistniejące i oddział wiążą się z wieloma zmiennymi; próba z jednego ośrodka | Skąd pochodzą dane (ankieta, dokumentacja), kryteria włączenia, granice uogólniania na innych pacjentów |
| Fizjoterapia | Mała próba kliniczna; korelacja bólu i funkcji czytana jak efekt ćwiczeń | Protokół i rzetelność pomiaru funkcji, szerokość przedziału, brak wniosków o skuteczności programu |
| Zarządzanie | Jeden respondent ocenia i przełożonego, i siebie; osoby z tych samych zespołów | Wspólna metoda, zagnieżdżenie w zespołach, implikacje dla menedżerów sformułowane warunkowo |
Najczęstsze błędy
- Tytuł o „wpływie” przy jednym pomiarze. Zmień tytuł albo plan badania.
- Liczebność wzięta z tabel dla sondaży. Margines błędu dla odsetka nie mówi nic o precyzji r.
- Rachunek mocy tylko dla korelacji surowej, gdy główna hipoteza dotyczy związku po kontroli.
- Kontrola „wszystkiego, co jest w metryczce”, bez uzasadnienia roli każdej zmiennej.
- Kontrola mediatora i wniosek, że „związek jest pozorny”.
- Zmienna kontrolna mierzona jednym pytaniem i pewność, że została „wyeliminowana”.
- Sama wartość p bez przedziału, zwłaszcza przy wyniku nieistotnym.
- Zalecenia praktyczne wyprowadzone wprost z korelacji.
Badanie korelacyjne w R: liczebność, analiza i trzy mechanizmy
Trzy przepisy liczą wszystkie liczby z tekstu. Pierwszy wyznacza liczebność, drugi tworzy symulowane dane i wykonuje analizę, a dane zapisuje w pliku CSV w folderze nadrzędnym (../), trzeci porównuje trzy mechanizmy. Rysunki powstały w osobnym skrypcie na tych samych danych. Dane możesz pobrać: badanie-korelacyjne-wsparcie-zaangazowanie.csv (168 ankiet: wersja formularza, wiek, tryb studiów, pozycje trzech skal; puste pola to braki).
Moc testu i szerokość przedziału dla r
R
# B467 – badanie korelacyjne: ile osób dla r = .25 (moc testu i szerokość przedziału ufności)
library(pwr)

r_plan <- .25   # najmniejszy związek, który ma znaczenie merytoryczne (uzasadnij literaturą)
moc <- pwr.r.test(r = r_plan, power = .80, sig.level = .05, alternative = "two.sided")
n_moc <- ceiling(moc$n)
cat(sprintf("Moc 80%%, r = .25, alfa = .05 (dwustronnie): n = %.2f, czyli %d osób\n", moc$n, n_moc))
cat(sprintf("Zapas na niekompletne ankiety 20%%: %d osób do zaproszenia do udziału\n", ceiling(n_moc / .80)))

# Mniejszy związek po kontroli zmiennych: r cząstkowa = .15, k = 2 zmienne kontrolne (df = n - 2 - k)
k <- 2
n_czastkowa <- ceiling(pwr.r.test(r = .15, power = .80, sig.level = .05)$n) + k
cat(sprintf("Cząstkowa r = .15, k = %d zmienne kontrolne: n = %d\n\n", k, n_czastkowa))

# Przedział ufności dla r z transformacji Fishera
ci_r <- function(r, n, poziom = .95) {
  q <- qnorm(1 - (1 - poziom) / 2)
  tanh(atanh(r) + c(-1, 1) * q / sqrt(n - 3))
}
n_dla_szerokosci <- function(r, szerokosc) {
  n <- 4
  while (diff(ci_r(r, n)) > szerokosc) n <- n + 1
  n
}

n_siatka <- c(50, 100, n_moc, 150, 200, 300, 500)
tabela <- t(sapply(n_siatka, function(n) {
  ci <- ci_r(r_plan, n)
  c(n = n, moc = pwr.r.test(n = n, r = r_plan, sig.level = .05)$power,
    dolna = ci[1], gorna = ci[2], szerokosc = diff(ci))
}))
cat("Co daje dana liczebność, gdy r w próbie wynosi .25:\n")
print(round(as.data.frame(tabela), 3), row.names = FALSE)

cat("\nLiczebność dla zadanej szerokości 95% CI (r = .25):\n")
for (s in c(.40, .30, .25, .20)) cat(sprintf("  szerokość %.2f: n = %d\n", s, n_dla_szerokosci(r_plan, s)))
Wynik w R
Moc 80%, r = .25, alfa = .05 (dwustronnie): n = 122.45, czyli 123 osób
Zapas na niekompletne ankiety 20%: 154 osób do zaproszenia do udziału
Cząstkowa r = .15, k = 2 zmienne kontrolne: n = 348

Co daje dana liczebność, gdy r w próbie wynosi .25:
   n   moc  dolna gorna szerokosc
  50 0.423 -0.030 0.494     0.524
 100 0.715  0.056 0.426     0.369
 123 0.802  0.076 0.409     0.333
 150 0.874  0.093 0.394     0.301
 200 0.949  0.115 0.376     0.260
 300 0.993  0.141 0.353     0.212
 500 1.000  0.166 0.330     0.164

Liczebność dla zadanej szerokości 95% CI (r = .25):
  szerokość 0.40: n = 86
  szerokość 0.30: n = 151
  szerokość 0.25: n = 217
  szerokość 0.20: n = 339
Dane, rzetelność, korelacje i korelacje cząstkowe
R
# B467 – wsparcie rówieśników a zaangażowanie w studia: dane symulowane i analiza
set.seed(4672)

n_ankiet <- 168
skutecznosc <- rnorm(n_ankiet)
wsparcie <- .55 * skutecznosc + sqrt(1 - .55^2) * rnorm(n_ankiet)
zaangazowanie <- .10 * wsparcie + .50 * skutecznosc + sqrt(1 - .10^2 - .50^2 - 2 * .10 * .50 * .55) * rnorm(n_ankiet)

pozycje <- function(cecha, liczba, prefiks) {
  m <- sapply(seq_len(liczba), function(i)
    pmin(pmax(round(3.2 + .80 * cecha + rnorm(length(cecha), 0, .75)), 1), 5))
  colnames(m) <- paste0(prefiks, seq_len(liczba))
  as.data.frame(m)
}
dane <- data.frame(
  id = seq_len(n_ankiet),
  wersja = sample(rep(c("A", "B"), length.out = n_ankiet)),
  wiek = pmin(pmax(round(rnorm(n_ankiet, 21.5, 2.2)), 19), 30),
  tryb = sample(c("stacjonarne", "niestacjonarne"), n_ankiet, replace = TRUE, prob = c(.72, .28)),
  pozycje(wsparcie, 6, "wsp"), pozycje(zaangazowanie, 8, "zaa"), pozycje(skutecznosc, 5, "sku")
)
# Część osób przerwała wypełnianie przed ostatnią skalą
przerwali <- sample(dane$id, 11)
dane[przerwali, paste0("sku", 1:5)] <- NA
write.csv(dane, "../badanie-korelacyjne-wsparcie-zaangazowanie.csv", row.names = FALSE, na = "", fileEncoding = "UTF-8")

# ---- Analiza ----
d <- dane[complete.cases(dane), ]
cat(sprintf("Ankiety: %d, niekompletne: %d (%.1f%%), do analizy: %d\n", nrow(dane), nrow(dane) - nrow(d),
            100 * (nrow(dane) - nrow(d)) / nrow(dane), nrow(d)))
cat(sprintf("Wersja A: %d, wersja B: %d; wiek M = %.2f, SD = %.2f; stacjonarne %.1f%%\n\n",
            sum(d$wersja == "A"), sum(d$wersja == "B"), mean(d$wiek), sd(d$wiek), 100 * mean(d$tryb == "stacjonarne")))

alfa <- function(x) { k <- ncol(x); k / (k - 1) * (1 - sum(apply(x, 2, var)) / var(rowSums(x))) }
skale <- list(wsparcie = paste0("wsp", 1:6), zaangazowanie = paste0("zaa", 1:8), skutecznosc = paste0("sku", 1:5))
for (s in names(skale)) d[[s]] <- rowMeans(d[skale[[s]]])
opis <- t(sapply(names(skale), function(s)
  c(M = mean(d[[s]]), SD = sd(d[[s]]), alfa = alfa(d[skale[[s]]]))))
print(round(opis, 2))

# Zapis APA: bez zera wiodącego dla r i p
bz <- function(x) sub("^(-?)0\\.", "\\1.", sprintf("%.2f", x))
p_apa <- function(p) if (p < .001) "p < .001" else paste0("p = ", sub("^0", "", sprintf("%.3f", p)))
r_apa <- function(r, df, ci, p) sprintf("r(%d) = %s, 95%% CI [%s, %s], %s", df, bz(r), bz(ci[1]), bz(ci[2]), p_apa(p))
r_tekst <- function(w) r_apa(w$estimate, w$parameter, w$conf.int, w$p.value)

cat("\nKorelacje zerowego rzędu (Pearson):\n")
cat("wsparcie - zaangazowanie:   ", r_tekst(cor.test(d$wsparcie, d$zaangazowanie)), "\n")
cat("wsparcie - skutecznosc:     ", r_tekst(cor.test(d$wsparcie, d$skutecznosc)), "\n")
cat("skutecznosc - zaangazowanie:", r_tekst(cor.test(d$skutecznosc, d$zaangazowanie)), "\n")
cat("Spearman wsparcie - zaangazowanie: rho =", bz(cor(d$wsparcie, d$zaangazowanie, method = "spearman")), "\n")

# Kolejność kwestionariuszy: czy korelacja różni się między wersjami A i B?
ra <- with(d[d$wersja == "A", ], cor(wsparcie, zaangazowanie)); na <- sum(d$wersja == "A")
rb <- with(d[d$wersja == "B", ], cor(wsparcie, zaangazowanie)); nb <- sum(d$wersja == "B")
z <- (atanh(ra) - atanh(rb)) / sqrt(1 / (na - 3) + 1 / (nb - 3))
cat(sprintf("\nWersja A: r = %s, wersja B: r = %s; z = %.2f, %s\n", bz(ra), bz(rb), z, p_apa(2 * pnorm(-abs(z)))))

# Korelacja cząstkowa z resztami regresji; df = n - 2 - k, CI Fishera z SE = 1/sqrt(n - 3 - k)
czastkowa <- function(x, y, kontrola, dane) {
  rx <- resid(lm(reformulate(kontrola, x), dane))
  ry <- resid(lm(reformulate(kontrola, y), dane))
  r <- cor(rx, ry); n <- nrow(dane); k <- length(kontrola); df <- n - 2 - k
  t <- r * sqrt(df / (1 - r^2))
  se <- 1 / sqrt(n - 3 - k)
  ci <- tanh(atanh(r) + c(-1, 1) * qnorm(.975) * se)
  r_apa(r, df, ci, 2 * pt(-abs(t), df))
}
cat("\nKorelacje cząstkowe wsparcie - zaangazowanie:\n")
cat("kontrola: wiek, tryb:              ", czastkowa("wsparcie", "zaangazowanie", c("wiek", "tryb"), d), "\n")
cat("kontrola: wiek, tryb, skutecznosc: ", czastkowa("wsparcie", "zaangazowanie", c("wiek", "tryb", "skutecznosc"), d), "\n")

m1 <- lm(zaangazowanie ~ wsparcie + wiek + tryb, d)
m2 <- lm(zaangazowanie ~ wsparcie + wiek + tryb + skutecznosc, d)
wsp <- function(m) sprintf("b = %.2f, 95%% CI [%.2f, %.2f]", coef(m)["wsparcie"],
                           confint(m)["wsparcie", 1], confint(m)["wsparcie", 2])
cat("\nRegresja (M1, bez skuteczności):", wsp(m1), "R2 =", bz(summary(m1)$r.squared), "\n")
cat("Regresja (M2, ze skutecznością):", wsp(m2), "R2 =", bz(summary(m2)$r.squared), "\n")
Wynik w R
Ankiety: 168, niekompletne: 11 (6.5%), do analizy: 157
Wersja A: 78, wersja B: 79; wiek M = 21.57, SD = 1.82; stacjonarne 71.3%

                 M   SD alfa
wsparcie      3.29 0.77 0.83
zaangazowanie 3.28 0.86 0.90
skutecznosc   3.32 0.86 0.85

Korelacje zerowego rzędu (Pearson):
wsparcie - zaangazowanie:    r(155) = .29, 95% CI [.14, .43], p < .001
wsparcie - skutecznosc:      r(155) = .48, 95% CI [.35, .59], p < .001
skutecznosc - zaangazowanie: r(155) = .48, 95% CI [.34, .59], p < .001
Spearman wsparcie - zaangazowanie: rho = .29

Wersja A: r = .34, wersja B: r = .26; z = 0.54, p = .590

Korelacje cząstkowe wsparcie - zaangazowanie:
kontrola: wiek, tryb:               r(153) = .29, 95% CI [.14, .43], p < .001
kontrola: wiek, tryb, skutecznosc:  r(152) = .08, 95% CI [-.08, .24], p = .311

Regresja (M1, bez skuteczności): b = 0.33, 95% CI [0.16, 0.50] R2 = .10
Regresja (M2, ze skutecznością): b = 0.09, 95% CI [-0.09, 0.27] R2 = .25
Trzy mechanizmy: surowa i cząstkowa korelacja
R
# B467 – trzy mechanizmy, a korelacja surowa i cząstkowa: W (wsparcie), Y (zaangażowanie), Z (skuteczność)
set.seed(4673)

czastkowa <- function(x, y, z) cor(resid(lm(x ~ z)), resid(lm(y ~ z)))
n <- 200000
reszta <- function(...) sqrt(1 - sum(c(...)^2))

# Świat A: Z wpływa na W i na Y, W nie wpływa na Y (zmienna zakłócająca)
z_a <- rnorm(n); w_a <- .6 * z_a + reszta(.6) * rnorm(n); y_a <- .5 * z_a + reszta(.5) * rnorm(n)
# Świat B: W wpływa na Z, Z wpływa na Y (mediator)
w_b <- rnorm(n); z_b <- .6 * w_b + reszta(.6) * rnorm(n); y_b <- .5 * z_b + reszta(.5) * rnorm(n)
# Świat C: jak A, ale Z zmierzono z rzetelnością .60
rzetelnosc <- .60
z_c <- z_a * sqrt(rzetelnosc) + sqrt(1 - rzetelnosc) * rnorm(n)

wynik <- data.frame(
  swiat = c("A: zmienna zakłócająca", "B: mediator", "C: Z zmierzone z rzetelnością .60"),
  r_surowa = c(cor(w_a, y_a), cor(w_b, y_b), cor(w_a, y_a)),
  r_czastkowa = c(czastkowa(w_a, y_a, z_a), czastkowa(w_b, y_b, z_b), czastkowa(w_a, y_a, z_c)),
  caly_wplyw_W_na_Y = c(0, .6 * .5, 0)
)
print(cbind(wynik[1], round(wynik[-1], 3)), row.names = FALSE)

# Świat C w próbach o liczebności badania: jak często cząstkowa wychodzi "istotna"?
powtorzen <- 2000; n_proby <- 157
p_cz <- replicate(powtorzen, {
  z <- rnorm(n_proby); w <- .6 * z + reszta(.6) * rnorm(n_proby); y <- .5 * z + reszta(.5) * rnorm(n_proby)
  z_obs <- z * sqrt(rzetelnosc) + sqrt(1 - rzetelnosc) * rnorm(n_proby)
  rp <- czastkowa(w, y, z_obs); df <- n_proby - 3
  2 * pt(-abs(rp * sqrt(df / (1 - rp^2))), df)
})
cat(sprintf("\nŚwiat C, %d prób po n = %d: cząstkowa z p < .05 w %.1f%% prób (przy braku wpływu W na Y)\n",
            powtorzen, n_proby, 100 * mean(p_cz < .05)))
Wynik w R
                             swiat r_surowa r_czastkowa caly_wplyw_W_na_Y
            A: zmienna zakłócająca    0.302       0.001               0.0
                       B: mediator    0.300      -0.001               0.3
 C: Z zmierzone z rzetelnością .60    0.302       0.147               0.0

Świat C, 2000 prób po n = 157: cząstkowa z p < .05 w 45.4% prób (przy braku wpływu W na Y)
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietem pwr; rysunki przygotowano w pakietach ggplot2, patchwork i svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- pwr (wersja 1.3-0): Champely, S. (2020). pwr: Basic functions for power analysis [R package]. https://doi.org/10.32614/CRAN.package.pwr
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Zanim oddasz podrozdział „Metoda”, sprawdź…
- Czy tytuł, hipotezy i wnioski używają języka związku, a nie wpływu?
- Czy schemat nazwano wprost: korelacyjny, przekrojowy lub podłużny?
- Czy założone r ma uzasadnienie w literaturze, a rachunek dotyczy głównej hipotezy?
- Czy przy wyniku podano przedział ufności?
- Czy kolejność kwestionariuszy jest opisana i (jeśli to możliwe) zrównoważona?
- Czy każda zmienna kontrolna ma uzasadnienie i nie może być skutkiem predyktora?
- Czy zmienne o niejasnej roli pokazano osobno, z zastrzeżeniem?
- Czy ograniczenia wymieniają wspólną metodę, dobór próby i jednorazowy pomiar?
Najczęstsze pytania
Czy w pracy korelacyjnej mogę napisać „wpływ”, jeśli tak brzmi zatwierdzony temat?
Temat zatwierdzony przez uczelnię czasem trudno zmienić. Wtedy w metodzie wyjaśnij, że sformułowanie tematu opisuje zainteresowanie badawcze, a zastosowany schemat korelacyjny pozwala ocenić tylko współwystępowanie zmiennych. W wynikach i wnioskach trzymaj się języka związku i porozmawiaj z promotorem o możliwej korekcie tytułu.
Ile osób wystarczy do badania korelacyjnego w pracy licencjackiej lub magisterskiej?
Nie ma jednej liczby, bo zależy to od oczekiwanej wielkości związku. Dla r = .25, mocy 80% i α = .05 potrzeba 123 osób, ale przedział ufności będzie wtedy szeroki: około [.08, .41]. Podaj rachunek i założenie o wielkości r, a do oceny wyniku używaj przedziału.
Czy nieistotna korelacja cząstkowa oznacza, że związku nie ma?
Nie. W przykładzie po uwzględnieniu poczucia skuteczności r(152) = .08, a przedział [−.08, .24] mieści i brak związku, i słaby związek dodatni. Do tego spadek po kontroli nie wskazuje, czy kontrolowana zmienna zakłóca związek, czy pośredniczy w nim.
Czy losowa kolejność kwestionariuszy robi z badania korelacyjnego eksperyment?
Nie. Losowy przydział dotyczy wtedy tylko kolejności skal, a nie poziomu predyktora. Badanie pozostaje korelacyjne. Losowanie wersji formularza pozwala jedynie ograniczyć i sprawdzić efekt kolejności pytań.
Co zrobić, gdy promotor wymaga określeń „zmienna niezależna” i „zmienna zależna” w badaniu bez manipulacji?
Zastosuj te określenia i dodaj jedno zdanie, że używasz ich w znaczeniu statystycznym, bez założenia o kierunku zależności. Dalej w tekście pisz o związku, a nie o wpływie.
Powiązane hasła
Przeczytaj też
Powtarzane pomiary – jak opisać metodę
Kontrbalansowanie, kwadrat łaciński i zrównoważony, odstępy, wprawa, przeniesienie, ubytek i łączenie pomiarów po kodzie – wzór metody z komentarzem i symulacja efektu kolejności w R.
Czytaj →PoradnikPorównanie grup istniejących
Pacjenci i osoby bez choroby, zawody, płeć: źródło każdej grupy, dobór grupy porównawczej, standaryzowane różnice, ANCOVA ostrożnie i gotowa metoda – z kodem R.
Czytaj →PoradnikRozdział metodologiczny – jak go napisać
Co napisać w każdym podrozdziale metody: hipotezy, zmienne, próba, narzędzia, procedura, etyka i plan analiz – z wzorami zdań i listą JARS.
Czytaj →PoradnikKorelacja Pearsona i Spearmana krok po kroku
Wybór miary, wykres rozrzutu, przedział ufności z transformacji Fishera, siła r, korelacja cząstkowa, macierz w APA i opis wyników z kodem R.
Czytaj →PoradnikJak opisać tabelę korelacji w pracy?
Tabela korelacji w stylu APA, opis wzorca zamiast listy współczynników, korekta przy wielu korelacjach, Pearson obok Spearmana i gotowy wzór opisu.
Czytaj →PoradnikEksperyment z losowym przydziałem – jak opisać metodę
Warunki, jednostka randomizacji, lista blokowa, ukrycie przydziału, zaślepienie i gotowy podrozdział Metoda z kodem R.
Czytaj →PoradnikBadanie przed i po – opis metody i wnioski
Gotowy podrozdział „Metoda” dla jednej grupy i grupy nierandomizowanej, symulacja regresji do średniej i zdania, które wolno napisać we wnioskach.
Czytaj →PoradnikSondaż przekrojowy – jak opisać metodę
Gotowy podrozdział „Metoda” dla ankiety w zdrowiu: STROBE, rekrutacja, odsetek odpowiedzi, braki danych, PR a OR i to, co wolno napisać we wnioskach – z przykładem w R.
Czytaj →Piszesz pracę opartą na korelacjach?
Pomożemy zaplanować liczebność, dobrać zmienne kontrolne i opisać metodę oraz wnioski tak, żeby tekst odpowiadał zastosowanemu schematowi – w R lub SPSS, z wyjaśnieniem, które pozwoli Ci samodzielnie obronić wyniki.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Becker, T. E., Atinc, G., Breaugh, J. A., Carlson, K. D., Edwards, J. R., & Spector, P. E. (2016). Statistical control in correlational studies: 10 essential recommendations for organizational researchers. Journal of Organizational Behavior, 37(2), 157–167. https://doi.org/10.1002/job.2053
- Bonett, D. G., & Wright, T. A. (2000). Sample size requirements for estimating Pearson, Kendall and Spearman correlations. Psychometrika, 65(1), 23–28. https://doi.org/10.1007/bf02294183
- Gignac, G. E., & Szodorai, E. T. (2016). Effect size guidelines for individual differences researchers. Personality and Individual Differences, 102, 74–78. https://doi.org/10.1016/j.paid.2016.06.069
- Grosz, M. P., Rohrer, J. M., & Thoemmes, F. (2020). The taboo against explicit causal inference in nonexperimental psychology. Perspectives on Psychological Science, 15(5), 1243–1255. https://doi.org/10.1177/1745691620921521 ● Otwarty dostęp
- Podsakoff, P. M., MacKenzie, S. B., Lee, J.-Y., & Podsakoff, N. P. (2003). Common method biases in behavioral research: A critical review of the literature and recommended remedies. Journal of Applied Psychology, 88(5), 879–903. https://doi.org/10.1037/0021-9010.88.5.879
- Rohrer, J. M. (2018). Thinking clearly about correlations and causation: Graphical causal models for observational data. Advances in Methods and Practices in Psychological Science, 1(1), 27–42. https://doi.org/10.1177/2515245917745629 ● Otwarty dostęp
- Westfall, J., & Yarkoni, T. (2016). Statistically controlling for confounding constructs is harder than you think. PLOS ONE, 11(3), Article e0152719. https://doi.org/10.1371/journal.pone.0152719 ● Otwarty dostęp
Cytowania BibTeX
@article{becker2016statistical, author={Becker, Thomas E. and Atinc, Guclu and Breaugh, James A. and Carlson, Kevin D. and Edwards, Jeffrey R. and Spector, Paul E.}, title={{Statistical control in correlational studies: 10 essential recommendations for organizational researchers}}, journal={Journal of Organizational Behavior}, year={2016}, volume={37}, number={2}, pages={157--167}, doi={10.1002/job.2053}}@article{bonett2000sample, author={Bonett, Douglas G. and Wright, Thomas A.}, title={{Sample size requirements for estimating Pearson, Kendall and Spearman correlations}}, journal={Psychometrika}, year={2000}, volume={65}, number={1}, pages={23--28}, doi={10.1007/bf02294183}}@article{gignac2016effect, author={Gignac, Gilles E. and Szodorai, Eva T.}, title={{Effect size guidelines for individual differences researchers}}, journal={Personality and Individual Differences}, year={2016}, volume={102}, pages={74--78}, doi={10.1016/j.paid.2016.06.069}}@article{grosz2020taboo, author={Grosz, Michael P. and Rohrer, Julia M. and Thoemmes, Felix}, title={{The taboo against explicit causal inference in nonexperimental psychology}}, journal={Perspectives on Psychological Science}, year={2020}, volume={15}, number={5}, pages={1243--1255}, doi={10.1177/1745691620921521}}@article{podsakoff2003common, author={Podsakoff, Philip M. and MacKenzie, Scott B. and Lee, Jeong-Yeon and Podsakoff, Nathan P.}, title={{Common method biases in behavioral research: A critical review of the literature and recommended remedies}}, journal={Journal of Applied Psychology}, year={2003}, volume={88}, number={5}, pages={879--903}, doi={10.1037/0021-9010.88.5.879}}@article{rohrer2018thinking, author={Rohrer, Julia M.}, title={{Thinking clearly about correlations and causation: Graphical causal models for observational data}}, journal={Advances in Methods and Practices in Psychological Science}, year={2018}, volume={1}, number={1}, pages={27--42}, doi={10.1177/2515245917745629}}@article{westfall2016statistically, author={Westfall, Jacob and Yarkoni, Tal}, title={{Statistically controlling for confounding constructs is harder than you think}}, journal={PLOS ONE}, year={2016}, volume={11}, number={3}, eid={e0152719}, doi={10.1371/journal.pone.0152719}}