Ankieta w kilku falach: decyzje, których nie poprawisz po pierwszej fali
Ankieta powtarzana na tych samych osobach to najprostsza forma schematu podłużnego. Łatwo ją uruchomić, ale wiele błędów wychodzi dopiero przy łączeniu fal. Zmienione brzmienie pytania, brak klucza do połączenia odpowiedzi albo brak zmiennych, które tłumaczą rezygnację, są w fali 3 nie do naprawienia. Lynn (2009) omawia cechy projektu swoiste dla badań podłużnych oraz ich mocne i słabe strony.
Liczbę pomiarów, moc i wybór modelu zmiany omawiamy we wpisie badanie podłużne w doktoracie. Ten wpis dotyczy samej ankiety: co ustalić przed falą 1, jak prowadzić dokumentację fal i jak przeanalizować ubytek. Na przykładzie w R porównujemy pięć analiz tych samych danych z trzech fal. Dwie z nich dają wynik bliski prawdzie, a jedna pokazuje spadek, którego nie było.
Co ustalić przed pierwszą falą
Liczba fal i odstęp. Odstęp dobierasz do tempa badanego procesu, a nie do kalendarza semestru. Gdy pytasz o efekty opóźnione, odstęp jest częścią hipotezy (zob. mediacja w danych podłużnych). Bardzo krótki odstęp zwiększa ryzyko efektu warunkowania panelowego, czyli zmiany odpowiedzi wywołanej samym udziałem we wcześniejszych falach. Warren i Halpern-Manners (2012) pokazują, że pominięcie tego zjawiska może dać błędny opis wielkości i korelatów zmian między falami.
Identyfikacja osób. Masz dwie drogi. Pierwsza to kod tworzony przez respondenta z elementów stałych, opisany we wpisie kod identyfikacyjny w ankiecie anonimowej. Druga to dane kontaktowe trzymane w osobnej bazie, połączonej z odpowiedziami tylko numerem uczestnika. Ta druga daje pewne łączenie i pozwala wysyłać przypomnienia. Oznacza jednak, że dane są pseudonimizowane, a nie anonimowe (zob. anonimizacja i pseudonimizacja oraz świadoma zgoda i RODO). Zgoda w fali 1 powinna więc mówić, że badanie obejmuje kolejne fale i jak długo przechowywany jest klucz.
Zmienne pomocnicze ubytku. Watson i Wooden (2009) poświęcają rozdział czynnikom, które wpływają na udział w kolejnych falach, i przewidywaniu odpowiedzi w dużym panelu. W fali 1 zadaj kilka pytań, które mogą przewidywać rezygnację i są związane z wynikiem. Przykłady to zamiar zmiany pracy lub miejsca zamieszkania, deklarowana gotowość udziału albo ocena obciążenia ankietą. Graham (2009) podkreśla, że zmienne pomocnicze zmniejszają obciążenie i zwiększają moc analiz z brakami. W przykładzie niżej to właśnie jedno takie pytanie decyduje o tym, czy model mieszany trafia w prawdziwą zmianę.
Kwestionariusz: co musi zostać takie samo
Każda zmiana narzędzia między falami miesza zmianę w ludziach ze zmianą w pomiarze. Tabela zbiera zasady, które warto spisać w protokole przed startem.
| Element | Zasada | Dlaczego |
|---|---|---|
| Brzmienie, kafeteria, skala | Bez zmian, łącznie z etykietami punktów skali i opcją „nie wiem” | Inna kafeteria zmienia rozkład odpowiedzi i udaje zmianę |
| Kolejność pytań i bloków | Bez zmian; nowe pytania dopisuj na końcu | Wcześniejsze pytania wpływają na późniejsze, więc nowy blok w środku zmienia kontekst |
| Tryb i urządzenie | Ten sam tryb we wszystkich falach albo zapis trybu jako zmiennej | Tryb wpływa na odpowiedzi (zob. efekt trybu) |
| Metryczka | Cechy stałe tylko w fali 1; w kolejnych falach tylko cechy zmienne (praca, stan cywilny) | Krótsza ankieta i mniej sprzecznych odpowiedzi |
| Skale wielopozycyjne | Plan sprawdzenia inwariancji podłużnej przed porównaniem średnich | Bez niej zmiana średniej może być zmianą znaczenia pozycji |
| Długość | Tak krótko, jak pozwala pytanie badawcze | Długa ankieta zniechęca do kolejnej fali |
Przed wysłaniem każdej fali przejdź przez ankietę jak respondent i sprawdź eksport (zob. test techniczny ankiety online). Przy kolejnych falach sprawdź też, czy link przekazuje numer uczestnika i czy nikt nie zmienił kolejności pozycji.
Dokumentacja fal: książka kodów z sufiksem fali
Jedna książka kodowa dla całego badania oszczędza tygodnie pracy. Zmienne mierzone w każdej fali dostają tę samą nazwę z sufiksem fali (wyp_w1, wyp_w2, wyp_w3). Cechy stałe mają nazwę bez sufiksu. Do każdej fali dopisz datę wypełnienia, wersję kwestionariusza i status udziału: odpowiedź, odmowa, brak kontaktu, wykluczenie. Status pozwala później odróżnić rezygnację od osoby, do której zaproszenie nie dotarło. Plik w formacie szerokim z takimi nazwami przekształcisz do formatu długiego jedną funkcją, co pokazuje przepis 1.
Utrzymanie uczestników
Podstawy, czyli przypomnienia, kilka kanałów kontaktu i dziennik odpadania, opisujemy we wpisie o badaniu podłużnym w doktoracie. Tu dwie uwagi uzupełniające. Laurie i Lynn (2009) omawiają zachęty w badaniach podłużnych, łącznie z eksperymentami w panelach. Zaplanuj zachęty od razu na wszystkie fale, także w budżecie i we wniosku do komisji etycznej. Druga uwaga: nie skreślaj osób, które opuściły jedną falę. Lugtig (2014) pokazuje, że wielu respondentów pomija jedną lub kilka fal i potem wraca, a ich przebieg udziału różni się od przebiegu osób, które odchodzą na stałe. Jeśli zgoda na to pozwala, zapraszaj je do kolejnych fal.
Przykład: trzy fale ankiety wśród pielęgniarek
W symulacji 800 pielęgniarek wypełnia skalę wypalenia (1–5) trzy razy co 6 miesięcy. W fali 1 pada też pytanie „Czy planujesz zmienić pracę w ciągu roku?”. Osoby z takim planem mają wyższe wypalenie i szybciej rosnące. Szansa odpadnięcia zależy od wypalenia w poprzedniej fali, od planu zmiany pracy i od pracy zmianowej. To mechanizm MAR: rezygnacja zależy od wartości, które badacz widzi. Kto nie odpowiedział w fali 2, nie dostaje zaproszenia do fali 3 (to uproszczenie symulacji; w praktyce takie osoby warto zapraszać ponownie).
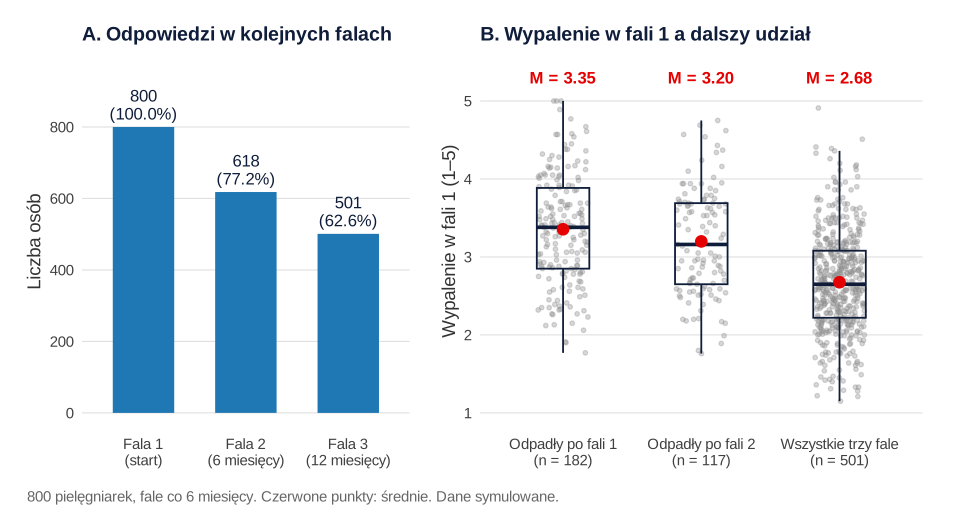
W fali 2 odpowiedziało 618 osób, a w fali 3 – 501 (62.6% próby). Wypalenie w fali 1 wyniosło średnio 3.29 u osób, które odpadły, i 2.68 u osób obecnych do końca, t(580.72) = 12.47, p < .001. Zmianę pracy planowało 48.8% osób, które odpadły, i 11.8% pozostałych.
Analiza ubytku: kto odpadł i od czego to zależało
Dumville i in. (2006) zalecają podawanie cech wyjściowych osobno dla osób analizowanych i utraconych (zob. utrata uczestników). Lepiej jednak dopasować model, w którym wszystkie zmienne z fali 1 jednocześnie przewidują udział w ostatniej fali. W przykładzie regresja logistyczna dała dla wypalenia OR = 0.36, 95% CI [0.28, 0.48], a dla planu zmiany pracy OR = 0.23, 95% CI [0.16, 0.34]. Dla pracy zmianowej wyszło OR = 0.74, 95% CI [0.52, 1.04], a dla wieku (na 10 lat) OR = 1.02, 95% CI [0.88, 1.18].
Taki model niczego nie dowodzi o mechanizmie braków. Pokazuje tylko, że braki nie są MCAR i które zmienne trzeba uwzględnić w analizie. Założenia MAR nie da się sprawdzić na danych, bo wymagałoby to znajomości odpowiedzi osób, które nie odpowiedziały (zob. braki danych MCAR, MAR i MNAR).
Pięć analiz tych samych danych
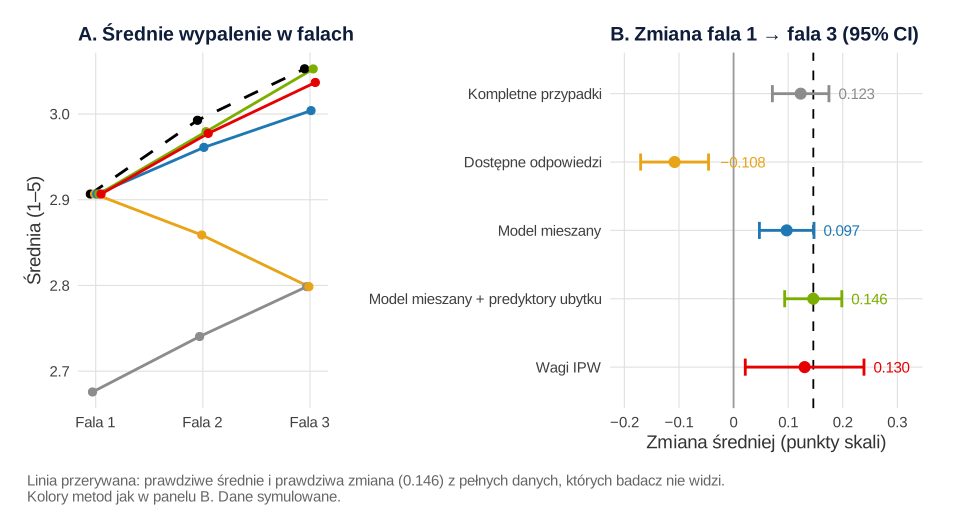
Szukamy średniego wypalenia w każdej fali i zmiany od fali 1 do fali 3. Ponieważ dane są symulowane, znamy prawdę: zmiana wyniosła 0.146 punktu.
| Metoda | Fala 1 | Fala 3 | Zmiana [95% CI] |
|---|---|---|---|
| Prawda (pełne dane) | 2.907 | 3.053 | 0.146 |
| Kompletne przypadki (501 osób) | 2.676 | 2.799 | 0.123 [0.071, 0.175] |
| Wszystkie dostępne odpowiedzi | 2.907 | 2.799 | −0.108 [−0.170, −0.046] |
| Model mieszany (fala) | 2.907 | 3.004 | 0.097 [0.047, 0.147] |
| Model mieszany + plan zmiany pracy i praca zmianowa | 2.907 | 3.053 | 0.146 [0.094, 0.198] |
| Wagi IPW na ubytek | 2.907 | 3.037 | 0.130 [0.021, 0.239] |
Wszystkie dostępne odpowiedzi to najczęstszy błąd w raportach z paneli: średnia z każdej fali liczona z osób, które akurat odpowiedziały. Wynik pokazuje spadek wypalenia o 0.108 punktu, choć wypalenie wzrosło. Średnia z fali 3 pochodzi od innej, mniej wypalonej grupy niż średnia z fali 1. Kompletne przypadki mierzą zmianę w tej samej grupie, więc zmiana jest bliższa prawdzie (0.123). Poziom jest jednak zaniżony: w fali 3 średnia wyniosła 2.799 zamiast 3.053, bo opisuje tylko osoby, które zostały.
Model mieszany wykorzystuje wszystkie odpowiedzi, a przy MAR i poprawnie określonym modelu daje oszacowania bez obciążenia (zob. ANOVA z powtarzanymi pomiarami czy model mieszany). Tu dał 0.097, bo ubytek zależał także od planu zmiany pracy, którego model nie zawierał. Osoby z planem szybciej się wypalały i częściej odchodziły, więc ich brakujące wyniki z fali 3 były wyższe, niż przewidywał model z samą falą. Po dodaniu planu i pracy zmianowej (z interakcją z falą) i uśrednieniu przewidywań dla całej próby model dał 0.146. Podobnie działają imputacja wielokrotna i FIML, pod warunkiem że plan zmiany pracy trafi do modelu imputacji albo do modelu jako zmienna pomocnicza (zob. braki danych i imputacja wielokrotna w R).
Wagi IPW idą inną drogą. Najpierw w każdej fali szacujesz prawdopodobieństwo udziału z wcześniejszego wyniku i zmiennych pomocniczych. Potem odpowiedzi z fali 3 ważysz odwrotnością iloczynu tych prawdopodobieństw, żeby osoby podobne do tych, które odpadły, liczyły się mocniej. Weuve i in. (2012) użyli tej metody w kohorcie z pięcioma pomiarami, a ważenie zwiększyło oszacowanie szybszego spadku funkcji poznawczych u palaczy o 56–86%. Seaman i White (2013) zauważają, że IPW jest zwykle mniej efektywne niż imputacja wielokrotna i wymaga uwagi przy skrajnych wagach. W przykładzie średnia waga w fali 3 wyniosła 1.59, a maksymalna 15.64, stąd przedział [0.021, 0.239] wobec [0.094, 0.198] w modelu mieszanym z predyktorami.
Jedna próba może zmylić, więc całe badanie powtórzyliśmy 500 razy. Przy ubytku MAR obciążenie zmiany wyniosło 0.003 dla modelu z predyktorami ubytku i −0.001 dla wag IPW, wobec −0.037 dla modelu mieszanego bez nich, −0.029 dla kompletnych przypadków i −0.221 dla dostępnych odpowiedzi. Rozrzut błędu był największy dla wag (SD = 0.028 wobec 0.016 dla modelu z predyktorami).
Granica: gdy rezygnacja zależy od tego, czego nie widzisz
W drugim wariancie symulacji szansa odpadnięcia zależała od bieżącego wypalenia, którego osoba nie zgłosiła, bo nie wypełniła ankiety. To mechanizm MNAR. Wszystkie metody zaniżały wtedy wzrost: o 0.071 (model z predyktorami), 0.078 (wagi), 0.087 (kompletne przypadki), 0.116 (model mieszany) i 0.275 (dostępne odpowiedzi). Prawdziwa zmiana wynosiła w tym wariancie średnio 0.171, więc nawet najlepsza metoda wyraźnie ją zaniżyła.
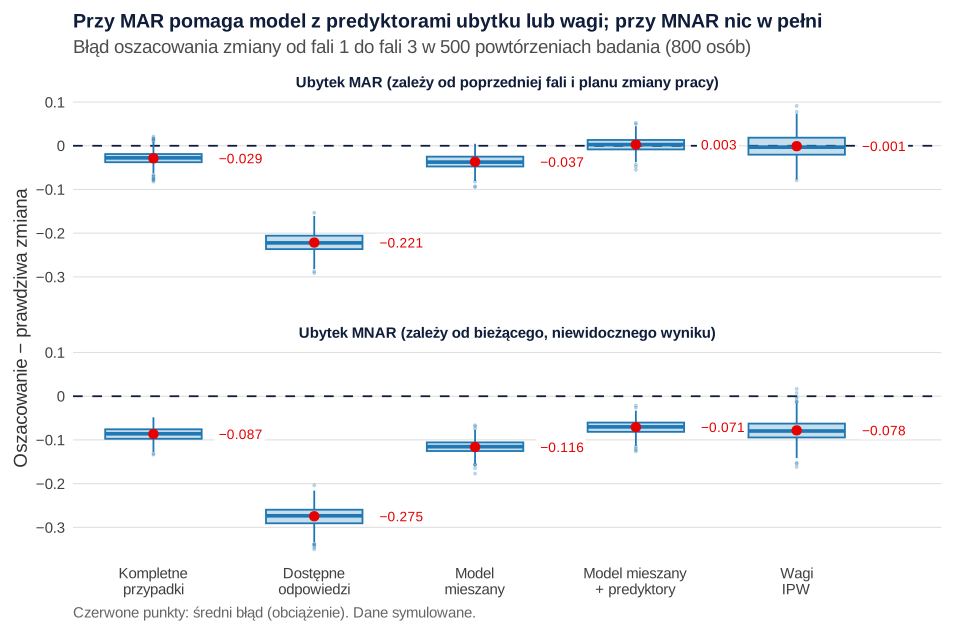
Wniosek praktyczny: najlepszą ochroną przed MNAR są zmienne zebrane wcześniej, które przewidują i wynik, i rezygnację. Plan zmiany pracy zmniejszył obciążenie także w wariancie MNAR, choć go nie usunął. Główną analizę oprzyj na MAR z tymi zmiennymi i dodaj analizę wrażliwości z założeniem, że osoby utracone miały wyniki gorsze o określoną wartość.
Jak opisać ubytek i analizę w artykule
Podaj liczbę osób w każdej fali, przyczyny braku udziału, porównanie osób pozostających i rezygnujących, model przewidujący ubytek, metodę obsługi braków z założeniem i analizę wrażliwości.
Jeśli przygotowujesz analizę danych z kilku fal i recenzent pyta o ubytek, możemy wspólnie zaplanować model braków, wagi i analizę wrażliwości w ramach analiz statystycznych dla badaczy.
Przykład w R
Przepisy uruchamiasz po kolei w jednej sesji R (drugi i trzeci korzystają z obiektów i funkcji z pierwszego). Pierwszy zapisuje dane w formacie szerokim, takie jak widzi badacz, do pliku ankieta-w-kilku-falach.csv (możesz go pobrać tutaj). Trzeci przepis liczy się około minuty. Potrzebne pakiety: tidyr, lme4, marginaleffects i survey.
1. Trzy fale, format długi i analiza ubytku
R
# Krok 1. Trzy fale ankiety, ubytek zależny od wcześniejszego wyniku i analiza osób, które odpadły (dane symulowane)
# 800 pielęgniarek, fale co 6 miesięcy, wynik: skala wypalenia 1–5 (średnia pozycji).
suppressPackageStartupMessages(library(tidyr))

generuj <- function(n, mechanizm = "MAR") {
  wiek <- round(runif(n, 23, 63))
  zmianowa <- rbinom(n, 1, 0.6)                          # praca zmianowa
  u0 <- rnorm(n, 0, 0.55); u1 <- rnorm(n, 0, 0.15)       # różnice indywidualne: poziom i tempo zmiany
  plan <- rbinom(n, 1, plogis(-1.3 + 1.5 * u0 + 2 * u1)) # w fali 1: „planuję zmienić pracę w ciągu roku”
  t <- 0:2
  y <- sapply(t, function(k) 2.7 + 0.2 * zmianowa + 0.3 * plan + u0 +
                (0.05 + 0.15 * plan + u1) * k + rnorm(n, 0, 0.35))
  y <- pmin(pmax(y, 1), 5)
  # Ubytek monotoniczny: kto nie odpowiedział w fali 2, nie dostaje zaproszenia do fali 3.
  # MAR: szansa odpadnięcia zależy od wyniku z poprzedniej fali i od planu zmiany pracy;
  # MNAR: zależy od bieżącego, niezaobserwowanego wyniku.
  odpada <- function(k) {
    yy <- if (mechanizm == "MAR") y[, k - 1] else y[, k]
    rbinom(n, 1, plogis(-1.9 + 1.0 * (yy - 3) + 0.9 * plan + 0.3 * zmianowa))
  }
  r2 <- 1 - odpada(2)
  r3 <- r2 * (1 - odpada(3))
  data.frame(id = seq_len(n), wiek, zmianowa, plan_w1 = plan,
             wyp_w1 = y[, 1], wyp_w2 = ifelse(r2 == 1, y[, 2], NA), wyp_w3 = ifelse(r3 == 1, y[, 3], NA),
             pelne_w2 = y[, 2], pelne_w3 = y[, 3])            # pelne_*: wyniki, których badacz nie widzi
}

set.seed(3731)
d <- generuj(800)
szer <- d[, c("id", "wiek", "zmianowa", "plan_w1", "wyp_w1", "wyp_w2", "wyp_w3")]
write.csv(transform(szer, wyp_w1 = round(wyp_w1, 2), wyp_w2 = round(wyp_w2, 2), wyp_w3 = round(wyp_w3, 2)),
          "ankieta-w-kilku-falach.csv", row.names = FALSE, na = "")

# Format szeroki (jedna osoba = wiersz, sufiks fali) → długi (osoba × fala) do modeli
dl <- pivot_longer(szer, starts_with("wyp_w"), names_to = "fala", names_prefix = "wyp_w", values_to = "wyp")
dl$fala <- factor(dl$fala); dl$t <- as.numeric(dl$fala) - 1
head(dl, 3)

# Ile osób w każdej fali i jakie wzorce udziału
cat("Liczba odpowiedzi w falach:\n"); print(colSums(!is.na(szer[, c("wyp_w1", "wyp_w2", "wyp_w3")])))
wzorzec <- apply(!is.na(szer[, c("wyp_w1", "wyp_w2", "wyp_w3")]), 1, function(x) paste(as.integer(x), collapse = ""))
print(table(wzorzec))

# Osoby, które zostały do fali 3, a osoby, które odpadły: porównanie w fali 1
d$zostal <- as.integer(!is.na(d$wyp_w3))
print(round(sapply(split(d[, c("wyp_w1", "plan_w1", "zmianowa", "wiek")], d$zostal), colMeans), 3))
tt <- t.test(wyp_w1 ~ zostal, data = d)
round(c(t = tt$statistic[[1]], df = tt$parameter[[1]], p = tt$p.value), 3)

# Model przewidujący udział w fali 3 (iloraz szans z 95% CI)
m_ubytek <- glm(zostal ~ wyp_w1 + plan_w1 + zmianowa + I(wiek / 10), family = binomial, data = d)
round(exp(cbind(OR = coef(m_ubytek), confint.default(m_ubytek)))[-1, ], 2)
Wynik w R
# A tibble: 3 × 7
     id  wiek zmianowa plan_w1 fala    wyp     t
  <int> <dbl>    <int>   <int> <fct> <dbl> <dbl>
1     1    23        0       0 1      2.34     0
2     1    23        0       0 2      2.21     1
3     1    23        0       0 3      2.81     2
Liczba odpowiedzi w falach:
wyp_w1 wyp_w2 wyp_w3
   800    618    501
wzorzec
100 110 111
182 117 501
              0      1
wyp_w1    3.294  2.676
plan_w1   0.488  0.118
zmianowa  0.662  0.541
wiek     42.311 42.435
      t      df       p
 12.466 580.718   0.000
             OR 2.5 % 97.5 %
wyp_w1     0.36  0.28   0.48
plan_w1    0.23  0.16   0.34
zmianowa   0.74  0.52   1.04
I(wiek/10) 1.02  0.88   1.18
2. Pięć analiz: kompletne przypadki, dostępne odpowiedzi, modele mieszane i wagi IPW
R
# Krok 2. Średnie w falach i zmiana od fali 1 do 3: pięć sposobów analizy tych samych danych
# (wymaga obiektów d i dl z kroku 1)
suppressPackageStartupMessages({library(lme4); library(marginaleffects); library(survey)})

prawda <- colMeans(d[, c("wyp_w1", "pelne_w2", "pelne_w3")])   # znana tylko w symulacji
prawda <- c(prawda, zmiana_1_3 = prawda[[3]] - prawda[[1]])

# 1–2. Kompletne przypadki (tylko osoby z trzech fal) i wszystkie dostępne odpowiedzi w każdej fali
srednie_svy <- function(dane, wagi = NULL) {
  dane$w <- if (is.null(wagi)) 1 else wagi
  ds <- svydesign(ids = ~id, weights = ~w, data = dane)
  m <- svyglm(wyp ~ 0 + fala, design = ds)
  z <- svycontrast(m, c(-1, 0, 1))
  rbind(cbind(coef(m), confint(m)), cbind(coef(z), confint(z)))
}
obs <- dl[!is.na(dl$wyp), ]
kompletne <- obs[obs$id %in% d$id[d$zostal == 1], ]
w_cc <- srednie_svy(kompletne)
w_ac <- srednie_svy(obs)

# 3. Model mieszany z falą jako czynnikiem (ML, wykorzystuje wszystkie odpowiedzi; poprawny przy MAR,
#    gdy ubytek zależy od wcześniejszych wyników w modelu)
m1 <- lmer(wyp ~ 0 + fala + (1 + t | id), data = obs, REML = FALSE)
k1 <- rbind(diag(3), c(-1, 0, 1))
v1 <- k1 %*% fixef(m1); s1 <- sqrt(diag(k1 %*% as.matrix(vcov(m1)) %*% t(k1)))
w_lmm <- cbind(v1, v1 - 1.96 * s1, v1 + 1.96 * s1)

# 4. Model mieszany z predyktorami ubytku (plan zmiany pracy, praca zmianowa) i średnie przewidywane dla całej próby
m2 <- lmer(wyp ~ fala * (plan_w1 + zmianowa) + (1 + t | id), data = obs, REML = FALSE)
siatka <- dl[, c("id", "fala", "t", "plan_w1", "zmianowa")]
p2 <- avg_predictions(m2, newdata = siatka, by = "fala", re.form = NA)
z2 <- avg_comparisons(m2, variables = list(fala = c("1", "3")), newdata = siatka, re.form = NA)
w_lmm2 <- rbind(cbind(p2$estimate, p2$conf.low, p2$conf.high), cbind(z2$estimate, z2$conf.low, z2$conf.high))

# 5. Wagi IPW na ubytek: sekwencyjne modele logistyczne udziału, waga = 1 / iloczyn prawdopodobieństw
d$r2 <- as.integer(!is.na(d$wyp_w2))
g2 <- glm(r2 ~ wyp_w1 + plan_w1 + zmianowa, family = binomial, data = d)
g3 <- glm(zostal ~ wyp_w2 + plan_w1 + zmianowa, family = binomial, data = subset(d, r2 == 1))
d$p2 <- fitted(g2)
d$p3 <- NA; d$p3[d$r2 == 1] <- fitted(g3)
waga <- with(merge(obs, d[, c("id", "p2", "p3")], by = "id", sort = FALSE),
             ifelse(fala == "1", 1, ifelse(fala == "2", 1 / p2, 1 / (p2 * p3))))
w_ipw <- srednie_svy(obs, waga)
cat("Wagi w fali 3: średnia", round(mean(waga[obs$fala == "3"]), 2), "maksimum", round(max(waga), 2), "\n")

wyniki <- list(kompletne = w_cc, dostepne = w_ac, model_mieszany = w_lmm,
               model_mieszany_z_predyktorami = w_lmm2, wagi_IPW = w_ipw)
tab <- t(sapply(wyniki, function(x) c(fala1 = x[1, 1], fala2 = x[2, 1], fala3 = x[3, 1],
                                      zmiana = x[4, 1], dolna = x[4, 2], gorna = x[4, 3])))
tab <- rbind(prawda = c(unname(prawda), NA, NA), tab)
print(round(tab, 3))
write.csv(data.frame(metoda = rownames(tab), tab), "oszacowania-jedna-proba.csv", row.names = FALSE)
Wynik w R
Wagi w fali 3: średnia 1.59 maksimum 15.64
                              fala1 fala2 fala3 zmiana  dolna  gorna
prawda                        2.907 2.993 3.053  0.146     NA     NA
kompletne                     2.676 2.740 2.799  0.123  0.071  0.175
dostepne                      2.907 2.859 2.799 -0.108 -0.170 -0.046
model_mieszany                2.907 2.961 3.004  0.097  0.047  0.147
model_mieszany_z_predyktorami 2.907 2.979 3.053  0.146  0.094  0.198
wagi_IPW                      2.907 2.977 3.037  0.130  0.021  0.239
3. Monte Carlo: ubytek MAR i MNAR
R
# Krok 3. 500 powtórzeń całego badania przy ubytku MAR i MNAR: obciążenie zmiany od fali 1 do fali 3
# (wymaga funkcji generuj() z kroku 1)
suppressPackageStartupMessages(library(lme4))

ster <- lmerControl(optimizer = "bobyqa")   # stabilniejszy optymalizator w pętli
jedno_badanie <- function(mechanizm) {
  d <- generuj(800, mechanizm)
  dl <- pivot_longer(d[, c("id", "zmianowa", "plan_w1", "wyp_w1", "wyp_w2", "wyp_w3")], starts_with("wyp_w"),
                     names_to = "fala", names_prefix = "wyp_w", values_to = "wyp")
  dl$fala <- factor(dl$fala); dl$t <- as.numeric(dl$fala) - 1
  obs <- dl[!is.na(dl$wyp), ]
  r2 <- !is.na(d$wyp_w2); r3 <- !is.na(d$wyp_w3)
  zm <- function(y1, y3) mean(y3) - mean(y1)
  m1 <- lmer(wyp ~ 0 + fala + (1 + t | id), data = obs, REML = FALSE, control = ster)
  m2 <- lmer(wyp ~ fala * (plan_w1 + zmianowa) + (1 + t | id), data = obs, REML = FALSE, control = ster)
  pr <- tapply(predict(m2, newdata = dl, re.form = NA), dl$fala, mean)
  p2 <- fitted(glm(r2 ~ wyp_w1 + plan_w1 + zmianowa, family = binomial, data = d))
  p3 <- fitted(glm(r3[r2] ~ wyp_w2 + plan_w1 + zmianowa, family = binomial, data = d[r2, ]))
  w3 <- 1 / (p2[r2] * p3)[r3[r2]]
  c(kompletne = zm(d$wyp_w1[r3], d$wyp_w3[r3]),
    dostepne = zm(d$wyp_w1, d$wyp_w3[r3]),
    model_mieszany = fixef(m1)[["fala3"]] - fixef(m1)[["fala1"]],
    model_z_predyktorami = pr[["3"]] - pr[["1"]],
    wagi_IPW = weighted.mean(d$wyp_w3[r3], w3) - mean(d$wyp_w1),
    prawda = zm(d$wyp_w1, d$pelne_w3),
    odsetek_w_fali_3 = mean(r3))
}
set.seed(3733)
mc <- lapply(c(MAR = "MAR", MNAR = "MNAR"), function(m) t(replicate(500, suppressMessages(jedno_badanie(m)))))
write.csv(do.call(rbind, lapply(names(mc), function(m) data.frame(mechanizm = m, round(mc[[m]], 4)))),
          "mc-ubytek.csv", row.names = FALSE)
for (m in names(mc)) {
  x <- mc[[m]]
  cat("\nUbytek", m, "– w fali 3 średnio", round(100 * mean(x[, "odsetek_w_fali_3"]), 1),
      "% próby; prawdziwa zmiana średnio", round(mean(x[, "prawda"]), 3), "\n")
  blad <- x[, 1:5] - x[, "prawda"]
  print(round(rbind(obciazenie = colMeans(blad), SD_bledu = apply(blad, 2, sd),
                    RMSE = sqrt(colMeans(blad^2)), blad_MC = apply(blad, 2, sd) / sqrt(nrow(x))), 3))
}
Wynik w R
Ubytek MAR – w fali 3 średnio 64.3 % próby; prawdziwa zmiana średnio 0.169
           kompletne dostepne model_mieszany model_z_predyktorami wagi_IPW
obciazenie    -0.029   -0.221         -0.037                0.003   -0.001
SD_bledu       0.016    0.023          0.017                0.016    0.028
RMSE           0.033    0.223          0.040                0.016    0.028
blad_MC        0.001    0.001          0.001                0.001    0.001

Ubytek MNAR – w fali 3 średnio 62.5 % próby; prawdziwa zmiana średnio 0.171
           kompletne dostepne model_mieszany model_z_predyktorami wagi_IPW
obciazenie    -0.087   -0.275         -0.116               -0.071   -0.078
SD_bledu       0.016    0.025          0.016                0.017    0.025
RMSE           0.088    0.276          0.117                0.073    0.082
blad_MC        0.001    0.001          0.001                0.001    0.001
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia przepisów 1–3 w R 4.5.3 (modele glm() i t.test() z pakietu stats) z pakietami tidyr, lme4, marginaleffects i survey; rysunki przygotowano w pakietach ggplot2 i patchwork.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- tidyr (wersja 1.3.2): Wickham, H., Vaughan, D., & Girlich, M. (2025). tidyr: Tidy messy data (R package version 1.3.2) [Computer software]. https://doi.org/10.32614/CRAN.package.tidyr
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- marginaleffects (wersja 1.0.0): Arel-Bundock, V., Greifer, N., & Heiss, A. (2024). How to interpret statistical models using marginaleffects for R and Python. Journal of Statistical Software, 111(9), 1–32. https://doi.org/10.18637/jss.v111.i09
- survey (wersja 4.5): Lumley, T. (2004). Analysis of complex survey samples. Journal of Statistical Software, 9(8), 1–19. https://doi.org/10.18637/jss.v009.i08
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots (R package version 1.3.2) [Computer software]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Średnie z dostępnych odpowiedzi w każdej fali przedstawione jako zmiana. Każda fala opisuje wtedy inną grupę osób.
- Zmiana brzmienia lub kafeterii między falami „bo lepiej brzmi”. Zmiana narzędzia miesza się ze zmianą w ludziach.
- Brak zmiennych pomocniczych w fali 1. Bez nich założenie MAR jest mniej wiarygodne, a korekta słabsza.
- Usunięcie osób, które opuściły jedną falę. Model mieszany wykorzystuje ich pozostałe odpowiedzi, a osoby te mogą wrócić.
- Niedziałające łączenie fal. Brak numeru uczestnika w linku albo kod tworzony za każdym razem inaczej odkrywa się zwykle dopiero przy łączeniu baz (zob. jak połączyć dwie bazy z ankiet).
- Wagi IPW bez sprawdzenia rozkładu wag. Kilka wag powyżej 10 może zdominować wynik; podaj średnią i maksimum wag, a w razie potrzeby przytnij skrajne wagi.
Najczęstsze pytania
Jak połączyć odpowiedzi tej samej osoby z kilku fal ankiety?
Potrzebny jest stały identyfikator: numer uczestnika przekazywany w linku albo kod tworzony przez respondenta z elementów stałych. Dane kontaktowe trzymaj w osobnej bazie, połączonej z odpowiedziami tylko numerem. Takie dane są pseudonimizowane, a nie anonimowe, co trzeba opisać w zgodzie z fali 1.
Czy w kolejnej fali ankiety można zmienić pytania?
Pytań, które mierzą zmianę, nie zmieniaj: ani brzmienia, ani kafeterii, ani kolejności. Nowe pytania dopisuj na końcu kwestionariusza. Każda zmiana narzędzia miesza się ze zmianą w ludziach i nie da się jej potem oddzielić.
Dlaczego średnie z kolejnych fal panelu mogą pokazywać fałszywą zmianę?
Bo w każdej fali odpowiada inna grupa osób. W przykładzie odpadały osoby bardziej wypalone, więc średnia z dostępnych odpowiedzi spadła o 0.108 punktu, choć prawdziwe wypalenie wzrosło o 0.146. Zmianę licz modelem mieszanym na wszystkich odpowiedziach albo z wagami na ubytek.
Kiedy wagi IPW na ubytek są lepsze niż model mieszany?
Gdy rezygnacja zależy od zmiennych, których nie chcesz umieszczać w modelu wyniku. Wagi są jednak mniej precyzyjne: w przykładzie 95% CI dla zmiany wyniósł [0.021, 0.239] wobec [0.094, 0.198] w modelu mieszanym z predyktorami ubytku. Przy skrajnych wagach rozważ ich przycięcie i zawsze podaj średnią i maksymalną wagę.
Jakie pytania dodać w pierwszej fali, żeby lepiej poradzić sobie z ubytkiem?
Pytania, które mogą przewidywać rezygnację i są związane z wynikiem: zamiar zmiany pracy lub miejsca zamieszkania, gotowość udziału w kolejnych falach, ocena obciążenia ankietą. W przykładzie dodanie planu zmiany pracy do modelu mieszanego zmniejszyło obciążenie zmiany z −0.037 do 0.003 przy ubytku MAR i z −0.116 do −0.071 przy ubytku MNAR.
Powiązane hasła
Przeczytaj też
Badanie podłużne w doktoracie
Liczba pomiarów i odstępy, moc w symulacji, rekrutacja z zapasem na odpadanie, kodowanie czasu oraz model mieszany i LGM w R z wzorem opisu.
Czytaj →PoradnikKod identyfikacyjny w ankiecie anonimowej
Jak zbudować kod respondenta, ile osób ma taki sam, dopasowanie z odległością Levenshteina, fałszywe pary i RODO – z symulacją w R.
Czytaj →PoradnikInwariancja podłużna pomiaru
Trzy pomiary w lavaan: kowariancje reszt, measEq.syntax, częściowa inwariancja w jednym pomiarze, odpadanie i progi – co zmienia się we wniosku o zmianie.
Czytaj →Masz dane z kilku fal i recenzent pyta o ubytek?
Pomożemy przeanalizować, kto odpadł, dobrać model braków lub wagi IPW i przygotować analizę wrażliwości oraz opis, który samodzielnie obronisz przed recenzentami.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Dumville, J. C., Torgerson, D. J., & Hewitt, C. E. (2006). Reporting attrition in randomised controlled trials. BMJ, 332(7547), 969–971. https://doi.org/10.1136/bmj.332.7547.969 ● Otwarty dostęp: pełny tekst
- Graham, J. W. (2009). Missing data analysis: Making it work in the real world. Annual Review of Psychology, 60(1), 549–576. https://doi.org/10.1146/annurev.psych.58.110405.085530
- Laurie, H., & Lynn, P. (2009). The use of respondent incentives on longitudinal surveys. In P. Lynn (Ed.), Methodology of longitudinal surveys (pp. 205–233). Wiley. https://doi.org/10.1002/9780470743874.ch12 ● Otwarty dostęp: pełny tekst
- Lugtig, P. (2014). Panel attrition: Separating stayers, fast attriters, gradual attriters, and lurkers. Sociological Methods & Research, 43(4), 699–723. https://doi.org/10.1177/0049124113520305
- Lynn, P. (2009). Methods for longitudinal surveys. In P. Lynn (Ed.), Methodology of longitudinal surveys (pp. 1–19). Wiley. https://doi.org/10.1002/9780470743874.ch1
- Seaman, S. R., & White, I. R. (2013). Review of inverse probability weighting for dealing with missing data. Statistical Methods in Medical Research, 22(3), 278–295. https://doi.org/10.1177/0962280210395740
- Warren, J. R., & Halpern-Manners, A. (2012). Panel conditioning in longitudinal social science surveys. Sociological Methods & Research, 41(4), 491–534. https://doi.org/10.1177/0049124112460374 ● Otwarty dostęp: pełny tekst
- Watson, N., & Wooden, M. (2009). Identifying factors affecting longitudinal survey response. In P. Lynn (Ed.), Methodology of longitudinal surveys (pp. 157–181). Wiley. https://doi.org/10.1002/9780470743874.ch10
- Weuve, J., Tchetgen Tchetgen, E. J., Glymour, M. M., Beck, T. L., Aggarwal, N. T., Wilson, R. S., Evans, D. A., & Mendes de Leon, C. F. (2012). Accounting for bias due to selective attrition: The example of smoking and cognitive decline. Epidemiology, 23(1), 119–128. https://doi.org/10.1097/ede.0b013e318230e861 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{dumville2006reporting, author={Dumville, Jo C. and Torgerson, David J. and Hewitt, Catherine E.}, title={{Reporting attrition in randomised controlled trials}}, journal={BMJ}, year={2006}, volume={332}, number={7547}, pages={969--971}, doi={10.1136/bmj.332.7547.969}}@article{graham2009missing, author={Graham, John W.}, title={{Missing data analysis: Making it work in the real world}}, journal={Annual Review of Psychology}, year={2009}, volume={60}, number={1}, pages={549--576}, doi={10.1146/annurev.psych.58.110405.085530}}@incollection{laurie2009use, author={Laurie, Heather and Lynn, Peter}, title={{The use of respondent incentives on longitudinal surveys}}, booktitle={Methodology of longitudinal surveys}, year={2009}, pages={205--233}, publisher={Wiley}, doi={10.1002/9780470743874.ch12}}@article{lugtig2014panel, author={Lugtig, Peter}, title={{Panel attrition: Separating stayers, fast attriters, gradual attriters, and lurkers}}, journal={Sociological Methods \& Research}, year={2014}, volume={43}, number={4}, pages={699--723}, doi={10.1177/0049124113520305}}@incollection{lynn2009methods, author={Lynn, Peter}, title={{Methods for longitudinal surveys}}, booktitle={Methodology of longitudinal surveys}, year={2009}, pages={1--19}, publisher={Wiley}, doi={10.1002/9780470743874.ch1}}@article{seaman2013review, author={Seaman, Shaun R. and White, Ian R.}, title={{Review of inverse probability weighting for dealing with missing data}}, journal={Statistical Methods in Medical Research}, year={2013}, volume={22}, number={3}, pages={278--295}, doi={10.1177/0962280210395740}}@article{warren2012panel, author={Warren, John Robert and Halpern-Manners, Andrew}, title={{Panel conditioning in longitudinal social science surveys}}, journal={Sociological Methods \& Research}, year={2012}, volume={41}, number={4}, pages={491--534}, doi={10.1177/0049124112460374}}@incollection{watson2009identifying, author={Watson, Nicole and Wooden, Mark}, title={{Identifying factors affecting longitudinal survey response}}, booktitle={Methodology of longitudinal surveys}, year={2009}, pages={157--181}, publisher={Wiley}, doi={10.1002/9780470743874.ch10}}@article{weuve2012accounting, author={Weuve, Jennifer and Tchetgen Tchetgen, Eric J. and Glymour, M. Maria and Beck, Todd L. and Aggarwal, Neelum T. and Wilson, Robert S. and Evans, Denis A. and Mendes de Leon, Carlos F.}, title={{Accounting for bias due to selective attrition: The example of smoking and cognitive decline}}, journal={Epidemiology}, year={2012}, volume={23}, number={1}, pages={119--128}, doi={10.1097/ede.0b013e318230e861}}